跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
yi songY

yi song

@yi song
体面乡绅 硕果累累
取消关注 关注
关于
帖子
53
主题
9
分享
0
群组
2
粉丝
1
关注
0

帖子

最新 最佳 有争议的

  • 买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业!
    yi songY yi song
    AI硬件 7900xtx

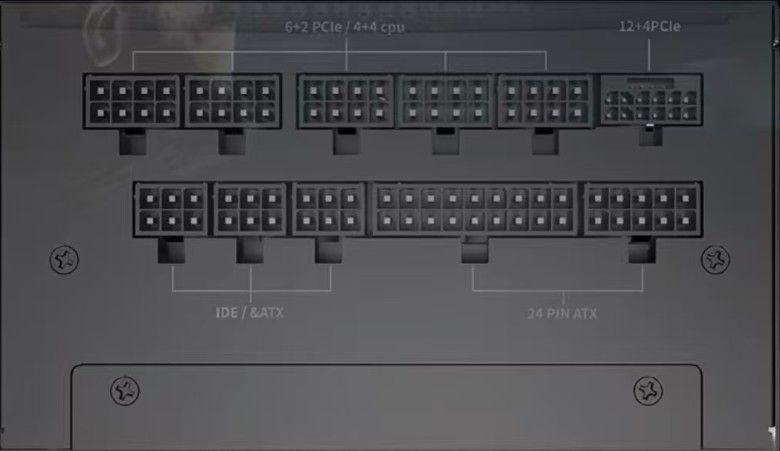
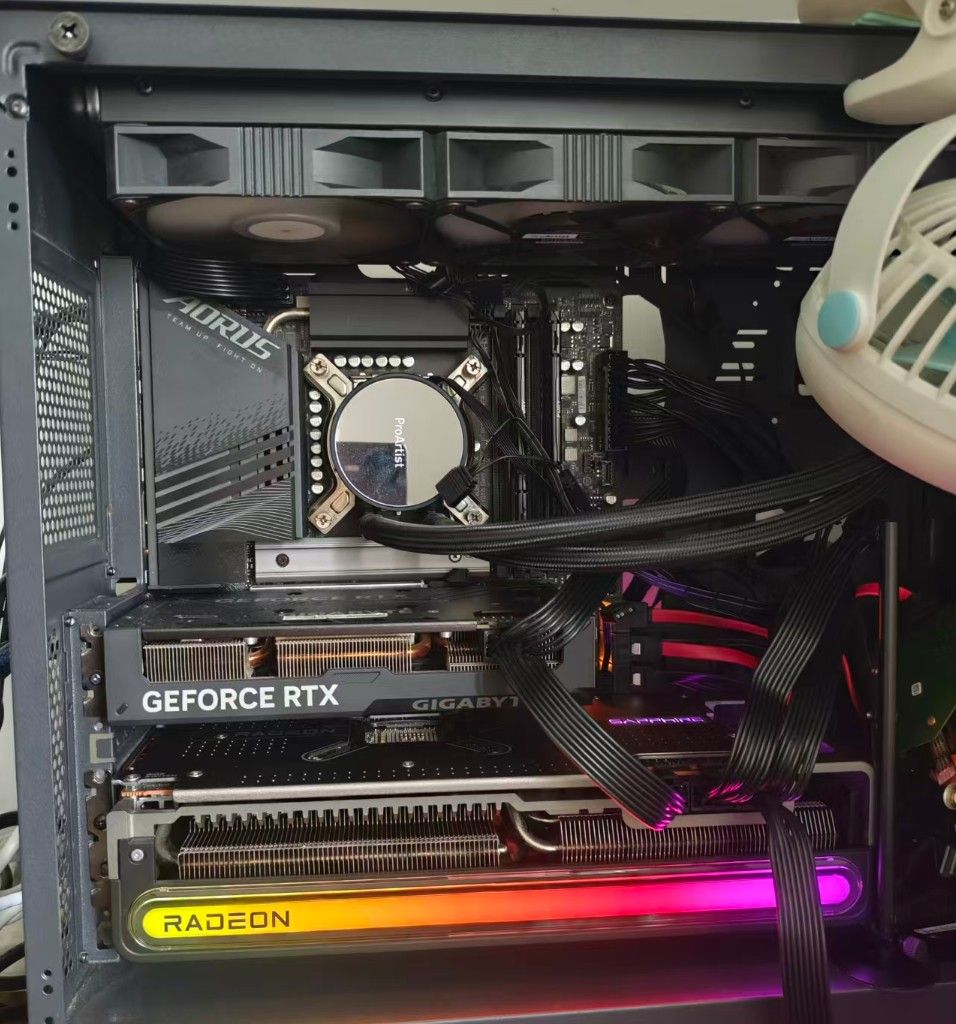
    @zhang-cun 7900xtx我刚装了一个,给你一个经验注意一下。7900xtx有3个电源供电口,需要3跟pcle的供电线,我买的1250W的长城巨龙,电源只带2根显卡电源线,所以你两张卡要6根线,你买电源的时候得注意。然后我的电源插口看下面图片,这里只有5个插槽,你还要给一个槽用CPU供电,所以你选电源的时候这个要注意。这个是我这两天刚发现的问题,不然再买线材还要等好久。

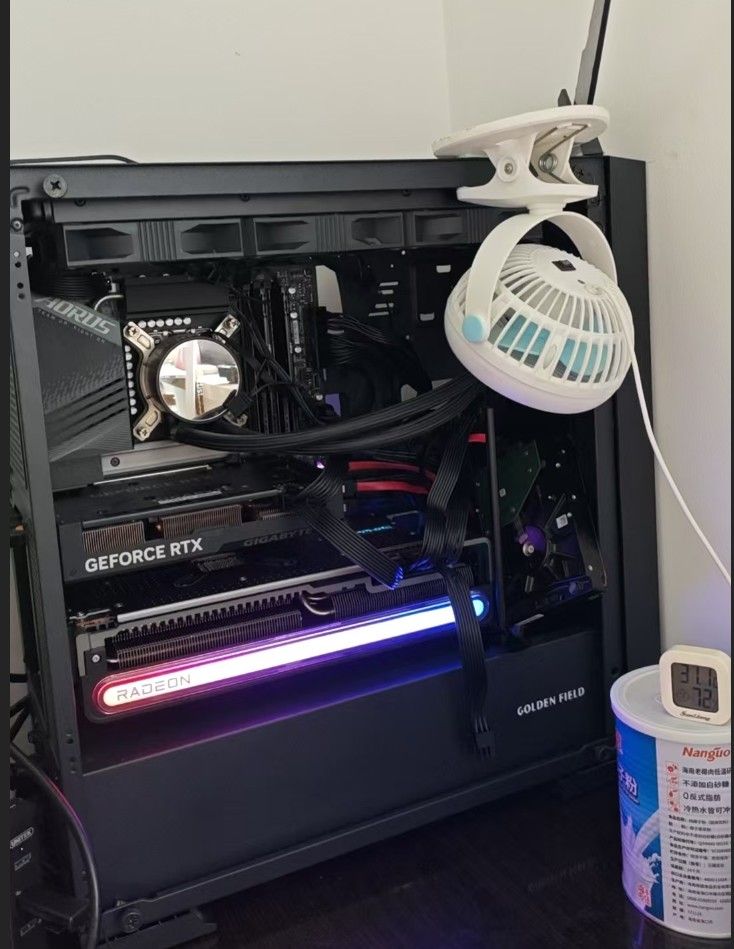
    对于空间的问题也要想好,我的主板是Z790,我之前是4060ti的卡,放在主卡槽,现在新买的7900xtx在副槽,这个是能插进去的,但是反过来就插不进去,所以你买主板的时候要注意两个插槽的距离,7900xtx很大,插槽太近插不进去。

    散热问题是我现在发现的问题,我是机箱两头都开着,机箱上面夹个风扇,现在跑本地嗷嗷叫,机箱小了肯定不行。

    bf2ce05e-6702-49e8-a0c5-675d0888a6b0-image.jpeg

    831d8e08-53f4-42d5-9fe6-7cc31ab7cb9e-image.jpeg


  • 给想要配X99+ddr3内存的兄弟们一点经验!
    yi songY yi song
    AI硬件 x99 7900xtx 本地模型

    我今天是终于完成了我的设备配置的安装,正好看到老特的视频,和我的配置一样,所以发个帖给兄弟们个建议。
    先说一下配置:
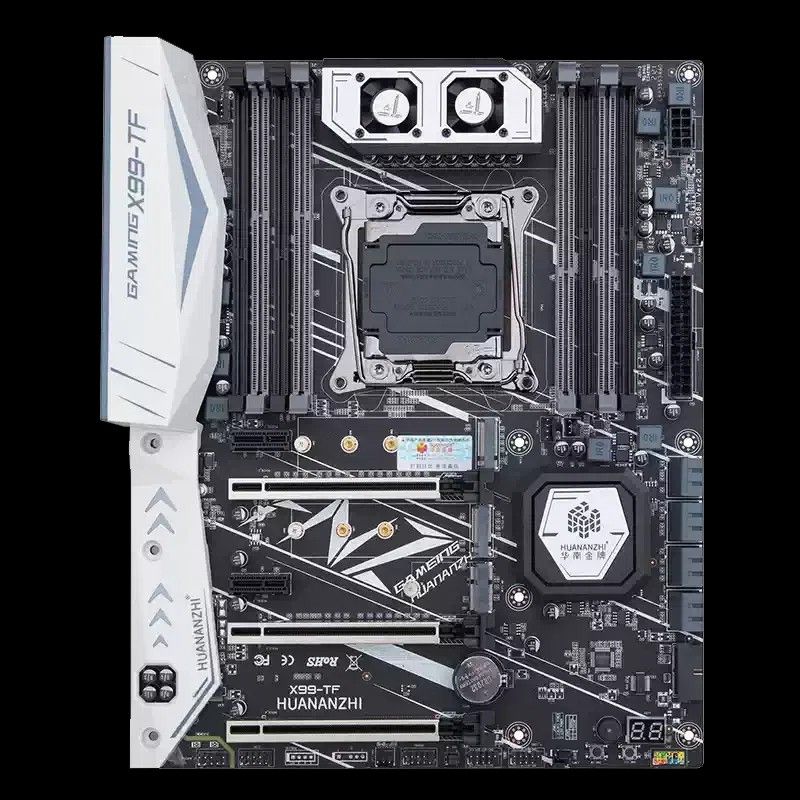
    X99 TF+2696V3+ddr3 32g*4+7900xtx+1250w电源。

    我的电源是以前和显卡一起买的,当时我两张显卡放我常用的电脑里,所以瓦数大,不想买新的就这样用,以后可能再加显卡。7900xtx也是之前双卡机器卸下来的。

    先说我的想法,strata架构老特刚说的时候,我用自己电脑测试了一下(Z790小雕+DDR5 32G*2+4060TI 16G+7900XTX),效果是运行Qwen Flash next模型,内存顶到头来,电脑会卡,所以一直用qwen3.8 27B Q4,速度能到48t/s,能用。但是我知道strata的潜力很大,所以决定ddr3顶到128G买洋垃圾
    179f18cd1b187f4575cc86abd8d78f28.jpg

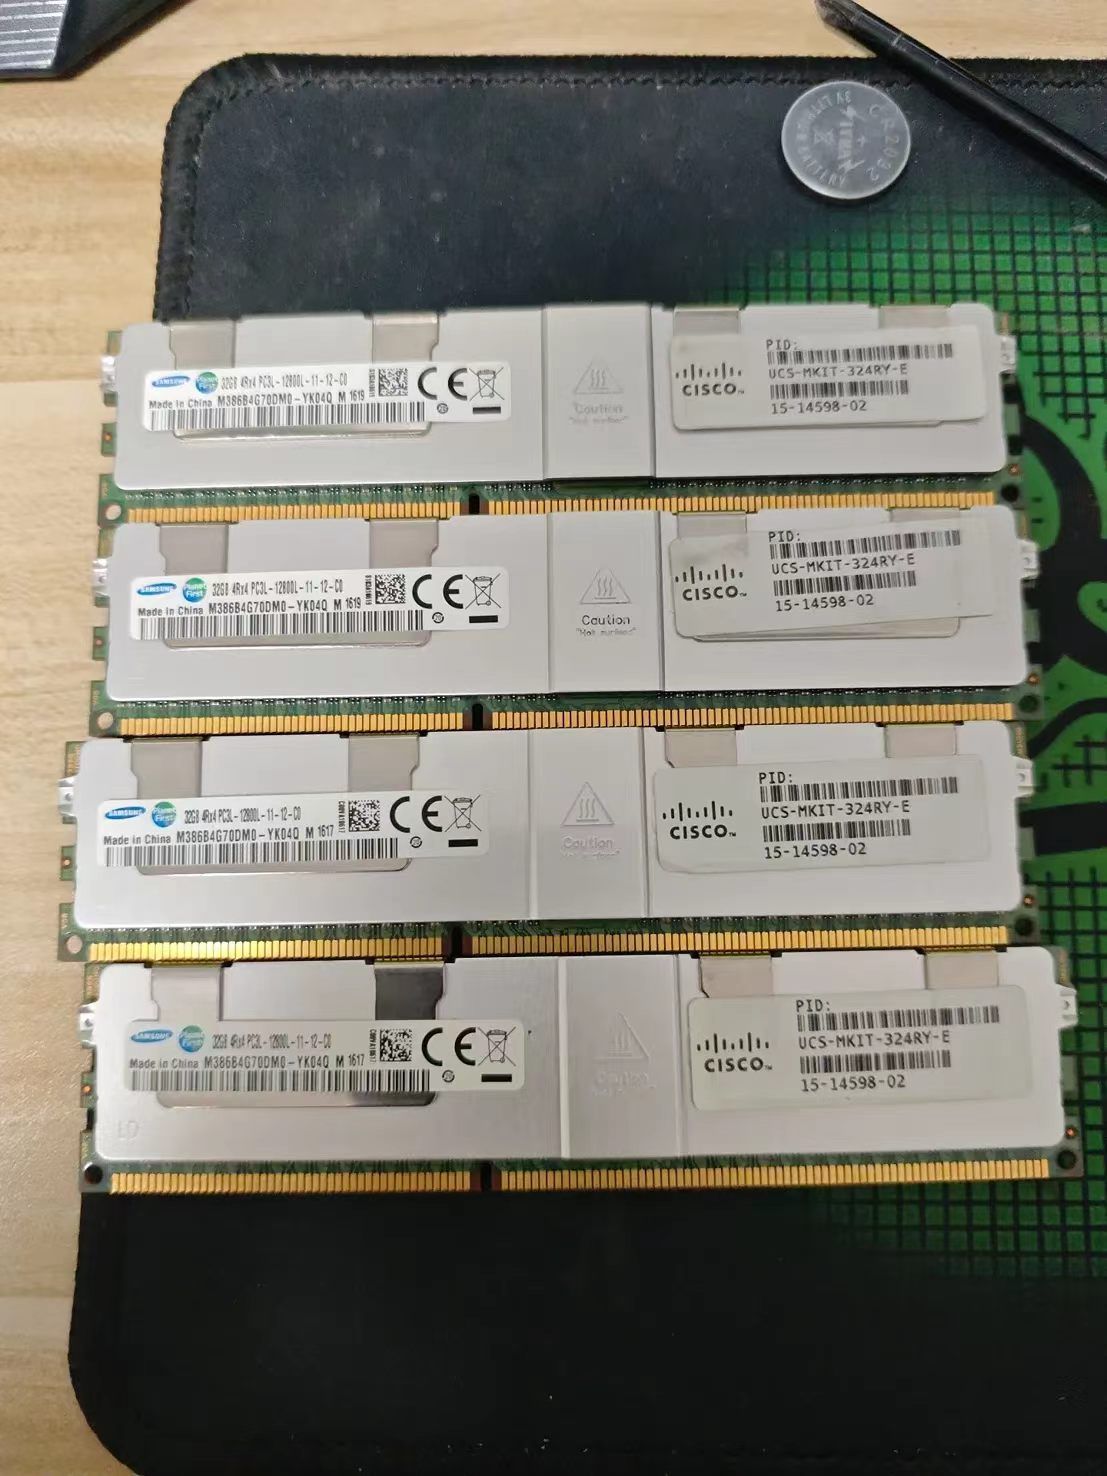
    再说选购洋垃圾这里面的坑。我所有配件都在闲鱼选,我就是有时间挑这个,最后选了X99(当时我想买AD3但是这个忽视了买错了)+2696v3,360块钱。32g*4根 1000块钱(这个选同批次出4根的非常难找,我找了好几天)。风扇38。其他配件我都有,所以综上选购。
    9efabe735cf5521a10ccd1689786a8c4.jpg
    8fe0f037baf45c5c09806ac9df09e825.jpg

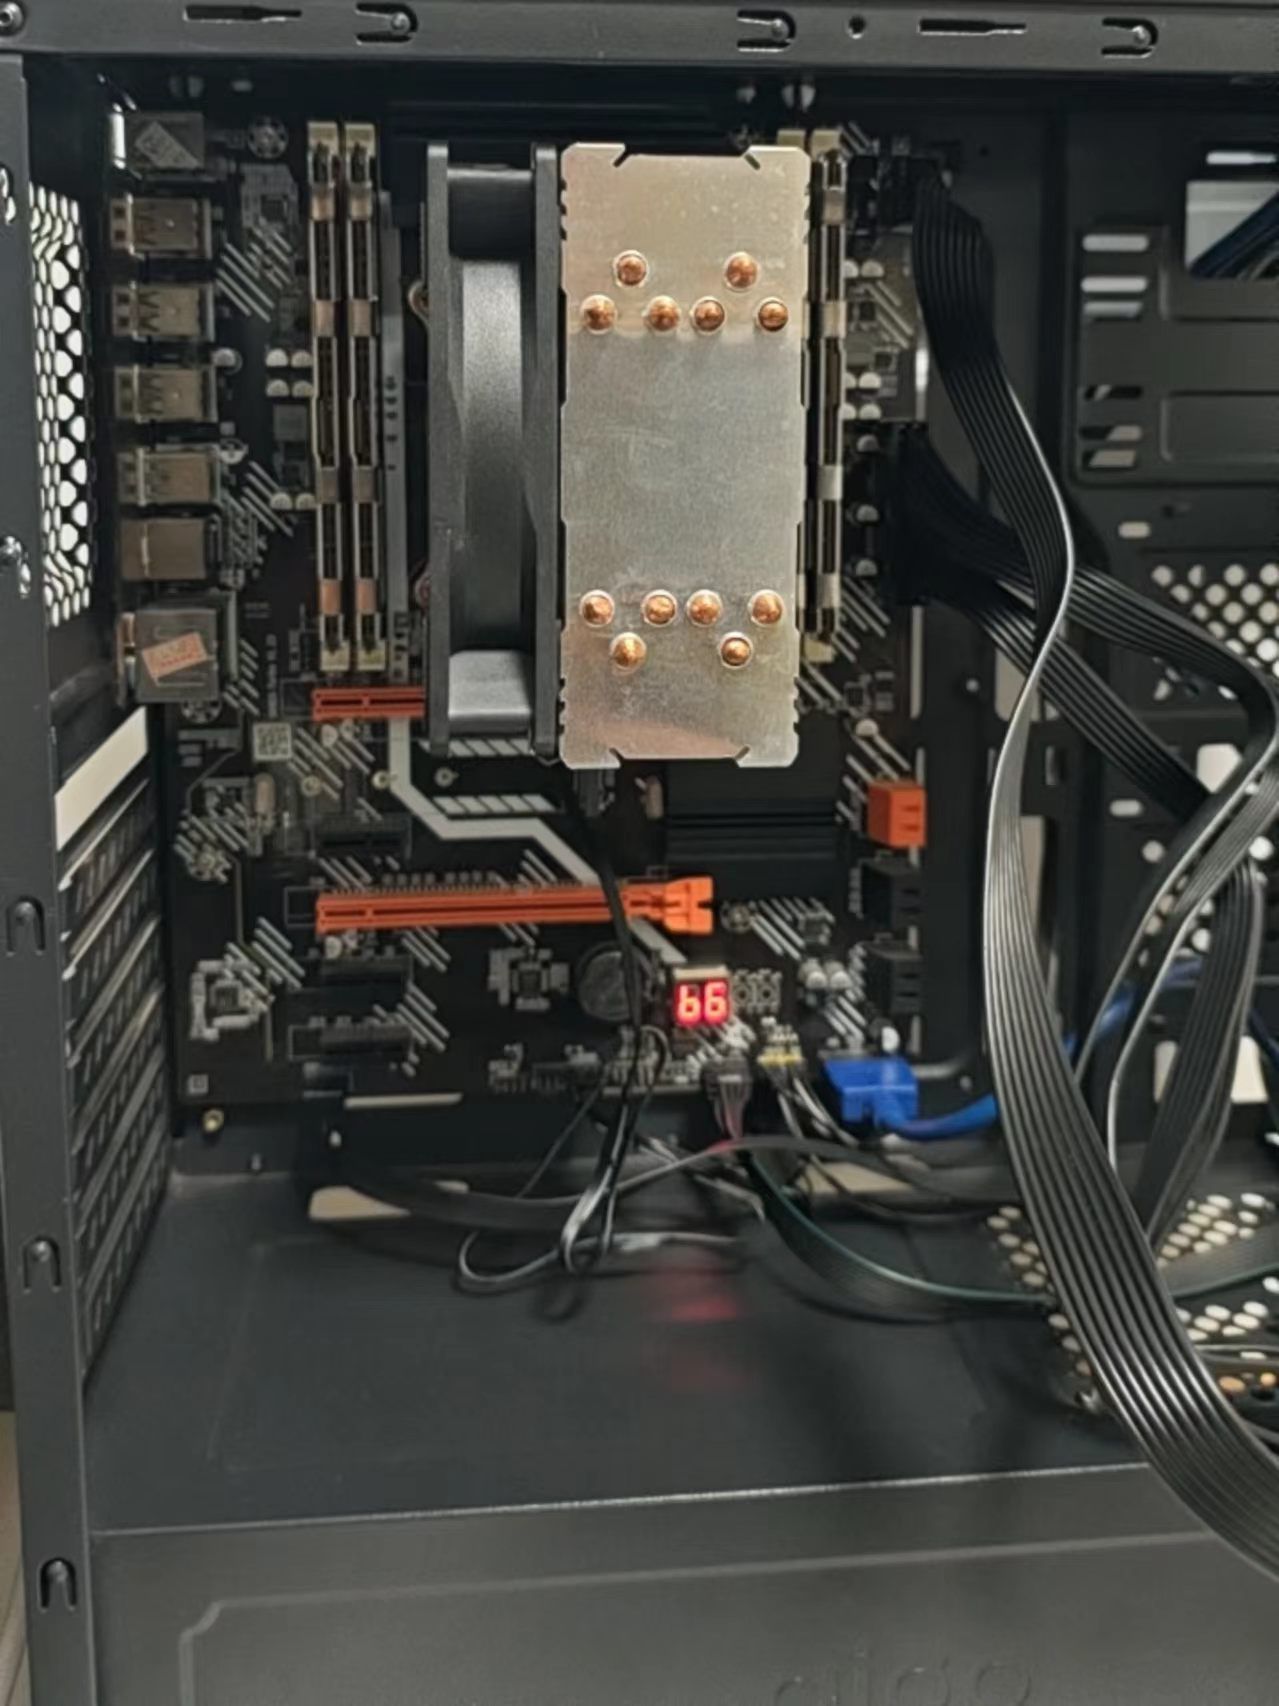
    这里第一次装,就是卡66
    a61f54d4f9943816afe05b4dbbb49a1b.jpg
    4d84a9ccdefe54ed911b22af13196eb6.jpg

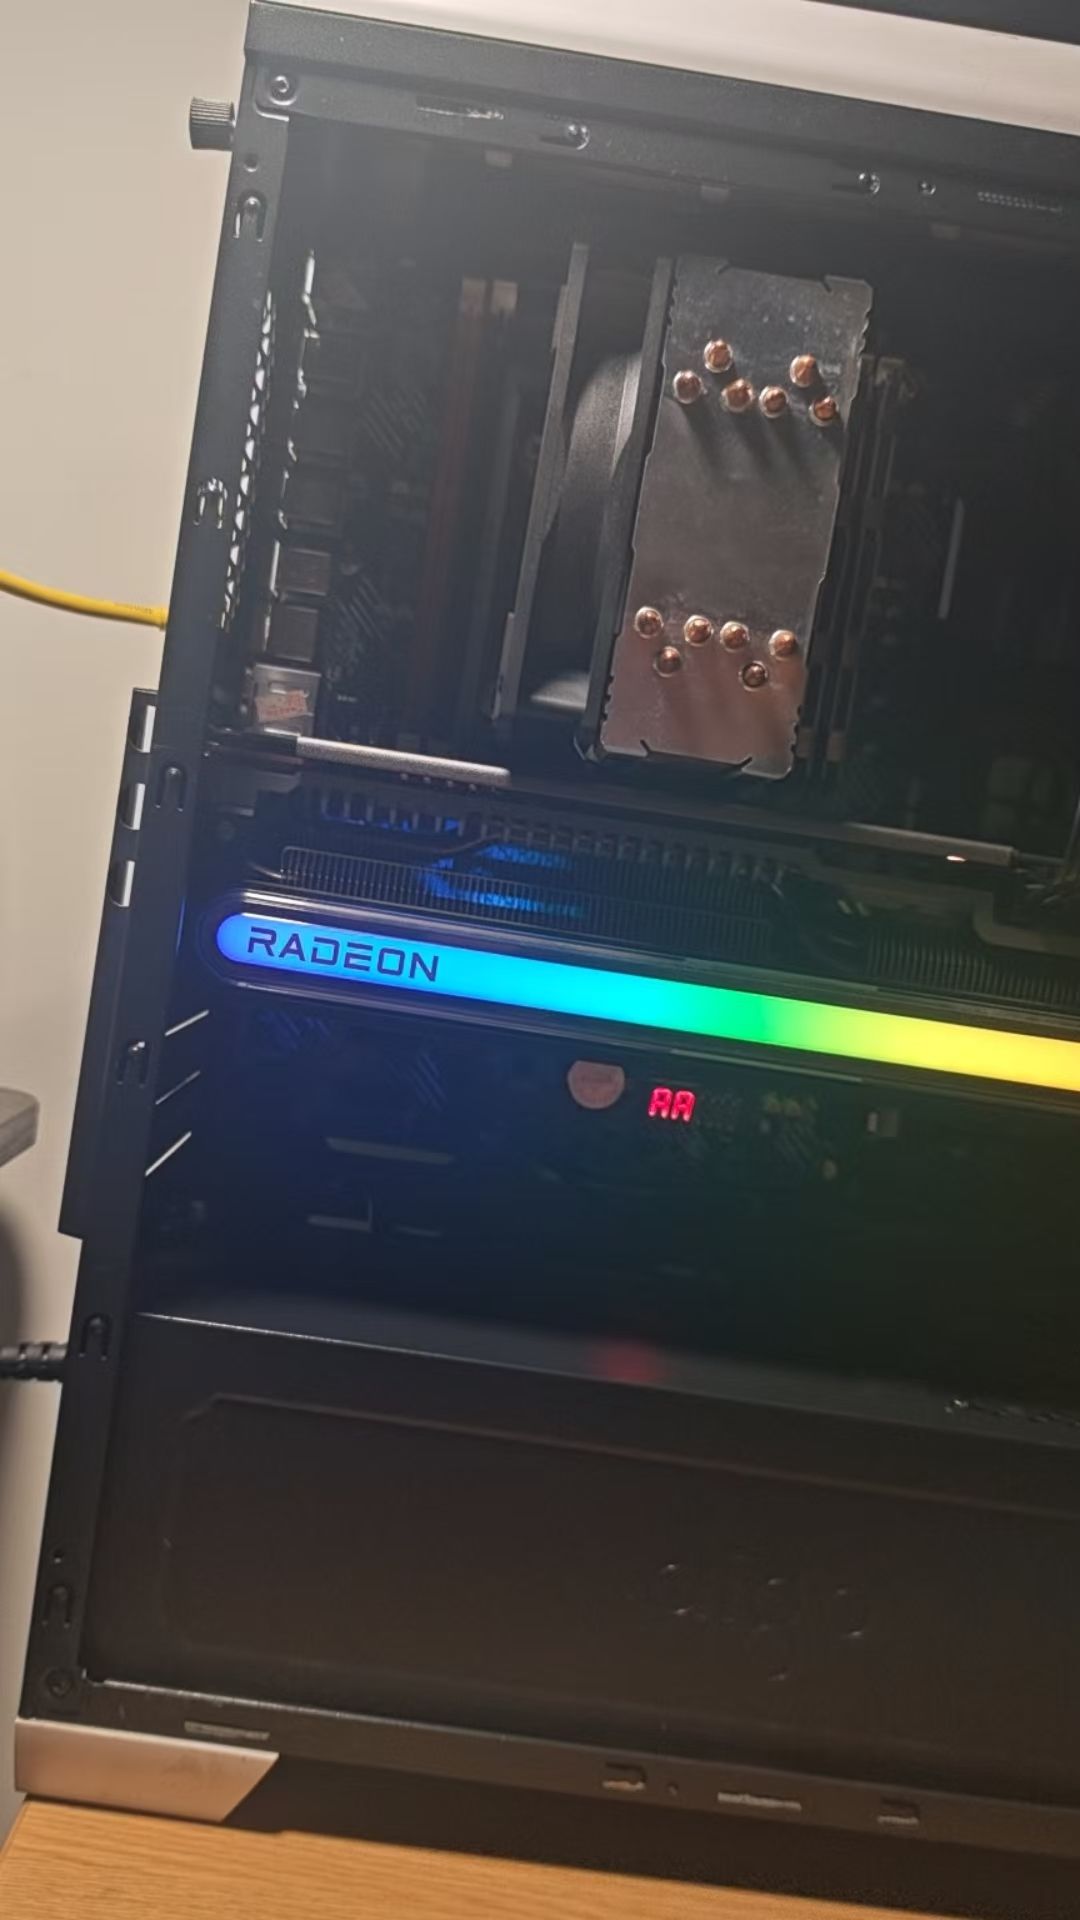
    测试其他口,不是66,就是67,还有60
    3cf4229ac02e72c7e5af2488c5c47a34.jpg

    最后点亮测出来是右侧两个内存插上识别到64G,左边两个内存只要插就报错,所以这个板子就能识别两个内存插槽。所以这台机器从18号用到今天22号。

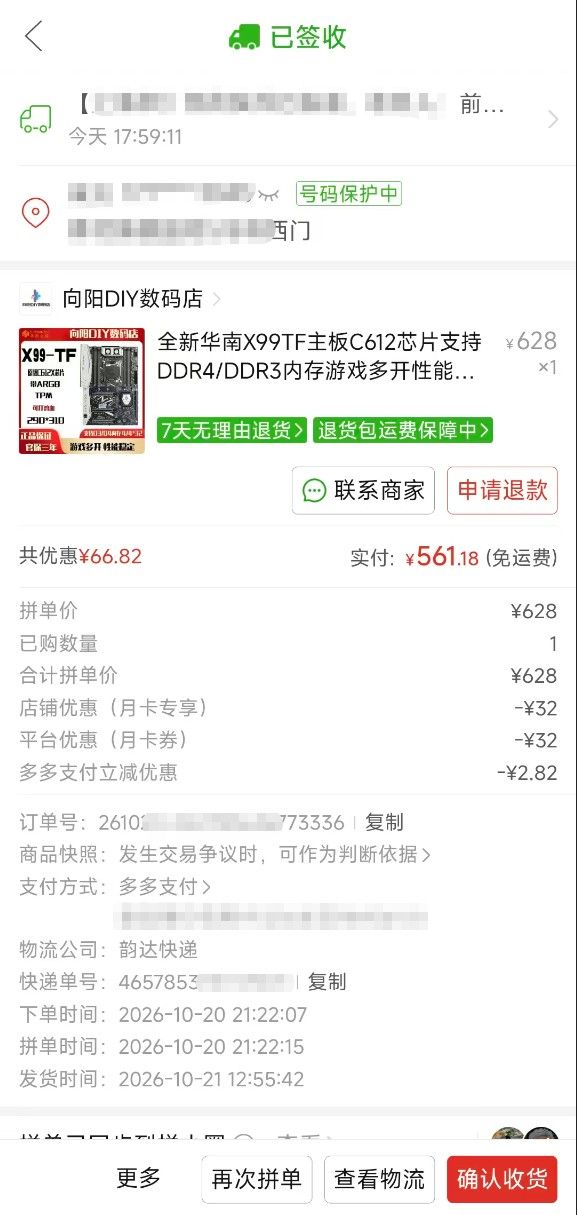
    因为目标是要上到128G,我也买了内存条4根,所以开始找板子。这时候选板子就发现X99 AD并不是最好的,开始研究X99板子,最终还是选择TF,因为做工好,线路更好,散热更好,这时候就在闲鱼游荡买了一张21年的板子,发过来内存插槽就报61,哪个槽都报61,所以退回去了,决定一步到位买新的带3年质保,多多上买的。
    image.jpeg

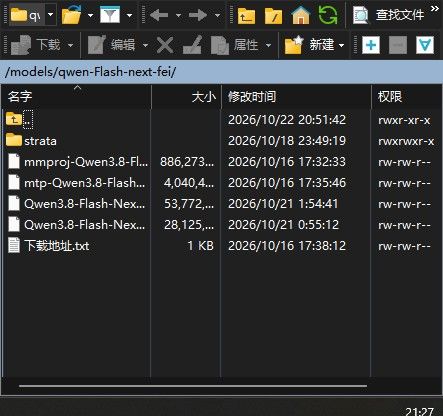
    收货就安上,一步到位,就是要自己配置网络,新板插网线竟然不分配网络,不知道原因,AI指导下完成,模型也从IQ3_XXS换成了IQ3_S,现在正在让DeepSeek配置完这个服务器。
    因为我有两个自己写的软件连的就是本地模型,所以比较麻烦,一会再发一下测试出来的速度。

    我有少部分敏感内容,所以一直用的都是非审查模型,XXS已经删除了,未来都用IQ3_S模型
    image.jpeg

    之前32k上下文速度峰值是102,平均80左右,现在还在配置中一会我再试试。

    最终总结,自己玩,内存要买同一批次的很重要,U随便闲鱼挑挑,主板还是买新的吧,二手的都是21年左右的识别内存上有问题。有人建议T8 F8,我当时没看这两款,因为标称是DDR4我就忽略了。目前我觉得TF还可以。
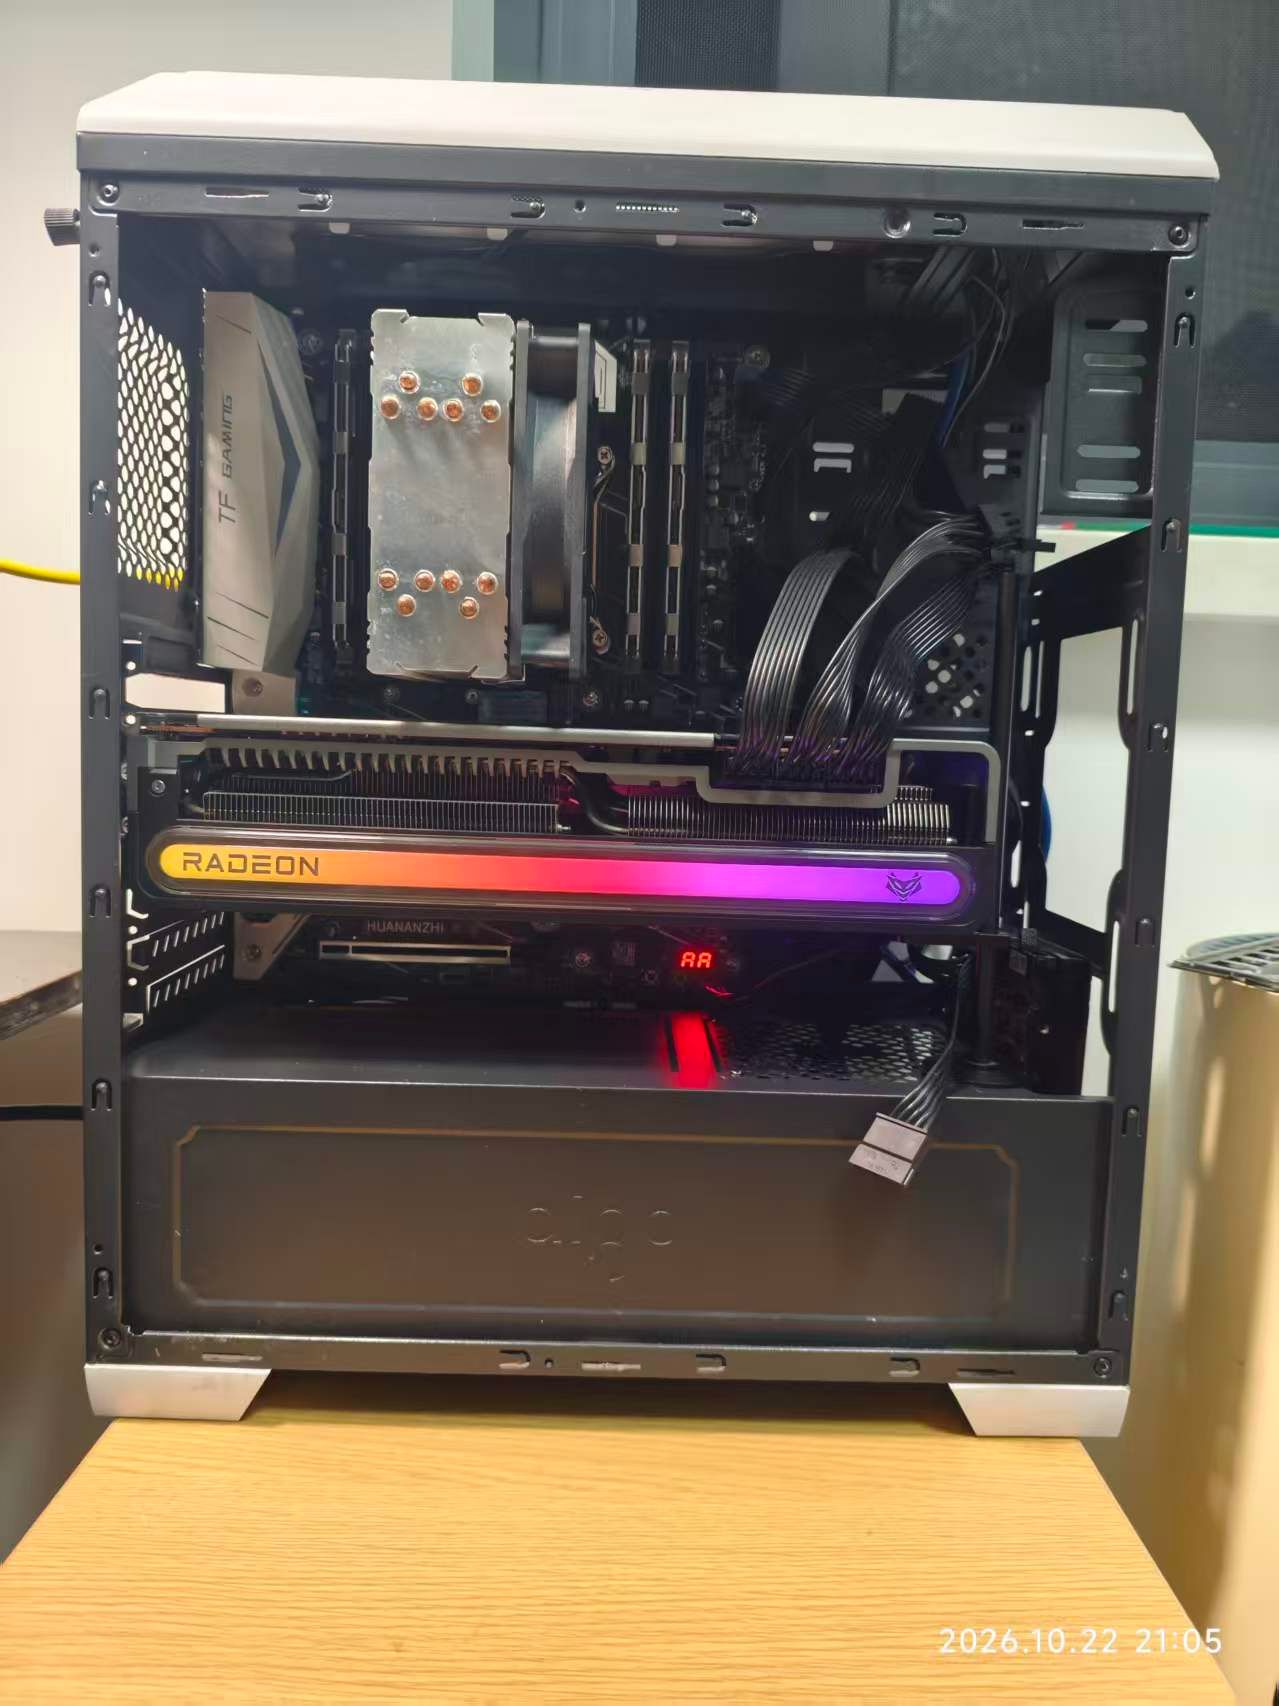
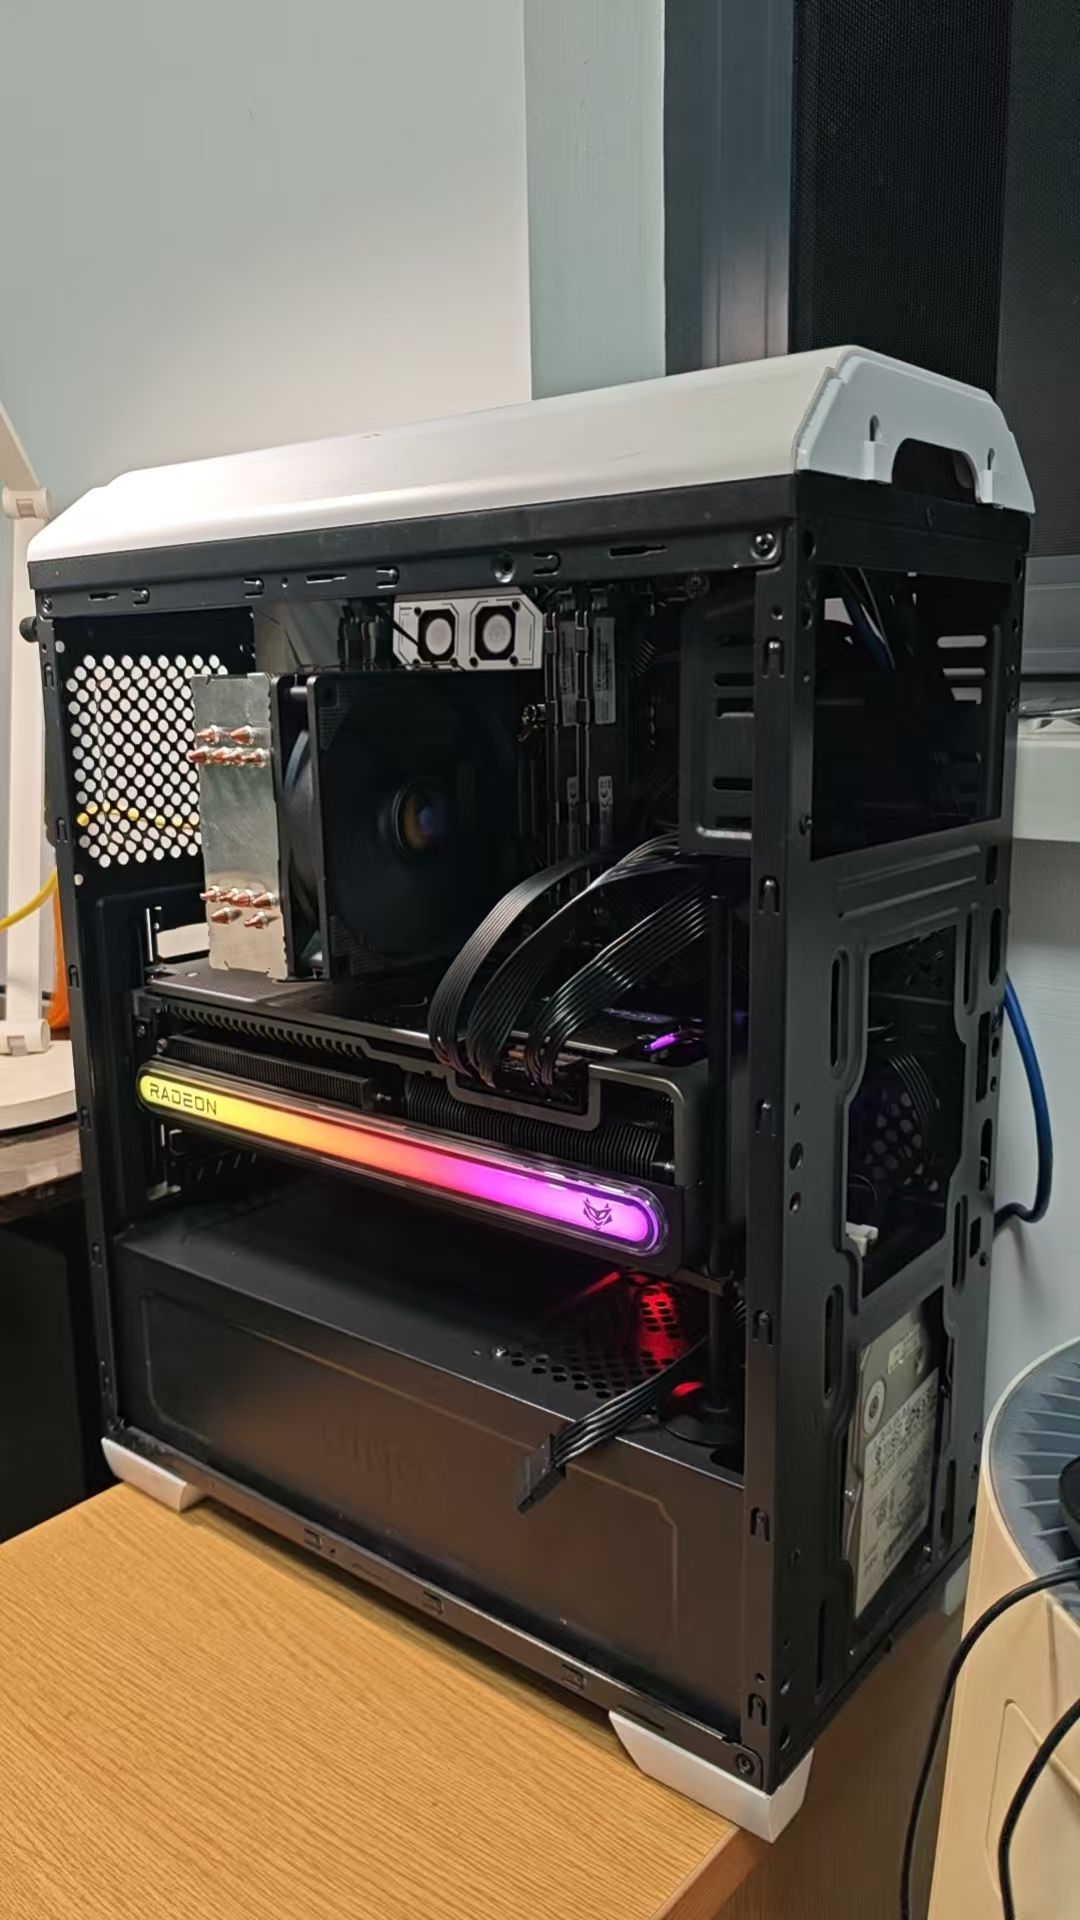
    1d1061f542e1d6c7a1b0353a59e3333b.jpgd907173df1ea81b0019a49f773360ab8.jpg

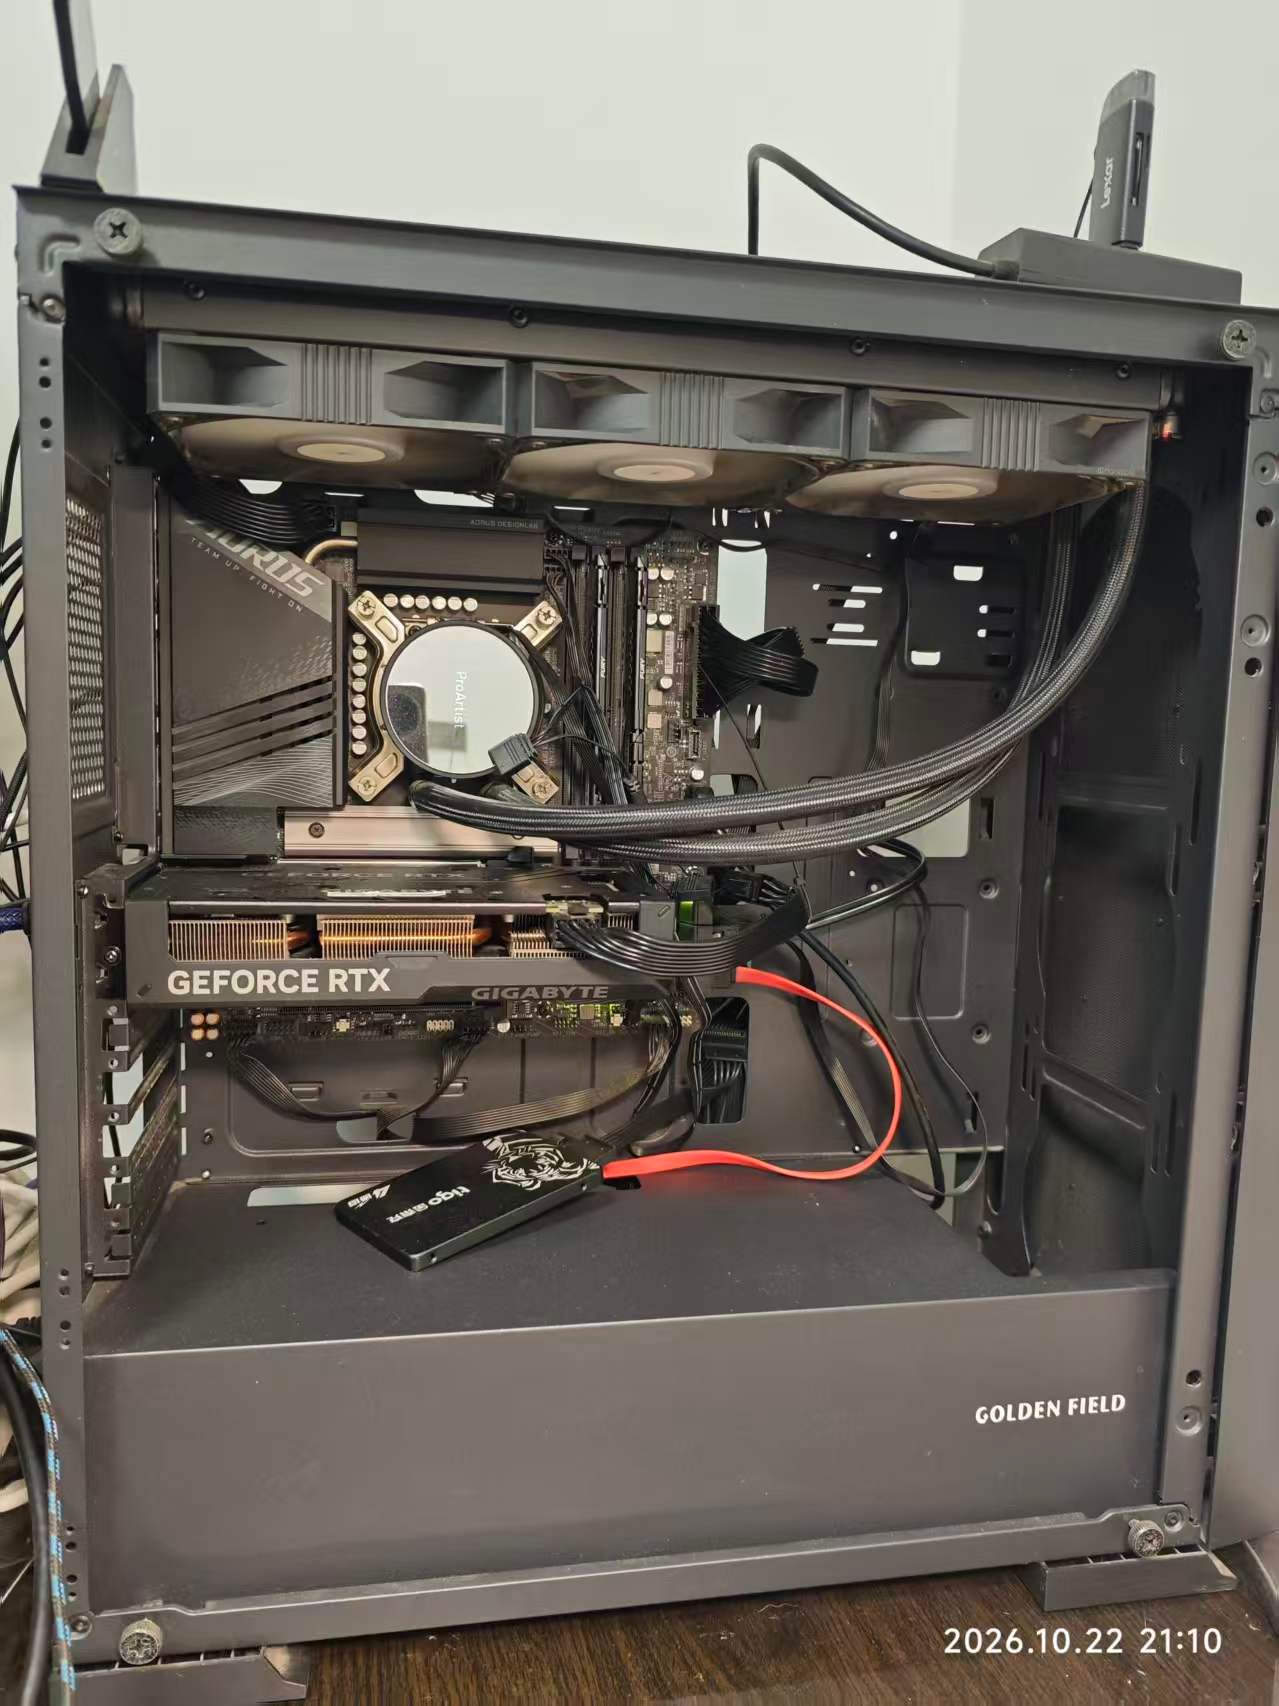
    机箱用的10年前的爱国者旧机器的机箱,把塑料件拆完,只留上面的按钮,四周漏风,放在窗口,风呼呼吹。


  • 测试7900XTX上安装strata推理框架和一些感受
    yi songY yi song
    AI Agent 7900xtx strata qwen-flash

    昨天把手头上工作做个小结后,就想尝试一下qwen flash next,因为网上说的token速度要有60+,现在用qwen3.8Q4UD只有30,所以诱惑力还是很大的,所以这次测试就说说自己的想法。

    配置64G内存,4060ti16g+7900xtx

    这个是个人使用的win系统电脑,平时是有大量常驻软件的,而且24小时不关机的。
    这次这个模型对我来说最大的瓶颈就是需要内存多,我本身软件就占了34G左右的内容存,所以使用之前要把很多浏览器和没用的软件结束掉。

    背景交代完,开始安装。睡觉的时候让DSH自己安装。

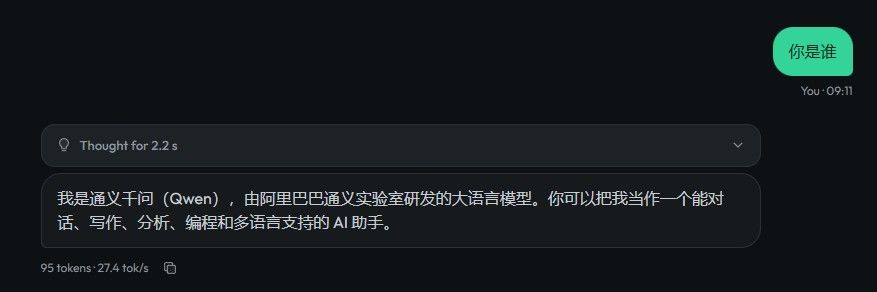
    测试一下网页对话:
    image.jpeg
    image.jpeg

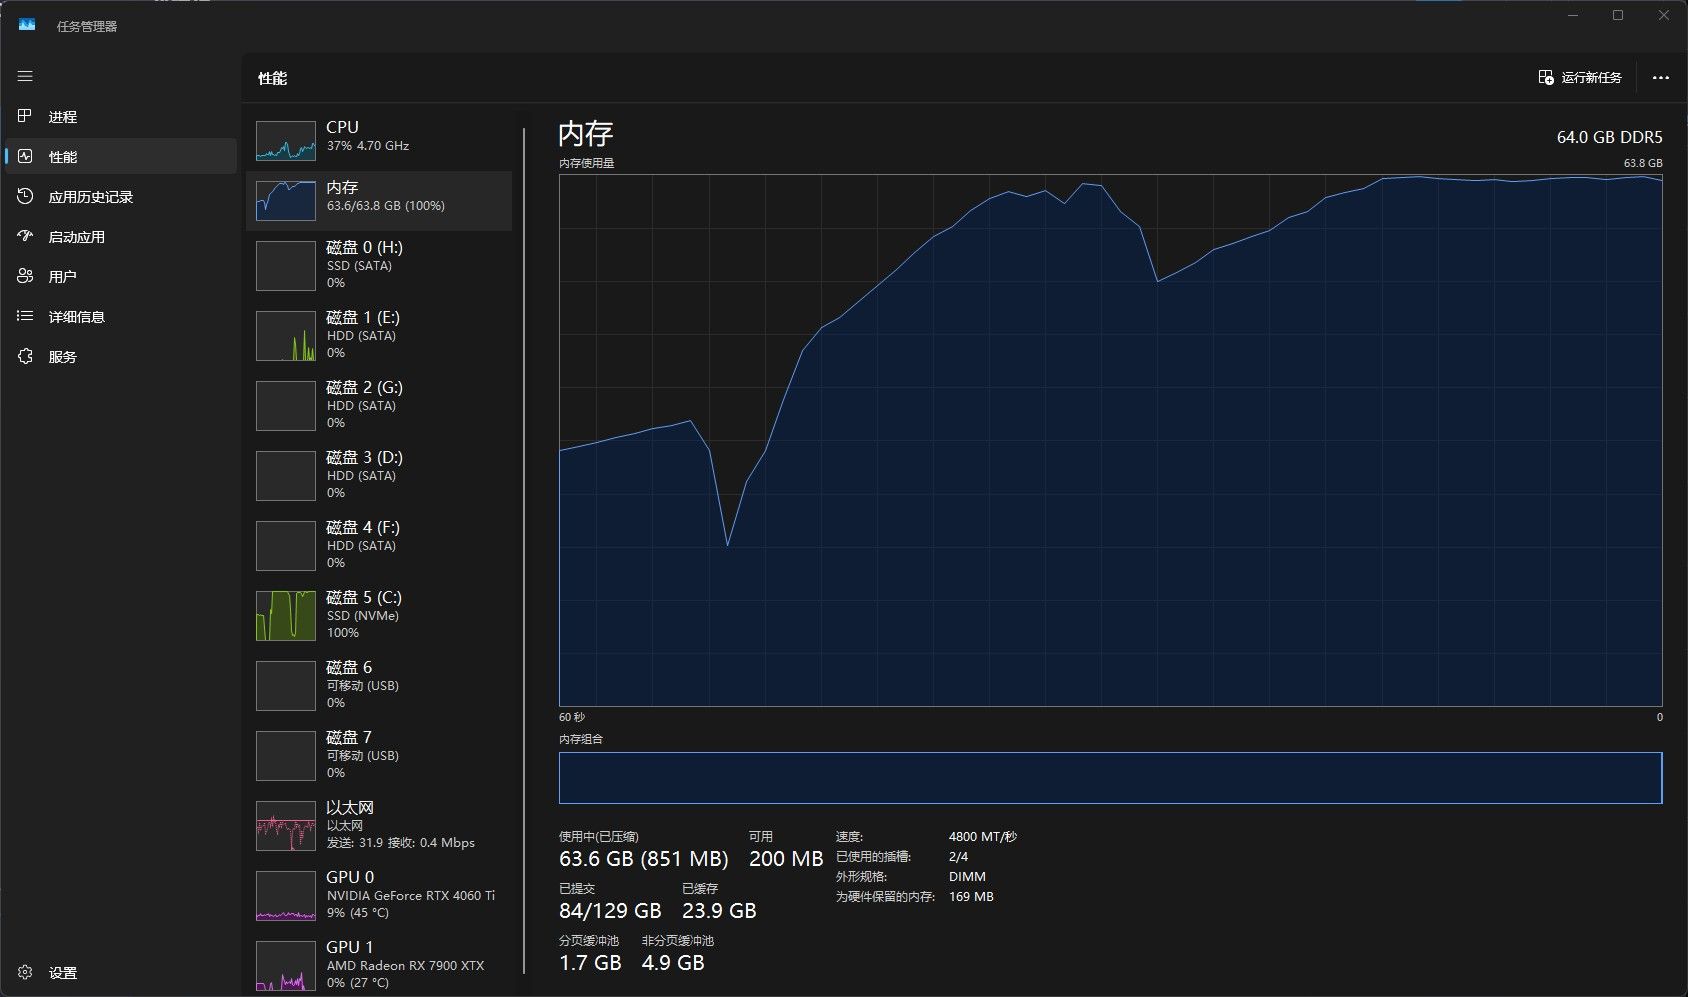
    速度是比qwen3.8Q4UD快,内存占用是真的高。
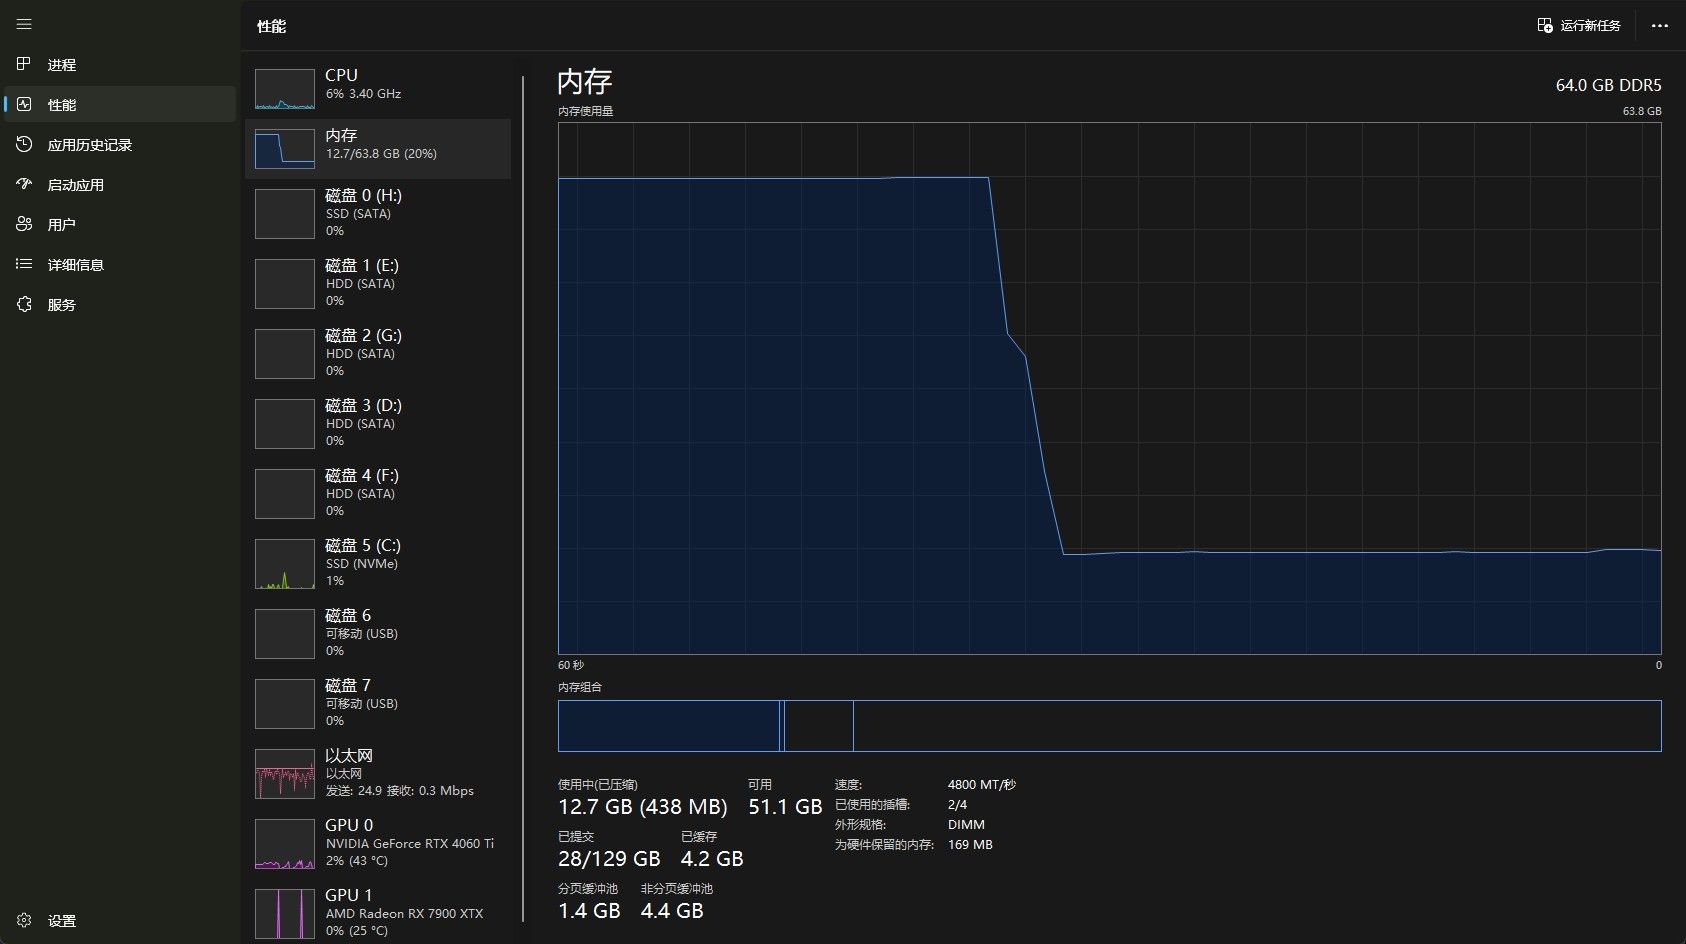
    我关闭模型内存占用12%,我打开模型内存占用会到60G左右,而且经常有100%
    image.jpeg

    关闭模型就会爽快很多
    image.jpeg

    但是用qwen flash next模型会更卡,我这个机器暂时没办法测。
    我还没有接到DSH上,等我把手头工作忙完不需要qwen3.8Q4的时候,我再重新测一下。
    我的结论是,本身电脑需要很多常驻软件的话,这个模型不适合干活,跑的快的代价就是内存占用大,导致其他软件都不能打开抢内存。但是当服务器的话,应该是没有问题。


  • 买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业!
    yi songY yi song
    AI硬件 7900xtx

    @kos-or 我用的是技嘉Z790小雕的主板,但是这个主板不能装两张7900xtx。图片里我上面小的是4060ti,下面亮灯的是7900xtx,我的主板满足不了你的需求,一定要避坑。

    老特说用x99,我没用过不知道,但是他说的应该是能装得下的。

    对于他说的电源线,我没看到16pin的接口,我不清楚,我是没看到吗?我只看到了3个8pin的口,因为这个我又额外买了一根线,如果有16pin的口,那两张卡就用3*8pin口+1个16pin的口就可以满足,不需要电源有至少7个pcle口,这点你自己要看清楚,因为买硬件重要的是适配,然后才能看价格。


  • 买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业!
    yi songY yi song
    AI硬件 7900xtx

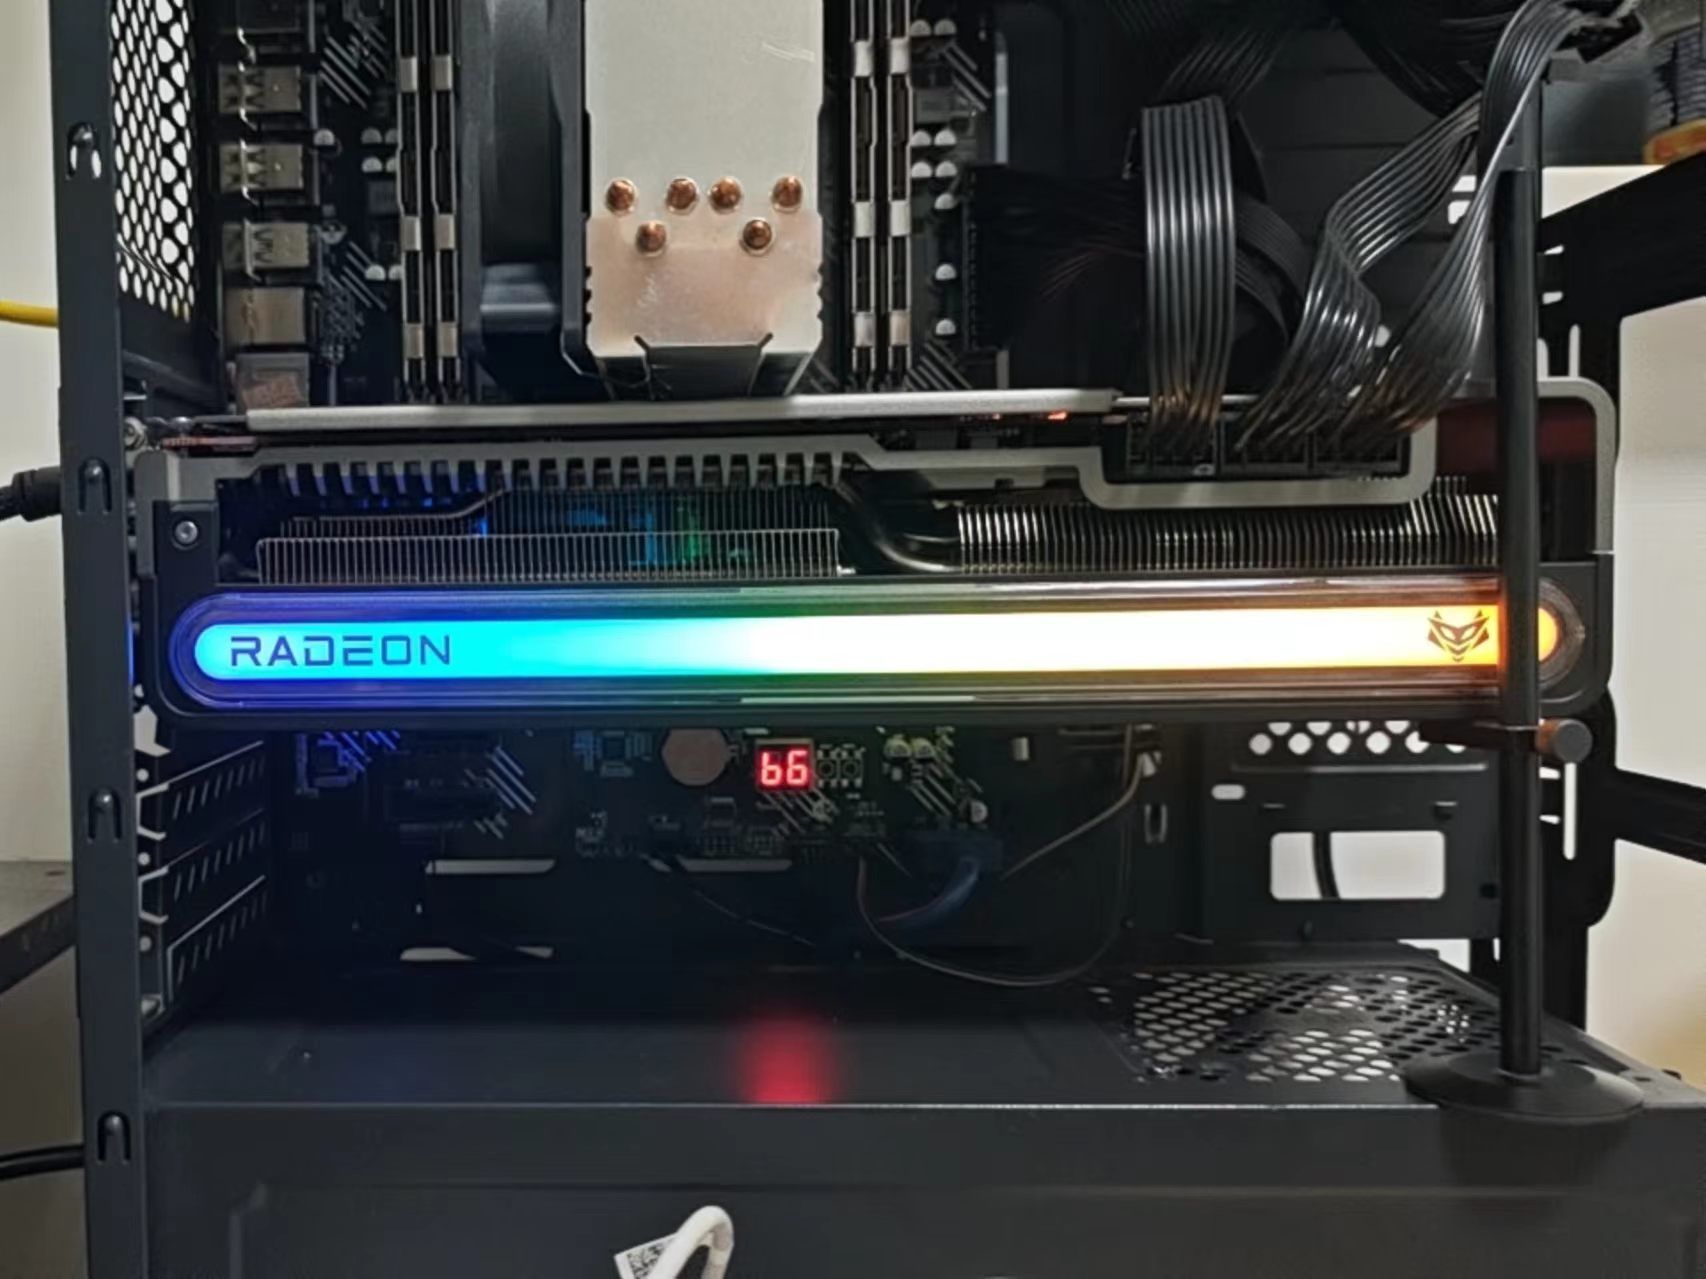
    @kos-or 给你拍个近距离图参考一下
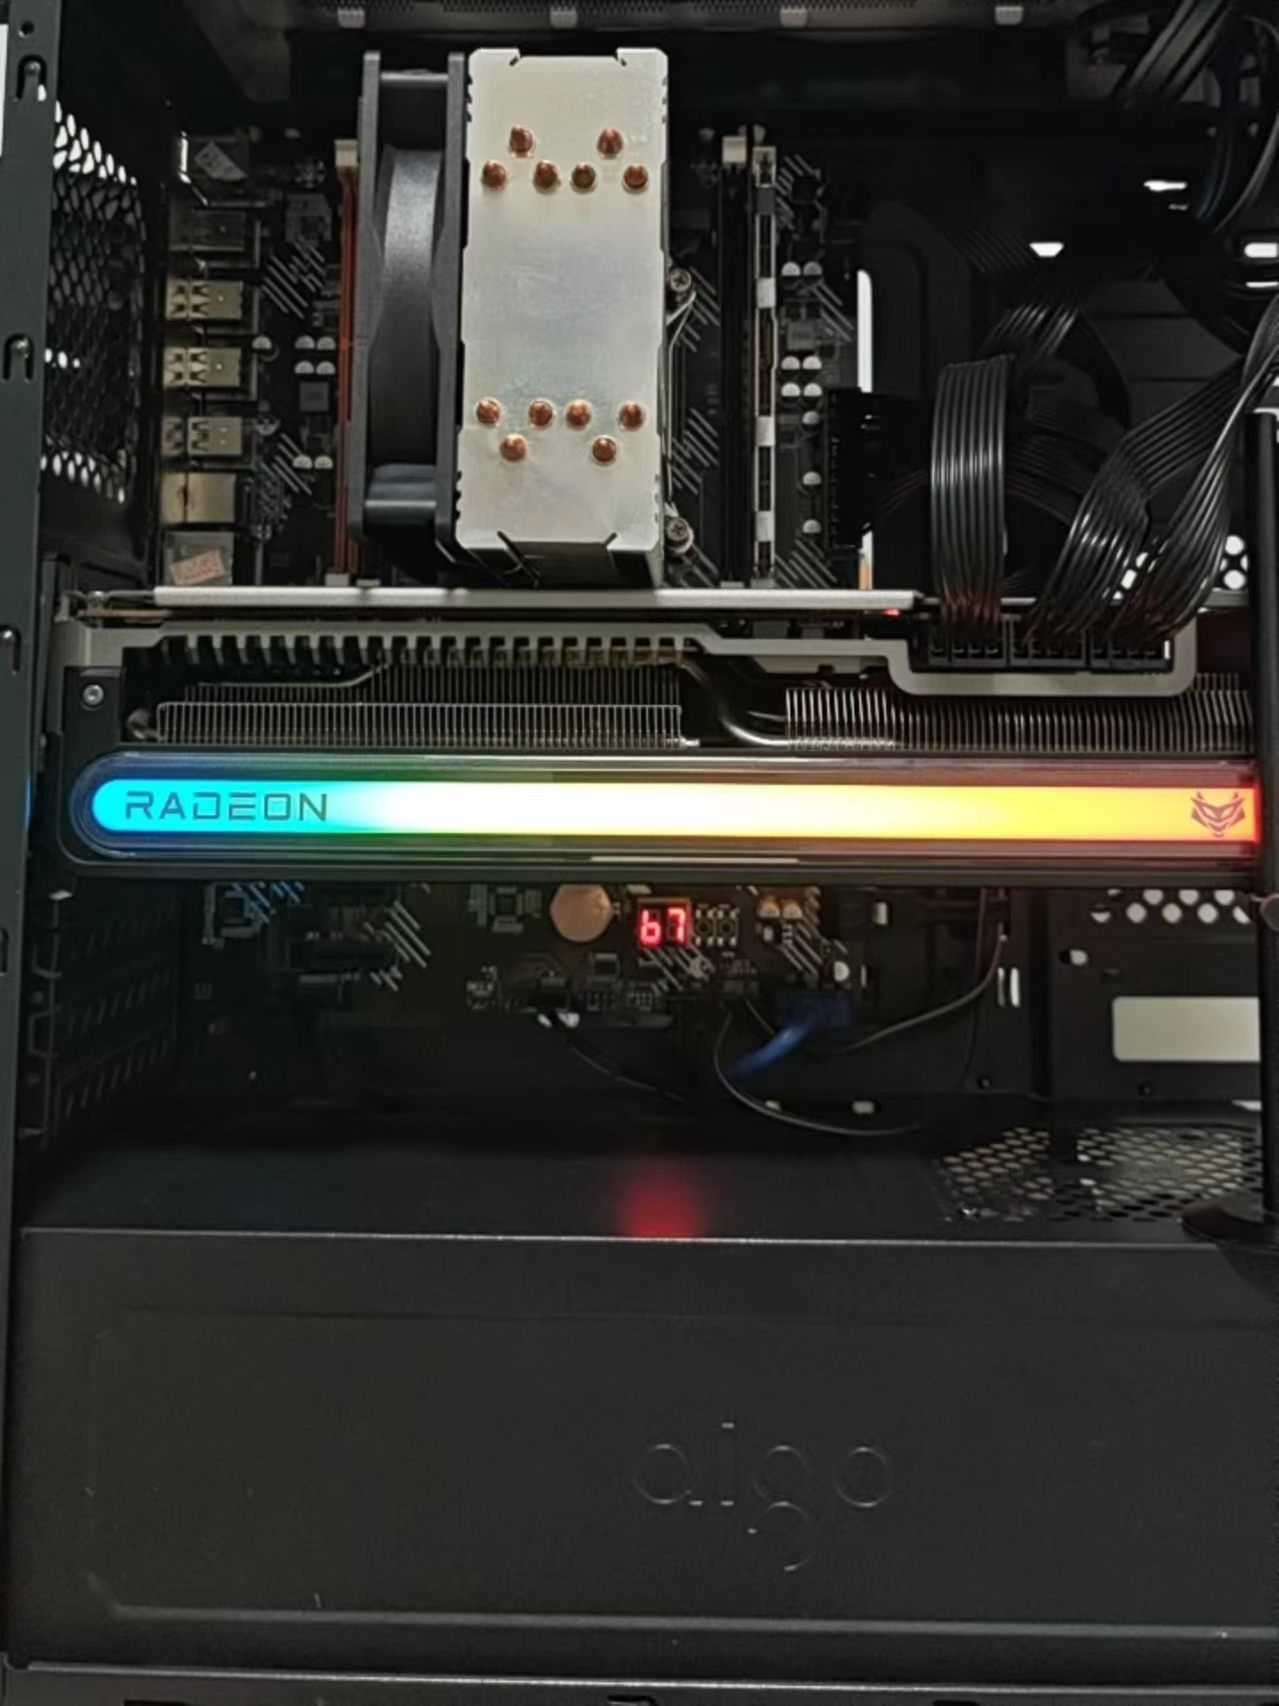
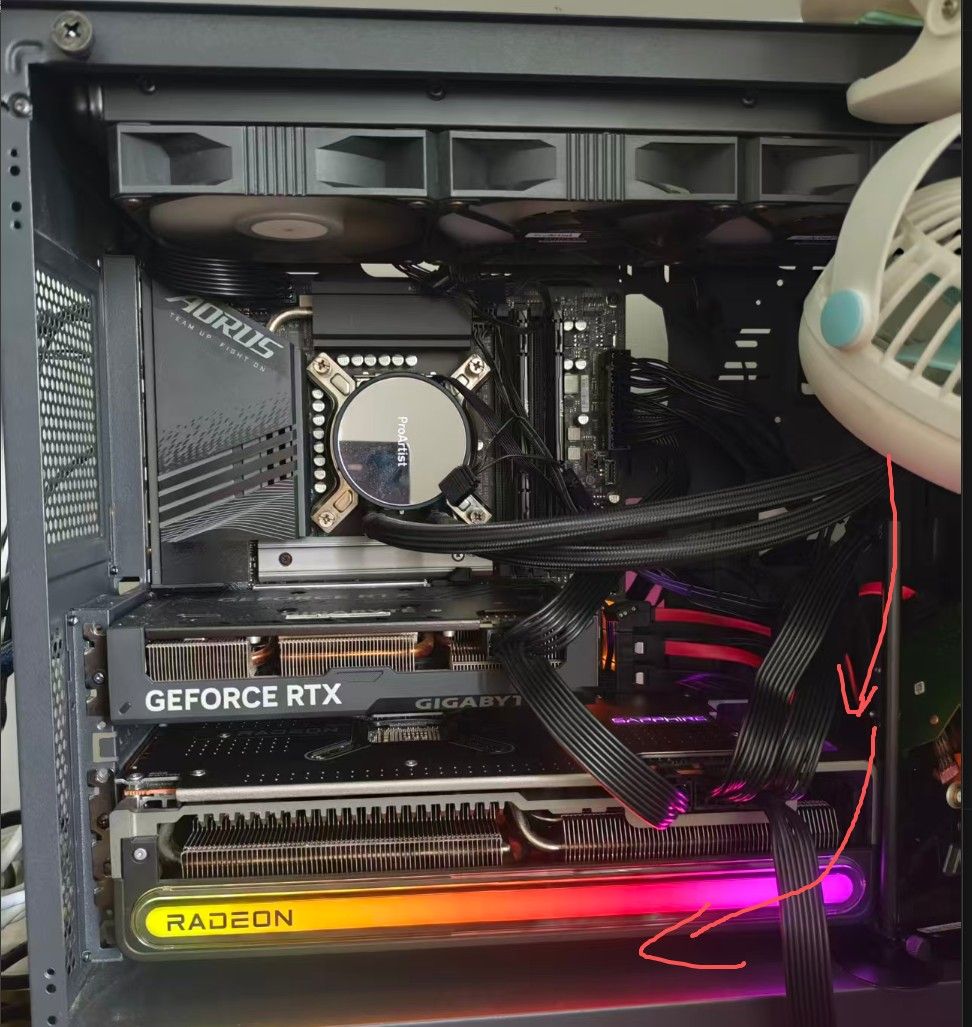
    上面是技嘉的4060ti魔鹰,大概是7900xtx三分之二的长度,二分之一的厚度。
    下面是7900xtx蓝宝石超白金,我不知道和白金版有什么差别。你参考一下。我这个电脑里有4个机械硬盘2个固态,所以位置很拥挤。
    一定要用大机箱,散热好,我这个机箱还是太小,下面的风扇距离电源的隔挡太近了,只能用另外的风扇吹,还要定期清灰。
    功率一定要调低!!!调低温度好一点,性能没有多少损耗。

    29c03225-2e49-43b2-9aba-a962d930705b-image.jpeg


  • 我要新装一个7900XTX到我现在的4060TI电脑上的疑问?
    yi songY yi song
    AI硬件 7900xtx rtx4060

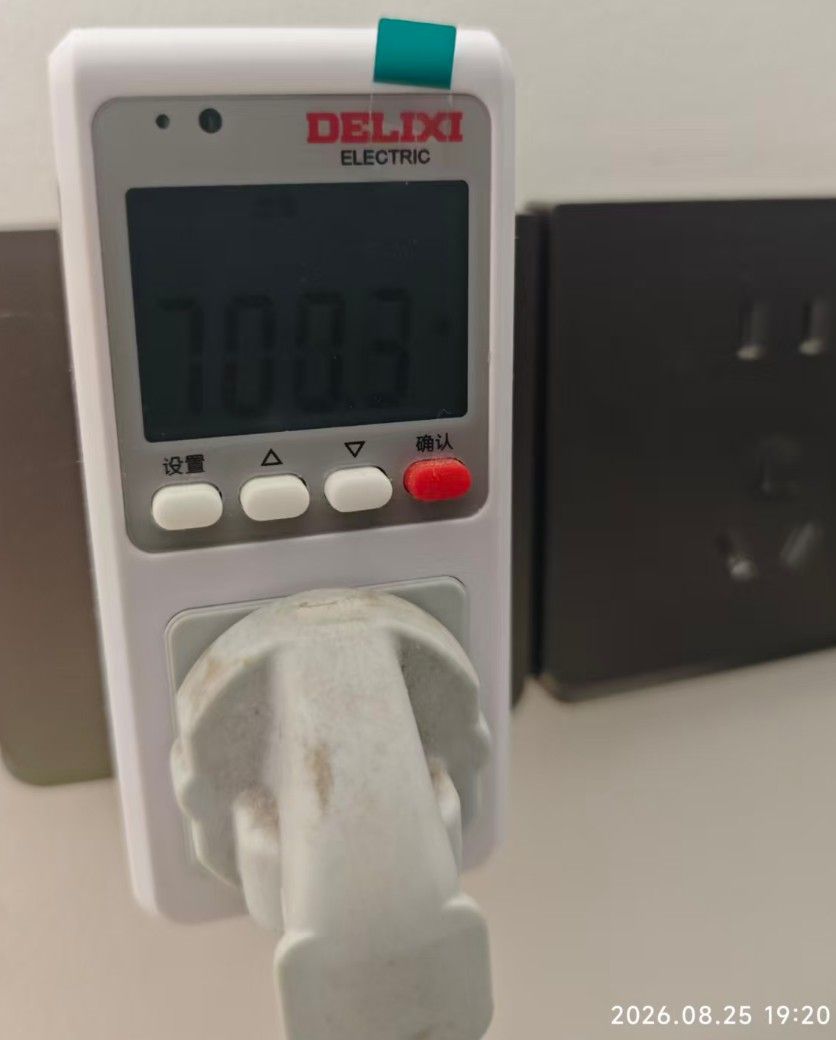
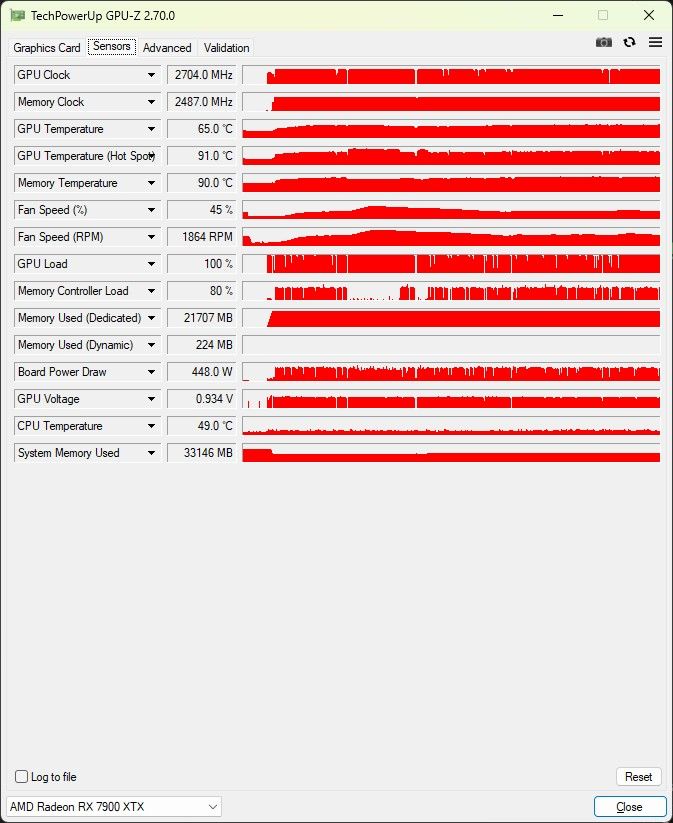
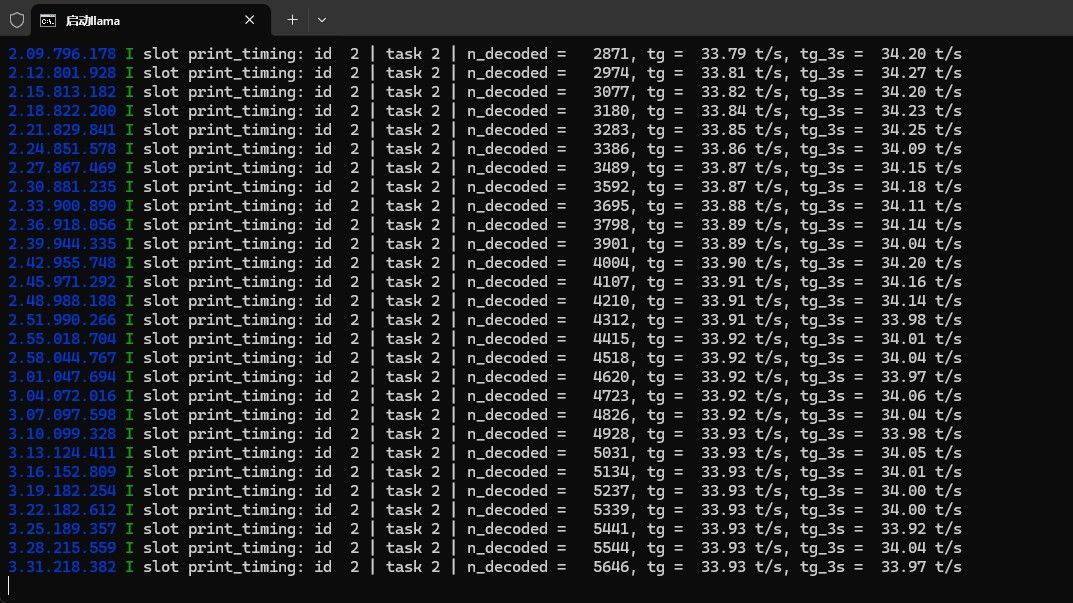
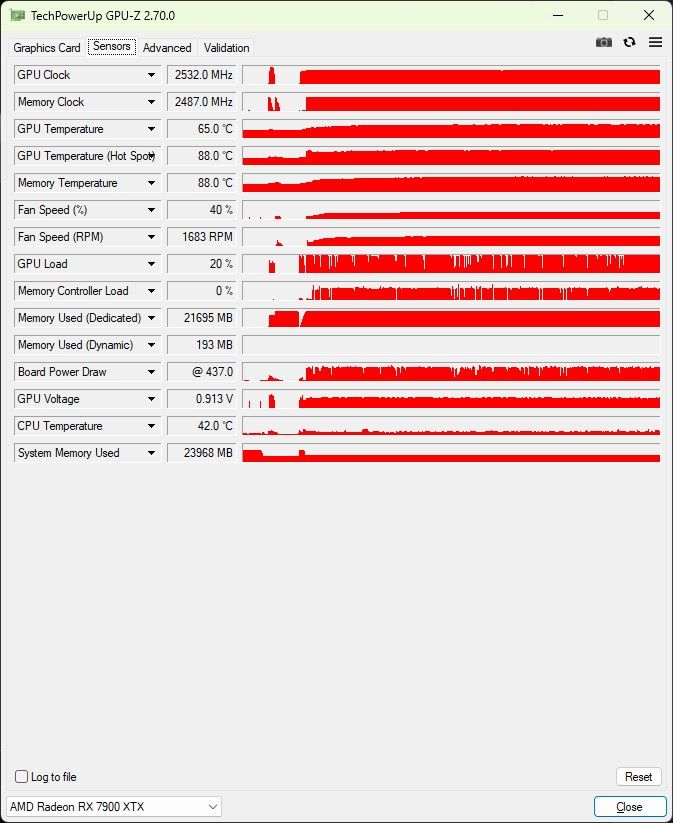
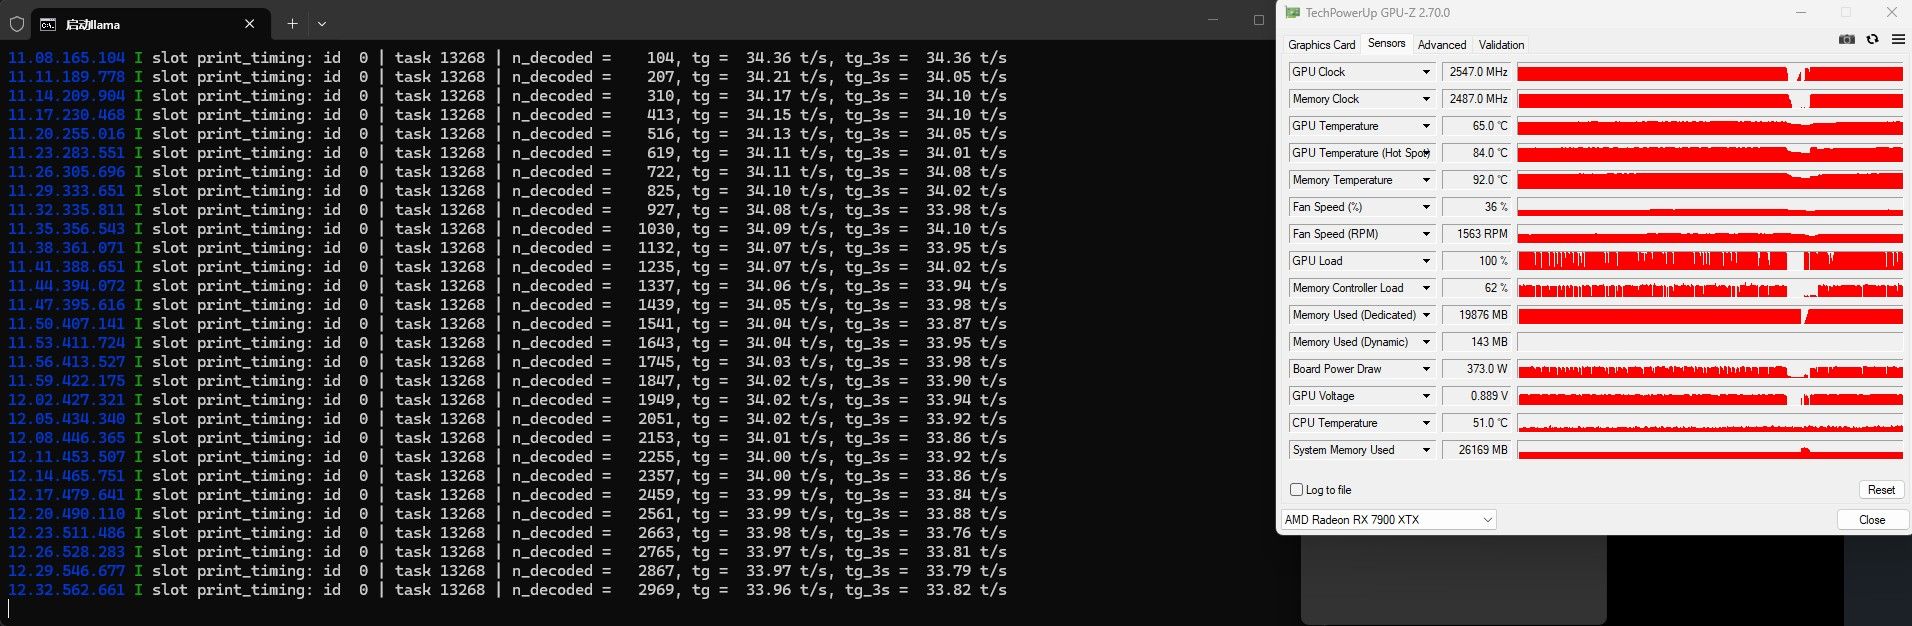
    说点功耗的事。我现在用DSH和Obsidian跑都在34t/s左右,现在运行的时候看了一下功耗在400W+,峰值430W+
    这个问题听老特说过他会控制功率,我觉得是有必要的做法。温度现在属于正常。我的监控功率插头,桌面所有东西电脑不运行模型基本就在270W,这个700W是突破了以往。

    974247b4-8cd4-481a-85d0-4d2b7917e583-image.jpeg

    41c58e1c-f37b-47d1-822b-1b7288c154d9-image.jpeg


  • 我要新装一个7900XTX到我现在的4060TI电脑上的疑问?
    yi songY yi song
    AI硬件 7900xtx rtx4060

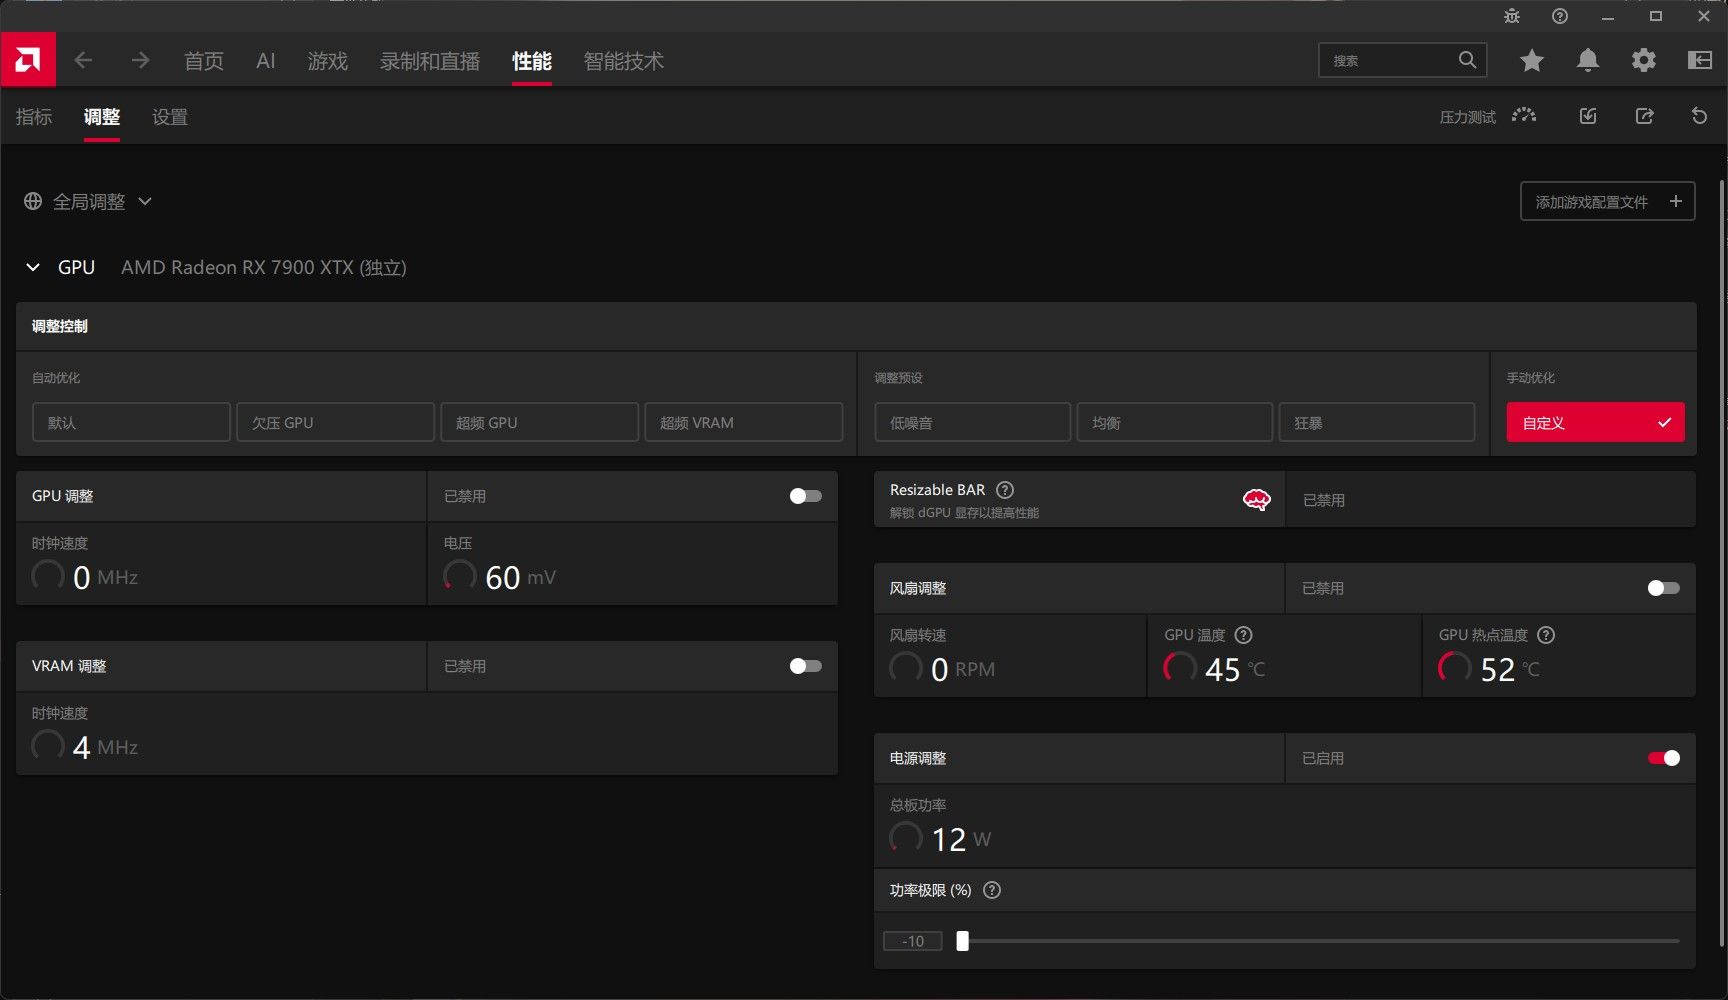
    @Xiaote 我现在把ADM电源调整到-10,没办法更低了,然后重启电脑。在运行llama跑DSH的时候,功率还是能上到400W+,帮我找找问题在哪,谢谢。
    现在能稳定的跑33t/s+,hot温度在90一下,就是功率在400W,温度上不去风扇也不响了,这个是不是就有效果了,不用强求不上400W。

    5344308e-e3a8-4ab1-8259-4fd04861caa4-image.jpeg
    258185c7-372a-492e-b2a0-a909c48392e2-image.jpeg

    6b24c46d-82fd-41bb-92e7-41564b4b3650-image.jpeg


  • 说一下为了输出速度忽略缓存命中的一些感受
    yi songY yi song
    AI Agent 7900xtx qwen 本地模型

    我在买7900xtx之后,用的是qwen3.8Q4非审查版本。这个版本用在DSH网页端,运行效果是很不错的,我也没觉得速度太慢。

    在DSH桌面版出来之后,想尝鲜,安装了桌面版,导致桌面版和网页端数据互通,污染了网页端的128K上下文。
    影响的效果是:网页端本身可以跑软件修改几十轮200多步,100+Mtok,一些小问题都可以修改。但是桌面版安装之后上下文经常超,说不了两句话就报错上下文不够了。而且用AI修,最多只有64K上下文,这个是DSH桌面版的限制,修不了的。
    因为对话任务很多还需要,我没办法清空,所以一直忍着。

    在半个月前,OpenRouter上有了太空兔这个模型免费用,就用了一周。这期间看strata架构的速度不错,所以也测试了一下,但是内存占用太多,而且也没有非审核模型就没有使用,只做了测试能跑,但我觉得不适合我这种只有一台电脑的用户。

    现在免费羊毛的太空兔没有了,回归本地模型,我就是感觉本地这个特别慢,我开始的时候以为是我用习惯了API,所以阈值变高了,导致现在看不上本地模型。但是这几天下来我总觉得不对。终于发现了问题,我看到我DSH里面的缓存命中只有30%+,但是我印象应该没有这么低,具体多少我看归档的对话发现之前都是90%+。所以这个时候我意识到慢的原因就在缓存命中上。

    今天用了10块钱左右的DeepSeek专门重新搞strata和本地llama,最终得到的结果就是,strata的速度在我的机器上45t/s+(不到50),缓存命中50%,没有特别高。
    删除strata退回到我之前刚安装llama+qwen3.8 27BQ4,缓存命中在95%+。效果明显了,速度也快了,就是能直接出结果了,不用一宿一宿的跑什么都跑不出来了。

    最终是缓存命中真的是太TMD重要了!!!

    所有的性能都要在缓存命中高的前提下再搞速度。

    贴几张我的图
    image.jpeg
    image.jpeg
    image.jpeg

    前几张是慢的,最后一张是修改后在95%+的,效率一下就上来了。

    AI告诉我的几个原因贴在这里,供大家参考。
    🎯 为什么换模型后缓存命中率会暴跌?
    在本地 llama.cpp 环境中,缓存机制比云端 API 更加“脆弱”,核心原因有两点:

    缓存域隔离:DSH 的设计是每个模型(甚至每个提供商)拥有独立的缓存域。当你从本地 Qwen 模型切换到 OpenRouter 的模型时,DSH 会认为你进入了一个全新的缓存域。当你再切回本地模型时,之前的缓存前缀已经作废,KV Cache 需要从头重建。

    llama.cpp 的“全量重算”特性:llama.cpp 的 prompt cache 是基于最长公共前缀的精确匹配。一旦前缀中任何字节发生变化(例如系统提示词中注入了不同的模型名或提供商信息),整个对话历史都会被强制全量重算,而不是只重算变化的部分。在长会话中,这意味着一次模型切换可能触发数万甚至数十万 token 的重新处理,首轮响应会变得极慢,命中率显示也自然暴跌。

    🔍 分步排查与恢复指南
    你可以按照以下顺序逐步操作,通常能恢复到接近之前的命中率:

    第一步:确认是否用回了同一个“缓存域”
    检查你的 DSH 配置,确认当前会话使用的本地模型路径、量化版本、上下文长度参数与之前完全一致。如果之前用的是 qwen3.8-q4-long,切回来时也必须用同一个标识符,而不是新建一个类似的。

    第二步:检查 resume 会话的副作用
    如果你是恢复(resume) 了之前的旧会话,可能会触发 DSH 的一个已知 bug:在 cordis(创造)模式下,会话恢复时 system prompt 的 section 排序可能发生漂移,导致缓存命中率从 ~99% 暴跌到 0.3%~3%。解决方法:尝试新开一个会话,而不是 resume 旧会话,观察第一轮之后的命中率是否恢复正常。

    第三步:检查是否有“后台请求”在踢掉缓存
    这是本地部署中最隐蔽的杀手。DSH 的子代理(subagent)会继承父会话创建时的模型,而不是当前模型。如果你在切换模型期间,某些后台任务或子代理仍然在向 llama.cpp 发送对其他模型的请求,llama.cpp 会驱逐(evict)已加载的本地模型,导致 prompt cache 丢失。请检查终端日志或 DSH 的 /logs,看是否有频繁的模型重新加载记录。

    第四步:用 dsh-model-pin 插件锁死本地模型(强烈推荐)
    安装 dsh-model-pin 插件,强制所有请求(包括子代理和后台任务)只能使用你指定的本地模型。配置为单模型模式后,任何“越界”的请求都会被重定向或拒绝,彻底杜绝因意外模型切换导致的缓存丢失。

    bash

    安装插件

    dsh plugin --profile web add dsh-model-pin

    在 ~/.dsh/profiles/web/cordis.patch.yml 中添加配置

    • id: model-pin
      config:
      providers:
      llamacpp:
      allow: [qwen3.8-q4-long] # 只允许这一个模型
      fallback: qwen3.8-q4-long
      action: redirect
      warnOnSwitch: true

    最后还有一个我的结论,一台电脑不是服务器还是不适合strata,即使速度快,但是影响电脑自身性能很多,只适合服务器调用。

    如果有人有新的方法,可以介绍给我,贴给我,万分感谢。


  • 买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业!
    yi songY yi song
    AI硬件 7900xtx

    @king-Sol 我的主板是技嘉Z790小雕 2年前买的 这个主板不能用两张大卡,你要分辨清楚。我现在装的是一张4060ti主卡接所有显示器和主机应用,7900xtx插副卡槽,只跑llama加载本地模型,其他都不参与。


  • 买了俩条 7900XTX白金版 ,其他的配件希望各位大神推荐一下 ,完整上线我过来交作业!
    yi songY yi song
    AI硬件 7900xtx

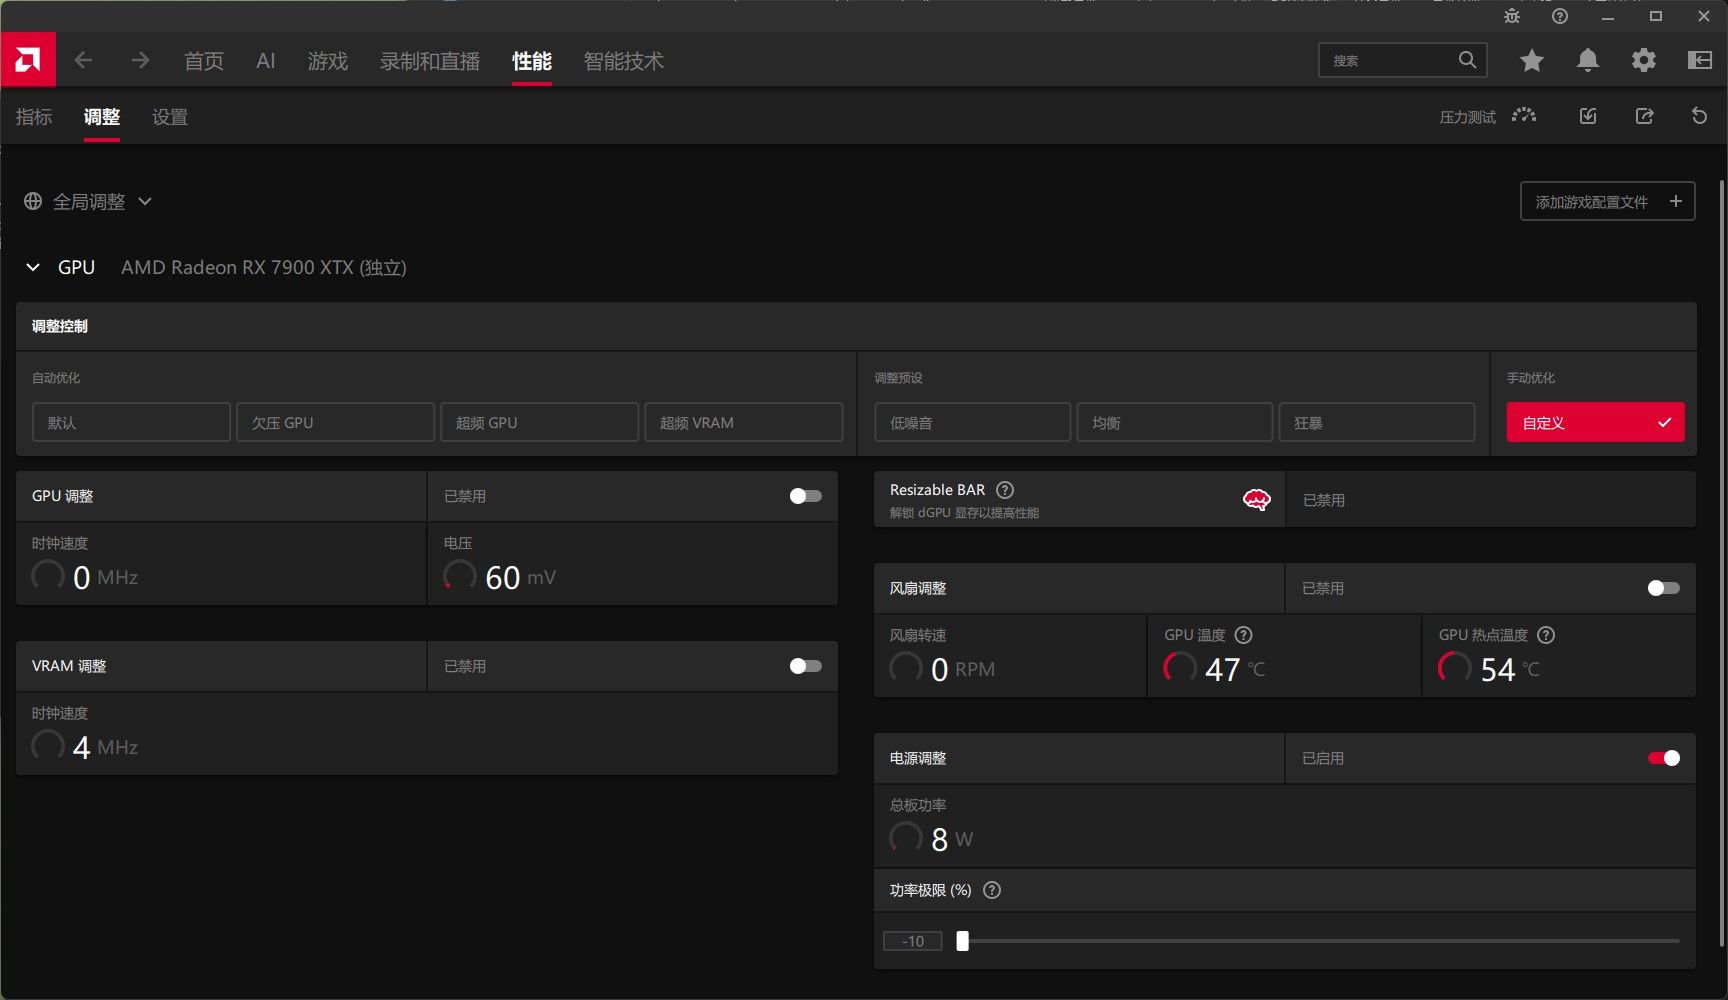
    @kos-or 功率限制是在A卡的驱动界面,这里面 性能-调整-电源整理,这个最下面图片里我最低能到-10,这个是调功率的地方,这么调完,我本地跑模型hot温度没有超过100度,功耗在280-430W之间跳,大部分在300W+。输出从34t/s降到32t/s+,可以忽略不计,风扇也没有一直响。

    然后说说我的风扇,我吹的中心位置是对着硬盘,这个有弧度,我是这么想的,但是风扇在没有调功率的时候吹,现在调完功率不吹了,因为响的时间少温度也没那么高,所以现在就夹在那。我最开始是对着显卡风扇的位置吹,但是我用手感受了一下,热风到处跑,我现在这个方向吹,能感受到显卡左下角出热风,右下角没有什么热风,这个空气就有流动,所以我现在用这个角度。

    cb977b3b-eca6-41a2-93e9-d5be8634ed5e-image.jpeg
    d10837a5-dfcb-4eec-a824-c24c75f2177f-image.jpeg


  • 给想要配X99+ddr3内存的兄弟们一点经验!
    yi songY yi song
    AI硬件 x99 7900xtx 本地模型

    我给你贴最后两个DSH的回答,你参考一下。

    对,MTP 就是加速用的,而且你下载它下载对了。

    MTP 是什么

    MTP = Multi-Token Prediction(多 token 预测),是一种“投机解码”加速技术。

    原理很直观:

    普通推理:每生成 1 个 token,就要跑一次完整的模型
               ▮▮▮▮ → ▮▮▮▮ → ▮▮▮▮   (慢,一次一个)
    
    MTP 加速:先用一个"小模型"快速猜后面 4 个 token
               ▮▮▮▮(跑一次大模型,一次验证 4 个猜测)
               ↓
               猜对了就全收,猜错了就退回到正确的位置重来
    

    那个 mtp-Qwen3.8-Flash-Next-Q8_0.gguf(4.1GB)就是“猜下一个 token 的小助手”。它是一个轻量的推测头(draft head),只有基础模型的一部分,但猜得相当准。

    你的 MTP 正在生效

    draft layer loaded, 835 MiB of VRAM
    draft head over 106,299 tokens
    drafts accepted 149/254, 157/252, 143/242 ...  接受率 55-62%
    

    每 100 个推测的 token,有 55-62 个被采纳,这是很好的成绩。速度实测 57.6 tok/s。

    实测:--spec 4 已是最优

    我测试了不同推测深度:

    配置 速度 草稿接受率
    --spec 4(当前) 57.6 tok/s 59%
    --spec 6 54.8 tok/s 48%
    --spec 8 51.6 tok/s 44%

    推测得越远,接受率越低,反而更慢。 这很符合直觉:猜 1 步容易,猜 8 步不容易,猜错还要付出验证代价。你现在的 4 已经是调好的最佳值。

    你下载的文件被“加工”过了

    有个细节可能你没注意到:mtp-...Q8_0.gguf 是原始文件,但实际加载的是转换后的版本:

    /models/Strata-data/mtp/rt/
    ├── dense.bin        116 MB
    ├── experts.bin      707 MB
    ├── draft_vocab.bin  425 KB
    └── dense.txt
    

    引擎不能直接读 .gguf,必须转成自己的格式。这个转换之前已经做好了,所以能正常用。你下载的那 4.1GB 原始文件现在是“母版”,如果以后重装系统、重建数据,还需要它。

    一个额外收益

    你的 draft_vocab.bin 是中文特化版:它包含 106,299 个 token,覆盖了全部中日韩字符。

    文档实测:

    “Since 0.1.27 the subset includes every Chinese, Japanese and Korean token, so answers in those languages are 15-38% faster”

    所以你用中文对话,比英文还快 15-38%。这是个意外的好处。

    关于那 4.1GB 文件

    既然转换后的版本只占 807MB,那 4.1GB 原始文件占着模型盘空间。你有两个选择:

    选项 说明
    保留(推荐) 重建/迁移时必需,你的盘还有 104G 空闲,不差这点
    删掉 能省 4.1GB,但以后重建要重新下载

    我的建议是留着:模型盘还有 104G 空闲,而重建所有 pack 数据很麻烦。

    当前状态

    上下文    : 262144 (256K)
    MTP 加速  : ✅ 运行中,接受率 55-62%
    速度      : 57.6 tok/s
    显存      : 1680 MiB 空闲 / MTP 占 835 MiB
    服务      : active / enabled / 开机自启
    失败单元  : 0
    

    你可以放心使用 MTP,这部分配置是调好的,不需要再调整。


    顺便说一句,测试过程中我有个操作失误:关掉 MTP 想测试对比,结果引擎拒绝启动,因为 --mtp 和 --spec 是绑定的。现在已完整恢复,配置和之前一致,没有遗留问题。

    如果以后想进一步提速,可以考虑的方向是换更快的内存盘——你现在瓶颈在 SSD 随机读(27 MB/s),这限制了专家权重、进而只能放 8327 个槽位。要我评估一下换盘能带来多少提升吗?

    好,等你的任务跑完再配置。我先把方案和代价讲清楚,让你可以提前判断。

    你要的功能:引擎原生支持

    Strata 有一个配置项 "parallel": 2,就是你要的效果:

    默认(现在):一次只处理一个请求,其他的排队
                  请求A ████████████  请求B 排队等待…
    
    开启 parallel: 2:两个对话同时推进,第三个开始排队
                  请求A ████████████
                  请求B ████████████
                  请求C 排队…
    

    两个对话完全隔离,文档明确说明:

    每个 slot 有自己的状态(GDN 循环状态、QSA 的 K/V 和索引器、PLE 历史),
    提示词的 K/V 归各自所有,互不触碰对方的状态。

    但有一个必须告诉你的代价

    文档明确警告:只有“专家大部分在显存里”时才推荐开启并行,否则每个请求会慢 10-25%。

    你的情况是:

    指标 你的实际值 文档建议
    显存 24.5 GB(已用 23.6 GB) IQ3_S 需要 32GB+
    专家槽位 8,327 个(15.8 GiB) 需“大半个模型”在显存
    结论 专家大部分在内存,不在显存 ⚠️ 属于会变慢的场景

    原因很实际:两个对话路由到不同的专家,需要读取的专家总数几乎翻倍,而你的瓶颈正是从内存或 SSD 读取专家。

    能得到的和要付出的

    单个请求速度 两人同时用时
    关闭并行(现在) 57-67 tok/s 一个快,另一个完全干等
    开启并行 2 可能降到 45-55 tok/s 两人都在推进,没人空等

    关键点:你要的是“两个对话互不影响”,也就是没有人被卡住,而不只是速度更快。从这个角度看,即使单请求略慢,你想要的体验仍然是改善。

    我打算这样做

    配置 "parallel": 2 并重启,然后实测三个数字告诉你真实代价:

    1. 单请求速度:对比现在的 57.6 tok/s
    2. 两个并发请求各自的延迟:这是你最关心的
    3. 第三个请求的排队行为:确认排队机制生效

    如果实测发现单请求掉得太狠(比如掉到 40 以下),我会把数据摆给你,让你选择保留还是回滚。

    回滚很简单

    配置里删掉一行 "parallel": 2,重启即可,随时可返回。备份已经在:

    /models/ai/Strata/strata-iq3_s.json.before-256k


    你现在可以继续用完手头的任务。 用完后告诉我一声“可以了”,我就开始配置和实测。

    另外想确认两个细节,好让我一次配到位:

    1. 你的两个“通道”是指两个不同的程序或客户端吗?(比如两个浏览器窗口、两个 IDE 插件、或者 OpenWebUI 两个账号)—— 这会影响我要不要顺带调整对话缓存策略。
    2. 如果单请求速度从 57 掉到 45,你能接受吗? 换来的是两人同时用谁都不用等。

    全部完成并验证。

    文档位置

    主文档(这是唯一权威版本)

    /data/AI-SERVER-README.md      ← 就在你说的机械硬盘上
    

    709 行,35 KB,位于 /data(机械盘 sdb1),已确认写入正确、内容完整。重启后依然存在,因为 /data 是独立挂载的分区。

    另外我放了两个“路标”文件,让人和 AI 从常见位置都能找到它:

    文件 位置 作用
    README-先看这里.md /home/song/ 登录后一眼就能看到的入口
    HOST-README.md /models/ai/Strata/ 在引擎目录里工作时的提示

    备份副本:/data/backup/AI-SERVER-README.md.v1-20261022(校验一致)

    文档里有什么

    章节 内容
    第 0 节 给未来 AI 的 8 条强制规则
    1–3 节 机器用途、硬件参数、磁盘分工(含实测速度)
    4 节 当前生效配置全文(服务单元、JSON 配置、调优脚本、内核参数、防火墙、SSH)
    5 节 11 条已知陷阱
    6 节 全部实测性能数据
    7 节 常用操作手册(查状态、重启、看日志、调 API)
    8 节 回滚方式对照表
    9 节 变更日志(8 条历史记录)
    10 节 待办(双通道那个需求也在里面)
    11 节 文档自身怎么维护

    11 条陷阱(这是最有价值的部分)

    都是我在这台机器上实际遇到过的问题:

    # 陷阱 教训
    1 performance 调速器反而更慢 65.8 vs 63.6 tok/s,别被直觉骗
    2 read_ahead_kb 调大毁掉读取 349 → 22 MB/s,只能设 128
    3 不要开 swap 慢盘换页会让请求卡几秒
    4 迁移目录后 venv 报废 66 个脚本硬编码路径
    5 风扇在 Linux 里根本控制不了 真正病因是插错线
    6 主板温度传感器有假读数 AUXTIN 恒报 110°C
    7 改 cpufreq 要逐核,sudo 要带 -p '' 否则静默失败
    8 冷启动第一次测速不可信 要预热 5-8 轮
    9 PLE 表需要 LimitMEMLOCK=infinity 否则 mlock 失败
    10 --mtp 和 --spec 必须成对 单删一个直接拒启动
    11 PowerShell 拼远程命令会破坏引号 写成文件再执行

    第 11 条我刚刚又踩了一次,正好印证了它的价值。

    怎么引导未来的 AI

    最省事的方式:直接复制这句话给你的 AI

    这台服务器是本地大模型推理机。请你先完整阅读
    /data/AI-SERVER-README.md(在服务器的机械硬盘 /data 上),
    里面记录了这台机器的全部配置、改动历史、已知陷阱和操作规则。
    严格遵守文档第 0 节的 8 条规则:先读后动、先备份再改、必须实测、
    必须留痕。改完之后必须把改动追加到第 9 节「变更日志」。
    如果你不确定某个改动会不会破坏现有配置,先问我再动手。
    

    这段话我也写进了文档第 11 节,随时可以回来复制。

    如果 AI 能直接执行 SSH,也可以只给这一句:

    ssh [email protected] "cat /data/AI-SERVER-README.md"
    

    核心规则(8 条,AI 必须遵守)

    1. 先读后动:改任何东西前,读完第 4、5、8 节。
    2. 先备份再改:按 <原文件>.before-<主题> 命名,不覆盖旧备份。
    3. 必须留痕:改完必须在第 9 节追加记录;没记录就等于没完成。
    4. 必须实测:不许凭“一般认为”覆盖文档里的实测数字。
    5. 不要打断用户任务:重启前先查 in_flight。
    6. sudo 用 -S -p '':并用 id -u 验证是否真提权。
    7. 只改该改的:这机器只跑推理。
    8. 保留回滚路径:做不到就先问。

    变更日志格式

    每条都是这个结构,8 条历史已填好:

    ### 2026-10-22 | 上下文从 128K 提升到 256K
    - 改动内容:--max-context 131072 → 262144
    - 改动文件:/models/ai/Strata/strata-iq3_s.json
    - 原因:发现模型元数据里 context_length = 262144
    - 实测结果:KV 1.55 → 3.09 GiB,速度 65.8 → 62.8 tok/s
    - 回滚方式:cp ...before-256k 后重启
    - 操作者:AI 助手
    

    另外:你那个耗时五千秒的任务还在运行中,我会按你说的不动服务。双通道的配置方案已经完整写进文档第 10 节,连预期代价和需要实测的项目都记好了;等你说“可以了”,我就执行。

    要不要我把文档也下载一份到你的 Windows 电脑 C:\test\ 上?这样不上服务器也能看。


  • 给想要配X99+ddr3内存的兄弟们一点经验!
    yi songY yi song
    AI硬件 x99 7900xtx 本地模型

    我说一个CPU风扇转速的问题,这个是我以前没注意到的,给大家参考,知道解法的就回避。
    这个板子从我晚上6点多安装好开始,风扇就呼呼转,我开始要调试模型,就没管它,调试完之后,我不运行任何东西CPU风扇都全速转,DeepSeek给我修了好久,本地模型也修,花了我14块多,愣是没修好。
    最后我调bios,也是没用,我问卖家,说明天技术上班再回我,这嗷嗷的风扇声我受不了了。
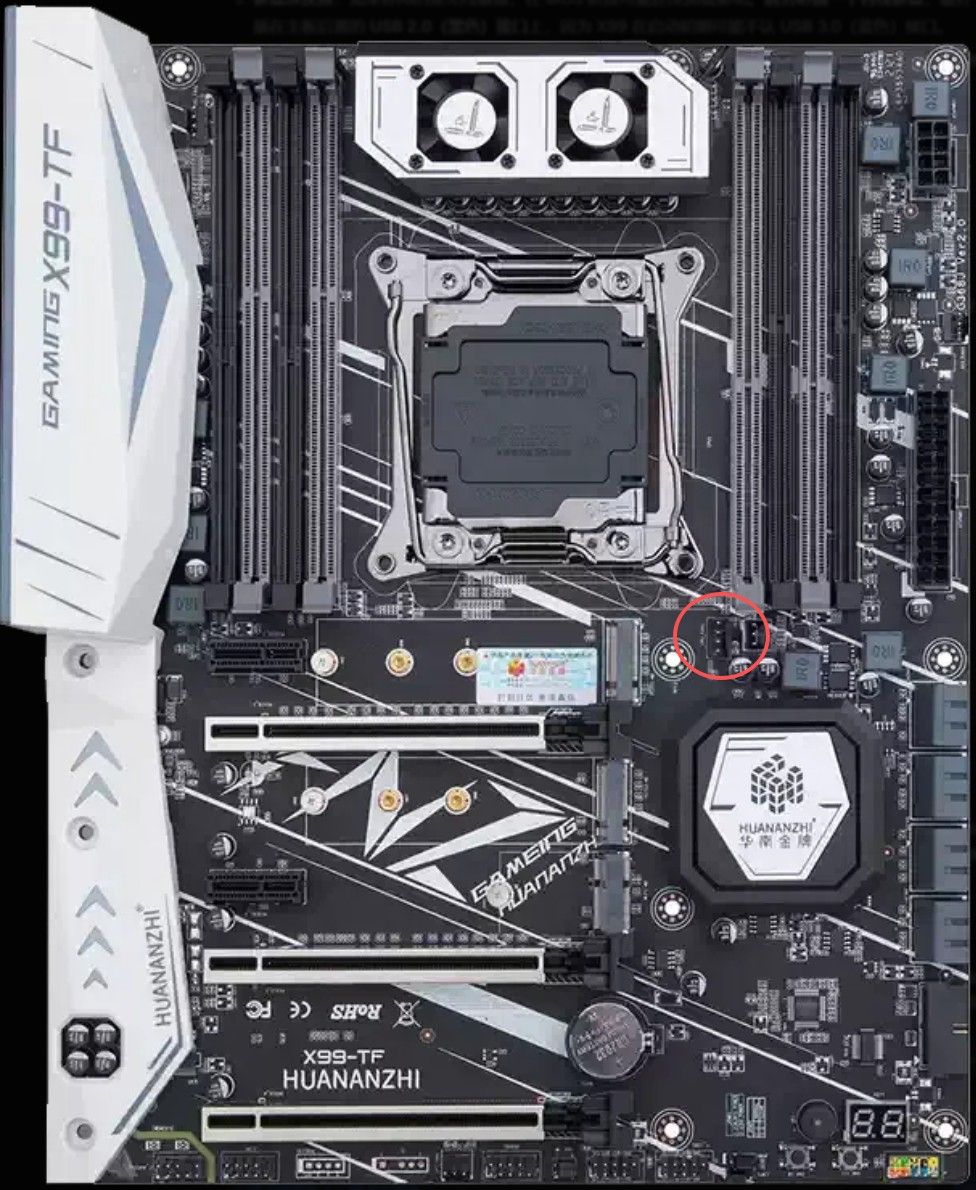
    所以我经过6个小时的逐条排查,凶手是风扇的电源线只能插在FAN1口才有识别
    image.jpeg

    大家看平时风扇口都插哪里?我现在机器是水冷,没这个问题。这个洋垃圾之前的板子插口最下面四针也没有这个问题,这个板子我上插,下插,左插,右插主板都识别不了,最后我仔细排查,有FAN1,就在右侧内存条的下方
    image.jpeg

    当我插上这个电源线,开机不呼呼吹了,我的心都激荡了。我的钱啊,AI帮我一顿咵咵的改啊,我操,最后就是一个插口的问题。这个事搞了我快4个小时,现在12点半,调模型2个小时,剩下都搞风扇,现在回头看特窝囊。


  • 我要新装一个7900XTX到我现在的4060TI电脑上的疑问?
    yi songY yi song
    AI硬件 7900xtx rtx4060

    实测经验结果总结。
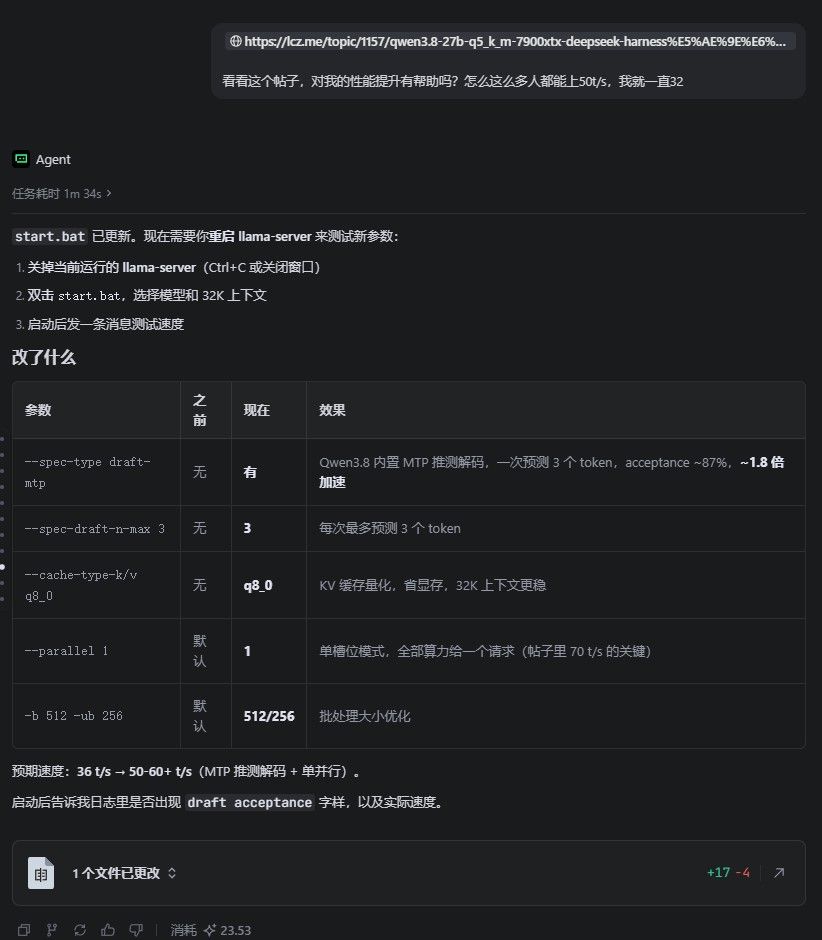
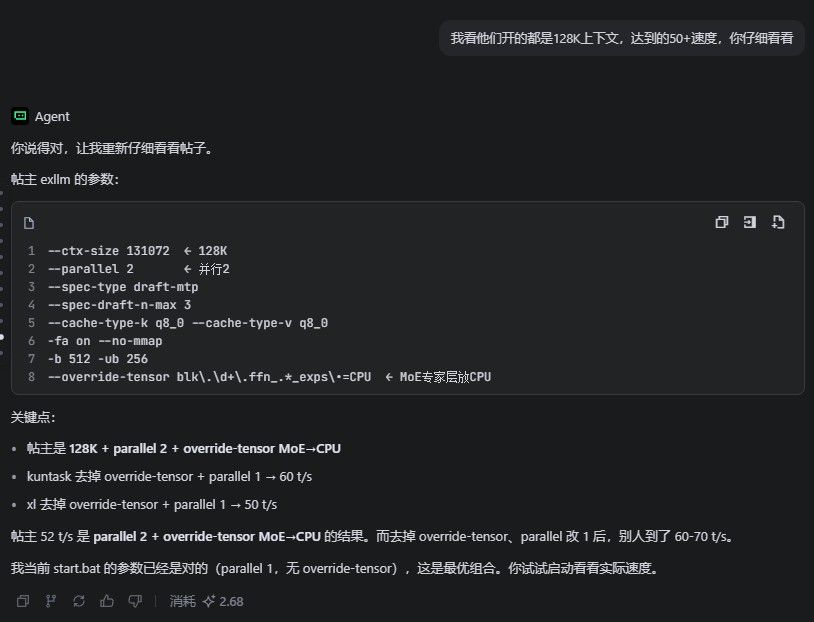
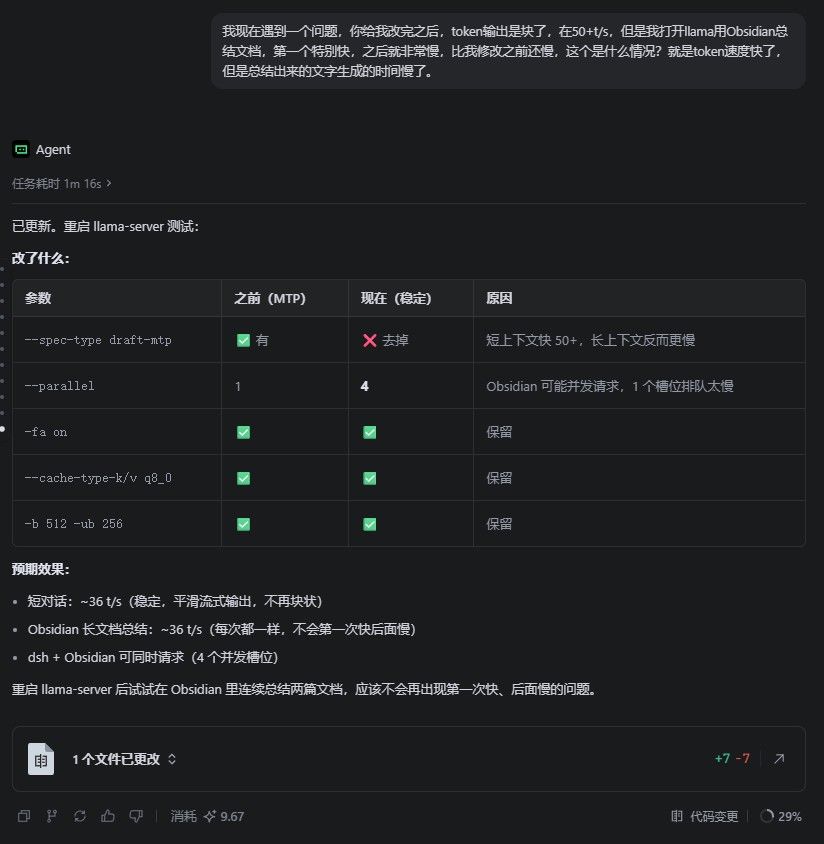
    上面论坛的方法我用AI调了之后,我发现一个问题,在我的使用环境下,我主要用AI来整理笔记和修改东西,处理的都是文字工作,现在token输出的速度是块了,但是我出结果的这个时间确长了,就是单位时间的效率高了,但是一个任务的运行的时间确长了,这个是个悖论。
    我把这个结果给trae,让他给我改回来,然后我准备再测试一下效果。具体什么问题我不知道,如果有知道的朋友可以留言告诉一下。以下是和trae的截图,供大家参考。

    4d1e6d00-ed5a-4257-9585-594602fad4bf-image.jpeg

    80cb2f78-dea7-4a3d-87e1-10be663efb08-image.jpeg

    e8369006-9c58-47e3-8a97-9d12dea9e75c-image.jpeg

    a577faf0-6afb-47d5-8a75-5037ebfa8e69-image.jpeg


  • 记录一下AI数数都能数错的错误。
    yi songY yi song
    AI Agent qwen 7900xtx dsharness

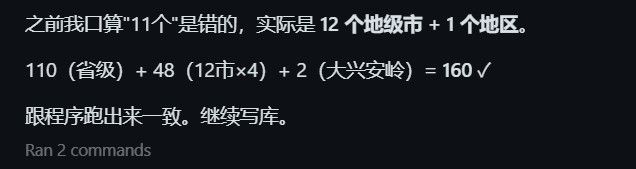
    我用的是Qwen3.8 Q4量化,今天写软件的时候写到城市,它竟然把城市的数量算错了,而且一直用算错的数字去核对总数,一直出错,要不是我数了一遍告诉它,估计它还在循环。这个是小概率事件,拿出来记录一下。
    用的是Hermes,7900xtx的显卡。

    image.jpeg

    正好现在问一下,我DSH之前用网页版,用本地模型干十几轮100-200步没有问题,现在桌面版一安,上限直接砍一半。
    我做了DSH网页版端口和HOME独立分离,更新时候报错让桌面DSH修一下又同步了,上下文长度又砍一半。桌面版这个对本地模型非常不友好,所以用回Hermes。

    不知道有没有人和我一样的遭遇。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组