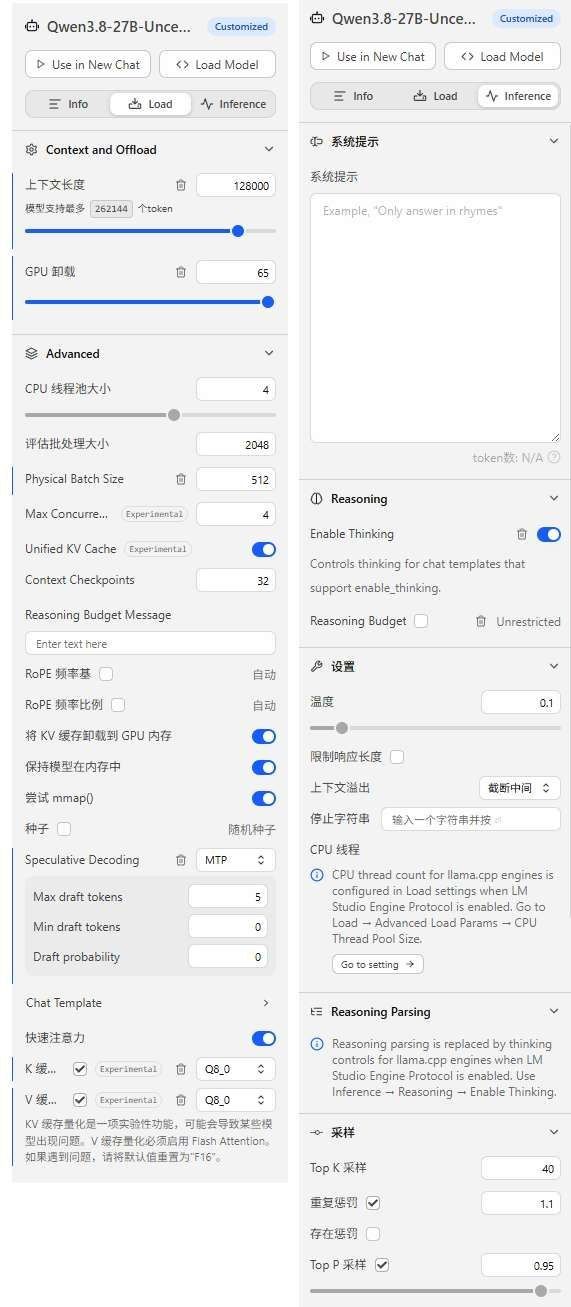
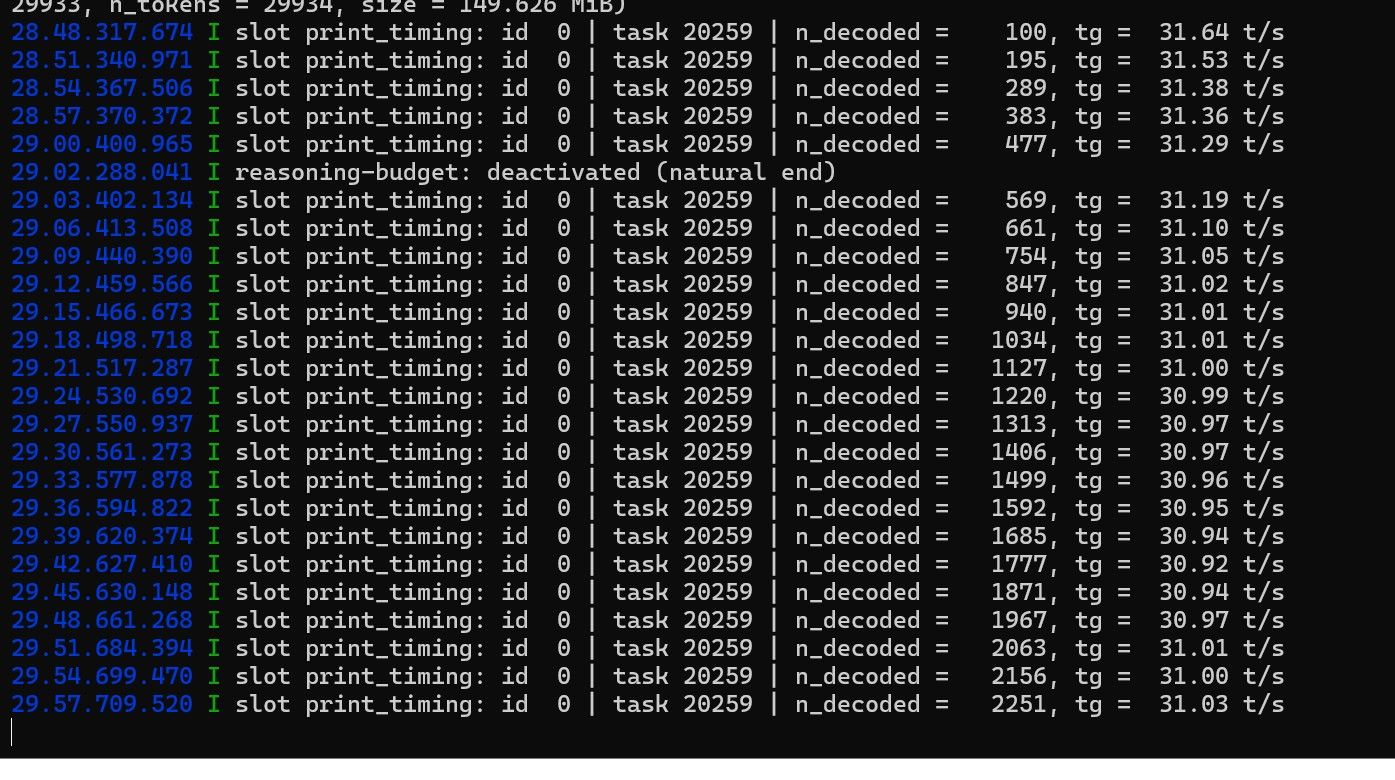
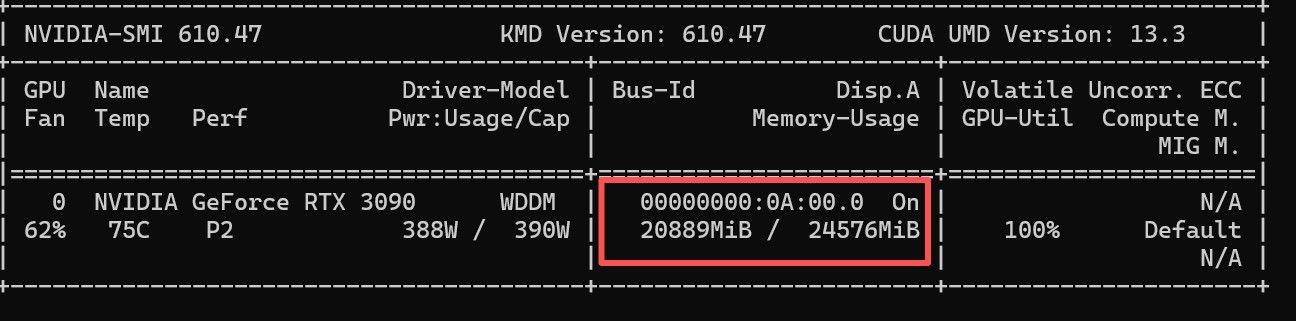
换算下来就是每卡每年332880刀?
难怪算力租赁吃香
 毅
毅袁
@毅袁
-
deepseek: 单一集群 155 万亿 Tokens/天,整体收入每卡每小时 38 美金 -
deepseek: 单一集群 155 万亿 Tokens/天,整体收入每卡每小时 38 美金 -
DSH本地模型的上下文救赎:dsh-command-context-trim 插件 -
[巨坑?] DeepSeek Harness v0.1.7 的上下文压缩/修剪策略会降低本地模型的可用性 -
Qwen3.8 27B, 单卡也可以跑191 tok/s : 一套优化到极致的部署与实测也部署了这个仓库:vLLM vs llama.cpp 同条件 A/B(3090 单卡,128K 上下文)
楼主好,也部署了这个仓库(vLLM 0.28 + W4A16 AutoRound-fast + DFlash2),同样是单卡 3090 24G。但我的用法和楼主不太一样:我是拿它给 agent 长会话(DSH)当后端,每步平均上下文约 79K token,比仓库标准测速的 ~190 token 深得多。所以顺手做了 vLLM 和 llama.cpp 的同条件 A/B 对比,数据放出来供参考。
部署配置
项 vLLM 侧 llama.cpp 侧 硬件 RTX 3090 24G 独占(功耗墙 280W),另有 3070 8G 未参与 同左 环境 Windows 10 + WSL2 (Ubuntu),vLLM 0.28.0 原生 venv llama.cpp,Windows 原生 模型 Qwen3.8-27B-W4A16-AutoRound-fast(项目自带,与楼主同款)Qwen3.8-27B-Uncensored-Q4_K_M.ggufKV 精度 int8( int8_per_token_head,CTX=long)q8_0 上下文上限 131072 131072 投机解码 DFlash2,7 草稿 draft-mtp,3 草稿 视觉塔 启用 启用(mmproj F16) 环境备注:Docker 路线放弃了——NVIDIA Container Toolkit 的 nvidia.github.io 源国内实测 0~1 KB/s,清华/中科大/阿里云镜像全 404/403。改走 WSL2 原生 venv + 离线 wheel(torch/vllm/triton/flashinfer 共 180 个 wheel 离线备好),装完不需要 toolkit。
测试口径(保证可比性的 5 条)
- decode = completion_tokens / (total − ttft),严格剔除预填,绝不把 prefill 平均进去
- 用真实提示词(仓库文档 + vLLM 源码,约 3.2 MB),不用随机 token——投机解码接受率完全取决于草稿能否猜中,随机 token 跑分没有意义
- 每个提示词加盐,避免被前缀缓存服务,测到的才是「冷」预填
- 先预热再测,丢弃首轮(含 JIT 编译,读数偏低 30~50%)
- 两侧都关思考(
enable_thinking: false)——否则思考 token 会把max_tokens预算吃光,两边不可比(实测:不关时 16 token 全被思考占掉,content为空)
实测数据
冷预填
上下文 vLLM llama ~1K 1141 t/s(0.90s) 977 t/s(1.05s) ~3.8K 1141 t/s(3.37s) 1083 t/s(3.54s) ~15.7K 936 t/s(16.78s) 1070 t/s(14.68s) ~44K 645 t/s(67.44s) 936 t/s(47.08s) vLLM 预填随上下文衰减明显(1141→645),llama 平稳得多(977→936),15.7K 起反超,44K 处快 45%。
★ 深上下文 decode(核心发现)
上下文 vLLM llama 胜负 ~1.9K 96.4 t/s 48.7 t/s vLLM 2.0× ~7.6K 72.1 t/s 50.7 t/s vLLM 1.4× ~23K 40.7 t/s 44.9 t/s llama 1.1× ~44K 29.2 t/s 42.4 t/s llama 1.45× ~75K 18.2 t/s 42.0 t/s llama 2.3× 差距不在绝对速度,在衰减曲线的形状:
vLLM : 96.4 → 18.2 t/s   掉 −81%   ← 断崖式衰减
llama: 48.7 → 42.0 t/s   掉 −14%   ← 几乎平坦
交叉点在 20K 附近:浅上下文 vLLM 快一倍,深上下文 llama 反超且差距持续拉大。
前缀缓存(对 agent 场景价值最大的一项)
冷 TTFT 热 TTFT 加速 命中率 vLLM 39.38s 2.17s 18.2× 96% llama 31.65s 0.21s 147.6× 100% agent 场景反复发送同一前缀(工具定义 + 历史消息),llama 热启动几乎瞬时,这项差异直接体现在每一轮的响应延迟上。
根因分析
vLLM 为什么深上下文崩得快:
- 投机解码验证开销随上下文线性增长:DFlash2 每步要对 7 个草稿 token 做一次多查询验证注意力,上下文越长这一步的 KV 读取越贵。DFlash2 接受率 48.0%、tokens/step 4.36——这是它浅上下文快 2 倍的直接原因,但这个优势随上下文增长迅速蒸发
- int8 KV 反量化开销:CTX=long 用
int8_per_token_head配 Triton attention 反量化,llama 的 q8_0 KV 有更成熟的 dequant 路径 - CUDA graph 捕获尺寸限制:为了不 OOM,
max_cudagraph_capture_size被压到 32,深上下文的部分 shape 落到 eager 路径
llama 为什么能保持平坦:
draft-mtp是模型自带的 MTP 头(非独立草稿模型),验证成本远低于 DFlash2 的 7 草稿 + 路径选择器,GGML 的 KV 管理也更直接。代价是浅上下文只有 vLLM 的一半——MTP 接受率不如 DFlash2。结论与建议
场景 推荐 理由 agent 长会话(20K+ 上下文) llama.cpp 75K 处快 2.3×;热启动 0.21s 短问答 / 单轮任务 vLLM 1.9K 处快 2.0× 需要视觉 两者都支持 都加载了视觉塔 我的当前决策:日常主力切回 llama.cpp,vLLM 方案完整保留作备选。
给楼主和各位两个提示:
- 仓库标准测速(8 条真实聊天 prompt,~190 token)覆盖的是 vLLM 占优的浅上下文区间;如果拿来做 agent 长会话,建议补一组深上下文 decode 测试(23K/44K/75K),否则断崖要等真实使用才会暴露
- 「128K prefill 1200t/s」应该是前缀缓存开启 + 固定 prompt 的口径;我们的「冷预填」(加盐防前缀缓存命中)在 44K 是 645 t/s 且还在衰减。两个数字都对,口径不同
顺带:无审查版也测了
leminkozey/Qwen3.8-27B-Uncensored-W4A16-AutoRound(同 AutoRound W4A16 配方,abliterated 无审查版):DFlash2 接受率 52.2%(略高于官方版 48.0%)、tokens/step 4.66,浅上下文 ~100 tok/s,245K 上下文。深上下文衰减曲线与官方版一致——瓶颈在 vLLM/DFlash2 侧,不在模型侧。一个 Qwen3.8 的坑(与部署无关但很影响体验)
Qwen3.8 官方
chat_template.jinja默认reasoning_effort=xhigh,思考 token 会把输出预算烧光导致content为空(实测同问题 xhigh=373 token / low=136 /enable_thinking=false=28,答案质量无差异)。vLLM 侧用请求参数{"chat_template_kwargs": {"enable_thinking": false}}即可覆盖,不用换模板。 -
小白到能玩# 4080 SUPER 32G 跑 Qwen3.8-27B 无审查版(Q6_K) 实测61.7t/s 完整部署与实测指南,自己从27t/s一路调上来的,分享给大家@imbiplaza-ASUS 感谢回复,我去研究下

-
小白到能玩# 4080 SUPER 32G 跑 Qwen3.8-27B 无审查版(Q6_K) 实测61.7t/s 完整部署与实测指南,自己从27t/s一路调上来的,分享给大家大佬,这个设置界面是自制的吗?看起来很惊艳,可否分享下?
拜谢! -
[神器?]NVIDIA CMP170HX 80G显存 -
2026-07 小测一个适合24g单卡跑Hermes 的模型 Qwen3.6-35B-A3B-UD-IQ4_NL_XL (140t/s 170K上下文 tooleval 96分) -
3090单卡跑的3090 club项目,hermes很慢,可能是啥原因呢? -
别再推荐免费编程工具Trae了,应该马上收费了,我每天用到被限制了. -
3090 24G 跑QWOPUS 3.6 27B mtp 131K上下文 KV(Q8_0) 55TOK/S 智能开关思考- 最终配置,再也不折腾了(6月14日更新)@c0aster https://github.com/ikawrakow/ik_llama.cpp 从这个项目自己编译的ik_llama,启动参数如下:
start "ik_llama - heretic-v2 27B" "%EXE%" ^
-m "J:\llama-b9370-bin-win-cuda-12.4-x64\models\1\Qwen3.6-27B-uncensored-heretic-v2-Native-MTP-Preserved-Q4_K_M.gguf" ^
--mmproj "J:\llama-b9370-bin-win-cuda-12.4-x64\models\1\Qwen3.6-27B-mmproj-BF16.gguf" ^
-ngl 99 -c 131072 --threads 12 --no-mmap ^
--flash-attn on ^
--cache-type-k q4_0 --cache-type-v q4_0 ^
--batch-size 512 --ubatch-size 256 ^
--merge-qkv --merge-up-gate-experts ^
--cache-ram 32768 ^
--spec-type mtp:n_max=4,p_min=0.0 ^
--jinja --chat-template-file "%TEMPLATE%" ^
--timeout 3600 --host 0.0.0.0 --port 8080 -
3090 24G 跑QWOPUS 3.6 27B mtp 131K上下文 KV(Q8_0) 55TOK/S 智能开关思考- 最终配置,再也不折腾了(6月14日更新) -
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s -
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s -
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s -
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s -
Claude Code编程最好用旗舰在线API,千万不要图便宜。 -
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s不好意思,一着急,启动参数贴错了
@echo off
chcp 65001 >nul
title Qwen3.6-27B-UD RTX3090 Optimized Launcher:: ================= 配置区 =================
:: 请将下方路径修改为你电脑上实际的模型文件路径
set MODEL_PATH=J:\llama-b9370-bin-win-cuda-12.4-x64\models\2\Qwen3.6-27B-NEO-CODE-HERE-2T-OT-Q4_K_M.gguf:: 如果你有对应的多模态视觉文件(mmproj),可以在下方取消注释并填写路径;没有则保持注释
set MMPROJ_PATH=J:\llama-b9370-bin-win-cuda-12.4-x64\models\2\mmproj-F16.gguf
:: ==========================================echo ========================================
echo Qwen3.6-27B-UD RTX 3090 启动中...
echo ==========================================:: 启动 llama.cpp (假设 llama-server.exe 或 main.exe 在当前目录下,如果不在请写绝对路径)
.\llama-server.exe ^
--model "%MODEL_PATH%" ^
--ctx-size 131072 ^
--gpu-layers 99 ^
--parallel 1 ^
--temp 0.8 ^
--top-p 0.95 ^
--top-k 20 ^
--cache-type-k q4_0 ^
--cache-type-v q4_0 ^
--flash-attn on ^
--timeout 3600 ^
--repeat-penalty 1.2 ^
--jinja --chat-template-file chat_template.jinja ^
--port 8080 ^
--host 0.0.0.0pause
-
求教,为什么我的3090跑Qwen3.6 27B,没有丝滑感,搭配codex编程只有不到30tokey/s