跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
清风明月清

清风明月

@清风明月
德高望重
取消关注 关注
关于
帖子
46
主题
10
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • SGLang HiCache 三层 KV 缓存实测:32GB Blackwell 单卡跑通 Qwen3.8-27B
    清风明月清 清风明月
    LLM讨论区 sg-lang qwen-27b

    背景

    看到论坛 neo 大佬分享的 SGLang HiCache 三层 KV 缓存(VRAM→RAM→NVMe),很感兴趣。核心卖点是:显存里的 KV Cache 放不下时,把暂时不用的 KV "搬到内存/磁盘",需要时再取回来——重启后 190K 上下文直接加载免 prefill。

    我的环境:RTX PRO 4500 Blackwell 32GB + 64GB RAM + X570 主板。之前一直用 llama.cpp 跑 Qwen3.8-27B(Q4 量化,150K ctx,MTP 投机解码)。今天折腾了一下午,把 SGLang HiCache 跑通了,记录一下过程和踩的坑。

    结论先行

    ✅ SGLang 0.5.18 + RadixArk Qwen3.8-27B-NVFP4 + HiCache L2 32GB 在 32GB Blackwell 单卡跑通

    关键数据:

    • 模型权重:20.14 GB(NVFP4)
    • GPU KV cache:101K tokens(fp8,~3.1GB)
    • HiCache L2:32GB host RAM
    • 系统总内存占用:~46GB / 64GB
    • 推理正常,reasoning_effort 可调

    踩坑记录(重要)

    坑1:Unsloth NVFP4 不兼容 SGLang

    Unsloth 的 NVFP4 用 compressed-tensors 格式 + FP8 lm_head,SGLang 加载报错。必须用 RadixArk/Qwen3.8-27B-NVFP4(NVIDIA Model Optimizer/modelopt 格式)。

    hf download RadixArk/Qwen3.8-27B-NVFP4 --local-dir ~/models/sglang/Qwen3.8-27B-NVFP4
    

    坑2:reasoning_parser 必须显式设

    不加 --reasoning-parser qwen3 的话,thinking 标签会残留在 content 里,reasoning_content 字段为 None。加了之后正确分离:

    reasoning: "The user said hi - a simple greeting..."
    content: "Hi there! How can I help?"
    

    完整部署步骤

    1. 安装 SGLang

    python3.12 -m venv ~/.sglang-venv
    source ~/.sglang-venv/bin/activate
    pip install --upgrade pip && pip install uv
    uv pip install --prerelease=allow sglang
    

    2. 下载模型

    hf download RadixArk/Qwen3.8-27B-NVFP4 --local-dir ~/models/sglang/Qwen3.8-27B-NVFP4
    

    约 21GB,3 个 safetensors 分片。

    3. 启动命令

    python -m sglang.launch_server \
      --model-path ~/models/sglang/Qwen3.8-27B-NVFP4 \
      --served-model-name qwen3.8-27B-NVFP4 \
      --host 127.0.0.1 --port 8000 \
      --enable-hierarchical-cache \
      --hicache-size 32 \
      --tp 1 \
      --mem-fraction-static 0.85 \
      --max-running-requests 1 \
      --context-length 131072 \
      --reasoning-parser qwen3 \
      --tool-call-parser qwen3_coder
    

    参数说明:

    • --hicache-size 32:L2 缓存分配 32GB host RAM
    • --context-length 131072:128K 上下文上限
    • --mem-fraction-static 0.85:GPU 内存分配比例
    • --reasoning-parser qwen3:分离 thinking 和 content
    • --tool-call-parser qwen3_coder:支持工具调用

    4. systemd 服务

    [Unit]
    Description=SGLang Qwen3.8-27B-NVFP4 with HiCache L2/L3 KV Cache
    After=network.target
    
    [Service]
    Type=simple
    WorkingDirectory=%h
    ExecStart=%h/.sglang-venv/bin/python -m sglang.launch_server \
      --model-path %h/models/sglang/Qwen3.8-27B-NVFP4 \
      --served-model-name qwen3.8-27B-NVFP4 \
      --host 127.0.0.1 --port 8000 \
      --enable-hierarchical-cache --hicache-size 32 \
      --tp 1 --mem-fraction-static 0.85 --max-running-requests 1 \
      --context-length 131072 \
      --reasoning-parser qwen3 --tool-call-parser qwen3_coder
    Environment=CUDA_VISIBLE_DEVICES=0
    Restart=on-failure
    RestartSec=10
    StandardOutput=journal
    StandardError=journal
    
    [Install]
    WantedBy=default.target
    

    内存分配实测数据

    组件 大小
    模型权重 (NVFP4) 20.14 GB
    Mamba SSM state 2.67 GB (18 slots)
    Mamba conv state 0.05 GB
    KV Cache (fp8, 101K tokens) 3.10 GB
    GPU 剩余 ~4.69 GB
    HiCache L2 (host RAM) 32 GB
    系统总占用 ~46 GB / 64 GB

    HiCache 的实际价值

    坦白说,HiCache 在单用户场景下最大的价值不是"跑更大上下文",而是多会话 KV 复用免 prefill。

    • GPU 上直接跑 ~101K tokens(全速)
    • 超出部分由 HiCache L2 从 RAM 换入(有延迟)
    • 重启服务后,之前的 KV 从 L2 恢复,不用重新 prefill
    • 多会话切换时,不活跃会话的 KV 换到 RAM,活跃的留在 VRAM

    对比 llama.cpp 的 150K 全 VRAM 方案:

    • llama.cpp 速度更快(全在 GPU 上,零搬运延迟)
    • SGLang HiCache 胜在会话复用(重启免 prefill)

    上下文性能预期

    上下文范围 性能
    <101K tokens 全速(KV 全在 GPU)
    101K-128K HiCache L2 换入,decode 有额外延迟
    128K+ 明显变慢(每步 PCIe 搬运 ~100ms+)

    建议设 128K 上限,日常控制在 100K 以内。

    NVMe L3 缓存

    L3(NVMe 磁盘缓存)在命令里加 --hicache-storage-backend file 即可开启。实测 NVMe 顺序读 ~3.5-7GB/s,延迟 ~100μs,对 decode 来说太慢了——从 NVMe 取 KV 做 prefill 比直接重算慢不了多少,实际价值有限。L2 RAM 缓存才是重点。

    MTP 投机解码可行性分析

    有人会问:SGLang 能不能也上 MTP 加速?答案是32GB 单卡上标准版不行,但有专门的轻量化 checkpoint 可以。

    为什么标准 RadixArk 版不行

    RadixArk 版权重 20.14GB,GPU 剩余 ~4.69GB。MTP 额外需要:

    • Draft KV cache: ~0.3-0.5 GB
    • Draft Mamba state: ~0.15 GB
    • MTP head 权重: ~0.1 GB
    • 总计: ~0.5-0.75 GB

    理论上 4.69GB 够放,但实际上 Unsloth 官方明确说了:

    "SGLang 0.5.18(NEXTN/MTP 在 32 GB 上无法有效适配)。在 32 GB 下,额外尺寸会占用 KV pool,因此无法容纳原生 256k。"

    根因是 MTP 会和 HiCache 的内存分配冲突——HiCache 需要预留 host memory pool,MTP 需要额外的 draft model 状态,两者抢同一块剩余空间。

    gittensor 优化版:技术可行但没必要

    社区有人(gittensor-model-hub)做了一个专门适配 RTX 5090 32GB 的优化 checkpoint:

    • 权重压到 ~18.8GB(比标准版小 1.3GB)
    • 配合 DSpark 推测解码,RTX 5090 上跑到 180 tok/s
    • 理论上在你的 RTX PRO 4500 上也能装下

    但没必要,三个原因:

    1. llama.cpp 已经有 MTP 了——我的标准版 UD-Q4_K_XL + MTP n=2 跑到 67 t/s,这是验证过的稳定方案。SGLang + MTP 在 896 GB/s 带宽上不会更快(RTX 5090 1792 GB/s 才能跑到 180 t/s)。

    2. HiCache 价值被 MTP 吃掉——加 MTP 后 GPU 内存更紧张,HiCache L2 分配空间被压缩,多会话复用的优势打折扣。

    3. 社区 checkpoint 质量不确定——gittensor 不是官方也不是大厂,模型质量和长期维护都不确定。你之前定的铁律是"模型必须官方源版本"。

    结论

    32GB 卡上 SGLang + NVFP4 的最优定位就是多会话 KV 复用,不追求 MTP 加速。MTP 投机解码留给 llama.cpp(那边已经验证稳定)。

    两者互补:

    • llama.cpp + GGUF + MTP:日常推理主力(67 t/s,稳定)
    • SGLang + NVFP4 + HiCache:多会话 KV 复用(~55 t/s,重启免 prefill)

    社区实测对比(来自抡锤者论坛)

    论坛版主 Terry 用 4090D 48GB 跑了类似方案,形成直接对比:

    维度 Terry (4090D 48GB) 本机 (RTX PRO 4500 32GB)
    模型格式 FP8 (28.5GB) NVFP4 (20.1GB)
    HiCache L2 24GB(64GB 系统不够开 32) 32GB
    GPU KV 270K tokens 101K tokens
    上下文 262K(满配) 128K
    MTP ✅ NEXTN 5步/6draft ❌ 无
    性能 63-76 t/s (thinking-off) ~55 t/s

    关键发现:

    • 32GB 卡红利最大:Terry 原话"对于 32G 显存的卡,开内存缓存意义非常重大"——因为 FP8/NVFP4 权重加载后显存所剩无几,HiCache 让 KV 有地方放
    • HiCache 有性能代价:论坛用户 折騰 实测开 --hicache-size 后 tok/s "掉得太厉害,直接打折"——RAM 换入延迟不是无感的
    • 48GB 可以 MTP + HiCache 全开:Terry 4090D 上 MTP accept len 3.8-4.2,同时 HiCache 24GB,但 32GB 卡两者只能二选一

    总结

    SGLang HiCache 是个不错的方案,但 32GB 单卡有几个硬约束:

    1. 必须用 NVFP4(FP8 权重太大)
    2. 必须用 RadixArk 版(Unsloth 版不兼容)
    3. GPU KV cache 只有 ~101K tokens,HiCache L2 是补充不是主力
    4. reasoning_parser 必须显式设
    5. MTP 投机解码不可用(标准 checkpoint 太大,轻量化版没必要)
    6. HiCache 有实测性能代价(tok/s 会打折),核心价值在多会话复用而非速度

    32GB 卡的最优组合:llama.cpp + GGUF + MTP 做日常推理(67 t/s),SGLang + NVFP4 + HiCache 做多会话 KV 复用(重启免 prefill)。两者互补,不互相替代。

    48GB 卡(4090D/RTX Pro 5000)可以全开:FP8 + MTP + HiCache + 262K 上下文,体验接近在线模型。

    如果你有 48GB+ 的卡,HiCache 的价值会更大——更多 KV 留在 GPU 上,L2 作为冷备,MTP 也能跑得动。32GB 单卡的话,这个组合已经够用了。


  • deepseek-v4-flash还是猛啊!
    清风明月清 清风明月
    随便聊聊 deepseek

    刚刚用hermes来一条龙部署cloudflare workers and pages,为了省钱,用的mimo-v2.5,弄了半个小时,在有技能的情况下,给我整得稀烂,没办法,熬到6点后,切deepseek-v4-flash,5分钟不到,搞定!哎,差距真是有点大啊,要是deepseek能回到涨价前就好了,这个模型实在是好用啊!


  • RTX PRO 4500 单卡跑 125B MoE:Strata + Qwen3.8-Flash-Next 实测 189 tok/s、262K 满上下文零崩溃——50 分钟从零到可用全纪录
    清风明月清 清风明月
    LLM讨论区 rtxpro4500 strata qwen-flash

    引言

    我是一个本地大模型玩家,机器是一台 X570 平台:RTX PRO 4500 Blackwell(32GB)+ Ryzen 7 3700X + 60GB 内存。之前主力是 27B 级别的本地模型(SGLang),一直眼馋 Qwen3.8-Flash-Next 这个 125B 的 MoE——但 125B 意味着"没有 96GB 显存别想碰",直到 Strata 出现。

    Strata(Niko1221/Strata,MIT 开源)是专为这一个模型写的推理引擎:把 24,576 个专家按三层摆放——热专家进显存、全部专家进内存、n-gram 查表进 SSD——让 12-32GB 的游戏卡也能跑 125B。10 月初它冲上 HN 首页(900+ 分),社区帖我也翻了个遍,国庆假期第六天,我花了一个下午把它从零装到能用。

    最值得讲的一组数字:我这张 32GB 卡上,短对话 decode 跑出 189 tok/s;升级到 262K 满上下文后,用 24.5 万 token 的长文实测零崩溃、埋词召回 3/3 全中。安装全程约 50 分钟(含编译、68GB 模型下载与校验)。

    这篇帖子把全流程、全部实测数据、踩过的坑、不要做的事一次写全。所有数字都附测法,欢迎复现。

    目录

    1. 先给结论
    2. 名词白话解释
    3. 我的环境
    4. 从零到可用:安装流程(可直接抄)
    5. 装完之后:接进自己的工作流
    6. 🔴 最重要机制:125B 是怎么塞进 32GB 显存的
    7. 实测数据(全附测法)
    8. 踩过的 5 个坑
    9. 不要做的事
    10. 复现附录与未测项
    11. 🔁 晚间更新:agent 对打补测 + 原主力退役

    先给结论

    表 1 · 最终成绩单

    维度 结果 备注
    模型 Qwen3.8-Flash-Next IQ2_XS(125B 总参 / 6B 激活) 68GB 权重,双文件 SHA256 对照官方全过
    设备 RTX PRO 4500 Blackwell 32GB 单卡 游戏卡/工作站卡通吃(本项目 NVIDIA/AMD 都支持)
    短对话速度 decode 189 t/s(16K-32K 档) 比官方 12GB 卡标线(79)高一倍多
    长文速度 127K 上下文 186.8 t/s;245K 深度 85.1 t/s 长上下文衰减系行业通性,官方同深度标线 ~53
    上下文 262K 满血(模型原生上限) 24.5 万 token 长文实测零崩溃
    召回 needle 全绿:32K/128K/250K 各深度 100% 90% 深度埋词也能捞出来
    思考模式 支持 off/low/medium/high 陷阱题答对,思维链完整
    资源占用 显存 ~33.2/34.2 GB(十进)、内存 47/60GB 显存"看起来"97% 是设计(见机制节)
    稳定性 全程零崩溃(含 4 连发 24.5 万 token 压力) 尚未做小时级长稳(见未测项)
    agent 任务补充实测 13.3 秒完成真代码任务、一次过隐藏验收;对照原主力 27B 快 6.9× 2026-10-06 晚补测,见文末更新

    表 2 · 这次实践的流水账

    环节 耗时 说明
    硬件自检 1 分钟 官方自带 --check
    CUDA 13.0 安装 15 分钟 Ubuntu 26.04 需手动路径(见坑 1)
    引擎编译 5 分钟 撞 glibc 坑,修复后全绿(见坑 2)
    模型下载+校验 13 分钟 68GB,换国内源后 120MB/s(见坑 3)
    配置补全(MTP+打包) 7 分钟 自动流程
    启动+首答 2 分钟 35.5GB 以 3.08GiB/s 载入内存
    全套实测 20 分钟 五档压测+召回+思考
    262K 升级+验证 15 分钟 含 24.5 万 token 四次压力测试
    agent 对打补测 10 分钟 同题同协议 vs 原主力 27B,见文末更新

    名词白话解释

    词 白话解释
    量化(IQ2_XS) 把模型权重压缩到约 2 比特的格式。体积省 8 倍,质量小损(不同压缩档质量不同,按内存选)
    MTP 推测解码 模型自带的"抢答小助手"先猜后面几个词,大头模型一次核对——猜中就赚了,输出质量不变。实测约 1.6-1.8 倍加速
    上下文 / 262K 模型一次能"记住"的文本量。262K token ≈ 19 万汉字,够塞一整本长篇小说
    prefill / decode 两个阶段的吐字速度:prefill = 读你发的内容(读入越慢首答越久);decode = 一个字一个字写答案的速度

    我的环境

    项 值
    GPU NVIDIA RTX PRO 4500 Blackwell,32GB GDDR7,驱动 595.91.07
    CPU AMD Ryzen 7 3700X(8 核 16 线程,AVX2,无 AVX-512——官方说 AVX-512 机器更快,我这台是普通款)
    内存 60GB DDR4
    磁盘 NVMe SSD(模型放根盘,1.3TB 空闲)
    系统 Ubuntu 26.04
    CUDA 13.0(为编译引擎装的,与系统原有 12.9 共存)
    引擎 Strata v0.1.39(源码编译)
    模型 Qwen3.8-Flash-Next GSQ-RCO IQ2_XS(68GB,官方推荐档)
    上下文 262,144(模型原生拉满)

    ⚠️ 为什么选 IQ2_XS 而不是更高质量的 IQ3_S?——内存。60GB 机器上的安全档是 IQ2_XS(专家 35.5GB);IQ3_S 的 50GB 专家 + 系统会让 64GB 机器贴边。如果你有 96GB+ 内存,直接上 IQ3_S(质量更高,速度低一档)。社区有人实测过:更激进的量化(IQ3_S→IQ3_XXS)快 14-23%,但输出 token 是 2.7 倍(过度思考、反复返工),端到端反而慢 2.4 倍——所以别只看压缩率。

    从零到可用:安装流程(可直接抄)

    # 1. 克隆 + 硬件自检(不装任何东西,1 分钟)
    git clone https://github.com/Niko1221/Strata.git && cd Strata
    ./setup.sh --check
    # 期望末行:This PC can run Strata. 且列出各量化档的 RAM 适配
    
    # 2. CUDA Toolkit 13.0(Ubuntu 22.04/24.04 可跳过——setup 自动装;
    #    26.04 需手动,见我踩的坑 1/2)
    # 3. 非交互安装(下载 68GB + 编译引擎,全程后台跑,可断点续传)
    ./setup.sh --yes --family qwen --model IQ2_XS --context 262144 --no-start
    #   ⚠️ 注意:改设置重跑时不要漏 --model(见我踩的坑 3)
    
    # 4. 启动(前台进程,关闭即停)
    ./run-iq2_xs.sh
    # 浏览器自动开 http://127.0.0.1:8080
    

    几个设计上良心的地方(实测确认):

    • 下载断点续传、步骤跳过(已完成步骤重跑时秒过)
    • 首次启动约 2 分钟(加载 35.5GB 到内存 + 预热显卡缓存),之后重启 25 秒
    • 自带 Web UI(Chat / Monitor / About 三个页签,Monitor 能实时看 GPU、缓存命中率、token 速度)
    • OpenAI / Anthropic / Responses 三种 API 全兼容——本地任何客户端直接接

    装完之后:接进自己的工作流

    光能跑不算数,我把它接进了自己的三套体系(都实测通过):

    集成 方式 实测
    systemd 服务化 strata.service(user 级) ⚠️ 必须配 LimitMEMLOCK=infinity(专家要锁 35.5GB 内存,systemd 默认只给 8MiB);25 秒就绪
    一键切换 个人切换脚本新增 strata 目标(现编号 1=strata) 与 SGLang 27B / ComfyUI 显存互斥自动生效;切换实测:起 30s / 互切 75s / 切回 55s
    dsh 客户端 新增 local-strata 渠道 关键配置:thinkingFormat: openai(它直接吃标准 reasoning_effort 字段);headless 实测 12.9 秒完成任务

    🔴 最重要机制:125B 是怎么塞进 32GB 显存的

    很多人第一反应是"32GB 显存跑 125B?骗人的吧"。原理其实很朴素,官方 paper 讲得很清楚,我用厨房打个比方:

    这台机器被当成一个"异构厨房"用:

    层 放什么 我这台实配
    🍳 灶台(VRAM 32GB) 每道菜都要用的(注意力/路由器/输出头,约 3.5GB)+ 最热门的专家缓存——它自己会学你聊什么、动态换血 18,119 个专家常驻(约 26GB),命中率 95-99%
    🧺 备菜台(RAM 60GB) 全部 24,576 个专家(35.5GB)——显卡没有的,CPU 当场算,和显卡同时干活 同时开 7 个 CPU 专家流水线
    📦 储物柜(SSD) 一张 28.8GB 的 n-gram 查表,每次只读几行 走系统页面缓存,基本无感

    三个关键设计(为什么能"同时"而不是"轮流"):

    1. GPU/CPU 流水线:每层显卡算完把"这轮要用哪 10 个专家"写进一块共享内存(门铃),CPU 不等驱动回调、自旋监听,立刻把显卡没有的专家就地算掉——两边同时进行,谁也不等谁
    2. 自适应缓存:显卡上那 18,000 个专家位不是死的,引擎每几轮就把"你这段对话最常点的专家"换进来——用得越久命中率越高
    3. 多 token 验证:MTP 一次猜 4 个词、大头模型一次全核对,猜中的全留下——所以"每写一个词要读几十 GB"的成本被摊薄了

    🔴 由此引出一个所有人都会误解的现象:我装好后看到显存占用 33.2/34.2 GB(97%)也慌了一下——这是设计状态,不是极限。引擎的策略就是"把剩余显存全部填成专家缓存换速度"(启动日志原话:"423 MiB of VRAM free with everything loaded")。我后来升级 262K 上下文实测:显存代价只有缓存缩 1%(18,314→18,119 槽)——因为长上下文的 KV 记忆主体放在内存里(+1GB),根本不吃显存。所以**"97% 占用"和"能开多大上下文"是两个独立问题**。

    实测数据(全附测法)

    测法说明:全部用 OpenAI 兼容接口、streaming 计时、temperature=0、reasoning off(思考模式单独测)。长短文任务为"编号记录复述"类(含固定句式重复文本),这类任务对推测解码友好,数字偏乐观——预计真实代码/agent 任务会有出入,见未测项。每条数据都由我机器上的基准脚本自动采集。

    表 3 · 五档压力实测(131K 配置时代)

    实际 prompt tokens prefill t/s decode t/s 召回判断题
    5,501 2,789 142.2 ✅
    22,576 3,514 189.1 ✅
    46,966 5,291 189.0 ✅
    96,106 5,138 179.7 ✅
    127,561 8,828 186.8 ✅

    表 4 · 262K 满上下文验证(升级后实测)

    项目 数据
    245,308 token 深度压测 prefill 3,263 t/s、decode 85.1 t/s、✅ 零崩溃、✅ 找回全部编号
    244K 深度召回 ✅ 3/3 找到(明细见表 5)
    升级后短任务复核 4K 档 144.5 t/s(与升级前持平,零损失)
    资源增量 内存 +1GB、显存缓存 -1%、重启 25 秒

    表 5 · needle 召回测试(官方工具 needle_bench.py,埋词位置 10%/50%/90% 三档)

    上下文长度 结果 耗时/次
    32K ✅ 3/3 5-10 秒
    128K ✅ 3/3 34-38 秒
    250K ✅ 3/3 73-77 秒

    思考模式:经典陷阱题("17 只羊除了 9 只都跑了还剩几只")✅ 答对,思维链走 reasoning_content 字段完整返回,总耗时 1.5 秒。

    表 6 · 横向对照(同模型不同硬件)

    机器 量化 decode @128K 来源
    本机 RTX PRO 4500 32GB IQ2_XS 186.8 t/s 本帖实测
    RTX 5090(同量化) IQ2_XS 165 t/s 社区报告
    RTX 5070 12GB(官方基准机) IQ2_XS 63 t/s 官方数据
    同款 4500 32GB(512GB 内存机) IQ3_S 116 t/s 社区报告

    📌 我这张卡能跑到 5090 之上,解释一下:32GB 显存对 IQ2_XS 这个体积的模型"缓存命中率"极高(95-99%),而 IQ2_XS 本身又是最轻的档——两个因素叠加。5090 那台跑的是同一量化但上下文策略不同。

    踩过的 5 个坑

    坑 1:Ubuntu 26.04 不在官方自动安装支持列表

    症状:setup.sh 到第 4 步停住——"the CUDA Toolkit can be installed automatically on Ubuntu 22.04 / 24.04 only",要求手动装 CUDA 13.0。
    根因:项目自动安装 CUDA 的路径只覆盖 22.04/24.04;26.04 太新。
    修复:手动走等效路径(cuda-keyring 用 ubuntu2404 源 + apt install cuda-toolkit-13-0,约 6GB/10 分钟)。装完把系统默认 cuda 软链接恢复指向旧版(用 update-alternatives --set),不影响引擎——它从 nvcc 绝对路径找工作,不依赖全局软链。

    坑 2:glibc 2.43 + CUDA 头文件冲突(26.04 独有,最硬的一个)

    症状:引擎编译第一步(CMake 探测编译器)就挂:error: exception specification is incompatible with that of previous function "rsqrtf"。
    根因:Ubuntu 26.04 的 glibc 2.43 给 rsqrt/rsqrtf 加了 noexcept 标记,与 CUDA 13.0 头文件的旧声明打架——系统头文件级别的冲突,换编译器版本没用(网上有人说降级 gcc,实测无效)。
    修复:llama.cpp 官方文档给的正解——给 CUDA 安装目录的头文件打一个小补丁(备份后,给 rsqrt/rsqrtf 两行声明加上 noexcept (true)),编译 5 分钟全绿。(项目仓库里 pinned 的 llama.cpp 文档正好写了这个 issue,而且是社区 issue 里维护者确认过的方案。)

    坑 3:官方源下载慢 600 倍——真正的解法是换源

    症状:从 HuggingFace 官方源拉 68GB 模型,速度只有 0.2-4MB/s(我这出口走代理跨境),aria2 多线程也只能 2-4MB/s,按这个速度要 7 小时。
    根因:不是工具问题,是到 HF 的线路慢(跨境瓶颈)。我测试对比过:内置下载器 0.2MB/s、aria2 八线程 2.6MB/s、hf-xet 3.8MB/s——都受限。
    修复:换 ModelScope(国内源)——实测 120MB/s,68GB 只要 11 分钟。安全性与官方源等价:MS 的存储对象 ID 就是文件 SHA256 本体,且下载后我用双文件 SHA256 对照 HF 官方发布值全部一致。连 MTP 层(另一种张量范围下载)也切到了 MS 通道继续沿用。

    💡 结论:跨境的锅别让工具背。测速 → 换源 → 校验(SHA256 对齐官方),比折腾多线程参数高效得多。

    坑 4:aria2 完成后偶发不退出 + 一个隐藏的配置坑

    症状:下载完成的 aria2 进程停在后台不退出(文件其实已完整)。
    根因 + 修复:进程停在收尾阶段,发 SIGTERM 后正常退(文件+控制文件都已就绪,无损)。另发现一个坑:aria2 配置里有 enable-rpc=true(6800 端口),同一时刻只能跑一个 aria2 实例——并发调用第二个会绑定失败秒退;另外配置里的下载目录会覆盖当前目录,用 -d 显式指定才稳妥。

    坑 5:中文填充的"名义上下文"和实际 token 数差 47%

    症状:测 262K 满上下文时,标称 131K 的测试集实际打进去 19.2 万 token,直接被服务端 400 拒绝——不是引擎的问题,是测试脚本按"每行 18 token"估算、中文实际每行 26+ token。
    修复:按实测比例(×1.47)反推目标值重测。这也是所有做上下文测试的人都会踩的坑——永远以服务端返回的 prompt_tokens 为准,别信标称值。

    不要做的事

    ❌ 别做 为什么
    在 26.04 上为了 glibc 冲突折腾 gcc 版本/降级系统库 冲突在系统头文件层,换编译器没用;正解是打 CUDA 头补丁(5 分钟)
    给官方源硬扛慢速下载 换国内源 + SHA256 校验,600 倍速度差
    看到显存 97% 就断定"开不了大上下文" 97% 是设计(缓存填满换速度),262K 实测只多占 1% 缓存
    跑 setup.sh --setup 改设置时不带 --model 它会把流程理解成"装新模型",自动下推荐档(我这边撞到它自动开始下 IQ3_XXS 76GB,幸好及时终止清理)
    60GB 内存机硬上 IQ3_S / 强行 512K 内存会贴边/换页,首答从 0.4 秒变分钟级;262K 是这台机器的甜蜜点
    把 --ple-io ram(锁页)当必开项盲目抄 那是双卡大内存机的优化;我 60GB 机器装不下(专家+PLE 会爆),且社区 A/B 实测 SSD 版反而略快

    复现附录与未测项

    复现清单(版本锁定):

    组件 版本/来源
    引擎 Strata v0.1.39(GitHub 源码编译)
    模型 ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF,IQ2_XS 档(ModelScope 同源下载)
    Web UI http://127.0.0.1:8080(Chat/Monitor/About)
    API http://127.0.0.1:8080/v1(OpenAI 兼容;模型名任意)
    关键参数 131K 配置自动生成;262K 仅改 --max-context 一处
    实测脚本 官方 needle_bench.py + 自建 streaming 计时基准(TTFT 首 token 时间戳法)

    未测项(诚实揭露):

    1. 小时级长稳没跑——目前是"4 连发 24.5 万 token 零崩溃 + 当晚持续可用",跟生产级长稳还有距离;
    2. 表格里所有 decode 数据来自复述型任务(推测解码友好,数字偏乐观)——代码/agent 任务的真实速度未单独测 → 已补测(10-06 晚,见文末「晚间更新」):真代码 agent 任务 13.3 秒一次通过,折算 ~155 t/s;
    3. IQ2_XS 在长程 agent 任务上是否有社区所说的"过度思考/返工"现象——未验证(这是更激进量化的已知风险区,我暂时都用于对话和长文);
    4. 视觉(图片输入)没开——32GB 卡开视觉会占 ~1.4GB 显存,我纯文本用不上;
    5. --calibrate(官方 NVIDIA 自动调参)没跑——据说还能再快几个 %,留作下次折腾。

    🔁 2026-10-06 晚间更新:agent 对打补测 + 我把原来的主力撤了

    补测:真代码 agent 任务,Strata vs 原主力 27B

    表 3 的数据是复述型任务(我当时自己就标注了「数字偏乐观、agent 任务未测」)。晚上把这个未测项补上了——两个模型跑同一道真实的 agent 题:

    题目:实现一个线程安全的 LRU + TTL 缓存模块(自动过期、异常校验),并自带 pytest 测试。
    协议:同一提示词、temperature=0、两边都开 medium 思考(各按自己的接口形态)、交付给同一套隐藏验收测试(模型看不到)+ 最多两轮反馈修复。
    测法:端到端计时(发请求→完整响应)、服务端 usage 计数、reasoning_content 字符数,全自动采集。

    表 7 · agent 对打(同题同协议)

    维度 Strata IQ2_XS(125B) 原主力 27B NVFP4
    验收结果 ✅ 一次通过(+自测全绿) ✅ 一次通过(+自测全绿)
    端到端耗时 13.3 秒 91.2 秒(6.9×)
    输出量 2,057 tokens 4,494 tokens
    思考量 1,021 字符 6,205 字符(6.1×)
    折算吞吐 ~155 t/s ~49 t/s
    产物质量 教科书级(OrderedDict + 锁 + 惰性过期) 教科书级(同构实现,注释更密)

    两点观察:

    1. 质量打平:两边都一次过隐藏验收,实现方式惊人地相似;125B 的 IQ2_XS 没有出现任何「量化过头」的迹象(至少这一题)。
    2. 差距比 benchmark 更大:agent 是「多轮往返」模式——同样跑 20 轮的任务链,27B 要 30 分钟,Strata 只要 4 分半;再加上 262K vs 131K 的上下文差距,长会话优势只会更明显。27B 那个「思考啰嗦」的老毛病(6.1 倍思考量)在这种对比下被彻底放大了。

    ⚠️ 诚实声明:n=1、单题中等复杂度、超长任务链未测——这是方向性结论,不是终审。但它是真代码 + 隐藏验收,比复述型任务可信得多。

    顺便:原 27B 主力退役

    对打当晚就做了决定:SGLang 27B / A3B 全部退役,Strata 升为主力。动作:

    • 27B / A3B / 投机解码草稿模型全部删除——释放 46.6GB 磁盘(想回来随时能重下,源都在)
    • Strata 配了 systemd 服务(不开机自启)、接入一键切换脚本(显存互斥自动处理)
    • 在一台 32GB 显存的机器上,单卡近 190 tok/s 的 125B 大过 27B——2026 年的本地部署格局是真变天了

    一句话总结:125B 级别的模型,2026 年真的可以在单张 32GB 游戏卡上跑到近 190 tok/s、开满 262K 上下文、零崩溃——这不是"能跑"的 Demo,是日常可用的生产力。感谢 Niko1221 写出这个引擎,也感谢社区把坑都趟平了。


    *本文所有数据来自作者机器实测(2026-10-06)


  • RTX PRO 4500 32G 跑 Qwen3.8-27B:Unsloth Desktop 默认参数 + MTP,2 槽位 × 150K,短上下文 54–64 t/s(GSP 篇续集,附完整配置)
    清风明月清 清风明月
    LLM讨论区 rtxpro4500 qwen-27b mtp

    RTX PRO 4500 32G 跑 Qwen3.8-27B:Unsloth Desktop 默认参数 + MTP,2 槽位 × 150K,短上下文 54–64 t/s(GSP 篇续集,附完整配置)

    平台:Linux(Ubuntu)/ llama.cpp(Unsloth Desktop 0.1.801 生成参数)/ NVIDIA RTX PRO 4500 Blackwell 32GB
    模型:Qwen3.8-27B-UD-Q4_K_XL(Unsloth Dynamic v3.0,17.56GB)+ mmproj-F16(0.88GB)
    配置:2 并行槽位 / 153856 ctx / MTP n-max 2 / Flash Attention / KV unified(q8_0:K=Q8_0 + V=Q8_0)
    日期:2026-08-21(含全天 MTP 接受率统计 195 次请求 + 高上下文压测)
    上一篇:《Qwen3.8-27B llama.cpp 部署实测与 Blackwell GSP 崩溃分析》(topic/1222),本篇是同一张卡的另一套日常配置,两篇对照着看。

    这张 RTX PRO 4500 买来就是为了跑本地 LLM,上篇踩了 GSP 崩溃的坑,折腾了不少。后来翻了论坛上各位大神的帖子(5070 Ti、双 3090、7900 XTX 的实测),又研究了 Unsloth 的桌面软件(口碑不错,会根据不同硬件自动生成初始参数)。拿到它的默认参数后,在实机上慢慢调,先加 MTP,再调 KV 量化,一步一步来。现在这套配置跑了一段时间,貌似不怎么崩了,分享给大家参考。

    一、先说结论

    • 上一帖是「单槽位 + 128K + K4V4」的稳定性向配置(67.2 t/s 压测均速)。这次换了 Unsloth Desktop 0.1.801 自动生成的默认参数 + 手动加 MTP,2 槽位 × 150K 日常向配置:短上下文平均 54.6 t/s(45.4–64.1),71K 上下文 18.6–41.1 t/s。

    • MTP 接受率 72.87%(195 次请求全天统计),平均每次验证步骤实际产出 2.55 个 token,理论加速上限 ~2.5×,实测相对关 MTP(24.5 t/s)加速 2.2–2.6×,效率约 89%。

    • Unsloth Desktop 的自动参数直接可用,我只手动加了 2 行(MTP 开关 + n-max),没手调其它参数。32GB 卡跑 2 槽位 × 150K 全层 GPU,显存 ≈25.4GB,余量 ~6.6GB(q8_0 KV)。

    • 白话:MTP = 模型自带的「草稿头」先猜 2 个 token,主模型一次前向全部验证,猜中就白拿。猜中率 72.87%,等于每步白捡 1.5 个 token,速度直接翻 2 倍出头。

    • 注意:2 小时 0 崩溃 ≠ 长期稳定,Blackwell GSP 固件 bug(Xid 62/8/154)还在,根因分析与规避手段见上一篇,本篇不重复。

    二、模型参数卡(官方 config.json × GGUF 头双重核对)

    以下数据来自 HuggingFace 官方 Qwen/Qwen3.8-27B 的 config.json,并与本地 GGUF 头部元数据逐项核对一致:

    | 项 | 值 |
    | 架构 | Qwen3_5ForConditionalGeneration(model_type: qwen3_5),原生多模态:文本 + 图像 + 视频 |
    | 参数量 | 27B(dense,非 MoE),BF16 原生 |
    | 层数 | 64 主层 + 1 MTP 层(GGUF block_count=65) |
    | 注意力 | 混合式:48 层线性注意力(Gated DeltaNet:conv k=4,16 key heads × 128 / 48 value heads × 128,SSM fp32)+ 16 层全注意力(full_attention_interval=4) |
    | 全注意力细节 | 24 heads / 4 KV heads(GQA 6:1),head_dim 256,partial rotary 0.25,rope_theta 1e7,mRoPE 交错(多模态 RoPE) |
    | 隐层 / FFN | hidden 5120 / FFN 17408(SiLU + 输出门) |
    | 上下文 | 原生 256K(max_position_embeddings 262144) |
    | MTP | mtp_num_hidden_layers=1,共享 embeddings(无独立 embed 表),即 llama.cpp 的 --spec-type draft-mtp |
    | 词表 | 248,320 |
    | 视觉塔 | ViT depth 27 / hidden 1152,image_token 248056 / video_token 248057 |
    | 量化(本卡) | UD-Q4_K_XL(Unsloth Dynamic v3.0 混合精度,imatrix 校准),17.56GB,≈5.2 BPW;mmproj-F16 0.88GB |
    | 仓库 | 官方 Qwen/Qwen3.8-27B(apache-2.0)/ 量化 unsloth/Qwen3.8-27B-GGUF |

    两个和本篇速度直接相关的点:只有 16 层全注意力存 KV cache(线性注意力层只占固定大小状态),所以 150K 上下文的 KV 在 f16 下 ~10GB、q8_0 下 ~5.4GB,2 槽位才塞得下;MTP 头共享 lm_head,不额外占权重。

    三、硬件 / 软件环境

    | 项 | 配置 |
    | 显卡 | NVIDIA RTX PRO 4500 Blackwell 32GB(sm_120,GB202,显存带宽 896 GB/s) |
    | 系统 | Ubuntu(Linux) |
    | 框架 | llama.cpp,Unsloth Desktop 0.1.801 安装并生成启动参数 |
    | 模型 | Qwen3.8-27B-UD-Q4_K_XL.gguf(17.56GB)+ mmproj-F16.gguf(0.88GB) |
    | 服务方式 | systemd 服务 llama-qwen-27B.service,端口 8000 |

    四、完整配置(可直接复制)

    Unsloth Desktop 自动生成基础参数,我手动只加了 MTP 两行(--spec-type / --spec-draft-n-max):

    # systemd service: llama-qwen-27B.service
    llama-server \
      -m ~/models/Qwen3.8-27B/Qwen3.8-27B-UD-Q4_K_XL.gguf \
      --mmproj ~/models/Qwen3.8-27B/mmproj-F16.gguf \
      --alias Qwen3.8-27B \
      --port 8000 \
      --parallel 2 \
      --flash-attn on \
      --no-context-shift \
      -c 153856 \
      -ngl -1 \
      --fit off \
      --metrics \
      --slot-save-path ~/.unsloth/studio/cache/llama-slots \
      --kv-unified \
      --jinja \
      --spec-type draft-mtp \
      --spec-draft-n-max 2 \
      --reasoning on --reasoning-preserve
    

    关键参数说明

    | 参数 | 为什么 |
    | --spec-type draft-mtp / --spec-draft-n-max 2 | MTP 投机解码,每步猜 2 个。参数名别写旧名 mtp(启动直接失败);n≥3 在 Blackwell 上收益递减(上篇实测) |
    | --parallel 2 | 2 槽位并行,主对话 + 后台任务同时跑,互不排队 |
    | -c 153856 | ~150K 上下文。模型原生 256K,但 ctx 越长单次 kernel 耗时越接近 GSP 看门狗阈值(上篇),150K 是 2 槽位的显存/稳定平衡点 |
    | --kv-unified | 多槽位共享统一 KV 内存池,避免每槽位独立预分配的碎片浪费 |
    | --flash-attn on | 必须开。关闭后 attention kernel 更慢,既掉速又更贴近 GSP 7 秒看门狗阈值 |
    | --no-context-shift | 上下文超限时直接报错而不是静默截断/移位,agent 场景不接受静默降级 |
    | --reasoning on --reasoning-preserve | 保留思考 token,多轮 agent 场景思考链不丢 |
    | -ngl -1 / --fit off | 全层上 GPU(32GB 放得下),禁用自动压缩 |
    | --slot-save-path | Unsloth Desktop 的槽位状态缓存,桌面端重开可恢复会话 |
    显存账本(2 槽位 × 150K,当前 q8_0 KV): 权重 17.56GB + mmproj 0.88GB + KV(16 层全注意力 × 153856 token × 34KB/token)≈ 5.4GB + 线性注意力状态与计算缓冲 ≈ 0.6GB ≈ 25.4GB / 32GB,余量 ~6.6GB(切换后实测比 f16 省 3.6GB)。

    五、实测数据

    测法:短上下文 = 日常真实请求,speed 取自 systemd journalctl 实时日志(llama-server 每请求一条 prompt eval + eval 统计);高上下文 = 预置 ~71K token 填充后生成 4096 token;接受率 = journalctl 的 Draft Acceptance 行,全天 195 次请求全量统计,非抽样。

    5.1 短上下文(日常交互,2026-08-21 14:33–14:36)

    | 时间 | 生成 tokens | 耗时 (ms) | 速度 (t/s) |
    | 14:33:42 | 2588 | 45254 | 57.17 |
    | 14:34:06 | 1160 | 23092 | 50.19 |
    | 14:34:29 | 1140 | 21017 | 54.19 |
    | 14:34:45 | 873 | 14390 | 60.60 |
    | 14:34:57 | 488 | 10242 | 47.55 |
    | 14:35:06 | 394 | 7984 | 49.22 |
    | 14:35:21 | 838 | 13048 | 64.14 |
    | 14:35:35 | 811 | 12853 | 63.02 |
    | 14:35:56 | 752 | 16555 | 45.36 |
    | 14:36:07 | 525 | 9589 | 54.65 |

    平均 54.6 t/s,范围 45.36–64.14。 波动主要来自 2 槽位偶发并发与请求长度分布,非性能衰减。(注:本表为 f16 KV 时代数据,切换 q8_0 后短 ctx 实测更高,见 5.5)

    5.2 高上下文压测(~71K ctx 填充 + 4096 生成,2026-08-21 13:14–13:30)

    | 请求 | 上下文 tokens | 生成 tokens | 耗时 (s) | 速度 (t/s) |
    | req 1 | 71280 | 4096 | 220.5 | 18.6 |
    | req 2 | 71764 | 4096 | 99.5 | 41.1 |
    | req 4 | 71791 | 4096 | 380.6 | 10.8(离群,见踩坑 #4) |

    71K 上下文下 18.6–41.1 t/s,衰减明显但可用。高 ctx 下 MTP 收益缩小(验证步骤变贵),这是混合注意力模型的通性,不是配置问题。

    5.3 MTP 接受率(全天 195 次请求)

    • 平均接受率 72.87%,范围 62.7%–97.6%
    • 平均每次验证步骤产出 2.55 token(1 个主模型 bonus + 1.55 个被接受的草稿)
    • 接受率与内容强相关:结构化输出(JSON/代码/固定格式)常 93%–97.6%,自由长文本 62.7%–77%

    抽样 10 次:

    | 时间 | 接受率 | 接受/生成 | 每步 token |
    | 14:33:42 | 87.57% | 1648/1882 | 2.75 |
    | 14:34:06 | 71.95% | 685/952 | 2.44 |
    | 14:34:29 | 76.28% | 688/902 | 2.53 |
    | 14:34:45 | 93.42% | 568/608 | 2.87 |
    | 14:34:57 | 62.73% | 271/432 | 2.25 |
    | 14:35:06 | 67.26% | 226/336 | 2.35 |
    | 14:35:21 | 96.33% | 551/572 | 2.93 |
    | 14:35:35 | 97.64% | 537/550 | 2.95 |
    | 14:35:56 | 67.71% | 432/638 | 2.35 |
    | 14:36:07 | 92.94% | 342/368 | 2.86 |

    5.4 上下文衰减阶梯(8K–128K,2026-08-21 补测)

    上下文 实际 token Prefill (t/s) 生成速度 (t/s) 相对基线
    ~2K(日常对话) 37–49 ~220 72.4 100%
    8K 8,222 1,498 70.7 97.7%
    16K 16,414 1,455 67.8 93.6%
    32K 32,798 1,330 64.2 88.7%
    64K 65,556 1,189 58.3 80.5%
    128K 131,076 873 51.7 71.4%

    测法:slot 0、MTP n2、reasoning off(纯速度测量)、每级预热后取稳态值(f16 KV 下测得)。衰减是渐进的,32K 以内基本无感(<12%),64K 起有感(~20%),128K 掉 ~29% 仍有 52 t/s。"明显变慢"的分水岭约在 64K–100K。

    5.5 q8_0 KV 量化实测(2026-08-21 切换后)

    指标 f16(之前) q8_0(现在) 变化
    VRAM 占用 ~29 GB ~25.4 GB -3.6 GB
    显存余量 ~3 GB ~6.6 GB +3.6 GB
    32K 上下文生成速度 64.2 t/s 68.4 t/s +6%
    GPU 利用率(生成时) 高 93-100% 正常
    CPU 占用 正常 ~100%(单核) 正常

    q8_0 全 8bit KV 切换后 VRAM 从 ~29GB 降至 ~25.4GB(省 3.6GB),32K 生成速度 68.4 t/s 比 f16 还快 6%。踩坑记录:先试过 q8v4(K=Q8+V=Q4)不对称方案,但 llama.cpp 的 flash attention 没有 K/V 混合类型的 CUDA kernel,运行时整体回退到 CPU——GPU 利用率掉到 0-25%、CPU 8 核满载、32K 上下文速度从 64 t/s 崩到 15.8 t/s。关键结论:K/V cache 必须对称——K4V4(Q4+Q4)实测 32K=59.1 / 64K=44.4 t/s 完全正常,q8_0(Q8+Q8)也正常。切换 KV 量化后务必跑长上下文验证(短 ctx 测不出来)。

    5.6 DFlash2 块扩散投机解码对比实测(2026-08-21)

    DFlash2 是 Z-Lab 的块扩散草稿模型(Inco 发布 Qwen3.8-27B 专用草稿头),llama.cpp 支持 --spec-type draft-dflash(本机 commit 5ecbe1a)。用独立测试服务(端口 8001,q8_0 KV 与生产一致)实测对比:

    上下文 MTP n2(生产) DFlash2(测试) 胜者
    短 ctx 72.4 t/s 47.3 t/s MTP(快 53%)
    32K 64.2 t/s 54.0 t/s MTP(快 19%)
    64K 58.3 t/s 45.9 t/s MTP(快 27%)
    64K 衰减 19% 37% MTP 更平缓
    GPU 利用率 93-100% 93-97% 平

    结论:本卡上 DFlash2 全面落后 MTP n2,不值得切换。 根因:Q4_K_M 草稿接受率仅 26.8%(vs MTP 72.87%),块扩散每步验证 8 个 token 的前向开销没被低接受率赚回来;短 ctx 下验证成本占比更高所以最慢。DFlash2 官方说明为无损投机(greedy 输出与主模型一致),质量无虞,只是速度不划算。

    备注:--hf-repo-draft 在本构建有 bug(草稿路径解析为空),需用 --model-draft 指定本地 GGUF 路径。

    六、MTP 加速账:从接受率到 2.2×

    n-max 2 时每步产出 = 1 + p₁ + p₁·p₂(p₁、p₂ 为两个草稿位置的条件接受概率),实测均值 2.55 token/步。验证 3 个 token 的前向比单 token 略贵,理论上限约 2.5×。

    | 配置 | 短上下文速度 | 相对无 MTP |
    | MTP n-max 2(本篇,2 槽位 150K) | 54.6 t/s(均值) | 2.23×(范围 1.85–2.62×) |
    | MTP 关闭(同卡实测 2026-08-19) | 24.5 t/s | 1× |
    | 理论上限(2.55 token/步) | — | ~2.5× |

    实测 2.23× 达到理论上限的 ~89%,剩余 11% 就是验证开销 + 偶尔的整组拒绝。这个效率对 dense 模型来说很健康(社区 MoE 模型 MTP 常见 1.5–1.7×,见 topic/1207 注)。

    七、社区跨卡对照(同模型 Qwen3.8-27B,均为本版论坛实测帖)

    | 卡 | 框架 | 量化 | 配置 | 速度 | 出处 |
    | RTX PRO 4500 32G(本篇) | llama.cpp | UD-Q4_K_XL | 2 槽位 150K,MTP n2 | 54.6(短 ctx 均值) | 本帖 |
    | RTX PRO 4500 32G(上篇) | llama.cpp | UD-Q4_K_XL | 1 槽位 128K,MTP n2,K4V4 | 67.2(1h 压测均值) | topic/1222 |
    | RTX 5070 Ti 16G | llama.cpp | IQ4_XS | 1 槽位 32K | 38–43 | topic/1207 |
    | 双 3090 24G NVLink | vLLM | AWQ-INT4 | 262K,MTP n3 | ~130(工具调用) | topic/1245 |
    | 7900 XTX 24G | llama.cpp Vulkan | Q4_K_M | 1 槽位 128K | 73.4 | topic/1164 |
    | 7900 XTX 24G | llama.cpp Vulkan | Q4_K_M | 1 槽位 256K,MTP n3,K4V4 | 67 | topic/100 |

    ctx、量化、框架、槽位数都不同,这张表只给量级感:32GB 卡单卡 llama.cpp 路线,短上下文 50–67 t/s 是这个模型在 Blackwell 专业卡上的正常水位。

    关于 topic/100(7900XTX + K4V4)的补充:该帖的 K4V4(Q4+Q4 对称)跑满 256K 正常,与本篇结论互相印证——llama.cpp 对对称 KV 类型(K4V4 或 q8_0)的支持与显卡无关,NVIDIA CUDA 下对称 K4V4 同样正常(本篇实测 32K=59.1 / 64K=44.4 t/s)。q8v4(K=Q8+V=Q4)混合类型回退 CPU 是 llama.cpp 通病,AMD Vulkan 后端同样不应混用。

    八、踩坑与经验

    1. MTP 参数名:--spec-type draft-mtp,写旧名 mtp 直接启动失败(日志里一句 spec 相关行都没有就是没启用);n-max 2 是 Blackwell 甜点位,n≥3 验证开销追上接受率收益。
    2. Unsloth Desktop 自动参数直接可用:0.1.801 生成的 flash-attn / kv-unified / no-context-shift / fit off 组合在 32GB 卡上开箱即稳,本次唯一手改就是 MTP 两行。桌面端小白流和手搓 systemd 流殊途同归。
    3. 2 槽位 × 150K 的显存红线 ≈29GB:再往上(200K 或 3 槽位)就吃紧。优先 q8_0(--cache-type-k q8_0 --cache-type-v q8_0,质量几乎无损,省 ~3.6GB);q4_0(K4V4)不建议(8.3% 输出相似度质量悬崖 + CPU 回退风险)。
    4. req4 的 10.8 t/s 是离群点:380 秒跑 4096 token,量级对应 GSP 看门狗心跳窗口 + 2 槽位争抢,不作外推依据;遇到单次掉速先看 journalctl 有没有 NVRM/Xid 行,有就是上篇那个 bug,没有就是槽位争抢。
    5. 稳定性预期管理:本篇 08-21 13:45 启动、0 崩溃、稳定 2 小时——但 GSP 固件 bug(Xid 62/154/79 或静默硬挂,需断电恢复)没修,无人值守批量推理必须挂看门狗 + 断电恢复(或留请求间隔 / 关 GSP),详见上篇根因章节。
    6. 接受率是内容函数不是配置函数:JSON/代码类结构化输出接受率 93%+,自由文本 63% 上下。如果你的 agent 负载以结构化为主,MTP 收益只会比本篇更高。
    7. K/V cache 必须对称(重要):llama.cpp 的 flash attention 不支持 K/V 混合类型(如 K=Q8_0+V=Q4_0),会整体回退到 CPU(GPU 利用率 0-25%、CPU 8 核满载、32K 速度暴跌 4 倍)。对称组合 K4V4(Q4+Q4)和 q8_0(Q8+Q8)都正常。切换 KV 量化后务必跑 32K/64K 长上下文验证(短 ctx 测不出来)。

    九、KV 量化质量对比与下一步

    质量影响(网测数据)

    InventiveHQ 在同模型上做了 f16 / q8_0 / q4_0 KV cache 直接对比(8K 上下文):

    KV 类型 输出相似度(vs f16) 评价
    f16(基准) 100% —
    q8_0 81.6% 安全交易,质量损失可控
    q4_0 8.3% 质量悬崖,回答完全不同

    Particula.tech 补充:Qwen 系列在 q8_0 下 KL 散度 < 0.04(极低),q4_0 损失真实且模型相关。来源:InventiveHQ / Particula

    对本模型的特殊考虑:Qwen3.8-27B 只有 16/65 层存 KV(48 层线性注意力是 fp32 无损状态),质量影响理论上比同参数纯 Transformer 小得多。

    社区实际使用反馈:有用户在 7900XTX 24G 上用 K4V4(Q4_0 KV)跑满 256K 上下文做代码生成,评价"质量不比在线 API 差"(topic/100)。这与 InventiveHQ 的 8.3% 相似度数据存在张力——可能的原因:(1) 8.3% 是文本相似度指标,捕捉到了措辞/表述差异,但代码功能正确性不受影响;(2) Qwen3.6-27B 与 Qwen3.8-27B 架构不同,质量衰减可能不同;(3) 主观感受难以捕捉长上下文末尾的细微召回丢失。结论:K4V4 对代码生成可能"够用",但对长文档精确召回(如 needle-in-haystack)仍有风险,q8_0 是更稳妥的选择。

    q8_0(K=Q8, V=Q8)分析(q8v4 已弃用)

    q8_0 全量 8bit KV:每 token 34KB(vs f16 64KB / q4_0 18KB)。曾试过 q8v4(K=Q8+V=Q4)不对称方案,但 llama.cpp 的 flash attention 不支持 K/V 混合类型,整体回退 CPU(GPU 0-25%、CPU 8 核满载、32K 崩到 15.8 t/s),不可用。对称组合都正常:K4V4(Q4+Q4)32K=59.1 / 64K=44.4 t/s,q8_0(Q8+Q8)32K=68.4 t/s。

    方案 每 token KV 150K 池 总显存 余量
    f16(现状) 64KB 9.9GB ~29GB ~3GB
    q8_0(已上线) 34KB 5.4GB ~25.4 GB(实测) ~6.6 GB
    q4_0(K4V4) 18KB 2.8GB ~21.8GB ~10.2GB

    为什么不推荐 q8v4 不对称方案:理论上 Key 用 Q8 保留注意力模式精度、Value 用 Q4 省显存很诱人,但 llama.cpp 的 flash attention 只支持对称 KV 类型,K=Q8+V=Q4 混合会整体回退 CPU(GPU 利用率 0-25%、CPU 8 核满载、32K 速度崩到 15.8 t/s),实际不可用。K/V 类型必须对称(K4V4 或 q8_0 均可,速度都正常)。

    (补充:q8v4 在非 Unsloth 配置下崩过,但归因是 GSP 固件 bug 的负载模式触发,与量化格式无因果。)

    下一步建议

    1. 日常已切换 q8_0(K=Q8_0 + V=Q8_0):VRAM ~25.4GB / 余量 ~6.6GB / 32K 上下文 68.4 t/s,标准版与免审查版均已生效。
    2. 需要省显存时首选 q8_0(--cache-type-k q8_0 --cache-type-v q8_0),质量几乎无损,多 ~4.7GB 余量,够冲 200K 或第 3 槽位。
    3. q8v4 已弃用:K/V 混合类型(Q8+Q4)触发 CPU 回退(GPU 闲置、CPU 满载、速度暴跌 4 倍),不要用;K/V 类型保持对称(K4V4 或 q8_0)。
    4. q4_0(K4V4)仅在"塞不下"时考虑:8.3% 输出相似度是质量悬崖,即使本模型有 16 层优势也不建议轻易尝试。
    5. 待验证:q8_0 日常使用质量观察;n-max 3 在 2 槽位下的接受率/速度拐点(DFlash2 已实测淘汰);GSP 修复(等 NVIDIA)后再谈 200K+。

    数据来源:systemd journalctl(MTP 接受率 195 次请求全量)+ 高 ctx 压测脚本 + 长上下文 CPU 回退验证;模型参数来自官方 config.json 与 GGUF 头部元数据双重核对。


  • DeepSeek Harness 添加本地 Qwen3.8-27B 模型要这样控制思考深度,亲测有效,也许你们都已经成功了,但我今天才认真考虑解决这个问题,主要是太难等了!
    清风明月清 清风明月
    LLM讨论区 dsharness qwen-27b 本地模型

    DeepSeek Harness 添加本地 Qwen3.8-27B 模型完整指南(llama.cpp × dsh)

    四档推理深度(关/低/中/高)全量生效实测 · 可直接复制配置 · 踩坑记录

    这篇是写给另一台机器上的 Hermes 看的操作文档:照着做就能把本地 Qwen3.8-27B(含 UC 版)完整配置进 DeepSeek Harness(dsh),四档推理深度全部真实生效。

    前提:llama.cpp 的 llama-server 已经在 127.0.0.1:8000 跑起来(--jinja --reasoning on --reasoning-preserve),dsh web 已装好。本文只讲「把模型加进 dsh」这一步。


    目录

    1. 先给结论
    2. 名词白话解释
    3. 最终配置(可直接复制)
    4. 四档推理深度机制(为什么必须这么配)
    5. 踩过的坑(4 个,都流了血)
    6. 验证清单(照做一遍)
    7. 附录:完整操作流程

    1. 先给结论

    项目 结果
    配置位置 ~/.dsh/settings.yaml 的 llm-pi-ai.providers 下加 provider
    模型条目 qwen3.8-27B + qwen3.8-27B-UC 两个
    推理深度 关/低/中/高 四档全部真实生效(抓包验证)
    关键 光配 reasoningEfforts 不够,必须配 compat 块
    一句话 reasoning_effort: "none" 关不掉 Qwen3.8 的思考,必须走 chat_template_kwargs.enable_thinking: false

    最终配置效果(tcpdump 抓包实测):

    • 关 → enable_thinking: false(思考彻底关闭,秒回)
    • 低 → enable_thinking: true, reasoning_effort: "low"(思考最简短)
    • 中 → enable_thinking: true, reasoning_effort: "medium"
    • 高 → enable_thinking: true, reasoning_effort: "xhigh"(官方最高档)

    2. 名词白话解释

    名词 白话解释
    dsh DeepSeek Harness,DeepSeek 官方开源的 agent harness,dsh web 是它的 Web UI(本机 127.0.0.1:3080)
    llama.cpp / llama-server 本地跑 GGUF 模型的推理引擎,提供 OpenAI 兼容 API(/v1/chat/completions)
    reasoningEfforts dsh 里给每个模型声明的「推理深度档位 → 端点参数」映射表
    thinkingFormat dsh 的 compat 配置,决定「把推理档位翻译成哪种端点的请求格式」
    chat_template_kwargs llama.cpp 端点认识的请求字段,Qwen3.8 的 jinja 模板用 enable_thinking 控制是否思考
    enable_thinking Qwen3.8 模板真正的思考开关。false = 不思考,true = 思考

    3. 最终配置(可直接复制)

    打开 ~/.dsh/settings.yaml,在 llm-pi-ai.providers 下加入(或合并到已有的 qwen provider 里):

    llm-pi-ai:
      providers:
        qwen-local:
          displayName: qwen-local
          apiKeyEnv: QWEN_LOCAL_API_KEY        # 任意命名,~/.dsh/.env 里加 QWEN_LOCAL_API_KEY=local(本地不校验)
          api: openai-completions
          baseURL: http://127.0.0.1:8000/v1
          models:
            - id: qwen3.8-27B
              name: qwen3.8-27B
              contextWindow: 153600
              maxTokens: 32768
              reasoningEfforts:
                'off': none
                low: low
                medium: medium
                high: xhigh          # ⚠️ 必须是 xhigh!Qwen3.8 模板不认 high,会直接 500
              compat:
                thinkingFormat: chat-template    # ⚠️ 必须是 chat-template,不是 qwen-chat-template!
                chatTemplateKwargs:
                  enable_thinking: {$var: thinking.enabled}
                  reasoning_effort: {$var: thinking.effort, omitWhenOff: true}
                  preserve_thinking: true
            - id: qwen3.8-27B-UC
              name: qwen3.8-27B-UC
              contextWindow: 153600
              maxTokens: 32768
              reasoningEfforts:
                'off': none
                low: low
                medium: medium
                high: xhigh
              compat:
                thinkingFormat: chat-template
                chatTemplateKwargs:
                  enable_thinking: {$var: thinking.enabled}
                  reasoning_effort: {$var: thinking.effort, omitWhenOff: true}
                  preserve_thinking: true
    

    然后:

    # 1. 备份
    cp ~/.dsh/settings.yaml ~/.dsh/settings.yaml.bak.$(date +%Y%m%d-%H%M%S)
    
    # 2. .env 补 apiKeyEnv 对应的变量(本地端点不校验 key 值,任意非空即可)
    echo 'QWEN_LOCAL_API_KEY=local' >> ~/.dsh/.env
    
    # 3. 默认模型指向本地(可选,按需)
    #    agent-default-model:
    #      provider: qwen-local
    #      model: qwen3.8-27B-UC
    #      reasoningEffort: 'off'     # ⚠️ off 必须带引号!
    
    # 4. 重启
    systemctl --user restart dsh-web.service
    sleep 6
    systemctl --user is-active dsh-web.service        # 期望 active
    curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:3080/   # 期望 200
    

    4. 四档推理深度机制(为什么必须这么配)

    4.1 Qwen3.8 模板只认 xhigh / medium / low

    从 Qwen3.8 GGUF 里直接提取的 jinja 模板源码:

    {%- if enable_thinking is undefined or enable_thinking is true %}
        {%- set resolved_reasoning_effort = reasoning_effort|default('xhigh') %}
        {%- if resolved_reasoning_effort not in ('xhigh', 'medium', 'low') %}
            {{- raise_exception('Unexpected reasoning effort ' ~ reasoning_effort ~ '. Supported types are xhigh (default), medium, and low.') }}
        {%- endif %}
    
    • none 不是合法档位 → 顶层 API 传 reasoning_effort: none 时被 llama.cpp 归一化剥掉(不传给模板),模板走默认 xhigh 满档思考——实测 none 思考最长(4631 字符)
    • high 不是合法档位 → 若直接把 high 塞进 chat_template_kwargs.reasoning_effort 传给模板,模板 raise_exception → HTTP 500(实测确认)
    • 所以 UI 四档映射:关 → enable_thinking: false;低 → low;中 → medium;高 → xhigh

    4.2 为什么必须用 chat-template 而不是 qwen-chat-template

    dsh 源码(pi-ai 的 openai-completions.js)里有两个 Qwen 分支:

    // qwen-chat-template 分支:只发开关,不带 effort → 低/中/高三档没区别!
    else if (compat.thinkingFormat === "qwen-chat-template" && model.reasoning) {
        params.chat_template_kwargs = {
            enable_thinking: !!options?.reasoningEffort,
            preserve_thinking: true,
        };
    }
    // chat-template 分支:走 buildChatTemplateKwargs → 支持 $var 占位符,带 effort!
    else if (compat.thinkingFormat === "chat-template" && model.reasoning) {
        const chatTemplateKwargs = buildChatTemplateKwargs(model, options, compat);
        ...
    }
    

    qwen-chat-template 分支只发 enable_thinking 开关(低/中/高都变成「开思考」+ 默认 xhigh 满档),必须用 chat-template 分支 + chatTemplateKwargs 里的 $var: thinking.effort 才能把档位传下去。

    4.3 $var 是 dsh 官方占位符

    chatTemplateKwargs 的 value 支持两种写法:

    • 字面量:string / number / boolean / null
    • 占位符:{$var: "thinking.enabled"} 或 {$var: "thinking.effort", omitWhenOff: true}

    thinking.effort 解析逻辑(dsh 源码 resolveChatTemplateKwargValue):

    • 有 effort(低/中/高)→ 查 thinkingLevelMap → 发对应值
    • off → omitWhenOff: true 让它不发(思考由 enable_thinking: false 关掉)

    5. 踩过的坑(4 个,都流了血)

    坑 1:光配 reasoningEfforts 关不掉思考(off 无效)

    症状:dsh 里把推理深度设「关」,模型还在不停思考。
    根因:dsh 走通用分支发 reasoning_effort: "none",但 Qwen3.8 模板不认 none → 默认 xhigh 满档思考。实测 reasoning_effort=none 思考最长(4631 字符)。
    修复:配 compat 走 chat-template 分支,发 chat_template_kwargs.enable_thinking: false(实测思考归零)。

    坑 2:reasoning_effort: {} 空对象 → 整个 provider 挂掉,模型从 dsh 消失

    症状:NO_ADAPTER: no adapter registered for provider "qwen-local",dsh 里模型全没了。
    根因:dsh 的 schema(chatTemplateKwarg)只接受 string/number/boolean/null/带必填 $var 的对象。空对象 {} 校验失败 → 整个 provider 被拒。
    修复:reasoning_effort 用 {$var: thinking.effort, omitWhenOff: true}。
    血泪:改完必须验证——dsh --profile headless '测试' 能回话才算真活。

    坑 3:PyYAML 把 off 重写成布尔 false

    症状:用 Python yaml 库改 settings.yaml 后,reasoningEffort: off 变成 reasoningEffort: false。
    根因:PyYAML 按 YAML 1.1 解析,off/on/yes/no 是布尔关键字;dsh 用 js-yaml 按 YAML 1.2 解析,off 是字符串。
    修复:写回时显式带引号 'off',改完 grep 检查 reasoningEffort 行。
    血泪:'off' 键也要带引号——PyYAML 会把 off: none 的键 off 解析成布尔 False。

    坑 4:high 档直接 500

    症状:选「高」档,请求 500 错误。
    根因:模板只认 xhigh/medium/low,high 触发 raise_exception。
    修复:reasoningEfforts.high 映射到 xhigh(官方最高档)。


    6. 验证清单(照做一遍)

    # 1. 服务健康
    systemctl --user is-active dsh-web.service          # active
    curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:3080/   # 200
    
    # 2. headless 实测(能回话 = provider 真活着)
    dsh --profile headless '27乘以43等于多少?一行答案。'
    # 期望:秒回「1161」这类答案(不是 NO_ADAPTER)
    
    # 3. 四档抓包验证(可选但推荐)
    # 临时改 agent-default-model.reasoningEffort 到 off/low/medium/high 各测一次
    sudo tcpdump -i lo -A -s 0 'tcp port 8000' > /tmp/dsh_cap.txt &
    dsh --profile headless '27乘以43等于多少?'
    grep -o 'chat_template_kwargs[^,}]*' /tmp/dsh_cap.txt
    # 期望:off → enable_thinking:false
    #       低 → reasoning_effort:"low",中 → "medium",高 → "xhigh"
    

    7. 附录:完整操作流程(给执行方 Hermes)

    1. 确认前提:curl -s http://127.0.0.1:8000/v1/models 返回模型列表(llama-server 活着)
    2. 确认 dsh 存在:ls ~/.dsh/settings.yaml + systemctl --user is-active dsh-web.service
    3. 备份:cp ~/.dsh/settings.yaml ~/.dsh/settings.yaml.bak.$(date +%Y%m%d-%H%M%S)
    4. 改配置:按第 3 节 YAML 加入 provider + 模型条目(或合并到已有 provider)
    5. 补 .env:echo 'QWEN_LOCAL_API_KEY=local' >> ~/.dsh/.env(apiKeyEnv 对应变量,本地不校验值)
    6. 重启:systemctl --user restart dsh-web.service
    7. 验证:is-active=active + curl 3080=200 + dsh --profile headless '测试' 回话
    8. 四档验证(可选):按第 6 节抓包确认各档位参数
    9. 收尾:web UI 里能看到模型,选推理深度各档位可切换

    注意:dsh 的 --dump-config 输出 profile 树,不含 llm-pi-ai 的 model 条目——grep 不到模型条目属正常,不能用来验证模型级配置。验证用第 6 节的方法。


    实测日期:2026-08-30 · 环境:Ubuntu + llama.cpp(CUDA 12.9)+ Qwen3.8-27B Q4_K_XL / Q4_K_P · dsh web :3080 · 全文配置均经抓包与 headless 实测验证


  • Qwen3.8-27B llama.cpp 部署实测与 Blackwell GSP 崩溃分析
    清风明月清 清风明月
    LLM讨论区 qwen-27b llama.cpp

    平台:Linux(Ubuntu)/ llama.cpp b10488 / NVIDIA RTX PRO 4500 Blackwell 32GB
    模型:Qwen3.8-27B-UD-Q4_K_XL(Unsloth Dynamic v3.0,17.92GB)
    用途:Hermes Agent 后端主力模型
    日期:2026-08-20(含 1 小时压力测试 + 社区崩溃根因调研)

    一、先说结论

    • 32GB Blackwell 卡跑 Qwen3.8-27B UD-Q4_K_XL,128K 上下文 + MTP 投机解码,稳定可用。
    • 性能:正文吐词 67 t/s(1 小时压测 avg_tps=67.2)。
    • 崩溃根因已定位:不是量化问题、不是 llama.cpp 问题——是 NVIDIA Blackwell GSP 固件已知 bug(GB202 die 通病),社区多卡实证。
    • 128K 上下文是工程折中:200K 实测 59 分钟崩溃,128K 有长期零崩记录。降 ctx 缩短 kernel 耗时→降低 GSP watchdog 触发概率,非根因修复。
    • 根因修复等 NVIDIA:上游已跟踪(NVIDIA/open-gpu-kernel-modules #1080、#1111),无公开 ETA。595-open 是当前唯一可用驱动路径。

    二、硬件 / 软件环境

    项 配置
    显卡 NVIDIA RTX PRO 4500 Blackwell,32 GB(32623 MiB),sm_120,GB202 die
    CPU AMD Ryzen 7 3700X(8C/16T)
    内存 60 GB
    系统 Ubuntu(Linux 7.0.0-29-generic)
    推理框架 llama.cpp b10488(源码编译,CUDA 12.8+)
    驱动 nvidia-open 595.91.07
    服务方式 systemd 用户服务,8000 端口互斥,llm-switch.sh 一键切换

    三、模型来源

    项 值
    仓库 unsloth/Qwen3.8-27B-GGUF
    文件 Qwen3.8-27B-UD-Q4_K_XL.gguf(17.92 GB,4.97 BPW)
    量化 Unsloth Dynamic v3.0,Q4_K 混合精度(359×Q4_K + 96×Q5_K + 43×Q6_K + 353×F32)
    视觉塔 mmproj-F16.gguf(885 MB)
    特点 kingy.ai 首推量化源,同精度比其它 Q4 高 10%+;BPW 4.97(比 Q4_K_M 的 4.84 略高)

    通过 hf download 直连 HuggingFace 下载,SHA256 校验通过。

    四、部署配置

    systemd 用户服务 ~/.config/systemd/user/llama-qwen-27B.service:

    [Unit]
    Description=llama.cpp Qwen3.8-27B UD-Q4_K_XL Service (128K, effort=medium, MTP n-max 2)
    
    [Service]
    ExecStart=%h/llama.cpp/build/bin/llama-server \
      -m %h/models/Qwen3.8-27B/Qwen3.8-27B-UD-Q4_K_XL.gguf \
      --mmproj %h/models/Qwen3.8-27B/mmproj-F16.gguf \
      --alias qwen3.8-27B \
      --host 127.0.0.1 --port 8000 \
      --ctx-size 131072 \
      --n-gpu-layers 99 \
      --flash-attn on \
      --parallel 1 \
      --jinja \
      --no-mmap \
      --ubatch-size 512 \
      --cache-type-k q4_0 \
      --cache-type-v q4_0 \
      --cache-ram 32768 \
      --chat-template-kwargs '{"reasoning_effort": "medium", "preserve_thinking": true}' \
      --reasoning-preserve \
      --temp 0.6 --top-k 20 --top-p 0.95 --min-p 0.0 \
      --spec-type draft-mtp \
      --spec-draft-n-max 2
    
    Environment=CUDA_VISIBLE_DEVICES=0
    Restart=on-failure
    RestartSec=10
    

    管理命令:

    systemctl --user start llama-qwen-27B    # 启动
    systemctl --user stop llama-qwen-27B     # 停止
    systemctl --user status llama-qwen-27B   # 查看状态
    journalctl --user -u llama-qwen-27B -f   # 实时日志
    

    五、1 小时压力测试结果

    测试配置

    项 值
    模型 Qwen3.8-27B-UD-Q4_K_XL(标准版)
    上下文 200K(204800),MTP n-max 2,K4V4 KV cache
    压测方式 每轮 512 token 生成,连续 60 分钟,守护进程独立运行
    总 token 226,816

    结果

    指标 值
    总轮数 446
    成功 443
    失败 3(均为第 444 轮崩溃后的连接拒绝,实为 1 次崩溃事件)
    平均 t/s 67.2
    最低 t/s 10.3(崩溃窗口期)
    最高 t/s 74.2
    崩溃时间 第 444 轮(约 18:38:42,59 分钟处)

    崩溃现场

    18:38:42 NVRM: krcWatchdog_IMPL: RC watchdog: GPU is probably locked! Notify Timeout Seconds: 7
    18:38:42 NVRM: Xid (PCI:0000:09:00): 8, pid=25546, name=llama-server, channel 0x00000012
    18:38:42 CUDA error: the launch timed out and was terminated
    18:38:45 systemd: llama-qwen-27B.service: Main process exited, code=dumped, status=6/ABRT
    

    崩溃后 systemd 自动拉起新进程,服务自动恢复。

    六、崩溃根因:Blackwell GSP 固件 Bug

    这不是什么

    • ❌ 不是量化模型的问题(Q4_K_M、UD-Q4_K_XL、Q4_K_P 均崩)
    • ❌ 不是 llama.cpp 的 bug(b8679 之前/之后均有报告)
    • ❌ 不是驱动版本问题(580/590/595 均复现)
    • ❌ 不是散热/供电问题(室温 28°C、1600W 铂金电源均有人复现)

    这是什么

    NVIDIA Blackwell 架构(GB202 die)的 GSP 固件心跳超时 bug。GSP(GPU System Processor)是 Blackwell 上强制启用的固件处理器,在持续高负载下会心跳超时死锁,导致 GPU 进入不可恢复状态。

    社区证据

    来源 GPU 工作负载 结果
    NVIDIA/open-gpu-kernel-modules #1080 RTX 5090 (GB202) Vulkan 游戏 GSP heartbeat timeout → Xid 8,与我们完全一致
    NVIDIA/open-gpu-kernel-modules #1111 RTX PRO 6000 (GB202, sm_120) llama.cpp 持续推理 45 分钟必崩;同机 RTX 3090(sm_86)跑 20+ 小时零崩
    NVIDIA/open-gpu-kernel-modules #1247 RTX 5060 Ti (Blackwell) Ollama/llama.cpp CUDA 分配时硬锁
    NVIDIA Forums #371272 RTX 5080 (Blackwell) 高上下文 LLM 推理 Xid 62 GSP Watchdog Timeout
    gengchaogit/blackwell-xid-wpr2-gsp-crash-recovery 多款 Blackwell 通用 专门为此 bug 写的恢复脚本

    关键对比(#1111 报告者):同机 RTX PRO 6000 Blackwell + RTX 3090×2,跑相同 llama.cpp 持续推理——Blackwell 45 分钟必崩,Ampere(sm_86)20+ 小时零崩。确认是 Blackwell 特有。

    崩溃链

    decode kernel 执行(随上下文长度增长)
        ↓ 超过 ~7 秒
    GSP watchdog 判定 GPU 锁死
        ↓
    krcWatchdog_IMPL: RC watchdog: GPU is probably locked!
        ↓
    Xid 8(launch timeout)→ CUDA error: the launch timed out
        ↓
    驱动尝试恢复 → WPR2 安全区无法清除 → 恢复失败
        ↓
    GPU 死锁,需要重启/Secondary Bus Reset
    

    为什么不同量化源崩溃频率不同

    权重分布 → CUDA kernel 执行时间不同 → 超 7 秒看门狗阈值的概率不同:

    • UD-Q4_K_XL 更稳定:权重分布让 kernel 执行时间更短,更不容易触发阈值
    • Q4_K_P 更频繁:权重分布导致 kernel 执行时间更接近阈值
    • 128K 比 200K 更稳定:上下文更短→KV cache 更小→kernel 耗时更短

    上游状态

    • NVIDIA 内部已跟踪(#1080 标记为 Open,#1111 标记为 Bug)
    • 580-open / 595-open 是当前唯一可用驱动路径(Blackwell 不支持闭源驱动)
    • 恢复路径在 Blackwell 上根本性损坏(WPR2 安全区无法清除)
    • 无公开修复 ETA

    七、为何选择 128K 上下文

    背景

    Qwen3.8-27B 模型支持 256K 上下文,最初我们也想用 200K(实用性与显存的平衡点)。但实测发现:

    配置 压测结果
    256K + MTP 08-19 凌晨连崩 2 次(6万/11万 token 处)
    200K + MTP 1 小时压测 59 分钟崩 1 次(22万 token 处)
    128K + MTP 长期使用零崩(08-18/19 已验证)

    原理

    GSP 固件 bug 的触发条件是任何单次 CUDA kernel 超过 ~7 秒。上下文越长→KV cache 越大→attention kernel 扫描的数据量越多→执行时间越长→越容易超 7 秒阈值。

    降 ctx 不是根因修复(阈值不固定,6万 token 处也曾崩过),但能把概率压到工程可接受水平。

    关 MTP 的考量

    MTP(Multi-Token Prediction)通过扩大单步 batch(draft n=2)提升吞吐,但也增大了 kernel 负载。关 MTP 可进一步降低崩溃概率,但代价:

    配置 预估 t/s
    128K + MTP n-max 2 ~67 t/s(已验证)
    128K + 无 MTP ~30 t/s(推算,未实测)
    256K + 无 MTP ~25 t/s(推算,未验证零崩)

    最终选择 128K + MTP:性能与稳定性的工程最优解。等 NVIDIA 修 GSP 固件后再考虑升 ctx。

    八、踩坑与经验

    1. MTP 参数名:--spec-type draft-mtp(旧名 mtp 会启动失败),--spec-draft-n-max 2(推荐值,n=3+ 在 Blackwell 上收益递减)。
    2. KV cache 用 Q4:--cache-type-k q4_0 --cache-type-v q4_0,128K 上下文 KV 约 32GB RAM(--cache-ram 32768),显著降低显存占用。
    3. --no-mmap:Blackwell 上 mmap 有兼容性问题,关掉更稳。
    4. --flash-attn on:必须开启,关闭后 kernel 执行时间更长,更容易触发 GSP watchdog。
    5. 崩溃后自动恢复:systemd Restart=on-failure + RestartSec=10,崩溃后 10 秒自动拉起。实际影响仅当轮请求丢失。
    6. 量化源选择:UD-Q4_K_XL(Unsloth Dynamic)在 Blackwell 上比其它 Q4 量化源更稳定——不是量化质量差异,是权重分布→kernel timing 差异。
    7. Blackwell GSP bug 通用性:RTX 5090/5080/5070/5060Ti/PRO 6000/PRO 4500 均受影响(同一 GB202/G200 die),不是个例。社区已有恢复脚本(sbr_recover.sh)但需要 root 权限。


  • 测试了两天,发现RTX PRO 4500 Blackwell 32GB这张卡真有点坑啊!有没有哪位大神在这张显卡上能稳定高速的27B-llama方案啊?
    清风明月清 清风明月
    LLM讨论区 rtxpro4500 qwen-27b

    本地双 Qwen3.8-27B 部署实测:vLLM vs llama.cpp 全路径踩坑实录

    平台:Linux(Ubuntu 26.04 LTS)/ RTX PRO 4500 Blackwell 32GB / systemd 用户服务
    日期:2026-08-19(模型 8-14 发布后 5 天,含 vLLM + llama.cpp 双框架全路径实测)

    一、结论

    硬件环境下的模型选型铁律

    模型类型 推荐框架 理由
    MoE 模型(A3B) vLLM + MTP 显存充裕,MTP 稳定,速度快(144 t/s)
    Dense 模型(27B) llama.cpp(无 MTP) 显存贴边,MTP 在 Blackwell 上必崩

    27B dense 模型在本机的最终定案

    • vLLM 路线已废弃:32GB 卡跑 NVFP4 显存贴边(22GB 权重 + 811MB MTP head),CUDA graphs 开不了(需额外 800MB),只能 enforce-eager,速度 ~20 t/s
    • llama.cpp 路线是唯一稳定选择:256K context + 无 MTP,速度 ~24.5 t/s,零崩溃
    • MTP 在 Blackwell sm_120 上是崩溃根源:实测 128K/256K × mmproj 有无全组合,decode 阶段必崩(CUDA launch timed out,ggml-cuda.cu:106),升级到最新 llama.cpp 9731ad3 仍崩

    本机现役三服务架构

    vllm-qwen-A3B.service      → Qwen3.6-35B-A3B NVFP4 (200K, ~144 t/s)
    llama-qwen-27B.service     → Qwen3.8-27B Q5_K_M (256K, ~24.5 t/s)
    llama-qwen-27B-uc.service  → Qwen3.8-27B-Uncensored Q5_K_M (256K, ~24.5 t/s)
    

    二、硬件 / 软件环境

    项 配置
    显卡 NVIDIA RTX PRO 4500 Blackwell,32 GB(sm_120),驱动 595.91.07
    CUDA 13.1(nvcc)/ 13.2(驱动最大支持)/ PyTorch CUDA 13.0
    CPU AMD Ryzen 7 3700X(8C/16T)
    内存 60 GB
    系统 Ubuntu 26.04 LTS
    推理框架 llama.cpp 源码编译(ggml 0.20.2,commit 98d1e92)+ vLLM 0.26.0
    服务方式 systemd 用户服务(systemctl --user),8000 端口互斥

    三、模型来源

    1. 官方原版 Qwen3.8-27B(默认主力)

    • 仓库:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
    • 底模:https://huggingface.co/Qwen/Qwen3.8-27B(官方,27.78B dense 混合注意力,64 层 = 48 Gated DeltaNet + 16 full-attn,262144 原生上下文,Apache 2.0)
    • 文件:Qwen3.8-27B-Q5_K_M.gguf(19.8GB)+ mmproj-F16.gguf(885MB)

    2. 去拒答版 Qwen3.8-27B-Uncensored

    • 仓库:https://huggingface.co/JonathanColetti/Qwen3.8-27B-Uncensored-GGUF
    • 加工:JonathanColetti 做 abliteration(正交化消解除拒答方向),拒答率 98/100 → 12/100
    • 文件:Qwen3.8-27B-Uncensored-Q5_K_M.gguf(19.5GB)+ Qwen3.8-27B-Uncensored-vision-f16.gguf(885MB)

    3. vLLM 版本(已废弃)

    • 仓库:https://huggingface.co/unsloth/Qwen3.8-27B-NVFP4(22GB)
    • 32GB 卡实测上限 100K context,CUDA graphs 不可用

    四、vLLM 路线实测(已废弃)

    部署参数

    vllm serve ~/models/Qwen3.8-27B-NVFP4 \
      --served-model-name qwen3.8-27b \
      --tensor-parallel-size 1 \
      --max-model-len 100000 \
      --gpu-memory-utilization 0.90 \
      --kv-cache-dtype fp8 \
      --enforce-eager \
      --speculative-config '{"method":"mtp","num_speculative_tokens":1}' \
      --reasoning-parser qwen3 \
      --host 127.0.0.1 --port 8000
    

    失败原因

    尝试 结果
    max-model-len=131072 (128K) KV cache 需 4.57GB,仅 3.9GB 可用 → OOM
    max-model-len=110000 KV cache 需 3.9GB,可用 3.69GB → OOM
    max-model-len=100000 成功启动,可用 3.69GB KV cache
    CUDA graphs 开启 模型占 29.7GB,CUDA graphs 需额外 800MB → OOM
    FlashInfer + enforce-eager 速度反而降到 13.7 tok/s

    最终速度

    • 吐词速度:~20 tok/s(enforce-eager 模式)
    • 对比 llama.cpp:24.5 t/s(无 MTP)→ vLLM 反而更慢

    结论

    32GB 单卡跑 27B NVFP4 显存贴边,vLLM 的 MTP + CUDA graphs 优势完全发挥不出来。vLLM 适合 MoE 模型(A3B),不适合 dense 模型(27B)。


    五、llama.cpp 路线实测(稳定方案)

    部署参数

    llama-server \
      -m ~/models/Qwen3.8-27B/Qwen3.8-27B-Q5_K_M.gguf \
      --mmproj ~/models/Qwen3.8-27B/mmproj-F16.gguf \
      --alias Qwen3.8-27B \
      --host 127.0.0.1 --port 8000 \
      --ctx-size 262144 \
      --n-gpu-layers 99 \
      --flash-attn on \
      --parallel 1 \
      --jinja \
      --no-mmap \
      --cache-type-k q4_0 \
      --cache-type-v q4_0 \
      --chat-template-kwargs '{"reasoning_effort":"medium","preserve_thinking":true}' \
      --reasoning-preserve \
      --spec-type none \
      --temp 1.0 --top-k 20 --top-p 0.95
    

    实测结果

    场景 速度
    短输出(<1K token) ~37 t/s
    中等输出(1K-10K token) ~30 t/s
    长输出(10K+ token) ~24.5 t/s
    100K 预填 + 6000 token 长生成 零崩溃

    显存占用

    项 占用
    Q5_K_M 权重 19.8GB
    mmproj 885MB
    256K ctx q4 KV ~5GB
    总计 ~26GB / 32GB

    256K context 的关键

    KV cache 全 4bit(--cache-type-k/v q4_0)是 32GB 卡跑 256K 的唯一正解。换成 fp8/fp16 直接放不下。


    六、MTP 在 Blackwell 上的崩溃分析

    崩溃现象

    • CUDA error: the launch timed out and was terminated(ggml-cuda.cu:106)
    • 崩溃点随机:366/771/2346/3208/5904 token(非上下文满导致)
    • 128K/256K × mmproj 有无全组合实测全部崩溃

    已知 Blackwell + MTP 的 bug

    1. Issue #24399:mul_mat_q<Q8_0,128> 在 Blackwell 上 shared-memory out-of-range 崩溃
    2. CUDA 13.2 乱码:Reddit 警告不要用 CUDA 13.2 编译 llama.cpp
    3. MTP × hybrid-GDN crash class (#50021):RTX 5090 上 NVFP4 和 W4A8 都崩
    4. nvcc 编译器 bug:Blackwell SM_120 MMQ kernels at -O3 生成错误机器码

    为什么 vLLM 的 MTP 能跑

    vLLM 的 MTP 实现路径与 llama.cpp 不同,避开了上述 CUDA kernel bug。但 32GB 卡显存不够,只能 enforce-eager 模式,速度优势被抵消。


    七、踩坑与经验

    必须知道的

    1. --jinja 必须加:3.8 官方 jinja 模板会把空 thinking 块包进输出,破坏多轮 agent 会话
    2. 过思考是 3.8 的祖传毛病:用 reasoning_effort=medium 压住,medium 下实际思考量很小
    3. 256K 是 32GB 卡的极限:288K 超预算(总显存 30GB 封顶,留 ~4GB 给桌面)
    4. 256K vs 128K 速度无差别:速度只与实际上下文长度相关,与档位无关(1K-12K 负载 tg≈37 持平)

    MTP 相关

    1. Blackwell 上 MTP 必崩:与驱动版本无关(595.91.07 不救 MTP),与 llama.cpp 版本也无关
    2. MTP acceptance rate 低:实测仅 45%(社区正常 80%+),Blackwell 上收益有限
    3. 关 MTP 正确参数:--spec-type none(新版无 --no-speculative)

    下载验证

    1. 字节级核验:HF 仓库 ?blobs=true 拿每个文件 size,与本地 stat 对比
    2. 别下错版本:同名量化可能差几百万字节(带不带 MTP、带不带 vision)

    服务管理

    1. 切模型 = 切服务:8000 端口互斥,切换前先停另一个
    2. 全部 disabled:按需手动 start,不开机自启

    八、接入 Agent 的方式

    llama.cpp 自带 /v1/chat/completions,标准 OpenAI 协议。

    # 文本测试
    curl http://127.0.0.1:8000/v1/chat/completions \
      -H 'Content-Type: application/json' \
      -d '{"model":"Qwen3.8-27B","messages":[{"role":"user","content":"Hello"}],"max_tokens":128}'
    
    # 视觉测试(base64 内联)
    curl http://127.0.0.1:8000/v1/chat/completions \
      -H 'Content-Type: application/json' \
      -d '{"model":"Qwen3.8-27B","max_tokens":500,
           "messages":[{"role":"user","content":[
             {"type":"image_url","image_url":{"url":"data:image/png;base64,..."}},
             {"type":"text","text":"描述这张图"}
           ]}]}'
    

    九、总结

    一句话:dense 27B 质量换速度(llama.cpp,24.5 t/s,无 MTP),MoE A3B 速度换质量(vLLM,144 t/s,MTP 稳定),同机器双方案按场景切。

    Blackwell sm_120 的现实:

    • llama.cpp MTP 有已知崩溃 bug,短期内无法修复
    • vLLM MTP 能跑但显存不够,32GB 卡只能 enforce-eager
    • 速度最优解是 MoE 模型(A3B)+ vLLM + MTP

    如果要速度:用 A3B(144 t/s)
    如果要质量:用 27B 无 MTP(24.5 t/s)
    如果两个都要:同机器双服务,按需切换


  • RTX PRO 4500 单卡跑 125B MoE:Strata + Qwen3.8-Flash-Next 实测 189 tok/s、262K 满上下文零崩溃——50 分钟从零到可用全纪录
    清风明月清 清风明月
    LLM讨论区 rtxpro4500 strata qwen-flash

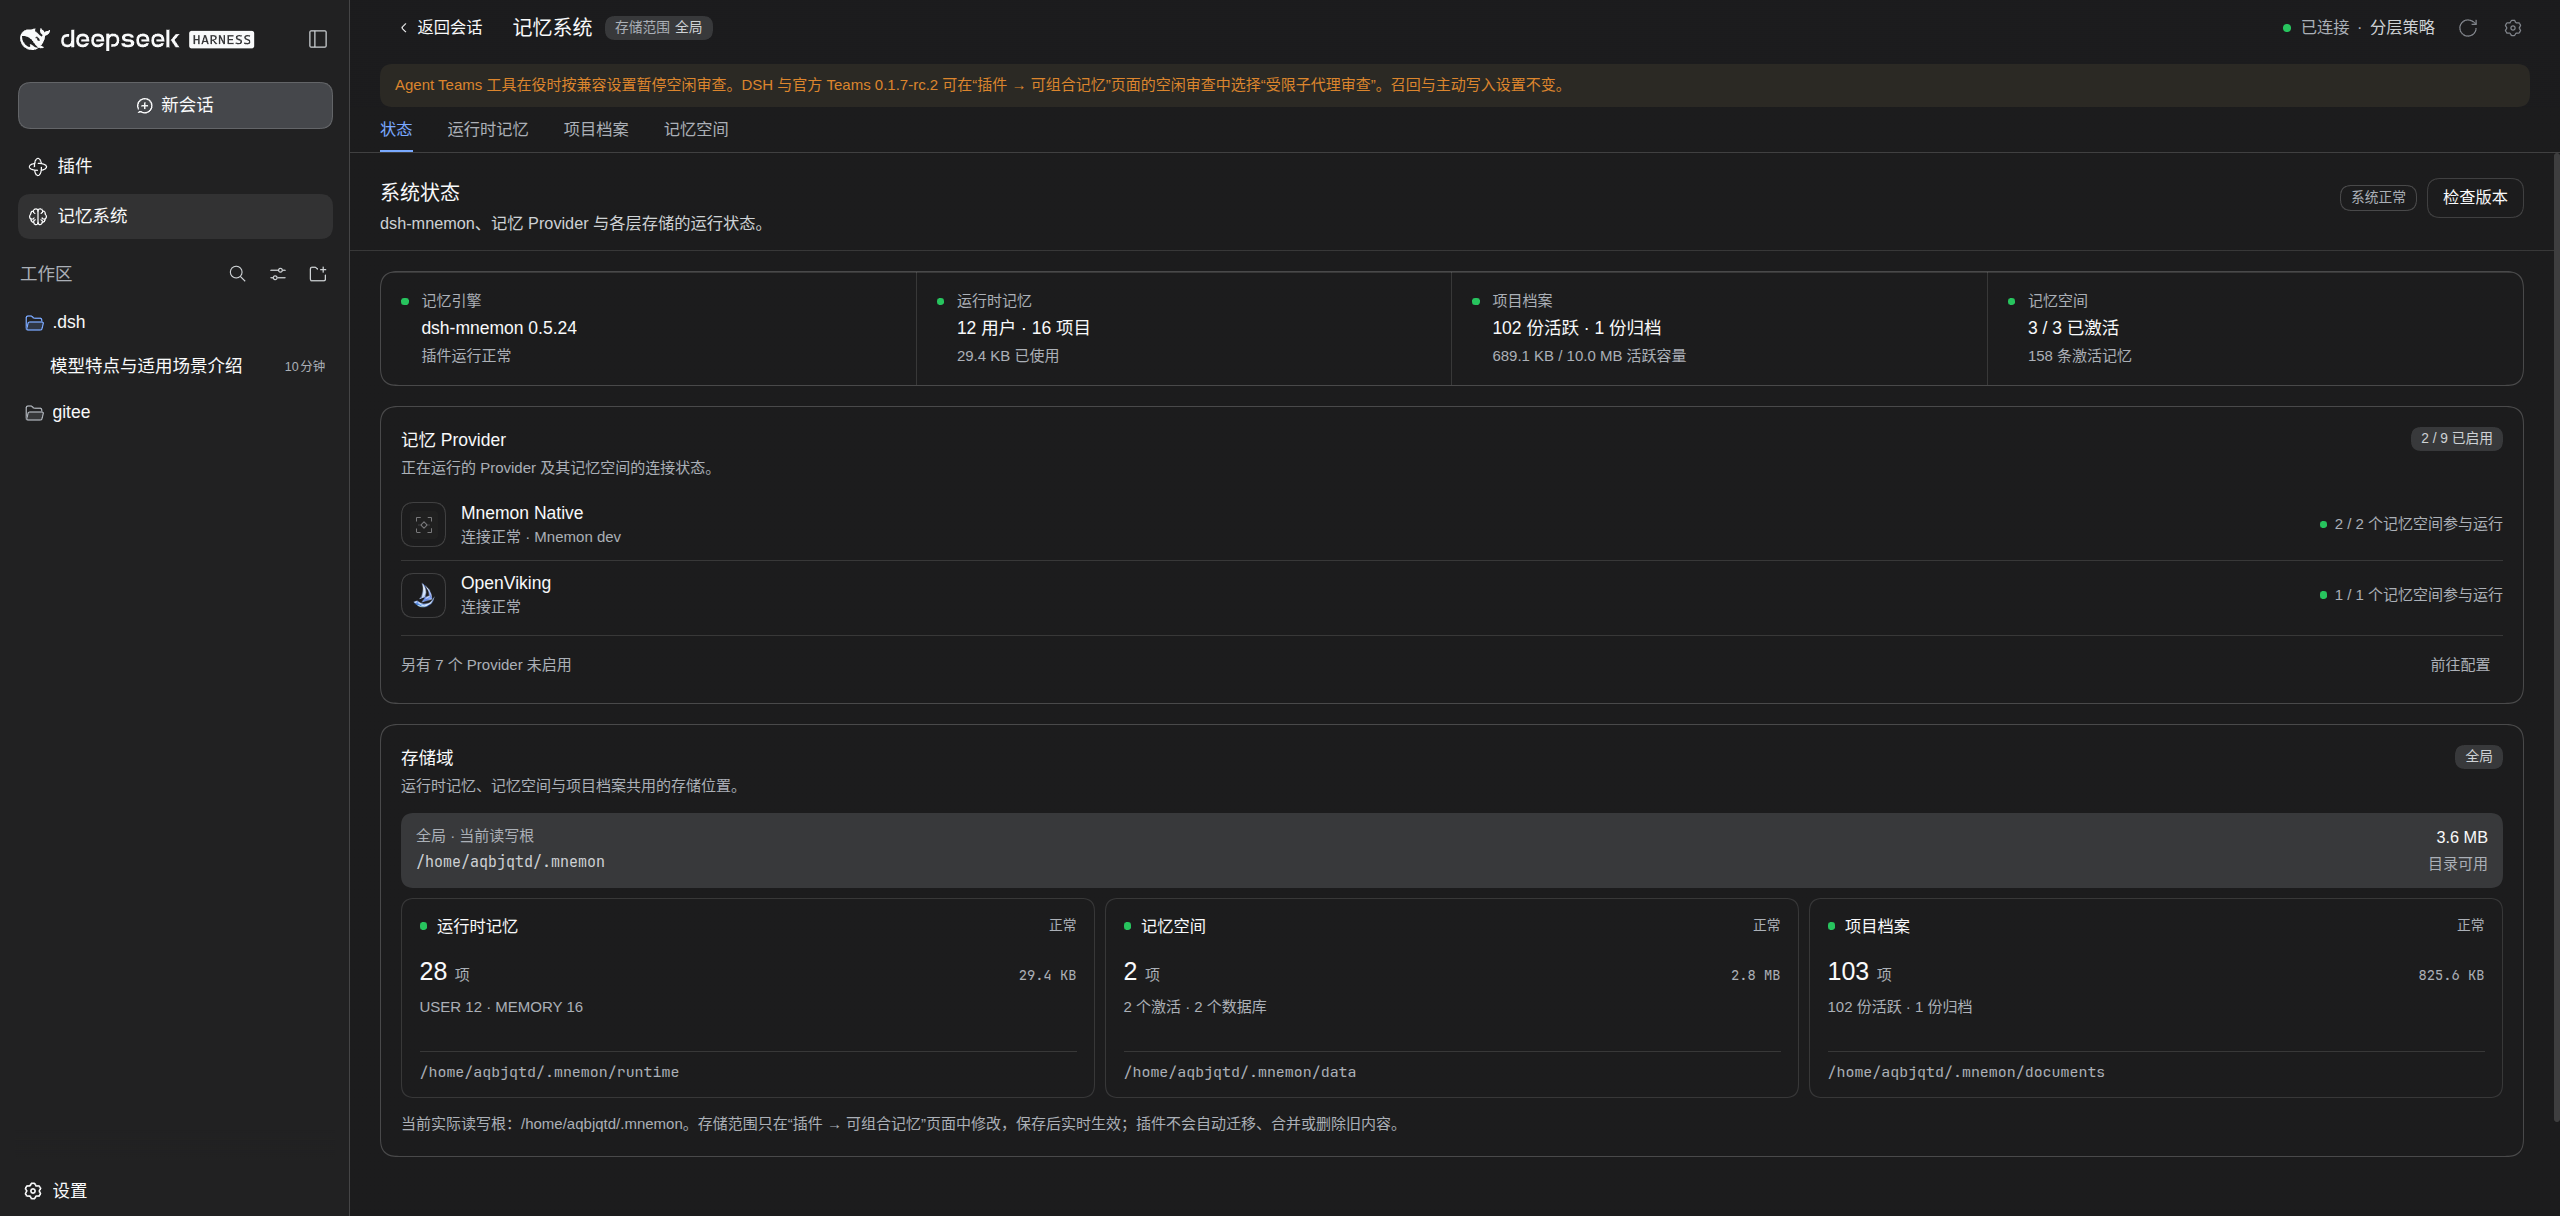
    另外,我为deepseekharness安装了记忆系统,让dsh也拥有跨会话长期记忆了。

    截图 2026-10-08 20-27-48.png


  • 本地跑双 Qwen3.8-27B 实践实录:官方原版 + 去拒答版,200K 上下文全量部署与实测数据
    清风明月清 清风明月
    LLM讨论区 qwen-27b 多卡部署 本地模型

    本地跑双 Qwen3.8-27B 实践实录:官方原版 + 去拒答版,200K 上下文全量部署与实测数据

    平台:Linux(Ubuntu 26.04 LTS)/ llama.cpp 源码编译 / systemd 用户服务
    用途:本地多模态 LLM(文字 + 视觉),日常 Hermes Agent 主模型
    日期:2026-08-18(模型 8-14 发布后 4 天内的完整实践)

    一、先说结论

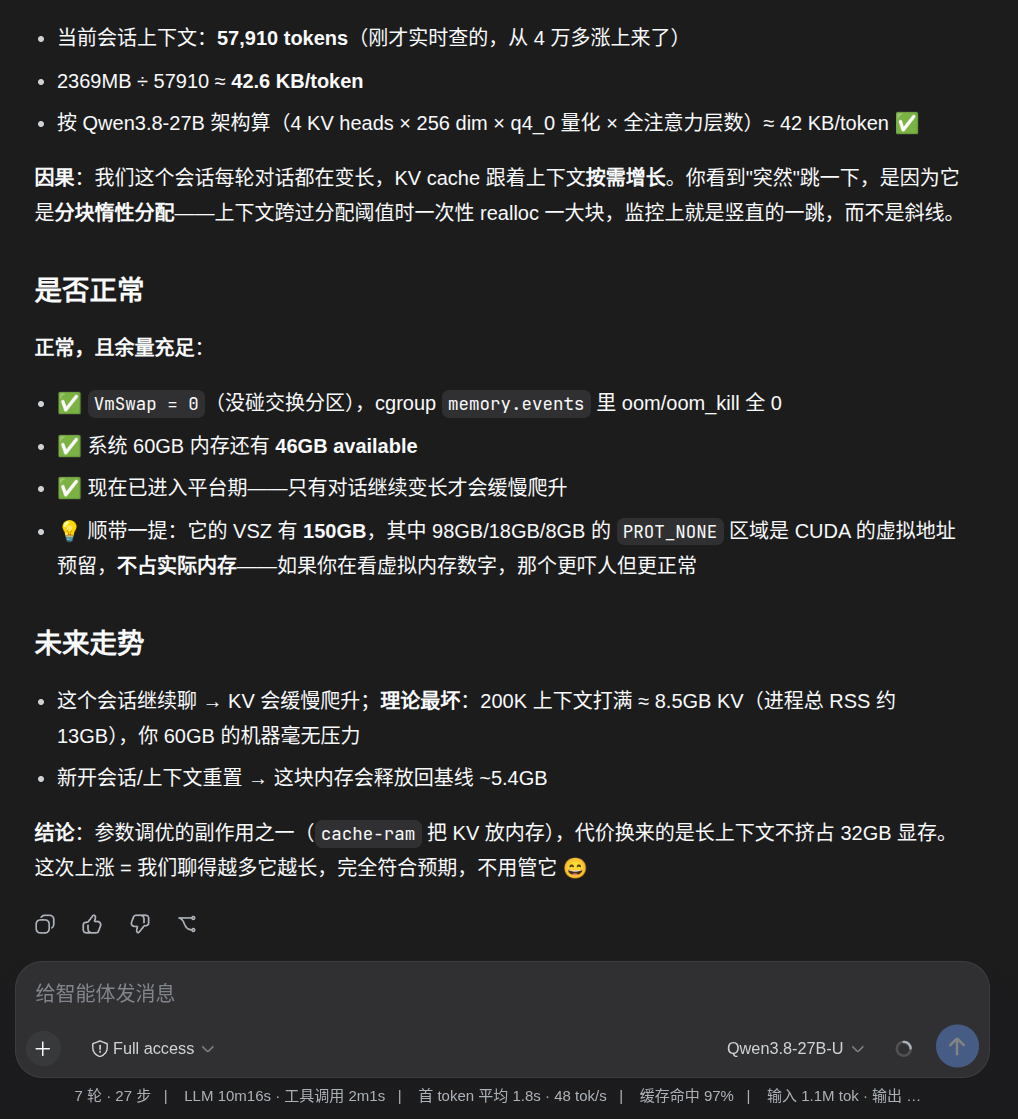
    截图 2026-08-18 17-01-13.png

    • 一台 32GB 显存卡可以同时把 Qwen3.8-27B 官方原版和社区去拒答版都部署起来跑 200K 上下文,全 GPU 加载,KV cache 4bit,每个服务实测占用约 25 GB 显存,32GB 卡还有 6GB 余量。
    • 实测吐词:API 端到端 58-60 t/s(含思考 token 计数);长续写工作负载 46-51 t/s;短输出配合 MTP 投机解码能冲到 83 t/s(draft 接受率 0.995)。
    • 视觉可用:一张真实截图发进去,4.5 秒内带思考返回,描述基本准确。
    • 最大坑在官方 chat template 会把空的 thinking 块嵌进多轮对话,禁 multi-turn agent——必须 --jinja 覆盖;另一个坑是 3.8 系过思考,用 reasoning_effort=medium 压住。

    二、硬件 / 软件环境

    项 配置
    显卡 NVIDIA RTX PRO 4500 Blackwell,32 GB(实测 32623 MiB),驱动 595.84
    CPU AMD Ryzen 7 3700X(8C/16T)
    内存 60 GB
    系统 Ubuntu 26.04 LTS
    推理框架 llama.cpp 源码编译(0.1.0-dev,build 1,commit 6509138,GCC 13.4.0)
    服务方式 systemd 用户服务(systemctl --user),8000 端口互斥

    三、模型来源(两个 27B 分别来自哪)

    Qwen 官方只发布 BF16 / FP8 权重,没有官方 GGUF,本地 GGUF 一律第三方转换。我实测字节级比对(本地文件 size 与 HF 仓库完全一致)确认了两份来源:

    1. 官方原版 Qwen3.8-27B(默认主力,llama.cpp Q5_K_M)

    • 仓库:https://huggingface.co/unsloth/Qwen3.8-27B-GGUF
    • 底模:https://huggingface.co/Qwen/Qwen3.8-27B(官方,8-14 发布,27.78B dense 混合注意力 VLM,262144 原生上下文,Apache 2.0)
    • 文件:Qwen3.8-27B-Q5_K_M.gguf(19,834,055,648 B)+ mmproj-F16.gguf(927,607,488 B)

    2. 去拒答版 Qwen3.8-27B-Uncensored(低拒版,专职"有问必答")

    • 仓库:https://huggingface.co/JonathanColetti/Qwen3.8-27B-Uncensored-GGUF
    • 加工:JonathanColetti 做 abliteration(正交化消解除拒答方向),拒答率 98/100 → 12/100,四种基准均值仅掉 0.5 分(噪声级),保留 MTP 投机解码头
    • 文件:Qwen3.8-27B-Uncensored-Q5_K_M.gguf(19,535,701,408 B)+ Qwen3.8-27B-Uncensored-vision-f16.gguf(927,606,912 B)
    • ⚠️ 注意别下错:Reddit 上推的 vcruz305/Qwen3.8-27B-AEON-ULTIMATE-UNCENSORED-GGUF(AEON 系)是 --no-mtp,不带 MTP 头,同类 Q5_K_M 只有 19,231,099,968 B,明显小一截。要 MTP 提数选 JonathanColetti 版。

    四、部署步骤(llama.cpp 源码 + systemd 服务)

    1. 编译 llama.cpp

    llama.cpp 需要足够新的版本才认识 qwen35 架构,建议直接源码编最新:

    git clone https://github.com/ggml-org/llama.cpp && cd llama.cpp
    cmake -B build -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release
    cmake --build build --config Release -j$(nproc)
    

    2. 下载模型(HF 直连,直接落到最终目录)

    hf download unsloth/Qwen3.8-27B-GGUF --local-dir ~/models/Qwen3.8-27B \
      --include "Qwen3.8-27B-Q5_K_M.gguf" "mmproj-F16.gguf"
    hf download JonathanColetti/Qwen3.8-27B-Uncensored-GGUF \
      --local-dir ~/models/Qwen3.8-27B-Uncensored \
      --include "Qwen3.8-27B-Uncensored-Q5_K_M.gguf" "Qwen3.8-27B-Uncensored-vision-f16.gguf"
    

    3. systemd 用户服务(两个服务参数完全一致,仅模型路径不同)

    ~/.config/systemd/user/llama-qwen-27B.service:

    [Unit]
    Description=llama.cpp Qwen3.8-27B Q5_K_M Service (200K, effort=medium)
    
    [Service]
    ExecStart=%h/llama.cpp/build/bin/llama-server \
      -m %h/models/Qwen3.8-27B/Qwen3.8-27B-Q5_K_M.gguf \
      --mmproj %h/models/Qwen3.8-27B/mmproj-F16.gguf \
      --alias Qwen3.8-27B \
      --host 127.0.0.1 \
      --port 8000 \
      --ctx-size 200000 \
      --n-gpu-layers 99 \
      --flash-attn on \
      --parallel 1 \
      --jinja \
      --no-mmap \
      --ubatch-size 512 \
      --cache-type-k q4_0 \
      --cache-type-v q4_0 \
      --cache-ram 32768 \
      --chat-template-kwargs '{"reasoning_effort": "medium", "preserve_thinking": true}' \
      --reasoning-preserve \
      --temp 1.0 \
      --top-k 20 \
      --top-p 0.95 \
      --min-p 0.0 \
      --spec-type draft-mtp \
      --spec-draft-n-max 2
    Environment=CUDA_VISIBLE_DEVICES=0
    Restart=on-failure
    RestartSec=10
    StandardOutput=journal
    StandardError=journal
    
    [Install]
    WantedBy=default.target
    

    启用高开一体,服务管理:

    systemctl --user daemon-reload
    systemctl --user enable --now llama-qwen-27B.service     # 官方版
    systemctl --user enable --now llama-qwen-27B-uc.service  # 去拒答版(同参数改模型路径)
    # 端口 8000 互斥:开一个前先停另一个
    systemctl --user start/stop/restart llama-qwen-27B.service
    

    五、实测结果(均为本机真实跑出的数字)

    吐词速度(llama-server 日志 + API 客户端实测)

    场景 数据 说明
    API 端到端(纯解码 300 token 全吐出) 60.1 t/s,TTFT 0.28s httpx 客户端计时,含网络开销
    API 端到端(带思考问答) 58.8 t/s,TTFT 0.16s 思考 279 token + 正文 189 token
    长续写工作负载(n_gen 418→1861 持续生成) tg 46-51 t/s 真实 agent 会话下的稳速
    短输出 + MTP 高命中 83.4 t/s draft acceptance 0.995,mean len 2.99

    MTP 投机解码统计(journal draft acceptance)

    • 长上下文会话:acceptance 0.615,mean len 2.23
    • 一般任务:acceptance 0.65 ~ 0.995,mean len 2.3 ~ 2.99
    • 结论:MTP 在长输出/低重复性文本收益浮动,短输出命中很高,白捡速度,显存代价可忽略,建议一直开着。

    视觉(多模态)实测

    • 输入真实截图(PNG, ~718 prompt token)+ 提问"描述这张截图"
    • 返回:4.5 秒,其中思考 107 token,正文准确描述了页面是各模型 API 请求配额表格(Grok/GPT/GLM/Kimi/Qwen/DeepSeek 各周期次数)
    • 结论:vision 走 --mmproj/vision-f16 正常,识别准确度够用

    显存占用(32GB 卡)

    项 占用
    llama-server(Q5_K_M 19.5GB 权重 + mmproj + 200K ctx q4 KV) 25,318 MiB ≈ 24.7 GB
    全卡总占用 26.0 / 32 GB(其余为桌面等)
    剩余余量 ~6 GB

    200K 上下文能塞进 32GB 的三个关键:KV cache 全 4bit(--cache-type-k/v q4_0)、全 GPU offload(-ngl 99)、--no-mmap 避免大文件映射把内存和随机 IO 拉爆。KV 换成 fp16 的话 200K 直接放不下。

    与 A3B(MoE)的参照对比

    同机还部署了 Qwen3.6-35B-A3B(vLLM NVFP4,MoE 3B 激活)作对照:

    指标 Qwen3.8-27B (dense) Qwen3.6-35B-A3B (MoE)
    纯解码 46-60 t/s 144 t/s
    往返延迟(纯文本问答) TTFT ~0.2s 1.2s
    定位 dense 全参,编码/深度推理/长文写作更强 速度翻倍余,工具调用/Hermes agent 首选

    一句话:dense 质量换速度,MoE 速度换质量,同机器双方案按场景切。

    六、踩坑与经验(给后面的人)

    1. 必须 --jinja:3.8 官方 jinja 模板会把空的 thinking 块包进输出,直接破坏多轮 agent 会话(llama.cpp 下实测)。GGUF 包里若烤了固定模板也要用 --jinja。
    2. 过思考是 3.8 的祖传毛病:简单 prompt 都能吐几千 token 思考(Reddit 上戏称"史上最 overthinking")。用 --chat-template-kwargs '{"reasoning_effort": "medium"}' + --reasoning-preserve 可控档,medium 下实际思考量很小。
    3. 官方 benchmark 别全信:SWE-bench Pro 61.7 之类是 Qwen 自报(且对比项直接复用别家成绩),发布当天没有独立复现。release 当天 Reddit 实测反馈一致好评(双 5080 Q6 能到 100 t/s、2080Ti 22GB Q8 也能 40 t/s),本机体验同样"明显强于 3.6-27B"——但"强"是有依据的主观体验,不是官方数字背书。
    4. 量化选 Q5_K_M 是甜点:Q4 能用、Q5 几乎无损、Q6/Q8 32GB 全 offload 放不下(Q8 是 26.63 GB + KV 直接爆卡)。14 层 hybrid attention 的 KV 天然小,配合 4bit KV 是 32GB 卡跑 200K 的唯一正解。
    5. 下载后务必字节级核验:HF 仓库 ?blobs=true 拿每个文件 size,与本地 stat 对比。不同仓库同名量化可能差几百万字节(带不带 MTP、带不带 vision),网上吹的"best one"未必是你要下的那个。
    6. 切模型 = 切服务:8000 端口互斥,切换脚本负责停旧起新,不要把服务常驻两个。

    七、接入 agent 的方式(OpenAI 兼容)

    llama.cpp 自带 /v1/chat/completions,标准 OpenAI 协议,视觉直接 image_url base64。接入任何 agent 框架只需把 base URL 指到 http://127.0.0.1:8000/v1:

    # 视觉测试(base64 内联)
    curl http://127.0.0.1:8000/v1/chat/completions \
      -H 'Content-Type: application/json' \
      -d '{"model":"Qwen3.8-27B","max_tokens":500,
           "messages":[{"role":"user","content":[{"type":"image_url","image_url":{"url":"data:image/png;base64,..."}},
           {"type":"text","text":"描述这张图"}]}]}'
    

    帖子里的所有速度、显存、延迟、MTP 统计均为本机(8-18)实测;模型来源均做过字节级比对。硬要说缺点:dense 27B 的算力开销比同机 MoE 大,长 agent 会话的思考 token 消耗要心里有数——这也是很多人对 3.8 的真实槽点。

    以上部署实测均由hermes调用opencodego套餐模型deepseek-v4-flash负责,本人只负责在旁边喝茶,静静地看着就行了。所以有问题也别问我,问你机器上的hermes或deepseek harness!


  • RTX PRO 4500 单卡跑 125B MoE:Strata + Qwen3.8-Flash-Next 实测 189 tok/s、262K 满上下文零崩溃——50 分钟从零到可用全纪录
    清风明月清 清风明月
    LLM讨论区 rtxpro4500 strata qwen-flash

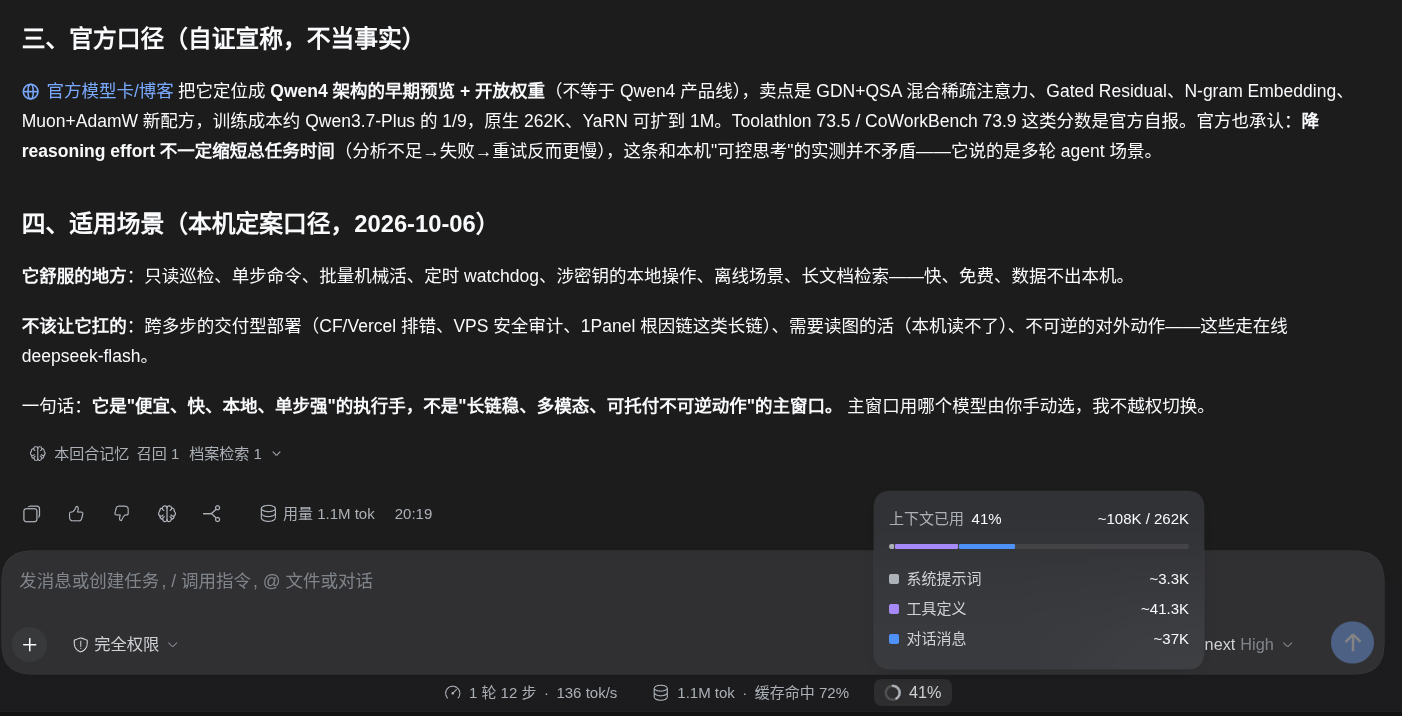
    截图 2026-10-08 20-24-02.png
    硬件就不晒了,老机箱的配置,只换了显卡,原32GB内存再加了32GB内存。晒一张这个模型驱动deepseekharness的截图吧!

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组