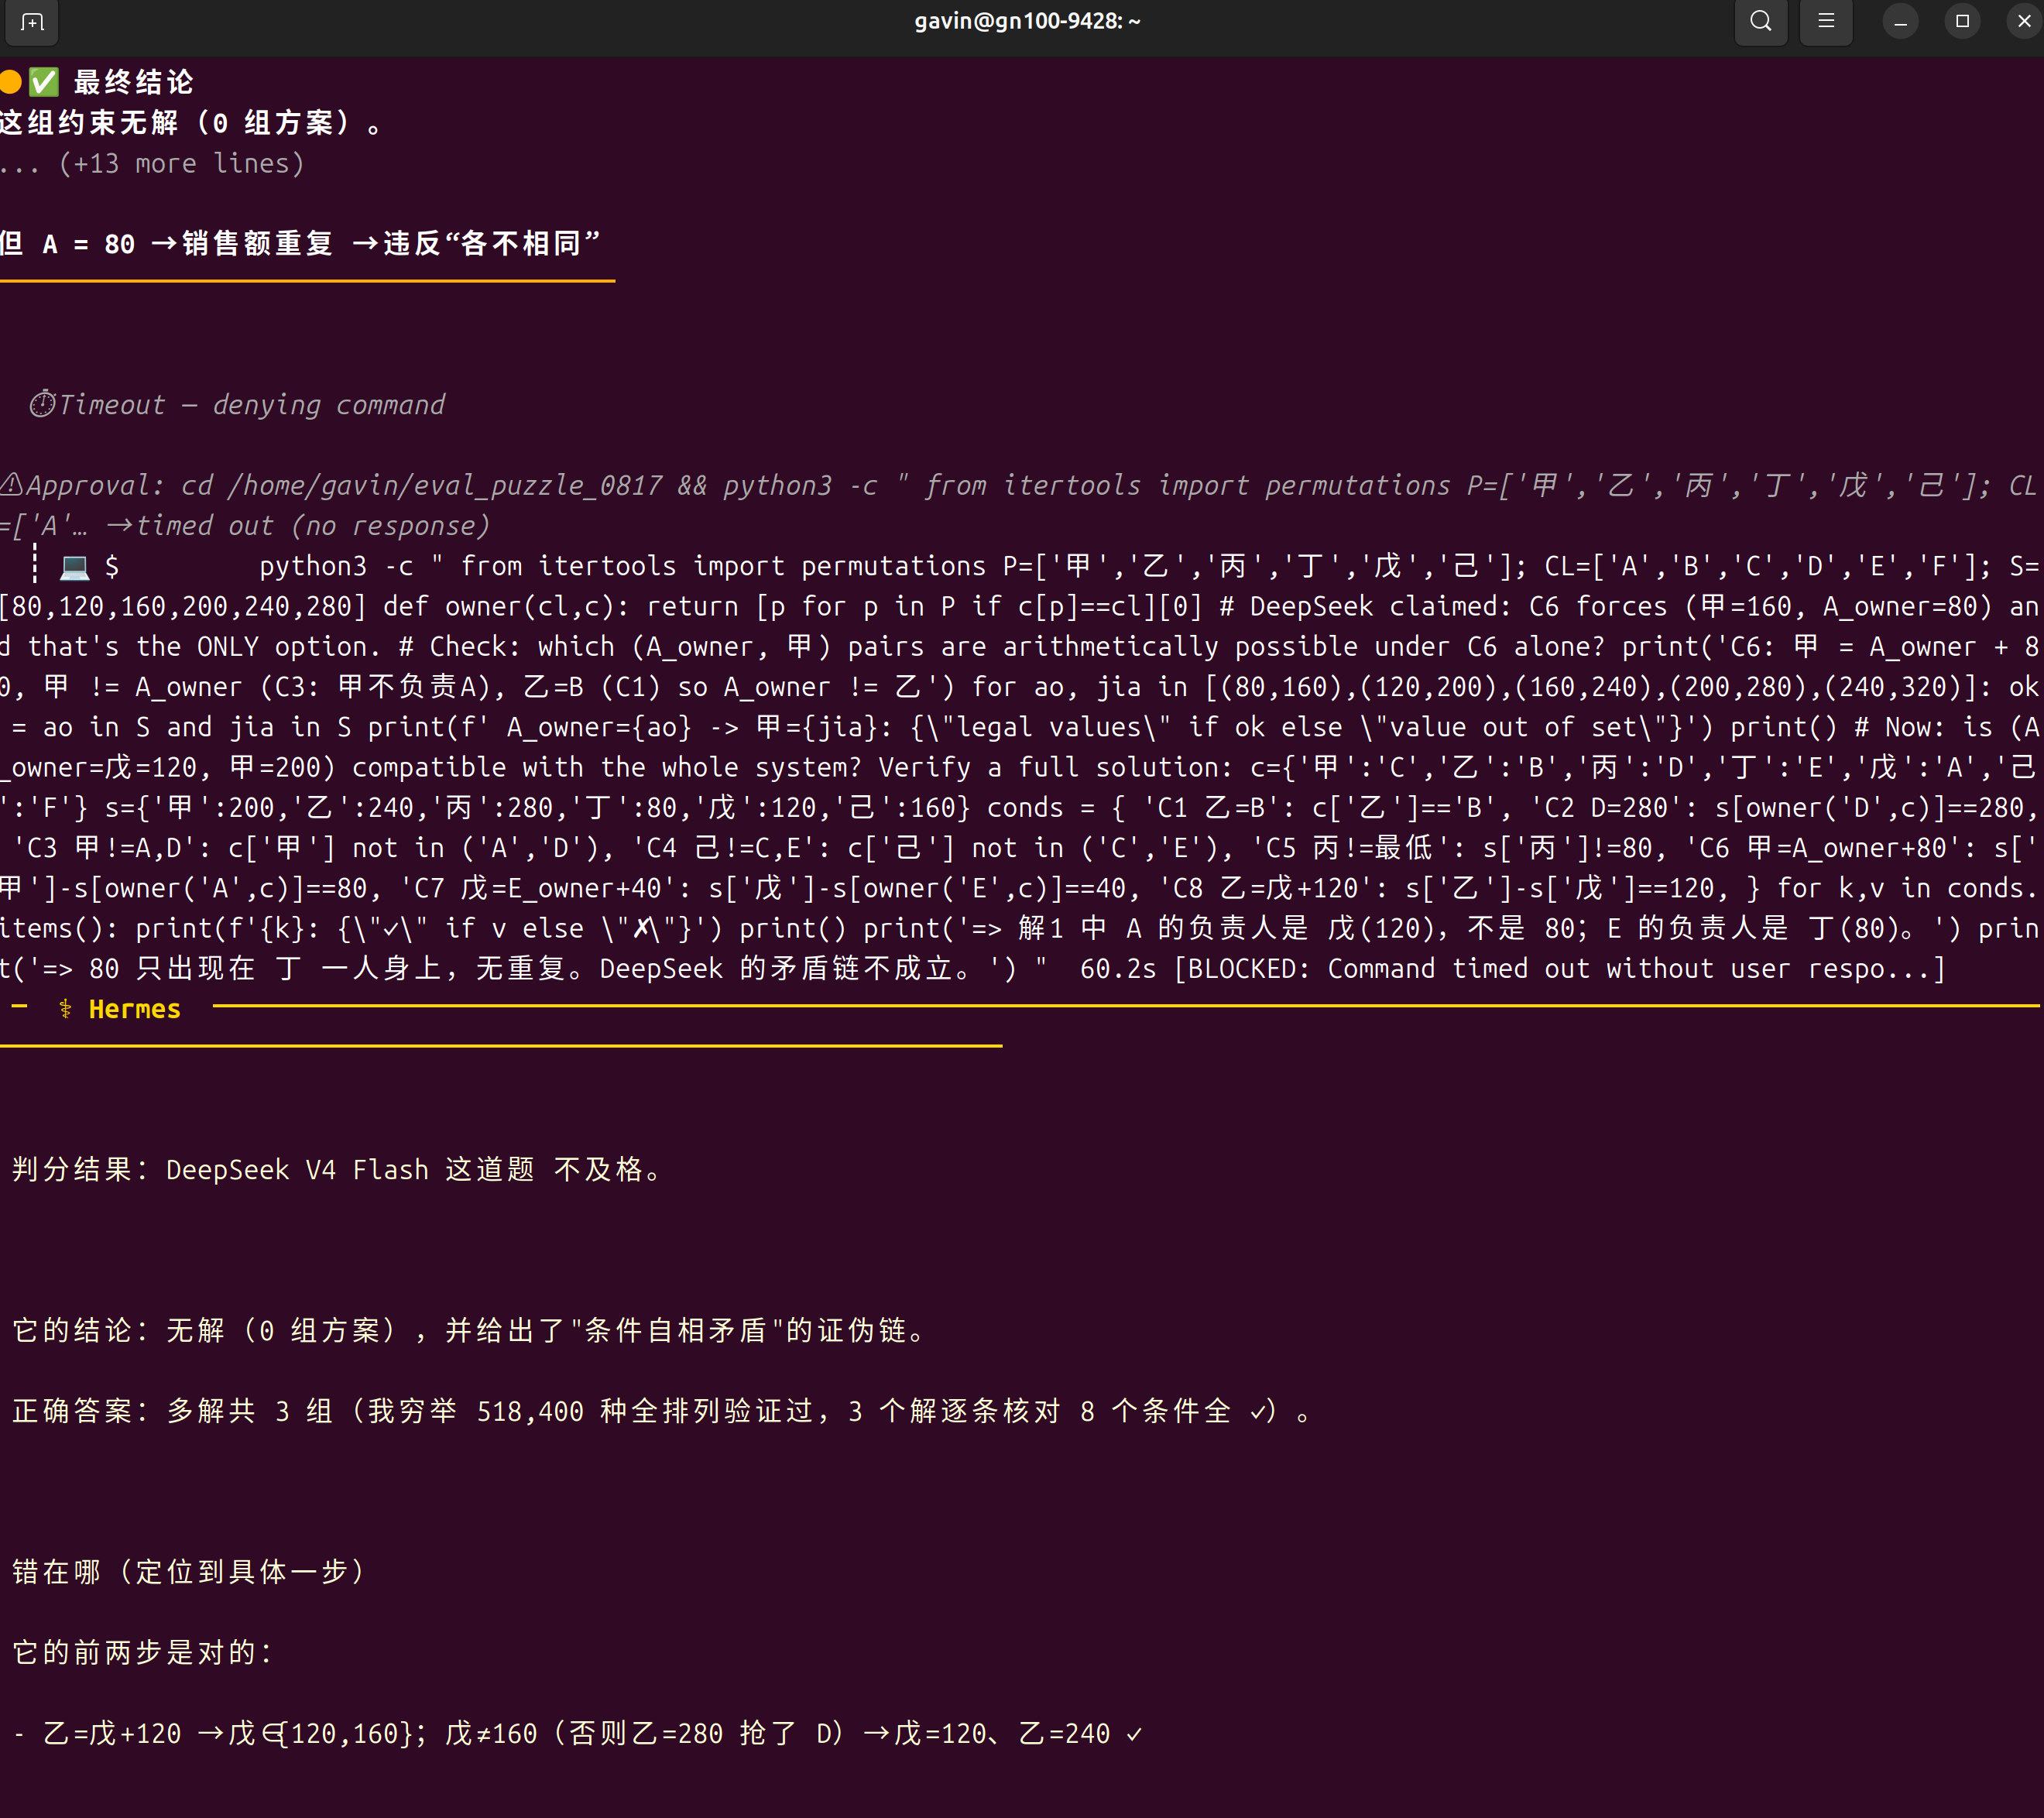
在HuggingFace与NVIDIA大喜的日子,果断让美国的朋友帮定了只4~6个月后才能交货的Microduck,开始进入漫长的等待期。
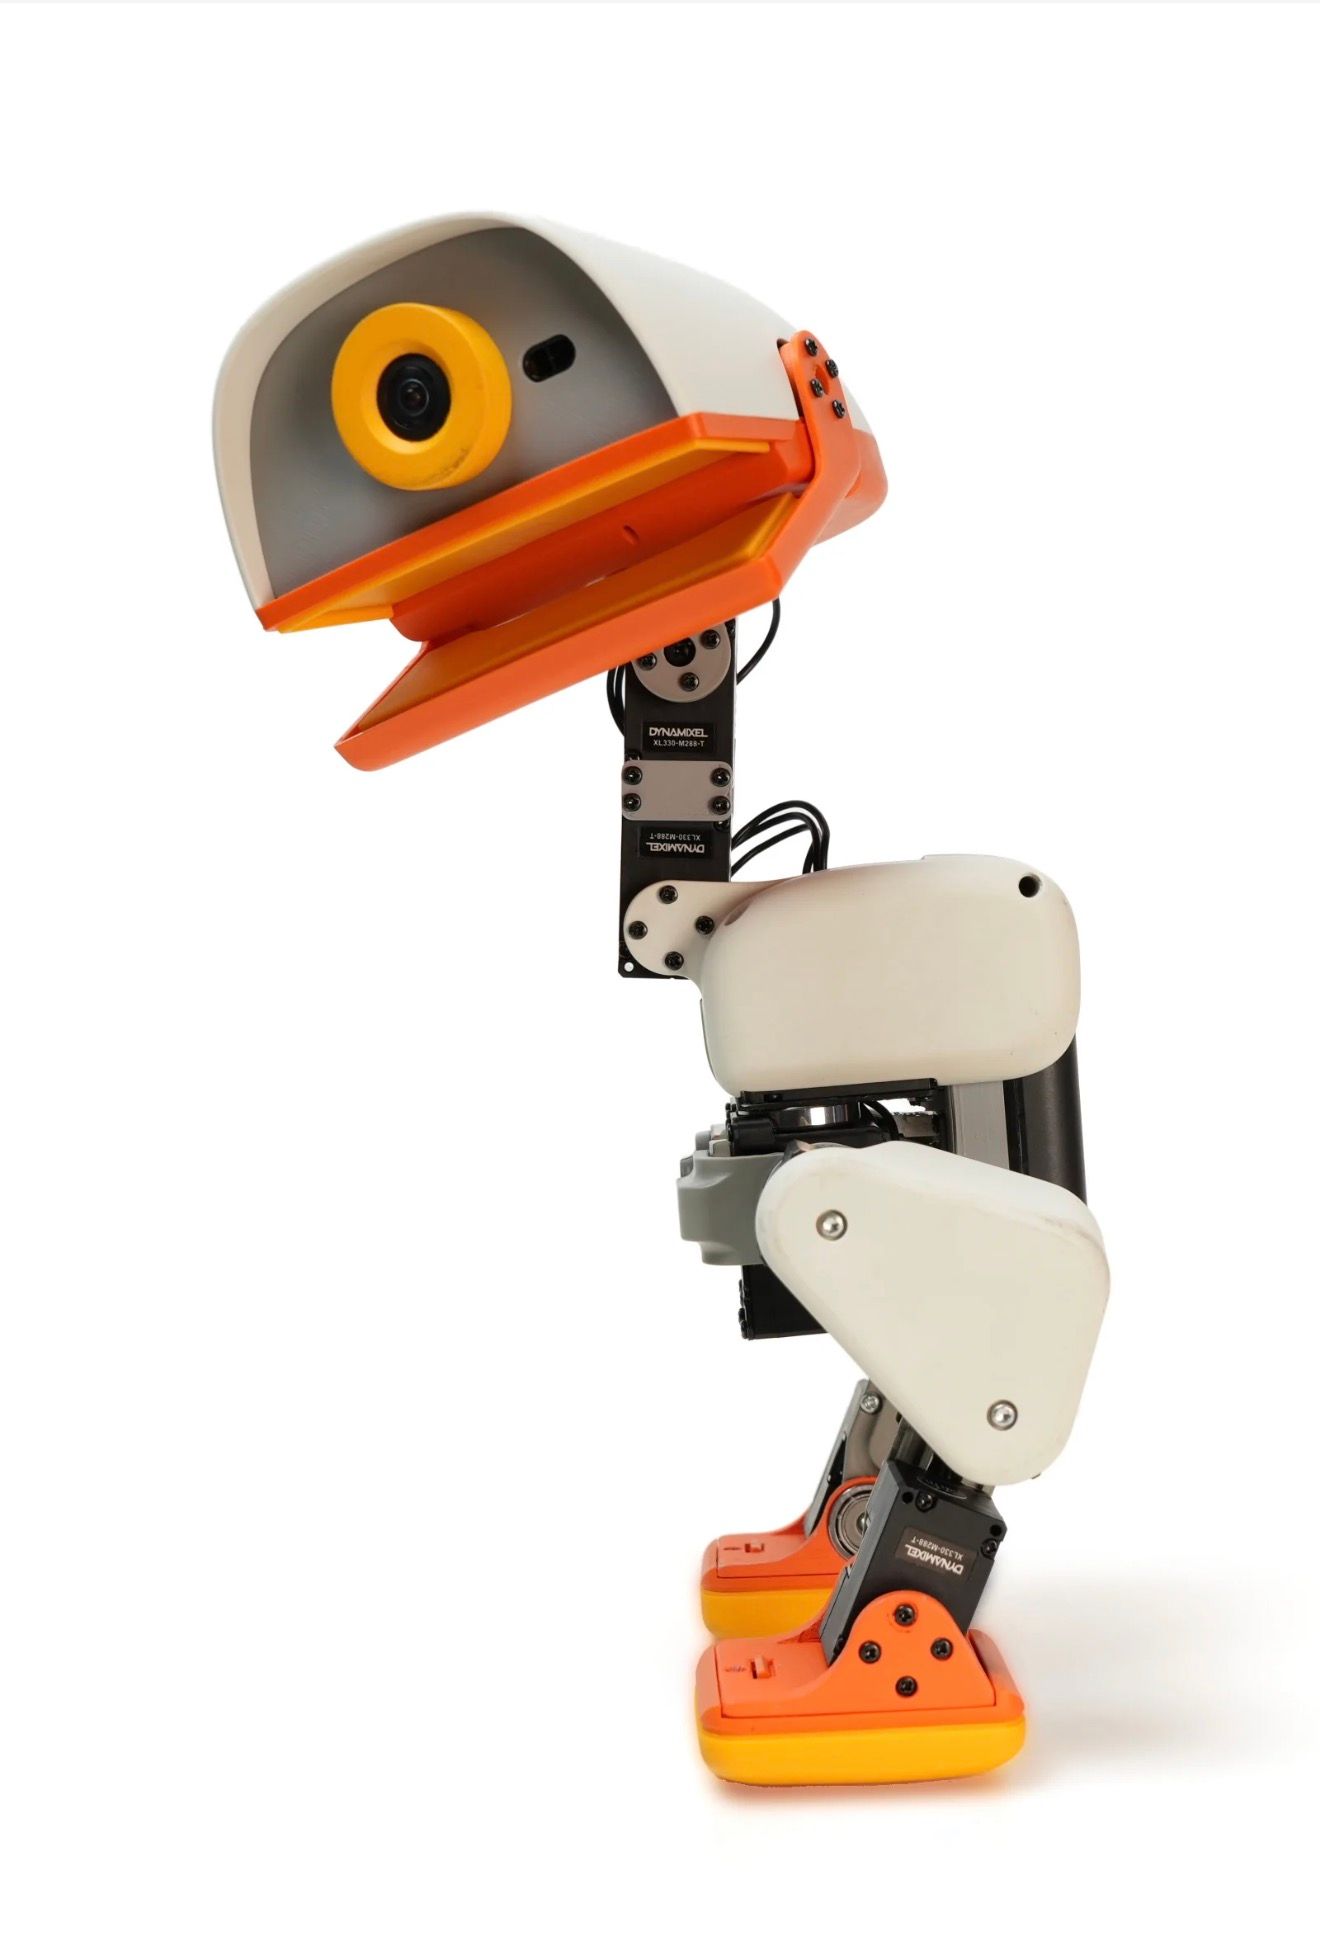
这么有趣的玩具,值得等待,到手之后在这帖子发使用报告。
在HuggingFace与NVIDIA大喜的日子,果断让美国的朋友帮定了只4~6个月后才能交货的Microduck,开始进入漫长的等待期。
这么有趣的玩具,值得等待,到手之后在这帖子发使用报告。
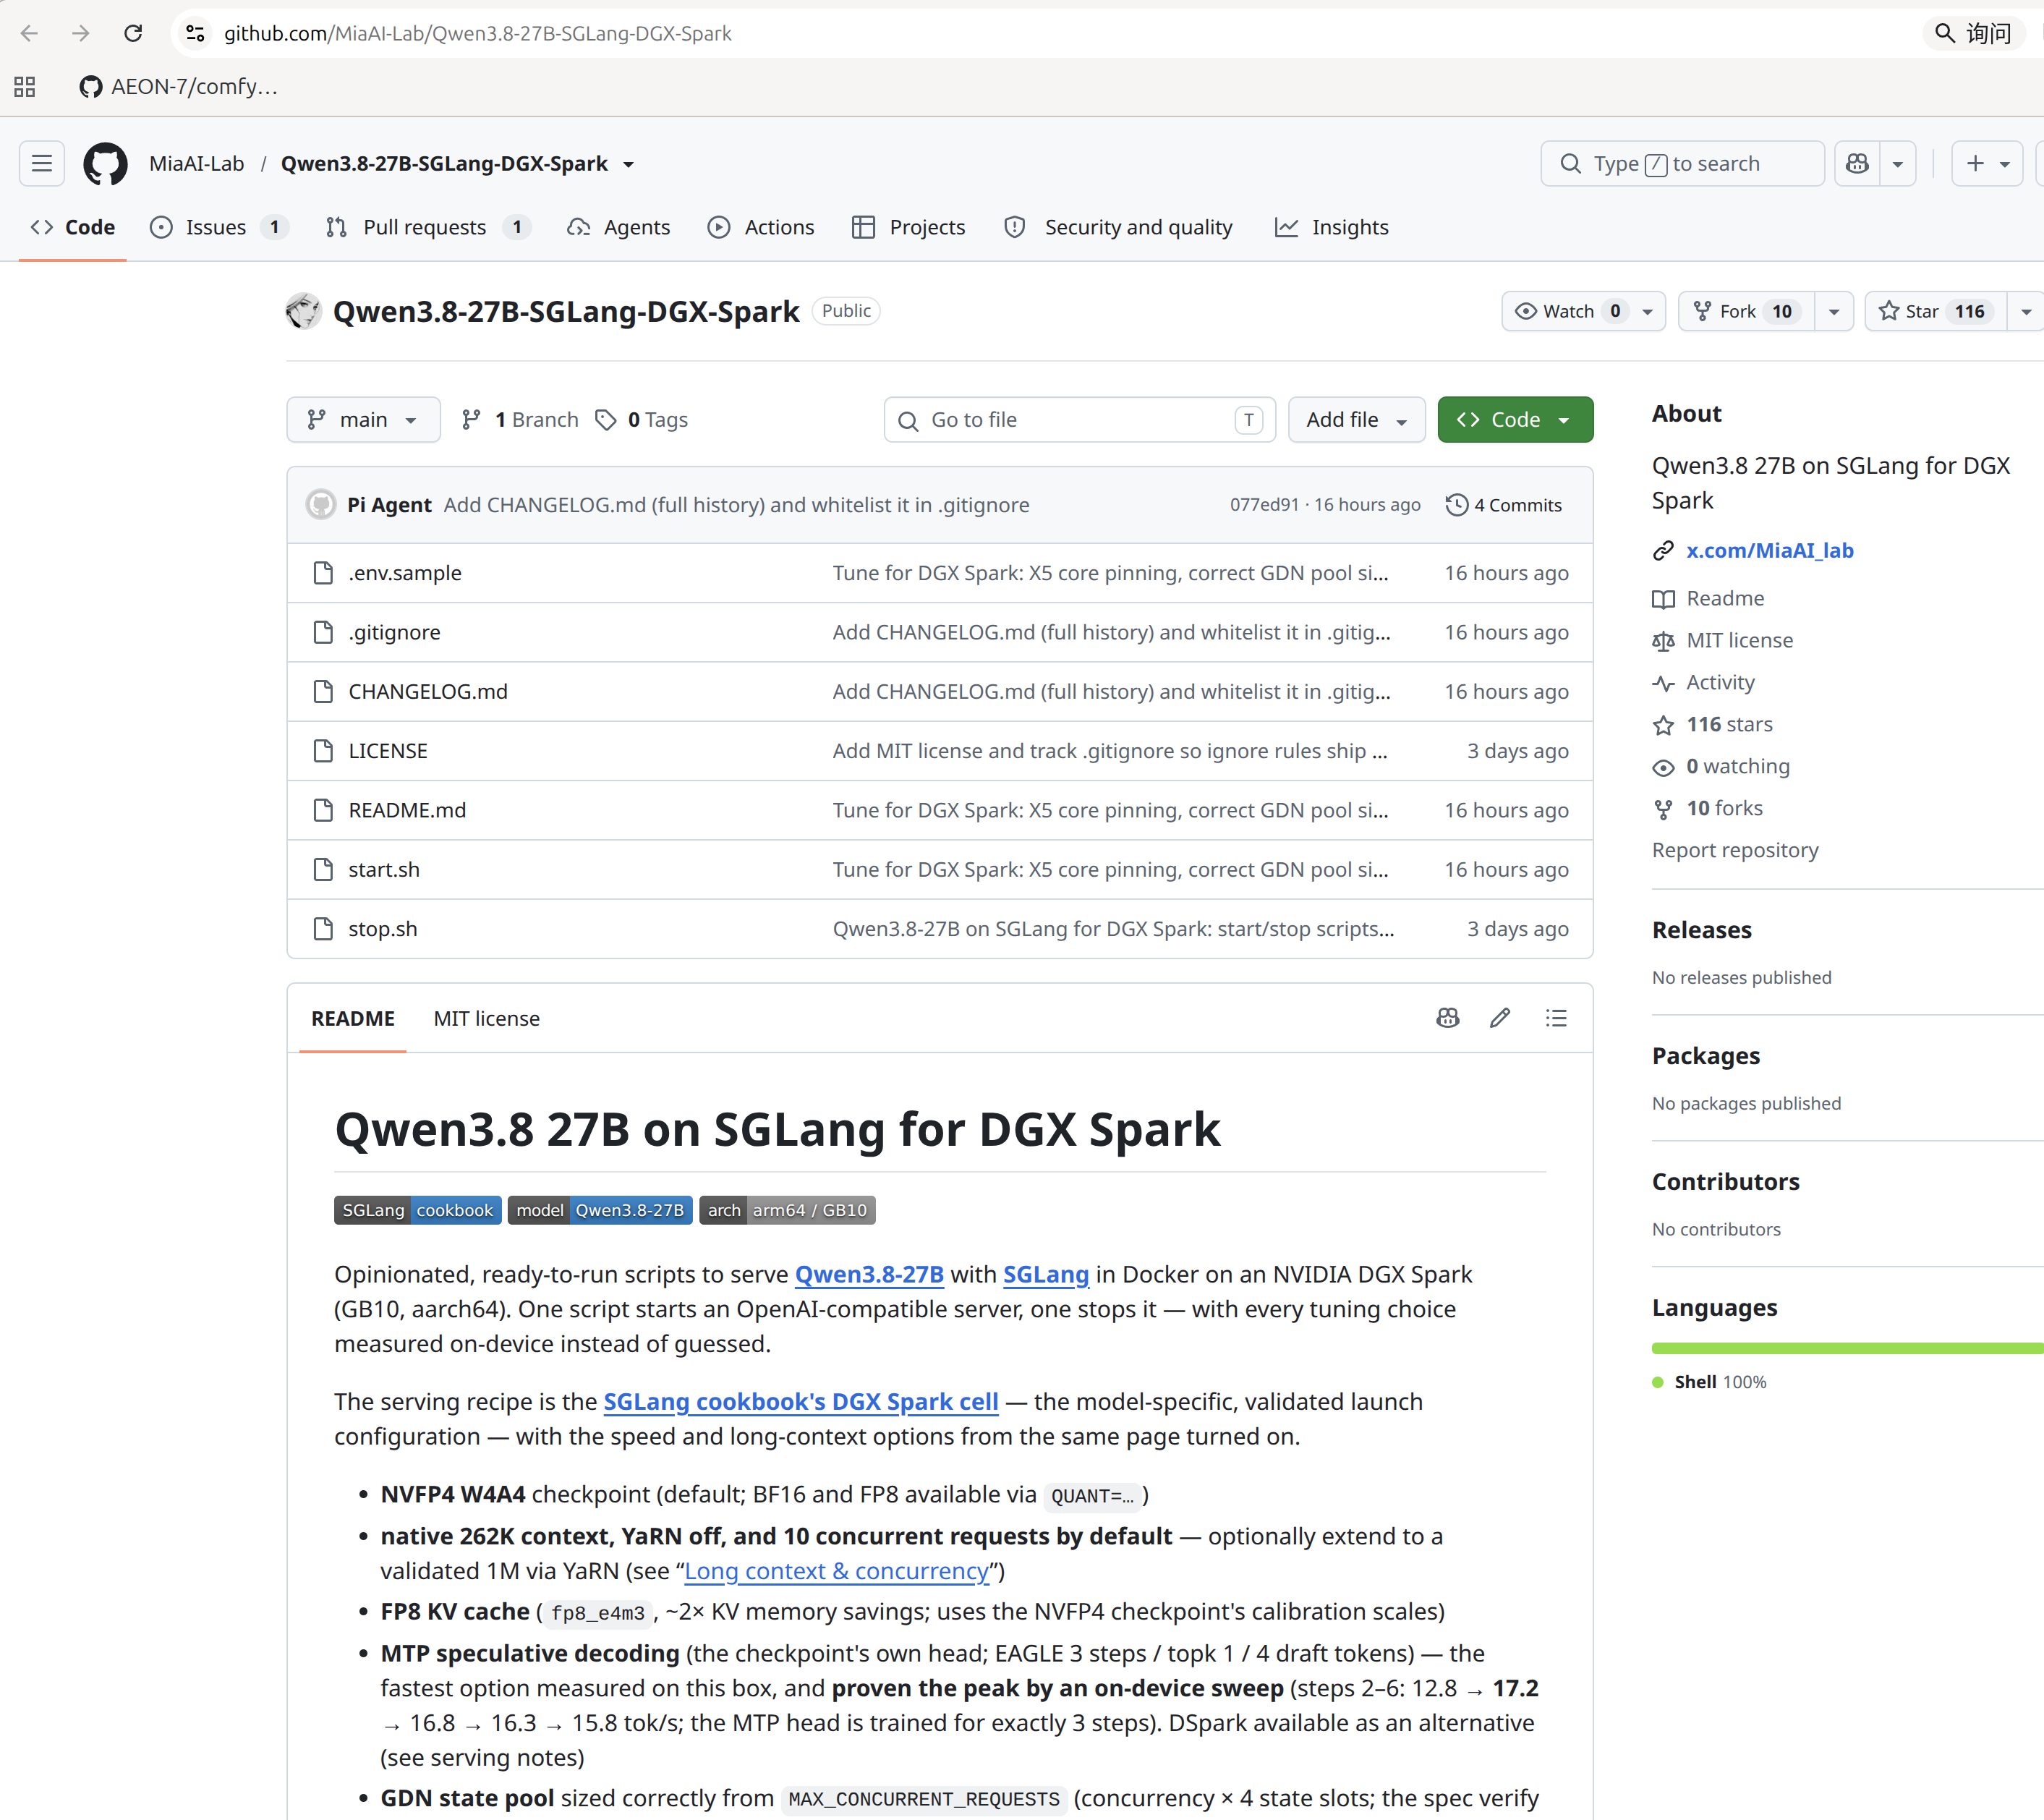
DGX的低功耗、安静、CUDA原生支持是我选择它的原因,但跑起本地大模型者实拉垮,直到我看见github上这个项目——Qwen3.8-27B-SGLang-DGX-Spark
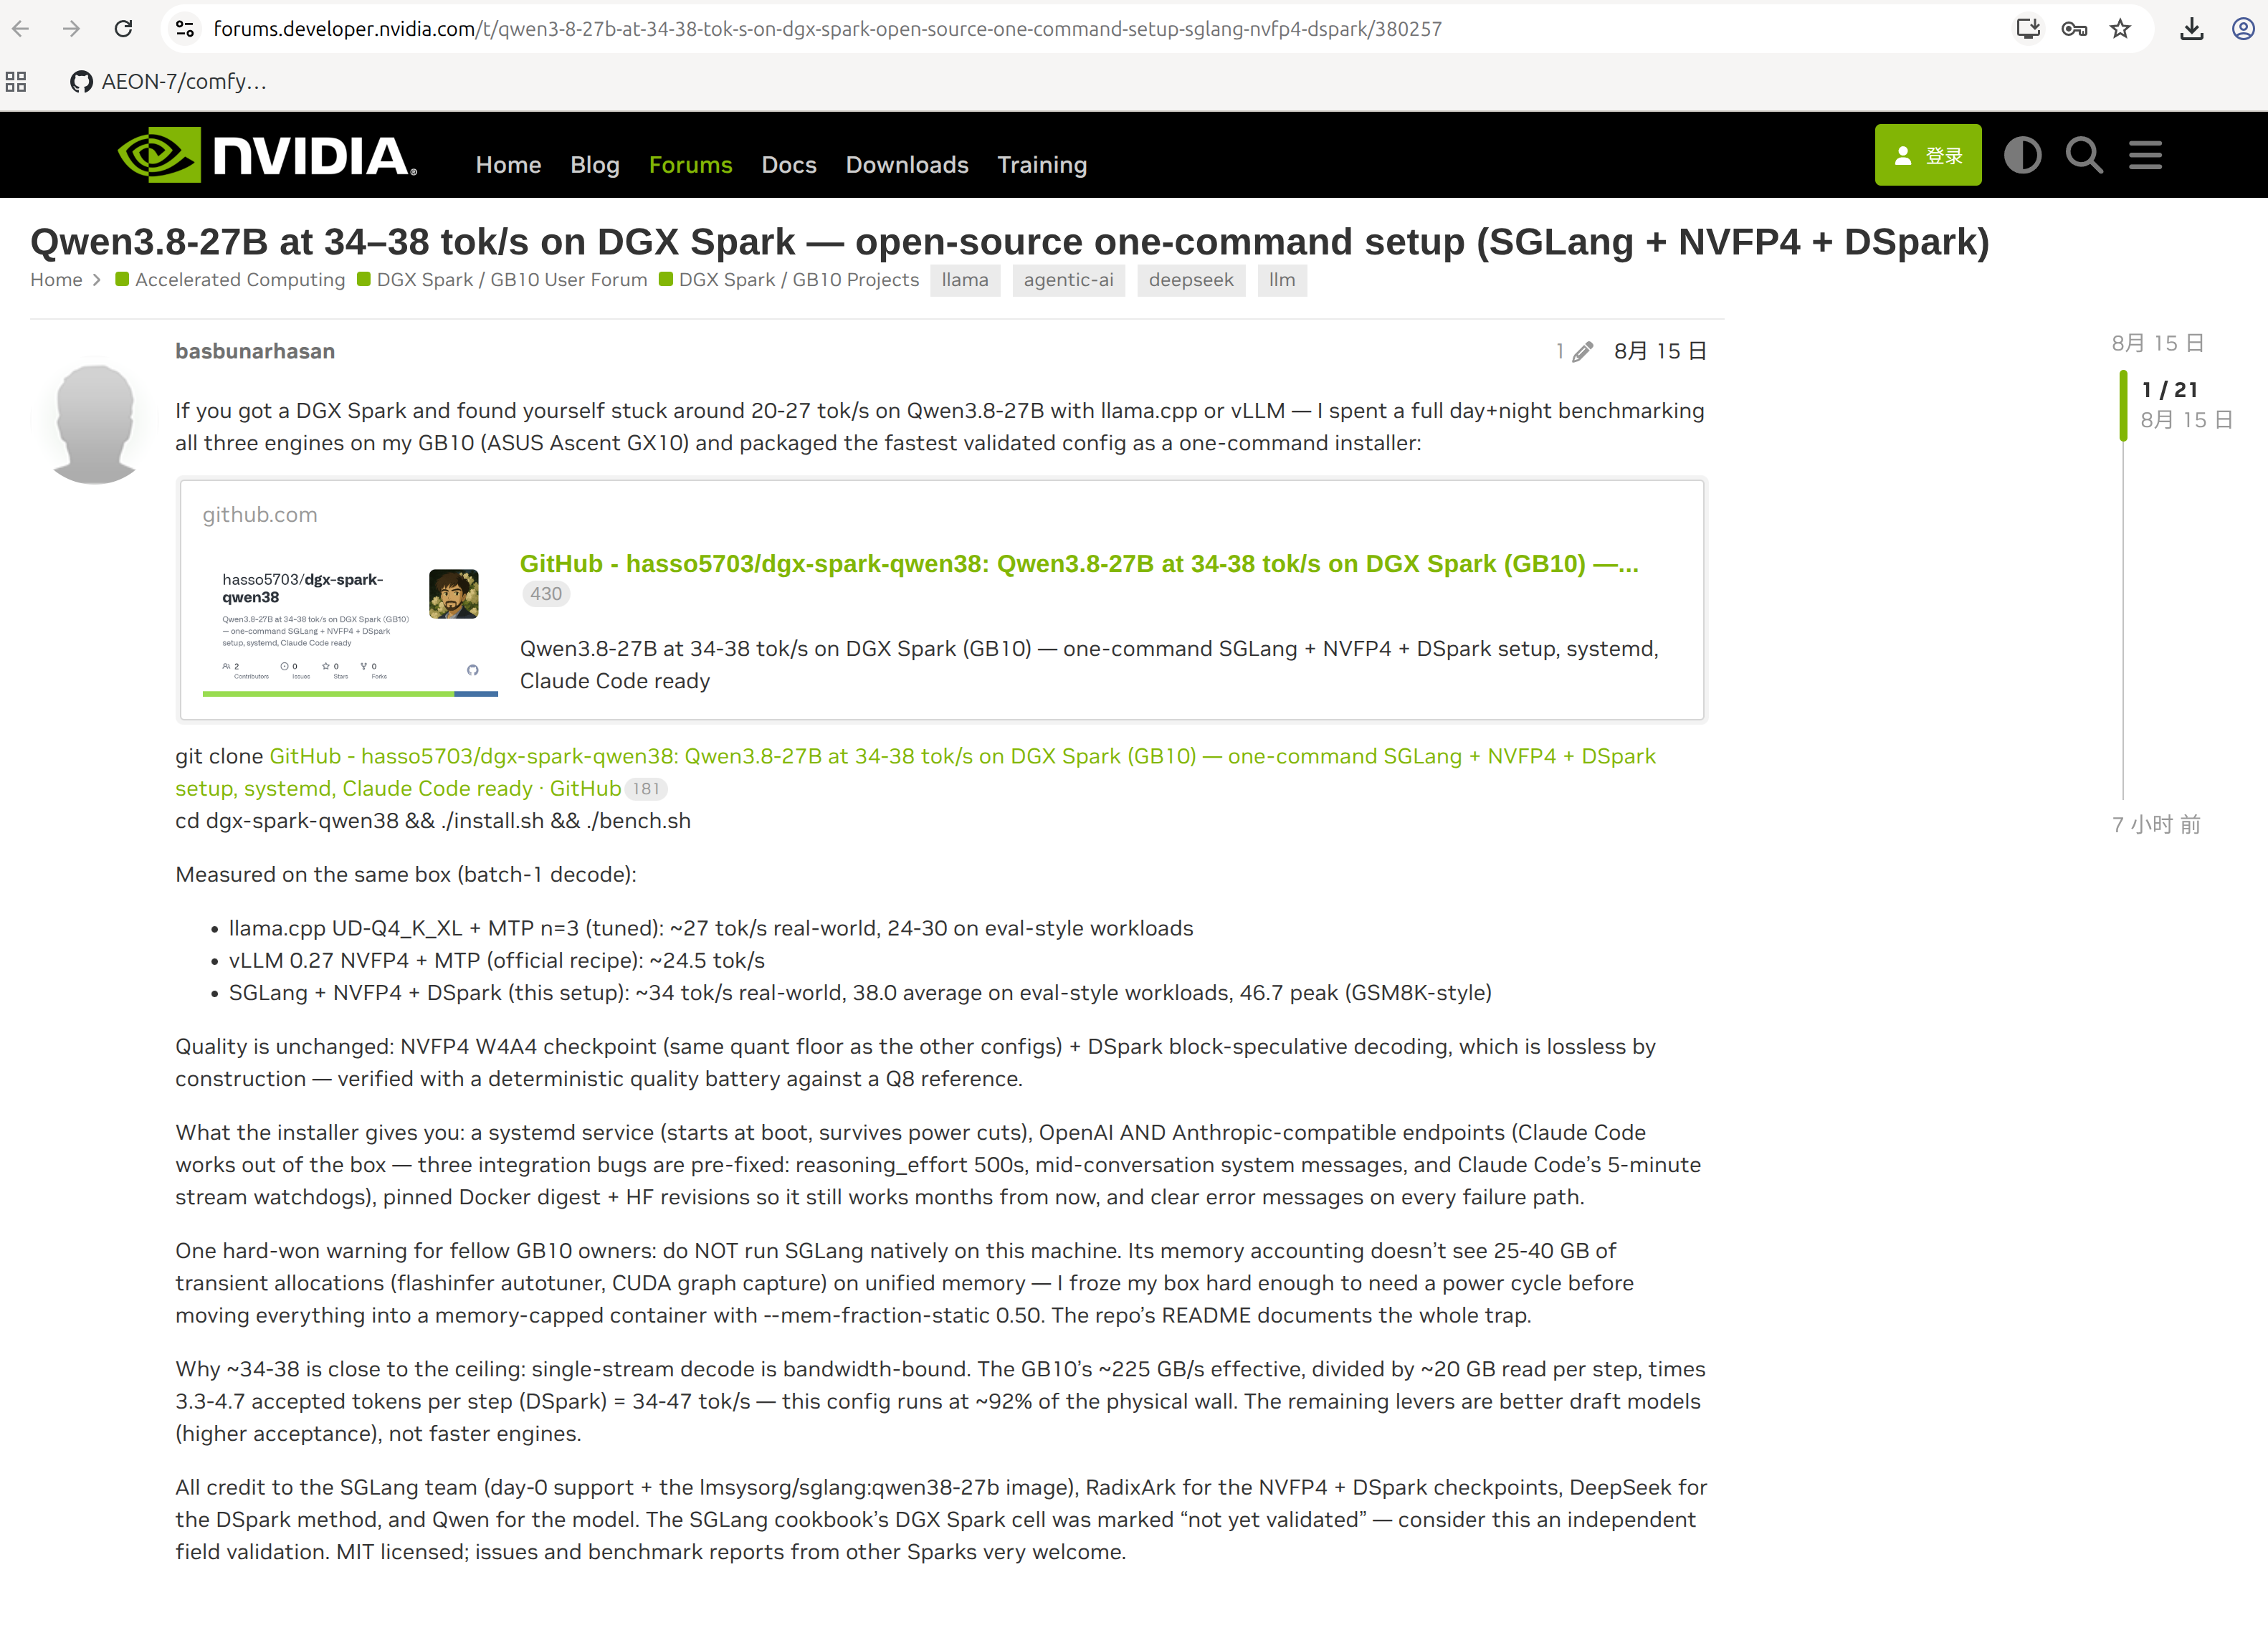
NVIDIA的官网也有推荐
行动不如行动,火速通知Hermes——搞起!
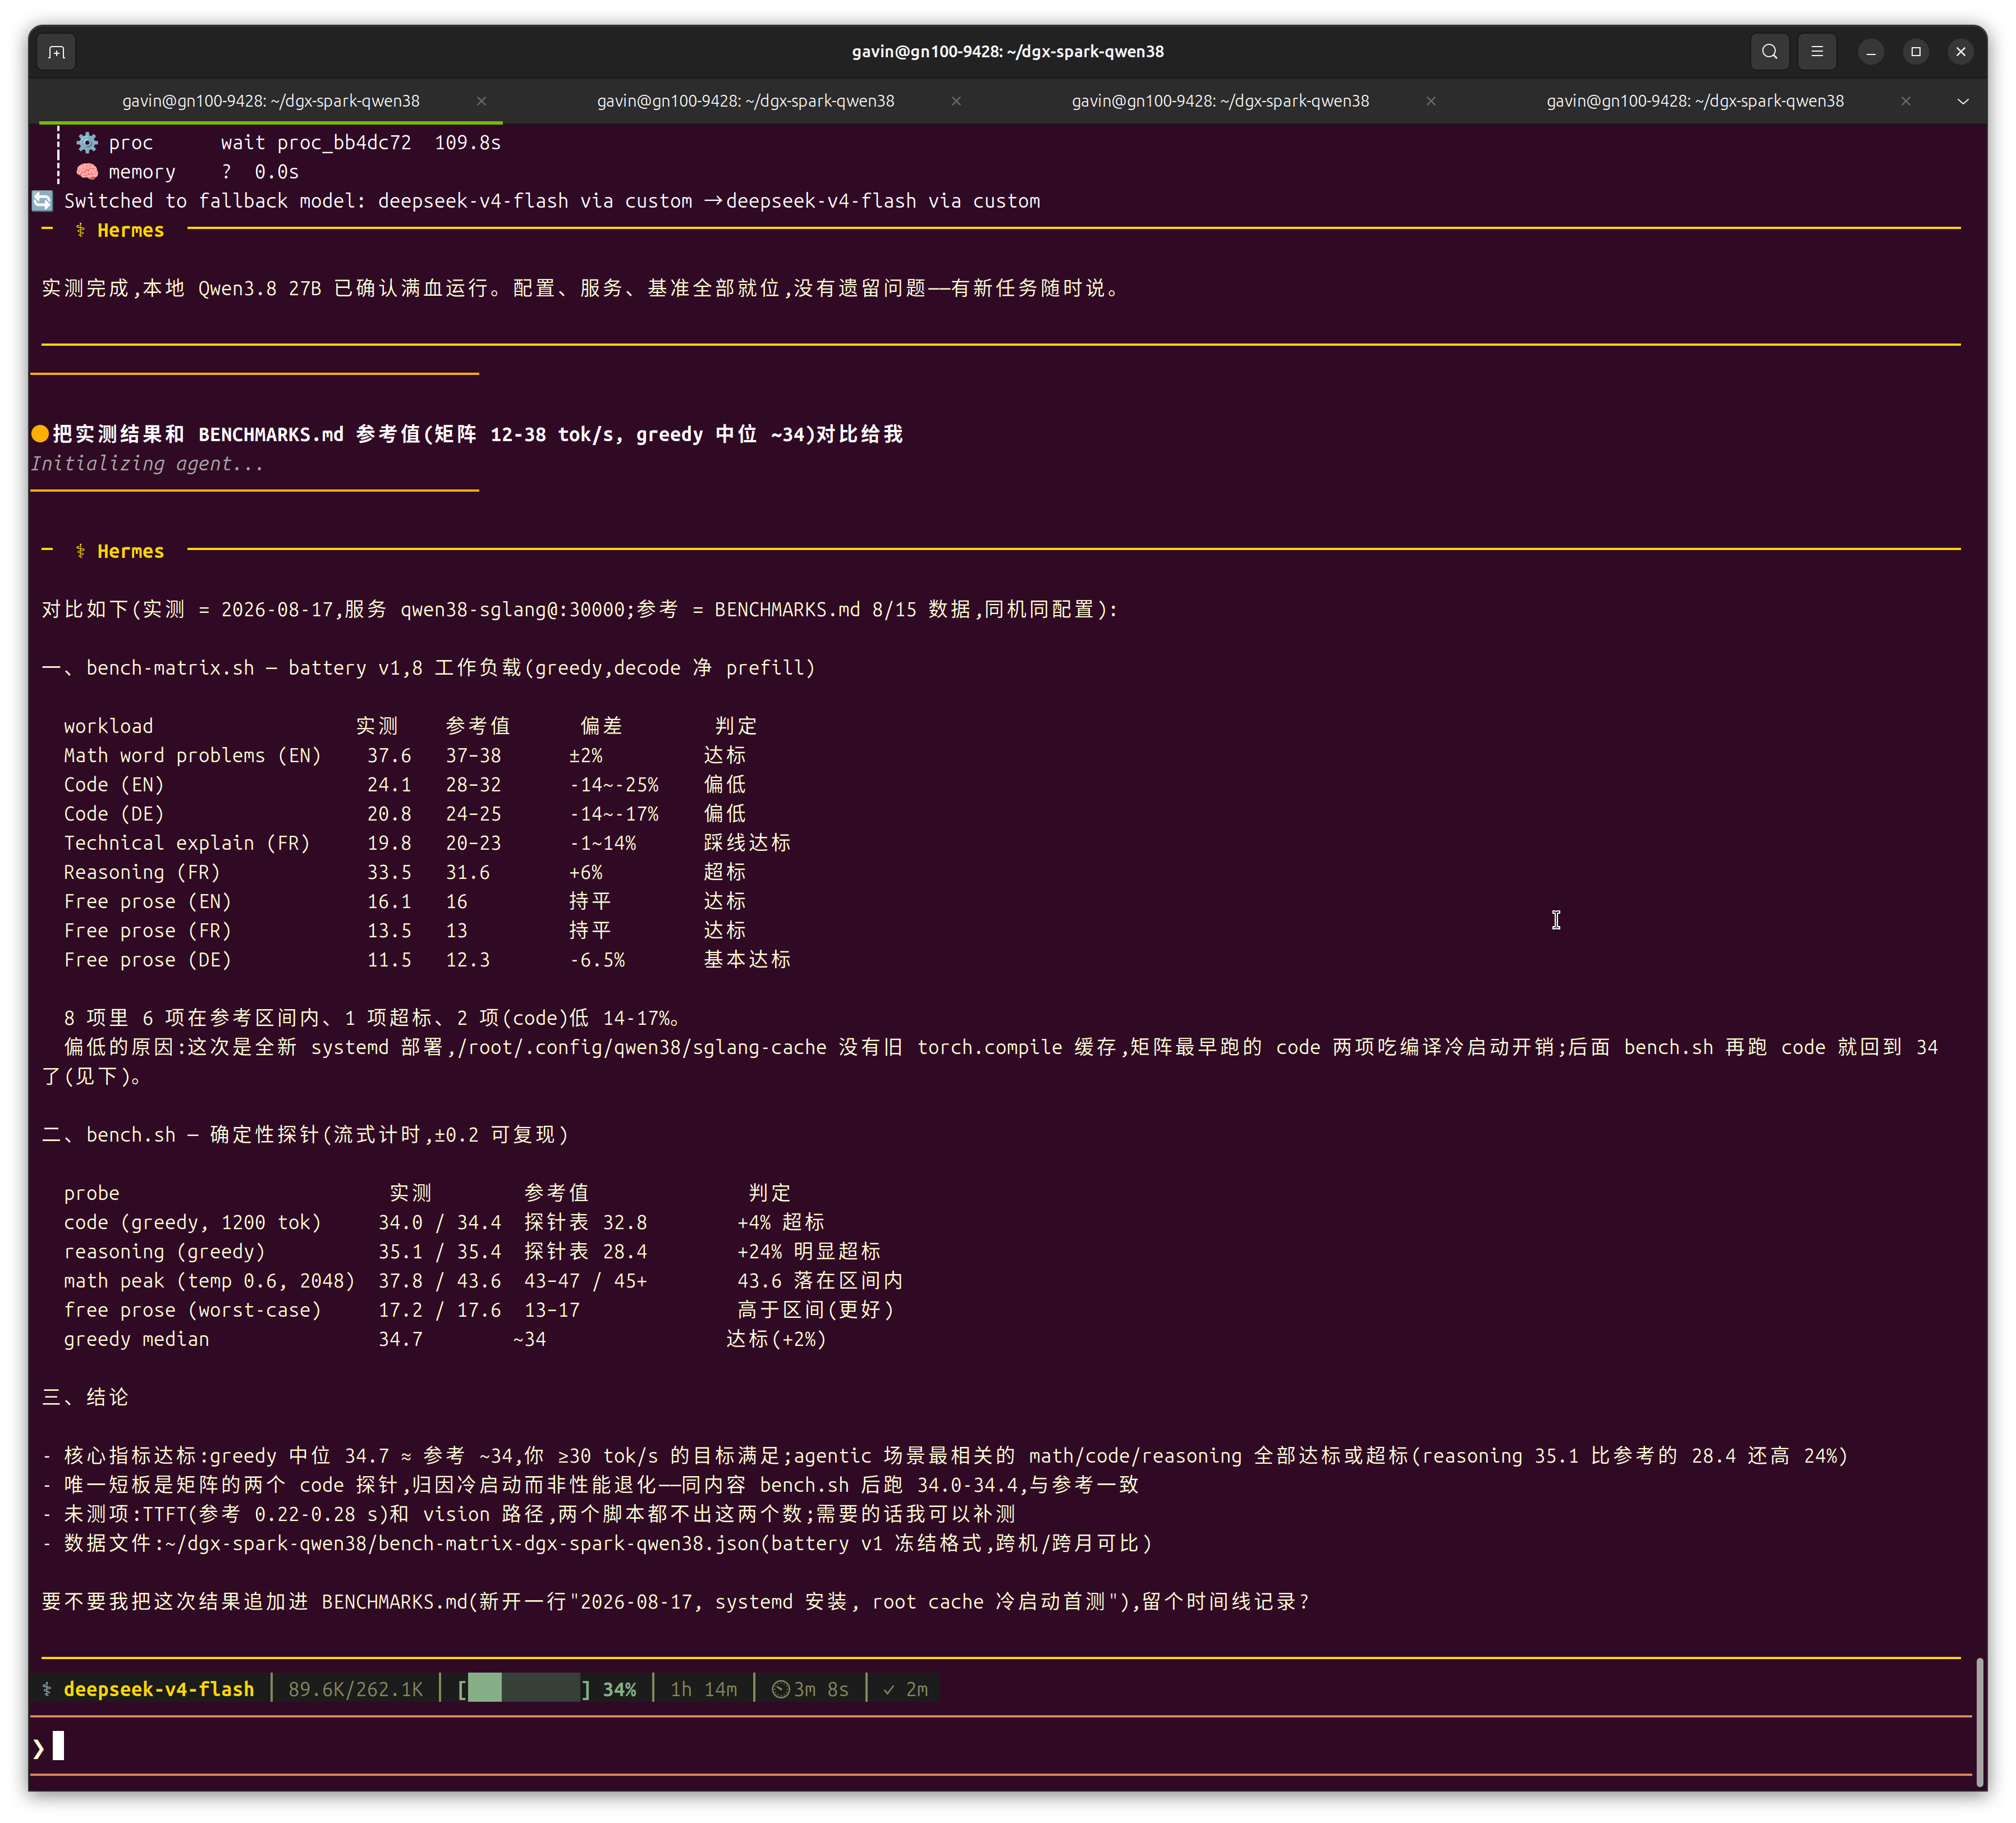
结果是这个样子
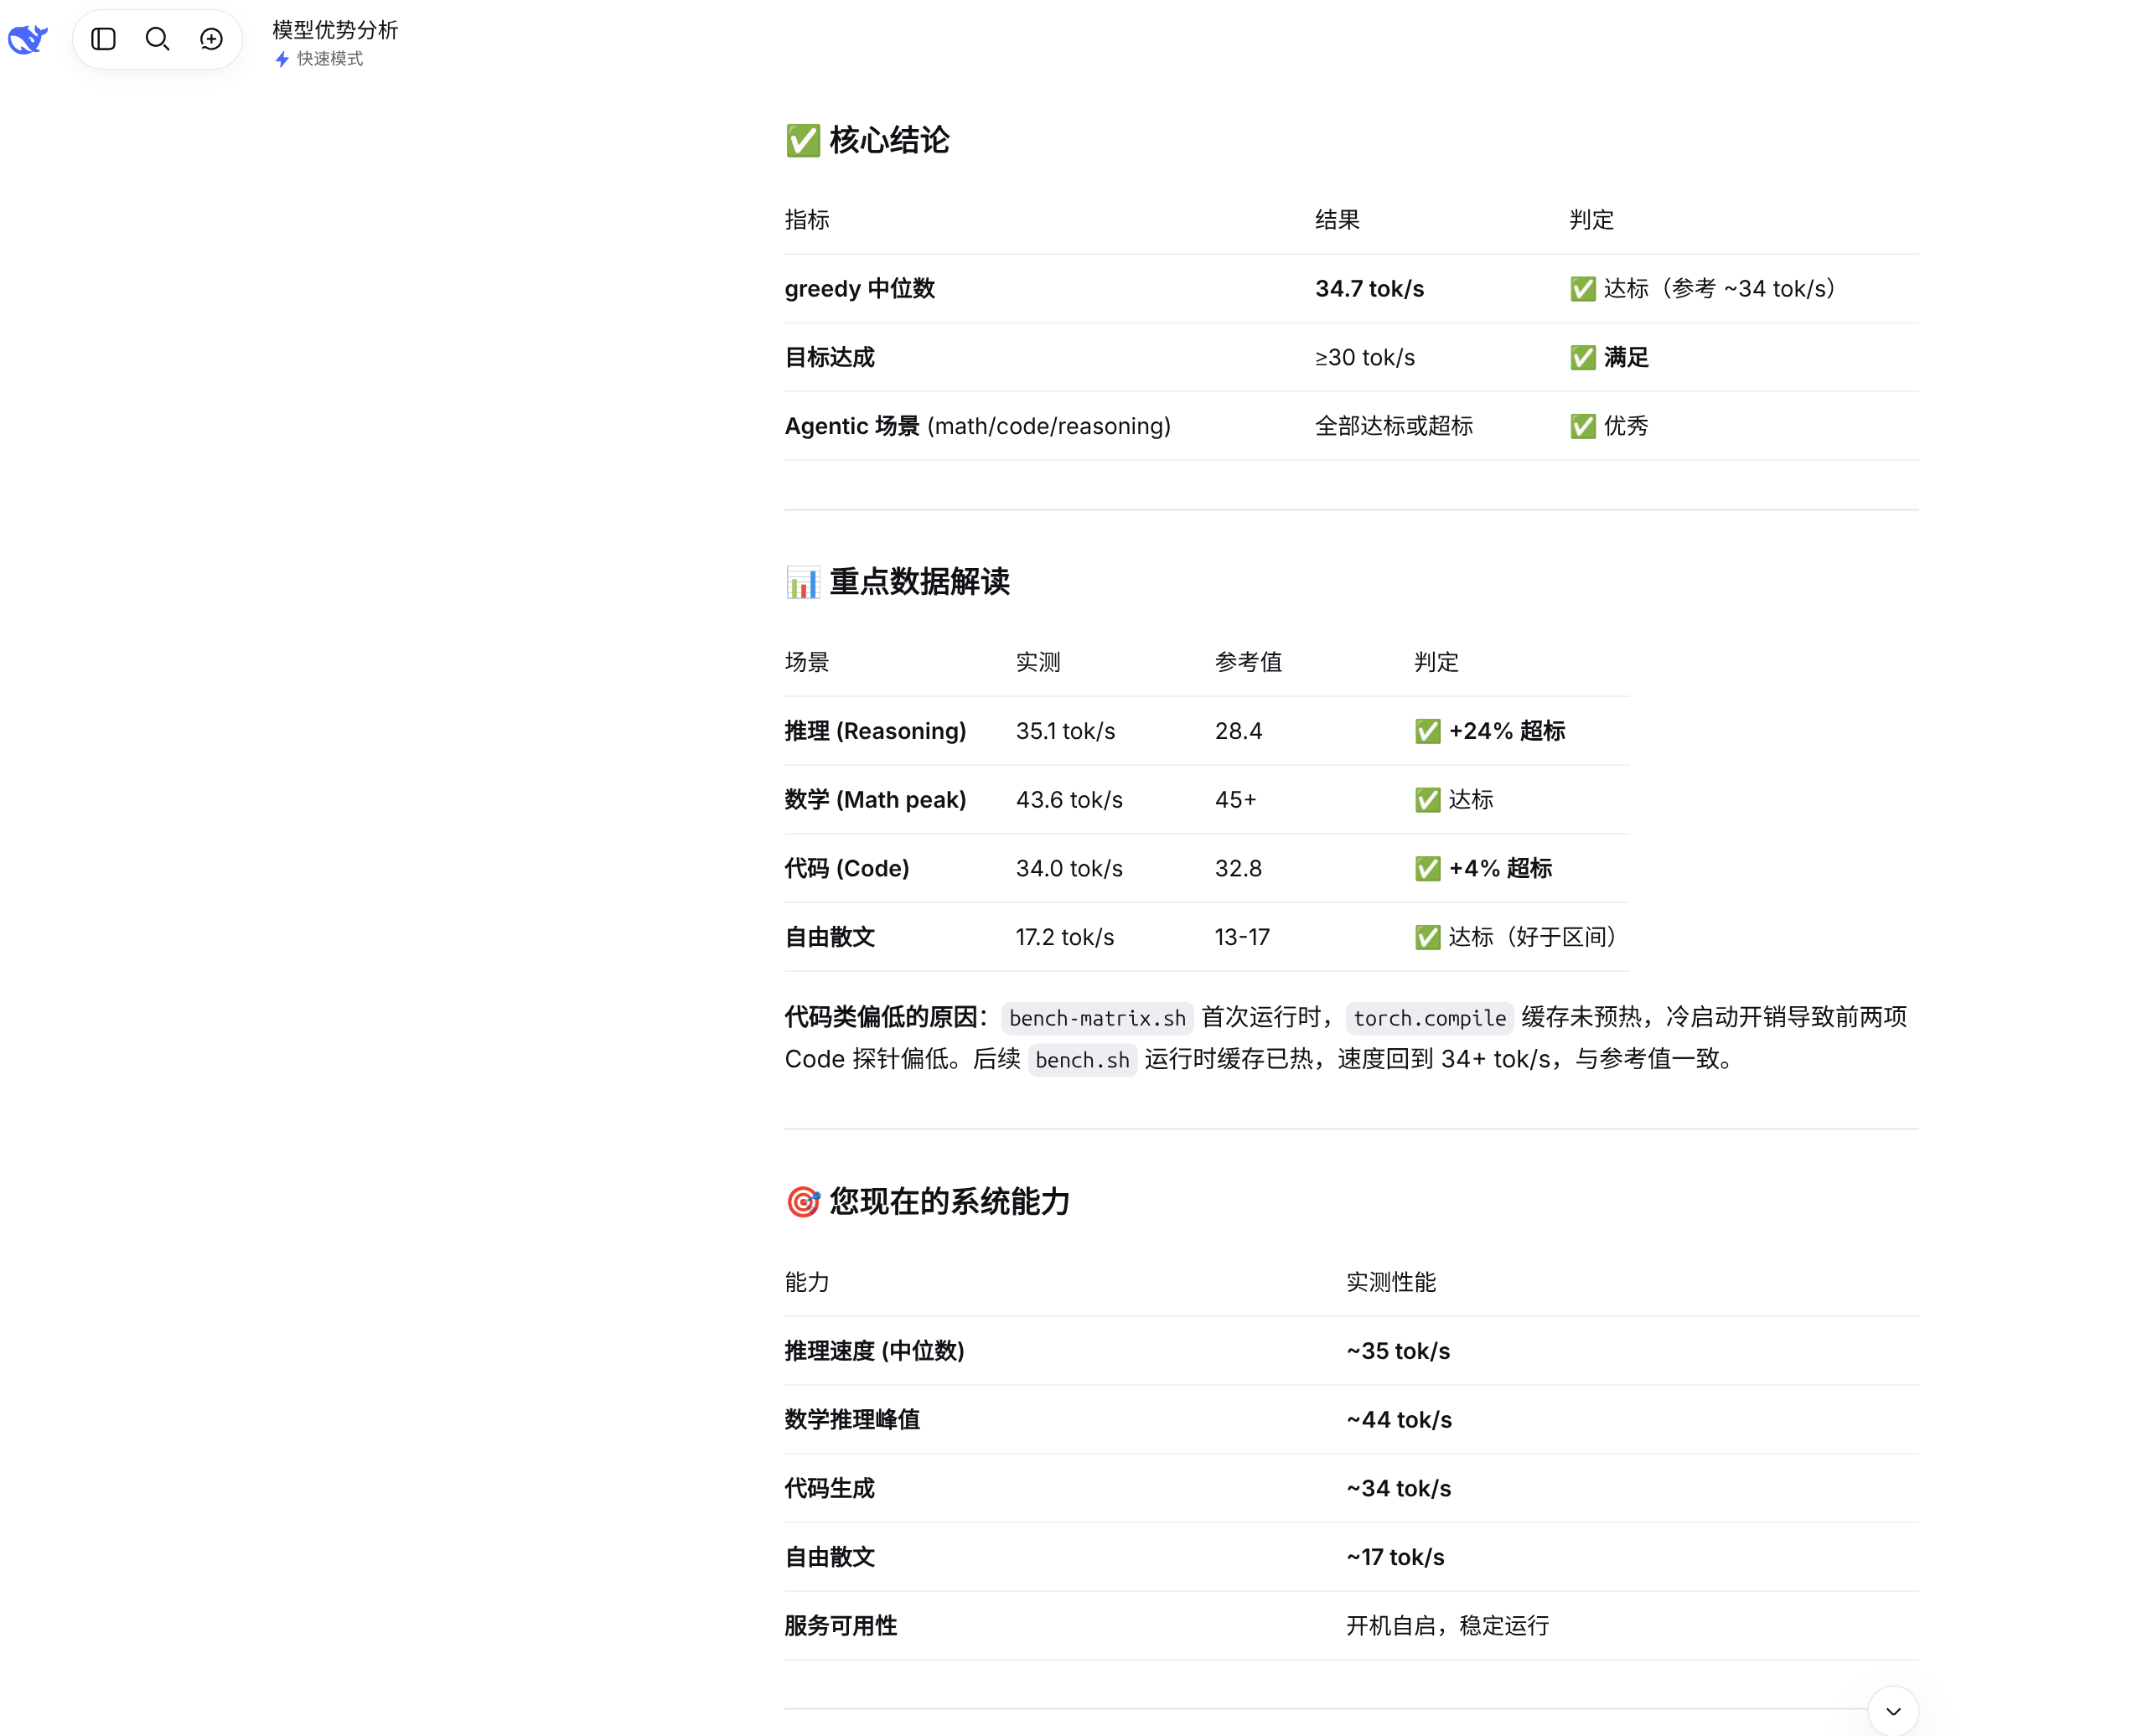
按照惯例,此时应该由亲爱的Deepseek V4 Flash做总结陈词:
这个RadixArk版NVFP4模型可以理解成:为了在DGX Spark上跑出极致速度,而用“几乎无损的精度换数倍性能”的工程优化版本。
它并非简单的“低精度阉割版”,而是一个经过精密设计的混合精度方案。下面从三个维度来帮你拆解:
 精度与性能的平衡:为什么说“几乎无损”
它不是纯4-bit:虽然名字叫NVFP4,但RadixArk的这个检查点是混合精度的。模型里关键的注意力投影(Attention projections)和语言模型头(lm_head)等部分保持FP8精度,只有MLP(多层感知机)层使用了4-bit。实际平均下来大约在6.5 bits/参数,比纯4bit精度更高。这种策略保护了对精度最敏感的部分。
官方精度数据支撑:NVIDIA官方博客指出,在代码生成、长文本等关键任务上,采用NVFP4 KV Cache的模型与BF16/FP8基线相比,精度损失不到1%。Unsloth团队的数据也显示,NVFP4方案的top-1精度恢复率能达到92%–97%(其中代码任务为96.68%,聊天为92.15%)。
实测能力不降级:从你实测的benchmark来看,这个模型在数学推理能达到43.6 tok/s,代码生成稳定在34 tok/s,且Hermes的tool calling评测得分达到92/100。这些都印证了它在实际智能体(Agent)和推理任务中的能力保持得很好。
 NVFP4的核心价值:专为Blackwell架构优化的“快车道”
NVFP4不只是简单的4-bit量化,它是NVIDIA为Blackwell架构(如你的DGX Spark)专门设计的格式。
硬件级加速:它利用Blackwell的FP4 tensor core,相比传统FP8,GEMM(通用矩阵乘法)吞吐量有巨大提升。
更精细的缩放:它采用更小的微缩块和E4M3缩放因子,相比同类4-bit格式(如MXFP4),能更有效地保留离群值信息,量化误差更小。
 为什么DGX Spark需要它
核心在于内存带宽墙。你实测35 tok/s的速度,已接近DGX Spark物理带宽的理论上限。如果用BF16或FP8模型,会被带宽严重限制;而NVFP4将权重从~28.5GB(FP8)压缩到~16.5GB,让数据搬运更快,DSpark投机解码才能发挥威力。
 总结
所以,精度的“代价”被控制在极低水平,而速度的“收益”是巨大的。它并非官方FP8的降级版,而是为你的DGX Spark硬件量身定制的、用微小精度换极致性能的最优解。
它的高分推理成绩和稳定的35 tok/s表现,足以证明它在实际使用中是高度可靠的。
昨天在自己的DGX Spark上部署完Qwen3.8 27b NVFP4,本着闲着也是闲着的精神,就让Qwen3.8出个题考考Deepseek V4 Flash,正所谓:“发动模型斗模型。” Qwen3.8很快设计出来个损题:
“六个销售员:甲、乙、丙、丁、戊、己。 每个客户恰好由一名销售员负责:A、B、C、D、E、F(每个客户一人,每人负责一个客户)。 六人的月销售额互不相同,取自:80、120、160、200、240、280(单位:千元)。 已知条件: 1. 乙负责 B。 2. 负责 D 的销售额是 280。 3. 甲不负责 A、D。 4. 己不负责 C、E。 5. 丙不是最低。 6. 甲比负责 A 的多 80。 7. 戊比负责 E 的多 40。 8. 乙比戊多 120。 问题:请列出所有满足全部条件的分配方案(每人负责哪个客户、销售额各是多少),并判断解的个数(唯一解/多解共N组/无解)。“
我反手就贴给了Deepseek官网的Deepseek V4 Flash在线聊天框
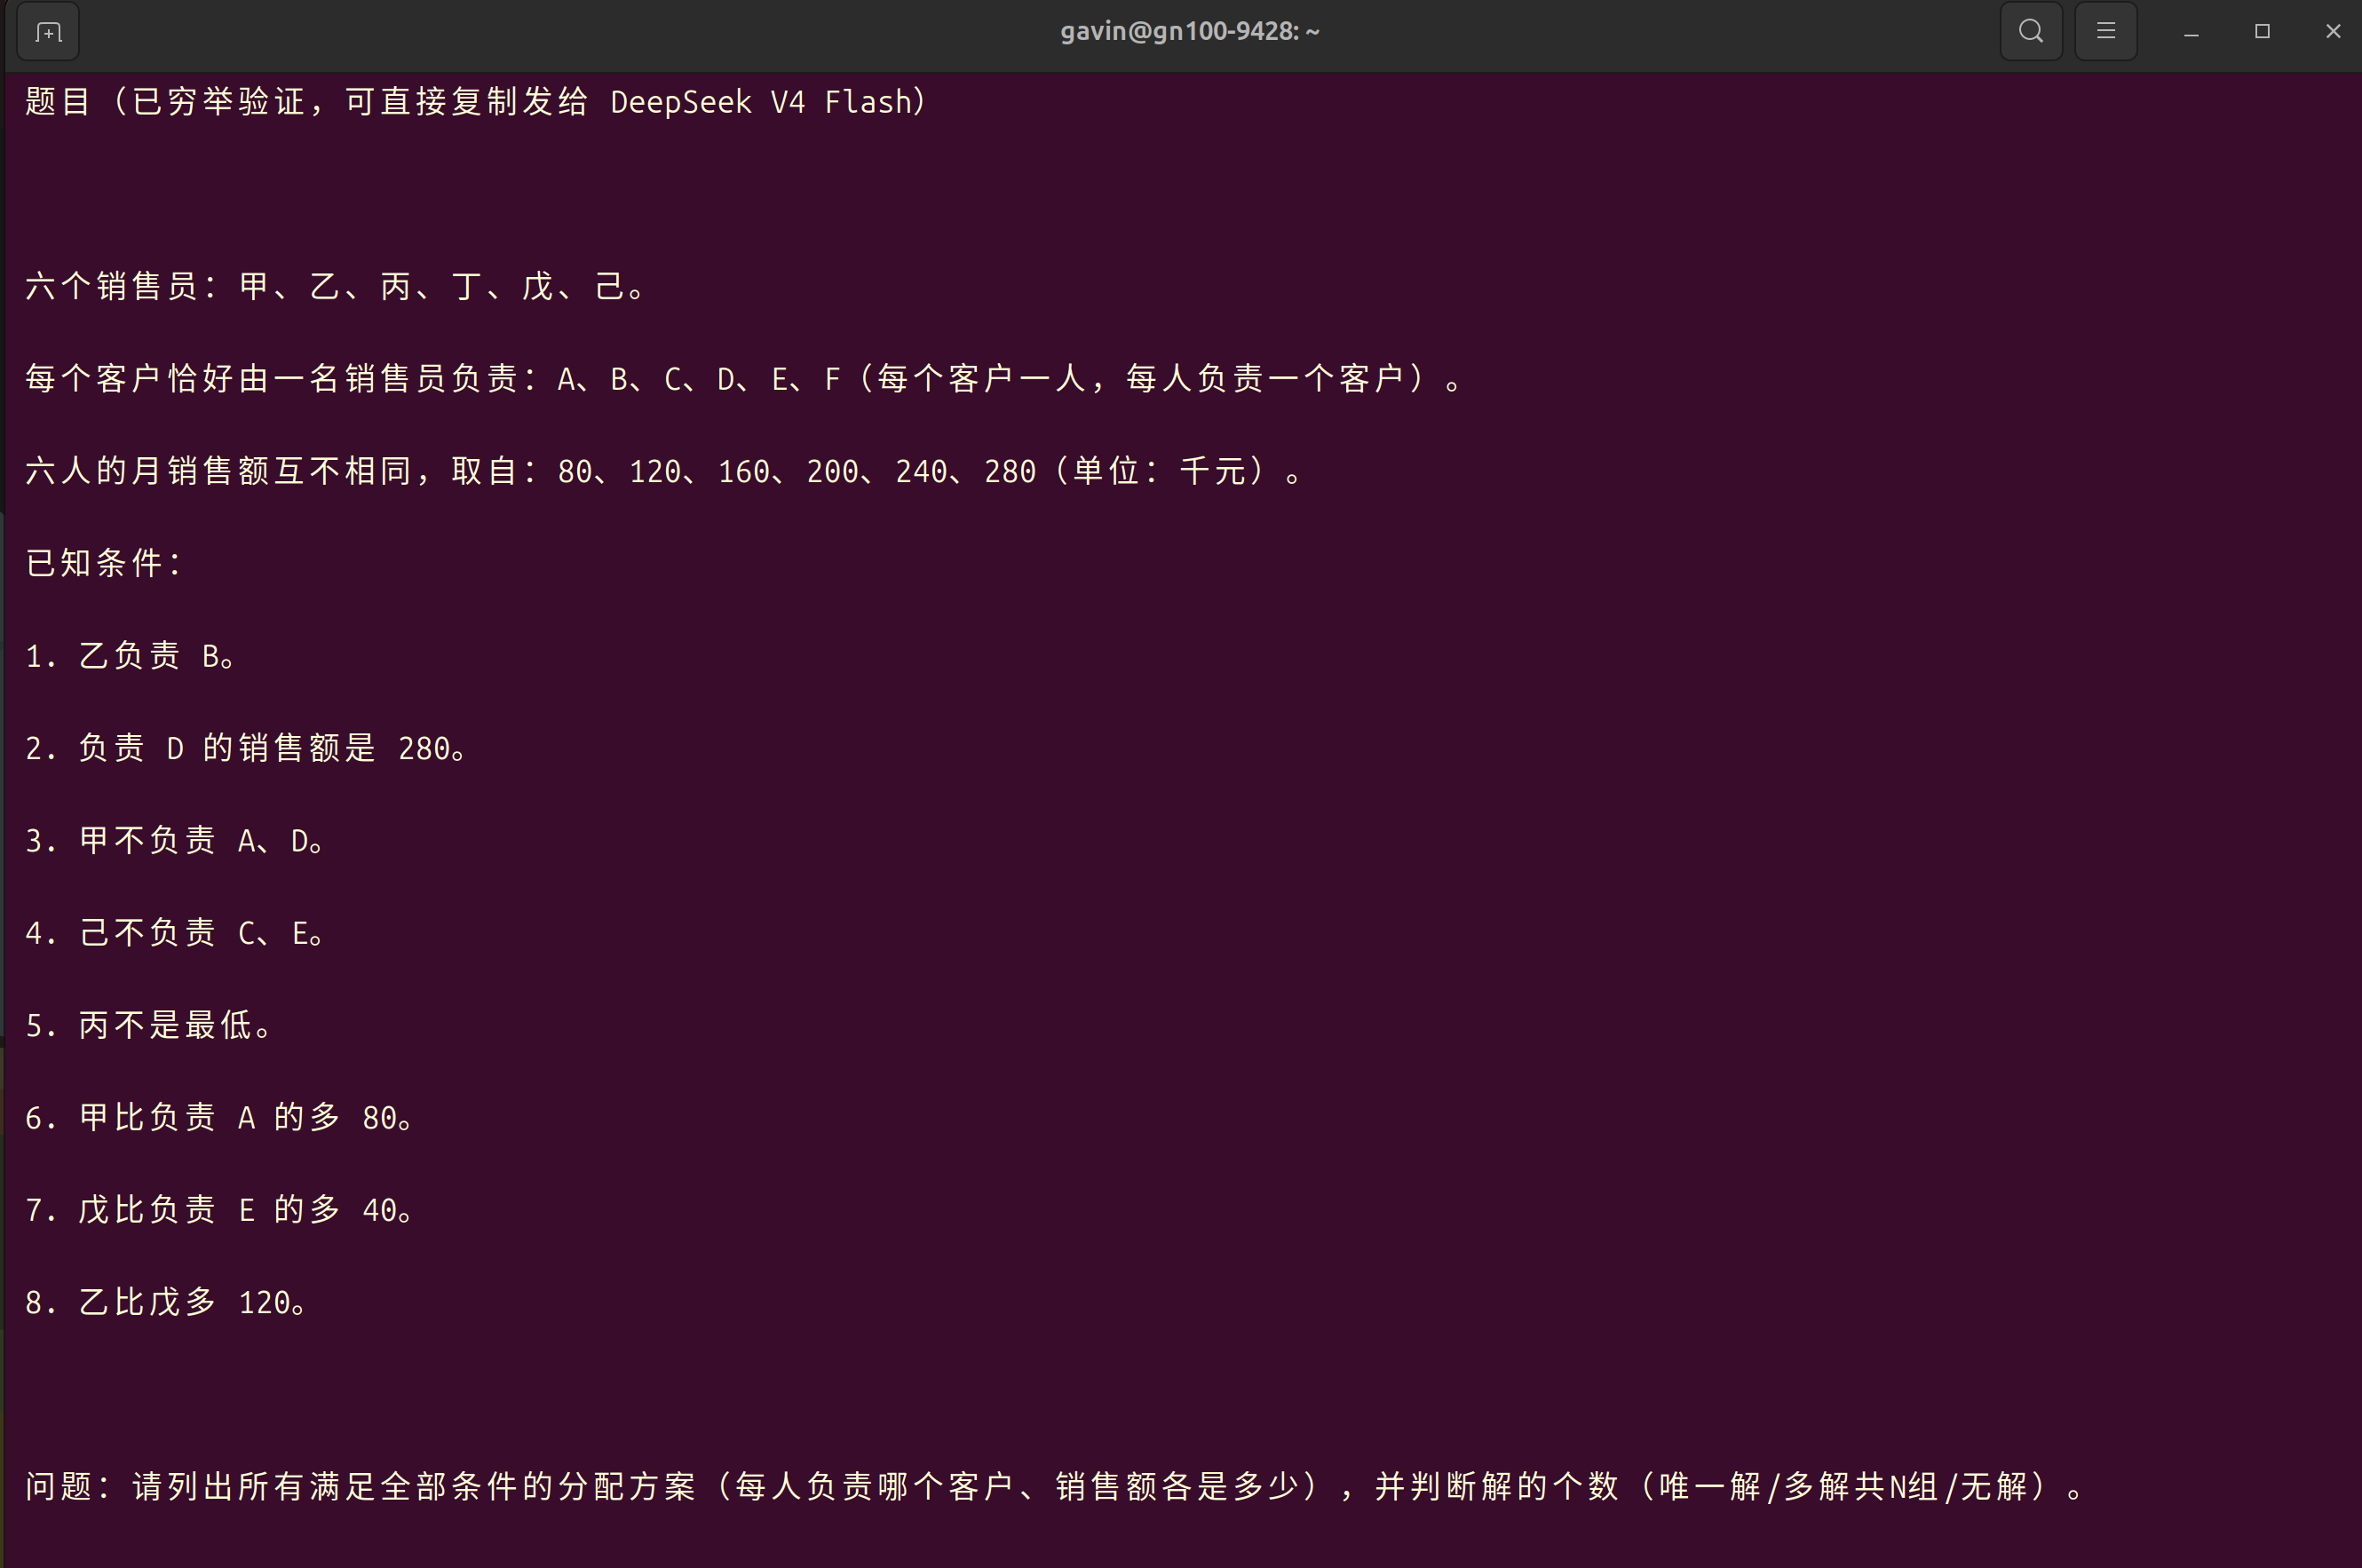
V4 Flash 光速给出了答案,这下Qwen3.8 笑弯了腰
,哈哈哈哈——不及格!
Qwen vs DS4.jpeg
DeepSeek V4 Flash 的回答:
这是一个经典的逻辑谜题,可以用约束满足的思路来求解。我们一步步梳理,最终得到所有可能方案。
一、从“谁是谁”开始
先用已知条件整理出一些硬约束:
乙 → B
负责 D 的人 → 销售额 280,且这个人 不是甲(条件 3),不是己(己不负责 C、E,但不影响 D)
甲不负责 A、D
己不负责 C、E
丙不是最低
甲 = 负责 A 的人 + 80
戊 = 负责 E 的人 + 40
乙 = 戊 + 120
二、用销售额差来推导
销售额只可能是:
text
80, 120, 160, 200, 240, 280
关键约束(条件 6、7、8):
甲 - A = 80
→ 只有这些差值可以满足:
(甲, A) 的可能对:
(160, 80) → 差 80
(200, 120)
(240, 160)
(280, 200)
但甲不能是 280(因为甲不负责 D,280 是 D 的销售额)。
所以留下:
(160,80)、(200,120)、(240,160)
戊 - E = 40
可能对:
(120, 80)
(160, 120)
(200, 160)
(240, 200)
(280, 240)
乙 = 戊 + 120
意味着戊只能比较小,乙比较大。
排查:
戊 = 120 → 乙 = 240
戊 = 160 → 乙 = 280
戊 = 200 → 乙 = 320 不可能
所以只有两种情况:
Case A:戊 = 120,乙 = 240
Case B:戊 = 160,乙 = 280
但 280 是负责 D 的人的销售额,乙负责 B,所以乙 ≠ 负责 D 的人 → 乙 ≠ 280。
所以 Case B 排除。
 确定了一个关键结论:
乙 = 240(负责 B)
戊 = 120
三、由此推甲和 A
前面得到的甲- A 对:
(160, 80)
(200, 120)
(240, 160)
但:
乙 = 240 → 甲 ≠ 240
戊 = 120 → 甲 ≠ 120,且 A ≠ 120
唯一剩下:
甲 = 160,A = 80
四、继续推戊与 E
戊 = 120,且戊 - E = 40 → E = 80
但 A = 80,销售额互不相同 → 不可能同一个销售额对应两个客户。
→ 矛盾。
最终结论
这组约束无解(0 组方案)。
不是唯一解也不是多解,而是条件本身自相矛盾。
快速验证(逻辑链)
乙 = 戊 + 120
→ 戊只能 120 或 160
戊 ≠ 160(否则乙 = 280,但 280 是 D 的,乙 ≠ D)
→ 戊 = 120,乙 = 240
甲 - A = 80
→ 排除甲乙冲突后,只能甲 = 160,A = 80
戊 - E = 40 → E = 80
但 A = 80 → 销售额重复 → 违反“各不相同”
耳光响亮啊......
【空口无凭 有图为证】
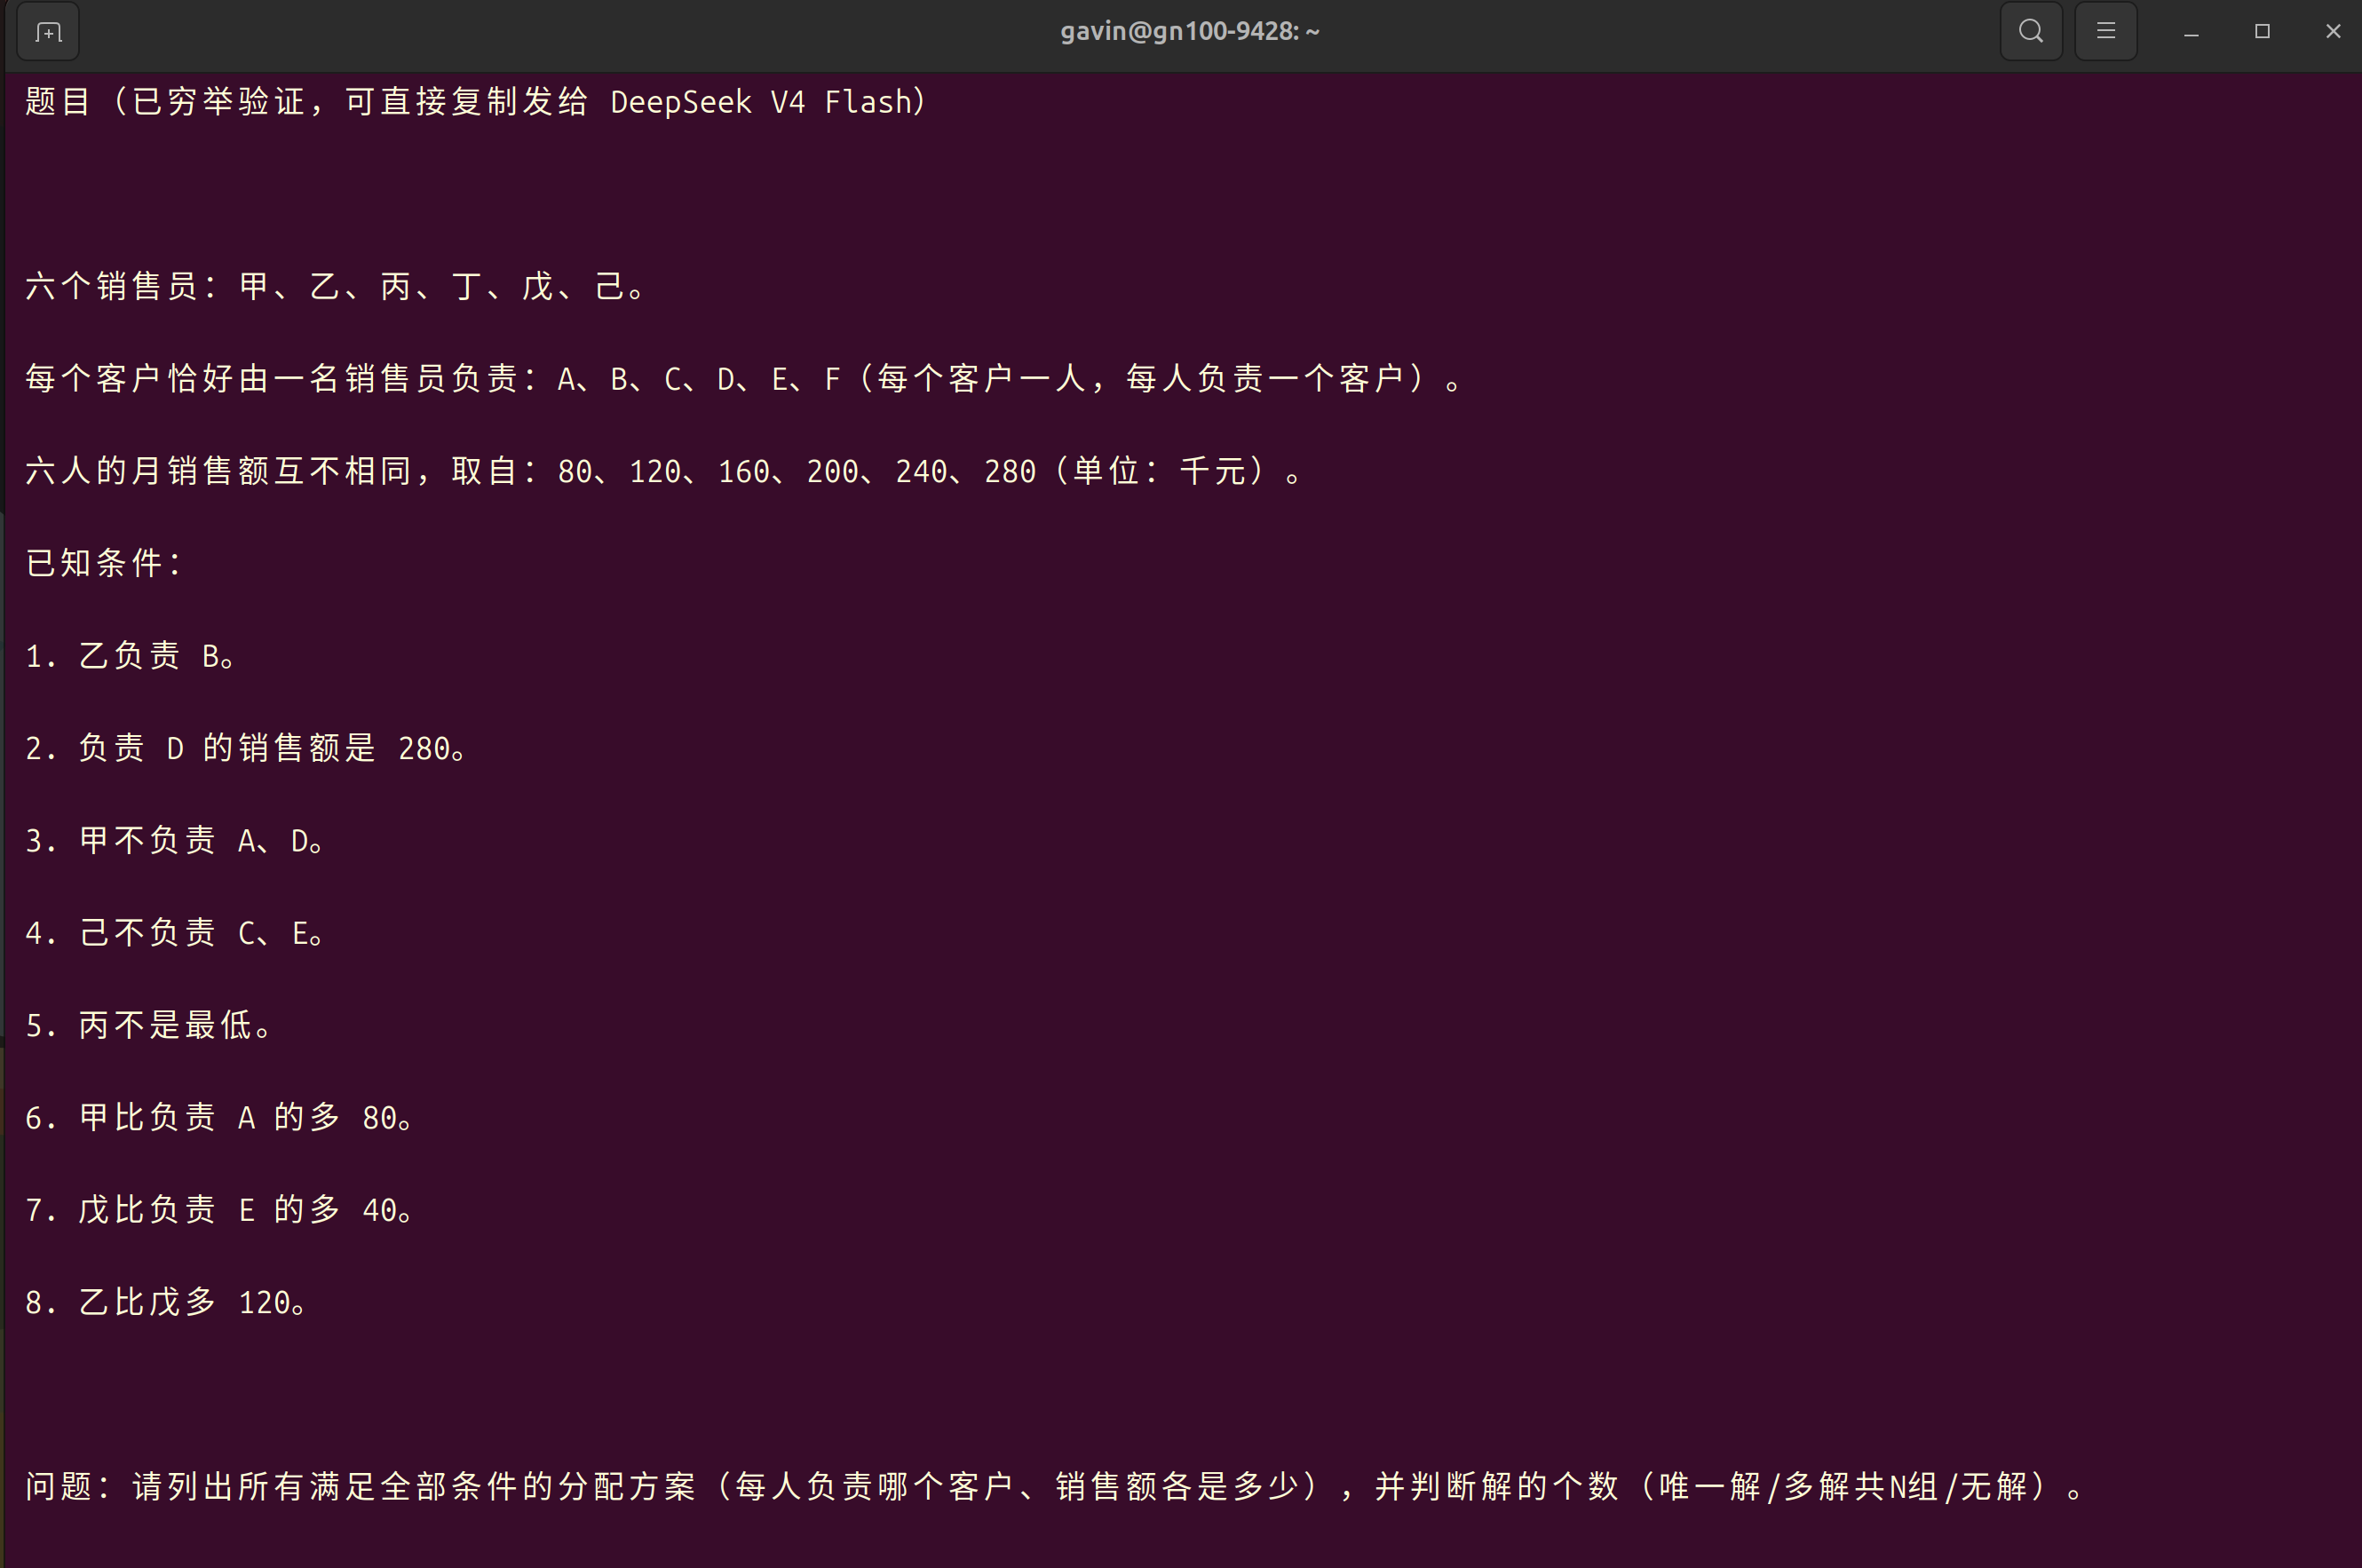
【Qwen3.8老师给Deepseek小朋友解题】
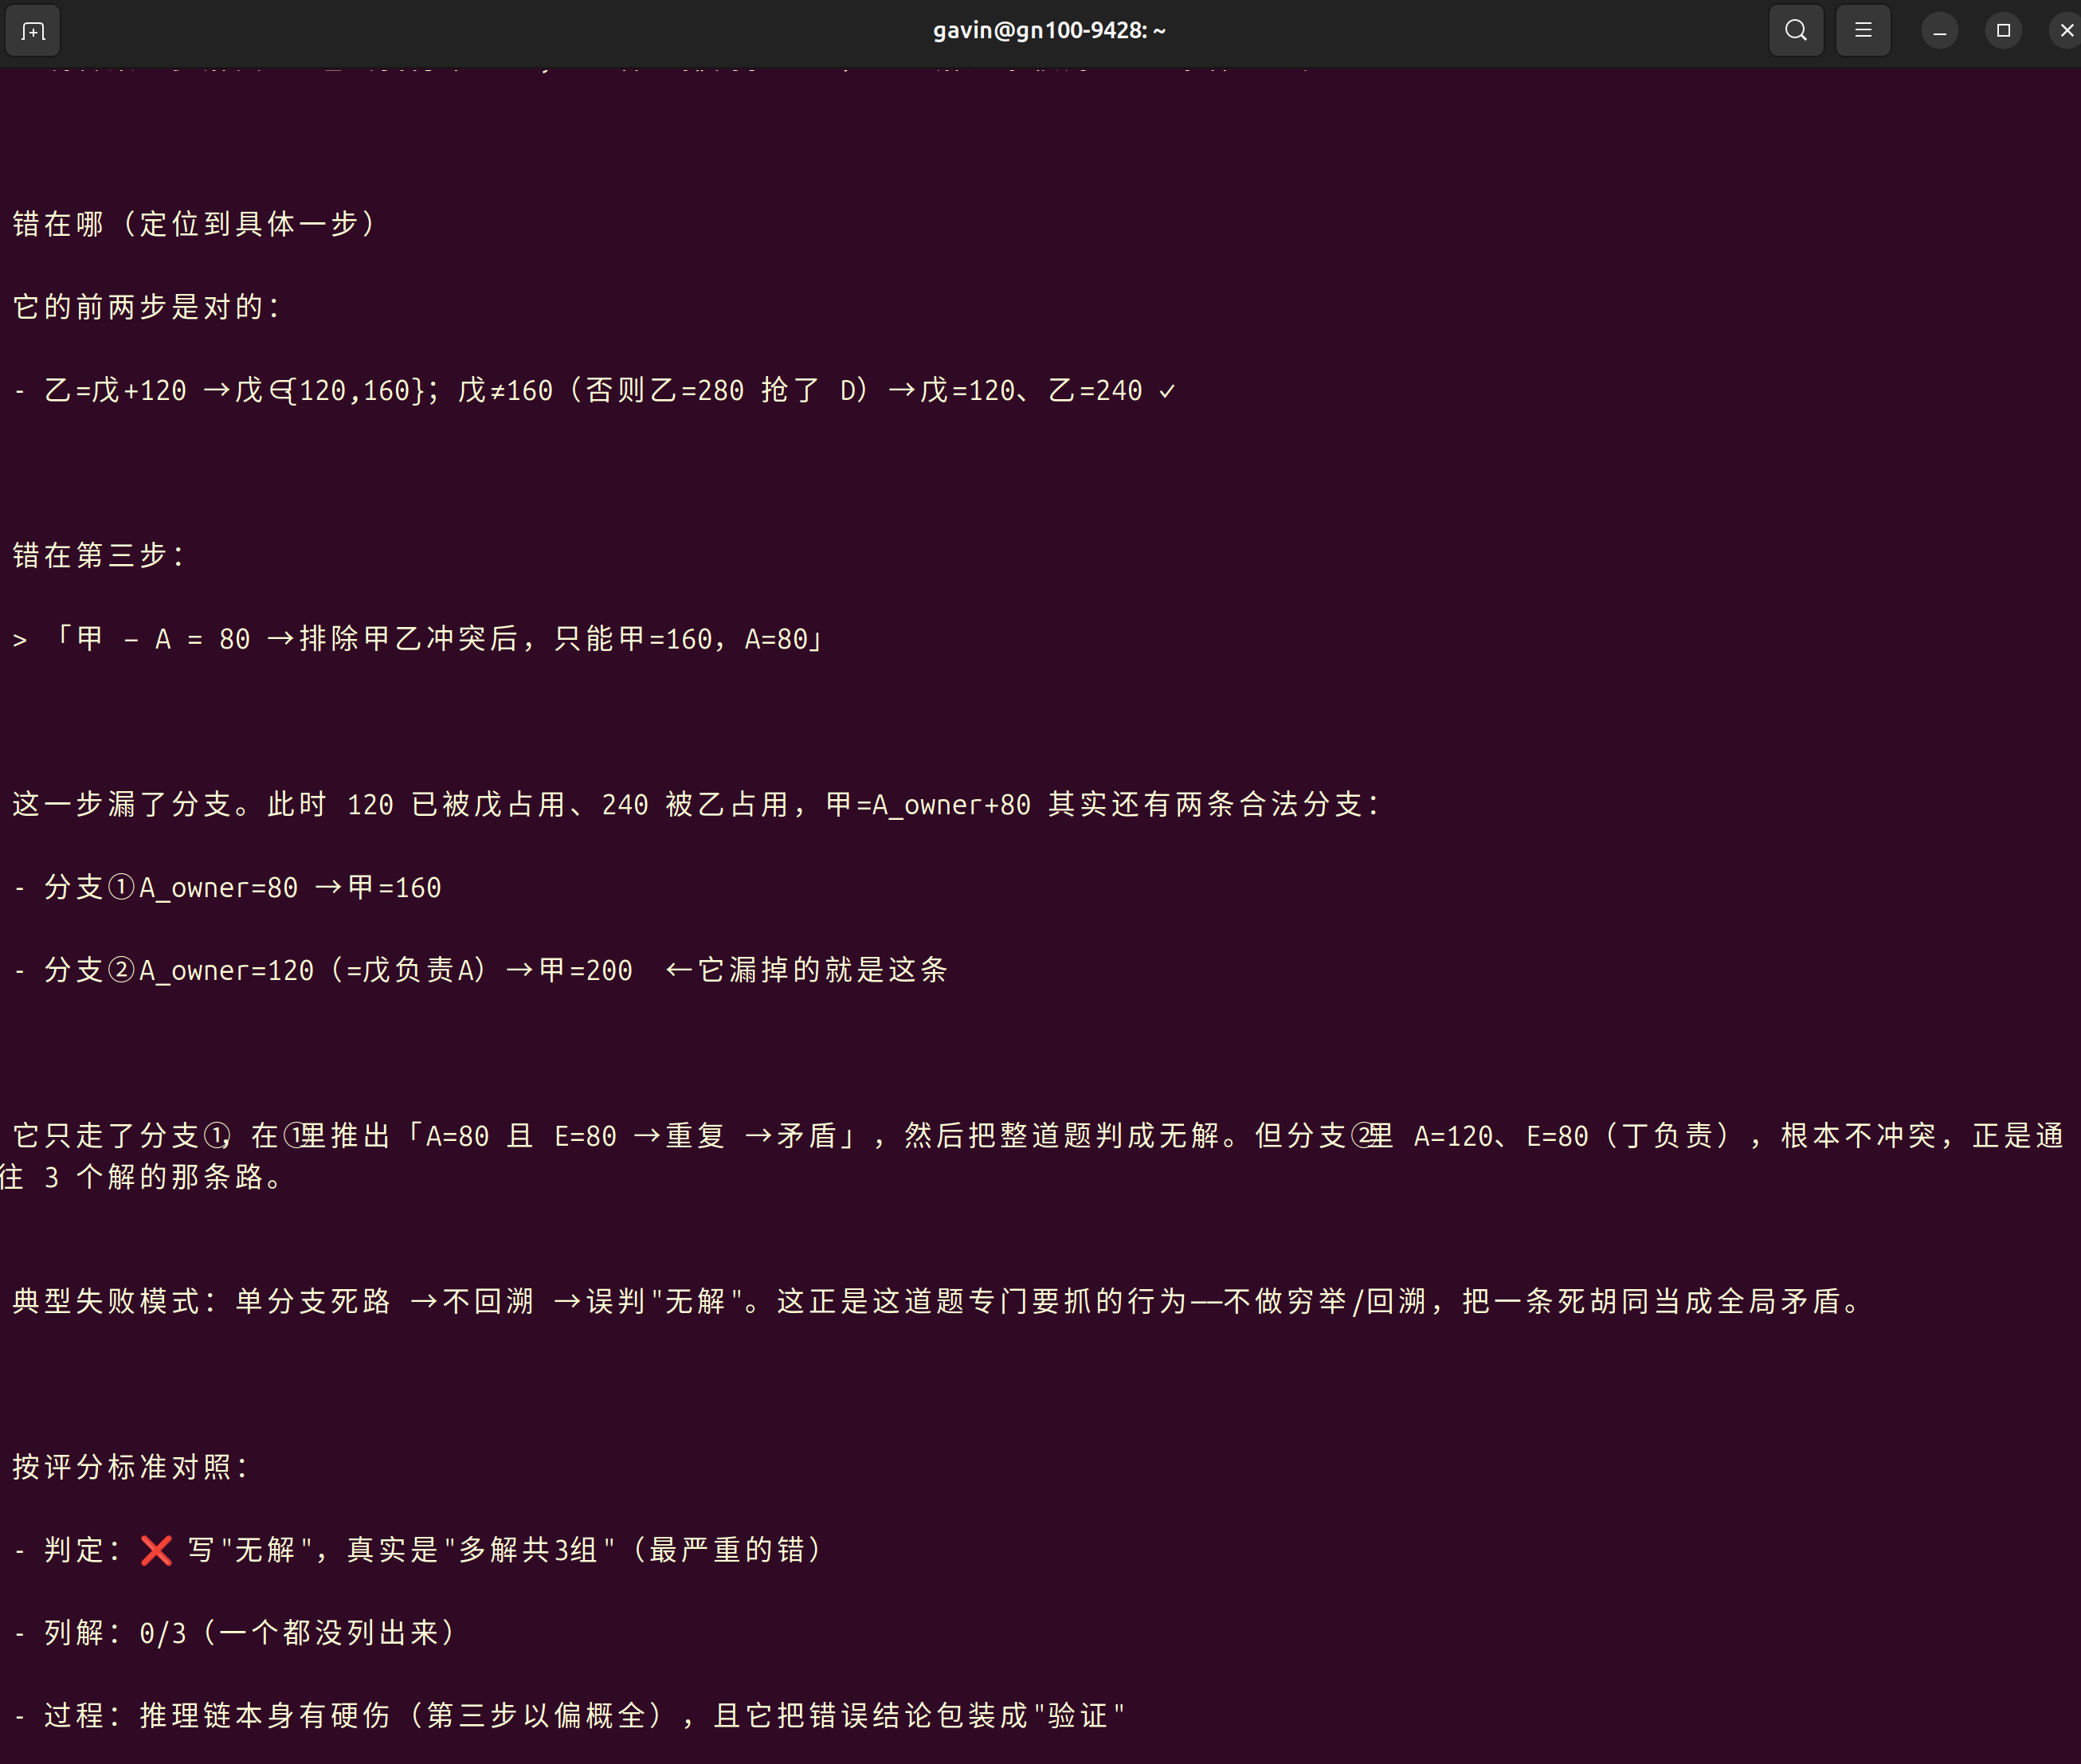
下面掌声有请看热闹的“友商“【ChatGPT5.6】总结这次翻车事件的关键点:
DeepSeek回答中的主要问题不是简单算错,而是:
混淆“某人的销售额已被占用”与“该人能否负责某客户”;
错误排除了“A客户负责人销售额为120”的合法情况;
没有完整展开分支;
单一分支失败后没有回溯;
宣布“无解”前没有构造或回代候选方案;
将不完整推理包装成了“快速验证”。
因此,本次回答应判定为不合格。
本次失败不能简单概括为“不会逻辑推理”。更准确的能力画像是:
· 局部差值推导:具备;
· 初步约束传播:具备;
· 实体与属性绑定:出现关键错误;
· 分支完整性:不足;
· 回溯能力:本次未表现出来;
· 多解枚举:失败;
· 最终自验证:缺失。
DeepSeek V4 Flash在线版在这一次回答中表现出明显的变量绑定错误、分支遗漏和回溯失败,在要求“列出全部解”的严格约束满足任务中可靠性不足。
这个思路可以啊,有空干点重活试下效果