跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. 双3090,哪个qwen 3.8 模型才是最好的呢?

双3090,哪个qwen 3.8 模型才是最好的呢?

已定时 已固定 已锁定 已移动 随便聊聊
rtx3090qwen-27b多卡部署
16 帖子 5 发布者 706 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • stxpnetS stxpnet

    c9d0313c-2674-4c79-aec3-d9609be4f547-image.jpeg

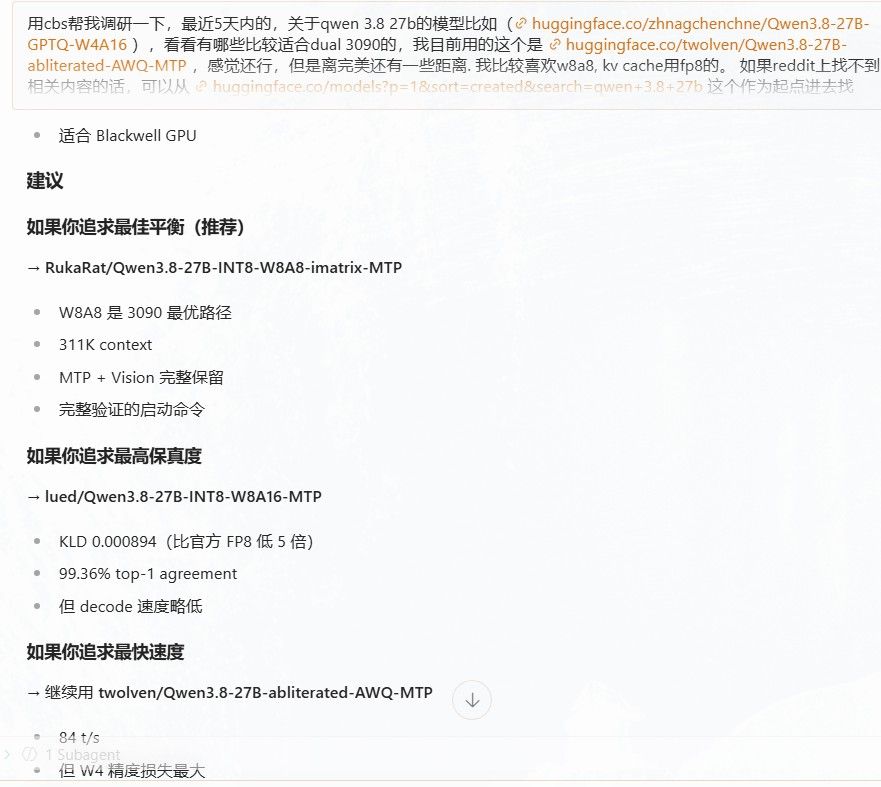
    我目前的情况是,配置了hindsight ,某些会话完成后,hindsight会疯狂调用 llm来进行记忆整理,目前使用的这个 twolven/Qwen3.8-27B-abliterated-AWQ-MTP 在超过131K上下文,或者并发较高的时候,由于 多并发没法控制,速度非常缓慢.而且作者的bench 也说明了,超过131K 上下文,prefill 会超过100秒。 这可能也是缓慢的根源之一。
    08162ded-316a-470a-94f9-dde8cbfb7636-image.jpeg

    kos orK
    kos orK
    kos or
    至尊皇帝
    发表于 最后由 kos or 编辑
    #7

    @stxpnet said:

    我目前的情况是,配置了hindsight ,某些会话完成后,hindsight会疯狂调用 llm来进行记忆整理

    我之前使用Highsight, 結果Docker上的記憶資料庫被Qwen3.6-27B無預警不小心刪除 就放棄使用

    hermes + hindsight記憶使用效果好嗎?

    1 条回复 最后回复
    0
    • stxpnetS
      stxpnetS
      stxpnet
      王侯将相
      发表于 最后由 编辑
      #8

      刚刚跑起来,才不到10天的记忆,还看不出来:
      偶尔进行一些任务的时候,HERMES会自动去调用 一些hs里面的记忆作为参考。

      其实会话完成后,手动通知HERMES进行一下存储,占用一点算力也还能接受。反正空着也是空着,目前把并发数降低了,似乎没有之前那么卡了。

      双卡3090 PCIE 4.0 16X/16X

      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
      1 条回复 最后回复
      1
      • N neo

        @stxpnet 我也用的hindsight作为长期记忆,不过我不用主模型来运行记忆整理,而是用专门的EDGE模型来处理,因为这个必须用短小精悍的模型,建议用9B或14B。另外重排和向量模型也可以自定义模型而不是hindsight内置的,模型也很小,不用多少显存,效率也高,因为内置模型用的是CPU。

        kos orK
        kos orK
        kos or
        至尊皇帝
        发表于 最后由 kos or 编辑
        #9

        @neo said:

        不过我不用主模型来运行记忆整理,而是用专门的EDGE模型来处理,因为这个必须用短小精悍的模型,建议用9B或14B。另外重排和向量模型也可以自定义模型而不是hindsight内置的

        用一個小型的MoE模型 Q4_K_M來整理記憶不知道合適不?
        只要語意理解能力夠高 應該不錯
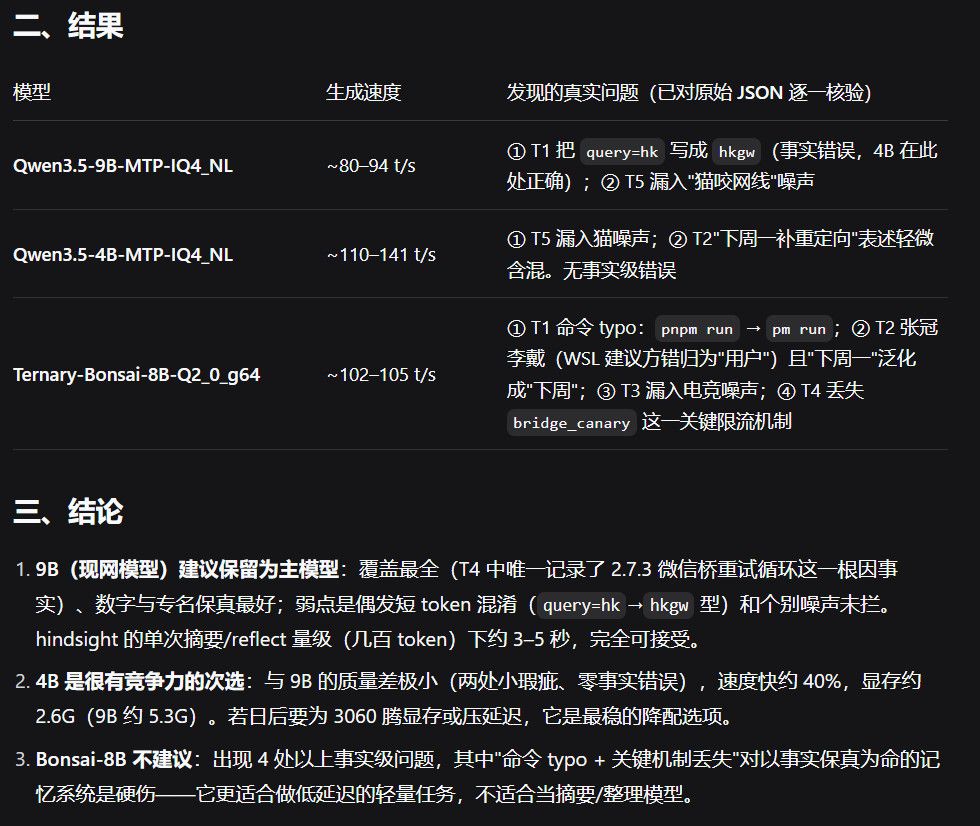
        突然想到TernaryBonsai-8B Q2

        prism-ml/Ternary-Bonsai-8B-gguf
        https://huggingface.co/prism-ml/Ternary-Bonsai-8B-gguf

        N 1 条回复 最后回复
        0
        • kos orK
          kos orK
          kos or
          至尊皇帝
          发表于 最后由 编辑
          #10

          當時使用Highsight 跑Qwen3.6-27B Dense 模型 好像每跑幾輪對話就會一直壓縮
          顯卡就一直跑壓縮整理記憶,
          假如有多的顯卡或免費API, 可以改其他API端點來進行記憶體整理 不要共用主模型就好 減少顯卡的運作壓力

          N 1 条回复 最后回复
          0
          • kos orK kos or

            @neo said:

            不过我不用主模型来运行记忆整理,而是用专门的EDGE模型来处理,因为这个必须用短小精悍的模型,建议用9B或14B。另外重排和向量模型也可以自定义模型而不是hindsight内置的

            用一個小型的MoE模型 Q4_K_M來整理記憶不知道合適不?
            只要語意理解能力夠高 應該不錯
            突然想到TernaryBonsai-8B Q2

            prism-ml/Ternary-Bonsai-8B-gguf
            https://huggingface.co/prism-ml/Ternary-Bonsai-8B-gguf

            N
            N
            neo
            体面乡绅 硕果累累
            发表于 最后由 编辑
            #11

            @kos-or TernaryBonsai-8B Q2 是个值得尝试的模型,要是成功了就进一步减轻显存压力了,我用的Qwen3.5-9B-IQ4-NL-MTP差不多需要8GB显存,你这个应该可以减少一半!主要还是看其语义理解和总结的质量是否能接受了。

            1 条回复 最后回复
            1
            • kos orK kos or

              當時使用Highsight 跑Qwen3.6-27B Dense 模型 好像每跑幾輪對話就會一直壓縮
              顯卡就一直跑壓縮整理記憶,
              假如有多的顯卡或免費API, 可以改其他API端點來進行記憶體整理 不要共用主模型就好 減少顯卡的運作壓力

              N
              N
              neo
              体面乡绅 硕果累累
              发表于 最后由 编辑
              #12

              @kos-or 会一直压缩的情况主要是hermes的原因,其他agent不会,因为hermes有个background_review的背景程序,默认每个N轮会进行对话整理,而且硬编码为主模型运行。

              1 条回复 最后回复
              2
              • stxpnetS
                stxpnetS
                stxpnet
                王侯将相
                发表于 最后由 编辑
                #13

                目前配好了new api分流,压制hind sight优先级,已经不会再和主要工作流争抢显卡了

                双卡3090 PCIE 4.0 16X/16X

                白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                1 条回复 最后回复
                1
                • N
                  N
                  neo
                  体面乡绅 硕果累累
                  发表于 最后由 编辑
                  #14

                  6fb78389-5ea7-4aec-ac4f-2415cf7d161a-image.jpeg

                  1 条回复 最后回复
                  0
                  • 2024fatwolf552
                    2024fatwolf552
                    2024fatwolf55
                    已封禁
                    发表于 最后由 编辑
                    #15

                    我也是双3090。对记忆系统,我的选择是:云端的一律不考虑,免费的API也可能在你某一天积累了大量记忆后收你的钱,你就不得不乖乖掏钱。去掉云端后,主要就是自托管的几个,包括mem0,Hind,hongcho。还考虑过reme(只使用MD文档),我还自己魔改过Mempalace,让Qwen3.6 Plus防facebook在10亿照片里找到类似照片的算法,写了一个搜索。最终是落在使用字节跳动开源的OpenViking上(我怀疑字节的豆包网页版之类,搞不好就是这个框架)。
                    OpenViking里面有多个LLM调用,官方推荐使用豆包模型。我用过豆包内置嵌入模型,后来发现这东西居然大量消耗我的豆包模型额度,直接改自托管了。
                    本来是丐版Mac上自托管,以本机LMStudio默认拉起BGE模型作为服务端,提供这个嵌入模型为OpenViking提供LLM服务。后来想起来局域网有一台12G的小主机,装了飞牛NAS,属于Debian系统。就让PI Agent把本机的OpenViking直接迁移到飞牛NAS上,PI迁移过去还比较平滑。
                    使用OpenViking我没遇到你这种集中”总结“的时刻,问Agent一些问题,它发现需要召回记忆的时候,会主动去OpenViking里翻。貌似效果还行。
                    OpenViking:https://github.com/volcengine/OpenViking

                    1 条回复 最后回复
                    1
                    • 2024fatwolf552
                      2024fatwolf552
                      2024fatwolf55
                      已封禁
                      发表于 最后由 编辑
                      #16

                      补充:使用本地小模型压缩整理记录是可以的,其实也可以考虑使用Agnes免费API,作为兜底措施。

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组