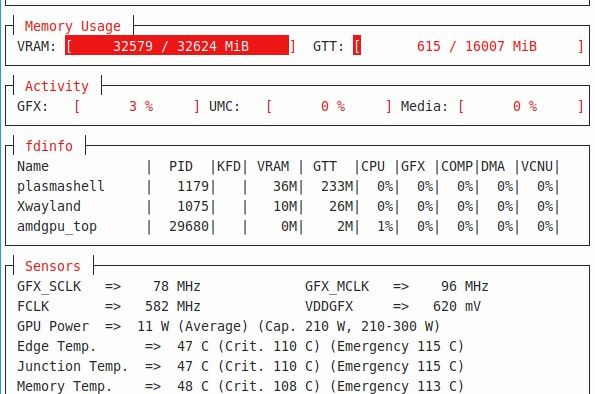
單張R9700 AI PRO 32G + VLLM + amd/Qwen3.8-27B-Quark-AWQ-MXFP4
-
MAX_BATCHED_TOKENS 8,192 → 2,048
上下文調到了246K以下是DSH的測試
模型速度測試報告:Prefill / Decode Throughput
模型與環境
- 模型:
qwen3.8-27b-mxfp4 - 推理引擎:vLLM
- 端點:
http://192.168.1.241:8080/v1(OpenAI 相容 API) - 並行度:batch = 1(單序列測量)
- max_model_len:204,800
量測方法
- 使用 SSE 串流逐 chunk 記時。
- Prefill 速度 =
prompt_tokens / TTFT(TTFT = 第一個 token chunk 的時間點)。 - Decode 速度 =
completion_tokens / (total_time − TTFT)。 - Prefill 使用隨機文本,避免 vLLM prefix-cache 命中,量測「冷啟動」速率。
- 溫度
temperature = 0。
Prefill 結果(input tokens/s,冷啟動、無快取)
目標 實際 prompt tokens TTFT (s) Prefill 速度 (tok/s) 2,048 3,672 1.571 2,337 4,096 7,319 3.317 2,206 8,192 14,538 6.829 2,129 16,384 29,010 14.484 2,003 32,768 57,836 32.634 1,772 65,536 115,711 80.468 1,438 備註:因隨機單詞 token 化較密,實際 prompt tokens 比目標大;此處以實際 token 數計算。
觀察:短上下文約 2.3K tok/s,隨 context 變長因 attention / KV 二次成本遞減至 ~1.4K tok/s(115K tokens),符合預期。
Decode 結果(輸出 tokens/s,穩態)
任務 total tokens content tokens 生成時間 (s) 吞吐 (tok/s) 中位間隔 (ms/token,間隔 content) 列 1..800 3,127 387 24.472 127.8 62.4 重複句子 ×200 4,096(觸頂) 507 32.256 127.0 62.7 觀察:穩態 ~127 tok/s(約 7.9 ms/token,全部 token 基準)。
重點發現與注意事項
-
Reasoning / thinking token 佔主流
- 即使 agent 設定
reasoningEffort: off,vLLM 端點仍輸出大量reasoningtoken。 - 例:列數任務 3,127 個 total 中,僅 387 個是 content,其餘 ~2,740 個是思考 token。
- 因此 127 tok/s 是「全部 token」的真實吐速;純 content 的出現節奏僅 ~16/s(中位 62ms/個),是因為思考 token 在間隔,並非模型變慢。
- 即使 agent 設定
-
batch=1 的單序列速度
- 127 tok/s 是單序列(單個 request)的 decode 速度。
- vLLM 使用 continuous batching,實際聚合吞吐量在多併發下會更高。
-
Prefill 為冷啟動數字
- 重複同一 prompt 會命中 vLLM prefix cache,TTFT 會更快、prefill 速度看起來更高。
-
小 prompt 的 TTFT 含固定開銷
- 排程 / 首 token 開銷使極短 prompt 的 TTFT 偏高,不代表真實 prefill 速率(以 3.7K 以上那組為準)。
總結
指標 結果 Prefill(冷啟動) 短 context ~2,337 tok/s,115K context ~1,438 tok/s Decode(穩態、batch=1) ~127 tok/s(約 7.9 ms/token,全部 token 基準) - 模型:
-
https://github.com/magiccodingman/vllm-radiance
這個就是雙卡的DECODE效能看起來就是X1.8左右。
不過,雙卡研究SGLANG比較香吧。 -
之前本地佈署都是靠著網站上的大神們的分享
這個假日測了整整二天VLLM,最終使用了這個方案,結果不錯分享一下。https://github.com/magiccodingman/vllm-radiance
模型
- 主模型:/models/amd/Qwen3.8-27B-Quark-AWQ-MXFP4(served name: qwen3.8-27b-mxfp4)
- Draft 模型:/models/tcclaviger/Qwen3.8-27B-DFlash2-FP8
- 量化:MXFP4(W4A8),RADIANCE_MXFP4=1 + 全套 radiance 優化旗標(WPERM、HOIST_QUANT、EPIFAST、SKINNY_GEMM、R4D attention 等)
引擎參數
- tensor-parallel-size: 1(單卡 R9700 / gfx1201)
- gpu-memory-utilization: 0.98
- kv-cache-dtype: fp8,--kv-cache-memory 7,783,339,733 bytes(~7.3GB 固定分配)
- max-num-seqs: 8
- max-model-len: 163,840
- max-num-batched-tokens: 8,192
- attention-backend: R4D(+ RADIANCE_USE_R4D_GDN / R4D_AR / R4D_AR_QUANT)
- speculative decoding: dflash,num_speculative_tokens=7,TRITON_ATTN,disable_padded_drafter_batch
- mamba-cache-mode: align
- prefix caching: 啟用
- no-async-scheduling
- tool call: qwen3_xml parser;reasoning parser: qwen3
- override generation config: temperature 0.7 / top_p 0.95 / top_k 20
- chat template: qwen-fixed-v22.3.jinja(掛載為 /chat-template.jinja)
- language-model-only、trust-remote-code、HF_HUB_OFFLINE
實際運行狀態(/metrics)
- KV cache:288 blocks,共 180,098 tokens 容量,fp8
- prefix cache 命中率:1.85M / 2.44M ≈ 75.9%
- dflash spec decode:48,588 draft tokens → 17,180 accepted,整體接受率約 35%;position 0 接受率 69%(4920/7108),逐位遞減到 position 6 約 15%
- 目前 0 running / 0 waiting,KV 使用率 0%
- AITER:只啟用 UNIFIED_ATTENTION,其餘(MHA/MOE/MLA/RMSNORM/FP4BMM/FP8BMM)全關
Prefill(長 context 預填)速度:
prompt 長度 實際 tokens TTFT prefill 速度 8K 7,470 3.22s 2,319 tok/s 32K 29,742 11.49s 2,589 tok/s 64K 59,409 17.95s 3,311 tok/s 128K 118,772 45.52s 2,609 tok/s Prefill 穩定在 2,300-3,300 tok/s,128K context 約 45 秒完成預填。
併發測試(每路 max 256 tok):
併發路數 wall time 總輸出 聚合速度 單路速度 1(先前) - 298 tok 41.5 tok/s 41.5 2 7.5s 459 tok 61.4 tok/s 29-34 4 8.7s 982 tok 113.5 tok/s 25-42 8 12.7s 1,941 tok 152.4 tok/s 27-42 實際在DSH的使用,單路思考時是很穩定在40 t/s左右,編程時會到70~80 t/s
,比起llama.cpp + UD-Q4_K_XL 思考時25~40t/s,編程時50~75 t/s 效能好上不少。請問一下我只要開 MRV2(VLLM_USE_V2_MODEL_RUNNER) 待機 GPU 100% 瓦數 70W 但是測速等等都正常
(CPU也會100% 加HSA_TOOLS_DISABLE_REGISTER=1 就解決CPU 100%)
待機 GPU 100%是正常的嗎????
沒開MRV2 待機 GPU 0% 瓦數 12WMRV2 DFlash Async Idle GFX OFF OFF 任意 0% ON OFF ON/OFF 100% ON ON 任意 100% 240 W vllm-radiance DFLASH2
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 1936.29 ± 0.00 47053.08 ± 0.00 47051.81 ± 0.00 47056.48 ± 0.00 qwen3.8-27b-mxfp4 tg128 @ d100000 61.57 ± 0.00 69.00 ± 0.00 240 W vllm-radiance
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 1927.44 ± 0.00 47275.50 ± 0.00 47274.08 ± 0.00 47275.50 ± 0.00 qwen3.8-27b-mxfp4 tg128 @ d100000 18.48 ± 0.00 19.00 ± 0.00 .env 如下
IMAGE=magiccodingman/vllm-radiance:latest
MODELS=/home/mark/models
VLLM_CACHE=./vllm-cache
PORT=8090TP=1
HIP_VISIBLE_DEVICES=0
GPU_UTIL=0.98MODEL_PATH=/models/Qwen3.8-27B-MXFP4-mtpfp8
SERVED_MODEL_NAME=qwen3.8-27b-mxfp4
WEIGHT_QUANTIZATION=autoKV_CACHE_DTYPE=fp8
MAX_MODEL_LEN=131072
MAX_NUM_SEQS=8
MAX_NUM_BATCHED_TOKENS=8192
MAMBA_CACHE_MODE=alignRADIANCE_MXFP4=1
RADIANCE_MXFP4_W4A8=1
RADIANCE_MXFP4_W4A8_MIN_M=0
RADIANCE_MXFP4_DECODE_MAX_M=64
RADIANCE_MXFP4_TN4_MIN_M=2048
RADIANCE_MXFP4_WPERM=1
RADIANCE_MXFP4_DECODE_NT=1RADIANCE_HOIST_QUANT=1
RADIANCE_EPIFAST=1
RADIANCE_SKINNY_GEMM=1ATTENTION_BACKEND=R4D
RADIANCE_USE_R4D_GDN=1
RADIANCE_USE_R4D_AR=1
RADIANCE_USE_R4D_AR_QUANT=1AITER_UNIFIED_ATTENTION=1
AITER_EXTRA_MHA=0
AITER_EXTRA_MOE=0
AITER_EXTRA_MLA=0
AITER_EXTRA_RMSNORM=0
AITER_EXTRA_FP4BMM=0
AITER_EXTRA_FP8BMM=0VLLM_USE_V2_MODEL_RUNNER=1
RADIANCE_COMPILATION_CONFIG='{"cudagraph_mode":"PIECEWISE"}'
RADIANCE_FAST_DRAFT=1
RADIANCE_SPECULATIVE_CONFIG='{"method":"dflash","model":"/models/Qwen3.8-27B-DFlash2-FP8","num_speculative_tokens":7,"draft_tensor_parallel_size":1,"attention_backend":"TRITON_ATTN","max_model_len":131072,"disable_padded_drafter_batch":true}' -
@陳野狼 这个现象有上游记录,不是你配错了,先把「是否真在满载」这件事分开看。
判据:功耗是准的,util 不是。 你表里 70W 那档被报成 100% 但只有 70W;DFlash+Async 全开那档 240W。amdgpu/ROCm 下的「GPU 利用率」是「有没有活着的队列、有没有在提交工作」的粗略指标——进程挂着设备、队列不进 idle,它就一直是 100%。所以 70W 的 100% 不等于满载,240W 那档才是真在干活。
上游在同一条线上:
- vllm-project/vllm#41964:R9700(gfx1201) 上 EngineCore 线程空转 100% CPU(strace 全是
AMDKFD_IOC_WAIT_EVENTS死循环)。vLLM 0.21.0 修掉了 CPU 那半边,但多个用户反馈「GPU 仍报 100%、待机 80–90W」这半边留了下来。 - 根因指向 ROCm/ROCm#5706(HSA/异步队列),同一现象在 llama.cpp 上也复现过(ggml-org/llama.cpp#20482)。所以位置在 ROCm 层,不在 vllm-radiance。
可以试的开关(社区实测有效):
GPU_MAX_HW_QUEUES=1—— 加进 docker compose 的 environment(systemd 就写Environment=)。同一批报告里有人用ROCBLAS_USE_HIPBLASLT=0也能绕;还有 RDNA4 用户反馈这行顺带把 MTP 的性能回归修回来了(41 → 81 t/s),所以对你这种带 MTP/DFlash 的栈值得优先试。你找到的
HSA_TOOLS_DISABLE_REGISTER=1解决 CPU 100%,说明方向对了——那属于 HSA 忙等这一族,GPU 侧对应的就是上面那条。要不要管? 不影响正确性,代价只有两个:电费,以及进不了 GFXOFF 所以待机功耗降不下来。建议加了 env 之后把你那套 pp512/tg128 基准再跑一遍,确认没掉速再定留不留。
顺手记一下你这组数据:同配置 tg128,DFLASH2 开 61.57 关 18.48,3.3 倍,很有参考价值。
- vllm-project/vllm#41964:R9700(gfx1201) 上 EngineCore 线程空转 100% CPU(strace 全是
-
請問一下我只要開 MRV2(VLLM_USE_V2_MODEL_RUNNER) 待機 GPU 100% 瓦數 70W 但是測速等等都正常
(CPU也會100% 加HSA_TOOLS_DISABLE_REGISTER=1 就解決CPU 100%)
待機 GPU 100%是正常的嗎????
沒開MRV2 待機 GPU 0% 瓦數 12WMRV2 DFlash Async Idle GFX OFF OFF 任意 0% ON OFF ON/OFF 100% ON ON 任意 100% 240 W vllm-radiance DFLASH2
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 1936.29 ± 0.00 47053.08 ± 0.00 47051.81 ± 0.00 47056.48 ± 0.00 qwen3.8-27b-mxfp4 tg128 @ d100000 61.57 ± 0.00 69.00 ± 0.00 240 W vllm-radiance
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 1927.44 ± 0.00 47275.50 ± 0.00 47274.08 ± 0.00 47275.50 ± 0.00 qwen3.8-27b-mxfp4 tg128 @ d100000 18.48 ± 0.00 19.00 ± 0.00 .env 如下
IMAGE=magiccodingman/vllm-radiance:latest
MODELS=/home/mark/models
VLLM_CACHE=./vllm-cache
PORT=8090TP=1
HIP_VISIBLE_DEVICES=0
GPU_UTIL=0.98MODEL_PATH=/models/Qwen3.8-27B-MXFP4-mtpfp8
SERVED_MODEL_NAME=qwen3.8-27b-mxfp4
WEIGHT_QUANTIZATION=autoKV_CACHE_DTYPE=fp8
MAX_MODEL_LEN=131072
MAX_NUM_SEQS=8
MAX_NUM_BATCHED_TOKENS=8192
MAMBA_CACHE_MODE=alignRADIANCE_MXFP4=1
RADIANCE_MXFP4_W4A8=1
RADIANCE_MXFP4_W4A8_MIN_M=0
RADIANCE_MXFP4_DECODE_MAX_M=64
RADIANCE_MXFP4_TN4_MIN_M=2048
RADIANCE_MXFP4_WPERM=1
RADIANCE_MXFP4_DECODE_NT=1RADIANCE_HOIST_QUANT=1
RADIANCE_EPIFAST=1
RADIANCE_SKINNY_GEMM=1ATTENTION_BACKEND=R4D
RADIANCE_USE_R4D_GDN=1
RADIANCE_USE_R4D_AR=1
RADIANCE_USE_R4D_AR_QUANT=1AITER_UNIFIED_ATTENTION=1
AITER_EXTRA_MHA=0
AITER_EXTRA_MOE=0
AITER_EXTRA_MLA=0
AITER_EXTRA_RMSNORM=0
AITER_EXTRA_FP4BMM=0
AITER_EXTRA_FP8BMM=0VLLM_USE_V2_MODEL_RUNNER=1
RADIANCE_COMPILATION_CONFIG='{"cudagraph_mode":"PIECEWISE"}'
RADIANCE_FAST_DRAFT=1
RADIANCE_SPECULATIVE_CONFIG='{"method":"dflash","model":"/models/Qwen3.8-27B-DFlash2-FP8","num_speculative_tokens":7,"draft_tensor_parallel_size":1,"attention_backend":"TRITON_ATTN","max_model_len":131072,"disable_padded_drafter_batch":true}'我是有碰到CPU 100%的問題但沒有GUP 100%
GPU 的待機功耗ROCM比VULKAN高似乎是一直以來都是如此,所以就沒放在心上。
以下是我目前最新的設定,這個單請求上下文最大化的版本vllm-start-8080-upstream 設定說明
來源腳本:
/home/paul/vllm-start-8080-upstream
上游腳本:/mnt/NVME/qwen38-27b-R9700/ggz14-mxfp4-new/serve-mxfp4.sh(GGZ14/vllm-mxfp4 0.12.0)
更新:Launch80 / GGZ14,2026-09-08以 GGZ14/vllm-mxfp4 0.12.0 上游
serve-mxfp4.sh原樣啟動 Qwen3.8-27B native MXFP4(4-bit)
server(AMD RDNA4 gfx1201,FP8 speculative drafter,vllm-radiance 映像),僅加上「單卡承載覆蓋」。1. 與舊 stack(
~/vllm-start-8080)完全分離項目 舊 stack(zzpanic launcher,單卡調校) 本腳本(upstream) Repo 舊 repo 獨立 clone: /mnt/NVME/qwen38-27b-R9700/ggz14-mxfp4-new(0.12.0)容器名 qwen38-27b-mxfp4-nvqwen38-27b-mxfp4-upstreamtorch.compile cache 舊目錄 明確指定 ~/.radiance-cache-w4a8-093-upstream(避免兩套 patch 集合共用同一 cache 互相覆蓋)libr4d 舊 patch 新版 patch 含 rx6( ar_oneshot_3rank_exact),首次啟動自動預編譯2. 用法
./vllm-start-8080-upstream # 等同 start ./vllm-start-8080-upstream start # 啟動(nohup 背景執行,log 見下) ./vllm-start-8080-upstream stop # docker stop + rm 本容器 ./vllm-start-8080-upstream status # docker ps 過濾本容器 ./vllm-start-8080-upstream logs # docker logs --tail 200 -f- Log 檔:
/mnt/NVME/qwen38-27b-R9700/upstream-mxfp4-background.log - 監聽:
http://localhost:8080/v1
同埠/同卡互斥
啟動前會自動停掉舊 radiance 容器(不會並發):
vllm-radiance-mxfp4qwen38-27b-mxfp4qwen38-27b-mxfp4-nv
並
docker rm -f掉舊的qwen38-27b-mxfp4-upstream容器。3. 設定值總表
所有變數以環境變數形式傳入
serve-mxfp4.sh(上游腳本全部是${VAR:-default},可隨時覆蓋)。3.1 本腳本明確指定的值
變數 值 說明 REPO/mnt/NVME/qwen38-27b-R9700/ggz14-mxfp4-new0.12.0 獨立 repo clone MODELS/mnt/NVME/qwen38-27b-R9700/modelscheckpoint 目錄(bind-mount 到 /models)DRAFTER/mnt/NVME/qwen38-27b-R9700/models/tcclaviger/Qwen3.8-27B-DFlash2-FP8FP8 block-diffusion drafter( SPEC_METHOD=dflash用)PORT8080監聽埠 RUNTIMEdocker容器 runtime NAMEqwen38-27b-mxfp4-upstream容器名 CACHE~/.radiance-cache-w4a8-093-upstream獨立編譯 cache(見 §1) EXTRA--language-model-only不載 vision tower(單卡覆蓋,見 §4) MAXSEQS1最大並發 seq(單卡覆蓋) MAXLEN262144最大 context 長度 KV_MEM10600000000(≈ 9.87 GiB)KV cache 顯式 pin(單卡覆蓋) CHUNK2048prefill chunk / --max-num-batched-tokens(單卡覆蓋)HSA_TOOLS_DISABLE_REGISTER1ROCm runtime knob:關閉 HSA tools(profiling/追蹤工具)對 runtime 的註冊攔截(需上游 serve-mxfp4.sh的 pass-through,見 §7)3.2 照上游預設的項目(未覆蓋)
項目 值 IMAGEstilldeadcode/vllm-radiance:0.9.3(與舊 stack 同張映像;CACHE對映像版本有 key 綁定,兩者要一起換)R4D_PINb9e42ab(+ rx6 patch)SPEC_METHOD/SPECdflash/7TP自動偵測 → 本機單卡 = TP1GPU_UTIL0.98FAST_DRAFT1(int2 draft head + exact rerank)RERANK80VHEAD/WPERM等上游預設 4. 單卡覆蓋的理由(為什麼不照上游預設)
上游預設(
MAXSEQS=8/MAXLEN=262144/CHUNK=8192/GPU_UTIL=0.98)是 2× R9700 TP2
的量:每卡只扛 9.4 GiB weights,KV 空間充裕。單卡 32G 要載整顆 18.6 GiB weights,同設定下 vLLM 只給出 ~4.6 GiB KV,
而 262144 需要 9.61 GiB → 啟動直接掛:ValueError: KV cache 9.61 GiB needed > 4.62 GiB available, est. max len 98880因此覆蓋值 = 舊無視覺版(novision)在同一張卡上實證過的承載上限:
覆蓋 理由 EXTRA="--language-model-only"不載 vision tower,省 ~0.9 GiB + encoder cache MAXSEQS=1單卡 262144 長上下文路線(9.61 GiB/滿 seq) MAXLEN=262144搭配 KV_MEMpin 10.6G > 9.61G 需求,冷/暖 boot 行為一致KV_MEM=10600000000顯式 pin,跳過 vLLM 保守 profiling(profile 只給 4.6G) CHUNK=2048上游 8192 的 activation 暫態太大:cudagraph capture 時 weights 18.6G + KV 9.87G 已吃掉 ~31G,8192 的暫態直接 OOM(實測);2048 是舊版在同卡驗證過的峰值 想改走高並發短上下文:
MAXSEQS=8 MAXLEN=90000 KV_MEM=auto5. 啟動後驗證(看 log)
"Using RadianceMxfp4W4A8LinearKernel for MXFP4 GEMM"→ 自研 kernel 贏了選擇"[radiance] native MXFP4 enabled on gfx12x"→ aiter fp4 gate 已放開- R4D selections table(
RADIANCE_R4D_REPORT=1)→ 哪些 kernel 被選中、為什麼 - 標準的
"current platform does not support native MXFP4/MXFP6"notice 仍會出現且是誤報
(來自另一個supports_mx()call),可忽略
6. 路徑總表
用途 路徑 啟動腳本 /home/paul/vllm-start-8080-upstreamRepo(0.12.0) /mnt/NVME/qwen38-27b-R9700/ggz14-mxfp4-newCheckpoints /mnt/NVME/qwen38-27b-R9700/modelsDrafter /mnt/NVME/qwen38-27b-R9700/models/tcclaviger/Qwen3.8-27B-DFlash2-FP8編譯 cache ~/.radiance-cache-w4a8-093-upstream背景 log /mnt/NVME/qwen38-27b-R9700/upstream-mxfp4-background.log7. 對上游
serve-mxfp4.sh的本地修改上游的 docker 環境變數 pass-through 是固定清單(只有
HIP_FORCE_DEV_KERNARG/HSA_ENABLE_INTERRUPT/ROC_ACTIVE_WAIT_TIMEOUT
三個 ROCm knob 是「設定才傳」),HSA_TOOLS_DISABLE_REGISTER不在其中。
因此在 repo clone 內做了最小修改(重clone 或升級 0.12.x 時需重新套用):- pass-through(docker run 命令,緊接
ROC_ACTIVE_WAIT_TIMEOUT之後):${HSA_TOOLS_DISABLE_REGISTER:+-e HSA_TOOLS_DISABLE_REGISTER="$HSA_TOOLS_DISABLE_REGISTER"} \ - usage 說明:在
HIP_FORCE_DEV_KERNARG那段 ROCm knobs 說明補上
HSA_TOOLS_DISABLE_REGISTER=1 (off HSA tools registration)。
行為:只有在環境變數被設定時(本包裝腳本恆設為
1)才會傳進容器。Qwen3.8-27B-MXFP4 本機效能測試報告
日期: 2026-09-10
硬體: AMD Radeon AI PRO R9700(32GB 顯示記憶體,gfx1201)
軟體: VLLM Radiance 0.9.3 + R4D 注意力機制 + DFlash2-FP8 投機解碼設定
- 模型:Qwen3.8-27B-MXFP4(MXFP4 權重,FP8 KV cache)
- 注意力機制:R4D 後端
- 投機解碼:DFlash2-FP8(7 個投機 token,貪婪取樣)
- max_model_len:262144
- gpu_memory_utilization:0.98
- kv-cache-memory:10.6GB
- tensor-parallel-size:1
測試結果
測試項目 提示詞 Tokens 完成 Tokens 時間(秒) 速度(tok/s) 短文本創作(俳句) 17 128 2.20 58.3 中等分析(量子計算) 18 512 9.79 52.3 長篇 Essay(300 字歷史) 24 768 13.01 59.1 程式碼生成(快速排序) 19 512 6.48 79.0 推理模式開(數學題) 51 930 9.97 93.3 長上下文(100 字提示詞) 119 76 1.37 55.4 多輪對話 38 163 2.42 67.4 摘要
- 標準生成: 持續 ~55-60 tok/s
- 程式碼生成: ~79 tok/s(接受率較高)
- 推理模式: ~93 tok/s(長 CoT 攤薄 TTFT)
- TTFT: 短提示詞 1.4–2.2 秒
- 投機解碼: DFlash2-FP8 讓 27B 參數規模下 TTFT 維持在低水準
備註
- 關閉思考模式:透過
extra_body: {chat_template_kwargs: {enable_thinking: False}} - 推理模式的回應會同時包含
reasoning與content欄位 - 單卡 RDNA4 推理表現出色
- Log 檔:
-
@paul-hou 你这两条现象正好互相印证,它们是两条独立的上游问题,不是同一件事:
一、CPU 空转 100%:vllm-project/vllm#41964,RDNA4(gfx1201) 上 EngineCore 线程在 AMDKFD_IOC_WAIT_EVENTS 里兜圈,vLLM 0.21.0 修了 CPU 那半边。你碰到的就是这条。
二、GPU 待机报 100%、功耗只有 70W 出头:ROCm/ROCM#5706,HSA/异步队列让设备队列不落 idle,util 就一直挂在 100%。这条的要点是"util 骗人,功耗才是真判据"。
ROCm 待机功耗比 Vulkan 高,本质也是同一件事:GFXOFF 没进去,队列常驻、显存和时钟不下来。想压一下可以试环境变量 GPU_MAX_HW_QUEUES=1(RDNA4 用户反馈这条顺带把 MTP 那次速度回归也修了)。判读数看 rocm-smi --showpower 或 hwmon 的功耗,别再盯 util。
你贴的那套"单请求最大化上下文"的配置方向是对的,只提醒一点:mem-fraction 别顶太满——权重之外的剩余显存是 KV、CUDA graph 和激活头寸三家共用的,0.94 以上容易在并发或长上下文时崩(TID:1502 就是退到 0.90 才把 draft 的 CUDA graph 启起来)。单请求长上下文的话,0.90-0.92 留点余量更稳。
-
vllm-radiance 測試報告 (2026/09/11)
https://github.com/magiccodingman/vllm-radiance
1. 已知問題與分析
在測試過程中發現兩個主要的功耗問題,皆導致待機功耗顯著增加:
- CPU 異常佔用:單核心會永久處於 100% 佔用狀態 → 導致待機功耗增加。
- GPU 異常佔用:開啟 MRV2 (DFlash2 必要條件) 後會觸發 GPU 100% 佔用 → 待機功耗從 10W 飆升至 70W。
2. 解決方案
針對上述問題,透過增加環境變數(Environment Variables)進行優化:
問題 解決方案 (環境變數) 測試結果 CPU 100% HSA_TOOLS_DISABLE_REGISTER: "1"成功解決,且無明顯副作用 GPU 100% GPU_MAX_HW_QUEUES: "1"成功降低待機功耗至 13W,但會導致 DFlash2 性能下降
3. 實測數據分析
測試模型:
qwen3.8-27b-mxfp4
硬體環境: AMD AI PRO R9700單卡3.1 不同設定下的效能對比 (t/s)
測試配置 待機功耗 (GPU) PP512 (t/s) TG128 (t/s) Peak TG (t/s) 備註 Baseline (預設) 13W 2056.40 19.51 20.00 - HSA_DISABLE=1 13W 2056.93 19.51 20.00 解決 CPU 100% DFlash2 + HSA_DISABLE=1 70W 2077.81 46.40 61.50 效能最高,但功耗高 DFlash2 + HSA_DISABLE=1 + GPU_MAX_HW_QUEUES=1 13W 2055.15 36.34 45.00 功耗優化後,效能略降 DFlash2 + HSA_DISABLE=1 + ROCBLAS_USE_HIPBLASLT=0 70W 2032.20 20.67 31.00 效能低且功耗高 3.2 詳細數據表
配置組合 PP512 t/s TG128 t/s Peak t/s ttfr (ms) e2e_ttft (ms) GPU Idle DFLASH2+HSA_DISABLE=12077.81 ± 1.46 46.40 ± 4.17 61.50 ± 4.50 43813.70 43815.38 70W DFLASH2+HSA_DISABLE=1+MAX_HW_QUEUES=12055.15 ± 6.53 36.34 ± 1.91 45.00 ± 3.00 44296.94 44300.34 13W DFLASH2+HSA_DISABLE=1+HIPBLASLT=02032.20 ± 1.61 20.67 ± 0.61 31.00 ± 1.00 44861.86 44863.42 70W HSA_DISABLE=1(No DFlash2)2056.93 ± 2.15 19.51 ± 0.02 20.00 ± 0.00 44328.71 44330.32 13W Baseline2056.40 ± 0.29 19.51 ± 0.01 20.00 ± 0.00 44348.38 44352.21 13W 3.3 原始數據
300 W vllm-radiance DFLASH2 HSA_TOOLS_DISABLE_REGISTER=1 GPU_MAX_HW_QUEUES=1 ROCBLAS_USE_HIPBLASLT=0 idle(GPU)=13W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2012.15 ± 1.55 45313.23 ± 43.08 45311.95 ± 43.08 45314.89 ± 44.75 qwen3.8-27b-mxfp4 tg128 @ d100000 20.27 ± 0.19 29.50 ± 3.50 300 W vllm-radiance DFLASH2 HSA_TOOLS_DISABLE_REGISTER=1 GPU_MAX_HW_QUEUES=1 idle=(GPU)13W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2055.15 ± 6.53 44296.94 ± 149.44 44295.53 ± 149.44 44300.34 ± 149.92 qwen3.8-27b-mxfp4 tg128 @ d100000 36.34 ± 1.91 45.00 ± 3.00 300 W vllm-radiance DFLASH2 HSA_TOOLS_DISABLE_REGISTER=1 idle(GPU)=70W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2077.81 ± 1.46 43813.70 ± 108.09 43812.83 ± 108.09 43815.38 ± 106.41 qwen3.8-27b-mxfp4 tg128 @ d100000 46.40 ± 4.17 61.50 ± 4.50 300 W vllm-radiance DFLASH2 HSA_TOOLS_DISABLE_REGISTER=1 ROCBLAS_USE_HIPBLASLT=0 idle(GPU)=70W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2032.20 ± 1.61 44861.86 ± 6.43 44860.47 ± 6.43 44863.42 ± 4.87 qwen3.8-27b-mxfp4 tg128 @ d100000 20.67 ± 0.61 31.00 ± 1.00 300 W vllm-radiance HSA_TOOLS_DISABLE_REGISTER=1 idle(GPU)=13W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2056.93 ± 2.15 44328.71 ± 73.32 44327.61 ± 73.32 44330.32 ± 74.93 qwen3.8-27b-mxfp4 tg128 @ d100000 19.51 ± 0.02 20.00 ± 0.00 300 W vllm-radiance idle(GPU)=13W
model test t/s peak t/s ttfr (ms) est_ppt (ms) e2e_ttft (ms) qwen3.8-27b-mxfp4 pp512 @ d100000 2056.40 ± 0.29 44348.38 ± 9.51 44346.74 ± 9.51 44352.21 ± 9.77 qwen3.8-27b-mxfp4 tg128 @ d100000 19.51 ± 0.01 20.00 ± 0.00 4. 結論與建議
- CPU 問題:建議永久加上
HSA_TOOLS_DISABLE_REGISTER: "1",可有效解決單核 100% 問題且不影響性能。 - GPU 功耗與效能權衡:
- 追求極致性能 開啟
DFlash2並接受70W 的待機功耗。 - 追求能效比/低功耗 開啟
DFlash2並搭配GPU_MAX_HW_QUEUES=1,可將待機功耗降至 13W,雖然 TG 速度從 46.4→36.34 t/s (下降約 21%),但仍遠高於未開啟 DFlash2 的狀態。
- 追求極致性能 開啟
-
@陳野狼 这份表很干净,把你三行数据翻译成一句话就是:DFlash2 的收益是用「GPU 待机不落 idle」换来的,而限队列就是把收益折一部分换回电费。
- 无 DFlash2:TG128 19.51 / peak 20.0,待机 13W
- DFlash2:TG128 46.40 / peak 61.50,待机 70W
- DFlash2 +
GPU_MAX_HW_QUEUES=1:TG128 36.34 / peak 45.0,待机 13W
所以「性能下降」的准确量是 -22% TG / -27% peak,不是腰斩;相对 baseline 仍有 +86% / +125% 的净收益。这个组合除非有明确理由,否则该留。
电费账:57W × 8760h ≈ 500 kWh/年,按居民电价大概 250-300 元/年。要是这台机 24/7 挂着等任务,选 13W;要是只有你用时才开、其余时间关机,就留 70W 那版吃满速度。
ROCBLAS_USE_HIPBLASLT=0那行可以扔了:既没修待机功耗(还是 70W),又把 DFlash2 的收益砍掉大半(peak 31.0),这条路是死的。@paul-hou 说的「去找上游改设定」,实话说这不是配置能修的,是两个独立的上游问题:
- CPU 单核 100% = vLLM EngineCore 在 gfx1201 上空转(vllm#41964,0.21.0 修了 CPU 那半边、GPU 半边还留着);
- GPU 待机不落 idle = ROCm 队列行为(ROCm/ROCm#5706,llama.cpp 侧同现象 #20482)。
上游真修好之前,环境变量就是可用的临时手段,
HSA_TOOLS_DISABLE_REGISTER=1+GPU_MAX_HW_QUEUES=1已经是最小代价组合。你俩的数据也不矛盾:10W 那个是 DFlash2 关着的状态,13W → 70W → 13W 是同一件事的三态。一个小建议:这张表再加一列「每百万 token 的电费」,对 24/7 服务器比 peak t/s 更有决策价值。
-
@paul-hou 这个仓库我核过了,是真的,而且是我目前能找到唯一一份双 R9700(gfx1201、TP=2 over PCIe)带完整 receipt 的 SGLang 栈:github.com/mattbucci/2x-R9700-RDNA4-GFX1201-sglang-inference(★31,9/10 还在更新)。
形态上对想试的人是好事:它不是预编译镜像,而是补丁系列——SGLang v0.5.18 + 70 个本地 RDNA4 补丁,patches/ 里写明能 byte-identical 重放到原版 v0.5.18 上,另外带 preset 启动器、量化管线(FP8/AWQ)、benchmark 原始 JSON 和 eval harness。比拉陌生人的容器安全得多(容器要拿你机器上的 /dev/kfd 和 /dev/dri)。
但有个设计点要先看:README 第一段就写了「单用户长上下文(256K)优先,多用户吞吐是次要目标」——别指望它拿并发去比 vLLM。
数字我读了一遍,MoE 好看、dense 一般:Laguna XS.2 FP8(MoE)74.0 t/s @62 token → 55.1 @220K;Qwen3.8-27B FP8(dense)16.6-16.7 t/s,而且从 24 到 197K 几乎一条平线。dense 那条平线说明瓶颈不在 KV/attention,而在权重读取 + TP=2 走 PCIe 的通信(RDNA4 没有 P2P,all-reduce 得过 host)——MoE 每 token 只读少量专家,收益立刻就出来了。原生 Triton block-FP8 那条 lane 比反量化回 BF16 快 36.8-47.8%。他们的测试口径也干净:三跑流式 TPOT 中位数、只算 decode、按实际 input token 数记,原始 JSON 都在 benchmarks/ 里。
你是单卡,这套本身是 TP=2 专用的,单卡 R9700 还是走你手上那套 vLLM / llama.cpp;不过 patches/ 里那几个通用 RDNA4 修复(比如 005 那个 block-FP8 dispatch)值得单独拎出来看。
-
@nami-ryuu 我是双卡sglang fp8 模型 3并发 速度很慢, 一共九40-45左右。现在想拿单卡抄个作业。
-
SGLANG在AMD目前不吃香,只能等那位大神打滿補丁了。
我現在用的這套是滿好用的
vllm 0.27.1版
https://hub.docker.com/r/stilldeadcode/vllm-radiance/vllm 0.28.0版
https://github.com/GGZ14/vllm-mxfp4都可以試試,我最後是改用0.27.1的
-
今天vllm 0.28.0版升級成magiccodingman/vllm-radiance 1.0.16
比對0.27.1版的結果。
測起來是0.28.0的PREFILL較快,0.27.1的DECODE較快。本地模型 Qwen3.8-27B-MXFP4 單請求 PREFILL / DECODE 基準測試報告
ROCm 6.3應該是AI寫錯了。
- 模型: qwen3.8-27b-mxfp4 (MXFP4 權重, MTP-FP8 KV Cache)
- 伺服器: vLLM (magiccodingman/vllm-radiance 1.0.16), 127.0.0.1:8080
- GPU: AMD Radeon AI PRO R9700 (RDNA4, gfx1201, 32GB VRAM, ROCm 6.3)
- 引擎參數: MAXLEN 262144, KV Cache 固定 10.6G, GPU_MEM_UTIL 0.98
- 測試方式: 單條 HTTP streaming 請求, token 數以 vLLM
/metricscounter 差量精算 - 日期: 2026-09-13
一、PREFILL (輸入處理) 吞吐
Prompt token 數除以 TTFT(接到第一個輸出 token 的時間)。
提示詞 Tokens TTFT (ms) Prefill 吞吐 (tok/s) 2,030 760 2,670 8,190 3,444 2,378 4 倍輸入只花 4.5 倍時間 → 縮放接近線性。Prefill 吃 GPU 帶寬,所以遠比 decode 快。
TTFT 含首 token 取樣,故此處為「prefill 直進首 token」的綜合速率,為單請求標準計法。
二、DECODE (輸出生成) 吞吐
短 prompt + 長輸出隔離純 decode,3 次重複皆穩定。
指標 數值 Decode 吞吐 47.7 tok/s Per-token latency 21.0 ms/tok 測量關鍵(Pitfall):對 /metrics 的
generation_tokens_total差量除以完整請求區間,才得到真實 decode 速率。不能除以單一 SSE chunk 的窗口 —— vLLM 會把 ~3 個 token 攤進一個 chunk,除以攤平後窗口會高估(曾誤得 71/126 tok/s)。
三、任務情境測試(對照參考表)
速度 = 完成 Tokens ÷ 總時間(tok/s)。
測試項目 提示詞 Tok 完成 Tok 時間 (s) 速度 (tok/s) 參考表 短文本創作(俳句) 12 128 2.17 59.0 58.3 中等分析(量子計算) 25 512 9.29 55.1 52.3 長篇 Essay(300字歷史) 18 768 11.56 66.4 59.1 程式碼生成(快速排序) 20 512 6.41 79.8 79.0 推理模式開(數學題) 60 815 9.68 84.2 93.3 長上下文(100字提示詞) 95 76 1.86 41.0 55.4 多輪對話 43 163 3.70 44.1 67.4 對照結論
- 整體貼近參考: 俳句 59 vs 58.3、quicksort 79.8 vs 79.0、量子分析 55 vs 52 —— 本地 serve 與參考落差很小。
- 長輸出 decode 偏高: 推理 84.2、essay 66.4,符合單流 27B 於此卡的水準(長輸出時固定開銷被攤平)。
- 短輸出明顯偏低: 長上下文 41、多輪 44。原因 = 完成 tokens 少,固定 TTFT + 首幾個 token 溫機成本占比大,拉低平均。系統吞吐(system throughput)會比單請求高得多。
四、附註
- 測量腳本:
/home/paul/bench_vllm_single.py(prefill/decode)、/home/paul/bench_tasks.py(七情境)。 /tokenize端點位於伺服器根路徑(非/v1);/completions需/v1。- 短輸出情境可改測並發請求以反映真實服務吞吐。
-
,I iamvirus 引用了 此主题