Proxmox VE 9.2+ Intel 核显 SR-IOV + AMD Radeon AI PRO R9700 直通+Ubuntu24.04部署实测(四)
-
Proxmox VE 9.2+ Intel 核显 SR-IOV + AMD Radeon AI PRO R9700 直通+Ubuntu24.04部署实测(四)
一、本机验证过的调优
读取工作区实体机三份文档,核心调优配方如下,已对齐应用到本机:
参数 作用 实体机实测依据 --spec-type draft-mtp --spec-draft-n-max 2MTP 投机解码 26 → 42~48 t/s(≈1.6 倍) -ctk q8_0 -ctv q8_0KV 缓存量化 省约一半 KV 显存并提速 --reasoning-effort medium控制思考长度 治好默认 xhigh 的"雷霆大思考" --temp 0.3 --top-p 0.9低温采样 准确度↑ + MTP 接受率↑(94.2%) --load-mode none权重不经 mmap 模型 4 秒加载 -ngl all -np 1全层进显存 + 单槽位 单用户 KV 池全归当前会话 --override-kv qwen35.context_length=int:131072前端如实显示 128K 防客户端按 256K 发送超限 --alias qwen3.8API 模型别名 客户端用 qwen3.8调用
二、最终生效的启动命令
由 systemd 单元
/etc/systemd/system/qwen38.service执行(开机自启 + 崩溃自愈):/opt/llama.cpp/bin/llama-server \ -m /opt/llama.cpp/models/Qwen3.8-27B-Uncensored-Q5_K_M.gguf \ --mmproj /opt/llama.cpp/models/mmproj-Qwen3.8-27B-Uncensored-F16.gguf \ --alias qwen3.8 \ -c 131072 --override-kv qwen35.context_length=int:131072 \ -ctk q8_0 -ctv q8_0 -fa on --load-mode none \ --reasoning-effort medium -ngl 99 -np 1 \ --temp 0.3 --top-p 0.9 \ --spec-type draft-mtp --spec-draft-n-max 2 \ --host 0.0.0.0 --port 8080环境变量:
LD_LIBRARY_PATH=/opt/llama.cpp/bin:/opt/rocm/lib、HIP_VISIBLE_DEVICES=0
三、调优结果(前后对比)
指标 调优前 调优后 提升 生成速度 23 t/s 40–41 t/s ↑ 1.75 倍 MTP 投机解码 未启用 生效(接受率 67–78%) — 思考长度 失控(曾跑 7900+ token) ~126 字受控 修复 显存占用 28.2GB(92%) 26.8GB(88%) 省 1.4GB 采样退化 有风险(temp 0.6) 无退化(temp 0.3) 修复 KV 缓存 f16 q8_0(省一半) — 日志告警 有 unused tensor 警告 零告警零错误 修复
四、调稳措施
- systemd 常驻:
/etc/systemd/system/qwen38.service,状态enabled + active,开机自启 + 崩溃 5 秒自动拉起(对齐实体机方案)。 - 单槽位
-np 1:单用户场景 KV 池全归当前会话,避免多槽抢占显存。 - 低温采样
temp 0.3:从根源杜绝"你你我我"式退化重复。
systemd 单元文件内容
[Unit]
Description=Qwen3.8-27B llama.cpp server (R9700 HIP, MTP, 128K)
After=network.target

[Service]
User=magicz890
Group=magicz890
Environment=LD_LIBRARY_PATH=/opt/llama.cpp/bin:/opt/rocm/lib
Environment=HIP_VISIBLE_DEVICES=0
ExecStart=/opt/llama.cpp/bin/llama-server \
  -m /opt/llama.cpp/models/Qwen3.8-27B-Uncensored-Q5_K_M.gguf \
  --mmproj /opt/llama.cpp/models/mmproj-Qwen3.8-27B-Uncensored-F16.gguf \
  --alias qwen3.8 \
  -c 131072 --override-kv qwen35.context_length=int:131072 \
  -ctk q8_0 -ctv q8_0 -fa on --load-mode none \
  --reasoning-effort medium -ngl 99 -np 1 \
  --temp 0.3 --top-p 0.9 \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  --host 0.0.0.0 --port 8080
Restart=on-failure
RestartSec=5
TimeoutStopSec=60
KillSignal=SIGTERM

[Install]
WantedBy=multi-user.target
五、最终测试结果(systemd 运行中实测)
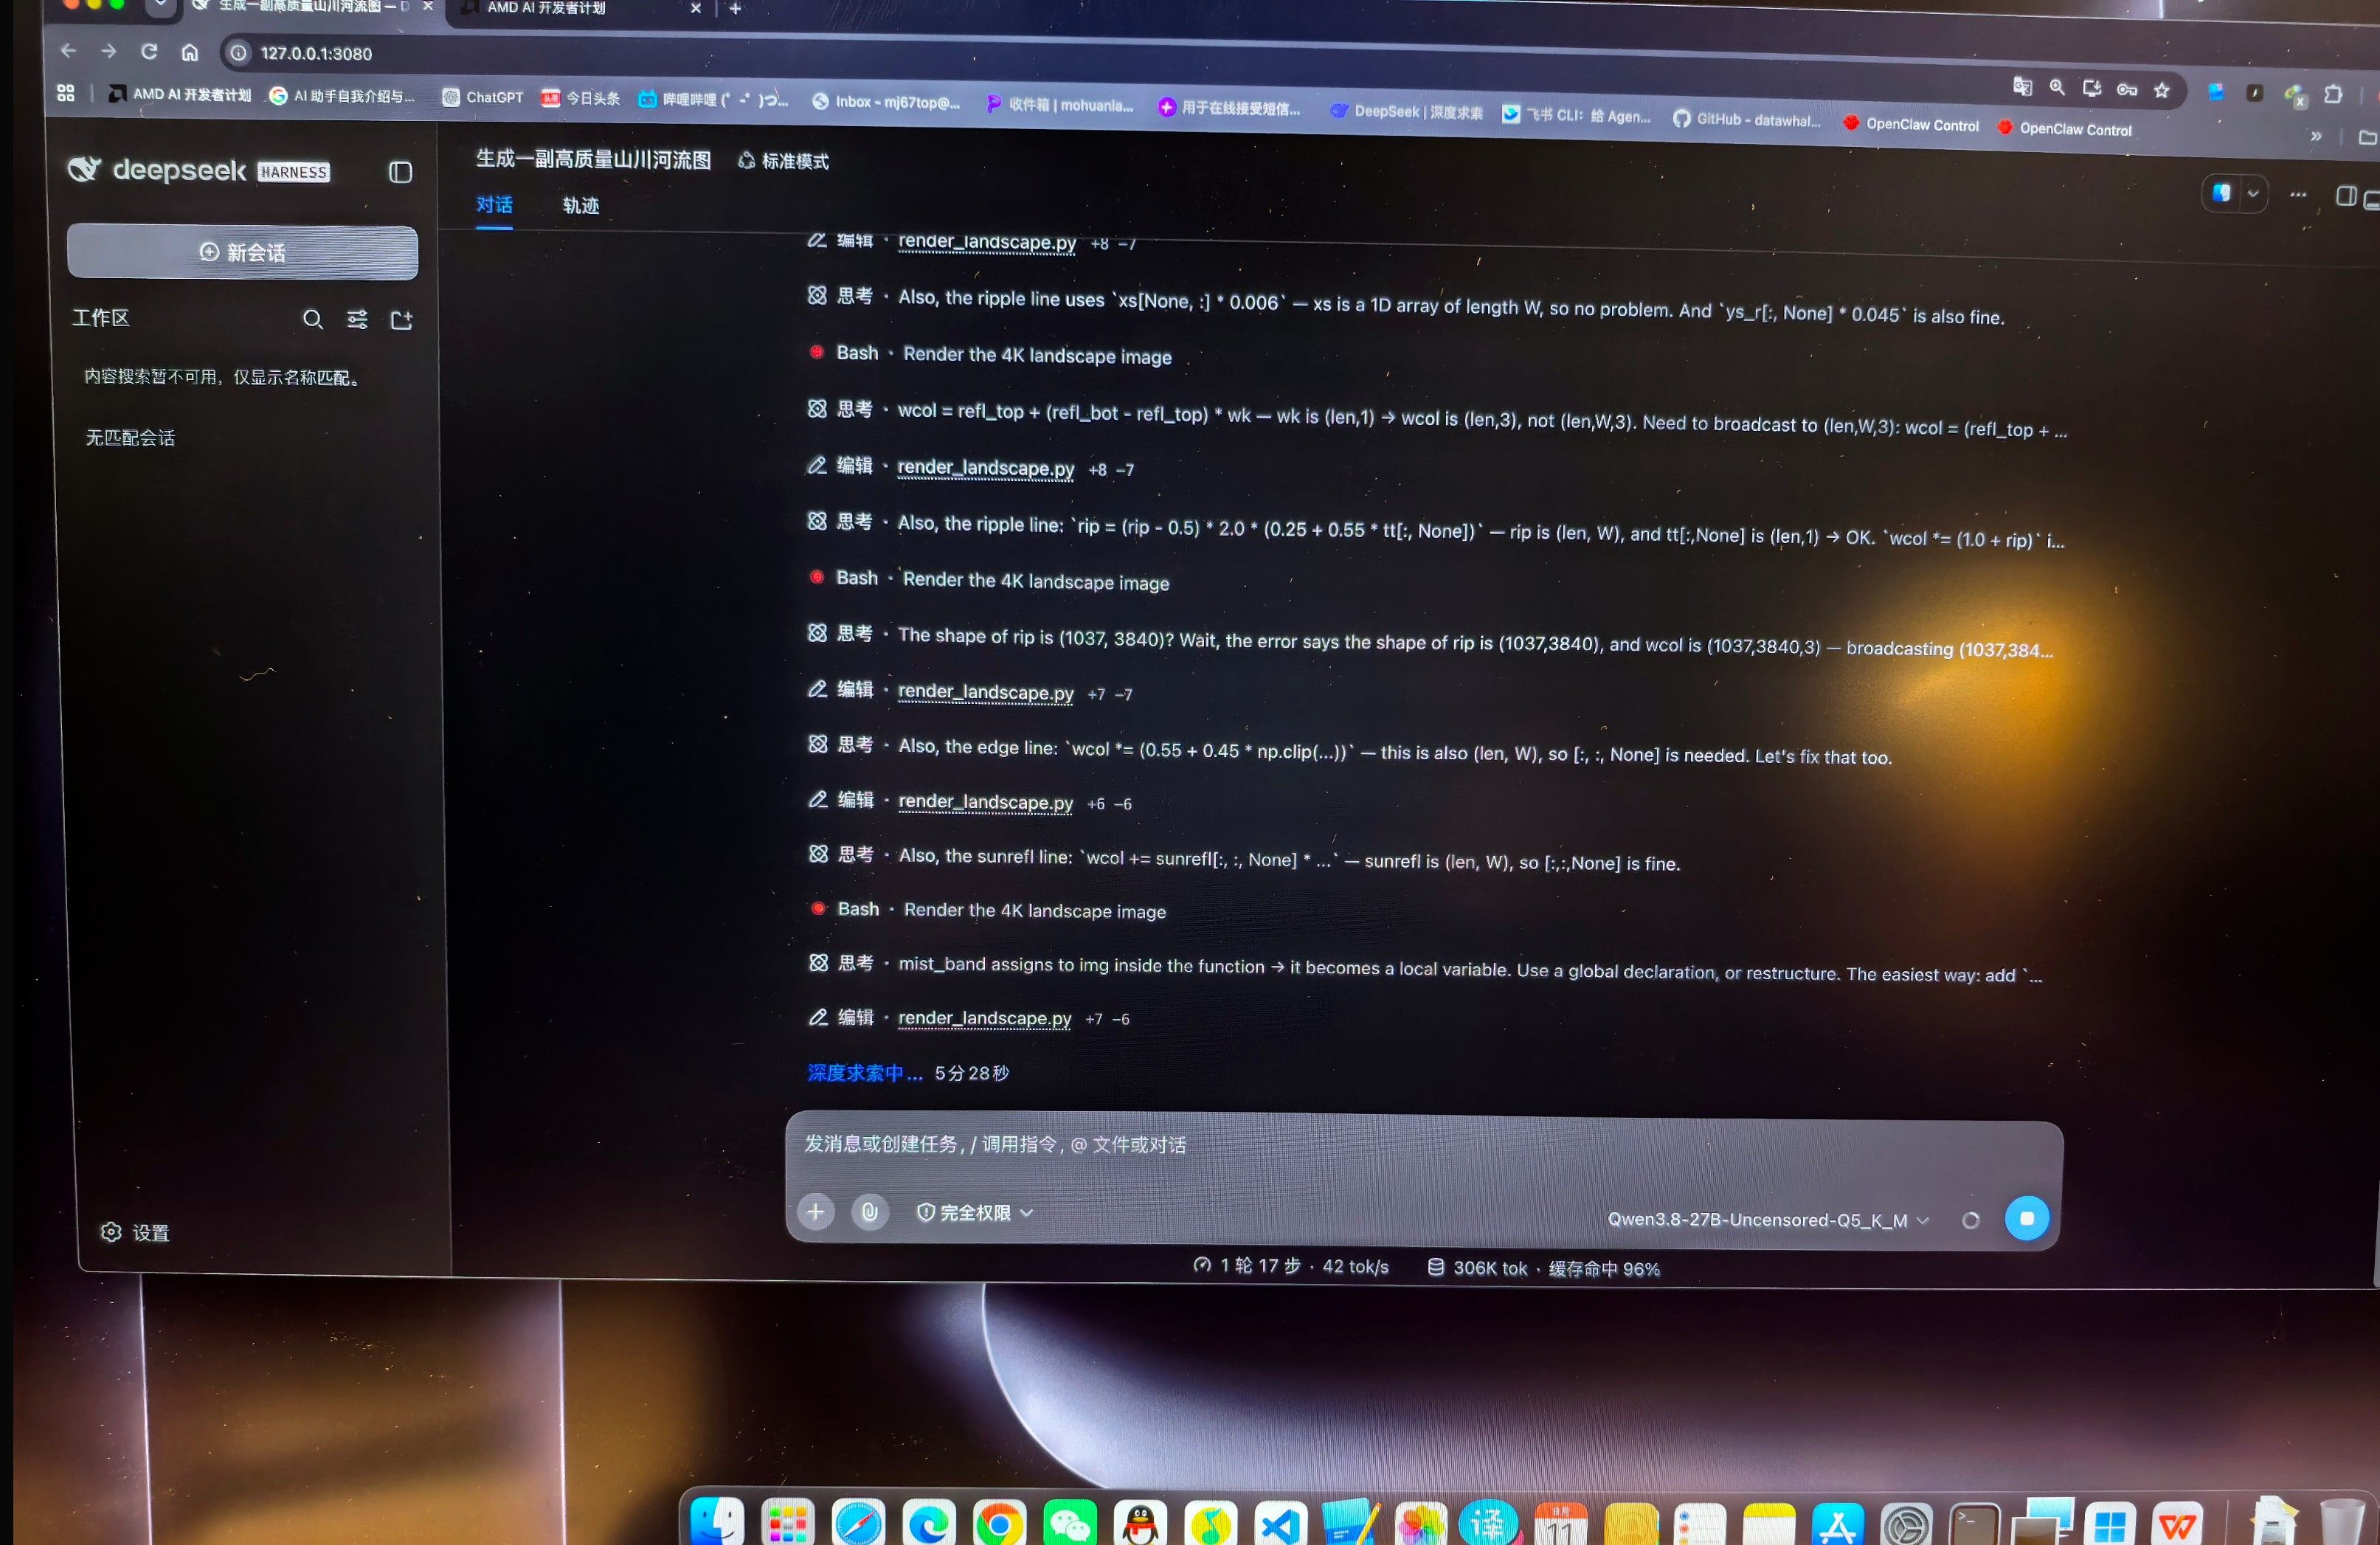
测试项 结果 /health{"status":"ok"}/v1/models别名 qwen3.8,上下文 131072(override-kv 生效)文本生成 "我是一个由阿里巴巴通义实验室研发的大语言模型…"(40.17 t/s) MTP 接受率 67–78%(随内容波动,mean len ≈ 2.2–2.6) 视觉识图 正确识别 "LLaMA C++" 封面及副标题 思考控制 思考长度 126 字(reasoning-effort medium 生效) 日志告警 零告警零错误(MTP 张量已正确加载,无 unused) GPU 40°C、空闲 3%、无硬件错误(UEC=0)
- systemd 常驻:
-
-
好文, Host内存多大?