Proxmox VE 9.2+ Intel 核显 SR-IOV + AMD Radeon AI PRO R9700 直通+Ubuntu24.04部署-全方位评测(终章)
-
PVE 9.2 物理主机 + Ubuntu 24.04 虚拟机 llama.cpp 服务+AMD Radeon AI PRO R9700 本地推理平台全方位评测验收
项目 内容 评测执行端 macOS 工作站 192.168.67.203(2.5GbE)PVE 物理主机 192.168.67.251(节点名R9700,Proxmox VE 9.2.18,内核7.0.14-16-pve)推理虚拟机 192.168.67.202(VMID 102,Ubuntu 24.04.5,内核7.0.0-31-generic)加速卡 AMD Radeon AI PRO R9700( gfx1201,Navi 48,32 GB GDDR6,PCIe 5.0 x16)推理服务 qwen38.service→ llama.cppllama-server0.4.0-dev,监听0.0.0.0:8080模型 Qwen3.8-27B-Uncensored-Q5_K_M.gguf(27.32 B 参数,Q5_K_M,128K 上下文)评测维度 健康度 / 稳定性 / 功耗与散热 / 局域网可用性与性能 / 安全性 / 可运维性 评测方式 SSH 只读采集 + 局域网端到端压测 + 1 Hz 功耗温度采样 本报告所有数据均通过局域网络凭据只读采集。
一、总览
1.1 结论
维度 实测结论 评级 PVE 主机健康度 0 个失败单元、0 次 MCE/硬件错误、0 次 CPU 热节流、0 次 PCIe AER,运行 1 小时 51 分无异常 优 虚拟机健康度 0 个失败单元、0 次 OOM、0 次 swap 换入换出、0 次 GPU 重置,内存压力指标≈0 优 GPU 健康度 MEM ECC 已启用,UMC RAS 计数 CE=0 / UE=0 / DE=0,无坏页;满载 5 分钟无任何错误 优 推理服务稳定性 NRestarts=0,近 7 天日志 0 条 error/fail;两次持续满载(252 s + 304 s)0 错误、吞吐零衰减优 推理性能 单流生成 52.7 token/s(σ=0.01);预填充峰值 949 token/s;首 token 中位 145 ms 优 局域网时延/吞吐 RTT 中位 0.69 ms、丢包 0%;双向吞吐 293 MB/s(2.34 Gbit/s),达 2.5GbE 线速的 94% 优 功耗控制 空闲 GPU 12 W / CPU 21 W;满载 GPU 299 W(功耗墙 300 W)/ CPU 47 W 良 散热 GPU 结温稳态 89 °C(峰值 97 °C)、显存温度 92 °C(峰值 94 °C) 需关注 多客户端并发能力 -np 1:请求被严格串行化,聚合吞吐恒定约 49 token/s,长请求会阻塞全部其他客户端 (家庭独占)差
1.2 七个最关键的事实
-
性能非常扎实,且完全稳定。 单流生成稳定在 52.4–52.7 token/s(多次测量标准差仅 0.01–0.17);5 分钟持续满载 78 个请求、0 错误、吞吐零衰减。对比服务日志中长上下文场景下的 30–43 token/s,可见短上下文性能有明显优势,长上下文会有衰减(见 6.3)。
-
最大的架构短板是
-np 1(单 slot),不是 GPU。 并发 1→16 时聚合吞吐几乎恒定在 47.5→49.0 token/s,说明请求被严格串行排队。实测一个 10 token 的小请求,在 16,200 token 长请求之后排队时,耗时从 0.40 s 涨到 19.78 s(49 倍)。多人/多 agent 同时使用同一服务时体验会显著恶化。 -
长上下文预填充是"分钟级"的。 98,304 token 的输入需要 261 秒;按实测速率外推,占满 128K 上下文约需 5.8 分钟。在此期间
/health仍返回 200,但推理接口完全不可用——健康检查不能代表服务可用性。 -
GPU 功耗正常但温度偏高。 R9700 空闲 12 W、满载 299 W(正好打满 300 W 功耗墙,峰值 304 W,曾观测到 354 W 瞬时尖峰);结温稳态 89 °C、峰值 97 °C,显存温度稳态 92 °C、峰值 94 °C——显存温度是本机散热的最热点。
-
数据安全存在真实风险:
AI服务器整块 1 TB 物理 NVMe 裸盘直通 (方案:停机备份整块盘)。 -
访问控制真实风险:
局域网内任何设备都可以直接占用这块 300 W 的 GPU -
主机与虚拟机的硬件健康度都很好。 0 次 MCE、0 次 AER、0 次 CPU 节流、内存压力≈0;GPU ECC 零错误。平台本身的可靠性没有问题。
二、评测环境与拓扑
2.1 物理拓扑
        ┌──────────────────────────────────────────────────────────────┐
        │  评测客户端  macOS 工作站   192.168.67.203                    │
        │  网卡 en1:2500Base-T 全双工   (icmp RTT 中位 0.37 ms)        │
        └───────────────────────────┬──────────────────────────────────┘
                                    │  2.5GbE 交换网络(同一广播域)
        ┌───────────────────────────▼──────────────────────────────────┐
        │  PVE 9.2.18 物理主机  192.168.67.251   节点名 R9700            │
        │  Intel Core Ultra 7 265K / 20 核 / 62 GiB DDR5-6400(非 ECC)  │
        │  ASUS TUF GAMING Z890-PRO WIFI  BIOS 3211                     │
        │  启动盘 Samsung 512GB NVMe → LVM(pve-root 467.94G + swap 8G)  │
        │  数据盘 Kingston 1TB NVMe →【整块裸盘直通】                    │
        │  上行 enp135s0 2500Mb/s → vmbr0(无 BMC/IPMI,防火墙已禁用)    │
        └───────────────┬──────────────────────────┬───────────────────┘
                        │ KVM + VFIO 直通          │
        ┌───────────────▼──────────────┐  ┌────────▼─────────┐
        │ VM 102  Ubuntu24.04-desktop  │  │ VM 100 Ikuai8    │
        │ 192.168.67.202               │  │ VM 101 OpenWrt   │
        │ 10 vCPU(host) / 48 GiB       │  │      停止待用     │
        │ 根盘 = Kingston 整块直通      │  └──────────────────┘
        │ GPU 04:00.0 R9700 直通        │
        │ qwen38.service :8080          │
        └──────────────────────────────┘
2.2 PVE 物理主机
项目 实测值 主机名 / 系统 R9700/ Debian GNU/Linux 13.6 (trixie)PVE 版本 pve-manager 9.2.18,proxmox-ve 9.2.0,qemu-server 9.2.7,pve-qemu-kvm 11.0.3-3 内核 7.0.14-16-pve(另留存 6.14.11-9、6.14.8-2 备用内核)主板 / BIOS ASUSTeK TUF GAMING Z890-PRO WIFI Rev 1.xx / BIOS 3211(2026-07-28) CPU Intel Core Ultra 7 265K,20 核 / 20 线程,800–5500 MHz,L3 30 MiB 内存 62 GiB(2 × 32 GB Kingston KF564C32-32 DDR5-6400 MT/s @1.4 V),非 ECC,4 槽仅用 2 槽 启动存储 Samsung MZAMX512HCLV-00BL2 512 GB → LVM: pve-root467.94 G(ext4) +pve-swap8 G数据存储 Kingston SNV2S1000G 1 TB(整块直通给 VM 102,AI推理服务器) 存储方案 LVM + ext4,未使用 ZFS;根分区已用 12 G / 461 G(3%) 上行链路 enp135s0(1c:86:0b:2f:1a:16)2500 Mb/s 全双工,桥接至vmbr0未用网口 eno1/enp136s0/enp137s0/enp138s0(NO-CARRIER)、wlp131s0(WiFi 未启用)内核启动参数 intel_iommu=on i915.enable_guc=3 i915.max_vfs=4 module_blacklist=xe调频策略 intel_pstate=active,governor=performance,EPP=default,no_turbo=0(睿频启用),max_perf_pct=100深度 C 态 intel_idle+menu,C3 驻留占运行时长约 83%热节流计数 core = 0,package = 0(从未节流) 传感器 coretemp(封装 39–40 °C 空闲)、2× NVMe、asushwmon(无风扇转速通道)、acpitz;无turbostat虚拟化 KVM 运行中,仅 VM 102 在跑;KSM 已启用(run=1) 防火墙 pve-firewall status→disabled/running;iptables 全链默认 ACCEPT备份 无 jobs.cfg、无 vzdump cron、/var/lib/vz/dump为空 → 无任何备份时间同步 chrony 已同步(Stratum 3,系统时间偏差 1.9 ms) 运行时长 1 小时 51 分(本次启动 2026-09-11 20:31)
2.3 Ubuntu 24.04 推理虚拟机(VM 102)
项目 实测值 VMID / 名称 102 / Ubuntu24.04-desktop主机名 / 系统 magicz890-Ai/ Ubuntu 24.04.5 LTS(Noble),内核7.0.0-31-generic虚拟化 systemd-detect-virt→kvm;机型pc-q35-11.0,UEFI(OVMF),cpu: host计算资源 10 vCPU / 48 GiB 内存(49152 MB),swap 8 GiB(文件,使用 0) 内存实测 总计 46 Gi,已用 13 Gi,可用 33 Gi; pswpin/pswpout = 0,oom_kill = 0GPU 直通 hostpci0: 0000:04:00.0,pcie=1→ 客体内01:00.0,驱动amdgpu3.64.0显卡规格 AMD Radeon AI PRO R9700( 1002:7551,Navi 48,Sapphire),VRAM 30,576 MiB = 29.86 GiB链路 PCIe 5.0 x16(32.0 GT/s ×16) ECC MEM ECC is active./GECC is currently enabled, which may affect performance存储 客体 sda931.5 G(QEMU HARDDISK,virtio-scsi)→ ext4/915 G,已用 80 G(10%)网络 enp6s18virtio(bc:24:11:ac:b1:1c),192.168.67.202/24,MTU 1500,单 RX/TX 队列ROCm 10.0.0~pre4(gfx1201 专用包),HIP 7.15.26333,AMD clang 23.0.0git llama.cpp 0.4.0-dev (build 1, commit df03399),GNU 13.3.0 编译, /opt/llama.cpp/共 45 GB远程桌面 gnome-remote-desktop监听 3389 / 3390(对全网段开放)其他服务 GNOME 桌面、Xorg、Chrome、 dsh web(127.0.0.1:3080)、cupsd防火墙 ufw未启用;iptables 全链 ACCEPT;未安装 fail2ban (测试机后备)运行时长 1 小时 51 分(本次启动 2026-09-11 20:31:47)
2.4 llama.cpp 服务配置
/etc/systemd/system/qwen38.service
  Description = Qwen3.8-27B llama.cpp server (R9700 HIP, MTP, 128K)
  User/Group  = magicz890
  Environment = LD_LIBRARY_PATH=/opt/llama.cpp/bin:/opt/rocm/lib
                HIP_VISIBLE_DEVICES=0
  ExecStart   = /opt/llama.cpp/bin/llama-server
                  -m  /opt/llama.cpp/models/Qwen3.8-27B-Uncensored-Q5_K_M.gguf
                  --mmproj /opt/llama.cpp/models/mmproj-Qwen3.8-27B-Uncensored-F16.gguf
                  --alias qwen3.8
                  -c 131072 --override-kv qwen35.context_length=int:131072
                  -ctk q8_0 -ctv q8_0 -fa on --load-mode none
                  --reasoning-effort medium -ngl 99 -np 1
                  --temp 0.3 --top-p 0.9
                  --spec-type draft-mtp --spec-draft-n-max 2
                  --host 0.0.0.0 --port 8080
  Restart     = on-failure / RestartSec=5 / TimeoutStopSec=60
关键参数 值 含义与影响 -c 131072+-ctk/-ctv q8_0128K 上下文,KV 量化 8 bit KV 缓存约 6.17 GiB(≈49.3 KiB/token),显存占用 25.2 GiB -fa onFlash Attention 开启 长上下文必需,已正确启用 -ngl 99全部层卸载到 GPU 正确(GPU 显存充足) -np 1仅 1 个 slot 请求串行化,无并发能力(自用测试) --spec-type draft-mtp+n-max 2MTP 自投机解码 日志显示接受率可达 0.99,是 52 t/s 高吞吐的主因 --host 0.0.0.0监听全部接口 无鉴权暴露到局域网 服务启动性能:模型加载耗时约 8.2 秒(20:31:49.898 → 20:31:58),对 18.19 GiB 模型而言非常快。
2.5 评测方法
项目 说明 采集方式 通过 expect 封装的 SSH(密码登录)执行只读采集脚本;未修改任何配置、服务、文件 压测方式 从 macOS 客户端 192.168.67.203通过局域网调用http://192.168.67.202:8080的 OpenAI 兼容与原生命令接口功耗采集 VM 内 1 Hz 读取 amdgpuhwmon(PPT 功率、三路温度、风扇、频率、显存);主机 1 Hz 读取 Intel RAPL 能耗计数器与coretemp环境 这是一台正在提供服务的生产机器。 评测期间该 llama 服务同时被 agent 工作流使用(日志可见 3 万 token 级上下文任务)。所有压测数据均在此共享背景下采集,代表"真实使用状态"而非实验室理想值 副作用 压测会冲掉 llama.cpp 的 prompt cache,可能使评测后第一个 agent 请求需要重新处理前缀;未重启、未停止任何服务; n_predict超限探测请求在客户端 30 s 超时断开后,服务端正确取消了任务未做事项 未做断电/掉电测试、未做 8 小时以上长稳、未做 PCIe 错误注入、未做多卡/NVLink 测试
三、健康度评测
3.1 PVE 主机健康度
检查项 实测结果 判定 失败 systemd 单元 0 个 正常 核心服务状态 pveproxy/pvedaemon/pve-cluster/qmeventd均 active(corosyncinactive 属正常单节点)正常 MCE / 机器检查 dmesg匹配mce|machine check|hardware error= 0 条正常 PCIe AER 仅 10 条 AER: enabled with IRQ初始化信息,无 AER 错误正常 EDAC 内存错误 未暴露 ce_count/ue_count(消费级平台无 ECC 也无可读计数器)不可观测 CPU 热节流 core_throttle_count = 0,package_throttle_count = 0(全部 20 核)优 内核错误级日志 仅 6 条,全部为无害项(见下) 正常 内存压力 PSI memory some/full total = 5 µs,基本为 0 优 交换 pswpin/pswpout = 0,swap 使用 0 B优 OOM oom_kill = 0优 负载 load1 = 0.14(1 分钟)/ 1.10(评测后),20 核机器非常空闲 优 时间同步 chrony Stratum 3,系统时间偏差 +1.9 ms 优
3.2 虚拟机健康度
检查项 实测结果 判定 失败 systemd 单元 0 个(56 个 running 单元) 正常 内核错误级日志 9 条,全部为开机瞬时告警( shpchp ... pci_hp_register failed、snd_hda_intel: no codecs found!)基本无害 amdgpu错误0 条 ring timeout / GPU reset / page fault 优 CPU 热节流 全部 vCPU core/package_throttle_count = 0优 内存压力 PSI memory some total ≈ 1 µs,full ≈ 1 µs 优 交换活动 pswpin/pswpout = 0,swap 使用 0 B优 OOM oom_kill = 0优 磁盘 /已用 80 G / 915 G(10%),无 md RAID 活动正常 待重启 /var/run/reboot-required不存在正常
3.3 GPU 健康度
检查项 实测结果 判定 型号识别 AMD Radeon AI PRO R9700,Device ID0x7551,SKU1E4990U,GUID 23946正常 GFX 架构 gfx1201(rocminfo 同时暴露gfx12-generic)正常 VBIOS 113-1E4990U-S83— 驱动 amdgpu 3.64.0,SMU fw104.76.0正常 显存 总 30,576 MiB(29.86 GiB),BAR 32768M,256-bit GDDR6 正常 显存 ECC MEM ECC is active./ GECC enabled优 RAS 模块 UMC: ENABLED、DF: ENABLED;SDMA/GFX/MMHUB/ATHUB/PCIE_BIF 等 DISABLED部分可用 ECC 计数 umc_err_count→ ue: 0,ce: 0,de: 0优 显存坏页 gpu_vram_bad_pages为空优 链路状态 PCIe 32.0 GT/s ×16(Gen5 x16),驱动 CfgCurrentLinkSpeed 16.0GT/s x16 优 计算单元 SE 4 × SH 2 × CU 8 = 64 CU(active_cu_number 64) 正常 满载 5 分钟后复检 ECC 仍为 0/0/0,无 GPU reset,无 ring timeout 优 直通告警 QEMU 启动时 vfio_container_dma_map(...) = -22 (Invalid argument)与0000:04:00.0: PCI peer-to-peer transactions on BARs are not supported.需关注 关于直通告警:QEMU 在建立 DMA 映射时出现一次
-22(EINVAL),并提示该卡不支持 BAR 级 P2P 事务。这两条是 VFIO 大 BAR(32 GB)映射的常见提示,在单卡直通、且不需要 GPU 间 P2P(NVLink/XGMI)的场景下不影响功能与稳定性——本次 5 分钟满载 0 错误即为佐证。3.4 服务健康度
检查项 实测值 服务状态 active (running),enabled(开机自启)重启次数 NRestarts0 本次运行时长 1 小时 50 分(20:31:49 起) 主进程 PID 1244( llama-server)内存占用 当前 29.5 G,峰值 36.4 G;RSS 17.9 GB CPU 累计 28 分 12 秒 线程数 16 相关告警 启动时 CORS is set to allow all origins ('*') and no API key is set、Qwen-VL models require at minimum 1024 image tokens文件描述符限制 LimitNOFILE软限 1024 / 硬限 524288 (需优先处理)
四、稳定性评测
4.1 运行时长与重启历史
PVE 主机:今天的重启全部是我修改参数,不是崩溃。
reboot   system boot  7.0.14-16-pve    Fri Sep 11 20:31 - still running
reboot   system boot  7.0.14-16-pve    Fri Sep 11 10:42 - 20:30  (09:48)
shutdown system down  7.0.14-16-pve    Fri Sep 11 20:30 - 20:31  (00:00)
reboot   system boot  7.0.14-16-pve    Fri Sep 11 09:02 - 10:15  (01:12)
shutdown system down  7.0.14-16-pve    Fri Sep 11 10:15 - 10:42  (00:27)
reboot   system boot  7.0.14-16-pve    Fri Sep 11 07:30 - 07:31  (00:00)
...
每条
reboot前都对应一条shutdown ... system down,7 次启动、0 次非正常掉电。journalctl --list-boots与last -x完全一致。虚拟机:同样全部为正常关机(
shutdown system down→reboot system boot),最快一次仅停机 1 分钟。llama 服务:
NRestarts=0,与主机重启时间严格对齐——主机重启时服务随虚拟机自启,未发生任何崩溃重启。
4.2 长稳压测结果
执行了两轮持续满载推理,均在 1 Hz 功耗采样覆盖下完成:
轮次 时长 并发 完成请求 生成 token 错误数 单请求速度 标准差 第一轮 304 s 2 78 14,976 0 52.46 t/s 0.17 第二轮 252 s 1 63 12,096 0 52.46 t/s 0.13 关键结论:约 9.3 分钟累计满载、141 个请求,零错误、零重试、吞吐零衰减。 两轮的单请求速度中位数完全一致(52.46 t/s),说明 GPU 在持续满载下没有出现降频或性能衰减。
请求延迟(192 token/请求):中位 7.56 s,p99 7.84 s,标准差 0.46 s——排队行为可预测。
4.3 满载后的状态复检
压测结束后立即复检(22:22:44),结果:
检查项 压测前 压测后 判定 NRestarts0 0 优 GPU ECC(UE/CE/DE) 0/0/0 0/0/0 优 显存坏页 无 无 优 内核错误数 9 9(无新增) 优 GPU reset / ring timeout 0 0 优 CPU 热节流计数 0/0 0/0 优 内核错误级日志 6 条 6 条(无新增) 优 GPU 状态回落 12 W 18 W → 随后回落到 12 W 优 GPU 温度回落 32 °C 边 66 °C 结温 → 冷却中 正常
4.4 温控稳定性
阶段 GPU 结温 GPU 显存温度 CPU 封装温度 风扇转速 是否降频 开机空闲 34 °C 32 °C 39 °C 891 rpm(最低) 否(SCLK 41 MHz 为深度空闲档) 满载 1 分钟 88 °C 90 °C 47 °C 2,370 rpm 否(SCLK 2788 MHz) 满载稳态 88–90 °C 92–94 °C 51 °C 2,470–2,595 rpm 否(SCLK 2730–3077 MHz) 峰值 97 °C 94 °C 62 °C 3,189 rpm 否 判定依据:整个压测过程 SCLK 未出现台阶式下降、生成吞吐标准差仅 0.13–0.17、CPU
core/package_throttle_count保持 0。平台没有热降频,但 GPU 显存温度已进入 90 °C 以上的"暖区"。
五、功耗与散热评测
5.1 GPU 功耗与温度实测(AMD R9700)
数据来源:
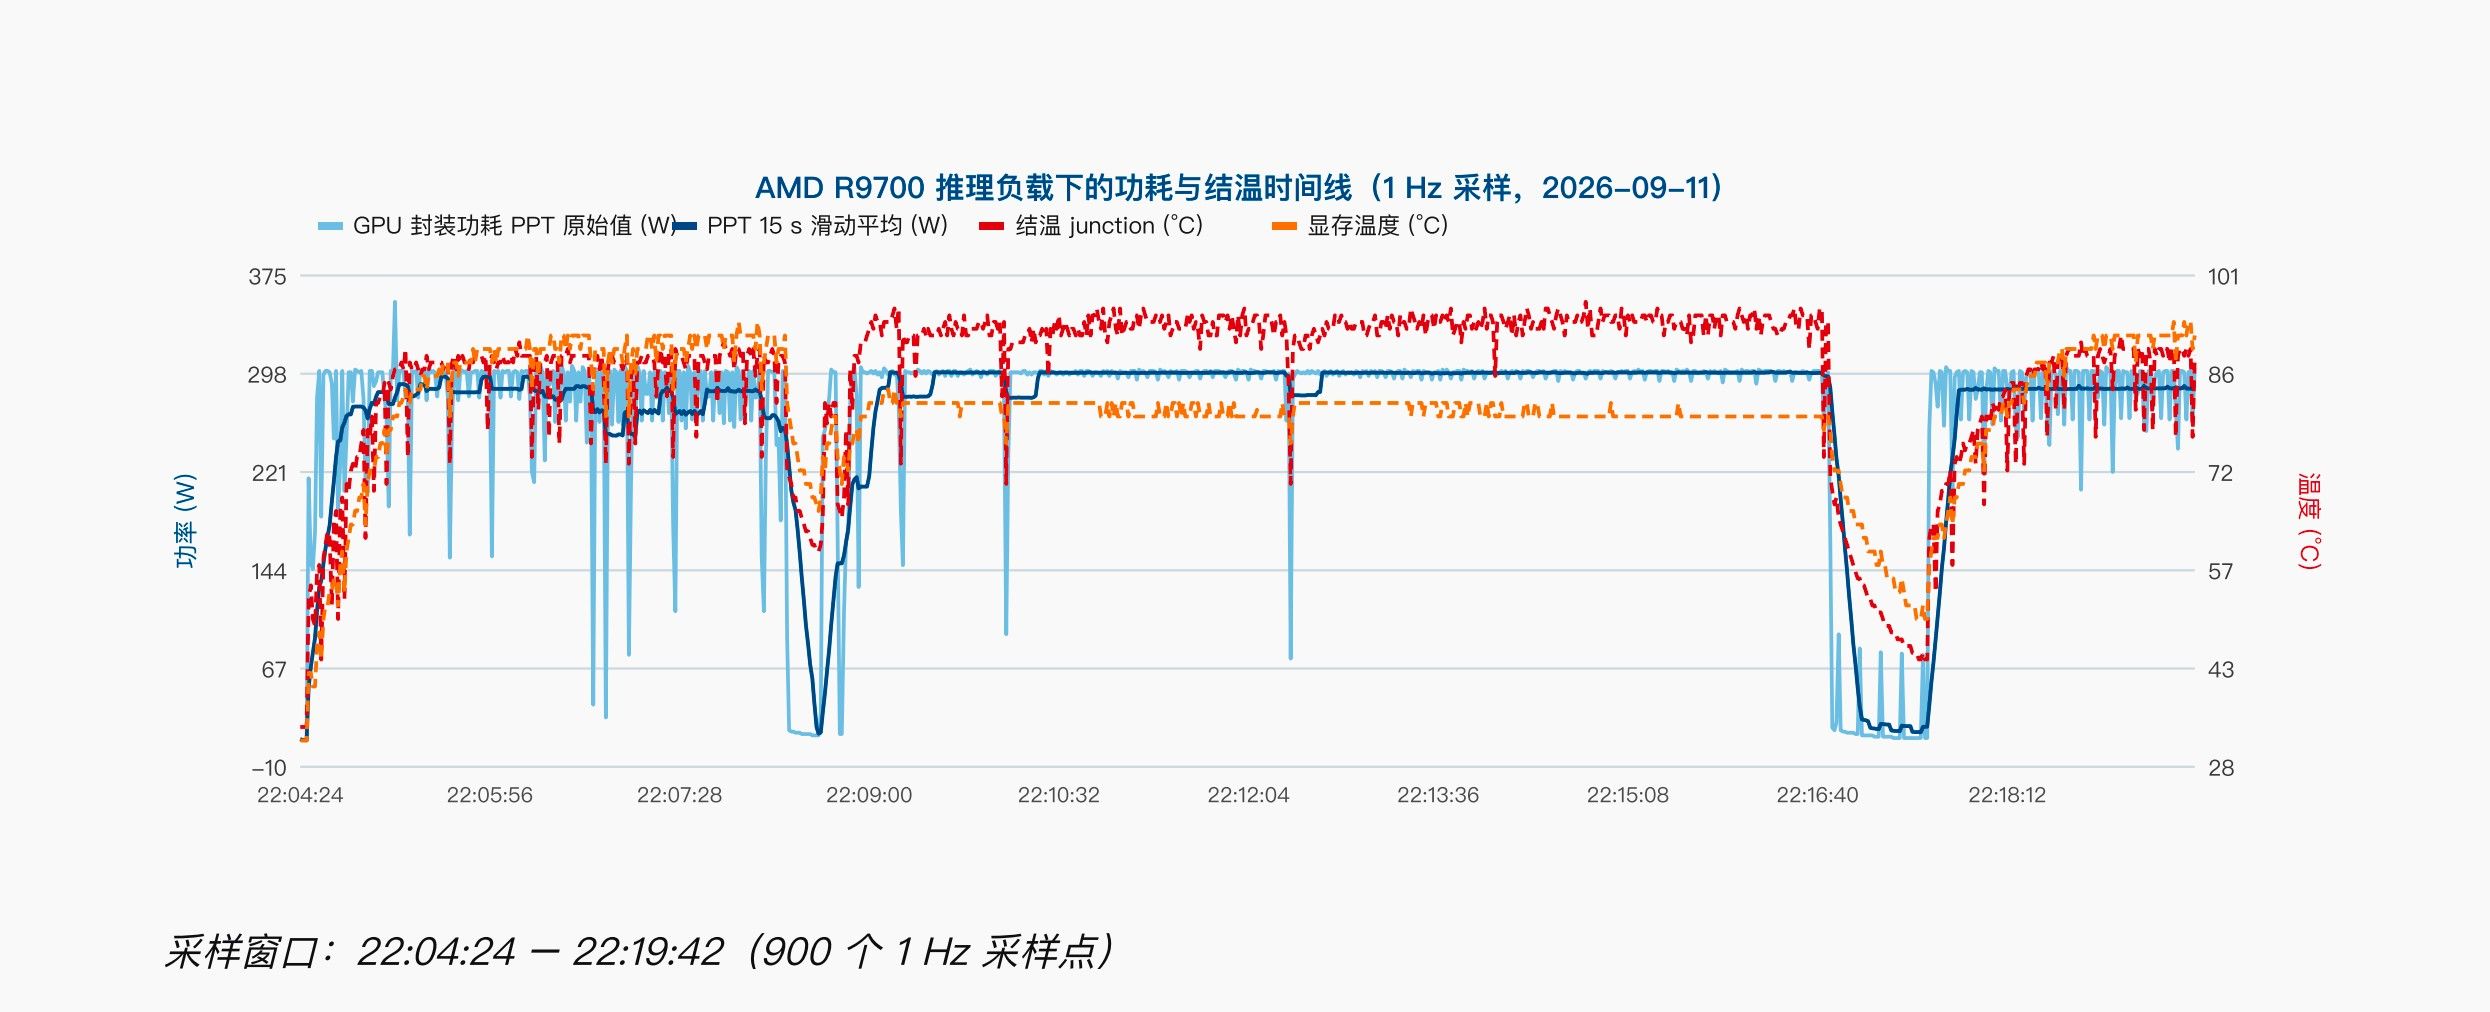
/sys/class/drm/card1/device/hwmon/hwmon0/(power1_average、temp1/2/3_input、fan1_input、freq1/2_input),1 Hz 采样,共 900 + 386 个样本。指标 空闲(无客户端) 满载(单流持续生成) 功耗墙 PPT 封装功耗 12 W(中位/最小 11–12 W) 299 W(中位)/ 均值 271 W / 峰值 304 W power1_cap = 300 W,min 210 W边缘温度 edge 32 °C 中位 72 °C / 峰值 73 °C — 结温 junction 34 °C 中位 89 °C / p90 95 °C / 峰值 97 °C — 显存温度 memory 32 °C 中位 92 °C / p90 90 °C / 峰值 94 °C — 风扇转速 891 rpm(20%,最低档) 中位 2,473 rpm / 峰值 3,189 rpm(56%) — 核心频率 SCLK 41 MHz 中位 2,822 MHz / 峰值 3,244 MHz 档位上限 2350 MHz(标称)/ 实测睿频可达 3.24 GHz 显存频率 MCLK 96 MHz 1,258 MHz(最高档) — GPU 占用率 3% 100% — 显存带宽占用率 mem_busy 0% 中位 63% / 峰值 87% — 显存占用 VRAM 25.8 GB(模型+KV 常驻) 25.8–26.0 GB 总 29.86 GiB 供电电压 VDDGFX 1.0 mV(未激活) — — GPU 是绝对功耗大头:满载时 GPU 299 W vs CPU 47 W,GPU 占整机功耗约 70%,如家庭使用可降频到270W左右,影响甚微。
空闲温度的测量口径:表中空闲值为开机后长时间无负载状态(本次为启动后 1 小时 33 分、无任何客户端)的实测值。压测结束冷却约 4 分钟后,三路温度回落到 37 / 39 / 38 °C(边缘/结温/显存),功耗回落到 11 W,风扇回到最低档 891 rpm —— 说明散热与功耗回退机制工作正常,只是机箱内部余温使读数略高于冷启动状态。
GPU 功耗/温度时间线
5.2 主机 CPU 功耗与温度实测(Intel RAPL)
数据来源:
/sys/class/powercap/intel-rapl:0/energy_uj(package)与intel-rapl:0:0(core),差分法计算瓦特。指标 空闲 满载 峰值 CPU 封装功耗 package 20.8 – 21.2 W 中位 46.9 W 69.2 W CPU 核心功耗 core 8.5 – 9.0 W 中位 31.2 W 50.4 W CPU 封装温度 39–40 °C 中位 51 °C 62 °C NVMe0(Kingston,VM 根盘) 46.9 °C 47.9 °C 51.9 °C NVMe1(Samsung,启动盘) 37.9 °C 36.9 °C 37.9 °C CPU 功耗/温度时间线
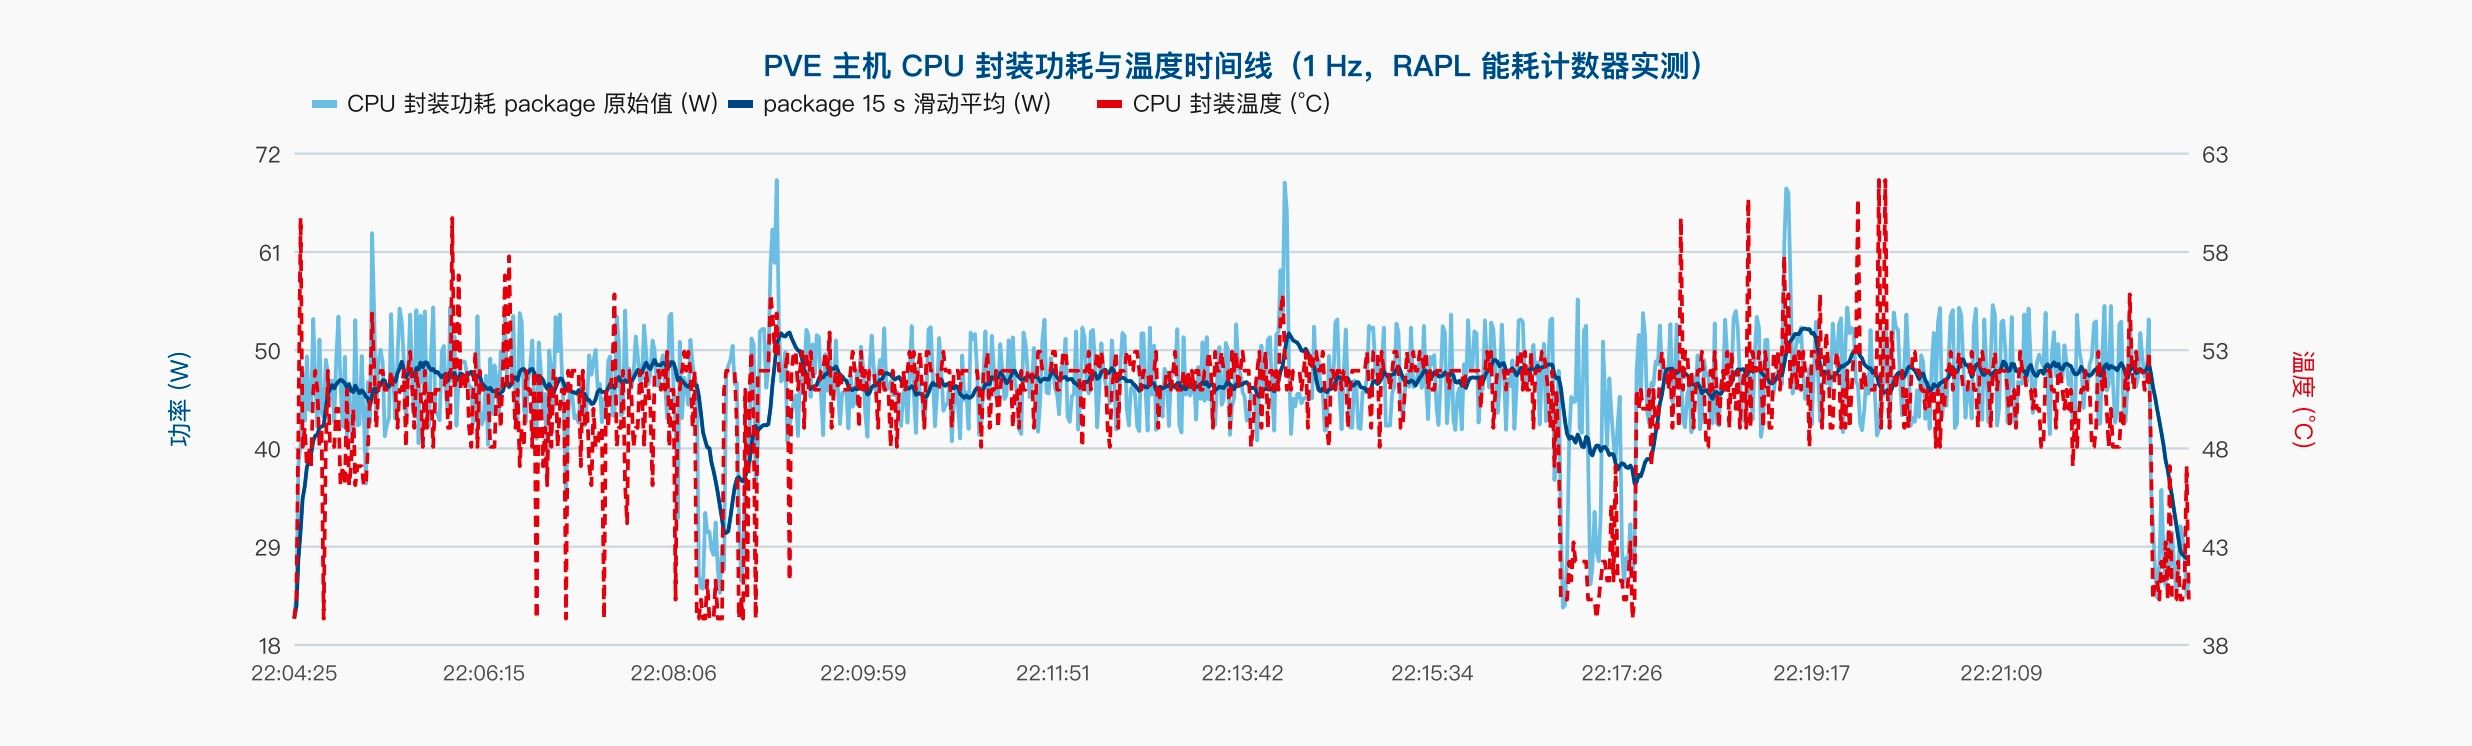
由 RAPL 可见,CPU 在推理场景中几乎"闲着":封装功耗仅从 21 W 升到 47 W(+26 W),远小于 GPU 的 +287 W。这与
llama-server的 CPU 占用很低这一事实一致 ——CPUUsageNSec折算其生命周期平均 CPU 占用约 25.4%(累计 1,692 s CPU 时间 / 6,655 s 运行时间 ÷ 10 vCPU ≈ 2.5 个 vCPU 等效),且这部分开销主要来自采样与 HTTP 层,矩阵计算全部在 GPU 上完成。
5.3 整机功耗估算(因消费级主板数据仅供参考)
主机无 BMC/IPMI、无机箱功耗计、无智能插座数据,因此整机瓦特数为基于实测分量的估算:
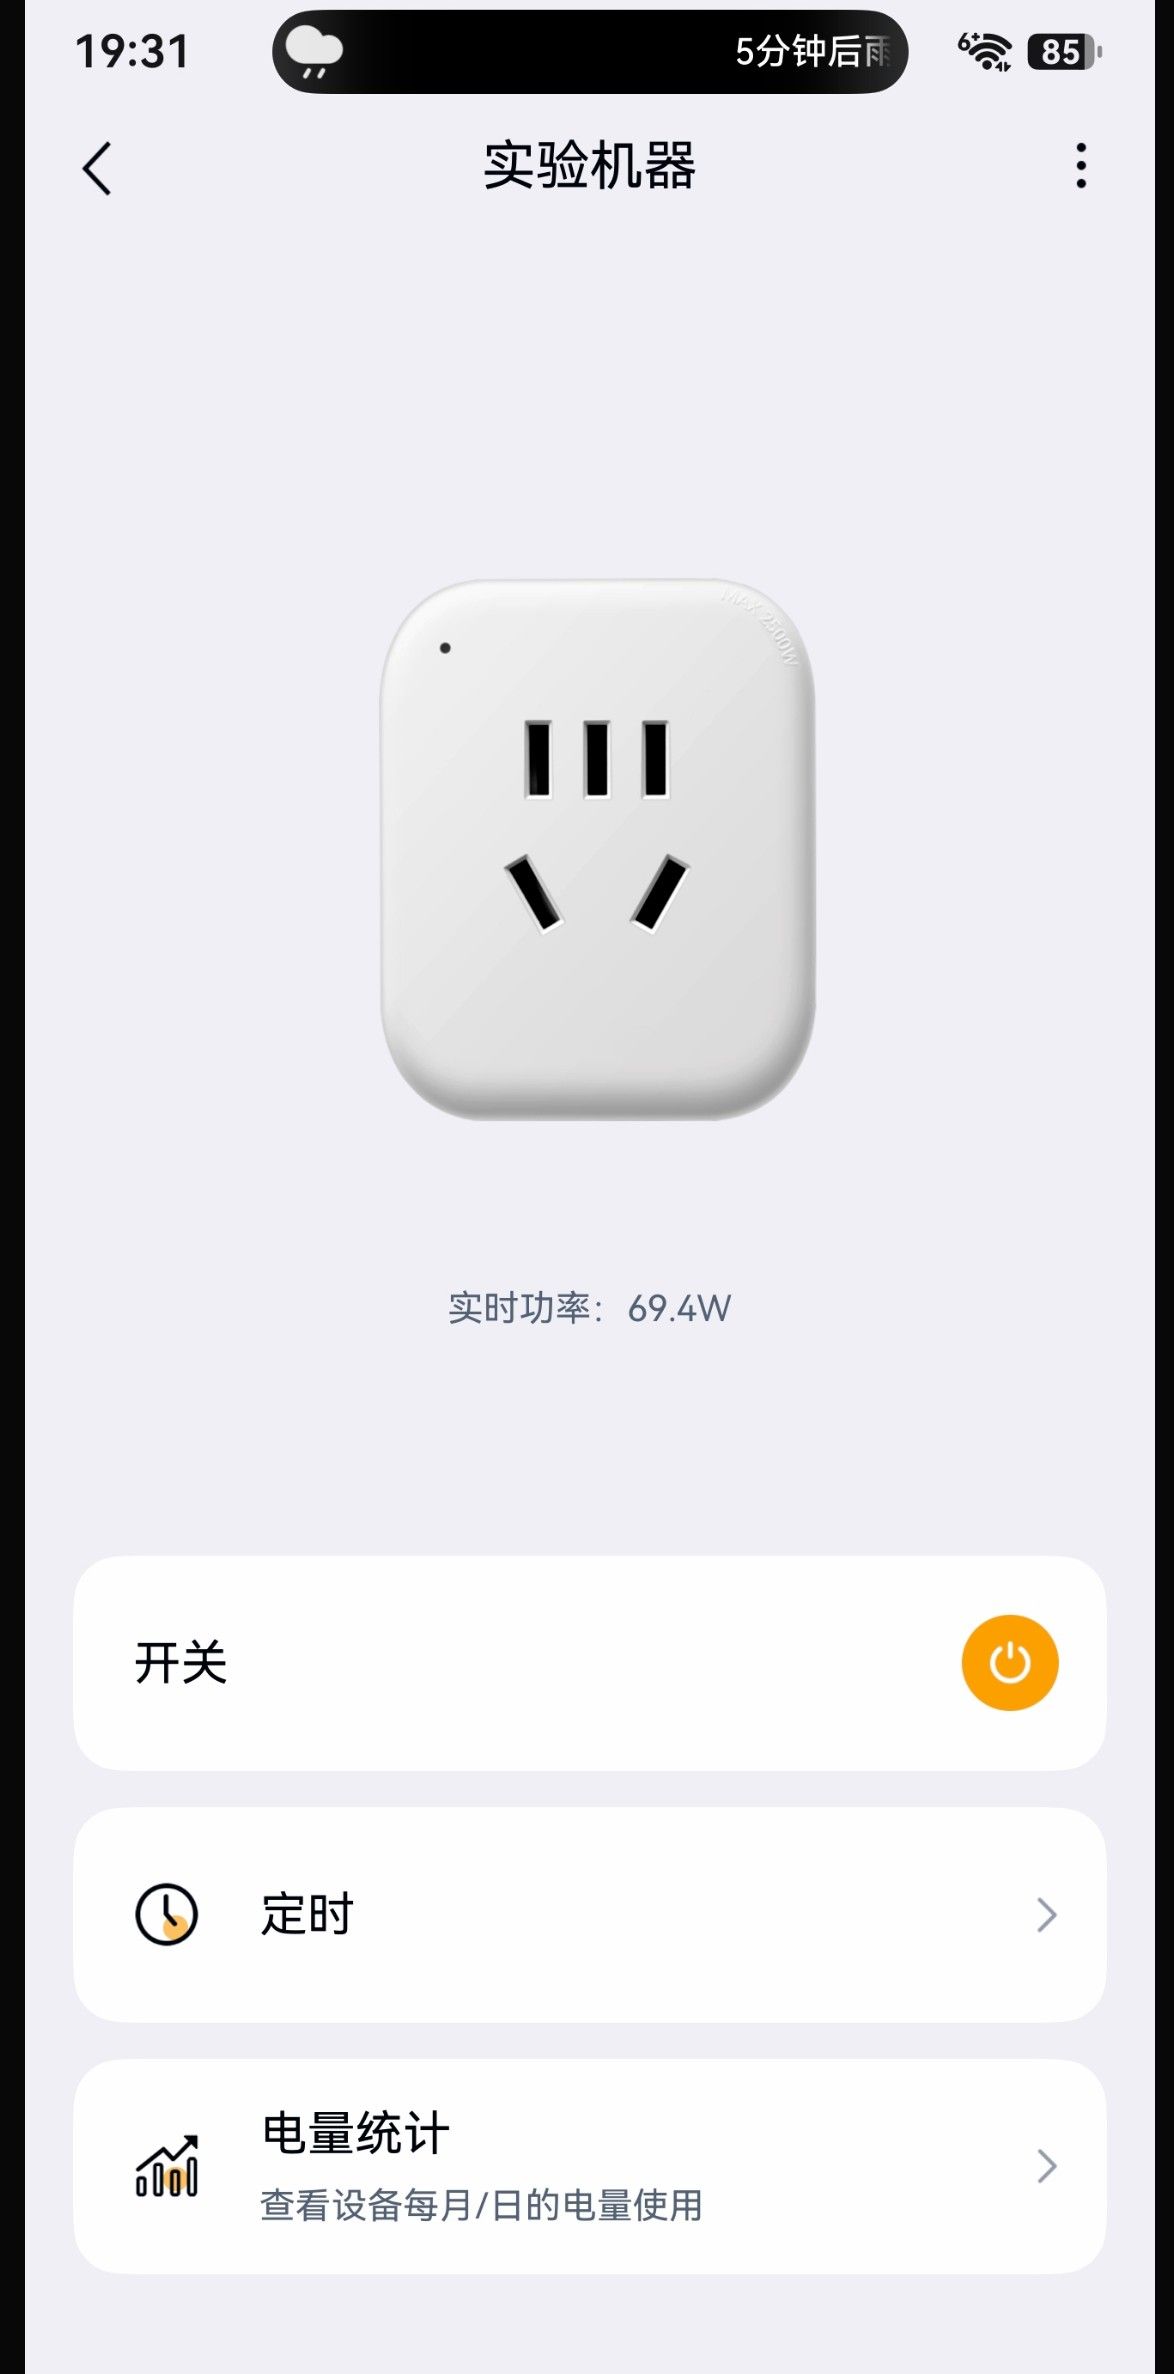
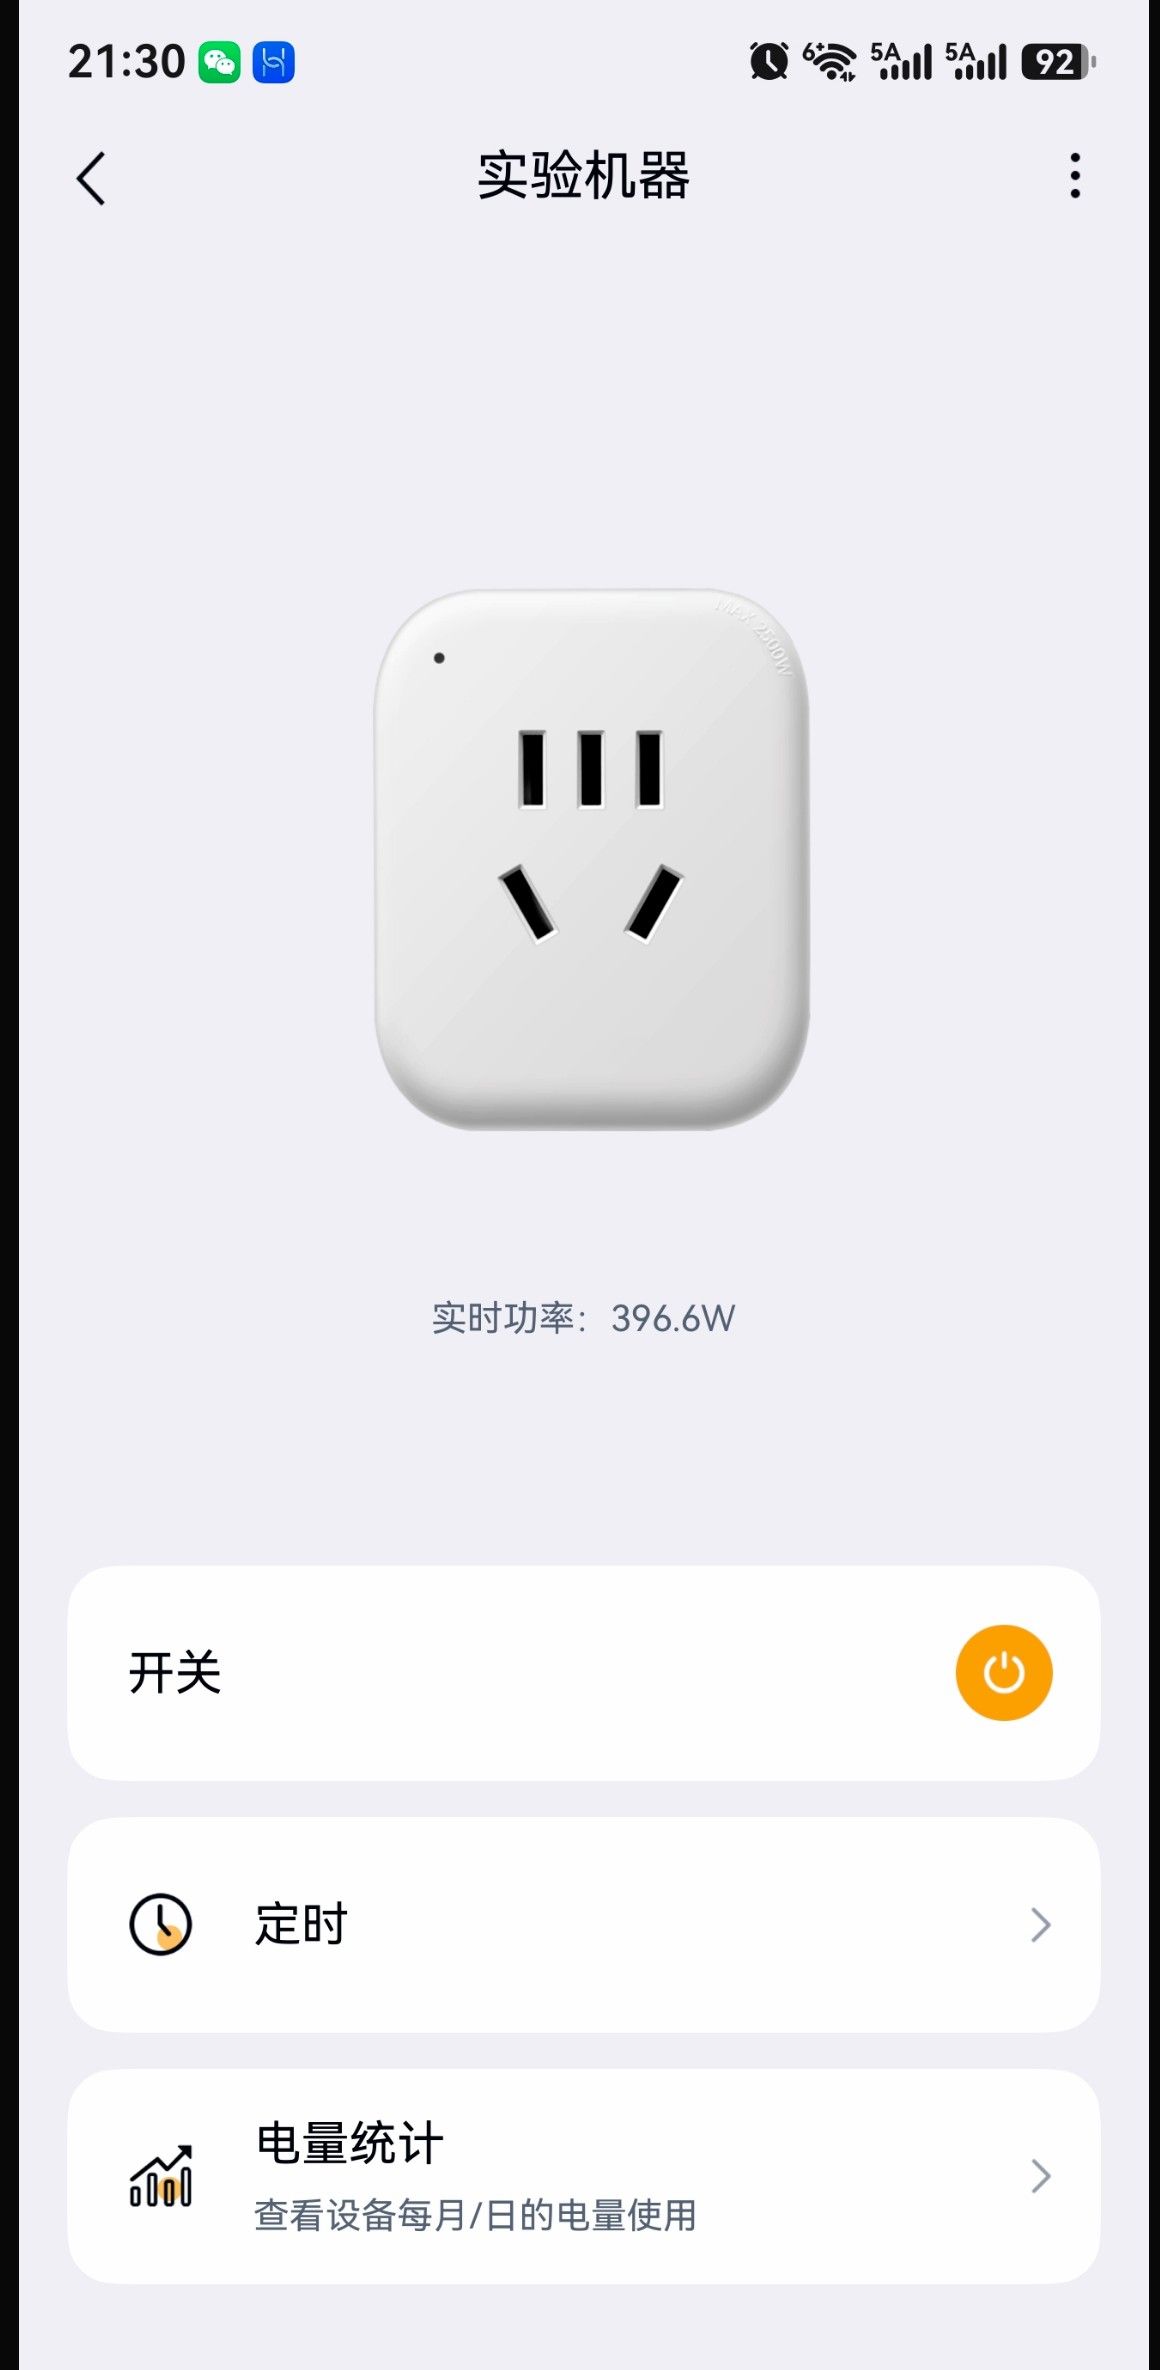
状态 GPU CPU 封装 主板+内存+2×NVMe+网卡+风扇 电源转换损耗(≈88%) 整机估算(墙端) 空闲(服务在跑、无请求) 12 W 21 W ≈28 W ≈8 W ≈70–90 W 推理满载 299 W 47 W ≈35 W ≈42 W ≈420–450 W 短时峰值 354 W 69 W ≈35 W ≈50 W ≈500 W 能耗折算(供参考)
场景 日耗电 年耗电 24 h 空闲 ≈1.9 kWh ≈700 kWh 24 h 满载 ≈10.4 kWh ≈3,800 kWh 实际(假设每日 4 h 满载 + 20 h 空闲) ≈3.6 kWh ≈1,320 kWh 按 0.6 元/kWh 估算,实际混合负载约 2.2 元/天、约 790 元/年。
5.4 散热评价
优点
- GPU 空闲时风扇停在 891 rpm、12 W,功耗控制优秀。
- 满载时核心频率稳定在 2.7–3.1 GHz 且未触发降频,说明散热能力足以支撑 300 W 持续功耗。
- CPU 与 NVMe 温度都很舒服(CPU 51 °C、NVMe ≤52 °C),机箱风道通畅。
需关注
- 显存温度(92 °C 稳态 / 94 °C 峰值)高于 GPU 核心结温(89 °C 稳态),这是典型的风冷 GDDR6 特征,也是本机最热的部件。持续高负载下会加速显存老化。
- 结温峰值 97 °C —— 虽然未触发降频(通常 AMD 结温降频阈值在 100 °C 以上),但已接近"舒适区"边界。
- 5 分钟压测尚不足以验证夏季高温环境或连续数小时满载下的表现;建议补做 1 小时以上满载测试。
散热提升建议(按性价比排序)
- 提高机箱进风量(前面板风扇),或改善 GPU 与机箱底板间距 —— 显存温度对风量最敏感。
- 使用
rocm-smi --setperflevel或pp_power_profile_mode切换到 COMPUTE 档(当前为BOOTUP_DEFAULT),可能获得更激进的风扇曲线(但会增加功耗/噪声)。 - 若可接受约 5–8% 的性能损失,把功耗墙从 300 W 下调到 250–270 W(
rocm-smi --setpoweroverdrive),可显著降低显存温度。 - 夏季前重做一次散热器硅脂/导热垫维护。
六、推理性能评测
所有测试均由局域网客户端
192.168.67.203发起,目标192.168.67.202:8080,属于真实端到端性能(含网络开销)。
6.1 单流生成速度(Decode)
生成长度 第 1 次 第 2 次 第 3 次 中位 标准差 32 token 44.42 44.63 44.67 44.63 t/s 0.11 128 token 52.10 51.89 51.89 51.89 t/s 0.10 512 token 52.71 52.55 52.40 52.55 t/s 0.13 1024 token 52.76 52.74 52.73 52.74 t/s 0.01 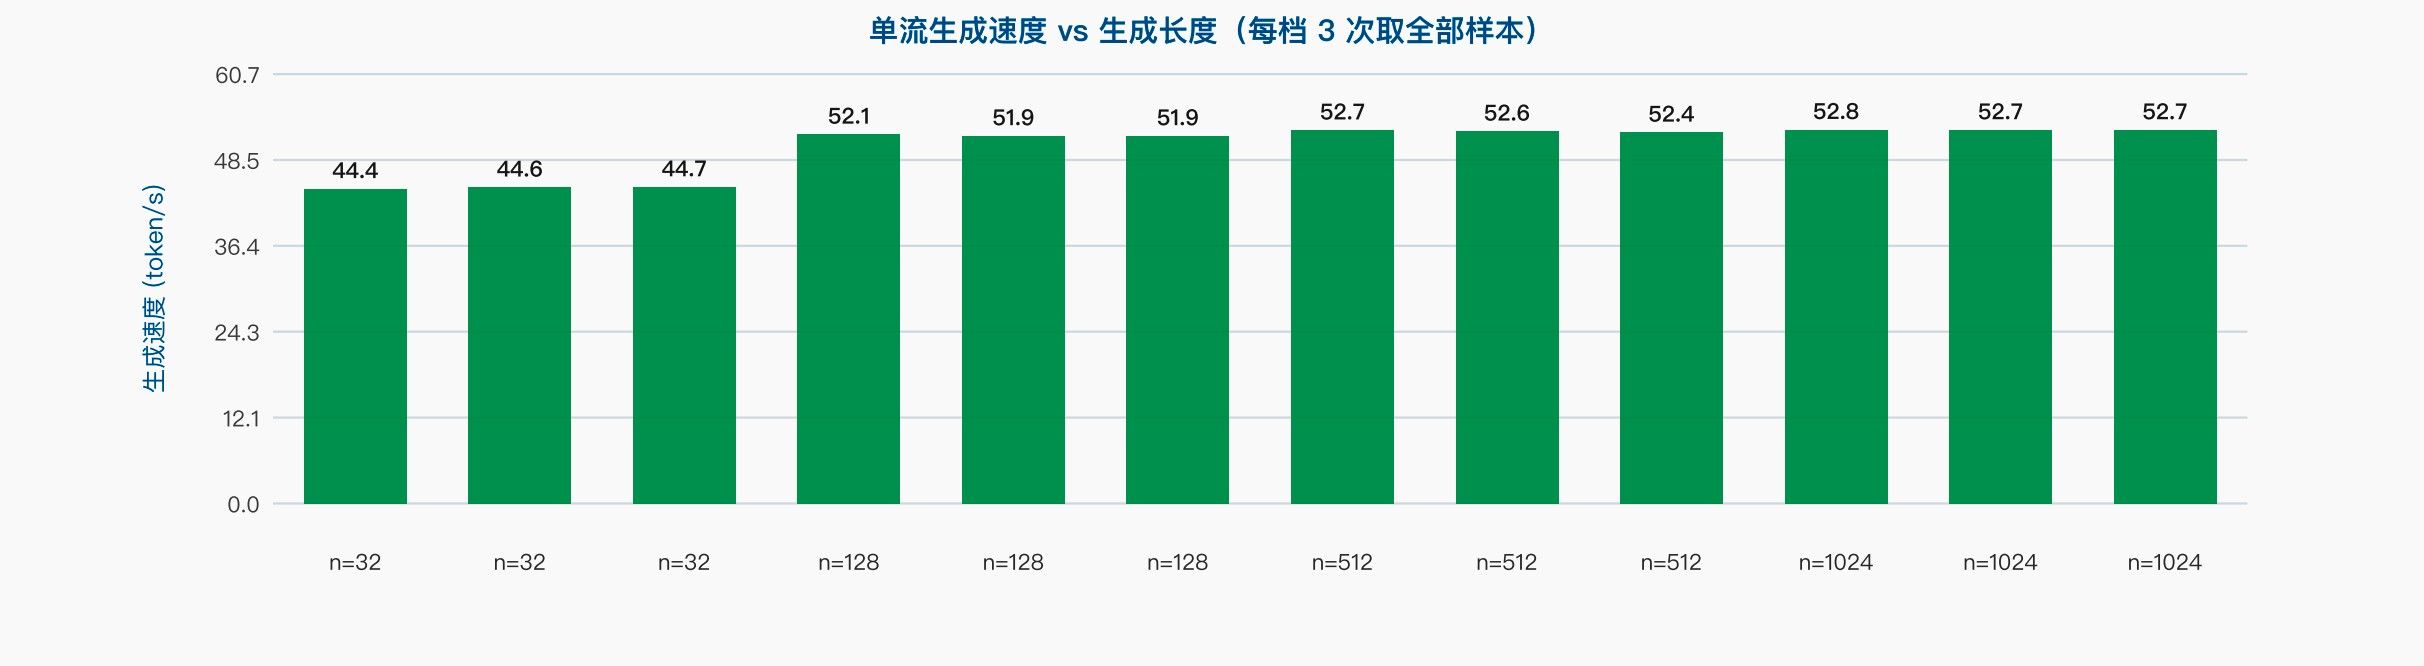
结论:
- 稳态生成速度 52.7 token/s,等价于 每 token 19.0 ms。
- 32 token 档偏低(44.6 t/s)是因为包含了首个 token 的计算与调度开销;长度 ≥128 token 后即进入稳态。
- 稳定性极佳:1024 token 档三次测量标准差仅 0.01 t/s(0.02%)。
- 该成绩显著受益于 MTP 投机解码(日志显示 draft 接受率可达 0.99,
mean len = 2.99)。
注意长上下文衰减:服务自身日志显示,当上下文达到 3 万 token 时生成速度降至 30–43 t/s(例如
tg_3s = 29.63 t/s、draft acceptance = 0.60)。上下文越长,MTP 接受率越低、速度越慢,这是本地大模型推理的普遍规律。
6.2 首 token 时延与流式输出
指标 实测 TTFT 中位(前缀已缓存) 145 ms TTFT 均值 / p90 199 ms / 304 ms(首次请求含冷启动) 客户端测流式吞吐 52.15 t/s(5 次,标准差 0.05) 服务端计时吞吐 51.87 – 52.02 t/s(与客户端一致,说明网络无损耗) 平均 token 间隔(ITL) 19.2 ms ITL 中位 / p90 0.02 ms / 55.5 ms(TCP 层聚合导致的分块到达) 256 token 总耗时 ≈5.05 s 说明:ITL 中位数 0.02 ms 而 p90 为 55 ms,是 llama.cpp 逐 token 推送被 TCP Nagle/缓冲合并的结果——客户端会以约 55 ms 的批次收到 token,但总吞吐完全一致(52.15 vs 51.9 t/s)。对于聊天类应用,体验等同于流式输出;对逐 token 实时性要求极高的场景(如语音),建议在服务端或客户端做
TCP_NODELAY/缓冲调优。
6.3 长上下文预填充能力(关键短板)
输入 token 数 预填充速度 实际耗时 相对峰值 256 669 t/s 0.38 s 70% 1,024 880 t/s 1.16 s 93% 4,096 949 t/s(峰值) 4.31 s 100% 16,384 809 t/s 20.3 s 85% 32,768 660 t/s 49.6 s 70% 65,536 480 t/s 136.6 s 51% 98,304 376 t/s 261.2 s(4 分 21 秒) 40% 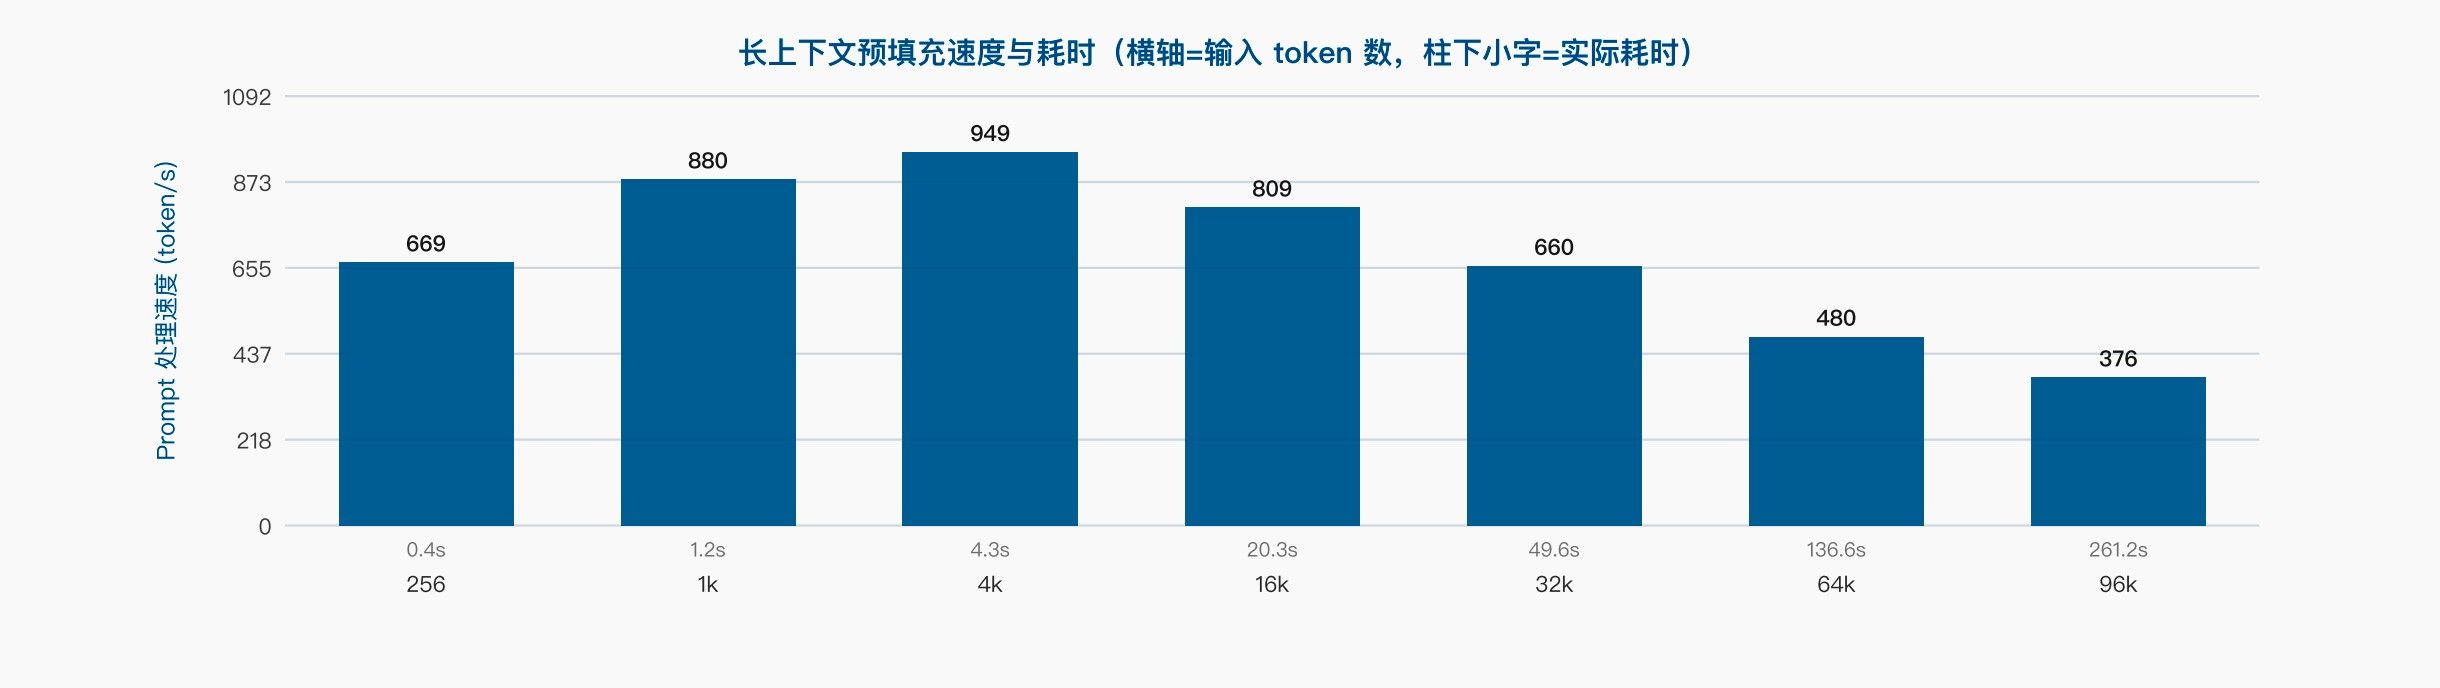
结论:
- 预填充速度在 4K token 时达到峰值 949 t/s,随后因注意力计算量随长度平方增长而持续下降。
- 98K token 输入需要 4 分 21 秒;按实测速率外推,占满 128K 上下文约需 5.8 分钟。
- 这是"单 slot 串行"架构下最致命的问题:一个长文档分析请求会让整个服务停摆数分钟。
- 横向参考:
n_ctx=131072的 128K 上下文能力确实可用(无截断、无 OOM),但代价是分钟级的首 token 等待。
6.4 前缀缓存(Prompt Cache)有效性
场景 处理 token 命中缓存 预填充速度 耗时 3,400 token 首次( cache_prompt=false)3,400 0 960 t/s 3.55 s 同一 prompt 再来一次( cache_prompt=true)4 3,396 — 0.24 s 同一 prompt 第三次 4 3,396 — 0.14 s 多轮对话追加 20 token 340 3,400 600 t/s 0.57 s 缓存命中带来约 15 倍加速(3.55 s → 0.24 s)。 这意味着:
- 客户端必须保证对话前缀逐字节不变,否则缓存全部失效;
- 多轮对话的追加式调用几乎无预填充开销;
- 但缓存容量有限——日志显示服务会淘汰旧条目(曾淘汰一条 6.2 GiB 的长上下文缓存),因此多客户端交替使用长上下文时缓存会互相冲刷。
6.5 并发能力(最重要的架构短板,双卡优势大)
并发压测:
-np 1下请求被严格串行化并发客户端 总耗时 完成/失败 聚合吞吐 单请求速度 最后一个请求的等待时间 1 2.70 s 1 / 0 47.5 t/s 51.4 t/s 2.70 s 2 5.36 s 2 / 0 47.8 t/s 51.4 t/s 5.36 s 4 10.44 s 4 / 0 49.1 t/s 51.5 t/s 10.44 s 8 20.86 s 8 / 0 49.1 t/s 51.5 t/s 20.86 s 16 41.79 s 16 / 0 49.0 t/s 51.4 t/s 41.79 s 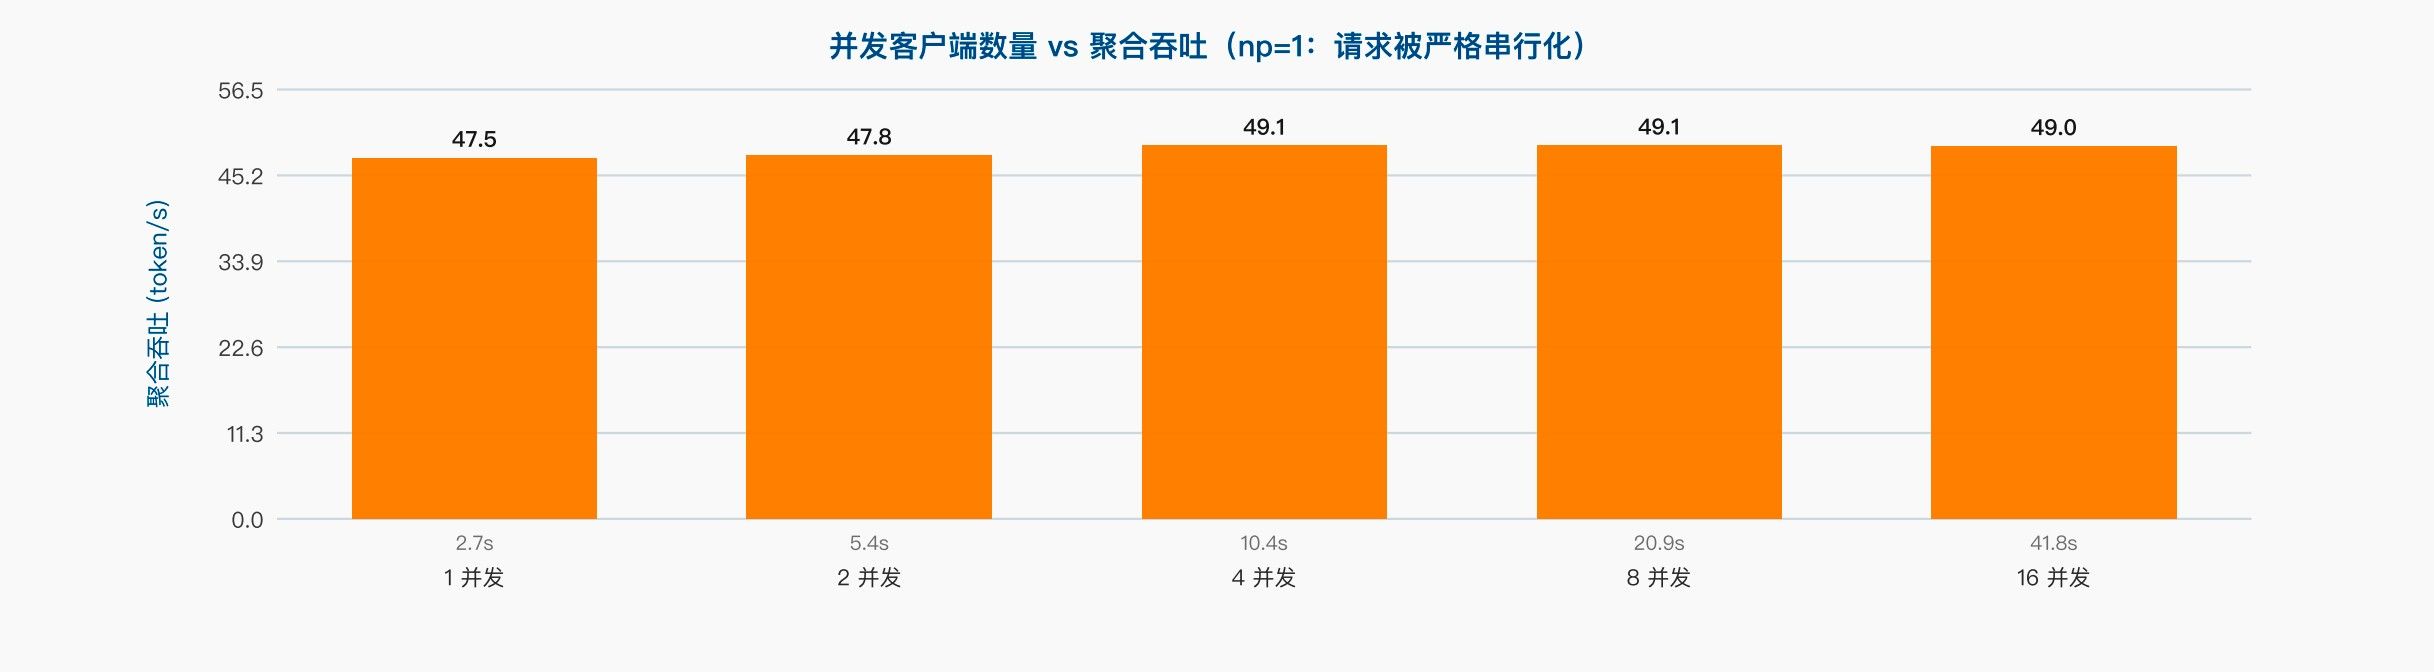
结论:并发 1 → 16,聚合吞吐几乎不变(47.5 → 49.0 t/s),总耗时与并发数严格成正比。 说明完全没有并行服务能力,每个请求排队串行执行。增加客户端只会等比拉长所有人的等待时间。
公平性实测:小请求被长请求"饿死"
场景 请求内容 耗时 单独执行 10 token 短请求 0.40 s 单独执行 16,200 token 长请求 19.99 s 并发(长请求先发 1 s) 10 token 短请求 19.78 s 放大倍数 49 × 一个正常情况下 0.4 秒完成的问候语请求,因为前面排队了一个 16K token 的预填充任务,实际等待了 19.8 秒。这就是
-np 1的直接后果。对"统一可用性"的影响(可用性长跑实测)
在评测窗口内以 2 秒间隔持续探测,共 365 次:
探测类型 成功 失败 说明 GET /health166 / 166(100%) 0 始终 <8 ms 返回 200 GET /v1/models166 / 166(100%) 0 始终快速返回 POST /completion(4 token 生成)30 / 33(91%) 3 次超时(120 s) 全部发生在长上下文预填充期间 /health是"进程活着"探针,不是"服务可用"探针。 在 3 次小请求超时 120 秒的同时,/health依然 100% 返回 200。任何基于/health做的负载均衡或健康检查都会失效。
6.6 多模态、工具调用与结构化输出
能力 实测结果 评价 视觉多模态 一张 1000×700 JPEG 编码后触发 707 prompt token,预填充 628 t/s,6.64 s 内完成 200 token 描述 功能可用,识别准确度差(见下) 图片识别准确度 把 AMD Radeon AI PRO R9700 识别为"华硕 TUF 系列 GeForce RTX 3060 Ti",外观描述错误但格式规范 差(模型能力问题,非部署问题) 工具调用 Tool Calling 正确返回 get_weather({"city":"北京"}),格式完全符合 OpenAI 规范优 严格 JSON Schema response_format={"type":"json_schema",...}输出{"city":"北京","population":21893092},结构与类型(integer)均正确优 response_format={"type":"json_object"}未强制生效:模型输出被包裹在 ```json代码块中,json.loads失败需注意 思维链(reasoning) reasoning_content正确分离返回(215 字符),最终答案正确(9.9 > 9.11 并解释了版本号混淆)优 关闭思维链 chat_template_kwargs={"enable_thinking": false}生效,22 token 直出答案,0.78 s优 服务端日志同时给出的一条重要提示:
Qwen-VL models require at minimum 1024 image tokens to function correctly on grounding tasks—— 建议按官方建议增加--image-min-tokens 1024参数以改善图像定位任务准确度。
6.7 API 兼容性矩阵
端点 方法 状态 说明 /healthGET 200 {"status":"ok"},1 ms/v1/modelsGET 200 返回 qwen3.8及完整 meta(n_params、n_ctx、ftype、size)/propsGET 200 返回默认采样参数、 total_slots=1、模态能力/slotsGET 200 返回 slot 状态、剩余 token、speculative 标记 /v1/chat/completionsPOST 200 OpenAI 兼容,支持流式、tools、response_format、reasoning /v1/completionsPOST 200 OpenAI 兼容补全 /completionPOST 200 原生端点,返回详细 timings(推荐用于压测) /tokenize//detokenizePOST 200 分词/反分词正常 /apply-templatePOST 200 / 400 传入完整 messages时 200 并返回渲染后 prompt;缺参时 400(正常)/infillPOST 500 缺 input_suffix时返回 500 而非 400 —— API 规范瑕疵/metricsGET 501 Start it with '--metrics'—— 监控指标未开启/v1/embeddingsPOST 501 Start it with '--embeddings'—— 无向量能力/ui与/GET 404 /props声明"ui": true,但该构建实际未提供 Web UI 端点参数校验行为
测试 结果 评价 model字段填不存在的名字仍然正常返回结果(不校验模型名) 轻微不规范,多模型场景下可能造成误用 n_predict = -5400 Value must be between -1 <= value <= 2147483647正确 缺少 prompt字段400 key 'prompt' not found正确 n_predict = 999999999接受,开始无上限生成 风险:单请求可长时间独占唯一 slot 客户端中途断开 服务端正确取消任务(日志 stop: cancel task)优
七、局域网连接与可用性评测(网络环境2.5G)
7.1 网络时延、抖动与丢包
对两台目标各发送 600 个 ICMP 包(间隔 200 ms,总计 2 分钟):
目标 最小 中位(p50) p90 p99 最大 均值 标准差 抖动(相邻差均值) 丢包 VM 192.168.67.202 0.108 ms 0.686 ms 1.125 ms 1.320 ms 1.406 ms 0.741 ms 0.283 ms 0.236 ms 0.0% PVE 192.168.67.251 0.152 ms 0.374 ms 0.493 ms 0.625 ms 0.963 ms 0.366 ms 0.109 ms 0.088 ms 0.0% 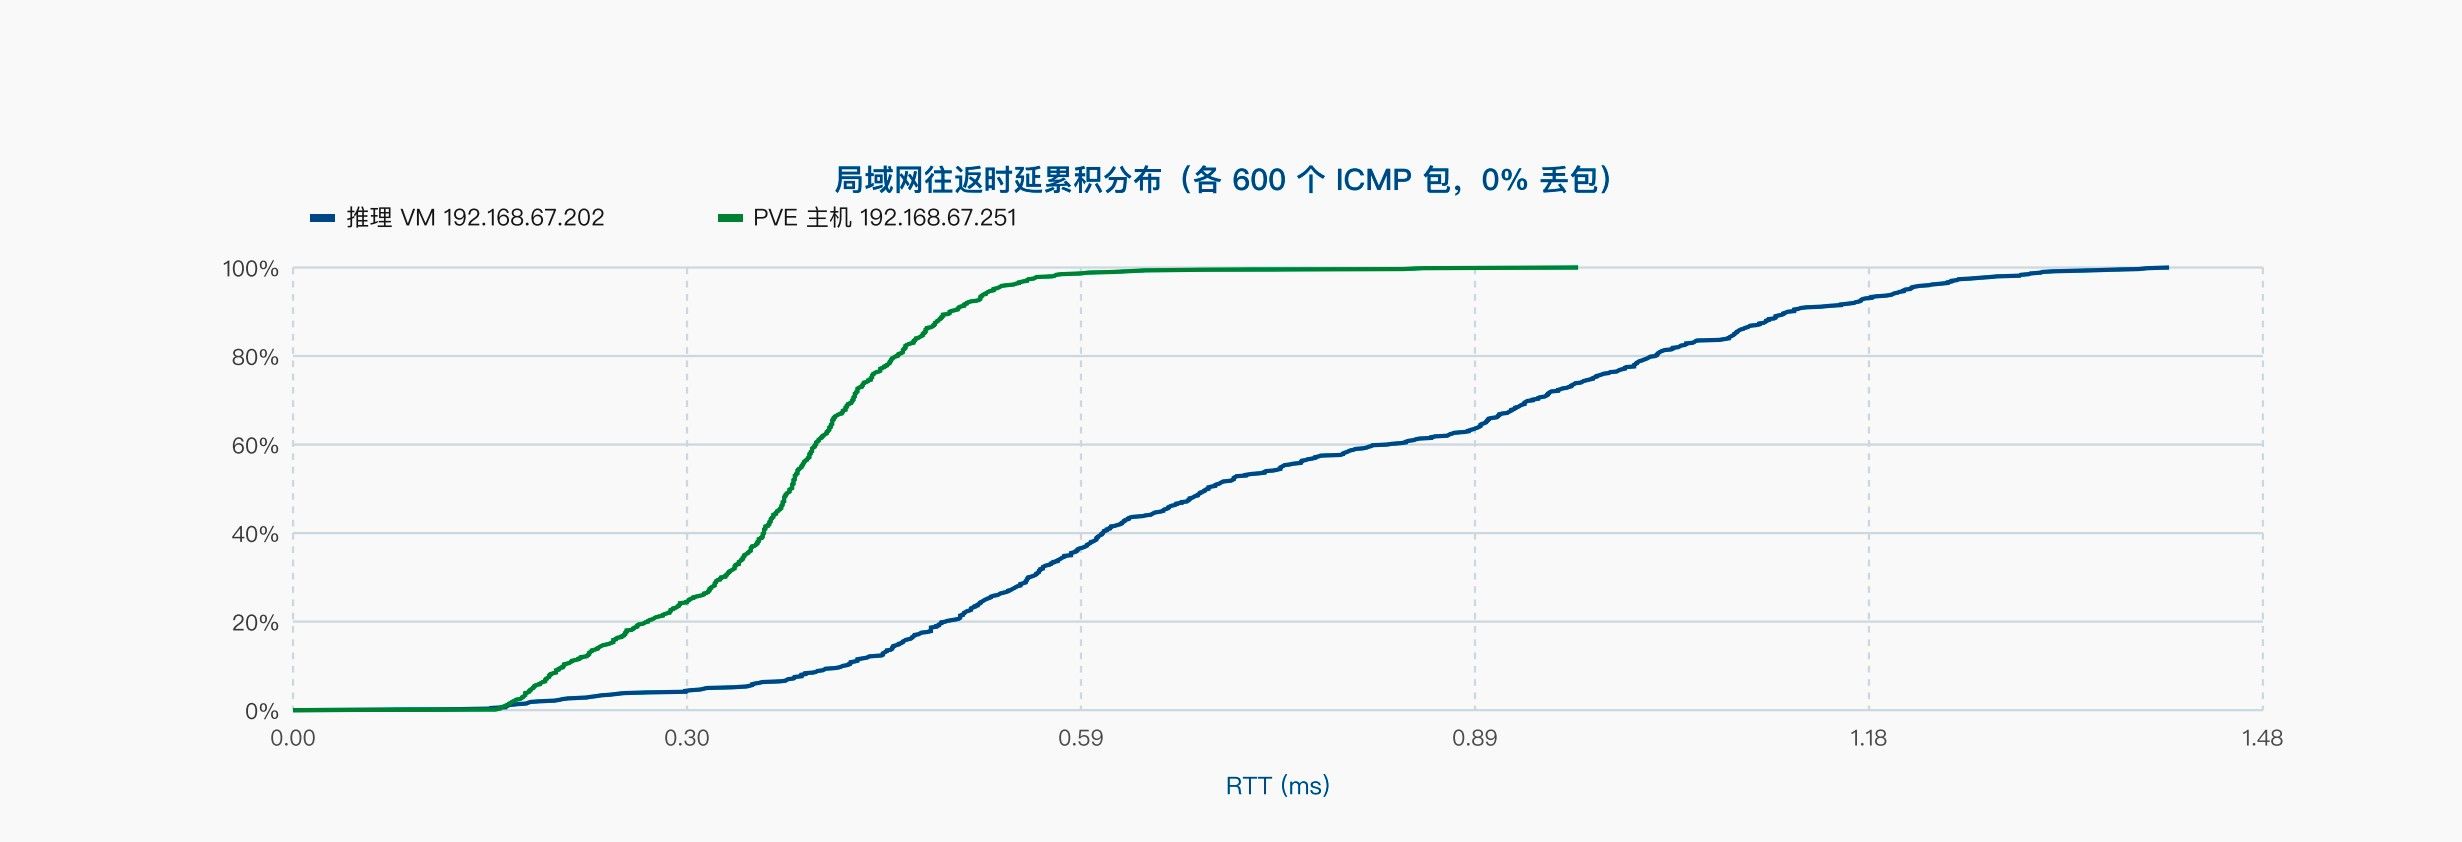
分析
- PVE 主机 p50 0.374 ms,是纯二层交换的理想值。
- 虚拟机 p50 0.686 ms,比主机多 0.31 ms —— 这就是 虚拟网卡(virtio → tap → fwbr → vmbr0)的固定开销,表现为一个约 0.3 ms 的双峰分布(38 个样本落在 <0.25 ms,说明部分包走了更短路径)。
- 零丢包、最大 1.4 ms,对 LLM 推理(单 token 19 ms)而言,网络时延完全不是瓶颈(占比 <4%)。
vmbr0累计 TX dropped 仅 4 个包,可忽略。
HTTP API 层时延(100 次
/health请求)最小 中位 p90 最大 均值 0.52 ms 0.80 ms 1.24 ms 7.38 ms 0.90 ms 7.2 局域网吞吐
使用自建 HTTP blob 服务端进行 1 GiB 定长传输,两个方向各 3 次:
方向 第 1 次 第 2 次 第 3 次 等效带宽 达成率 Mac → VM(VM 接收) 292.99 MB/s 292.68 MB/s 293.06 MB/s 2.344 Gbit/s 93.8%(2.5GbE 理论 2.5 Gbit/s) VM → Mac(VM 发送) 293.28 MB/s 293.70 MB/s 293.01 MB/s 2.344 Gbit/s 93.8% 结论:网络链路完全不是瓶颈。 虚拟机 virtio 网卡(单队列、TSO/GSO/GRO 全开)可以打满 2.5GbE 线速,且收发对称。对推理服务而言,即使每 token 都带 100 字节负载,52 t/s 也仅需 5 KB/s —— 带宽余量有 4 个数量级。
MTU 探测
目标 payload 1472(MTU 1500) payload 4000 payload 8972(巨帧 MTU 9000) VM 通过(不分片) 失败 失败 PVE 通过 — 失败 全链路 MTU = 1500,未启用巨帧。对 LLM 推理无影响,无需调整。
7.3 可用性长跑与故障行为
场景 行为 评价 服务空闲 /health0.8 ms,/slots正常优 单流满载 5 分钟 78 请求 0 失败, /health始终可用优 长上下文预填充期间 小请求排队超时(120 s 内未返回); /health仍 200差 客户端中途断开 服务端取消任务,资源正确释放 优 超大 n_predict请求正常接受并持续生成(可被滥用为拒绝服务) 风险 服务重启后恢复 模型加载 8.2 秒 完成并开始监听 优 主机重启后自恢复 onboot: 1+enabled,自动启动,NRestarts=0优 实测可用性指标(评测窗口)
指标 值 /health可用率100.0%(166/166) /v1/models可用率100.0%(166/166) 真实推理请求成功率 90.9%(30/33,3 次超时全部由槽位排队引起) HTTP 错误率(4xx/5xx 主动返回) 0%
八、补图
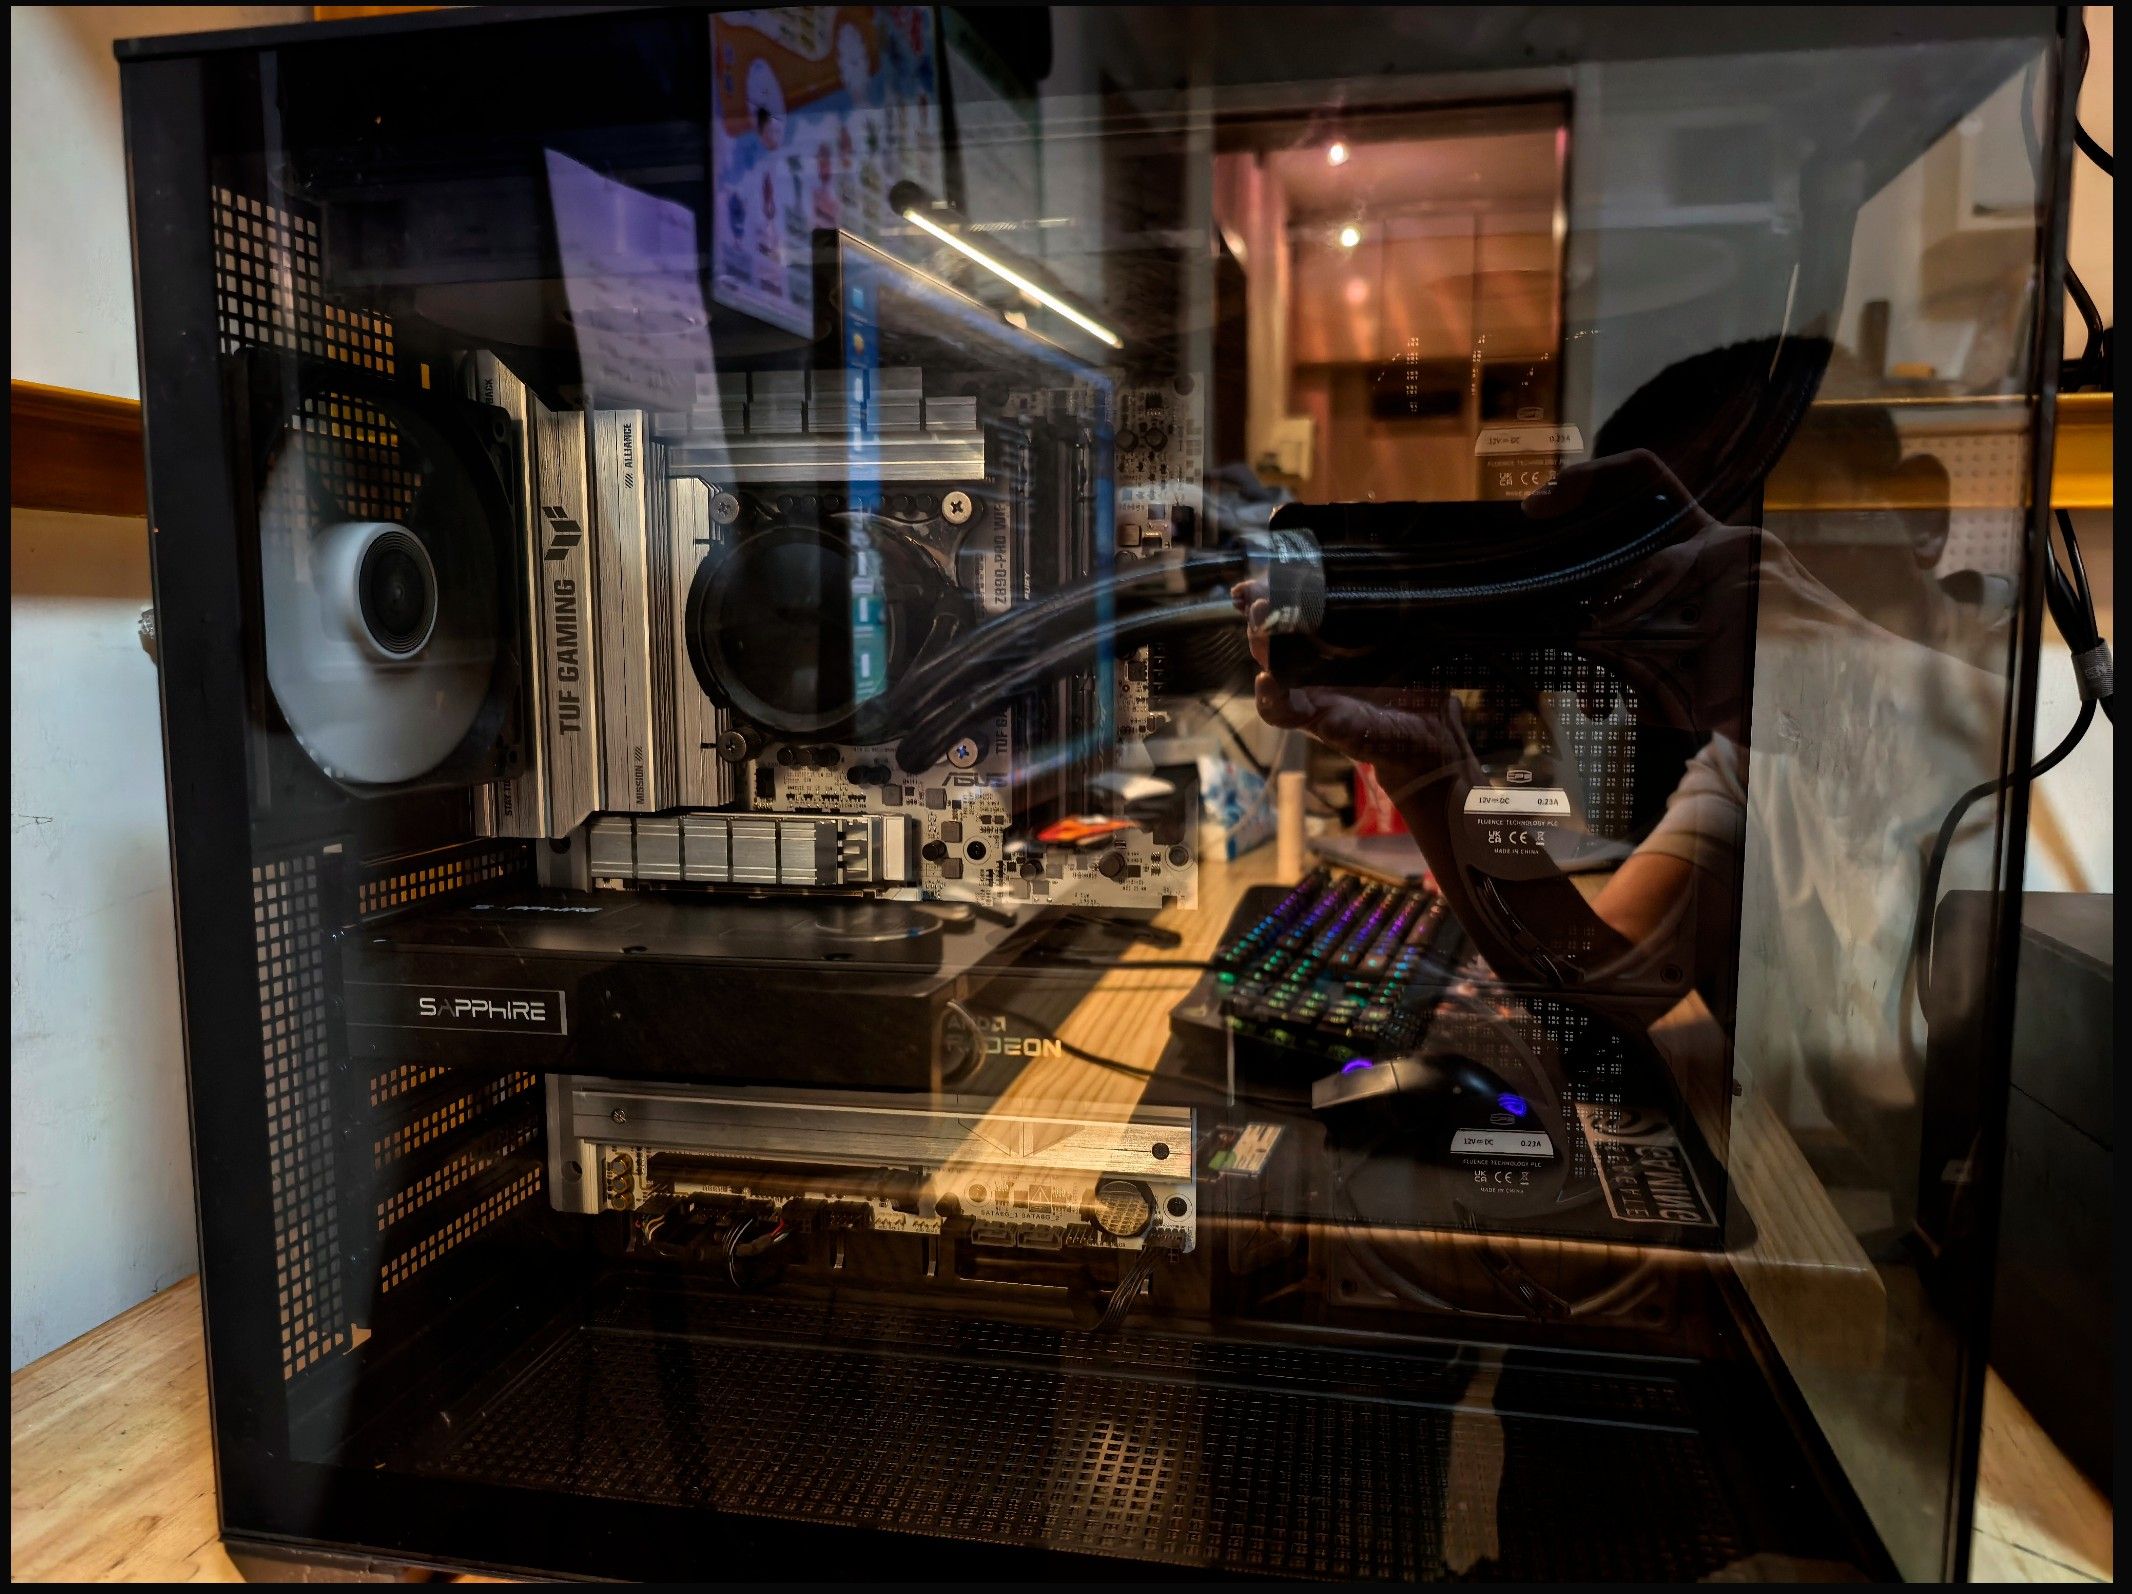
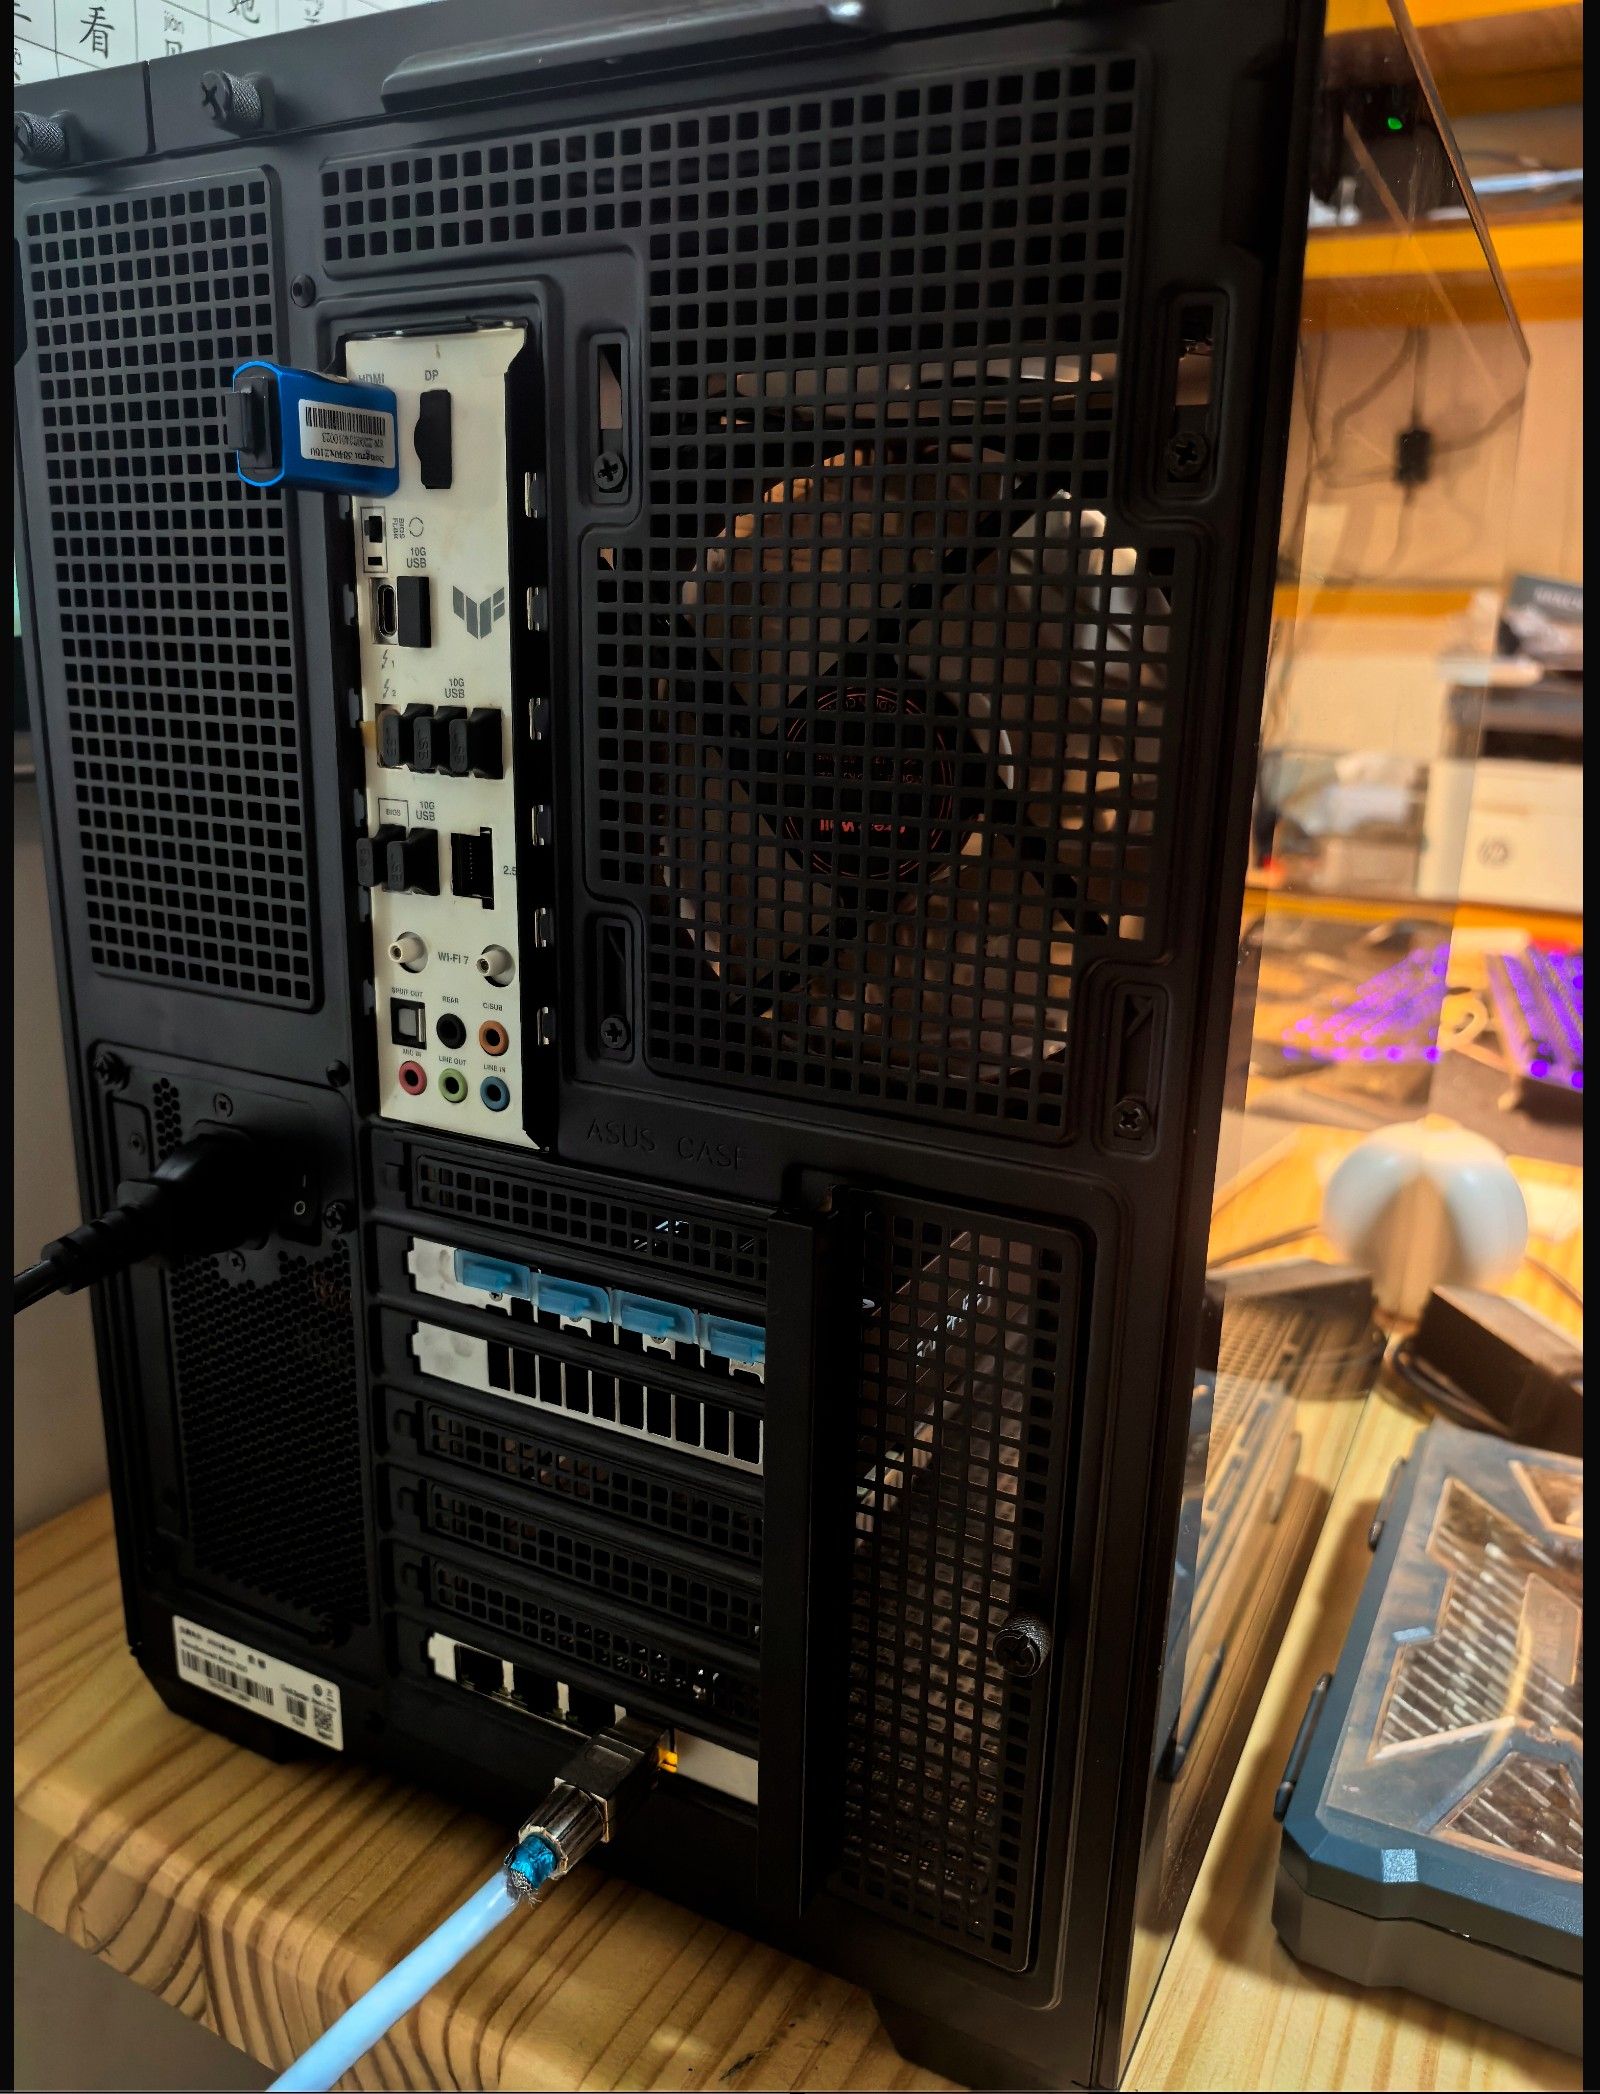
8.1 主机图片(闷罐)
8.2 待机功率
8.3 满载功率
九、实测结束
 ALL IN ONE · ALL IN BOOM

 一台机器,全部搞定 —— 然后,炸裂全场!
 ALL IN ONE —— 一机全能
 ️ 虚拟化 (PVE)

 AI 推理 (llama.cpp)
 GPU 直通 (R9700)
 网络服务
 存储中心
一台机器 = 服务器 + AI 工作站 + 存储 + 网关 All in One,All the Power.

-