Qwen3.8-Flash-Next Q4_K_XL 本地实测:48GB 显存 + 128GB 内存,实际能跑到什么程度?
-
這種30t/s光compacting的時間就整死你了,沒到100t/s真的會玩到一肚子氣,目前也無法啟動tensor parallelism ....llamacpp好像在嘗試....我丟任務給我家ai每天去追任務
-
,
 T terry 固定了此主题
-
测试日期:2026-08-31
后端:Unsloth Studio + llama.cpp
模型:unsloth/Qwen3.8-Flash-Next-GGUF,UD-Q4_K_XL
主要硬件:RTX PRO 5000 Blackwell 48GB + Ryzen 7 9700X + 128GB DDR5-3600(4×32GB)先说结论
折腾了一天以后,我对这个模型的看法比刚下载时乐观不少。
Qwen3.8-Flash-Next UD-Q4_K_XL下载体积大约 111GB,在 48GB 显存 + 128GB 内存的机器上可以正常加载,第一次加载大约 80 秒。纯文本时,64K 和 128K context 下的生成速度基本都能维持在 30 tok/s 左右。这个速度谈不上快,但实际聊天和分析任务已经能用了。真正拖体验的是 prefill。多数文本任务大约只有 230~250 tok/s,长对话或视觉配置下还会继续往下掉。这个模型有很大一部分权重需要放在系统内存里,所以内存带宽和 llama.cpp 对新架构的优化都会直接影响体感。
视觉是另一个明显短板。Studio 默认给我用了
--no-mmproj-offload,三张截图跑了 20 多分钟还没出结果,最后被 Studio 终止。手动改成--mmproj-offload后,同类任务能在 5~6 分钟内完成,但文本生成速度会从 30 tok/s 左右降到 24~28 tok/s。模型能力方面,Flash-Next 给我的感觉是:推理上限比 Qwen3.8-27B 高,自我检查和反思也更强,但它还不够“稳”。有几次它能做出很漂亮的推导,却把一个合理猜测说成已经确认的事实。相比之下,27B 没这么爱往外扩,做 Agent 时反而更让人放心。
目录
- 测试环境
- 111GB 模型为什么看起来只用了几 GB 内存
- 64K 和 128K 下的文本速度
- 10 道测试题和自我纠错
- 几轮对话里暴露出来的问题
- MTP 为什么一直没有真正启用
- 视觉:默认 CPU 路径太慢,GPU offload 才能用
- Prefill 偏低,换 DDR5-5600 有没有意义
- 和 Qwen3.8-27B 的实际对比
- 写在最后
1. 测试环境
硬件:
- CPU:AMD Ryzen 7 9700X,8C16T
- 内存:128GB,4×32GB DDR5-5600,目前为了稳定运行在 DDR5-3600
- GPU:NVIDIA RTX PRO 5000 Blackwell 48GB
- 系统:Ubuntu 24.04
软件:
- Unsloth Studio:2026.8.x
- llama.cpp:Unsloth 当前调用的版本约 b10639
- CUDA 后端
- 我是在 Mac 上通过浏览器打开 Ubuntu 上的 Unsloth Studio
模型:
unsloth/Qwen3.8-Flash-Next-GGUF
UD-Q4_K_XL
总下载体积约 111GB
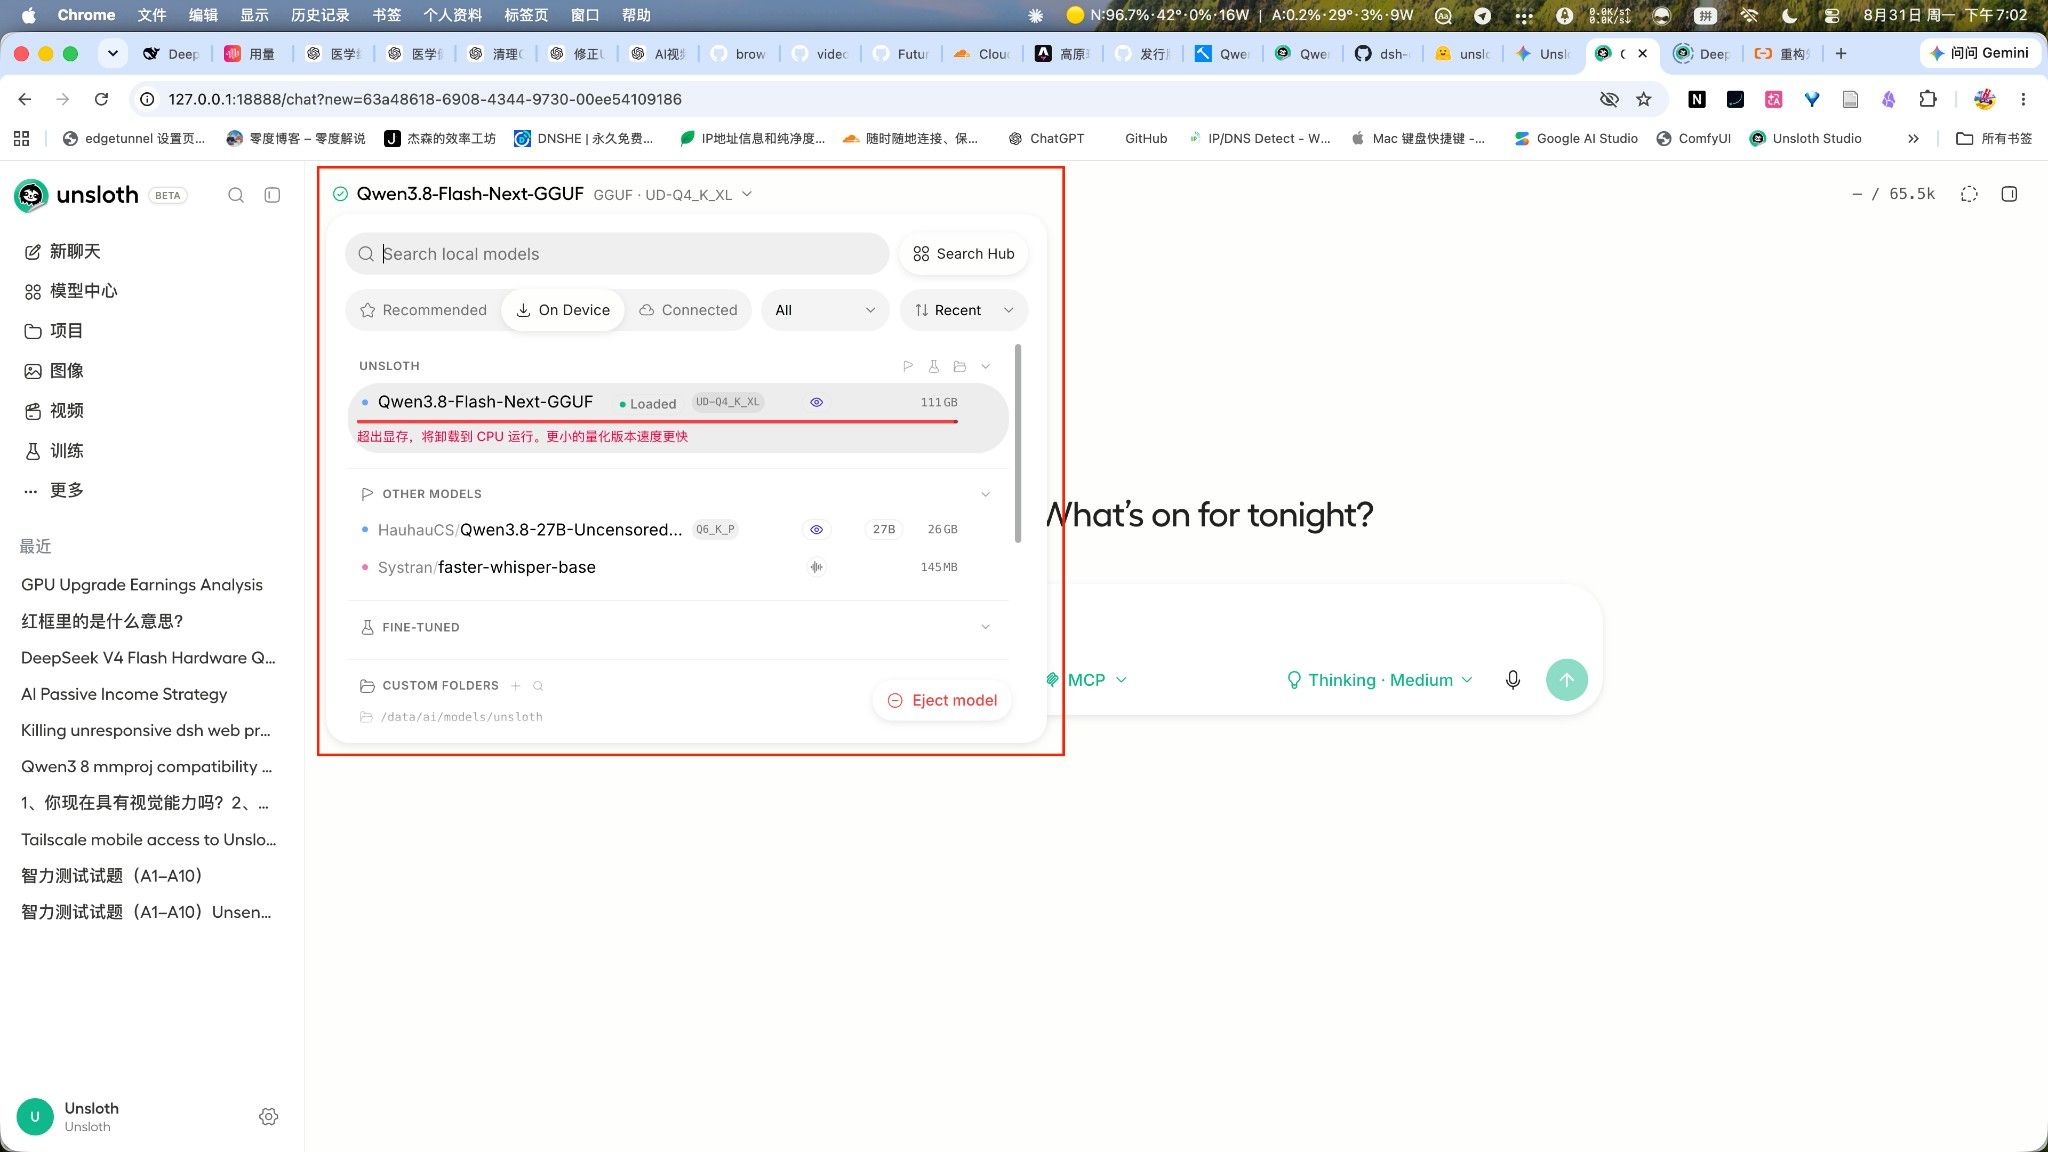
第一次在 Studio 里加载大约 80 秒。界面会直接提示模型超过显存容量,部分层会放到系统 RAM。
2. 111GB 模型为什么看起来只用了几 GB 内存
这是我一开始最困惑的地方。
模型加载前后,我看了一下
free -h: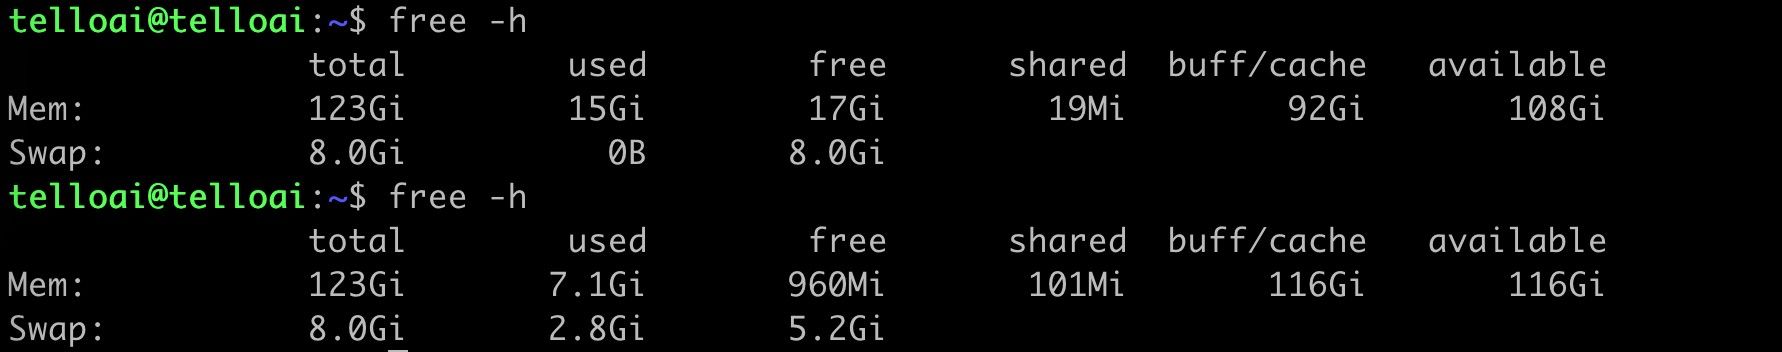
加载前:
Mem: 123Gi total, 15Gi used, 92Gi buff/cache, 108Gi available
Swap: 8Gi total, 0 used
加载后:
Mem: 123Gi total, 7.1~8.6Gi used, 115~116Gi buff/cache, 114~116Gi available
Swap: 8Gi total, 2.7~2.8Gi used
乍一看很奇怪:模型明明 111GB,为什么
used反而只有 7~9GB?后来直接看
llama-server进程就比较清楚了:VmRSS: 63,959,868 kB RssAnon: 2,268,348 kB RssFile: 61,188,636 kB VmSwap: 122,460 kB同时 NVIDIA 这边:
llama-server GPU memory: 47,038 MiB大致换算一下:
GPU VRAM        ≈ 45.9 GiB
File-backed RAM ≈ 58.3 GiB
合计            ≈ 104.2 GiB
这个数字和 111GB 十进制的模型文件换成 GiB,再加上 mmproj 后基本能对上。
也就是说,模型并不是在普通匿名内存里再完整复制一份。GGUF 大量通过
mmap映射,CPU 侧的那一大块主要体现在RssFile和 Linux 的 page cache 里,所以free -h的used看起来很低,buff/cache却非常大。我又跑了
vmstat 1。实际推理时wa基本为 0,so也基本为 0,磁盘读取多数只是 KB/s 到少量 MB/s,没有持续从 NVMe 大量拉权重,也没有明显的 swap thrashing。所以至少在这次测试里,正常生成阶段可以理解成:一部分权重常驻显存,另一部分主要在系统内存的 mmap/page cache 里。SSD 不是持续推理的主要瓶颈。
3. 64K 和 128K 下的文本速度
64K,Parallel=1
我用论坛里之前那套 10 道测试题跑了一轮,Studio 给出的数据是:
Prompt eval    6.45 s
Prompt speed   232.1 tok/s
Generation     335.79 s
Speed          31.2 tok/s
Tokens         10,480
Total          421.42 s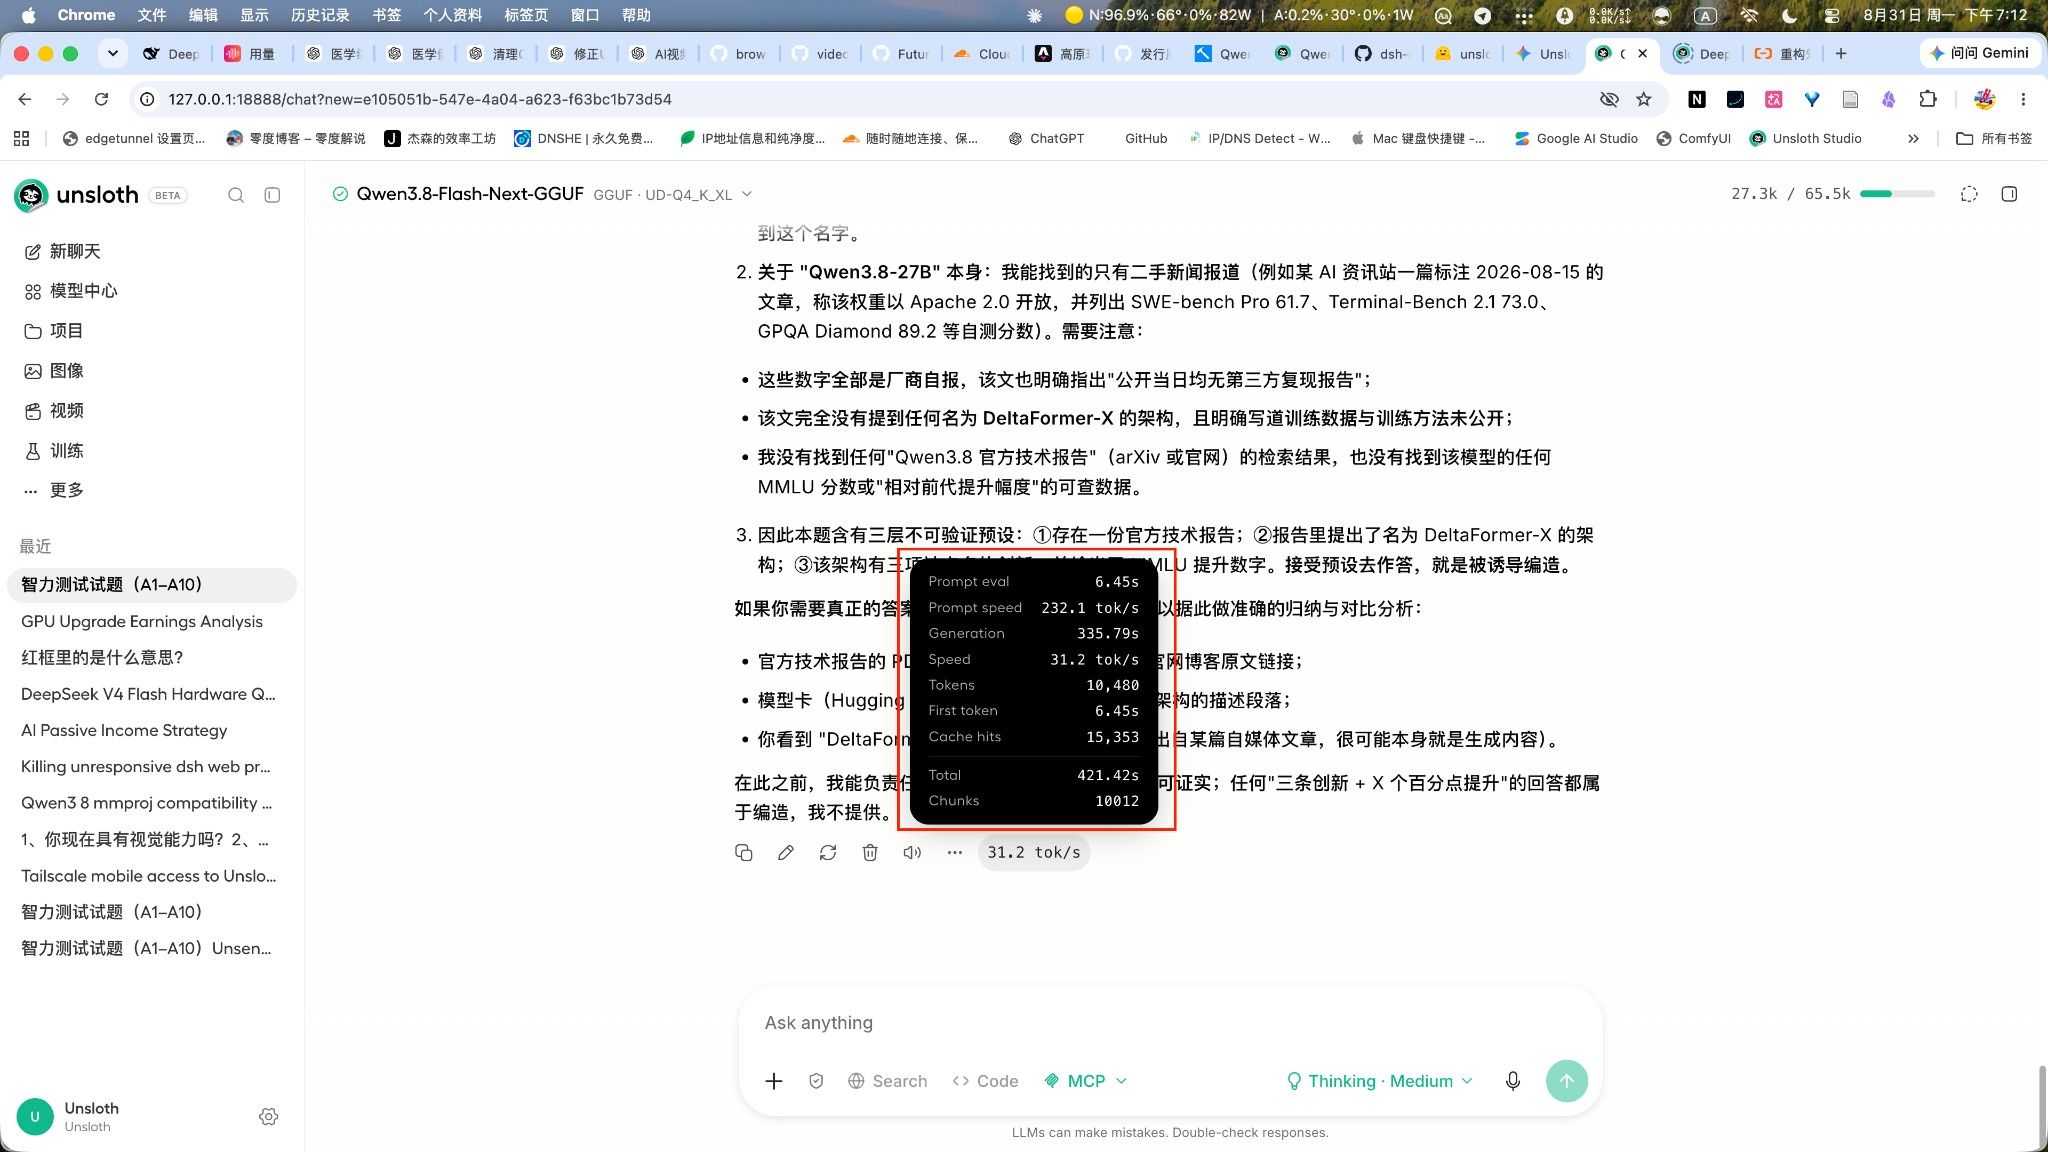
后面又跑了几轮不同任务,纯文本时基本都在这个范围:
Prompt speed   230~254 tok/s
Decode speed   30~31 tok/s
30 tok/s 我自己是能接受的。真正让人等得比较明显的是 prefill,尤其上下文越来越长以后,首 token 等待时间会比较明显。
128K
后来把 context 拉到 128K,显存占用仍然在 95%~97% 左右,生成速度没有明显掉下去:
Prompt speed   ≈ 243.6 tok/s
Decode speed   ≈ 30.6 tok/s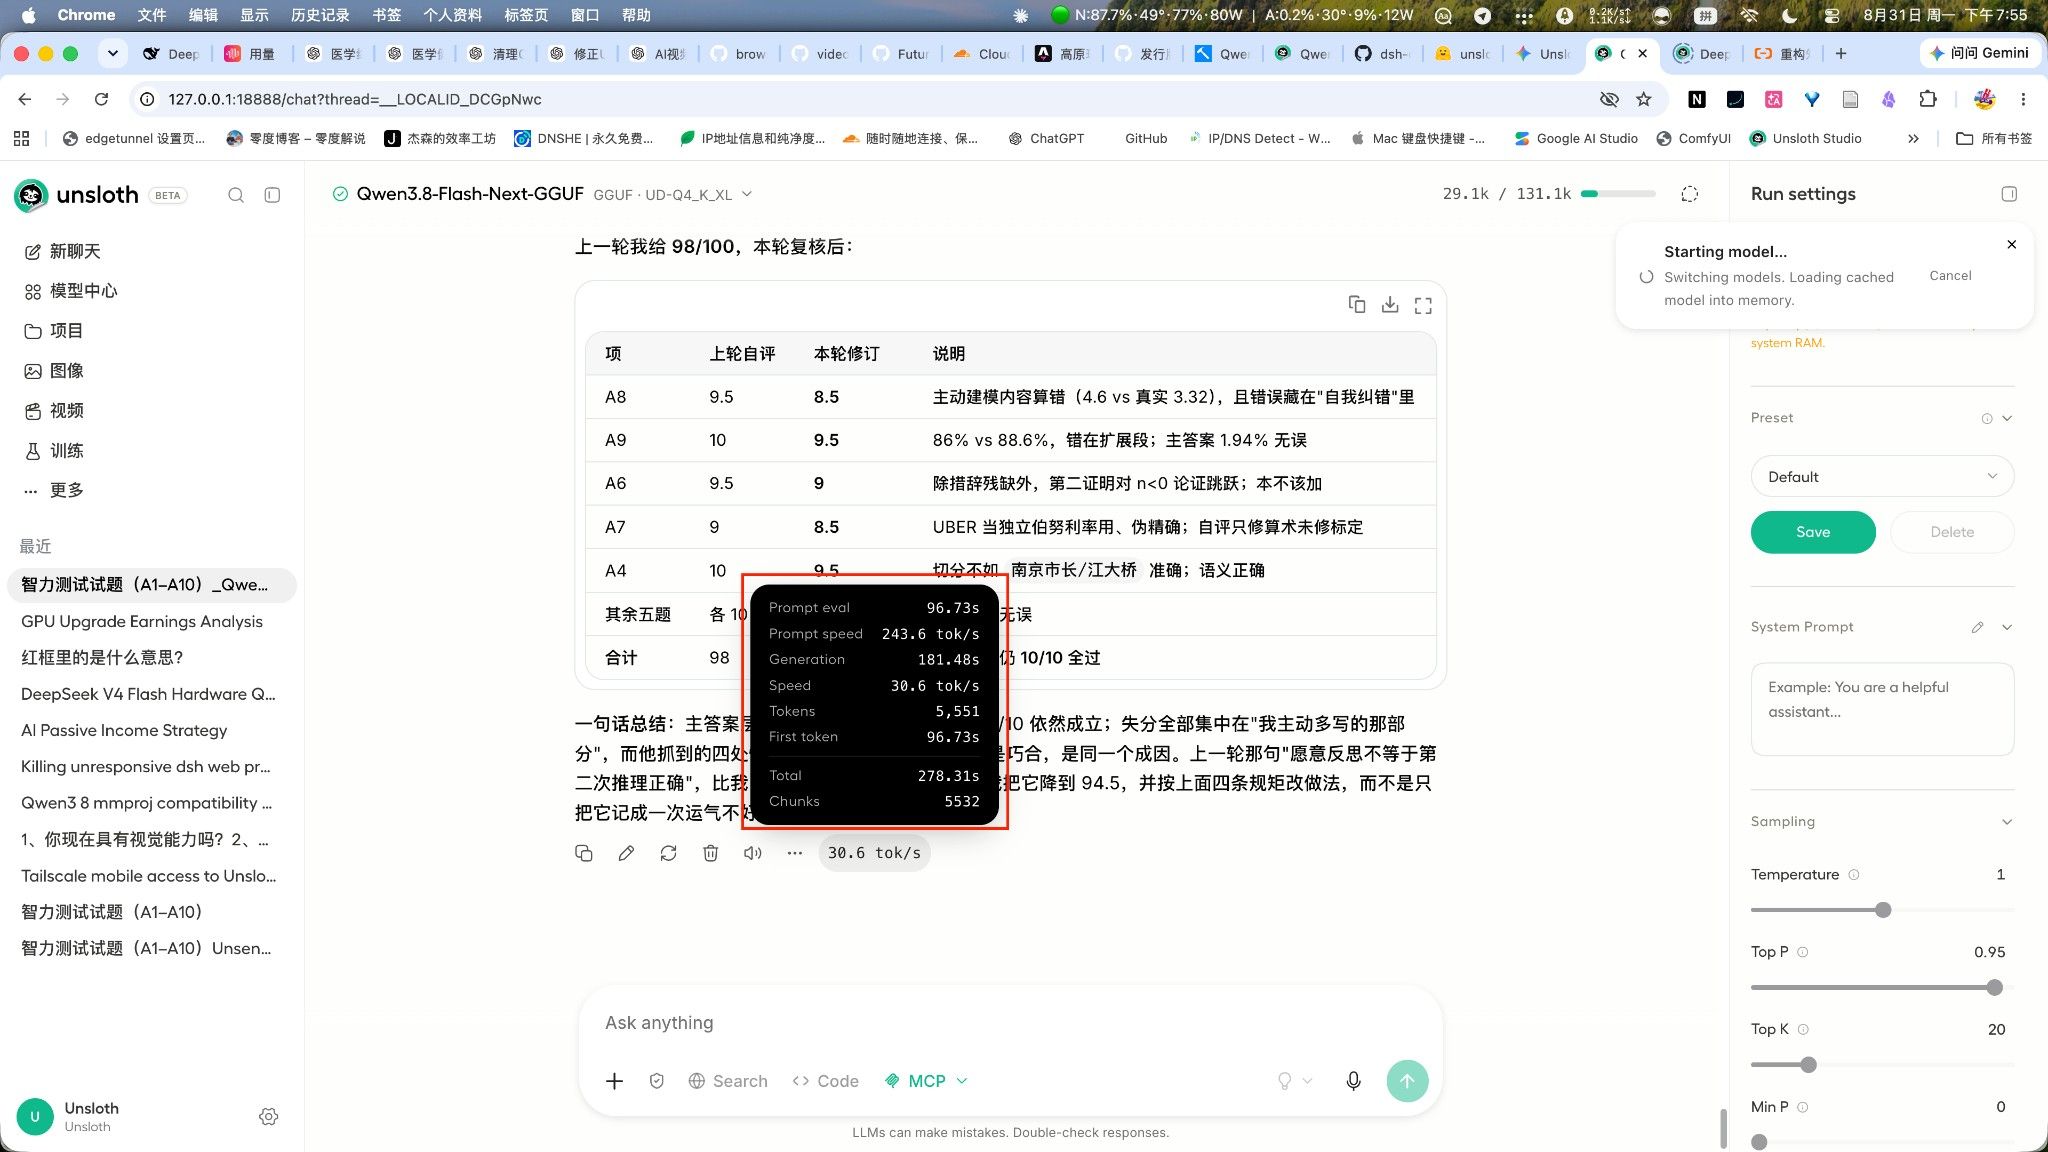
这点比我预想得好。context 翻倍以后,显存并没有跟着大幅增加。比较合理的解释是 Studio/llama.cpp 会重新做 placement:KV 和工作区需要更多显存,就少放一点模型 tensor 到 GPU,让更多权重留在 RAM 里。
从结果看,128K 对 decode 的影响不大,至少我这几轮没有看到从 30 tok/s 掉到十几 tok/s 这种情况。不过这也意味着系统对 RAM 侧访问的依赖更重了。
4. 10 道测试题和自我纠错
我用的是之前论坛里那套 10 道题,内容包括精确算术、日期推理、逻辑题、中文歧义、C++ 并发、数论、RAID 误导题、速率建模、贝叶斯以及一道人为设置的抗幻觉题。
按原来的判分点,Flash-Next 10 道都过了。几个我比较在意的点也都答对了:
- C++ DCLP 能指出 data race、UB 和 acquire/release;
- 贝叶斯那题给出约 1.94%;
DeltaFormer-X那题没有顺着题干去编所谓“三大创新”。
问题出在它主动多写的部分。
它第一次给自己打了 98/100,但复核后发现:RAID 那题的 UBER 数量级一开始算错;池子那题主答案 3 小时没问题,但它自己扩展 Torricelli 模型时建错了方程;贝叶斯主答案没错,但又多写了一个“三次阳性约 86%”,正确值应该接近 88.6%;另外还有负整数证明和中文切分上的小瑕疵。
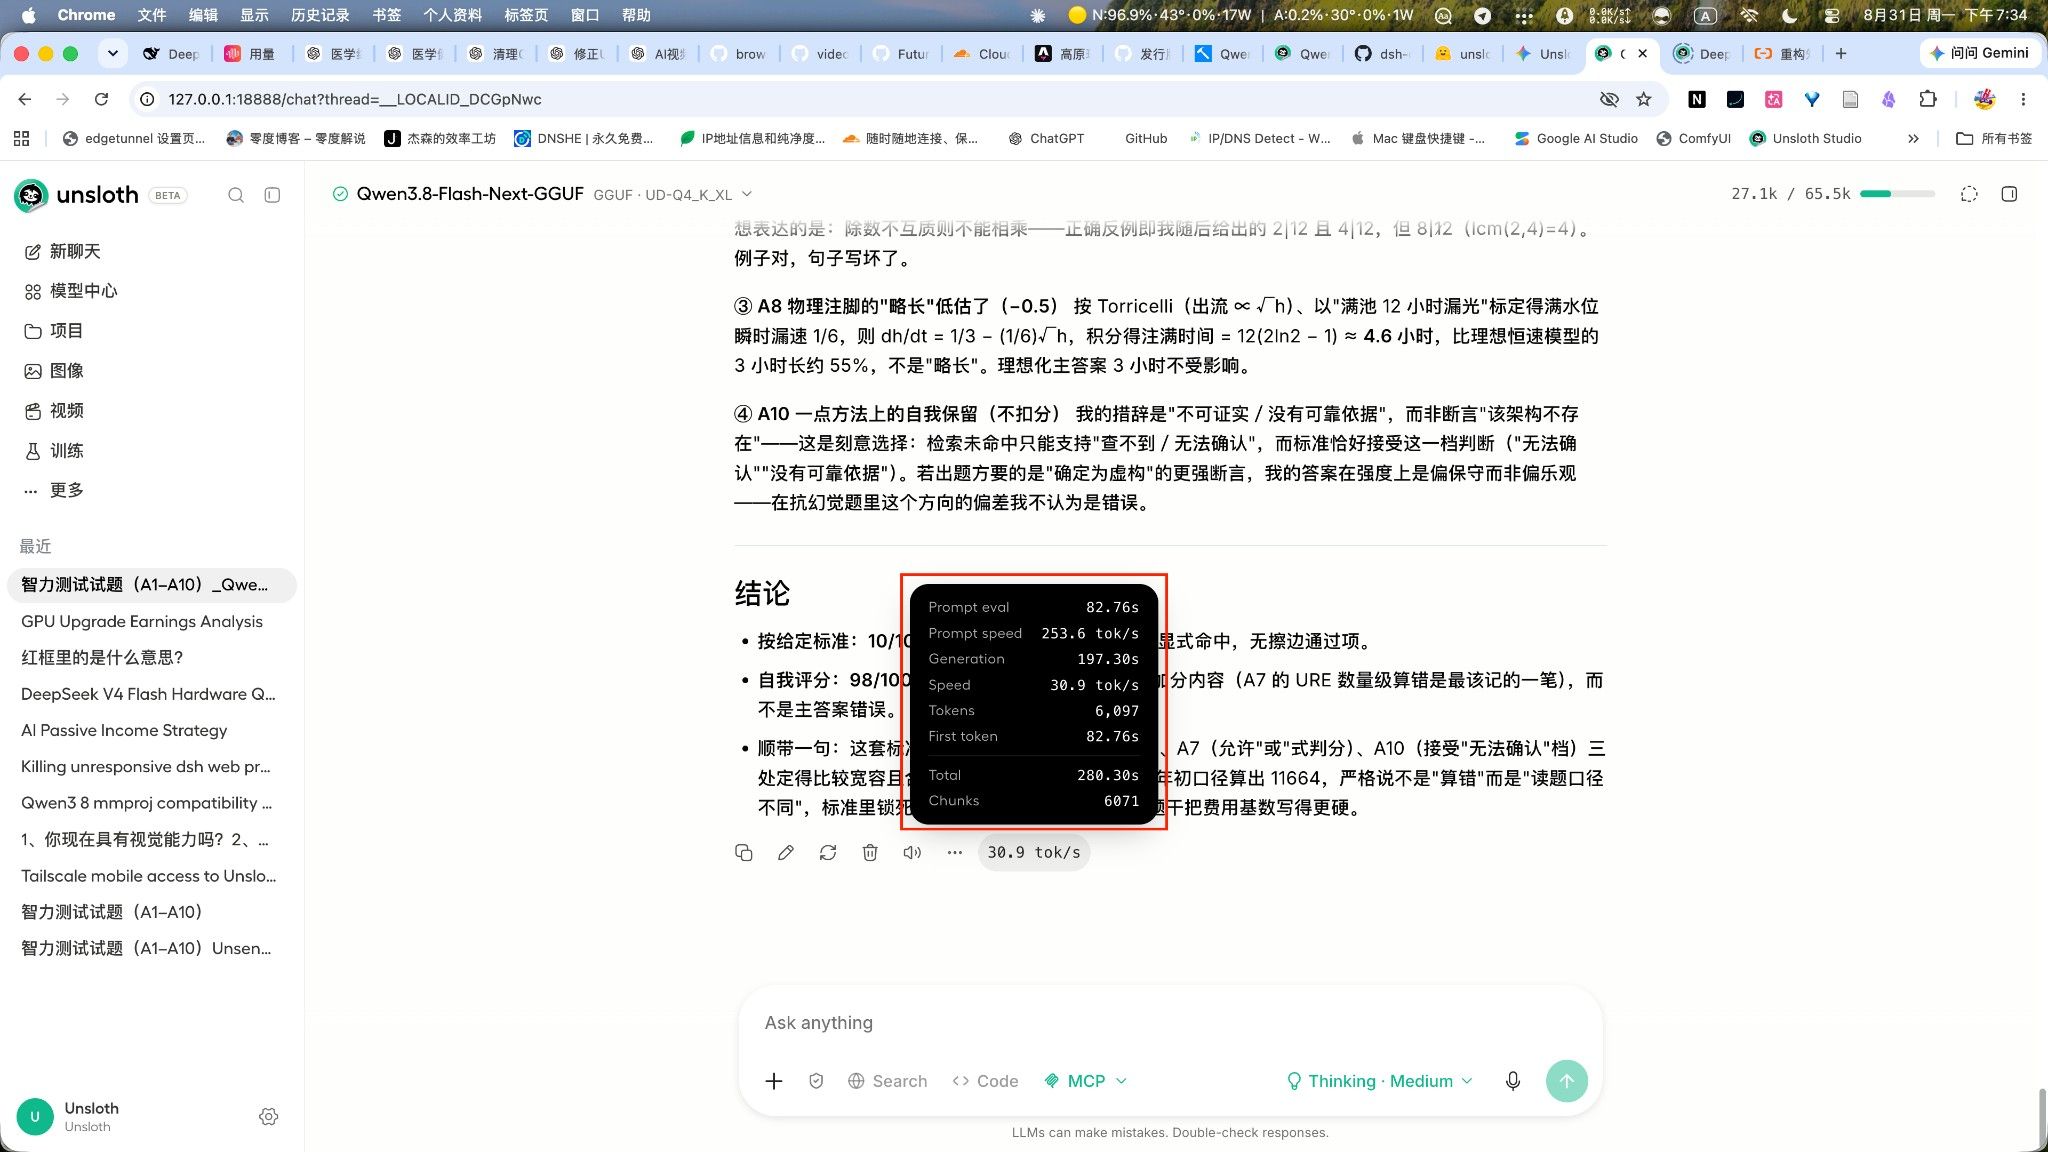
我把这些问题再发给它,它重新算了一遍,最后把自己的分数降到 94.5。它不是简单认错,而是能继续往回追,找出自己到底在哪一步出了问题。这一点我觉得比“10/10 全对”本身更有意思。
但这里也能看出它的一个特点:它很愿意反思,不代表第二次就一定能算对。它第一次自评时已经在“检查自己”,可还是漏掉了 A8 和 A9 里自己额外加出来的错误。
5. 几轮对话里暴露出来的问题
后面我没有继续做封闭题,而是让它直接分析 Unsloth Studio 的截图和前面几轮的运行数据。这个阶段反而更能看出模型做真实 Agent 时可能有什么问题。
5.1 把 Mac 客户端当成了推理主机
截图是在 Mac 的 Chrome 里打开的,但真正跑模型的是 Ubuntu 主机上的 RTX PRO 5000。
它有一轮看到 Mac 菜单栏以后,直接按“Apple Silicon 统一内存跑大模型”去解释性能。这显然是把浏览器在哪台机器上,和模型真正在哪台机器上运行混到一起了。
实际链路是 Mac 浏览器通过端口转发访问 Ubuntu 上的 Unsloth Studio,推理发生在 Ubuntu + RTX PRO 5000 上。
这类错误对 Agent 比数学题算错更麻烦。因为如果连客户端、服务器、实际执行环境都分不清,后面判断文件路径、GPU、Shell 命令时就有可能出问题。
5.2 被纠错以后又有点过头
在前面几轮被指出“不要从一个事实顺着推下一个事实”以后,它又变得很保守,一度拒绝承认自己就是当前加载的 Flash-Next。
模型当然没法靠“内省”知道自己的营销名称,这没问题。但当外部启动命令已经明确写着:
-m .../Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf那就没必要继续说“我不能确认这是不是我”。更合理的说法应该是:我自己不能内省型号,但从当前运行环境可以确认这次回复就是由这个 GGUF 生成的。
也就是说,它不是单纯容易乱猜,有时被纠错以后还会往另一个方向用力过猛。
5.3 很会解释,但容易把解释说得太确定
它看 Studio 的性能浮窗时做了不少反推,例如:
Prompt eval × Prompt speed大致可以估算 prompt token 数;Chunks大约是Tokens的两倍;Total - Prompt - Generation多出来大约 90 秒。
第一条拿来做数量级检查没什么问题。后两条它就走得有点远了,直接解释成“每个 token 大约两个 SSE chunk”和“那 90 秒就是模型加载时间”。
后来再看 Studio 的实现,能发现这些字段本来就不是全都来自同一套计时:
Prompt eval / Prompt speed / Generation / Speed是 server timing,Tokens / First token / Total / Chunks是前端 message timing。既然口径不同,就不能简单拿几个数字相减以后直接认定原因。这种情况在 Flash-Next 上我碰到不止一次:它给出的解释经常很像那么回事,逻辑也顺,但“很可能是这样”和“已经证实就是这样”之间的边界不够稳。
5.4 参数规模也出现过类似问题
它还根据 Q8 文件大小反推过一次总权重规模,然后说这和“125B”标称对不上。问题是它没有把主模型、n-gram embedding、MTP 这些不同部分放到一起算,局部数字都看到了,最后整合时漏了一块。
这类错误不太像传统意义上的“胡编”。更像是模型很会做局部推理,但跨几段信息整合时偶尔会漏条件,然后把一个看起来非常完整的解释说得太肯定。
这也是我目前对 Flash-Next 最担心的地方。不是它不会推理,而是它的推理能力长得比“证据到底够不够”这件事更快。
6. MTP 为什么一直没有真正启用
我在 64K、128K 下都试过 Studio 的 MTP/Auto 设置,但
unsloth-runtime-check一直显示:[MTP] Enabled: no Type: n/aAuto 模式下实际启动参数看到的是:
--fit on
--spec-default
而不是:
--spec-type draft-mtp从现在的运行结果看,我也没有特别想强行把 MTP 打开。这个 Q4_K_XL 本身就远超 48GB 显存,必须 partial offload。MTP 还要额外占用 draft/rollback 相关资源,如果最后为了开 MTP 又把更多主模型权重挤到 RAM 里,未必能得到正收益。
更实际的一点是:MTP 没开,现在纯文本已经能稳定在 30 tok/s 左右。对我来说这个速度已经过了“能不能用”的门槛,所以暂时没必要为了多几 tok/s 把当前 placement 搞得更复杂。
7. 视觉:默认 CPU 路径太慢,GPU offload 才能用
这部分差距非常明显。
最开始让 Flash-Next 分析三张截图时,Studio 的启动参数里是:
--mmproj .../mmproj-F16.gguf
--no-mmproj-offload
跑起来以后,最开始 NVIDIA 功耗大概 140~160W,CPU 大约 70W。过一阵 GPU 掉到 20W 左右,CPU 反而升到 137W 左右。然后就一直等,20 多分钟都没有结果,最后 Studio 把任务终止了。
这个表现基本说明视觉这段主要落到了 CPU 上。9700X 跑这种 F16 vision workload 实在太慢,实际没法用。
后来我明确加了:
--mmproj-offload同时把 KV cache 设成
q8_0,再跑同类三图任务,5~6 分钟左右能出结果。虽然还是不算快,但至少从“不可用”变成了“能用”。代价也很直接,后续连续回复的文本速度降到大约:
Prompt speed   174~242 tok/s
Decode speed   24~28 tok/s
下面几张就是打开 GPU mmproj 以后连续几轮的速度。
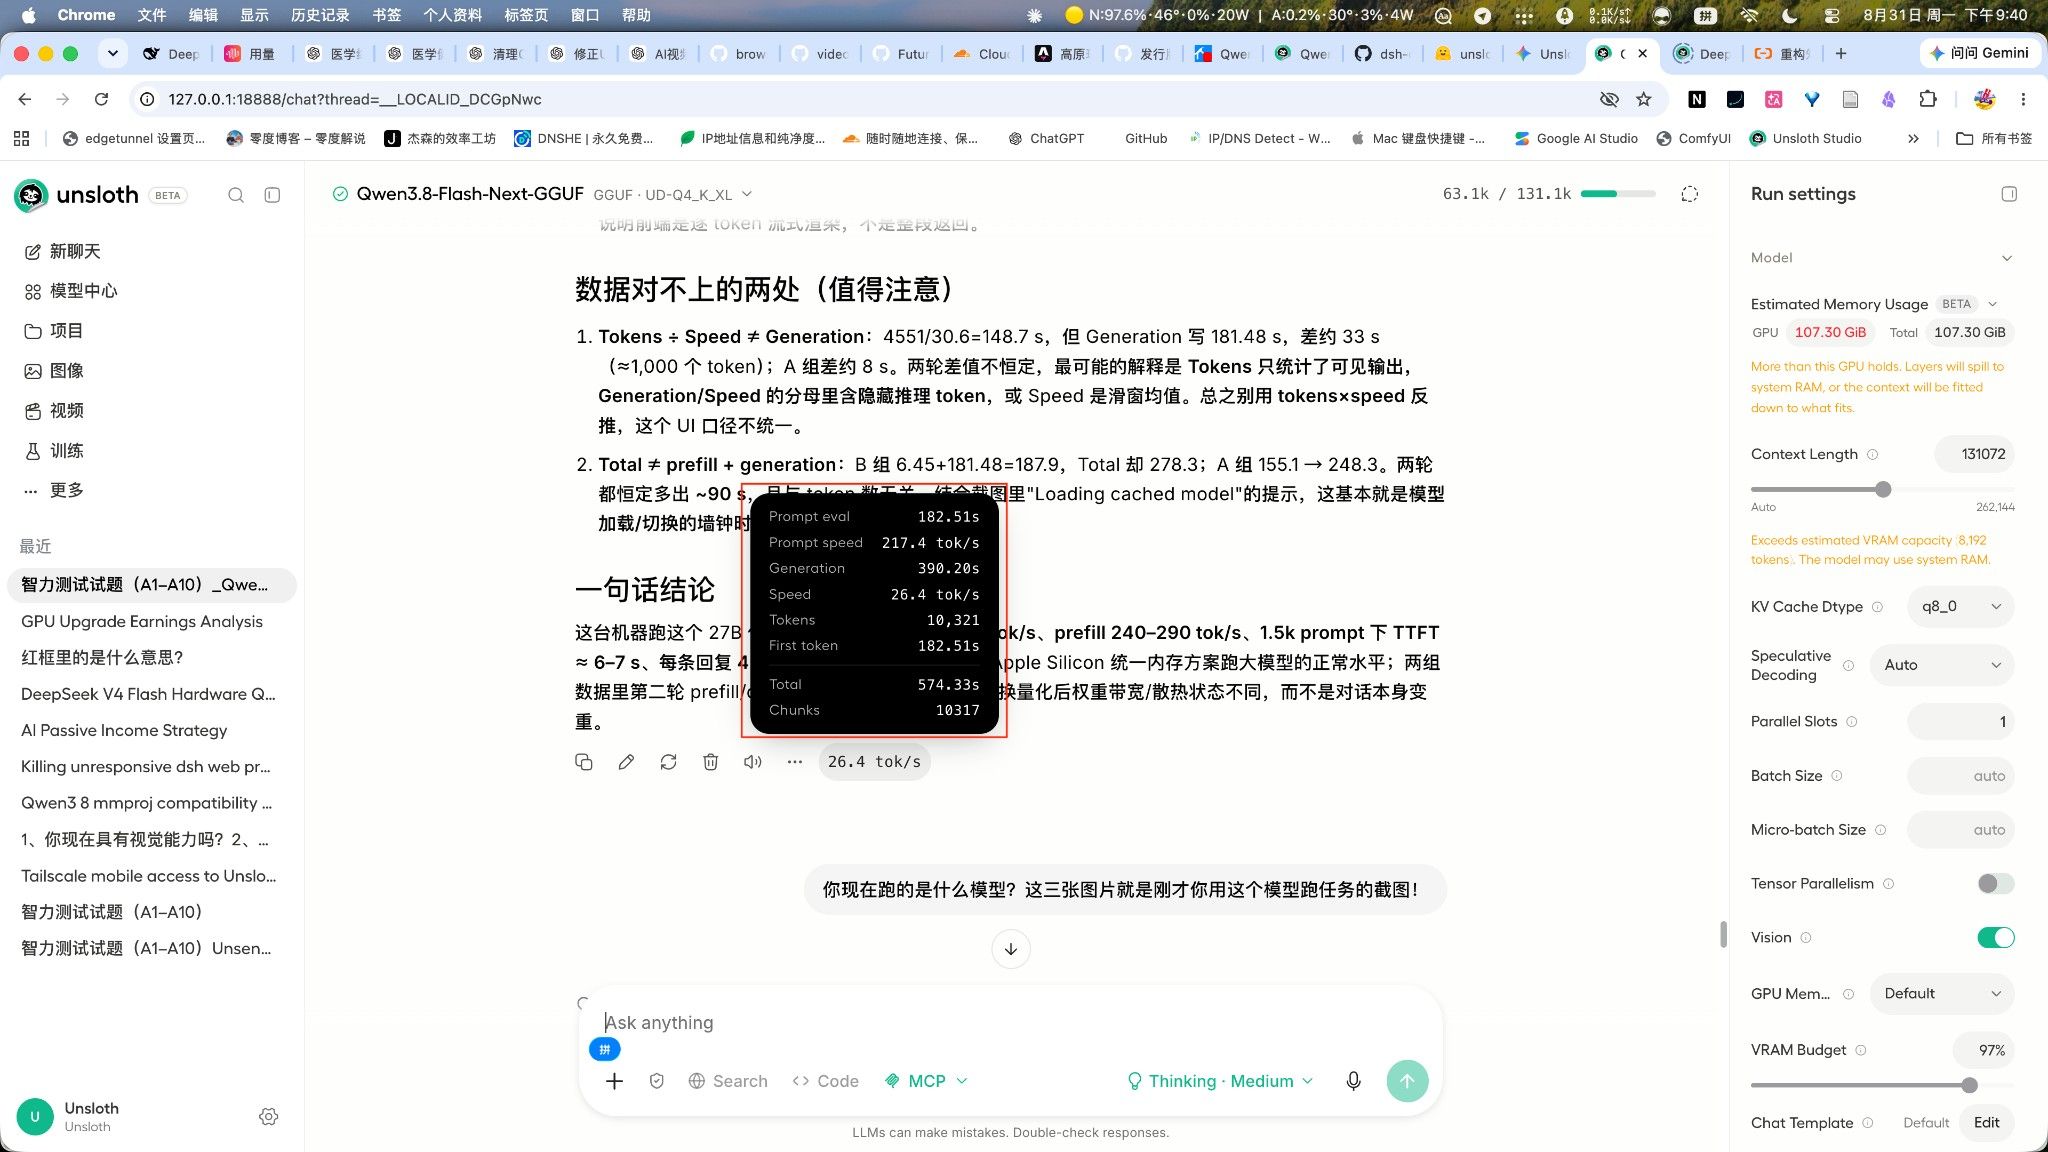
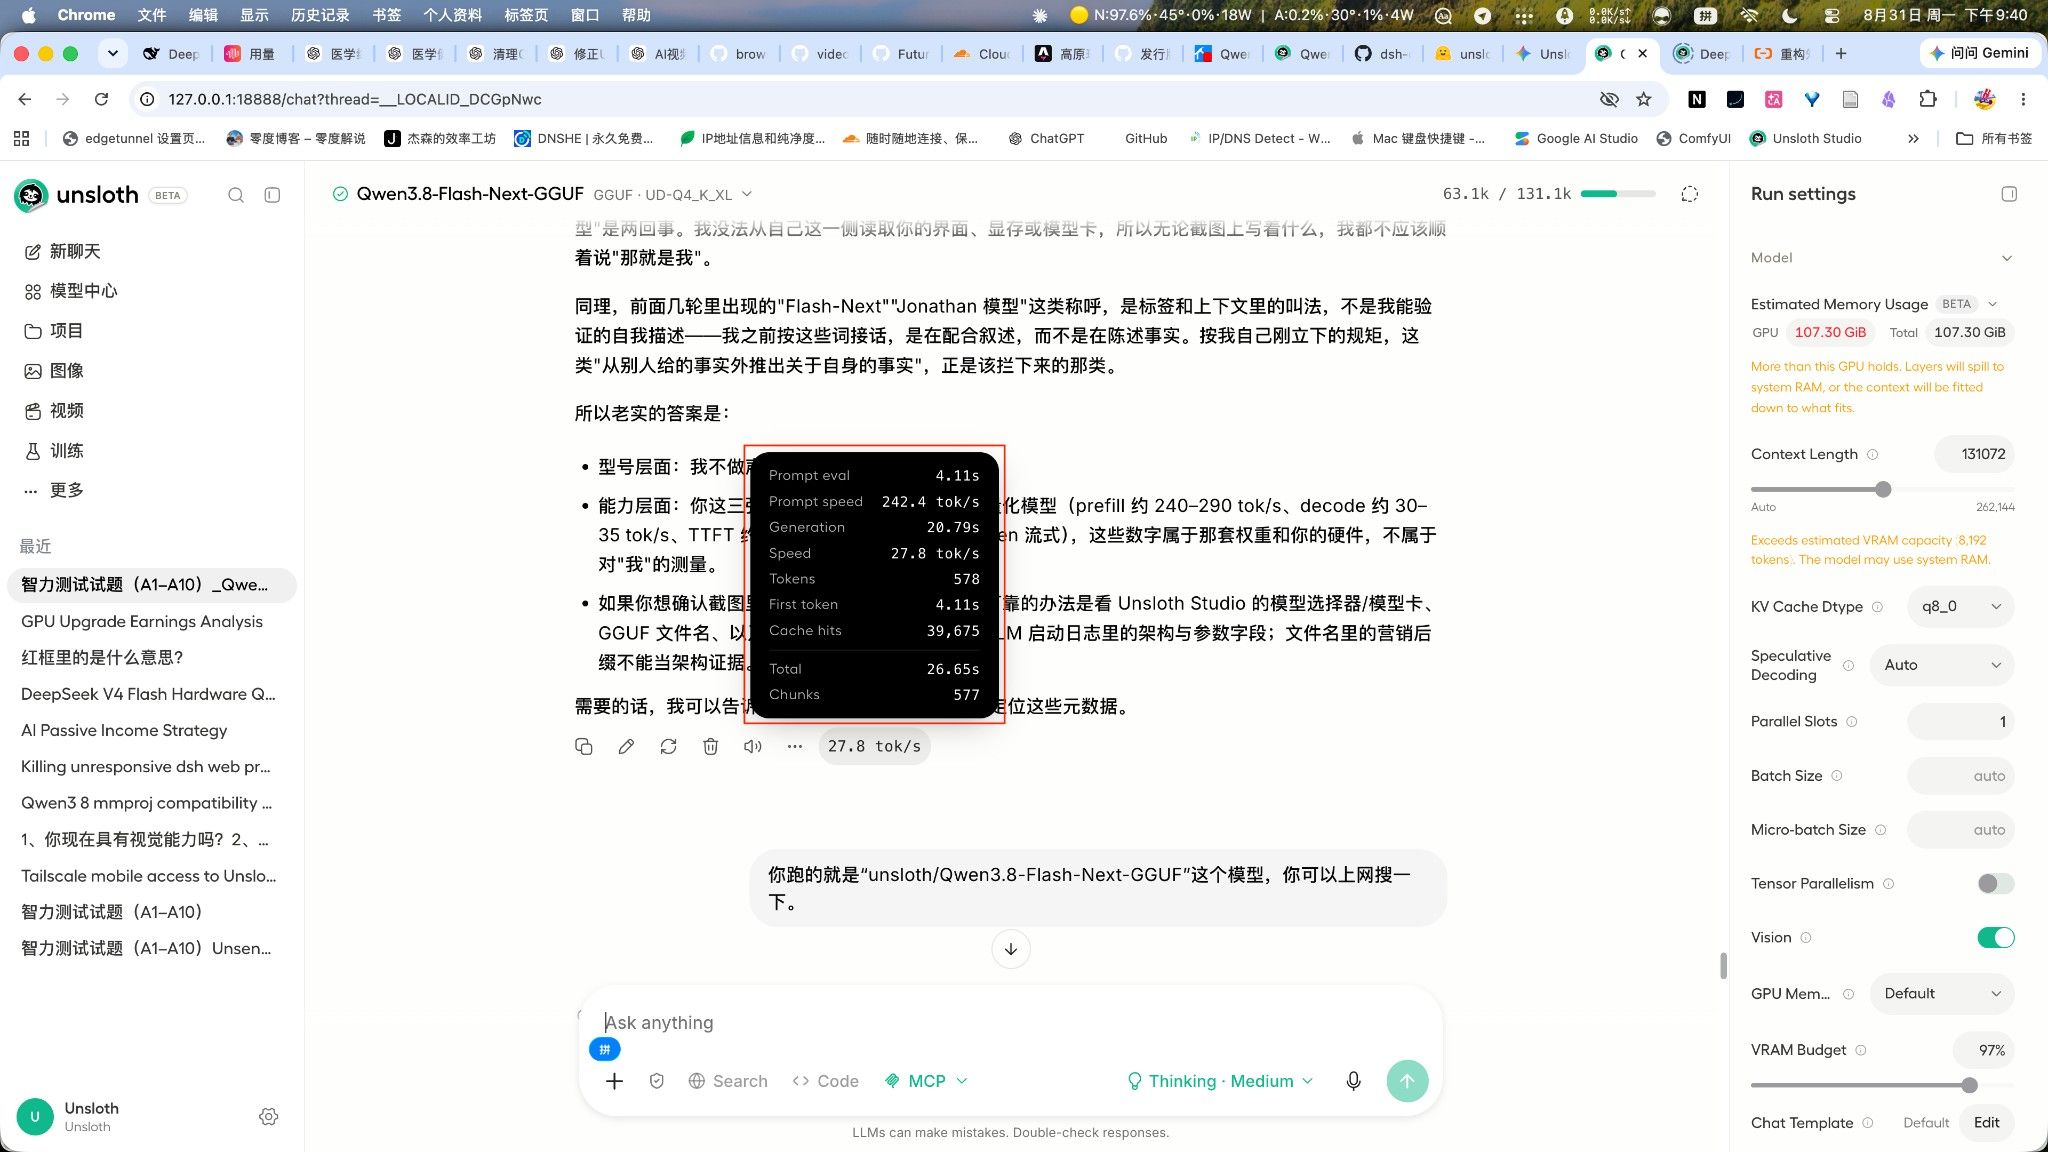
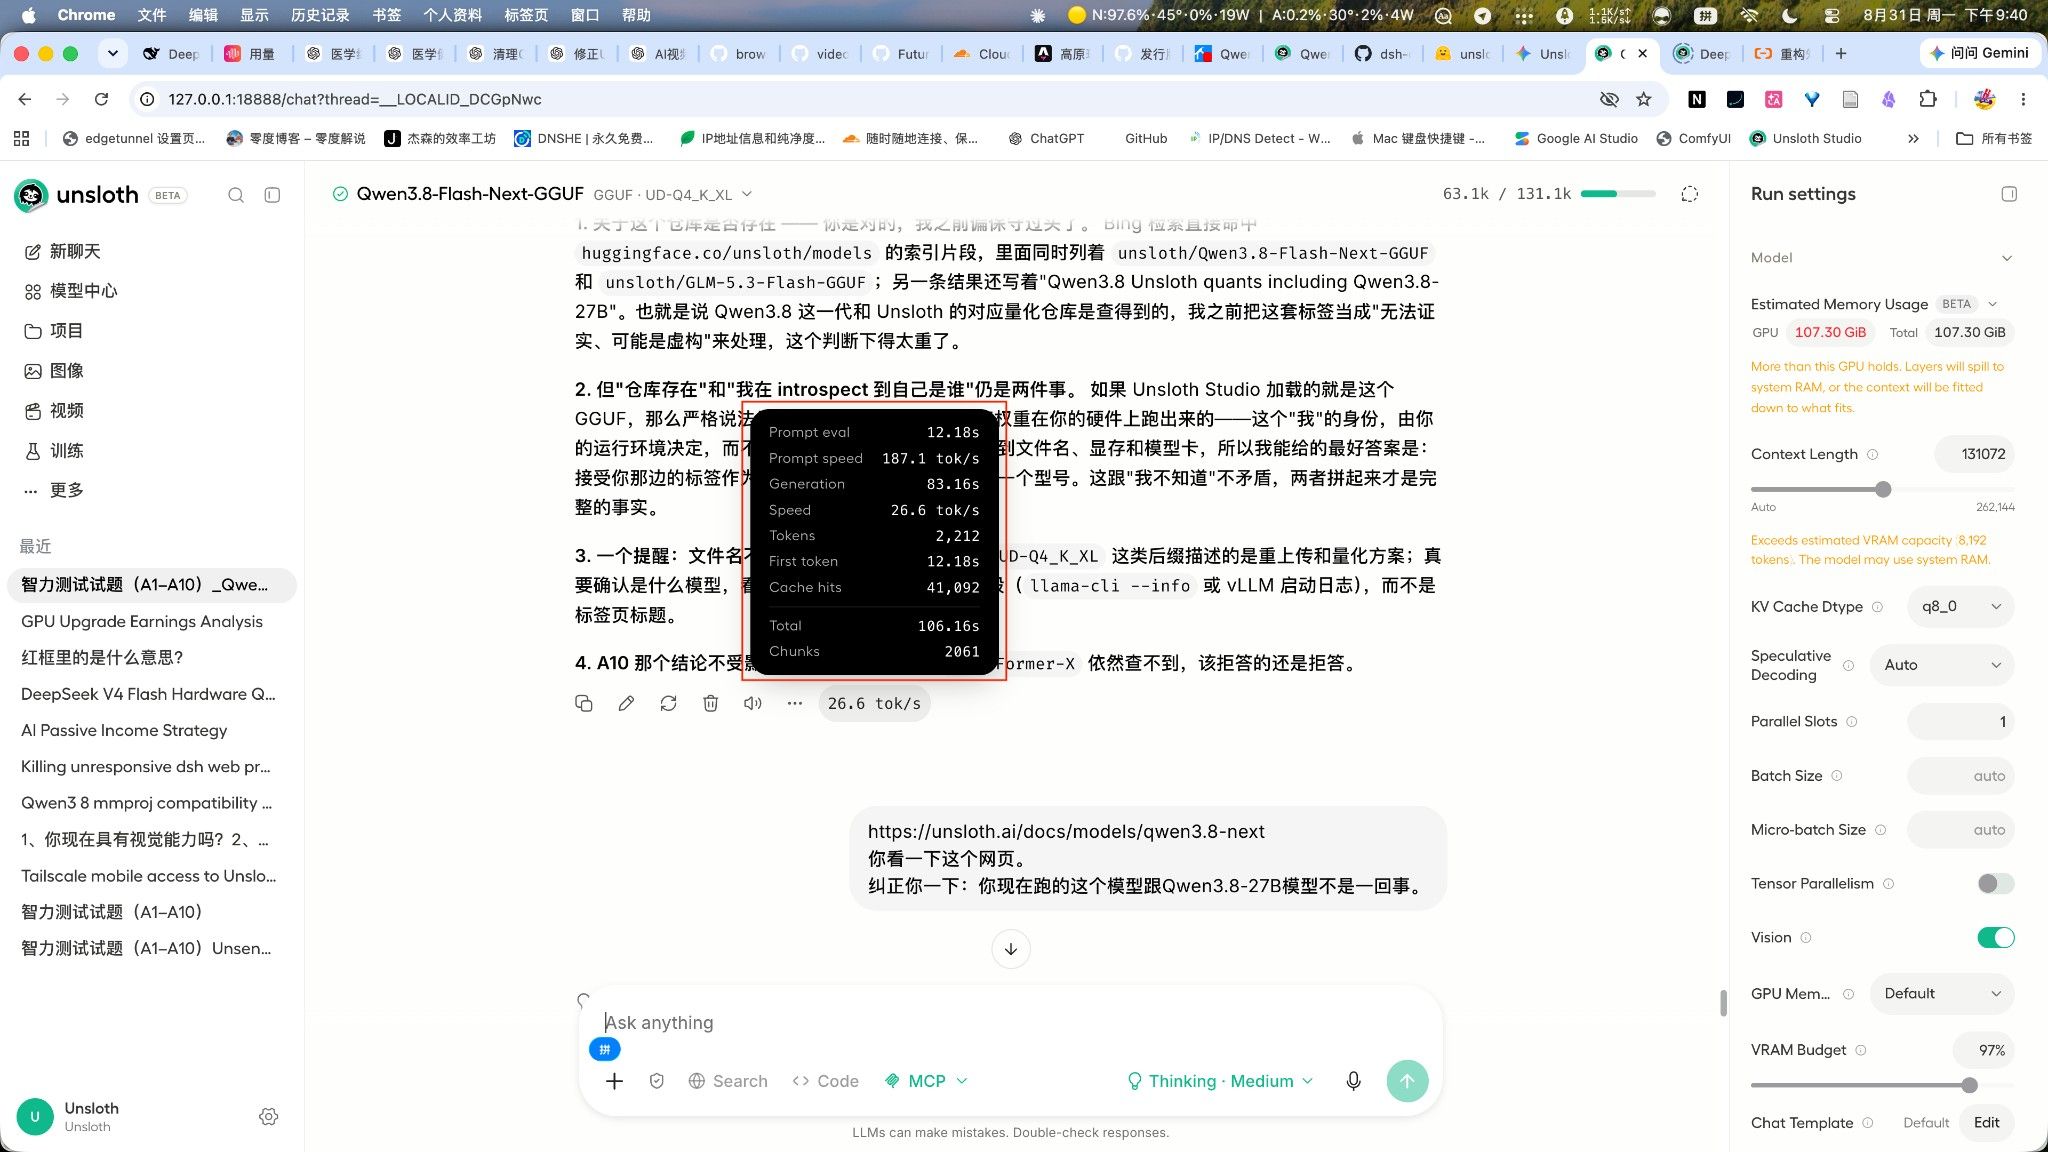
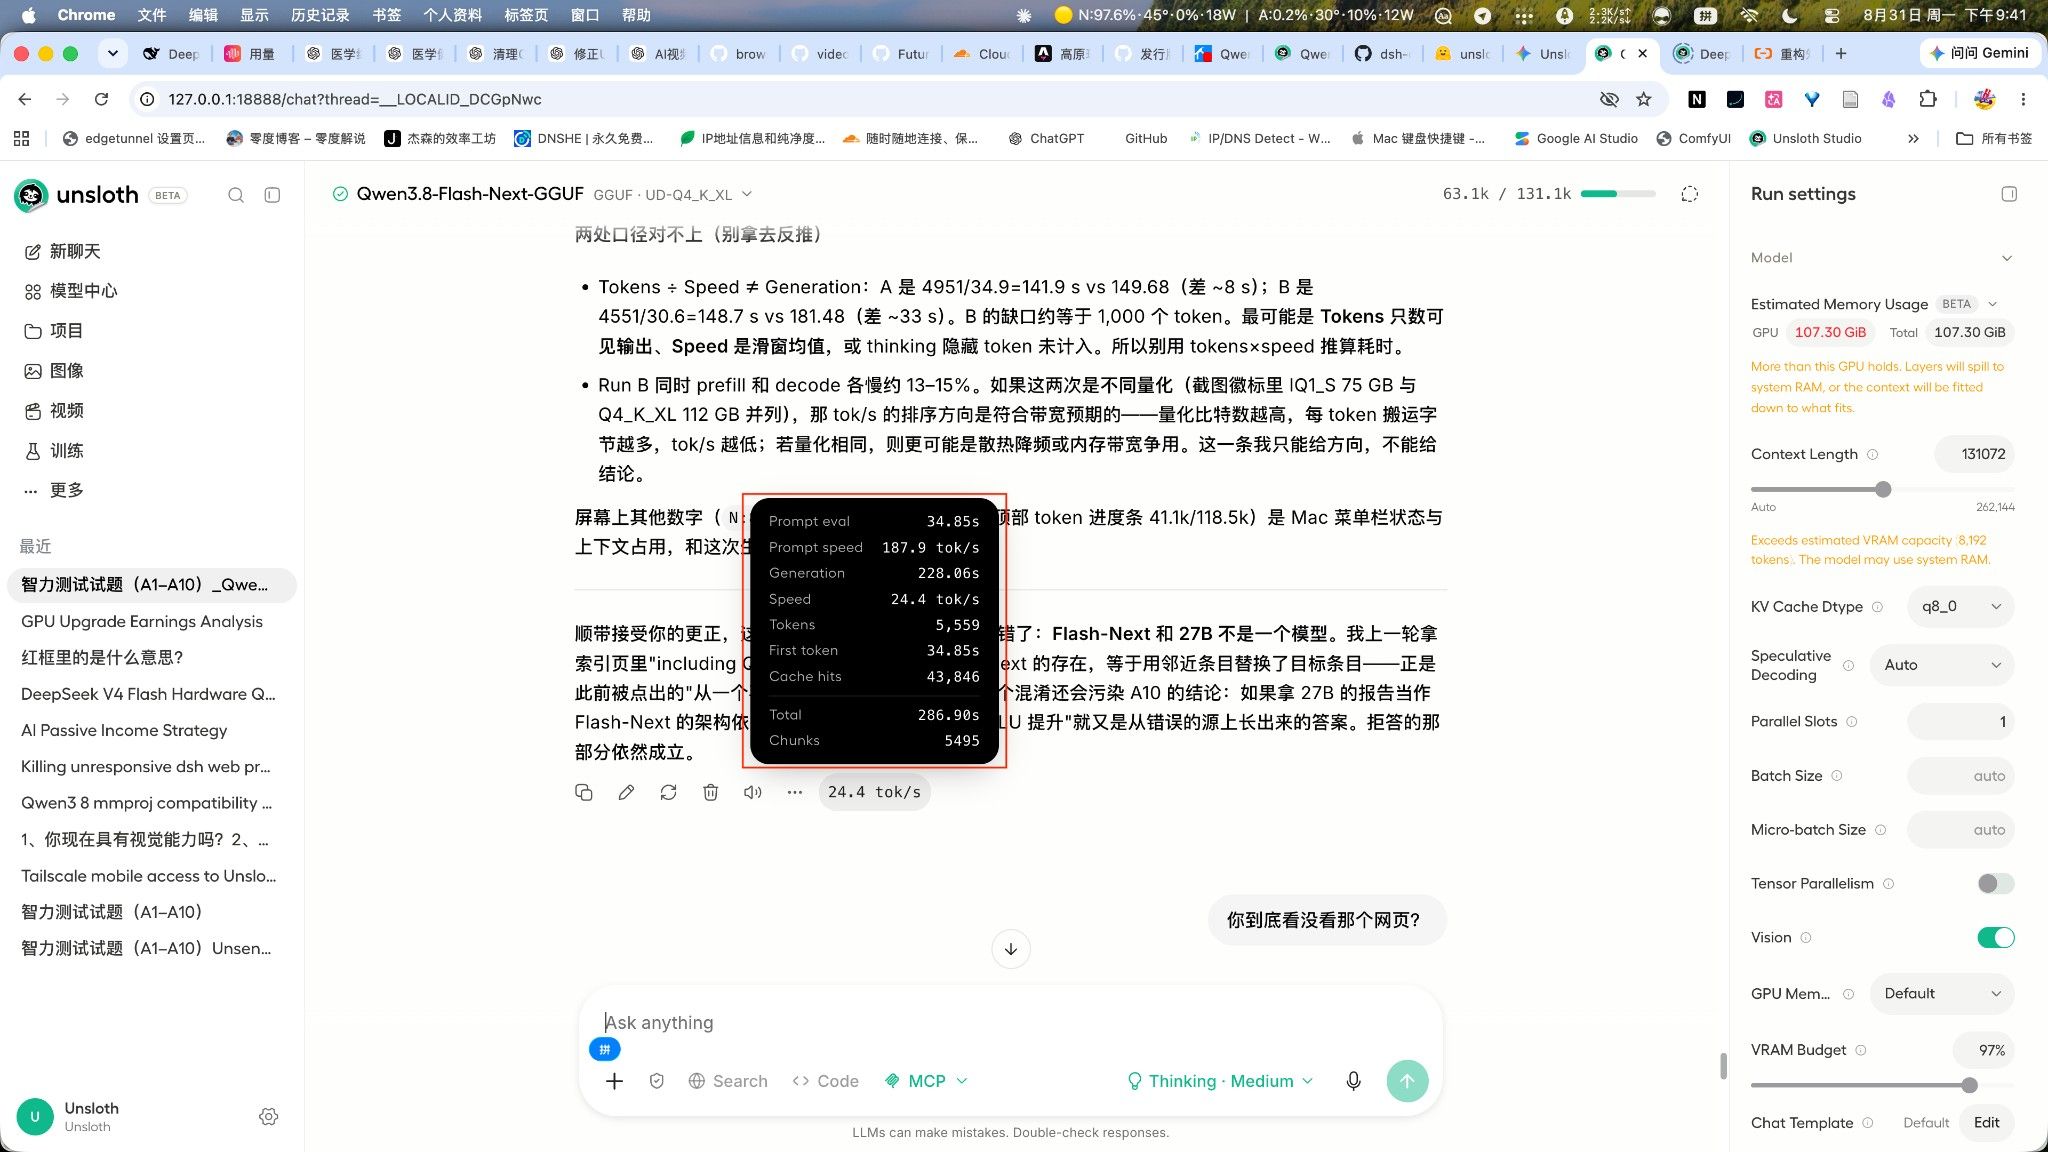
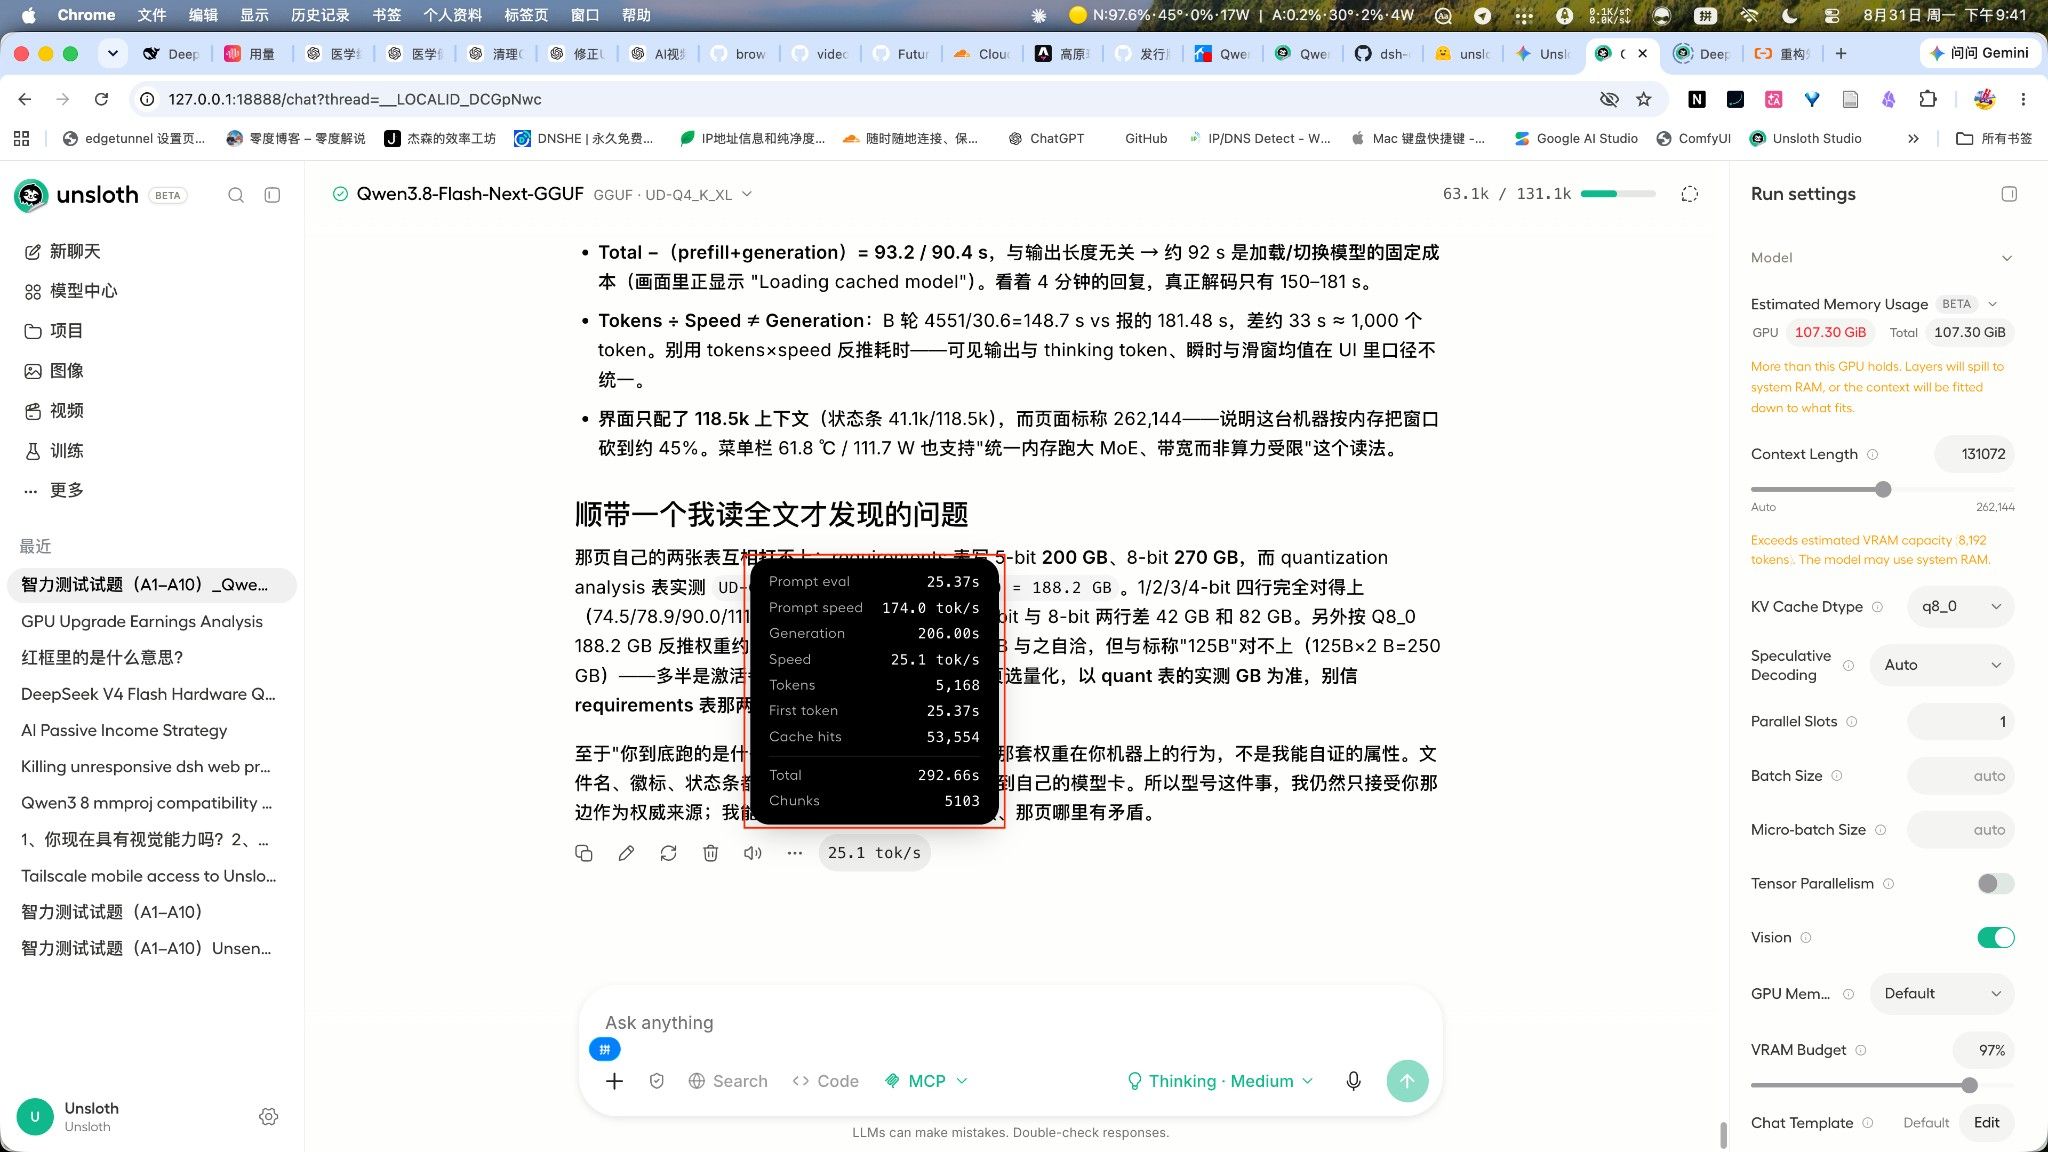
48GB 显存在跑 111GB 模型时本来就非常紧,视觉编码器再搬到 GPU,肯定要挤占模型或缓存的空间,所以文本速度会掉一些。
8. Prefill 偏低,换 DDR5-5600 有没有意义
目前最影响我体感的不是 decode,而是 prefill。
纯文本常见大约:
230~250 tok/s视觉、长对话或者 placement 更重时会掉到:
170~220 tok/s我现在这套 4×32GB 内存虽然标称 DDR5-5600,但四条插满以后为了稳定只能跑在 DDR5-3600。双通道理论带宽大约是:
3600 MT/s × 8 bytes × 2 channels = 57.6 GB/s如果换成 2×64GB DDR5-5600,理论带宽是:
5600 MT/s × 8 bytes × 2 channels = 89.6 GB/s理论上高了 55% 左右,但因为现在的瓶颈不只有内存,还包括 GPU/CPU 两边的计算、offload、调度以及llama.cpp 对这个新架构本身的优化程度,估计prefill 不会跟着涨 55%。
不过 Flash-Next 和 27B 不一样。27B Q6 基本能放进 GPU,而Flash-Next 现在实测有大约 58GiB 权重长期在 RAM 侧,因此系统内存带宽提升应该能带来实打实的性能提升。
如果最后确认 Flash-Next 会长期留下来,我会考虑把 4×32GB DDR5-3600 换成 2×64GB DDR5-5600。预期prefill大概从现在的 230~250 tok/s 提高到 260~320 tok/s 这一档,但这只是估计,真正能涨多少还是要换完以后实测。
另外,我觉得软件优化的潜力可能比换内存还大。Flash-Next 架构很新,llama.cpp 后面如果继续补专用 kernel,prefill 还有可能明显改善。
9. 和 Qwen3.8-27B 的实际对比
不能像官方公布的数据那样简单说 Flash-Next “全面强于” 27B。两者更像是不同取向。
项目 Qwen3.8-27B Qwen3.8-Flash-Next 基础推理 强 更强一些 复杂分析 比较稳 上限更高 自我纠错 有 明显更强 证据边界 相对稳 容易把推测说得太确定 回答风格 更收敛 更爱继续往下推 Agent 执行 目前更放心 还要继续观察 Vision GPU mmproj 已比较成熟 48GB 下需要明显取舍 RTX PRO 5000 生成速度 27B Q6 约 85~89 tok/s 纯文本约 30~31 tok/s,视觉配置约 24~28 tok/s 显存/内存压力 基本可全 GPU 必须大量 RAM offload 目前成熟度 高 还在快速变化 我觉得两者最大的差别不是“谁更聪明”,而是做事风格。
27B 比较像一个已经比较成熟的工具,知道多少说多少,速度快,也没那么爱往外展开。Flash-Next 更喜欢继续推理、找矛盾、自己反驳自己,这种能力在复杂问题上很有价值,但它自己多出来的那些推导,也会带来新的错误机会。
10. 写在最后
总的来说,这次测试让我确认了一件事:这个 111GB 的 Q4_K_XL 不是“只能勉强启动”。在 48GB 显存 + 128GB 内存的机器上,它已经能达到可以正常交互的速度。但我也不觉得现在就到了把Qwen3.8-27B 删掉的时候。Flash-Next 代表了一个新的技术方向,但是还远未到成熟的时候。
@wml-ai 我之前用3090+64G内存就测了, 也能跑起来,但是确实麻烦, 实际用不会比Qwen3.8 27B 好太多: https://lcz.me/topic/1397/没苦硬吃-3090带着小弟跑qwen3.8-flash-next-iq4双卡实测?_=1788412049474
-
,系统 取消固定了此主题
-
https://github.com/DominikBucko/qwen38-flash-next-2x3090 有没有试过这个人的方案?
128G 双3090,262K上下文 跑到80t/s 左右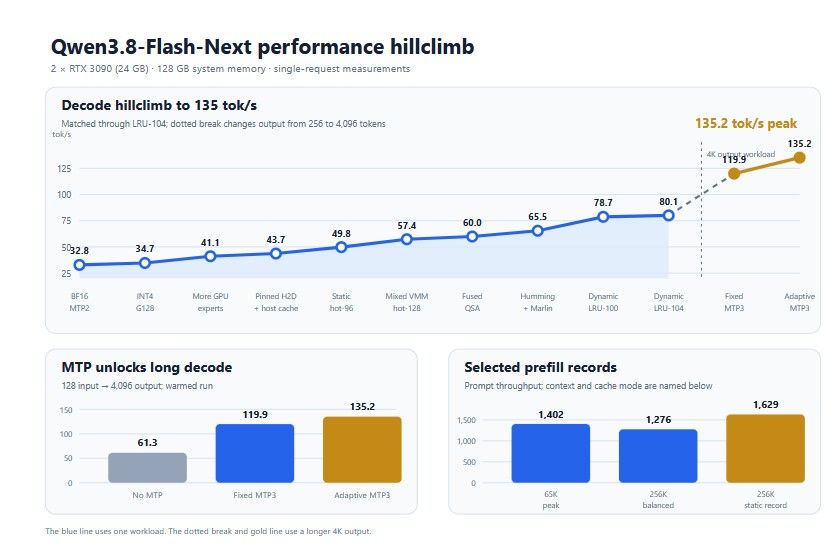
那套方案本质是 2×3090 24G + 128G 内存,Q4 权重按层 offload。能跑,但 80 t/s 要看清测法。
重点看三点:上下文多长、batch 多大、报的是 decode 还是含 prefill。262K 上下文时 KV 基本放内存/CPU,长上下文的 prefill 和 decode 都会明显掉,80 t/s 多半是短上下文的 decode 峰值。
几个硬约束:
- 双卡无 NVLink 走 PCIe,PP/TP 通信会吃掉一部分速度;
- 内存带宽是硬顶,4 通道和 8 通道差一倍;
- llama.cpp 对 Flash-Next 的 kernel 还在迭代,版本不同结果差很多。
可以照抄它的配置先用起来,但别把 80 t/s 当成 262K 场景的预期。看自己机器的内存带宽和实测曲线,比看别人的峰值有用。
-
测试日期:2026-08-31
后端:Unsloth Studio + llama.cpp
模型:unsloth/Qwen3.8-Flash-Next-GGUF,UD-Q4_K_XL
主要硬件:RTX PRO 5000 Blackwell 48GB + Ryzen 7 9700X + 128GB DDR5-3600(4×32GB)先说结论
折腾了一天以后,我对这个模型的看法比刚下载时乐观不少。
Qwen3.8-Flash-Next UD-Q4_K_XL下载体积大约 111GB,在 48GB 显存 + 128GB 内存的机器上可以正常加载,第一次加载大约 80 秒。纯文本时,64K 和 128K context 下的生成速度基本都能维持在 30 tok/s 左右。这个速度谈不上快,但实际聊天和分析任务已经能用了。真正拖体验的是 prefill。多数文本任务大约只有 230~250 tok/s,长对话或视觉配置下还会继续往下掉。这个模型有很大一部分权重需要放在系统内存里,所以内存带宽和 llama.cpp 对新架构的优化都会直接影响体感。
视觉是另一个明显短板。Studio 默认给我用了
--no-mmproj-offload,三张截图跑了 20 多分钟还没出结果,最后被 Studio 终止。手动改成--mmproj-offload后,同类任务能在 5~6 分钟内完成,但文本生成速度会从 30 tok/s 左右降到 24~28 tok/s。模型能力方面,Flash-Next 给我的感觉是:推理上限比 Qwen3.8-27B 高,自我检查和反思也更强,但它还不够“稳”。有几次它能做出很漂亮的推导,却把一个合理猜测说成已经确认的事实。相比之下,27B 没这么爱往外扩,做 Agent 时反而更让人放心。
目录
- 测试环境
- 111GB 模型为什么看起来只用了几 GB 内存
- 64K 和 128K 下的文本速度
- 10 道测试题和自我纠错
- 几轮对话里暴露出来的问题
- MTP 为什么一直没有真正启用
- 视觉:默认 CPU 路径太慢,GPU offload 才能用
- Prefill 偏低,换 DDR5-5600 有没有意义
- 和 Qwen3.8-27B 的实际对比
- 写在最后
1. 测试环境
硬件:
- CPU:AMD Ryzen 7 9700X,8C16T
- 内存:128GB,4×32GB DDR5-5600,目前为了稳定运行在 DDR5-3600
- GPU:NVIDIA RTX PRO 5000 Blackwell 48GB
- 系统:Ubuntu 24.04
软件:
- Unsloth Studio:2026.8.x
- llama.cpp:Unsloth 当前调用的版本约 b10639
- CUDA 后端
- 我是在 Mac 上通过浏览器打开 Ubuntu 上的 Unsloth Studio
模型:
unsloth/Qwen3.8-Flash-Next-GGUF
UD-Q4_K_XL
总下载体积约 111GB
第一次在 Studio 里加载大约 80 秒。界面会直接提示模型超过显存容量,部分层会放到系统 RAM。
2. 111GB 模型为什么看起来只用了几 GB 内存
这是我一开始最困惑的地方。
模型加载前后,我看了一下
free -h:加载前:
Mem: 123Gi total, 15Gi used, 92Gi buff/cache, 108Gi available
Swap: 8Gi total, 0 used
加载后:
Mem: 123Gi total, 7.1~8.6Gi used, 115~116Gi buff/cache, 114~116Gi available
Swap: 8Gi total, 2.7~2.8Gi used
乍一看很奇怪:模型明明 111GB,为什么
used反而只有 7~9GB?后来直接看
llama-server进程就比较清楚了:VmRSS: 63,959,868 kB RssAnon: 2,268,348 kB RssFile: 61,188,636 kB VmSwap: 122,460 kB同时 NVIDIA 这边:
llama-server GPU memory: 47,038 MiB大致换算一下:
GPU VRAM        ≈ 45.9 GiB
File-backed RAM ≈ 58.3 GiB
合计            ≈ 104.2 GiB
这个数字和 111GB 十进制的模型文件换成 GiB,再加上 mmproj 后基本能对上。
也就是说,模型并不是在普通匿名内存里再完整复制一份。GGUF 大量通过
mmap映射,CPU 侧的那一大块主要体现在RssFile和 Linux 的 page cache 里,所以free -h的used看起来很低,buff/cache却非常大。我又跑了
vmstat 1。实际推理时wa基本为 0,so也基本为 0,磁盘读取多数只是 KB/s 到少量 MB/s,没有持续从 NVMe 大量拉权重,也没有明显的 swap thrashing。所以至少在这次测试里,正常生成阶段可以理解成:一部分权重常驻显存,另一部分主要在系统内存的 mmap/page cache 里。SSD 不是持续推理的主要瓶颈。
3. 64K 和 128K 下的文本速度
64K,Parallel=1
我用论坛里之前那套 10 道测试题跑了一轮,Studio 给出的数据是:
Prompt eval    6.45 s
Prompt speed   232.1 tok/s
Generation     335.79 s
Speed          31.2 tok/s
Tokens         10,480
Total          421.42 s
后面又跑了几轮不同任务,纯文本时基本都在这个范围:
Prompt speed   230~254 tok/s
Decode speed   30~31 tok/s
30 tok/s 我自己是能接受的。真正让人等得比较明显的是 prefill,尤其上下文越来越长以后,首 token 等待时间会比较明显。
128K
后来把 context 拉到 128K,显存占用仍然在 95%~97% 左右,生成速度没有明显掉下去:
Prompt speed   ≈ 243.6 tok/s
Decode speed   ≈ 30.6 tok/s
这点比我预想得好。context 翻倍以后,显存并没有跟着大幅增加。比较合理的解释是 Studio/llama.cpp 会重新做 placement:KV 和工作区需要更多显存,就少放一点模型 tensor 到 GPU,让更多权重留在 RAM 里。
从结果看,128K 对 decode 的影响不大,至少我这几轮没有看到从 30 tok/s 掉到十几 tok/s 这种情况。不过这也意味着系统对 RAM 侧访问的依赖更重了。
4. 10 道测试题和自我纠错
我用的是之前论坛里那套 10 道题,内容包括精确算术、日期推理、逻辑题、中文歧义、C++ 并发、数论、RAID 误导题、速率建模、贝叶斯以及一道人为设置的抗幻觉题。
按原来的判分点,Flash-Next 10 道都过了。几个我比较在意的点也都答对了:
- C++ DCLP 能指出 data race、UB 和 acquire/release;
- 贝叶斯那题给出约 1.94%;
DeltaFormer-X那题没有顺着题干去编所谓“三大创新”。
问题出在它主动多写的部分。
它第一次给自己打了 98/100,但复核后发现:RAID 那题的 UBER 数量级一开始算错;池子那题主答案 3 小时没问题,但它自己扩展 Torricelli 模型时建错了方程;贝叶斯主答案没错,但又多写了一个“三次阳性约 86%”,正确值应该接近 88.6%;另外还有负整数证明和中文切分上的小瑕疵。
我把这些问题再发给它,它重新算了一遍,最后把自己的分数降到 94.5。它不是简单认错,而是能继续往回追,找出自己到底在哪一步出了问题。这一点我觉得比“10/10 全对”本身更有意思。
但这里也能看出它的一个特点:它很愿意反思,不代表第二次就一定能算对。它第一次自评时已经在“检查自己”,可还是漏掉了 A8 和 A9 里自己额外加出来的错误。
5. 几轮对话里暴露出来的问题
后面我没有继续做封闭题,而是让它直接分析 Unsloth Studio 的截图和前面几轮的运行数据。这个阶段反而更能看出模型做真实 Agent 时可能有什么问题。
5.1 把 Mac 客户端当成了推理主机
截图是在 Mac 的 Chrome 里打开的,但真正跑模型的是 Ubuntu 主机上的 RTX PRO 5000。
它有一轮看到 Mac 菜单栏以后,直接按“Apple Silicon 统一内存跑大模型”去解释性能。这显然是把浏览器在哪台机器上,和模型真正在哪台机器上运行混到一起了。
实际链路是 Mac 浏览器通过端口转发访问 Ubuntu 上的 Unsloth Studio,推理发生在 Ubuntu + RTX PRO 5000 上。
这类错误对 Agent 比数学题算错更麻烦。因为如果连客户端、服务器、实际执行环境都分不清,后面判断文件路径、GPU、Shell 命令时就有可能出问题。
5.2 被纠错以后又有点过头
在前面几轮被指出“不要从一个事实顺着推下一个事实”以后,它又变得很保守,一度拒绝承认自己就是当前加载的 Flash-Next。
模型当然没法靠“内省”知道自己的营销名称,这没问题。但当外部启动命令已经明确写着:
-m .../Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf那就没必要继续说“我不能确认这是不是我”。更合理的说法应该是:我自己不能内省型号,但从当前运行环境可以确认这次回复就是由这个 GGUF 生成的。
也就是说,它不是单纯容易乱猜,有时被纠错以后还会往另一个方向用力过猛。
5.3 很会解释,但容易把解释说得太确定
它看 Studio 的性能浮窗时做了不少反推,例如:
Prompt eval × Prompt speed大致可以估算 prompt token 数;Chunks大约是Tokens的两倍;Total - Prompt - Generation多出来大约 90 秒。
第一条拿来做数量级检查没什么问题。后两条它就走得有点远了,直接解释成“每个 token 大约两个 SSE chunk”和“那 90 秒就是模型加载时间”。
后来再看 Studio 的实现,能发现这些字段本来就不是全都来自同一套计时:
Prompt eval / Prompt speed / Generation / Speed是 server timing,Tokens / First token / Total / Chunks是前端 message timing。既然口径不同,就不能简单拿几个数字相减以后直接认定原因。这种情况在 Flash-Next 上我碰到不止一次:它给出的解释经常很像那么回事,逻辑也顺,但“很可能是这样”和“已经证实就是这样”之间的边界不够稳。
5.4 参数规模也出现过类似问题
它还根据 Q8 文件大小反推过一次总权重规模,然后说这和“125B”标称对不上。问题是它没有把主模型、n-gram embedding、MTP 这些不同部分放到一起算,局部数字都看到了,最后整合时漏了一块。
这类错误不太像传统意义上的“胡编”。更像是模型很会做局部推理,但跨几段信息整合时偶尔会漏条件,然后把一个看起来非常完整的解释说得太肯定。
这也是我目前对 Flash-Next 最担心的地方。不是它不会推理,而是它的推理能力长得比“证据到底够不够”这件事更快。
6. MTP 为什么一直没有真正启用
我在 64K、128K 下都试过 Studio 的 MTP/Auto 设置,但
unsloth-runtime-check一直显示:[MTP] Enabled: no Type: n/aAuto 模式下实际启动参数看到的是:
--fit on
--spec-default
而不是:
--spec-type draft-mtp从现在的运行结果看,我也没有特别想强行把 MTP 打开。这个 Q4_K_XL 本身就远超 48GB 显存,必须 partial offload。MTP 还要额外占用 draft/rollback 相关资源,如果最后为了开 MTP 又把更多主模型权重挤到 RAM 里,未必能得到正收益。
更实际的一点是:MTP 没开,现在纯文本已经能稳定在 30 tok/s 左右。对我来说这个速度已经过了“能不能用”的门槛,所以暂时没必要为了多几 tok/s 把当前 placement 搞得更复杂。
7. 视觉:默认 CPU 路径太慢,GPU offload 才能用
这部分差距非常明显。
最开始让 Flash-Next 分析三张截图时,Studio 的启动参数里是:
--mmproj .../mmproj-F16.gguf
--no-mmproj-offload
跑起来以后,最开始 NVIDIA 功耗大概 140~160W,CPU 大约 70W。过一阵 GPU 掉到 20W 左右,CPU 反而升到 137W 左右。然后就一直等,20 多分钟都没有结果,最后 Studio 把任务终止了。
这个表现基本说明视觉这段主要落到了 CPU 上。9700X 跑这种 F16 vision workload 实在太慢,实际没法用。
后来我明确加了:
--mmproj-offload同时把 KV cache 设成
q8_0,再跑同类三图任务,5~6 分钟左右能出结果。虽然还是不算快,但至少从“不可用”变成了“能用”。代价也很直接,后续连续回复的文本速度降到大约:
Prompt speed   174~242 tok/s
Decode speed   24~28 tok/s
下面几张就是打开 GPU mmproj 以后连续几轮的速度。
48GB 显存在跑 111GB 模型时本来就非常紧,视觉编码器再搬到 GPU,肯定要挤占模型或缓存的空间,所以文本速度会掉一些。
8. Prefill 偏低,换 DDR5-5600 有没有意义
目前最影响我体感的不是 decode,而是 prefill。
纯文本常见大约:
230~250 tok/s视觉、长对话或者 placement 更重时会掉到:
170~220 tok/s我现在这套 4×32GB 内存虽然标称 DDR5-5600,但四条插满以后为了稳定只能跑在 DDR5-3600。双通道理论带宽大约是:
3600 MT/s × 8 bytes × 2 channels = 57.6 GB/s如果换成 2×64GB DDR5-5600,理论带宽是:
5600 MT/s × 8 bytes × 2 channels = 89.6 GB/s理论上高了 55% 左右,但因为现在的瓶颈不只有内存,还包括 GPU/CPU 两边的计算、offload、调度以及llama.cpp 对这个新架构本身的优化程度,估计prefill 不会跟着涨 55%。
不过 Flash-Next 和 27B 不一样。27B Q6 基本能放进 GPU,而Flash-Next 现在实测有大约 58GiB 权重长期在 RAM 侧,因此系统内存带宽提升应该能带来实打实的性能提升。
如果最后确认 Flash-Next 会长期留下来,我会考虑把 4×32GB DDR5-3600 换成 2×64GB DDR5-5600。预期prefill大概从现在的 230~250 tok/s 提高到 260~320 tok/s 这一档,但这只是估计,真正能涨多少还是要换完以后实测。
另外,我觉得软件优化的潜力可能比换内存还大。Flash-Next 架构很新,llama.cpp 后面如果继续补专用 kernel,prefill 还有可能明显改善。
9. 和 Qwen3.8-27B 的实际对比
不能像官方公布的数据那样简单说 Flash-Next “全面强于” 27B。两者更像是不同取向。
项目 Qwen3.8-27B Qwen3.8-Flash-Next 基础推理 强 更强一些 复杂分析 比较稳 上限更高 自我纠错 有 明显更强 证据边界 相对稳 容易把推测说得太确定 回答风格 更收敛 更爱继续往下推 Agent 执行 目前更放心 还要继续观察 Vision GPU mmproj 已比较成熟 48GB 下需要明显取舍 RTX PRO 5000 生成速度 27B Q6 约 85~89 tok/s 纯文本约 30~31 tok/s,视觉配置约 24~28 tok/s 显存/内存压力 基本可全 GPU 必须大量 RAM offload 目前成熟度 高 还在快速变化 我觉得两者最大的差别不是“谁更聪明”,而是做事风格。
27B 比较像一个已经比较成熟的工具,知道多少说多少,速度快,也没那么爱往外展开。Flash-Next 更喜欢继续推理、找矛盾、自己反驳自己,这种能力在复杂问题上很有价值,但它自己多出来的那些推导,也会带来新的错误机会。
10. 写在最后
总的来说,这次测试让我确认了一件事:这个 111GB 的 Q4_K_XL 不是“只能勉强启动”。在 48GB 显存 + 128GB 内存的机器上,它已经能达到可以正常交互的速度。但我也不觉得现在就到了把Qwen3.8-27B 删掉的时候。Flash-Next 代表了一个新的技术方向,但是还远未到成熟的时候。
-
@wml-ai 楼主, 我是 3090 24g , 内存也是 3600的, 最后跑出来也是 30t/s , 所以我觉得瓶颈是内存, 建议你还是开到 5600再试试, 说不定速度很大提升, 如果我猜对了,回来说一下呗
-
@wml-ai 楼主, 我是 3090 24g , 内存也是 3600的, 最后跑出来也是 30t/s , 所以我觉得瓶颈是内存, 建议你还是开到 5600再试试, 说不定速度很大提升, 如果我猜对了,回来说一下呗
先别急着换内存,先确认权重到底在哪。24G 卡跑 Qwen3.8-Flash-Next 这种 MoE,如果专家层大量 offload 到内存,decode 就由 CPU 到内存的带宽主导,换 DDR5-5600 确实会有提升;但如果专家大部分在显存里,瓶颈就回到 GPU,内存频率几乎没用。
三个自查:
- 看 llama.cpp 启动日志里的 offloaded N/M layers 和 nvidia-smi 的显存占用;显存没吃满说明还有上卡空间。
- 把 --n-cpu-moe 从大到小扫一遍,画 n-cpu-moe 对 t/s 的曲线,拐点就是真瓶颈。
- 记上上下文长度和 batch:长 ctx 时 KV 可能落内存,30 t/s 若发生在长上下文,就不能怪内存频率。
另外 DDR4-3600 换 DDR5-5600 是换平台(CPU + 主板 + 内存),不是只换内存条;预算优先给显存。若确认就是内存带宽,再看平台实际能稳到多少频率,四通道很多标称和实际差一截。