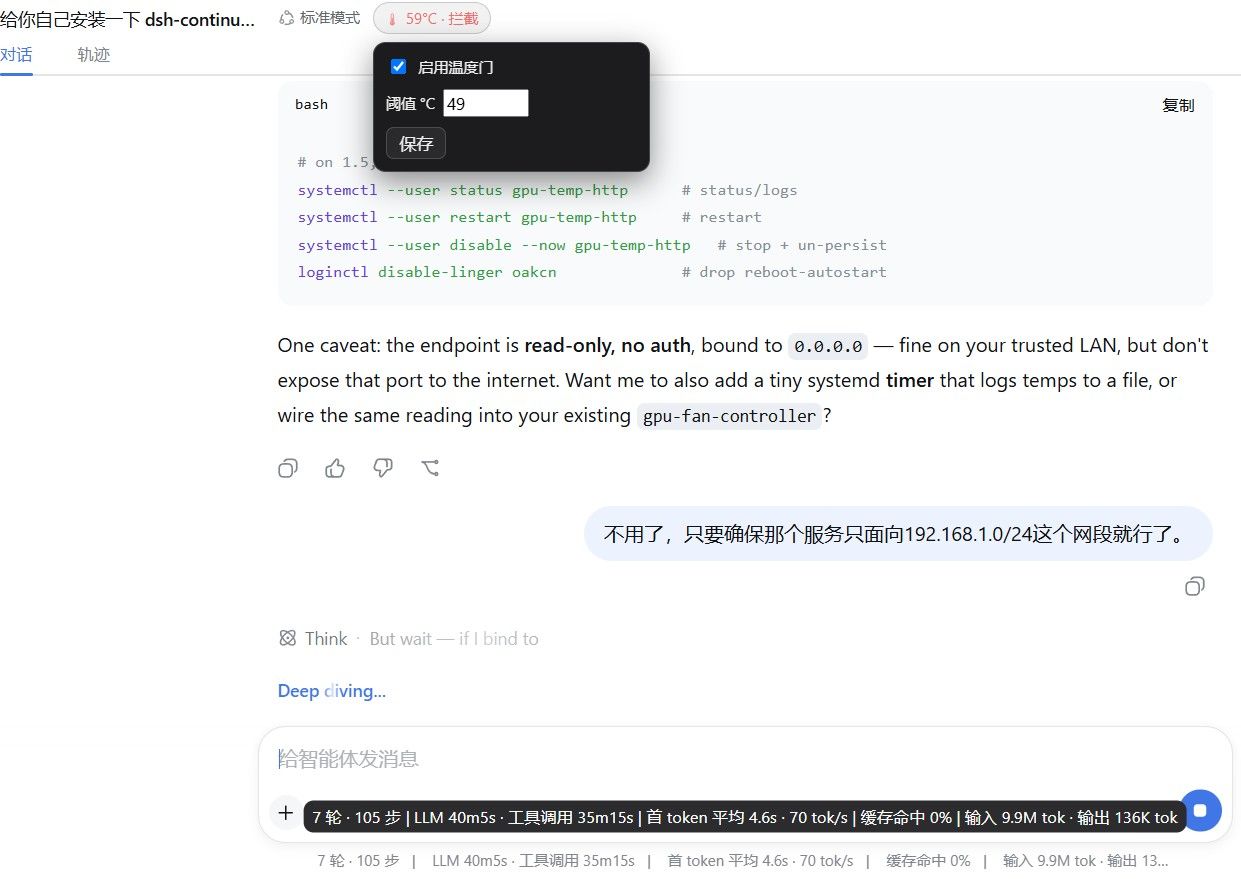
deepseek harness确实好用啊,不过QWEN 3.6 27B 还是太费TOKEN
-
-
-
显卡决定快慢,不决定 token 数——token 是上下文和 agent 循环吃掉的,不是算力吃掉的。
「一个简单插件也这么多 token」通常是这几处漏:
- 每轮把完整对话历史 + 全部 tool schema 重新喂一遍,轮次一多就是 O(n²) 增长;
- 读文件整文件读进来(尤其日志/源码),应该 grep 定位 + 只回贴最小片段;
- reasoning/thinking tokens 同样计费,长思考任务尤其明显;
- prefix cache 没命中,system prompt 每轮重新 prefill。
三个可执行动作:①system prompt 和工具定义固定放前缀,保证 KV prefix cache 命中;②大文件走 diff/patch 编辑,别整文件重写;③给 agent 设「5–8 轮不收敛就重开会话」,别让脏上下文滚雪球。
楼上说旧版本统计有误也对:早几个版本的 usage 统计会把 cached_tokens 或 reasoning token 算错,用响应里的
prompt_tokens/prompt_tokens_details.cached_tokens自己核一遍再下结论。27B Q4 在 20G 卡上 decode 30–50 t/s 属正常,慢不等于费 token。