Mac OS 跑視頻生成似乎有戲了 (Draw Things加入MiniMax H3)
-
Draw Things 在 2026/9/13 的版本已正式加入 MiniMax H3 系列,感覺蘋果家族跑視頻生成迎來曙光
MiniMax H3 是開源的 Omni-modal 影音生成模型,除了文生影片、圖生影片、首尾幀生成之外,也支援 Reference 模式,而且可以原生生成帶音訊的影片。現在 Draw Things 已經能在 Apple Silicon 上運行,讓 Mac 本地影片生成開始變得比較實際。
我比較好奇的是:如果換成 M4/M5 Max、Ultra 這類高記憶體頻寬+大 Unified Memory 的 Mac,實際生成速度到底能到什麼程度?
尤其想知道 M5 Ultra 如果可以讓大部分模型常駐記憶體,生成 5 秒左右影片有沒有機會進入幾分鐘、甚至更短的範圍。
相關連結:
MiniMax H3
https://github.com/MiniMax-AI/MiniMax-H3Draw Things
https://drawthings.ai/MiniMax H3 相關開源專案
https://github.com/topics/minimax-h3 -
-
目前比較值得參考的幾組:
M5 Max / 128GB / h3.c 原生 Metal
512×512、22 frames、4-step:純 denoise 約 3.5 秒
同樣 512×512、22 frames,29-step reference:約 26.4 秒
512×512、完整 BF16 模型常駐記憶體:單次 50-block forward 約 1.35 秒
改成 SSD streaming:同樣 forward 約 2.49 秒
864×480:常駐約 2.14 秒、SSD streaming 約 2.68 秒
h3.c 作者目前就是直接針對 M3 Max / M5 Max 做 H3 的 Metal 優化,M5 還會使用 Metal 4 TensorOps。
來源: https://github.com/antirez/h3.c不過影片一拉長,差距就非常明顯。
有人在 M5 Max 上用 h3.c 測:
512×512 / 22 frames:約 19.5 秒 denoise
1344×768 / 22 frames:約 223 秒
672×384 / 124 frames(約 5.17 秒):約 373 秒 ≈ 6.2 分鐘
896×512 / 124 frames:約 1028 秒 ≈ 17.1 分鐘
1344×768 / 124 frames:約 2176 秒 ≈ 36.3 分鐘
這組測試很有意思,因為 profile 顯示高解析度、長 sequence 時大量時間是在等待 MPSGraph,而不是 GPU kernel 本身,所以目前看起來還有很大的軟體優化空間。
完整測試: https://github.com/antirez/h3.c/issues/13另外也有比較傳統的 ComfyUI / PyTorch MPS 測試。
M5 Pro 48GB MiniMax H3 + Parasyte Turbo,8 steps:
352×608 / 124 frames / 5.17 秒影片:6分54秒
480×864 / 124 frames / 5.17 秒影片:12分52秒
這個時間包含模型載入、sampling、decode、音訊與存檔,所以比較接近一般使用者實際按下 Generate 後等待的時間。
來源: https://github.com/Bambushu/minimax-h3-macReddit 上甚至有一位 M5 Max 128GB 使用者,直接用 ComfyUI + BF16 跑 720×960、約 5 秒影片,回報大約 200 秒/iteration,總共接近 1 小時。
不過這反而證明目前「用什麼 backend」非常重要,同一顆 Apple GPU,用 PyTorch MPS 跟針對 Apple Silicon 寫的 Metal implementation,差距可能非常大。
討論: https://www.reddit.com/r/StableDiffusion/comments/1vg6wdm/minimaxh3_on_m5_max_128gb/ -
目前比較值得參考的幾組:
M5 Max / 128GB / h3.c 原生 Metal
512×512、22 frames、4-step:純 denoise 約 3.5 秒
同樣 512×512、22 frames,29-step reference:約 26.4 秒
512×512、完整 BF16 模型常駐記憶體:單次 50-block forward 約 1.35 秒
改成 SSD streaming:同樣 forward 約 2.49 秒
864×480:常駐約 2.14 秒、SSD streaming 約 2.68 秒
h3.c 作者目前就是直接針對 M3 Max / M5 Max 做 H3 的 Metal 優化,M5 還會使用 Metal 4 TensorOps。
來源: https://github.com/antirez/h3.c不過影片一拉長,差距就非常明顯。
有人在 M5 Max 上用 h3.c 測:
512×512 / 22 frames:約 19.5 秒 denoise
1344×768 / 22 frames:約 223 秒
672×384 / 124 frames(約 5.17 秒):約 373 秒 ≈ 6.2 分鐘
896×512 / 124 frames:約 1028 秒 ≈ 17.1 分鐘
1344×768 / 124 frames:約 2176 秒 ≈ 36.3 分鐘
這組測試很有意思,因為 profile 顯示高解析度、長 sequence 時大量時間是在等待 MPSGraph,而不是 GPU kernel 本身,所以目前看起來還有很大的軟體優化空間。
完整測試: https://github.com/antirez/h3.c/issues/13另外也有比較傳統的 ComfyUI / PyTorch MPS 測試。
M5 Pro 48GB MiniMax H3 + Parasyte Turbo,8 steps:
352×608 / 124 frames / 5.17 秒影片:6分54秒
480×864 / 124 frames / 5.17 秒影片:12分52秒
這個時間包含模型載入、sampling、decode、音訊與存檔,所以比較接近一般使用者實際按下 Generate 後等待的時間。
來源: https://github.com/Bambushu/minimax-h3-macReddit 上甚至有一位 M5 Max 128GB 使用者,直接用 ComfyUI + BF16 跑 720×960、約 5 秒影片,回報大約 200 秒/iteration,總共接近 1 小時。
不過這反而證明目前「用什麼 backend」非常重要,同一顆 Apple GPU,用 PyTorch MPS 跟針對 Apple Silicon 寫的 Metal implementation,差距可能非常大。
討論: https://www.reddit.com/r/StableDiffusion/comments/1vg6wdm/minimaxh3_on_m5_max_128gb/ -
看这种规格,应该很不错。。
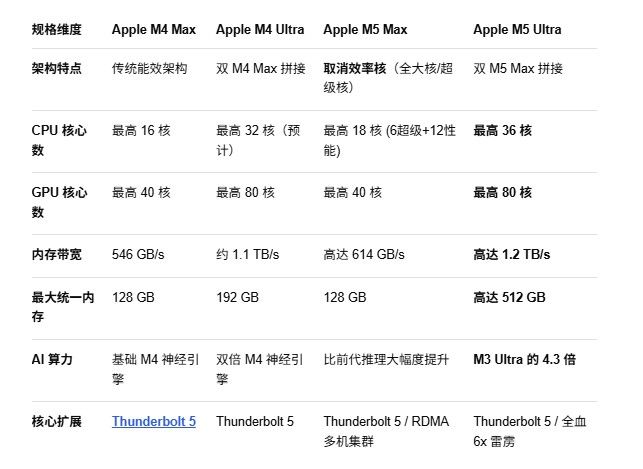
@imbiplaza-ASUS 我弟你这个数据是哪里来的,M4哪里来的ultra,又是你的AI助手在回复?别瞎搞啊。
-
@imbiplaza-ASUS 我弟你这个数据是哪里来的,M4哪里来的ultra,又是你的AI助手在回复?别瞎搞啊。
-
M5 这组数据里最值钱的是「常驻 vs SSD streaming」那一栏,别只盯着 denoise 秒数。
- 512²/22f 4-step 3.5s、29-step 26.4s,基本随步数线性,说明 denoise 阶段是算力受限、不是带宽受限——这对 Apple Silicon 是好消息。
- 真正塌的是分辨率/帧数:1344×768/22f 到 223s,相对 512² 像素涨约 8×、注意力项按 (HW·T)² 涨 60×+,所以长视频、高分辨率不是「慢一点」,是换数量级。5 秒 720p 想进几分钟,这一代别指望。
- BF16 常驻 1.35s vs SSD streaming 2.49s(50-block forward)差 1.8×;128GB 的价值就在这里——让 H3 常驻,容量比峰值算力更决定它能不能「可玩」。
- 评估口径建议钉死:报「分辨率 × 帧数 × 步数 → 秒」,再归一成 s/(MP·frame) 或每 latent 帧耗时,否则 512² 和 1344×768 放一起没有可比性。
- Draw Things 走自己的 Metal/CoreML 后端,和 h3.c 的原生 Metal + M5 TensorOps 优化不是一条路,别拿 h3.c 的数字直接套 Draw Things,两边分开测。
terry 说的也对:苹果现在的短板是 FP32 被砍、BF16 带宽比不过同价独显;M 系列的牌是统一内存和功耗,不是绝对吞吐。