R9700 單/雙卡有抄magiccodingman/vllm-radiance 作業的同學看一下
-
-
@terry
我只有單卡喔,目前論壇中的雙卡數據就是十分接近*2。
以PREFILL的感覺來說,線上DSV4F或LUNA之類的FLASH模型大約快了3倍,雙卡算起來還是比不上但很接近了。
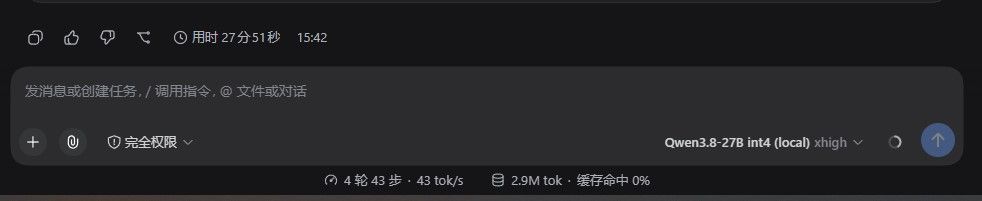
DECODE來說,差不了多少,線上都是時快時慢的,雙卡應該跟飛的一樣。這是今天是EFR32BG22 MCU的工作,設定GPIO,設定BEACON的格式,讀取MCU內部電壓,設定各種狀況的廣播方式和IO動作,省電設定,一個會話9輪做好,上下文262144 壓縮了2次,一次壓縮的時間是55秒,只有IO中斷有問題重新修改了一次就完成任務。
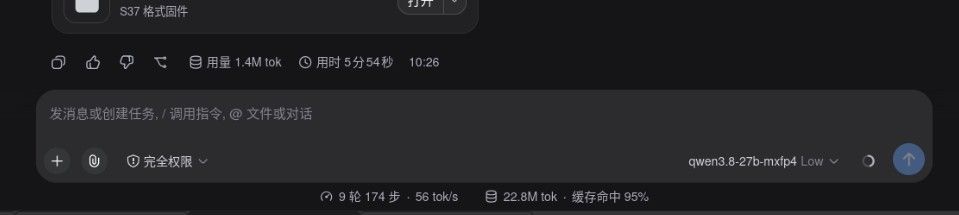
目前用起來確實是Launch80/Qwen3.8-27B-PARO-MXFP4在較長的上下文沒這麼笨,之前用AMD的模型大多要修改個3-5次才能完工。關於緩存命中,vllm的數值是平均值,llama.cpp常常在99%,算起來不該這麼高,猜測是當次載入的命中率。
-
正主版本又有更新了,這次主要針對單R9700進行效能升級,DECODE看起來是效能上漲了80%,晚上裝來試試看。
-
新的FORK方案
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main昨天晚上有小試了一下,https://github.com/GGZ14/vllm-mxfp4 版本
簡單的MCU OTA APP,讓DSH分析程式和檢查BUG。
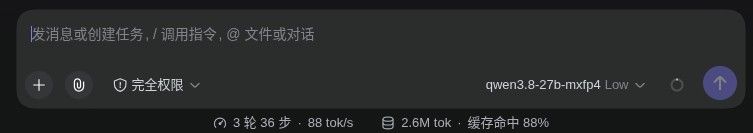
之前版本TOKEN的平均值大概在55-60TOKEN左右,新版提升到88TOKEN。
過程中大多維持在10X TOKEN,最後的分析說明很長一大堆,就降到了88 TOKEN。DSH的新會話按下送出到開始思考的第一行出現,目測大概比前一版快了1秒左右。
-
新的FORK方案
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main昨天晚上有小試了一下,https://github.com/GGZ14/vllm-mxfp4 版本
簡單的MCU OTA APP,讓DSH分析程式和檢查BUG。
之前版本TOKEN的平均值大概在55-60TOKEN左右,新版提升到88TOKEN。
過程中大多維持在10X TOKEN,最後的分析說明很長一大堆,就降到了88 TOKEN。DSH的新會話按下送出到開始思考的第一行出現,目測大概比前一版快了1秒左右。
新的FORK方案
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main昨天晚上有小試了一下,https://github.com/GGZ14/vllm-mxfp4 版本
簡單的MCU OTA APP,讓DSH分析程式和檢查BUG。
之前版本TOKEN的平均值大概在55-60TOKEN左右,新版提升到88TOKEN。
過程中大多維持在10X TOKEN,最後的分析說明很長一大堆,就降到了88 TOKEN。DSH的新會話按下送出到開始思考的第一行出現,目測大概比前一版快了1秒左右。
民间最终也是走了梁圣的路线,不断的调优一次次探索和突破硬件极限边界
-
新的FORK方案
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main昨天晚上有小試了一下,https://github.com/GGZ14/vllm-mxfp4 版本
簡單的MCU OTA APP,讓DSH分析程式和檢查BUG。
之前版本TOKEN的平均值大概在55-60TOKEN左右,新版提升到88TOKEN。
過程中大多維持在10X TOKEN,最後的分析說明很長一大堆,就降到了88 TOKEN。DSH的新會話按下送出到開始思考的第一行出現,目測大概比前一版快了1秒左右。
-
新的FORK方案
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main昨天晚上有小試了一下,https://github.com/GGZ14/vllm-mxfp4 版本
簡單的MCU OTA APP,讓DSH分析程式和檢查BUG。
之前版本TOKEN的平均值大概在55-60TOKEN左右,新版提升到88TOKEN。
過程中大多維持在10X TOKEN,最後的分析說明很長一大堆,就降到了88 TOKEN。DSH的新會話按下送出到開始思考的第一行出現,目測大概比前一版快了1秒左右。
-
最近二天裝的新版本還沒試
之前的版本大概跑一個工作大概輸入30M的TOKEN,平均的DECODE會落在55~60之間。新版本目前測試是快了20多%。
我所謂的舊版=> https://github.com/GGZ14/vllm-mxfp4
新版=> https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main一個是原始發佈,一個是FORK,新舊是我安裝的順序而言。
-
最近二天裝的新版本還沒試
之前的版本大概跑一個工作大概輸入30M的TOKEN,平均的DECODE會落在55~60之間。新版本目前測試是快了20多%。
我所謂的舊版=> https://github.com/GGZ14/vllm-mxfp4
新版=> https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main一個是原始發佈,一個是FORK,新舊是我安裝的順序而言。
-
-
@Magic629
版本是
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
模型:unsloth/Qwen3.8-27B-NVFP4
DHS上 /plan + 執行
整體是29分鐘多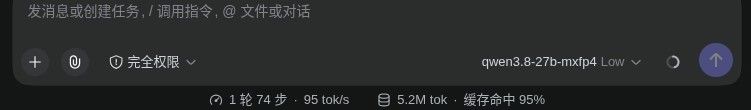
-
-
正主版本又有更新了,這次主要針對單R9700進行效能升級,DECODE看起來是效能上漲了80%,晚上裝來試試看。
-
-
-
@Magic629
版本是
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
模型:unsloth/Qwen3.8-27B-NVFP4
DHS上 /plan + 執行
整體是29分鐘多 -
-
@Magic629
版本是
https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
模型:unsloth/Qwen3.8-27B-NVFP4
DHS上 /plan + 執行
整體是29分鐘多我发现这个版本会有幻觉。昨天处理一个长任务 ,就一直循环住了。
-
-