跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試

單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試

已定时 已固定 已锁定 已移动 热议 LLM讨论区
r9700vllmqwen-27b
61 帖子 14 发布者 2.7k 浏览 6 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • I iamvirus

    双r9700 单prefill速度可以上6000token/s 了

    张光璞张
    张光璞张
    张光璞
    技术大牛 劳动模范
    编写于 最后由 编辑
    #8

    @iamvirus 说:

    r9700 单prefill速度可以上6000token/s 了

    离谱

    paul houP 1 条回复 最后回复
    0
    • paul houP
      paul houP
      paul hou
      德高望重 劳动模范
      编写于 最后由 编辑
      #9

      https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main

      這方案讓QWEN3.8 27B NVFP4去安裝,只修改一次就啟動成功了
      就不貼一大篇了,講差異就行了。
      vllm版本 : 0.27.1 => 0.29.0
      ROCM版本 : 7.14.0 => 10
      PREFILL : 少不到100,也許是誤差
      DECODE : +5~10%左右

      alan.lgv60A 1 条回复 最后回复
      0
      • 张光璞张 张光璞

        @iamvirus 说:

        r9700 单prefill速度可以上6000token/s 了

        离谱

        paul houP
        paul houP
        paul hou
        德高望重 劳动模范
        编写于 最后由 编辑
        #10

        @张光璞

        我在REDDIT看到了,那是雙卡的數據。

        1 条回复 最后回复
        0
        • I
          I
          iamvirus
          德高望重 劳动模范
          编写于 最后由 编辑
          #11

          Dual AMD R9700 - Real Performance. Local LLM Inference

          版本/环境: Betterbench 0.6.0 | Localhost.localdomain | GGZ14 MXFP4 • vLLM Build

          Decode Performance

          Category Decode T/S (tokens per second)
          chat 144.4
          code 262.0
          file_edit 280.0
          json 290.0
          math 259.8
          prose 124.6
          reasoning 237.9
          summarization 215.1
          combined 237.9

          Prefill Performance

          Depth Tok/s (tokens per second)
          2000 5769.4
          8000 6043.8
          16000 5959.3
          32000 5741.7
          64000 5395.5

          Technical Stack & Features

          • DUAL AMD R9700: Maximum throughput. Real world performance.
          • GGZ14 MXFP4: Our custom vLLM support.
          • vLLM: High performance. Open source.
          • BETTERBENCH 0.6.0: Real benchmarks. Real numbers.
          1 条回复 最后回复
          0
          • paul houP
            paul houP
            paul hou
            德高望重 劳动模范
            编写于 最后由 paul hou 编辑
            #12

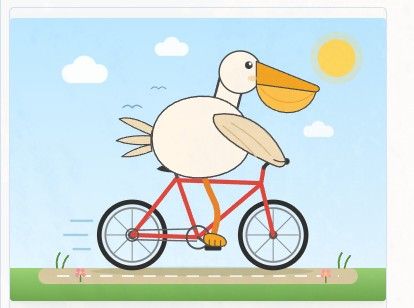
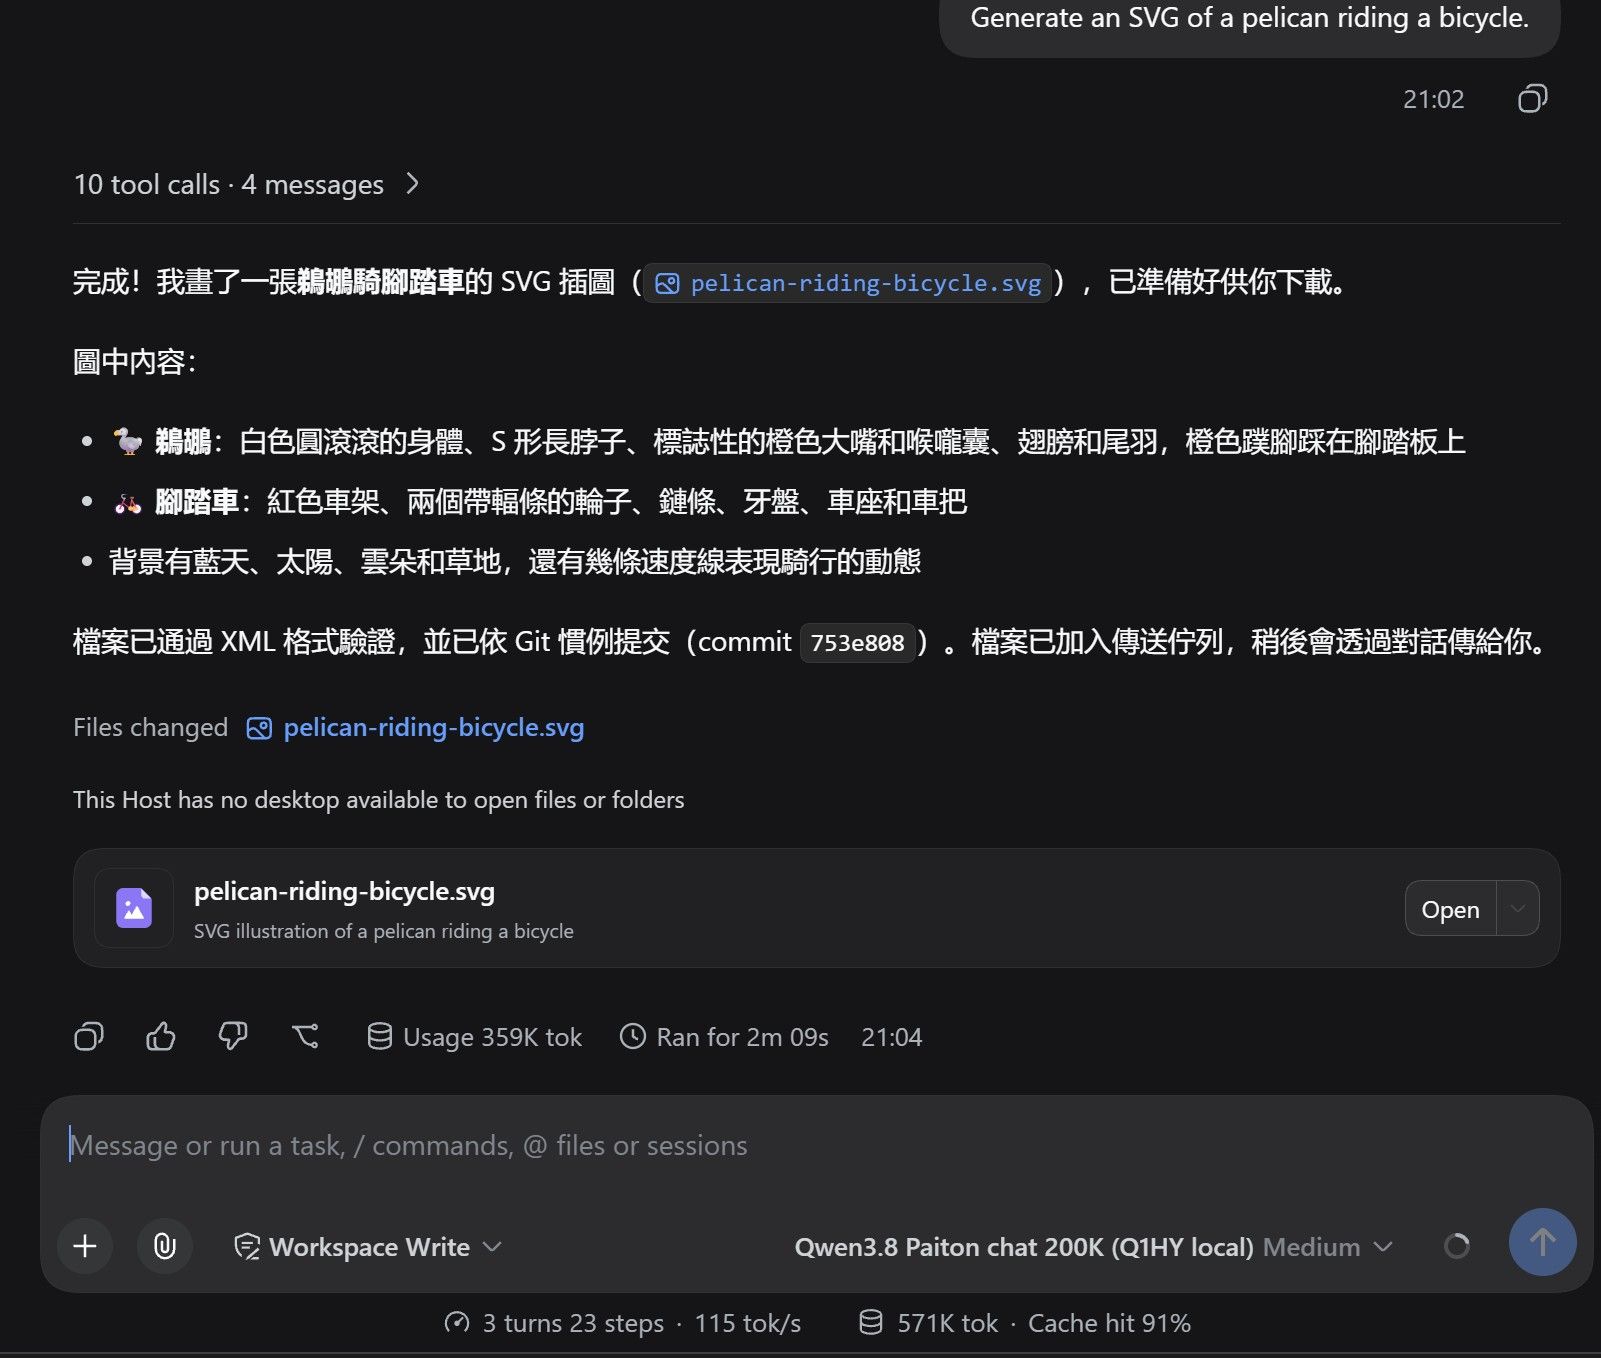
            測試傳說中的Generate an SVG of a pelican riding a bicycle.
            方案:https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
            目前思考強度的設定是無效的,所以思考強度是被VLLM強設在MEDIUM。
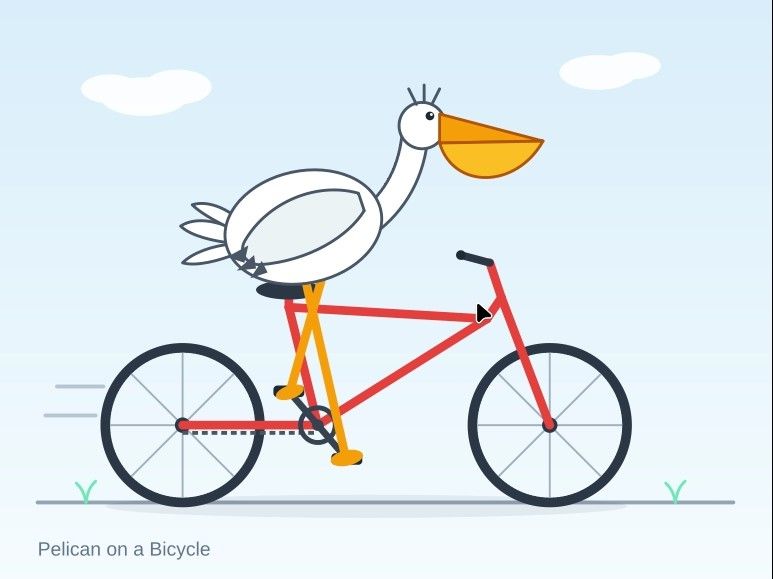
            image.jpeg

            image.jpeg

            张光璞张 1 条回复 最后回复
            0
            • 张光璞张
              张光璞张
              张光璞
              技术大牛 劳动模范
              编写于 最后由 编辑
              #13

              我已经把我的Qwen3.8 更新到这个推理框架上了,的确比以前快,但总是感觉想得太多了。

              BunseiB 1 条回复 最后回复
              0
              • paul houP
                paul houP
                paul hou
                德高望重 劳动模范
                编写于 最后由 编辑
                #14

                我是筆電剛裝dsh,思考強度設定是錯誤的起不了作用,平常工作都是設定在low,設成不思考我覺得太笨了提示詞要打很長。
                要很簡單的一句提示就要做出成果來,用xhigh會比較有機會。

                1 条回复 最后回复
                0
                • 张光璞张 张光璞

                  我已经把我的Qwen3.8 更新到这个推理框架上了,的确比以前快,但总是感觉想得太多了。

                  BunseiB
                  BunseiB
                  Bunsei
                  技术大牛 劳动模范
                  编写于 最后由 编辑
                  #15

                  @张光璞 说:

                  我已经把我的Qwen3.8 更新到这个推理框架上了,的确比以前快,但总是感觉想得太多了。

                  它的雷霆思考,就是智力的“代价”。

                  1 条回复 最后回复
                  0
                  • paul houP paul hou

                    測試傳說中的Generate an SVG of a pelican riding a bicycle.
                    方案:https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
                    目前思考強度的設定是無效的,所以思考強度是被VLLM強設在MEDIUM。
                    image.jpeg

                    image.jpeg

                    张光璞张
                    张光璞张
                    张光璞
                    技术大牛 劳动模范
                    编写于 最后由 编辑
                    #16

                    @paul-hou 说:

                    測試傳說中的Generate an SVG of a pelican riding a bicycle.
                    方案:https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
                    目前思考強度的設定是無效的,所以思考強度是被VLLM強設在MEDIUM。

                    image.jpeg

                    image.jpeg

                    有种智能体在网上搜答案的感觉

                    36ef5846-eafb-4692-8d17-baaa222514c2-image.jpeg

                    alan.lgv60A 1 条回复 最后回复
                    0
                    • 张光璞张
                      张光璞张
                      张光璞
                      技术大牛 劳动模范
                      编写于 最后由 编辑
                      #17

                      R9700 的性价比还在提升

                      1 条回复 最后回复
                      0
                      • williamlouisW
                        williamlouisW
                        williamlouis
                        超级版主
                        编写于 最后由 编辑
                        #18

                        模型优化团队也是自杀群体。
                        越优化的越好。卡越涨价。。。。。。。。
                        无解

                        个人主页:xlkj.org Telegram https://t.me/xlkjorg

                        1 条回复 最后回复
                        0
                        • nami ryuuN
                          nami ryuuN
                          nami ryuu
                          编写于 最后由 编辑
                          #19

                          @paul-hou 这个和你之前那个是一样的吗,就是换成nvfp4了吗?这个能双卡吗?

                          paul houP 1 条回复 最后回复
                          0
                          • nami ryuuN nami ryuu

                            @paul-hou 这个和你之前那个是一样的吗,就是换成nvfp4了吗?这个能双卡吗?

                            paul houP
                            paul houP
                            paul hou
                            德高望重 劳动模范
                            编写于 最后由 编辑
                            #20

                            @nami-ryuu
                            能雙卡,PREFILL都破6000了~

                            1 条回复 最后回复
                            0
                            • paul houP paul hou

                              https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main

                              這方案讓QWEN3.8 27B NVFP4去安裝,只修改一次就啟動成功了
                              就不貼一大篇了,講差異就行了。
                              vllm版本 : 0.27.1 => 0.29.0
                              ROCM版本 : 7.14.0 => 10
                              PREFILL : 少不到100,也許是誤差
                              DECODE : +5~10%左右

                              alan.lgv60A
                              alan.lgv60A
                              alan.lgv60
                              编写于 最后由 编辑
                              #21

                              @paul-hou
                              我们用同一张 R9700 测试了不同功耗和上下文配置,数据如下,供参考。

                              测试环境

                              项目 值
                              显卡 AMD Radeon AI PRO R9700 32 GB (RDNA4 gfx1201)
                              TP 1
                              方案 Eliovp-BV/paiton-vllm-plugin
                              vLLM 0.29.0 + ROCm 10
                              官方镜像 v1.1.0 (sha256:28af1731cfd8)
                              模型 Qwen3.8-27B MXFP4
                              KV cache 8 GiB fp8
                              chunk size 4096
                              spec decode DFlash2, num_speculative_tokens=7
                              测试工具 BetterBench 0.6.0
                              采样 temp 0.7 / top_p 0.95,每类别 n=20,8 类别共 160

                              A. 功耗对比 — Paiton vLLM 0.29 ROCm10, 65K preset

                              Prefill(tok/s)

                              深度 (tok) 260 W 300 W
                              ~1.5K 3,160 3,498
                              ~5.9K 3,149 3,433
                              ~11.8K 3,219 3,471
                              ~23.5K 3,069 3,292
                              ~47.0K 2,859 3,054

                              Decode(weighted t/s,8 类别合并)

                              功耗 Weighted decode
                              260 W 138.4
                              300 W 141.5

                              两组为同一张卡、同一镜像、同一天、同一组测试参数,只修改 power1_cap(260 W ↔ 300 W)。

                              B. 三种上下文配置对比 — Paiton v1.1.0 官方镜像,全部 260 W

                              本节三个配置使用同一个官方 v1.1.0 镜像。其中 64K×8 为官方 preset;100K×2 为官方 entrypoint override(--max-model-len 100000 --max-num-seqs 2),非官方 preset,未经官方完整 benchmark 认证。

                              TG(weighted decode t/s)

                              配置 上下文 max_num_seqs TG wt
                              64K×8 65,536 8 103.89
                              200K×1 200,000 1 103.91
                              100K×2 100,000 2 103.84

                              Prefill(tok/s)

                              深度 (tok) 64K×8 200K×1 100K×2
                              ~1.5K 3,228 3,234 3,229
                              ~5.9K 3,130 3,143 3,153
                              ~11.8K 3,048 3,066 3,072
                              ~23.5K 2,862 2,876 2,883
                              ~47.0K 2,522 2,538 2,540

                              并发(aggregate t/s / TTFT p50 ms,48 请求/档位)

                              配置 c1 c2 c4 c8
                              64K×8 87.2 / 109 ms 151.1 / 162 ms 226.2 / 179 ms 309.6 / 201 ms
                              100K×2 87.1 / 109 ms 147.7 / 162 ms 151.3 / 2,771 ms 148.2 / 8,588 ms
                              200K×1 87.1 / 109 ms 87.0 / 2,227 ms 85.8 / 7,835 ms 87.4 / 15,396 ms

                              paul houP 1 条回复 最后回复
                              0
                              • alan.lgv60A alan.lgv60

                                @paul-hou
                                我们用同一张 R9700 测试了不同功耗和上下文配置,数据如下,供参考。

                                测试环境

                                项目 值
                                显卡 AMD Radeon AI PRO R9700 32 GB (RDNA4 gfx1201)
                                TP 1
                                方案 Eliovp-BV/paiton-vllm-plugin
                                vLLM 0.29.0 + ROCm 10
                                官方镜像 v1.1.0 (sha256:28af1731cfd8)
                                模型 Qwen3.8-27B MXFP4
                                KV cache 8 GiB fp8
                                chunk size 4096
                                spec decode DFlash2, num_speculative_tokens=7
                                测试工具 BetterBench 0.6.0
                                采样 temp 0.7 / top_p 0.95,每类别 n=20,8 类别共 160

                                A. 功耗对比 — Paiton vLLM 0.29 ROCm10, 65K preset

                                Prefill(tok/s)

                                深度 (tok) 260 W 300 W
                                ~1.5K 3,160 3,498
                                ~5.9K 3,149 3,433
                                ~11.8K 3,219 3,471
                                ~23.5K 3,069 3,292
                                ~47.0K 2,859 3,054

                                Decode(weighted t/s,8 类别合并)

                                功耗 Weighted decode
                                260 W 138.4
                                300 W 141.5

                                两组为同一张卡、同一镜像、同一天、同一组测试参数,只修改 power1_cap(260 W ↔ 300 W)。

                                B. 三种上下文配置对比 — Paiton v1.1.0 官方镜像,全部 260 W

                                本节三个配置使用同一个官方 v1.1.0 镜像。其中 64K×8 为官方 preset;100K×2 为官方 entrypoint override(--max-model-len 100000 --max-num-seqs 2),非官方 preset,未经官方完整 benchmark 认证。

                                TG(weighted decode t/s)

                                配置 上下文 max_num_seqs TG wt
                                64K×8 65,536 8 103.89
                                200K×1 200,000 1 103.91
                                100K×2 100,000 2 103.84

                                Prefill(tok/s)

                                深度 (tok) 64K×8 200K×1 100K×2
                                ~1.5K 3,228 3,234 3,229
                                ~5.9K 3,130 3,143 3,153
                                ~11.8K 3,048 3,066 3,072
                                ~23.5K 2,862 2,876 2,883
                                ~47.0K 2,522 2,538 2,540

                                并发(aggregate t/s / TTFT p50 ms,48 请求/档位)

                                配置 c1 c2 c4 c8
                                64K×8 87.2 / 109 ms 151.1 / 162 ms 226.2 / 179 ms 309.6 / 201 ms
                                100K×2 87.1 / 109 ms 147.7 / 162 ms 151.3 / 2,771 ms 148.2 / 8,588 ms
                                200K×1 87.1 / 109 ms 87.0 / 2,227 ms 85.8 / 7,835 ms 87.4 / 15,396 ms

                                paul houP
                                paul houP
                                paul hou
                                德高望重 劳动模范
                                编写于 最后由 paul hou 编辑
                                #22

                                @alan.lgv60

                                我是降到210W,降速約30%,PREFILL慢了近22%,真是一分電源一分速度。
                                DEOCDE差異就小很多了。
                                所以還是降功率比較好。

                                BunseiB 1 条回复 最后回复
                                0
                                • paul houP paul hou

                                  @alan.lgv60

                                  我是降到210W,降速約30%,PREFILL慢了近22%,真是一分電源一分速度。
                                  DEOCDE差異就小很多了。
                                  所以還是降功率比較好。

                                  BunseiB
                                  BunseiB
                                  Bunsei
                                  技术大牛 劳动模范
                                  编写于 最后由 编辑
                                  #23

                                  @paul-hou 说:

                                  @alan.lgv60

                                  我是降到210W,降速約30%,PREFILL慢了近22%,真是一分電源一分速度。
                                  DEOCDE差異就小很多了。
                                  所以還是降功率比較好。

                                  应该不至于吧,我这边反复测试的结果大概是210W会有10%的性能影响。

                                  paul houP 1 条回复 最后回复
                                  0
                                  • BunseiB Bunsei

                                    @paul-hou 说:

                                    @alan.lgv60

                                    我是降到210W,降速約30%,PREFILL慢了近22%,真是一分電源一分速度。
                                    DEOCDE差異就小很多了。
                                    所以還是降功率比較好。

                                    应该不至于吧,我这边反复测试的结果大概是210W会有10%的性能影响。

                                    paul houP
                                    paul houP
                                    paul hou
                                    德高望重 劳动模范
                                    编写于 最后由 paul hou 编辑
                                    #24

                                    @Bunsei
                                    跟alan.lgv60給的數值來比較確實就差了21.x%。
                                    之前用llama.cpp就確實是只差8~10%左右而已。

                                    這代表VLLM-RADIANCE的GPU效能利用率很高,不過640的頻寬,DECODE的上限就這樣。

                                    1 条回复 最后回复
                                    0
                                    • 张光璞张 张光璞

                                      @paul-hou 说:

                                      測試傳說中的Generate an SVG of a pelican riding a bicycle.
                                      方案:https://github.com/Eliovp-BV/paiton-vllm-plugin/tree/main
                                      目前思考強度的設定是無效的,所以思考強度是被VLLM強設在MEDIUM。

                                      image.jpeg

                                      image.jpeg

                                      有种智能体在网上搜答案的感觉

                                      36ef5846-eafb-4692-8d17-baaa222514c2-image.jpeg

                                      alan.lgv60A
                                      alan.lgv60A
                                      alan.lgv60
                                      编写于 最后由 alan.lgv60 编辑
                                      #25

                                      @张光璞 我也是R9700用家,上載給大家參考一下
                                      92c38892-acc9-473e-a6a0-00ea89b48c27-image.jpeg

                                      张光璞张 Magic629M 2 条回复 最后回复
                                      0
                                      • ,terryT terry 固定了此主题
                                      • alan.lgv60A alan.lgv60

                                        @张光璞 我也是R9700用家,上載給大家參考一下
                                        92c38892-acc9-473e-a6a0-00ea89b48c27-image.jpeg

                                        张光璞张
                                        张光璞张
                                        张光璞
                                        技术大牛 劳动模范
                                        编写于 最后由 张光璞 编辑
                                        #26

                                        @alan.lgv60 说:

                                        @张光璞 我也是R9700用家,上載給大家參考一下

                                        92c38892-acc9-473e-a6a0-00ea89b48c27-image.jpeg

                                        我昨天打了补充,他搞一下没搞定的协议解析一把就过了。

                                        Magic629M 1 条回复 最后回复
                                        0
                                        • A
                                          A
                                          applejuice
                                          技术大牛 劳动模范
                                          编写于 最后由 编辑
                                          #27

                                          我手上用着3090x2
                                          看到这个帖我有冲动买 r9700

                                          paul houP kos orK 2 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组