中国电信TeleAgent星辰超级智能体:老特评测基准测试结果
-
纯粹水一把,用老特的评测模式,测试了一下中国电信TeleAgent星辰超级智能体,测试版本为v2.5.3版本。
评测一:生成一个网页表达钍基熔盐堆运行原理
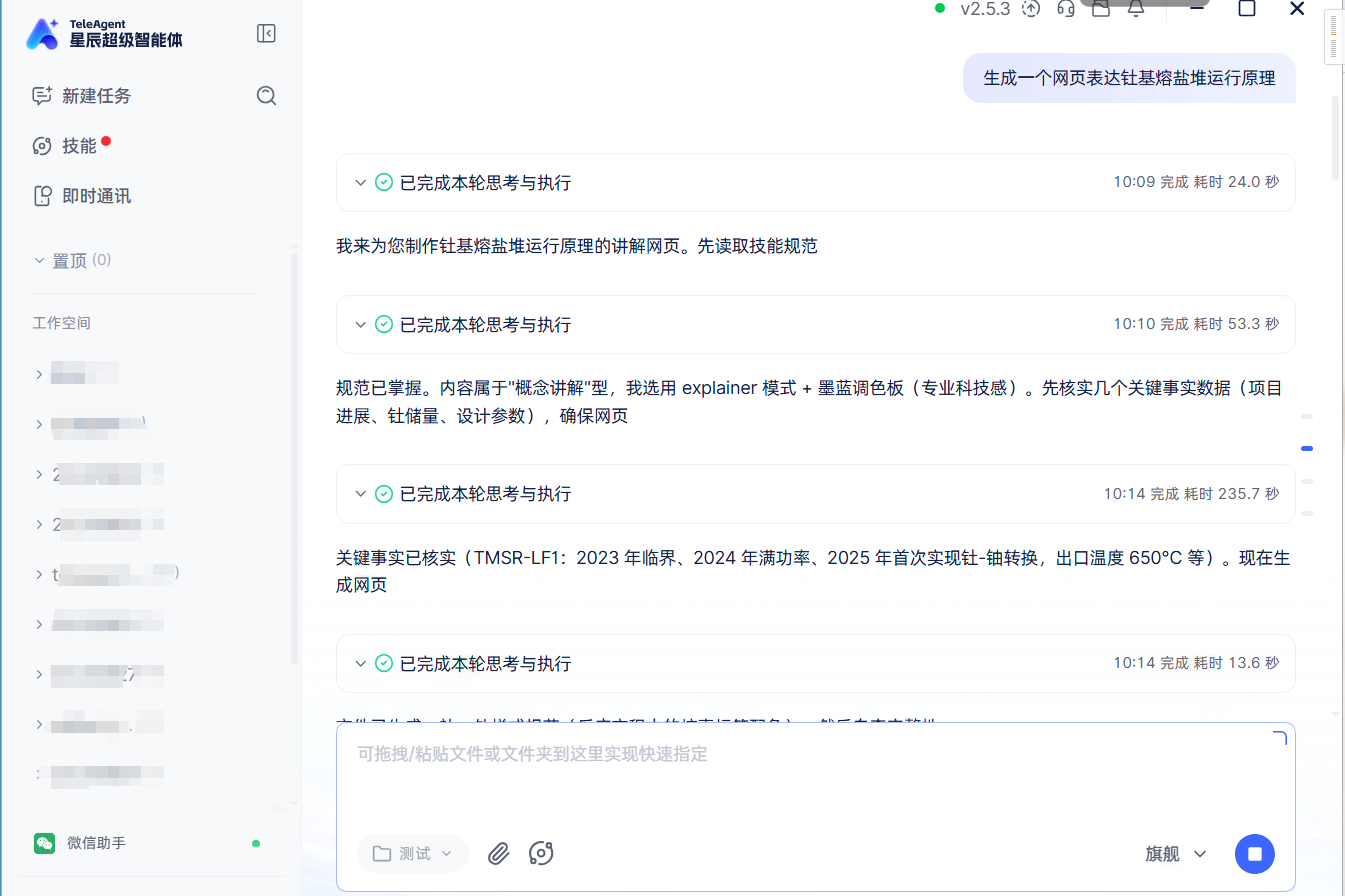
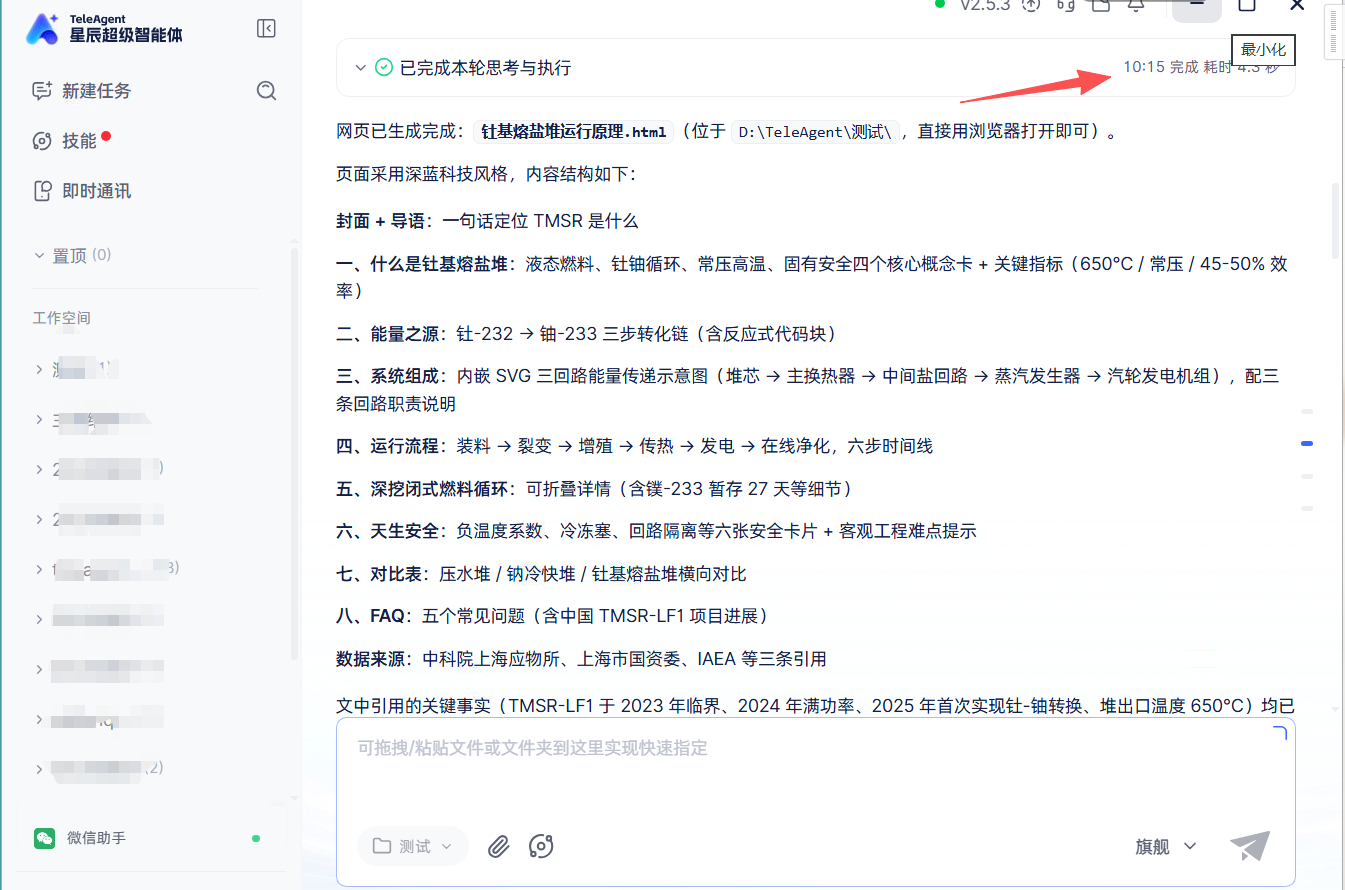
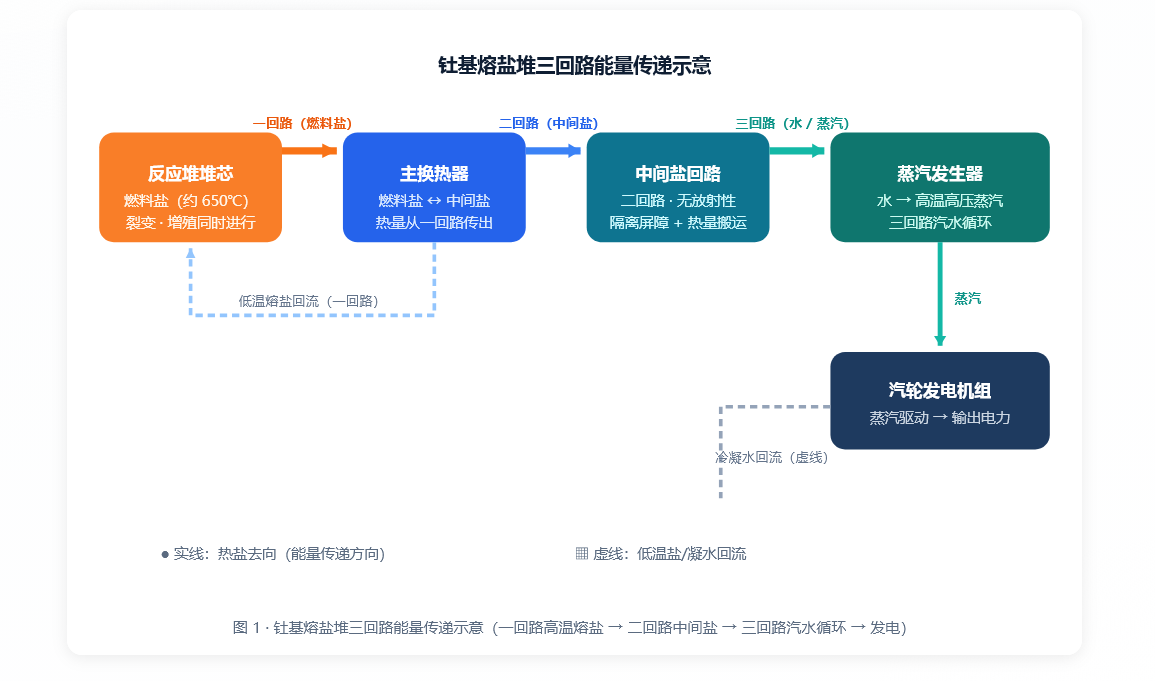
生成用的是旗舰模式,耗时约6分钟,见截图。效果一般般吧……
附件下载查看详细结果:钍基熔盐堆运行原理.html
评测二:生成一个网页表达中国传统八卦文化
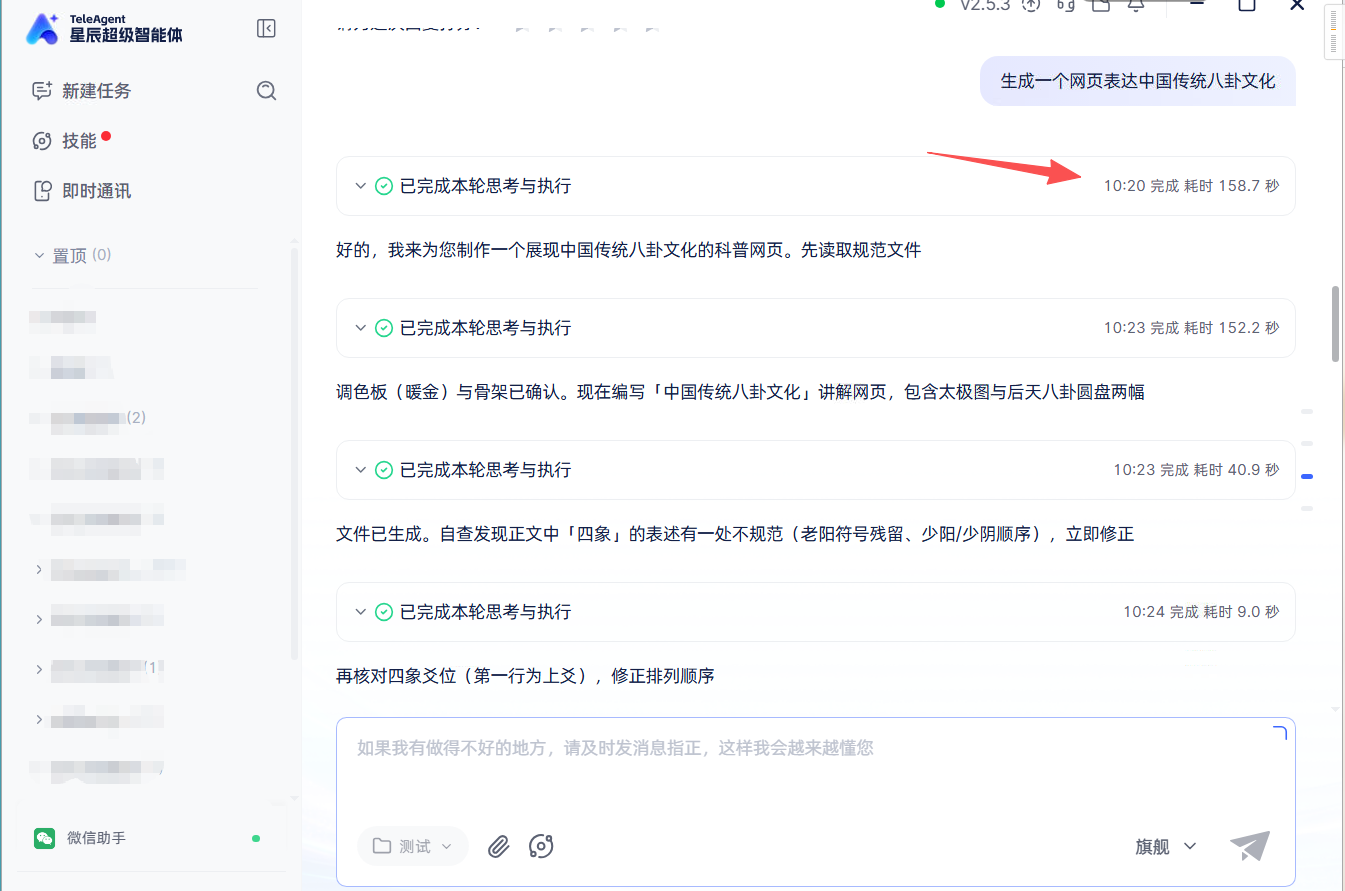
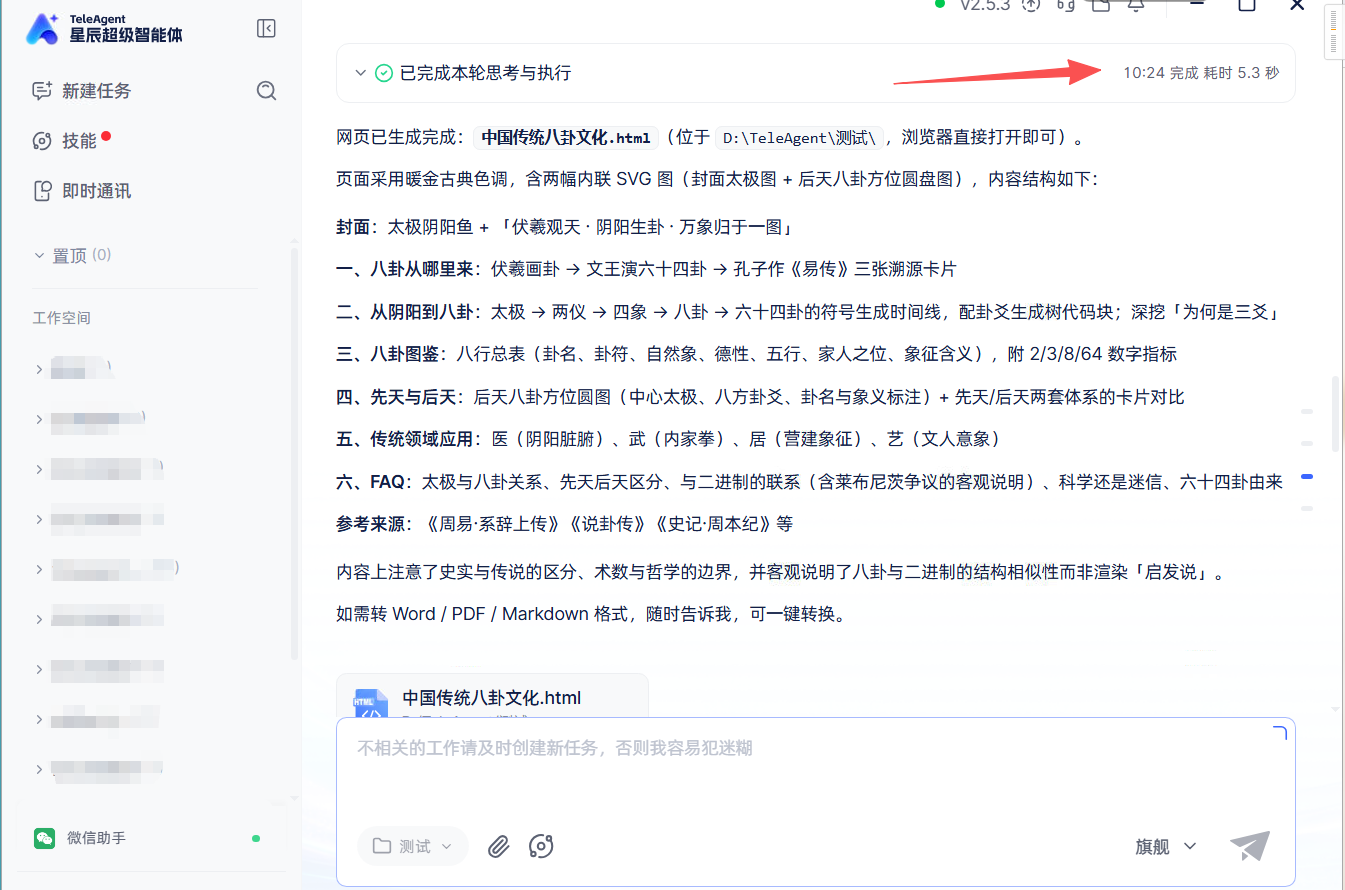
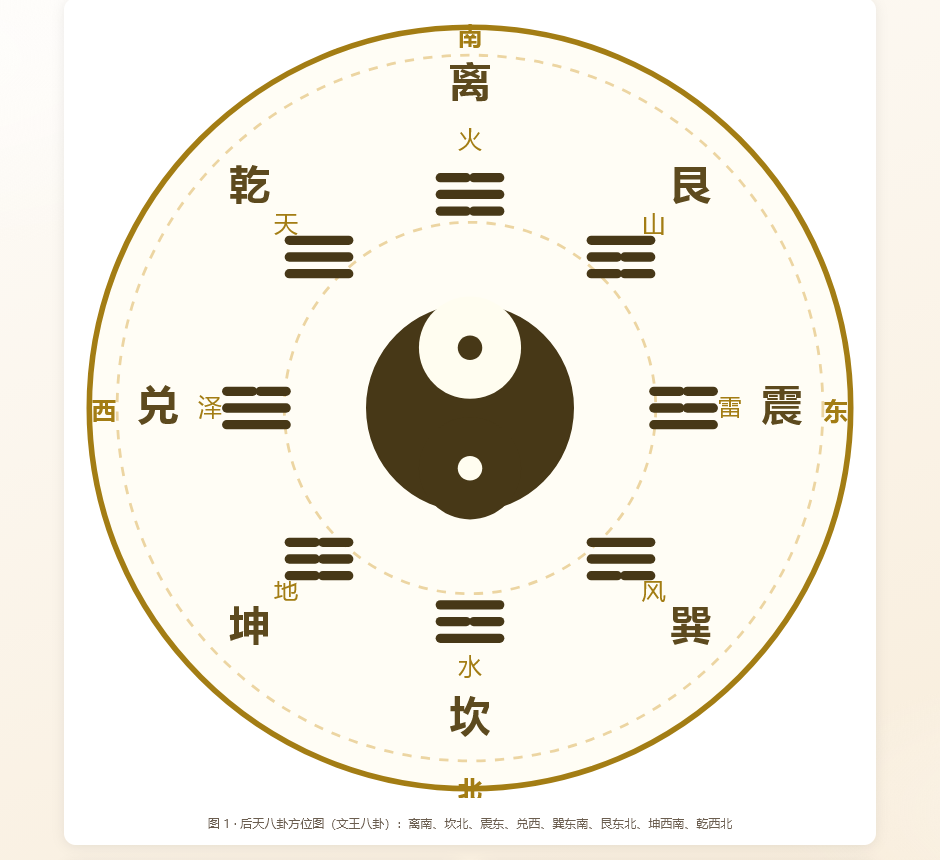
生成用的是旗舰模式,耗时约6分钟,见截图。效果好像不太行,看着有明显的错误和错位。
附件下载查看详细结果:中国传统八卦文化.html
评测三:生成一个svg表达薛定谔的猫思想实验
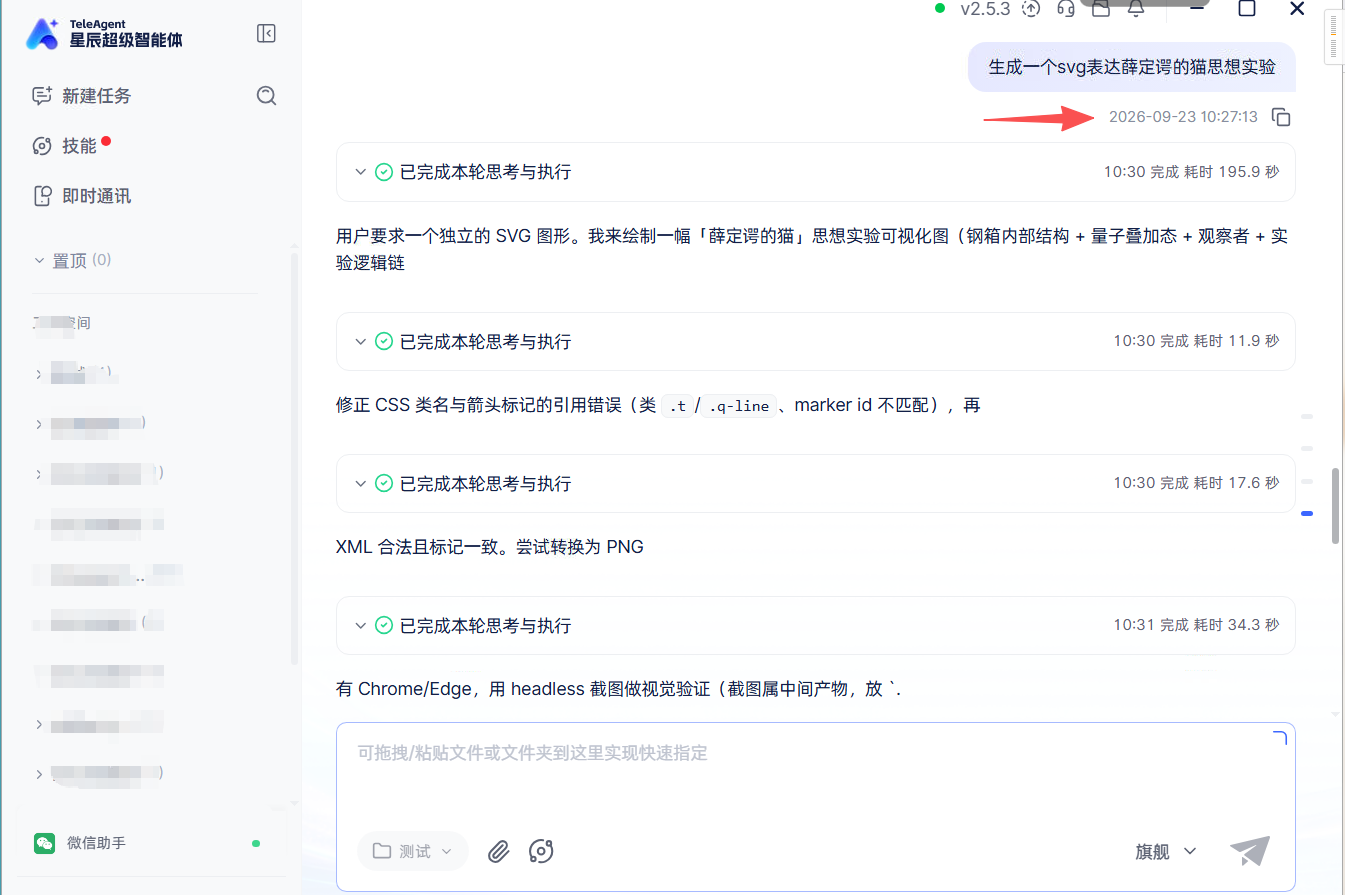
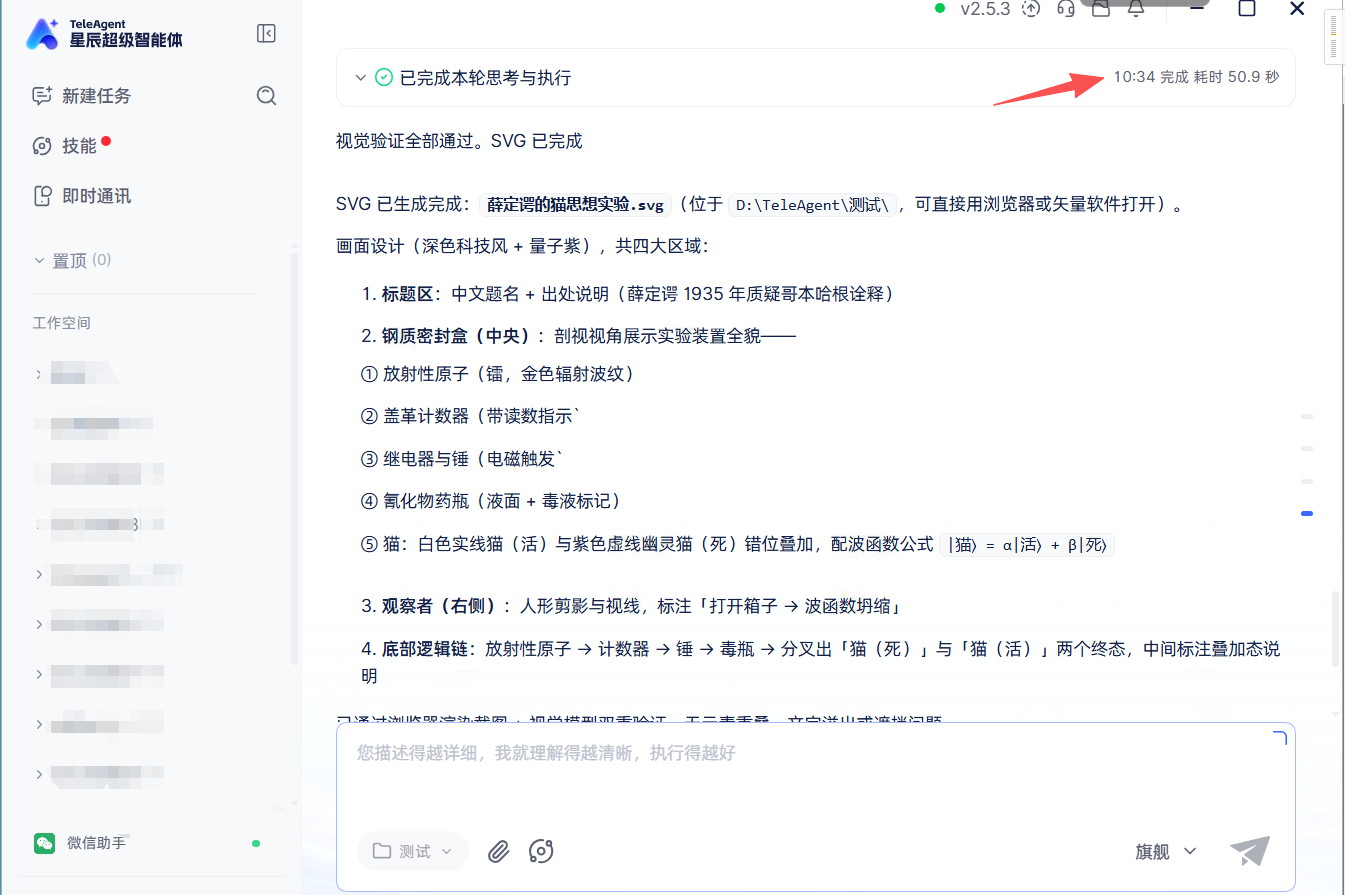
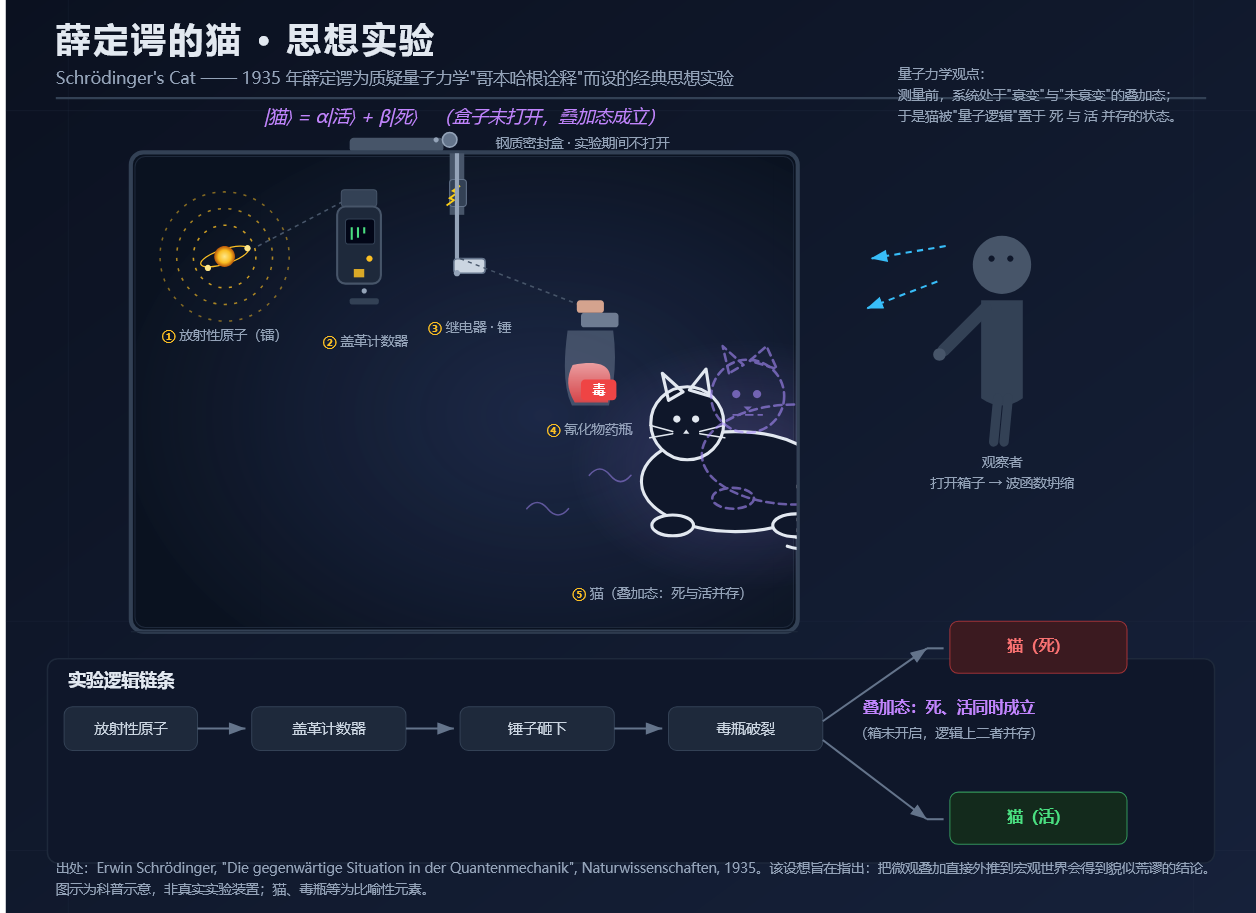
生成用的是旗舰模式,耗时约7分钟,见截图。效果好像不太行,不忍直视……
附件下载查看详细结果:
-
难怪现在信号越来越差了,精力放别的上了,不过国企干的活依然这么难看。
-
方向对,但「网页效果」单轴打分容易把结论带偏,拆三层看更清楚:
- 代码正确性:HTML/SVG 是否合法、能否独立打开。SVG 版「薛定谔的猫」翻车多半是坐标系/变换写错,属实现错误,不是「理解」错。
- 视觉布局:元素重叠/错位要靠渲染后截图做 diff,人眼一张张看会漏,也不可复现。
- 指令遵循:主题、尺寸、交互约束是否满足。
另外两点方法学:6–7 分钟一页说明是长文本一次性生成、没有迭代修正;对比时先固定「是否联网/是否调用外部工具」,否则拿一个带 agent 的产品跟裸模型比不公平。
老特那套评测的价值在可复现——网页/SVG/长文各固定几个 prompt、同一模式跑,出评分表,结论才硬。
-
楼主开宗明义, 说得很明白了. 哈哈