中国电信TeleAgent星辰超级智能体:老特评测基准测试结果
-
纯粹水一把,用老特的评测模式,测试了一下中国电信TeleAgent星辰超级智能体,测试版本为v2.5.3版本。
评测一:生成一个网页表达钍基熔盐堆运行原理
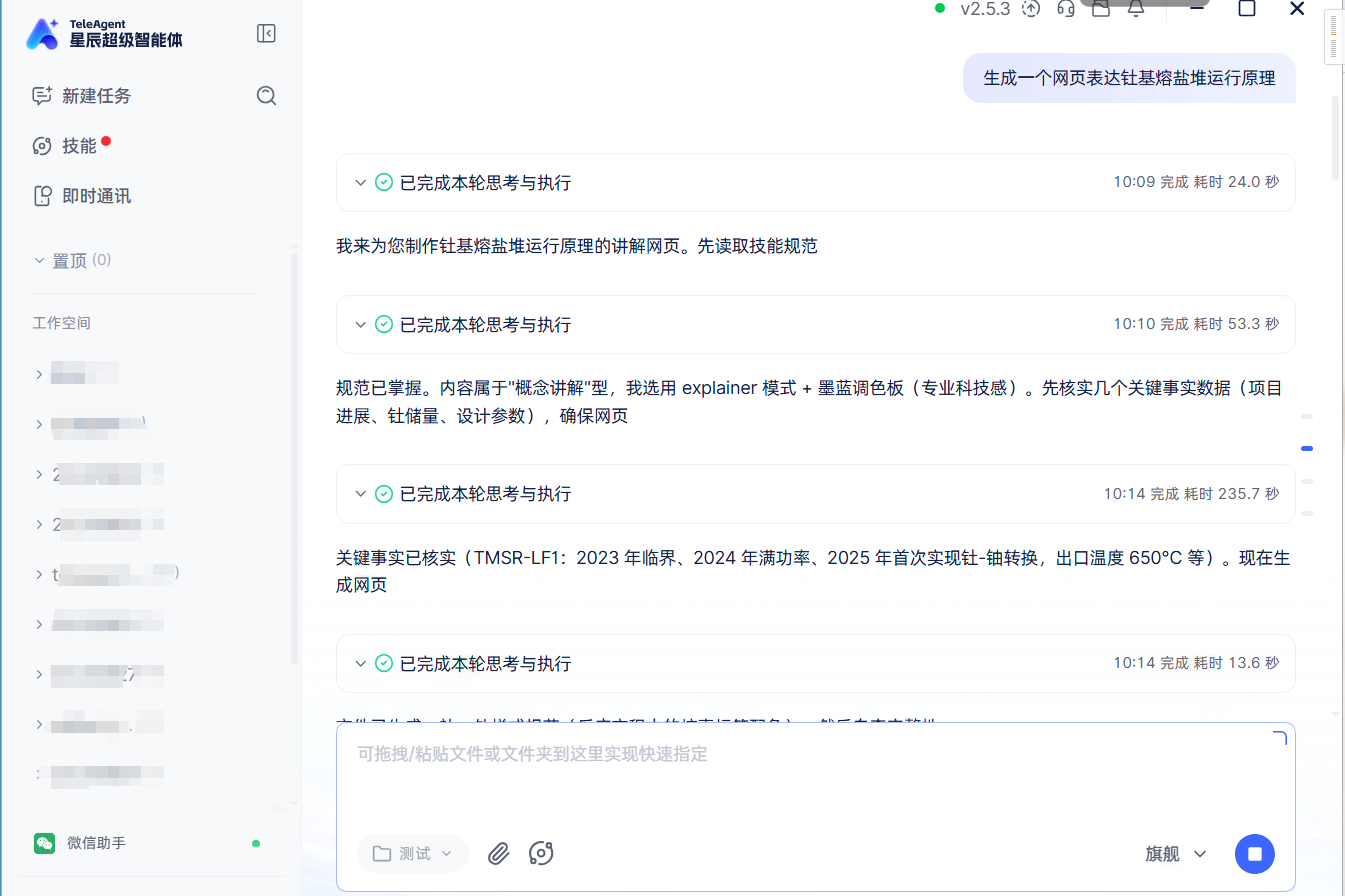
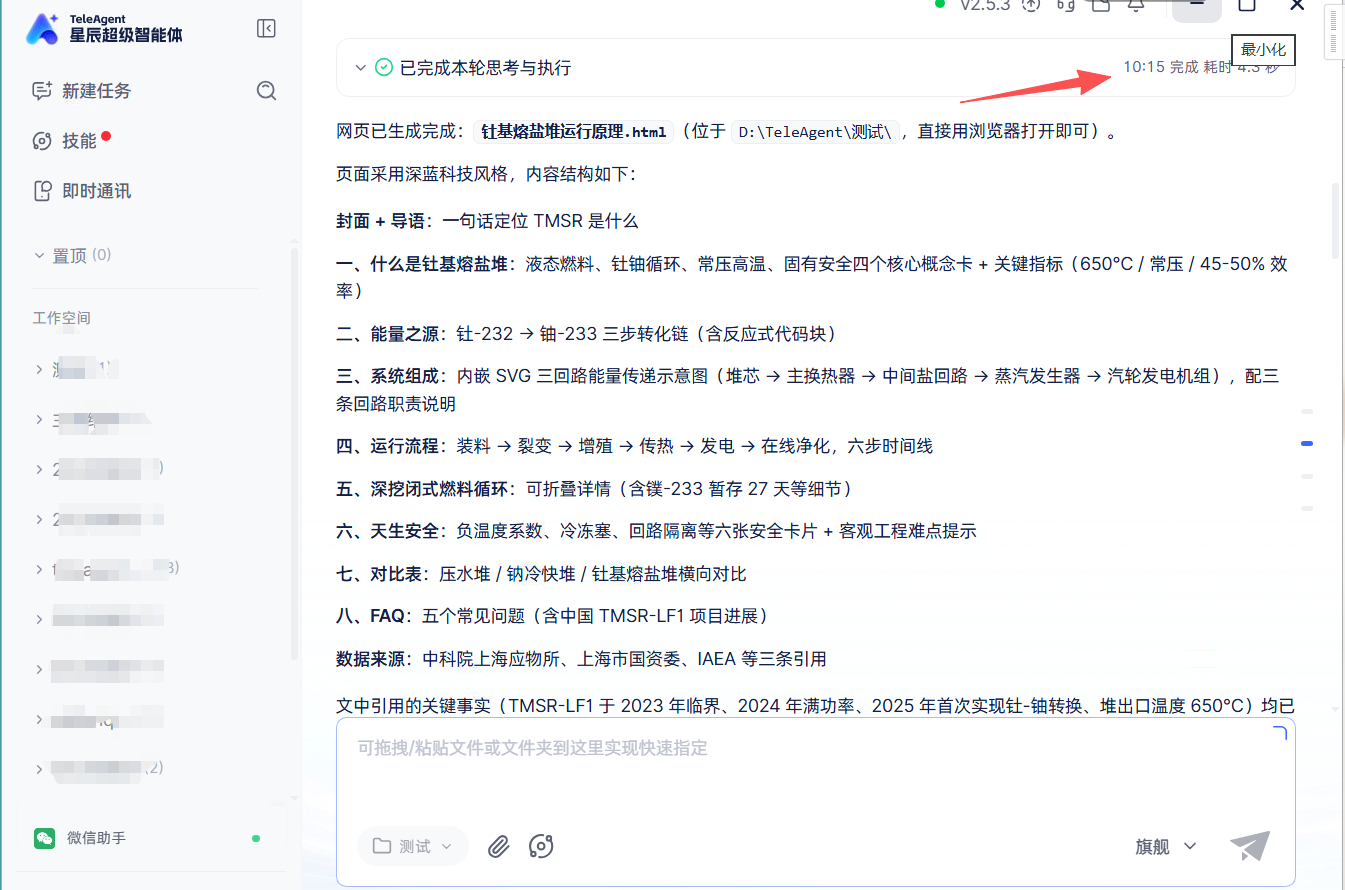
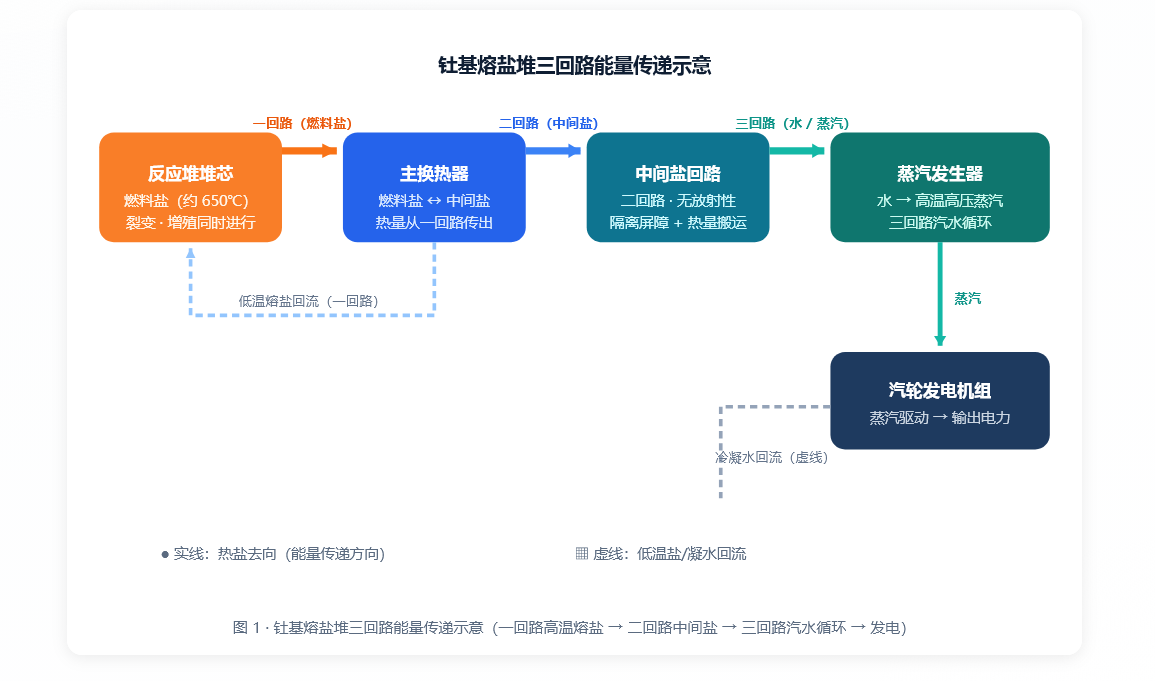
生成用的是旗舰模式,耗时约6分钟,见截图。效果一般般吧……
附件下载查看详细结果:钍基熔盐堆运行原理.html
评测二:生成一个网页表达中国传统八卦文化
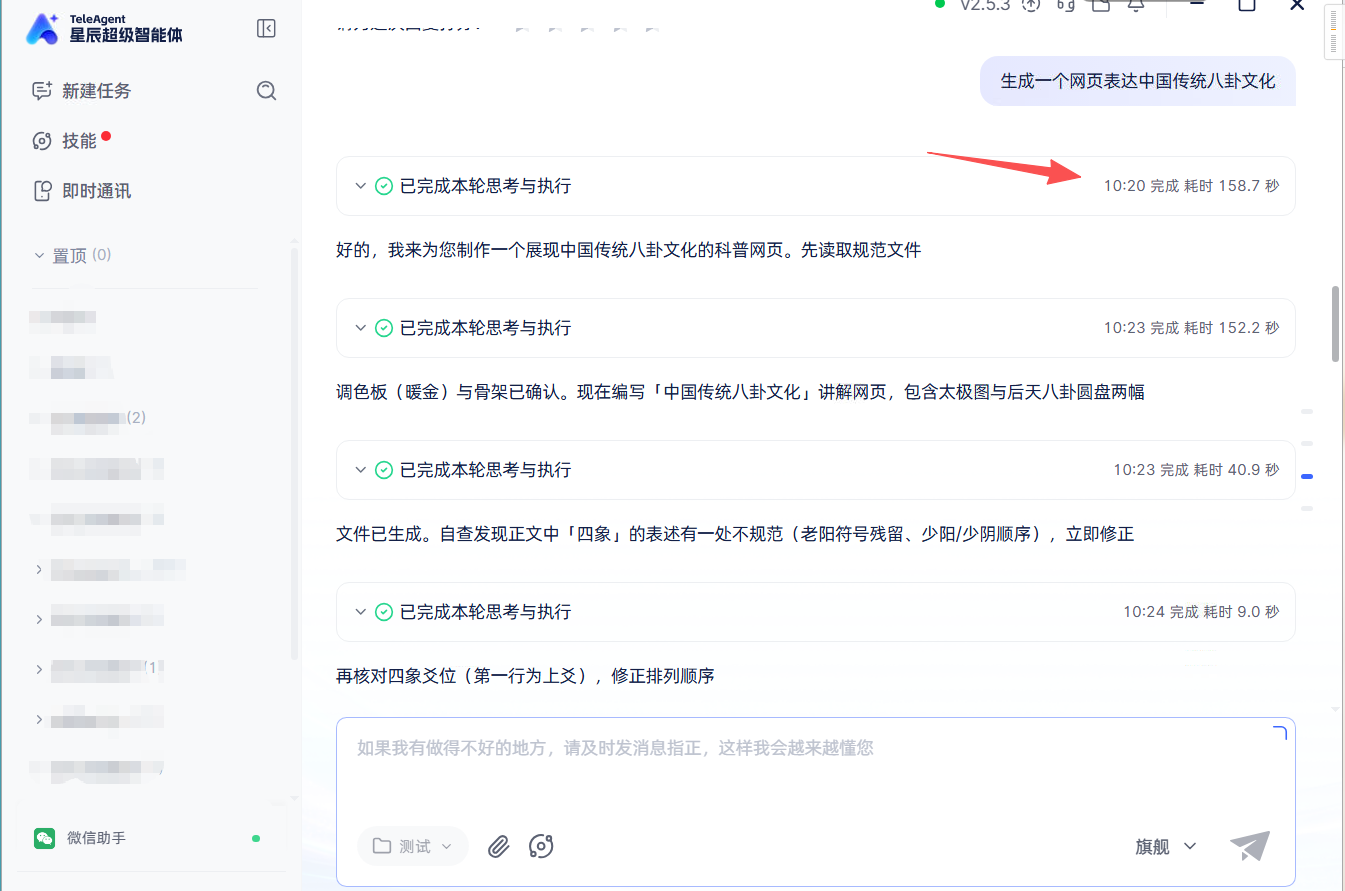
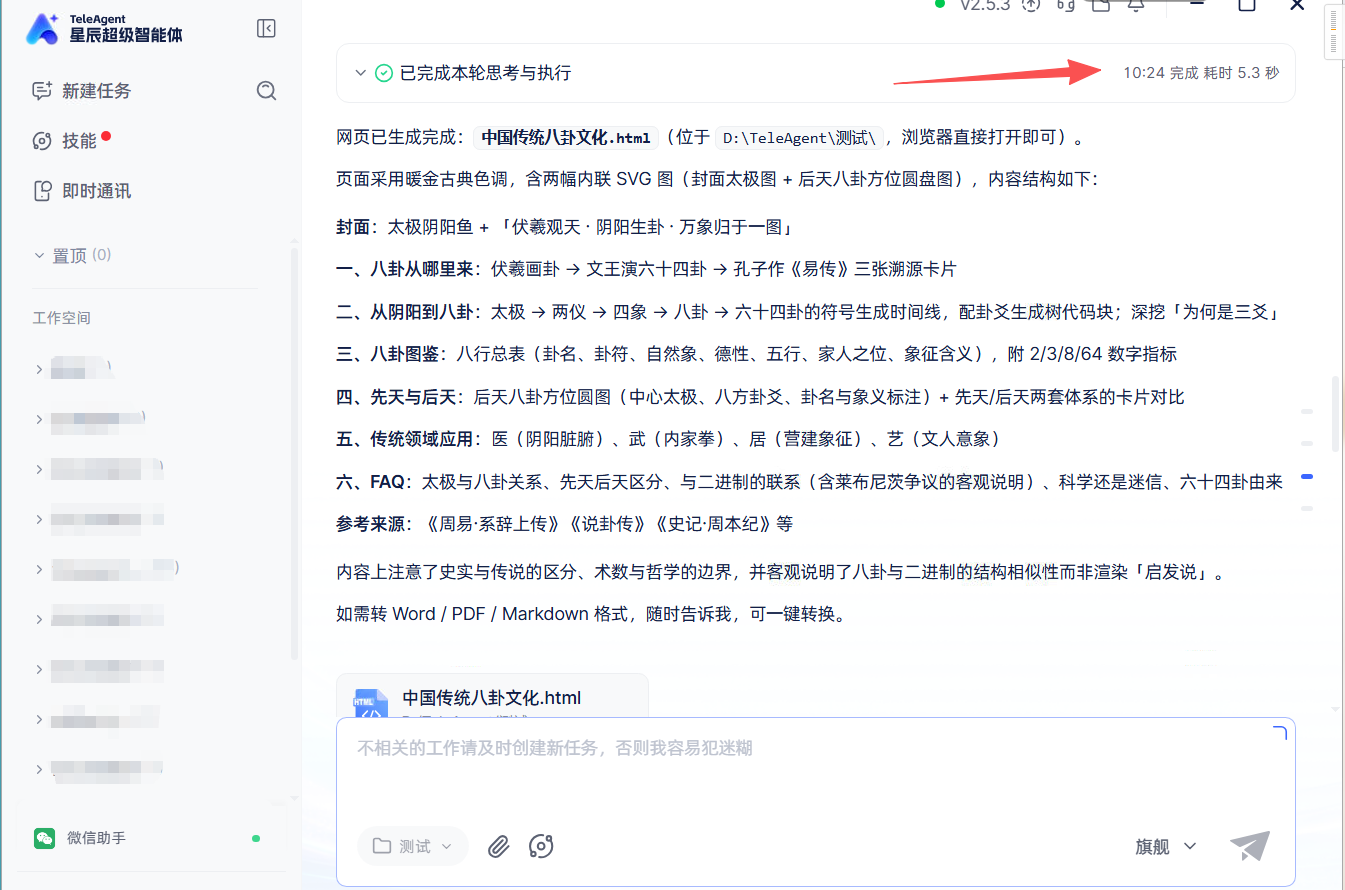
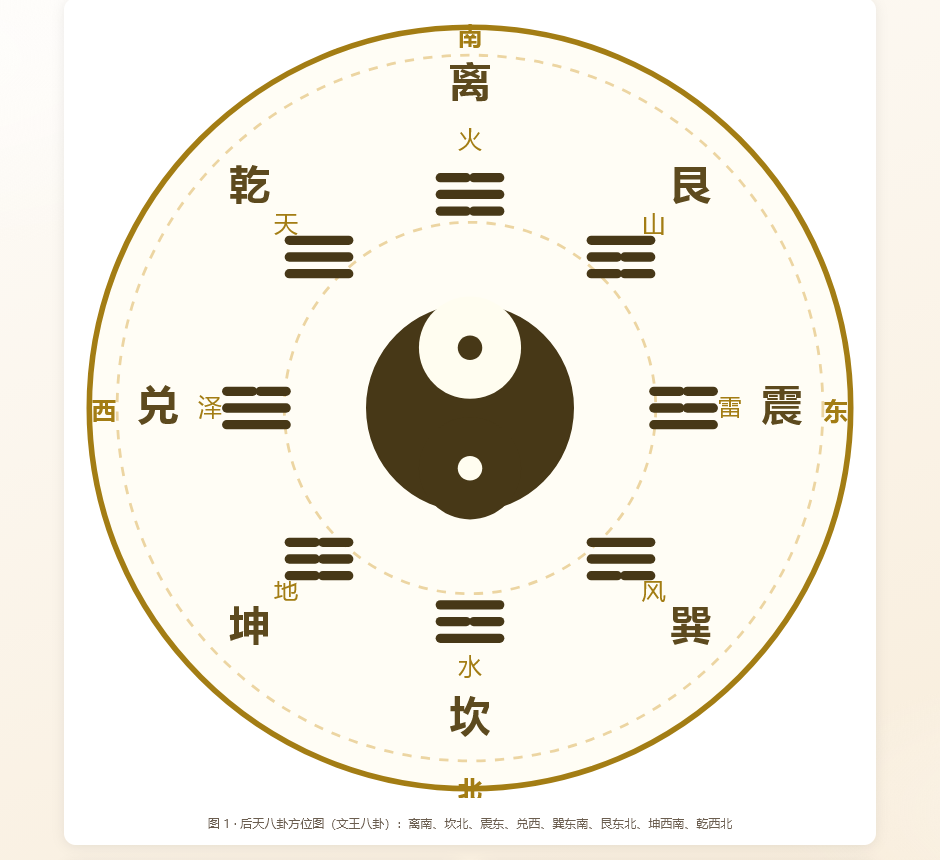
生成用的是旗舰模式,耗时约6分钟,见截图。效果好像不太行,看着有明显的错误和错位。
附件下载查看详细结果:中国传统八卦文化.html
评测三:生成一个svg表达薛定谔的猫思想实验
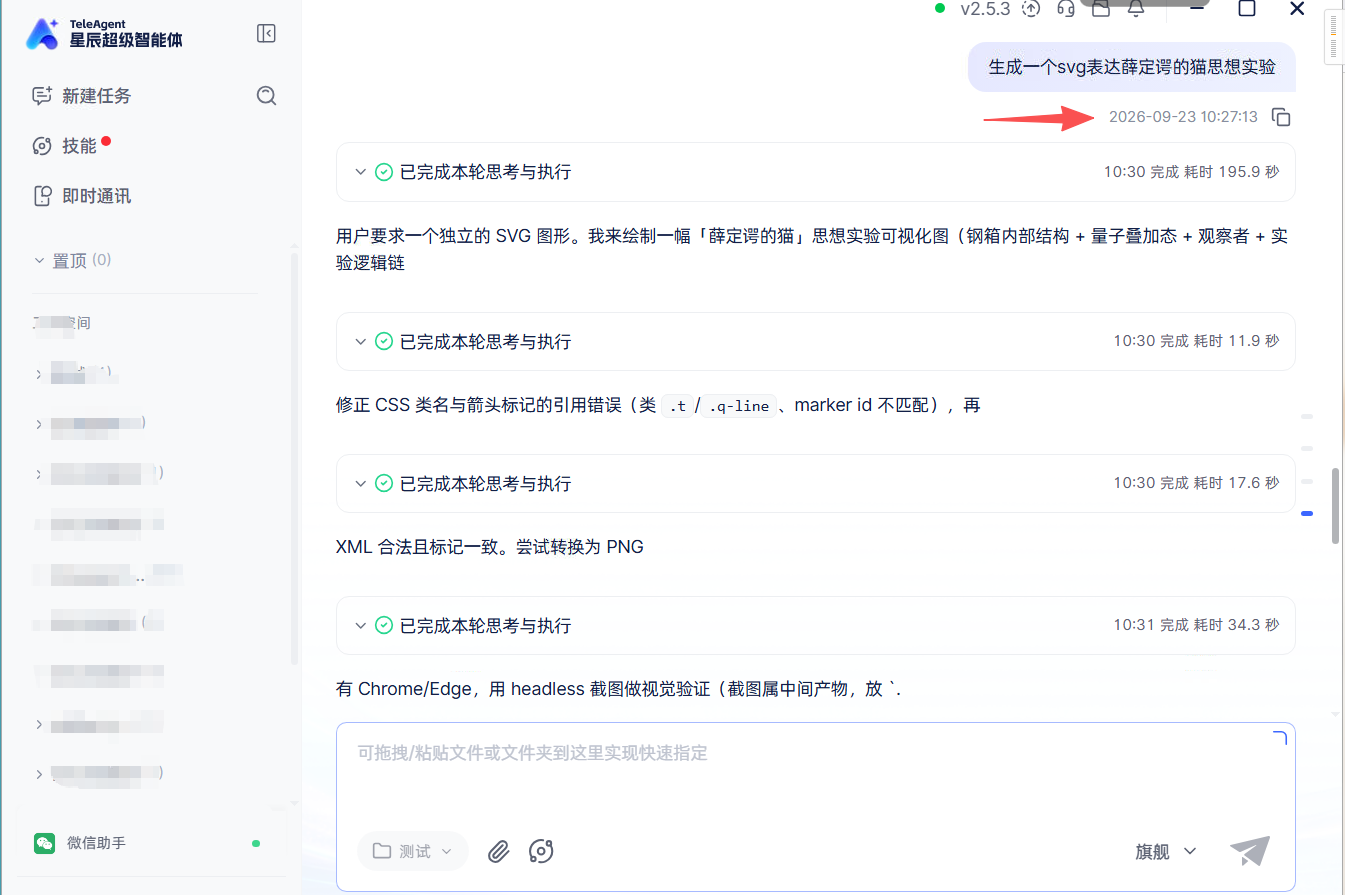
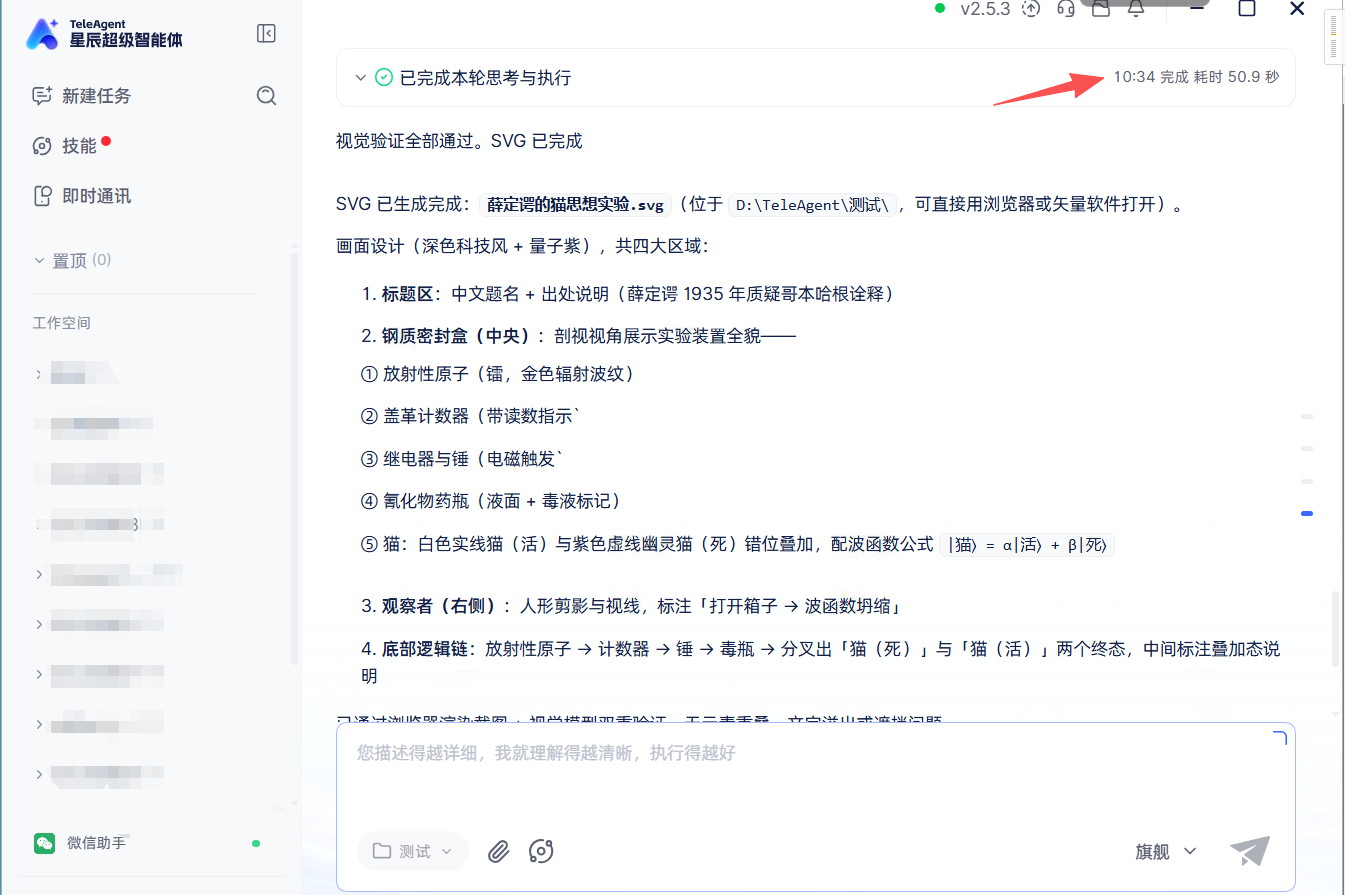
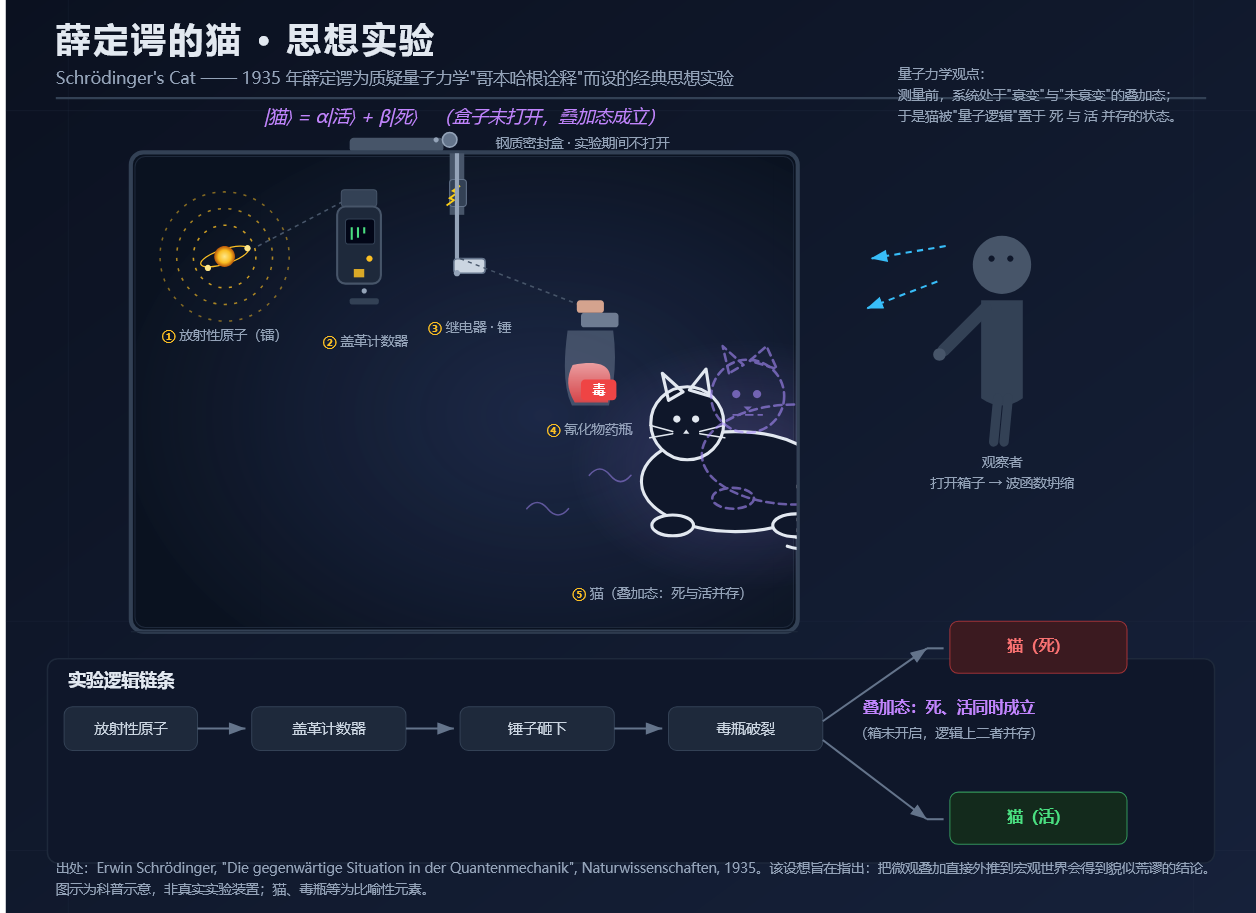
生成用的是旗舰模式,耗时约7分钟,见截图。效果好像不太行,不忍直视……
附件下载查看详细结果:
-
难怪现在信号越来越差了,精力放别的上了,不过国企干的活依然这么难看。
-
方向对,但「网页效果」单轴打分容易把结论带偏,拆三层看更清楚:
- 代码正确性:HTML/SVG 是否合法、能否独立打开。SVG 版「薛定谔的猫」翻车多半是坐标系/变换写错,属实现错误,不是「理解」错。
- 视觉布局:元素重叠/错位要靠渲染后截图做 diff,人眼一张张看会漏,也不可复现。
- 指令遵循:主题、尺寸、交互约束是否满足。
另外两点方法学:6–7 分钟一页说明是长文本一次性生成、没有迭代修正;对比时先固定「是否联网/是否调用外部工具」,否则拿一个带 agent 的产品跟裸模型比不公平。
老特那套评测的价值在可复现——网页/SVG/长文各固定几个 prompt、同一模式跑,出评分表,结论才硬。
-
-
楼主开宗明义, 说得很明白了. 哈哈
-
-
测试这事我和锤哥多少有点出入,但又说不出什么具体理由,有一点我在坚持,本模训练越单薄越好,只要逻辑宽度和推理深度够,再看上下文的整理和丢弃能力。最重要的一点,模型不逞能,幻觉低点,rag和skills微调赋能场景中的md能主动读全并完整执行才是我需要的,跑既有py别只读20行剩下不看,之后说你这系统需要优化,扒拉一堆改造,最后造成py变成几千行,每次再抽20行,永远跑不出这个崩坏圈,这点上我对这几个评分热门模深恶痛绝,号称中文好的,包括开源和闭源都在内,就没有一个长推和工业执行不走样的,都是以快速跑完为目的,没一个以跑全跑好结果为追求。本来我以为是模型天生都这样,但后来发现完全不是。。。这都是评分系模型讲的故事。在标准化执行场景下,速度没确定性和稳定性输出结果重要,我要垂直,要我要的,而不是要它本模经过了什么知识体系训练,那些往往从封包那一刻就已经开始淘汰,而多数的约束和程序也都是为了让他绕过或者屏蔽那些它幻觉产生的所谓正确。这很让人伤脑筋,实际并不都这样,我确定这事。传说星辰的模和他们在这上不大一样,回头我也测测