跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!

不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了!

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
rtx3090strataqwen-flash
103 帖子 27 发布者 4.3k 浏览 5 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Tony WangT Tony Wang

    Qwen3.8-Flash-Next 激活参数只有6B, 激活参数加载后, decode 跑到 100 应该没什么问题.

    但问题是加载和TTFT, 我想可能Coding 路由的专家层比较固定, 所以表现更好. 而聊天的路由经常变化, 需要加载时间更长. 总体表现就差一点儿.

    @johnnybegood TTFT的速度怎么样, 感觉能干活吗?

    johnnybegoodJ
    johnnybegoodJ
    johnnybegood
    超凡大师
    编写于 最后由 编辑
    #6

    @Tony-Wang 没问题,速度很快。如果是多轮有缓存命中的话,非常快。

    1 条回复 最后回复
    1
    • kos orK kos or

      今晚有看到 "最低 8G 視訊記憶體!就能跑 Qwen3.8-Flash-Next 大模型!125B 塞進記憶體,支援N卡、A卡" 晚點試試,
      Strata 怎麼有辦法跑這麼快?

      RTX 5070 Ti 16GB 更新 第一批速度數字(初測)

      • 66 prompt tokens → 200 輸出 tokens,3.28 s → 約 61 tok/s
      • 與官方宣稱(RTX 5070 12GB 上 IQ3_XXS 短聊天 62 tok/s)幾乎一致 —— 用 16GB 卡 + MTP + vision,沒有因為容器化而掉速

      目標LLM : Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS.gguf (76GB)
      我選擇GSQ-RCO 是因為根據Qwen3.8-27B的使用經驗, ISTA-DasLab的在量化壓縮的效果表現非常傑出
      https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF

      johnnybegoodJ
      johnnybegoodJ
      johnnybegood
      超凡大师
      编写于 最后由 johnnybegood 编辑
      #7

      @kos-or 他github上面有解释,优化了专家和内存的分配算法,附件是它具体的Paper。Strata-Paper.pdf

      1 条回复 最后回复
      1
      • David ChenD
        David ChenD
        David Chen
        德高望重 劳动模范
        编写于 最后由 编辑
        #8

        8G????!!!!!!!!!!看來我的3060 12G不只能做動畫了,晚點驗證看看

        benson PlaybenB 1 条回复 最后回复
        0
        • ,terryT terry 固定了此主题
        • M
          M
          marsempire
          编写于 最后由 编辑
          #9

          啥,那qwen3.8-27b就这样被淘汰了?

          johnnybegoodJ kos orK 2 条回复 最后回复
          1
          • M marsempire

            啥,那qwen3.8-27b就这样被淘汰了?

            johnnybegoodJ
            johnnybegoodJ
            johnnybegood
            超凡大师
            编写于 最后由 编辑
            #10

            @marsempire 那倒不是, 这个很难说, 还是给大家多一个选择, 至于适不适合自己, 还是得自己去试,每个人工作环境和需求都不一样。 之前老特也做过相关的测试, 他就还是觉得27B好用的。

            1 条回复 最后回复
            0
            • stxpnetS
              stxpnetS
              stxpnet
              超凡大师
              编写于 最后由 编辑
              #11

              突破是正常的,有AI加持 + 社区 共享精神,只会越来越快,越来越准.

              双卡3090 PCIE 4.0 16X/16X

              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
              kos orK 1 条回复 最后回复
              1
              • 鍾子揚鍾
                鍾子揚鍾
                鍾子揚
                编写于 最后由 编辑
                #12

                r9700還在癡癡的等~QQ

                kos orK J 2 条回复 最后回复
                0
                • 鍾子揚鍾 鍾子揚

                  r9700還在癡癡的等~QQ

                  kos orK
                  kos orK
                  kos or
                  超凡大师
                  编写于 最后由 编辑
                  #13

                  @鍾子揚

                  7900 XTX 也在苦等中 ~~~

                  1 条回复 最后回复
                  0
                  • stxpnetS stxpnet

                    突破是正常的,有AI加持 + 社区 共享精神,只会越来越快,越来越准.

                    kos orK
                    kos orK
                    kos or
                    超凡大师
                    编写于 最后由 编辑
                    #14

                    @stxpnet said:

                    突破是正常的,有AI加持 + 社区 共享精神

                    最近出現很多 神人級進化, 看來很多資深工程師有了一個AI團隊後 能做出大事

                    1 条回复 最后回复
                    0
                    • johnnybegoodJ johnnybegood

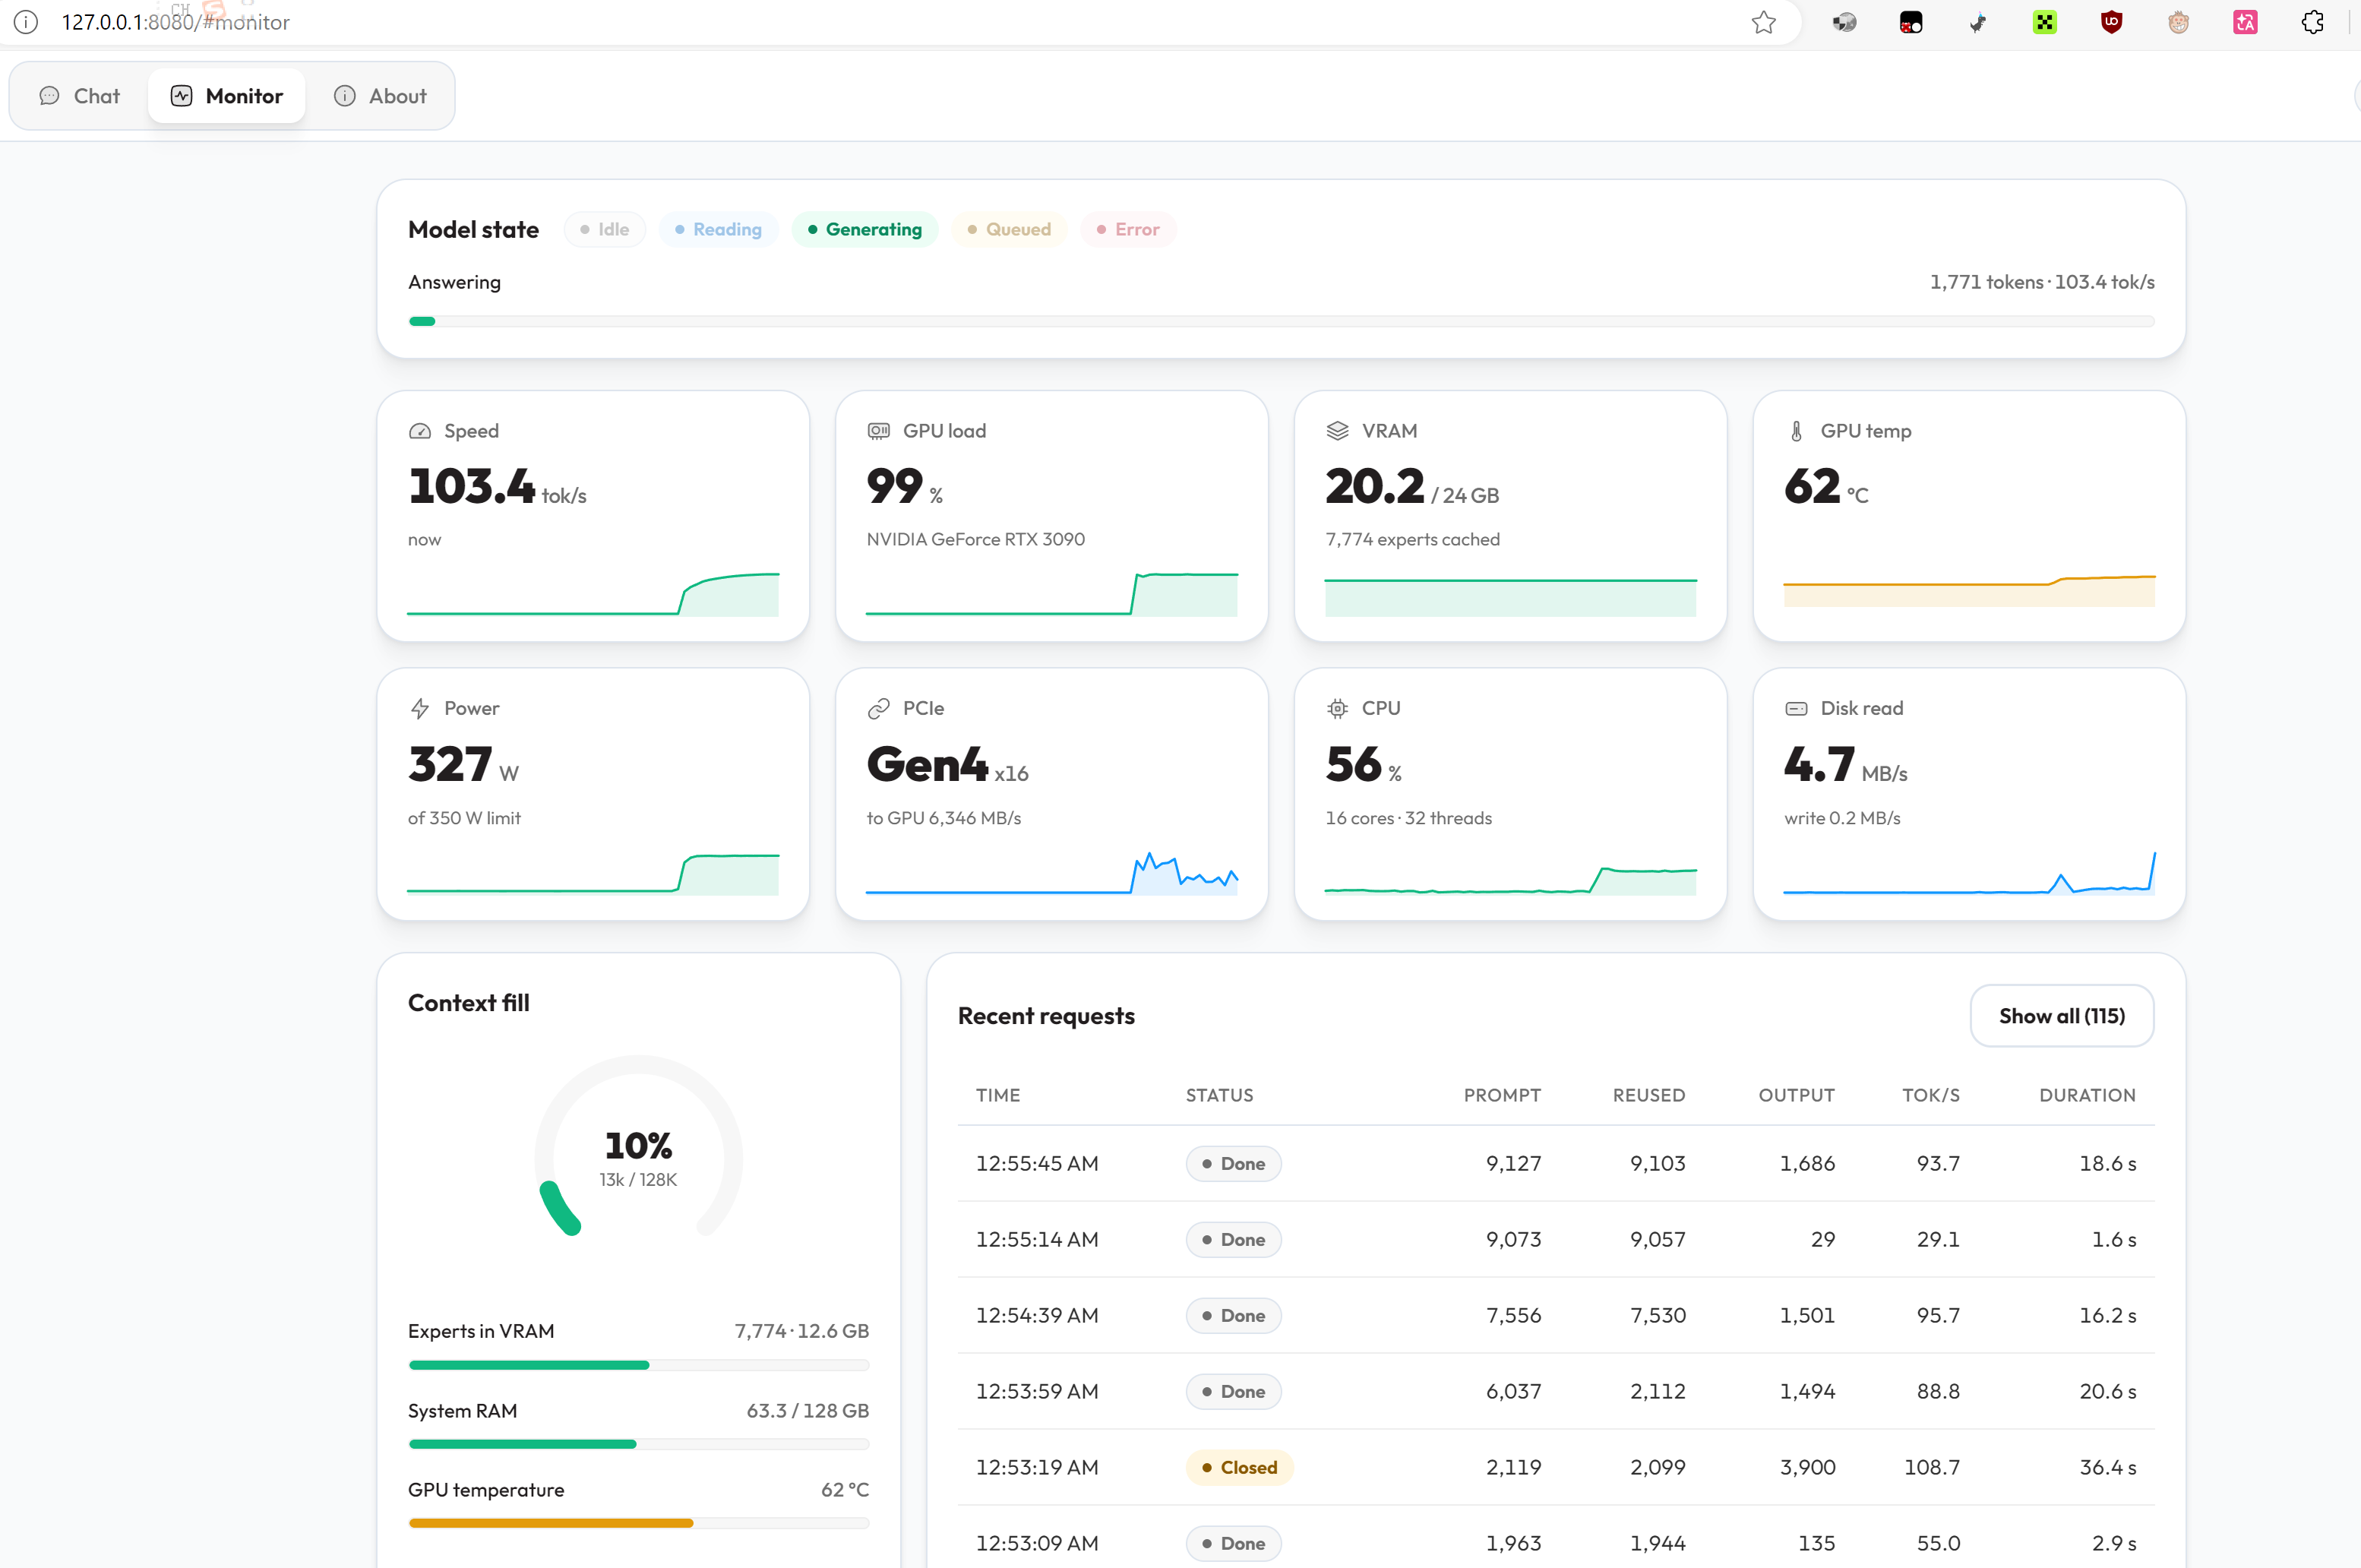
                      我自己也跑了跑 ,论坛里面已经有兄弟发了类似的帖子 https://lcz.me/topic/1987
                      只是他用的3080, 我就懒得详细弄了, 我跑的参数跟他不太一样, 只写几行提示, 感兴趣的兄弟自己去试验:

                      关键词:
                      1、单卡 3090 24G
                      2、64G 内存以上
                      3、 项目地址 https://github.com/Niko1221/Strata
                      4、 模型选用 swift-Qwen3.8 Flash Next IQ3_XXS 特别优化、无损接近Q4
                      5、上下文128K, Coding > 100tok/s , Chat> 60tok/s

                      多了不说了, 只贴一张图。3090真是潜力无限,我瘫坐在椅子上。
                      100tg.png

                      安装

                      环境要求

                      • 显卡: NVIDIA RTX 30、40 或 50 系列,显存 12 GB 及以上
                      • 内存: 足够装下你选择的模型大小
                      • 磁盘: 约 80 GB 空闲空间 —— 用固态硬盘首次启动会快很多
                      • 系统: Windows 10/11 或 Linux

                      唯一需要你自己装的是当前版本的 NVIDIA 驱动。其余全部由脚本自动装好。

                      Windows

                      1. 下载本项目并解压(或 git clone)。
                      2. 双击 START-HERE.bat。
                      3. 回答几个问题,或一路按回车采用推荐选项。
                      4. 下载全部内容(模型约 70 GB,首次耗时较久,支持断点续传)并启动。
                      5. 浏览器打开 http://127.0.0.1:8080。

                      首次启动会很慢,可能 1–3 分钟无响应,属正常现象,不要关窗口。

                      下次启动

                      再双击 START-HERE.bat 即可,不会重复下载。关闭窗口即停止模型。

                      更新

                      解压新版或 git pull 后运行 START-HERE.bat。模型文件存在
                      Strata-data 文件夹,不会重复下载。

                      Linux

                      运行 ./setup.sh

                      Ben LeeB
                      Ben LeeB
                      Ben Lee
                      超凡大师
                      编写于 最后由 编辑
                      #15

                      @johnnybegood 大侠你有没有不同上下文的prefill和decode数字?

                      johnnybegoodJ 1 条回复 最后回复
                      0
                      • Ben LeeB Ben Lee

                        @johnnybegood 大侠你有没有不同上下文的prefill和decode数字?

                        johnnybegoodJ
                        johnnybegoodJ
                        johnnybegood
                        超凡大师
                        编写于 最后由 johnnybegood 编辑
                        #16

                        @Ben-Lee 测的比较乱,没整理,我一直是128k上下文没变,记得prefill最高1100多,最低时候三四百。我休假出来了玩了,估计没空测别的啦。

                        1 条回复 最后回复
                        0
                        • M marsempire

                          啥,那qwen3.8-27b就这样被淘汰了?

                          kos orK
                          kos orK
                          kos or
                          超凡大师
                          编写于 最后由 编辑
                          #17

                          @marsempire said:

                          啥,那qwen3.8-27b就这样被淘汰了?

                          還在測試中, 如果CPU夠強悍, 能同時支援兩張單卡同時跑兩個Qwen3.8-Flash-NEXT
                          不排除是高於Qwen3.8-27B 更佳的選擇

                          1 条回复 最后回复
                          0
                          • stxpnetS
                            stxpnetS
                            stxpnet
                            超凡大师
                            编写于 最后由 编辑
                            #18

                            128K其实也够用了,不过我觉得二者的用途是不同的。 3.8 FLASH似乎适合规划,27B DENSE似乎适合于专门编程,最好就是各配两张显卡。

                            双卡3090 PCIE 4.0 16X/16X

                            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                            1 条回复 最后回复
                            0
                            • M
                              M
                              marsempire
                              编写于 最后由 编辑
                              #19

                              刚装好玩了一下,感觉可以啊,4080S 32g加64g内存,能70-90tok/s,有时跑到100多。

                              关键似乎稍长的任务,显卡温度没那么高了,风扇不像跑27b那样频繁呼呼响了,不知道是不是错觉……

                              1 条回复 最后回复
                              0
                              • kos orK
                                kos orK
                                kos or
                                超凡大师
                                编写于 最后由 kos or 编辑
                                #20

                                RTX 5070 Ti 16GB 上下文可以直接開到 256K, 應該是用到 RAM

                                不知道為何它decode是越來越快, 可能MTP的因素

                                [strata] reading the prompt: 9,876 tokens, 10 s so far
                                [strata] reading the prompt: 8,124 of 9,876 tokens, 15 s so far
                                [strata] reading the prompt: 9,871 of 9,876 tokens, 20 s so far
                                [strata] thinking: 48 of max 32768 tokens, 72.2 tok/s, 21 s
                                [strata] thinking: 119 of max 32768 tokens, 69.8 tok/s, 22 s
                                [strata] thinking: 203 of max 32768 tokens, 74.6 tok/s, 23 s
                                [strata] thinking: 296 of max 32768 tokens, 79.1 tok/s, 25 s
                                [strata] thinking: 404 of max 32768 tokens, 84.8 tok/s, 26 s
                                [strata] thinking: 505 of max 32768 tokens, 87.5 tok/s, 27 s
                                [strata] thinking: 612 of max 32768 tokens, 90.2 tok/s, 28 s
                                [strata] thinking: 719 of max 32768 tokens, 92.3 tok/s, 29 s
                                [strata] thinking: 811 of max 32768 tokens, 92.2 tok/s, 30 s
                                [strata] thinking: 918 of max 32768 tokens, 93.5 tok/s, 31 s
                                [strata] thinking: 1031 of max 32768 tokens, 95.2 tok/s, 32 s
                                [strata] thinking: 1131 of max 32768 tokens, 95.5 tok/s, 33 s

                                ? johnnybegoodJ 2 条回复 最后回复
                                0
                                • huaye XUH
                                  huaye XUH
                                  huaye XU
                                  编写于 最后由 编辑
                                  #21
                                  此主題已被删除!
                                  1 条回复 最后回复
                                  0
                                  • huaye XUH
                                    huaye XUH
                                    huaye XU
                                    编写于 最后由 编辑
                                    #22

                                    哦买噶,我的5090 laptop笔记本跑这个居然可以跑满256K上下文,40-50 tok/s,前两天我还在为128k,40toks以上,可劲折腾27b。

                                    1 条回复 最后回复
                                    0
                                    • M
                                      M
                                      marsempire
                                      编写于 最后由 编辑
                                      #23

                                      分别用这个和27b做了几道题,这个占据明显智商优势,好,以后做大项目决定用这个了……

                                      只有一个问题,求无审查版本 😀

                                      huaye XUH 1 条回复 最后回复
                                      0
                                      • M marsempire

                                        分别用这个和27b做了几道题,这个占据明显智商优势,好,以后做大项目决定用这个了……

                                        只有一个问题,求无审查版本 😀

                                        huaye XUH
                                        huaye XUH
                                        huaye XU
                                        编写于 最后由 huaye XU 编辑
                                        #24

                                        @marsempire 有无审查版的,兄弟。我就试了画鹈鹕,鹈鹕有点智障。https://huggingface.co/orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF

                                        M 1 条回复 最后回复
                                        0
                                        • huaye XUH huaye XU

                                          @marsempire 有无审查版的,兄弟。我就试了画鹈鹕,鹈鹕有点智障。https://huggingface.co/orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF

                                          M
                                          M
                                          marsempire
                                          编写于 最后由 编辑
                                          #25

                                          @huaye-XU 这个普通的无swift的会不会速度变慢,再等等好了,等待更好的……
                                          每试一个模型都要下几十g,这种更是近乎上百G……我怕我的ssd太短命……

                                          huaye XUH 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组