跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. Strata v0.1.30 支援 RX7900 XTX / AI Pro R9700 跑 Qwen3.8-Flash-NEXT

Strata v0.1.30 支援 RX7900 XTX / AI Pro R9700 跑 Qwen3.8-Flash-NEXT

已定时 已固定 已锁定 已移动 热议 LLM讨论区
strata7900xtxqwen-flash
36 帖子 14 发布者 1.9k 浏览 2 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    超凡大师
    编写于 最后由 kos or 编辑
    #1

    Strata v0.1.30 : An AMD Radeon RX 7900 XT / XTX, RX 9070 / 9070 XT or Radeon AI PRO R9700 on Linux works too (experimental): ./setup.sh --backend hip, chosen by itself on a PC with no NVIDIA card Strata can use. It installs ROCm without sudo and compiles the engine (one GPU, no images yet). Details: AMD HIP.

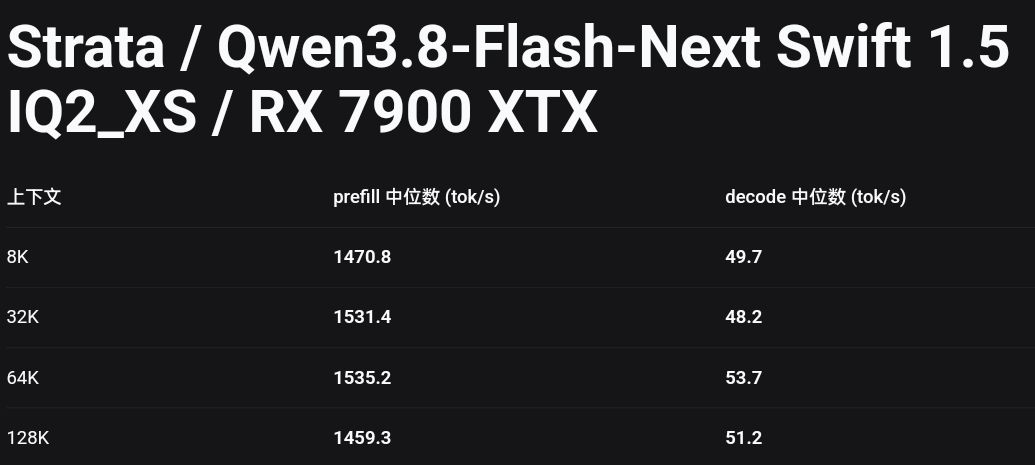
    有7900 XTX 的使用者可以實測看看, 已經有網友實測成功 decode 55 tok/s

    Strata 已把 AMD GPU 的 HIP backend 正式 merge 進主分支,因此 RX 7900 XTX 現在可以直接跑 Strata v0.1.27。
    https://github.com/Niko1221/Strata

    我該選哪個模型?

    以下差異主要在於模型大小(同一個模型,只是壓縮程度不同):

    模型 RAM + VRAM 需求 速度 品質
    Q2_0 37.6 GB 最快 良好
    IQ2_XS 39.2 GB 快 更好(推薦)
    IQ3_XXS 47.0 GB 較慢 很優秀
    IQ3_S 54.8 GB 最慢 最佳:在已公布的測試中,表現可媲美完整未壓縮模型(僅針對原始模型測試)

    LCZ論壇實作

    7900 XTX 的可能性探索|单卡篇(四):魔法打败魔法 - 7900XTX Strata 引擎跑Qwen3.8 Flash-Next 快得让你怀疑人生 by Ben Lee

    至於 Nvidia顯卡 8G, 12G, 16G, 24G, 32G 的使用者請參考此帖
    RTX 3080 20G 单卡跑 Qwen3.8-Flash-Next IQ2_XS:Strata 上机实测(128K 上下文 / int8 KV / MTP) by Simo
    不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了! by Johnny

    Strata PR #121 2026-09-29 的 commit 是 「Add gfx1100 HIP support with tuned prefill and bounded expert uploads」,目標就是 RX 7900 XT/XTX(RDNA3 / gfx1100)。
    HIP 是什麼?

    技術 角色
    NVIDIA CUDA NVIDIA GPU programming/runtime stack
    AMD HIP 類 CUDA 的 GPU programming API/runtime
    ROCm AMD 完整 GPU compute platform
    hipBLAS / hipBLASLt AMD 對應 cuBLAS / cuBLASLt 的矩陣運算 library
    johnnybegoodJ Ben LeeB V 3 条回复 最后回复
    2
    • kos orK kos or

      Strata v0.1.30 : An AMD Radeon RX 7900 XT / XTX, RX 9070 / 9070 XT or Radeon AI PRO R9700 on Linux works too (experimental): ./setup.sh --backend hip, chosen by itself on a PC with no NVIDIA card Strata can use. It installs ROCm without sudo and compiles the engine (one GPU, no images yet). Details: AMD HIP.

      有7900 XTX 的使用者可以實測看看, 已經有網友實測成功 decode 55 tok/s

      Strata 已把 AMD GPU 的 HIP backend 正式 merge 進主分支,因此 RX 7900 XTX 現在可以直接跑 Strata v0.1.27。
      https://github.com/Niko1221/Strata

      我該選哪個模型?

      以下差異主要在於模型大小(同一個模型,只是壓縮程度不同):

      模型 RAM + VRAM 需求 速度 品質
      Q2_0 37.6 GB 最快 良好
      IQ2_XS 39.2 GB 快 更好(推薦)
      IQ3_XXS 47.0 GB 較慢 很優秀
      IQ3_S 54.8 GB 最慢 最佳:在已公布的測試中,表現可媲美完整未壓縮模型(僅針對原始模型測試)

      LCZ論壇實作

      7900 XTX 的可能性探索|单卡篇(四):魔法打败魔法 - 7900XTX Strata 引擎跑Qwen3.8 Flash-Next 快得让你怀疑人生 by Ben Lee

      至於 Nvidia顯卡 8G, 12G, 16G, 24G, 32G 的使用者請參考此帖
      RTX 3080 20G 单卡跑 Qwen3.8-Flash-Next IQ2_XS:Strata 上机实测(128K 上下文 / int8 KV / MTP) by Simo
      不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了! by Johnny

      Strata PR #121 2026-09-29 的 commit 是 「Add gfx1100 HIP support with tuned prefill and bounded expert uploads」,目標就是 RX 7900 XT/XTX(RDNA3 / gfx1100)。
      HIP 是什麼?

      技術 角色
      NVIDIA CUDA NVIDIA GPU programming/runtime stack
      AMD HIP 類 CUDA 的 GPU programming API/runtime
      ROCm AMD 完整 GPU compute platform
      hipBLAS / hipBLASLt AMD 對應 cuBLAS / cuBLASLt 的矩陣運算 library
      johnnybegoodJ
      johnnybegoodJ
      johnnybegood
      超凡大师
      编写于 最后由 编辑
      #2

      @kos-or 最新版增强了中文的性能!

      On this PC (RTX 5070, Q2_0, greedy), answers in Chinese are 15-38% faster: a concept explanation 55 -> 76 tokens/s,
      在这台电脑上(RTX 5070,Q2_0 版本),使用中文输入时,响应速度提升了 15-38%:例如,解释某个概念时,所需的时间从 55 个字符/秒减少到了 76 个字符/秒。

      a translation 67 -> 81, code with Chinese comments 68 -> 79. An answer in Japanese: 63 -> 72.
      翻译结果:67 -> 81;带有中文注释的代码:68 -> 79。用日语表示的答案:63 -> 72。

      On the Coder, the Chinese answers are 3-8% faster.
      在“Coder”这个平台上,中文的回答速度要快 3-8%。

      kos orK 1 条回复 最后回复
      1
      • 懒人烘培懒
        懒人烘培懒
        懒人烘培
        德高望重 劳动模范
        编写于 最后由 编辑
        #3

        可以玩玩这个模型,感觉还不错

        双 7900 XTX:模型本地跑,Token 随便烧!

        1 条回复 最后回复
        0
        • johnnybegoodJ johnnybegood

          @kos-or 最新版增强了中文的性能!

          On this PC (RTX 5070, Q2_0, greedy), answers in Chinese are 15-38% faster: a concept explanation 55 -> 76 tokens/s,
          在这台电脑上(RTX 5070,Q2_0 版本),使用中文输入时,响应速度提升了 15-38%:例如,解释某个概念时,所需的时间从 55 个字符/秒减少到了 76 个字符/秒。

          a translation 67 -> 81, code with Chinese comments 68 -> 79. An answer in Japanese: 63 -> 72.
          翻译结果:67 -> 81;带有中文注释的代码:68 -> 79。用日语表示的答案:63 -> 72。

          On the Coder, the Chinese answers are 3-8% faster.
          在“Coder”这个平台上,中文的回答速度要快 3-8%。

          kos orK
          kos orK
          kos or
          超凡大师
          编写于 最后由 kos or 编辑
          #4

          @johnnybegood

          軟件剛爆發, 目前版本更新速度好像蠻快的, 可以等過一小段時間更新版本

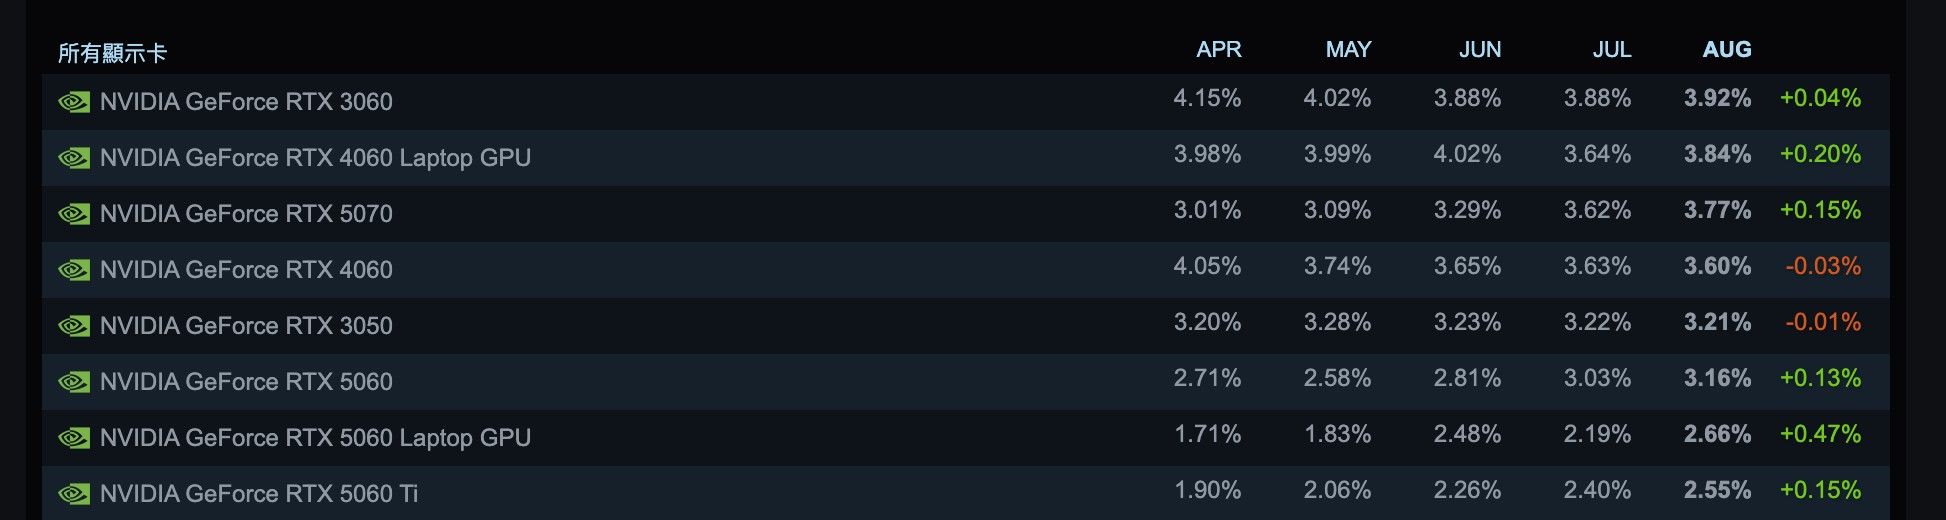
          RTX 5070 12G不到1000美元 就能爽跑 QFN, 玩ComfyUI , 看來5070會被搜刮一波

          工程師 Niko1221 大概已經收到offer被挖角, 可能組團隊或開公司都是不錯的選則

          Steam 上的顯卡使用比例排名 5070 排第三
          image.jpeg

          1 条回复 最后回复
          0
          • kos orK
            kos orK
            kos or
            超凡大师
            编写于 最后由 编辑
            #5

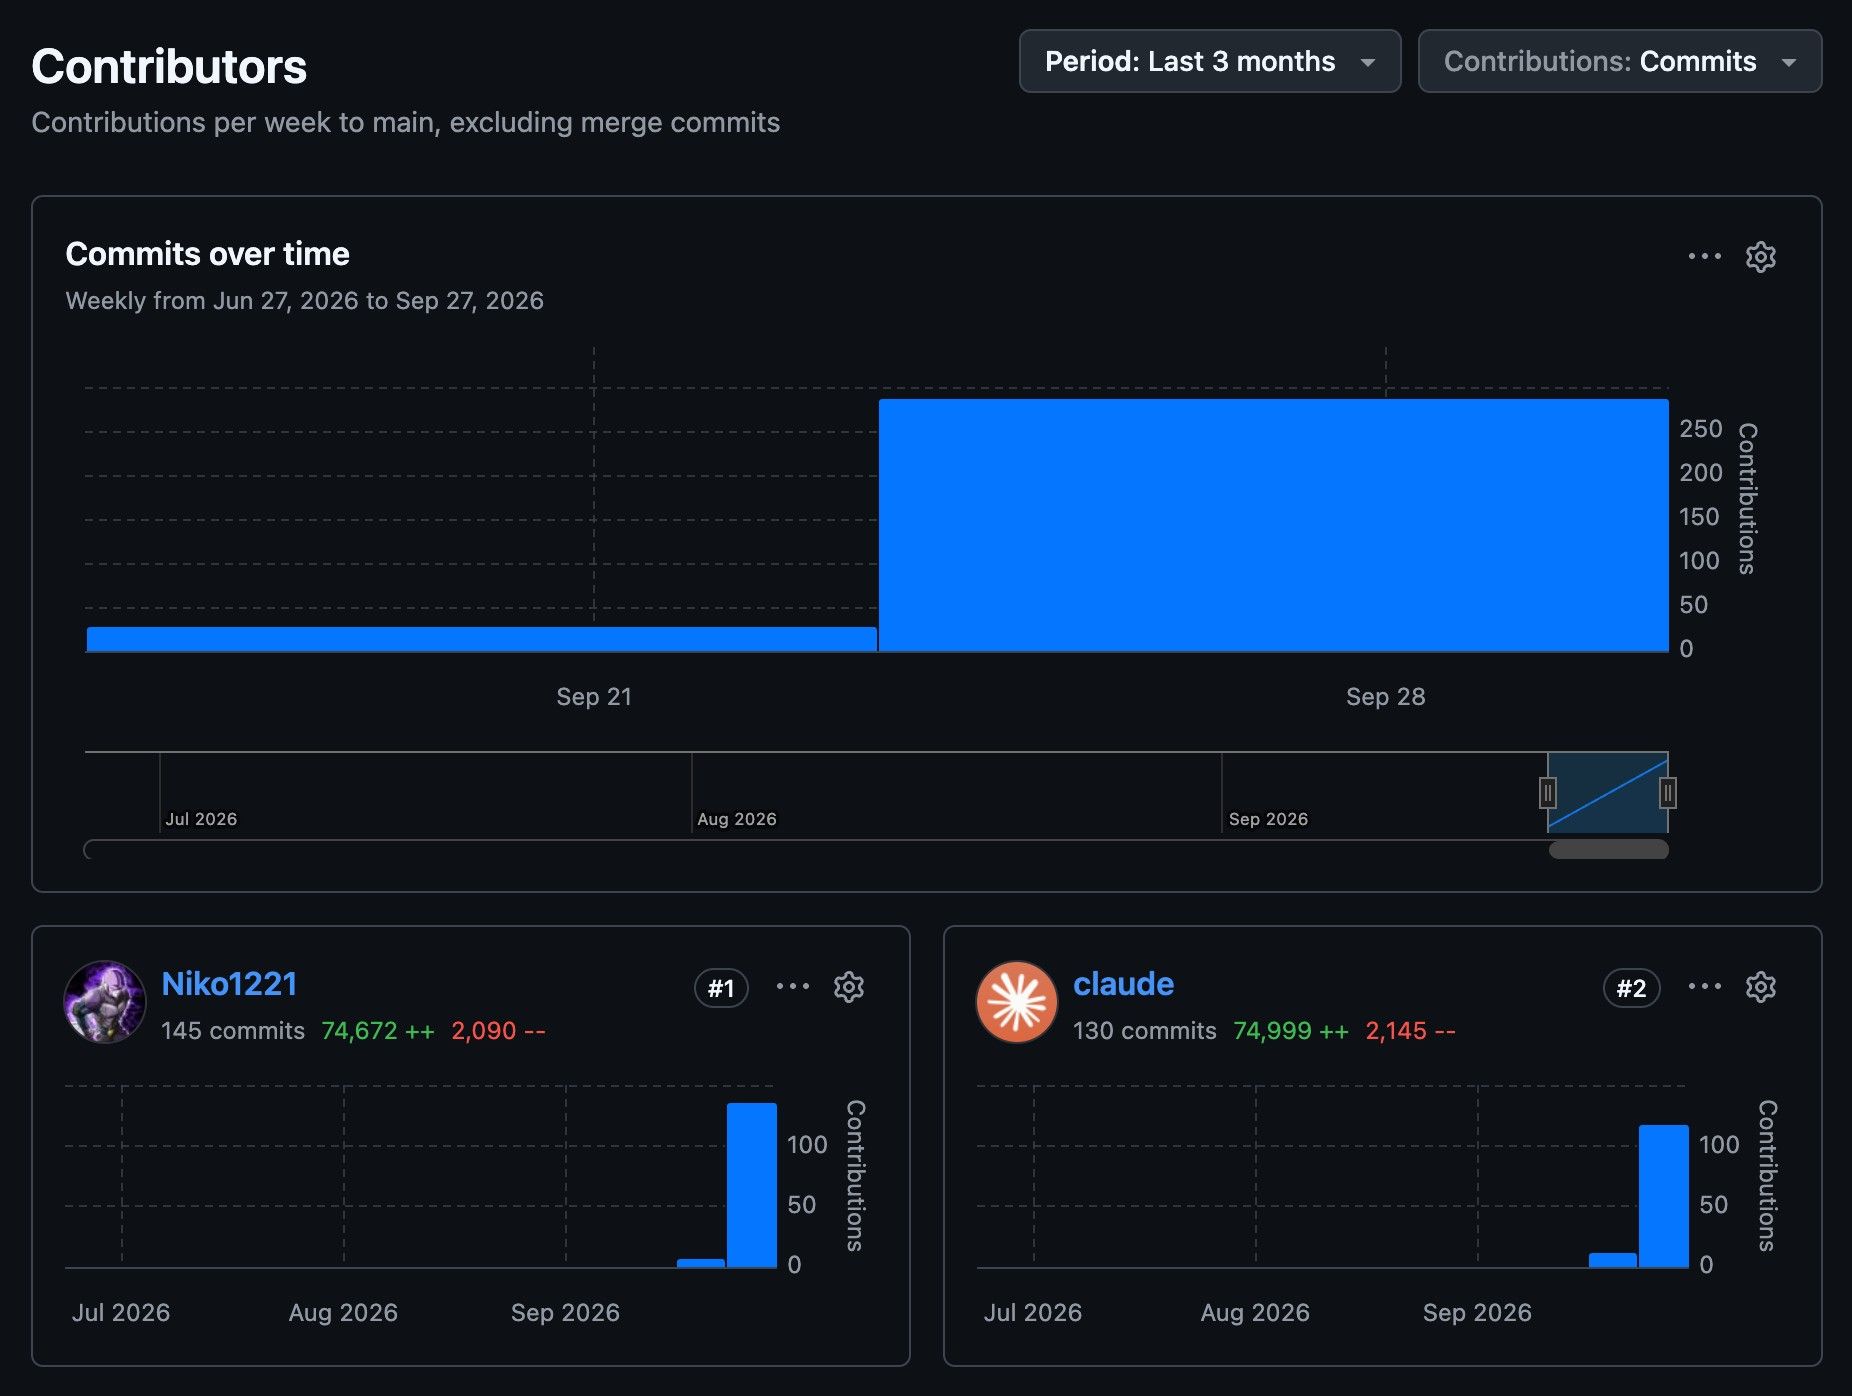
            Anthropic Claude 也進來github 專案 commits ? 是機器人自己來參與的嗎?有點好玩

            image.jpeg

            1 条回复 最后回复
            0
            • kos orK kos or

              Strata v0.1.30 : An AMD Radeon RX 7900 XT / XTX, RX 9070 / 9070 XT or Radeon AI PRO R9700 on Linux works too (experimental): ./setup.sh --backend hip, chosen by itself on a PC with no NVIDIA card Strata can use. It installs ROCm without sudo and compiles the engine (one GPU, no images yet). Details: AMD HIP.

              有7900 XTX 的使用者可以實測看看, 已經有網友實測成功 decode 55 tok/s

              Strata 已把 AMD GPU 的 HIP backend 正式 merge 進主分支,因此 RX 7900 XTX 現在可以直接跑 Strata v0.1.27。
              https://github.com/Niko1221/Strata

              我該選哪個模型?

              以下差異主要在於模型大小(同一個模型,只是壓縮程度不同):

              模型 RAM + VRAM 需求 速度 品質
              Q2_0 37.6 GB 最快 良好
              IQ2_XS 39.2 GB 快 更好(推薦)
              IQ3_XXS 47.0 GB 較慢 很優秀
              IQ3_S 54.8 GB 最慢 最佳:在已公布的測試中,表現可媲美完整未壓縮模型(僅針對原始模型測試)

              LCZ論壇實作

              7900 XTX 的可能性探索|单卡篇(四):魔法打败魔法 - 7900XTX Strata 引擎跑Qwen3.8 Flash-Next 快得让你怀疑人生 by Ben Lee

              至於 Nvidia顯卡 8G, 12G, 16G, 24G, 32G 的使用者請參考此帖
              RTX 3080 20G 单卡跑 Qwen3.8-Flash-Next IQ2_XS:Strata 上机实测(128K 上下文 / int8 KV / MTP) by Simo
              不管你信不信, 单卡 3090 跑 Qwen3.8 Flash Next 可以到 100tok/s 了! by Johnny

              Strata PR #121 2026-09-29 的 commit 是 「Add gfx1100 HIP support with tuned prefill and bounded expert uploads」,目標就是 RX 7900 XT/XTX(RDNA3 / gfx1100)。
              HIP 是什麼?

              技術 角色
              NVIDIA CUDA NVIDIA GPU programming/runtime stack
              AMD HIP 類 CUDA 的 GPU programming API/runtime
              ROCm AMD 完整 GPU compute platform
              hipBLAS / hipBLASLt AMD 對應 cuBLAS / cuBLASLt 的矩陣運算 library
              Ben LeeB
              Ben LeeB
              Ben Lee
              超凡大师
              编写于 最后由 编辑
              #6

              @kos-or 我正在测,这个周末前发我的系列帖子之第四篇。

              terryT 1 条回复 最后回复
              2
              • J
                J
                jatwu
                德高望重
                编写于 最后由 jatwu 编辑
                #7
                单流 24 题 1 路 并发总吞吐 预填 专家命中率 暗号
                R9700 单卡(Strata,我们移植) 64.3 70.6 66~82(不涨) 1575 t/s 98~99.8% 4/4
                XTX(Strata) 63.9 68.4 62~77 757 88~97% 4/4
                1 条回复 最后回复
                2
                • Ben LeeB Ben Lee

                  @kos-or 我正在测,这个周末前发我的系列帖子之第四篇。

                  terryT
                  terryT
                  terry
                  超级版主
                  编写于 最后由 编辑
                  #8

                  @Ben-Lee 很期待,如果xtx能跑,那就是真的牛逼了,单卡也起飞了。

                  油管:https://www.youtube.com/@抡锤者

                  Ben LeeB 2 条回复 最后回复
                  1
                  • terryT terry

                    @Ben-Lee 很期待,如果xtx能跑,那就是真的牛逼了,单卡也起飞了。

                    Ben LeeB
                    Ben LeeB
                    Ben Lee
                    超凡大师
                    编写于 最后由 Ben Lee 编辑
                    #9

                    @terry 特哥,给你看下目前的测试成绩,7900XTX单卡,DDR5 64G,跑Flash Next - prefill/decode 中位数(tok/s)分别是 8K 799.6/95.9、32K 661.6/88.8、64K 535.6/75.3、128K 387.9/57.5、192K 303.9/46.0。 但是先卖个关子,等我发帖看细节。

                    这TM都快比我单卡27B还牛X了

                    kos orK 1 条回复 最后回复
                    2
                    • Ben LeeB Ben Lee

                      @terry 特哥,给你看下目前的测试成绩,7900XTX单卡,DDR5 64G,跑Flash Next - prefill/decode 中位数(tok/s)分别是 8K 799.6/95.9、32K 661.6/88.8、64K 535.6/75.3、128K 387.9/57.5、192K 303.9/46.0。 但是先卖个关子,等我发帖看细节。

                      这TM都快比我单卡27B还牛X了

                      kos orK
                      kos orK
                      kos or
                      超凡大师
                      编写于 最后由 kos or 编辑
                      #10

                      @Ben-Lee said:

                      DDR5 64G

                      DDR5 記憶體速度可能會影響 產出速度
                      包含PCIe 速度 最高峰瞬間有 29GB/s 的資料傳輸量, 平均約 10 GB/s
                      接近我的PCIe 4.0 x 16 32GB/s 的理論值了

                      1 条回复 最后回复
                      0
                      • N
                        N
                        naniandemeng
                        编写于 最后由 编辑
                        #11

                        Screenshot_2026-09-30-23-05-43-33_82b10d9f3584360f08225ddcebbb4f6d.jpg
                        我的测试数据是这样的,不知道为什么decode比你的差这么多

                        terryT 1 条回复 最后回复
                        0
                        • N
                          N
                          naniandemeng
                          编写于 最后由 编辑
                          #12

                          prefill调优后特别稳,我是x99+ddr3 64G+7900xtx

                          johnnybegoodJ 1 条回复 最后回复
                          0
                          • N naniandemeng

                            prefill调优后特别稳,我是x99+ddr3 64G+7900xtx

                            johnnybegoodJ
                            johnnybegoodJ
                            johnnybegood
                            超凡大师
                            编写于 最后由 编辑
                            #13

                            @naniandemeng 这个是 IQ2_XS 模型, 可能工作起来幻觉和问题比较多了, 最低也得用 IQ3_XXS吧

                            N terryT 2 条回复 最后回复
                            0
                            • johnnybegoodJ johnnybegood

                              @naniandemeng 这个是 IQ2_XS 模型, 可能工作起来幻觉和问题比较多了, 最低也得用 IQ3_XXS吧

                              N
                              N
                              naniandemeng
                              编写于 最后由 编辑
                              #14

                              @johnnybegood 按官方推荐设置部署的,用deepseek简单测试了下智商与能力14/14全过,先跑起来,后面有需要再换大点的模型。

                              1 条回复 最后回复
                              0
                              • N naniandemeng

                                Screenshot_2026-09-30-23-05-43-33_82b10d9f3584360f08225ddcebbb4f6d.jpg
                                我的测试数据是这样的,不知道为什么decode比你的差这么多

                                terryT
                                terryT
                                terry
                                超级版主
                                编写于 最后由 编辑
                                #15

                                @naniandemeng 我弟这么厉害?详细帖子呢?

                                油管:https://www.youtube.com/@抡锤者

                                N 1 条回复 最后回复
                                0
                                • johnnybegoodJ johnnybegood

                                  @naniandemeng 这个是 IQ2_XS 模型, 可能工作起来幻觉和问题比较多了, 最低也得用 IQ3_XXS吧

                                  terryT
                                  terryT
                                  terry
                                  超级版主
                                  编写于 最后由 编辑
                                  #16

                                  @johnnybegood IQ3实测和Q4差距不大吗?

                                  油管:https://www.youtube.com/@抡锤者

                                  johnnybegoodJ 1 条回复 最后回复
                                  0
                                  • stxpnetS
                                    stxpnetS
                                    stxpnet
                                    超凡大师
                                    编写于 最后由 编辑
                                    #17

                                    做点实际的作品,看看速度和质量呢?

                                    請使用單個獨立的 HTML 文件,編寫一個基於 Three.js 的 3D 体素風格(Voxel Style)「寶塔花園」互動網頁。代碼必須包含完整的 HTML、CSS 和 JavaScript,並且可以直接在 Chrome 瀏覽器中運行。
                                    核心場景要求:
                                    1. 中式寶塔(Pagoda): 在場景中央建立一座多層(如 5 层或 9 层)的中式寶塔。外觀需具備體素方塊特徵,擁有層層收分的飛簷和寶頂結構。
                                    2. 禪意花園(Garden): 圍繞寶塔布置花園。包含幾棵盛開的體素粉色櫻花樹、環繞的綠色竹林、一條用方塊鋪成的小徑,以及一個清澈的池塘。
                                    3. 動態水體(Water): 池塘需有動態的水面微波效果,並設計一個簡單的體素小瀑布,水流有向下的粒子或位移效果。
                                    視覺與交互要求:
                                    1. 動態光影切換: 介面上設計一個按鈕(或自動循環),可在「清晨、正午、日落、深夜」四種晝夜環境光影(Lighting)之間切換,不同时段会有太阳或月亮在适当位置(月亮的盈缺为随机),寶塔的窗戶在深夜會發出暖黃色的光。
                                    2. 相機控制: 整合 OrbitControls,允許用戶通過鼠標進行旋轉、縮放和拖拽視角。
                                    3. 代碼規範: 所有 Three.js 庫(包括主庫、OrbitControls 等)請使用穩定且可用的 CDN 鏈接引入。代碼結構清晰,一次性生成完整可運行的單文件,不要使用省略號。
                                    4.先规划需求,然后再拆分组件模块,以经典的软件工程思想来完成本项目。 
                                    5.尽快做出MVP,减少视觉测试,处理所有语法或运行错误,如需测试可在最后阶段 邀请人类协助进行简单测试。
                                    

                                    双卡3090 PCIE 4.0 16X/16X

                                    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                    kos orK 张光璞张 3 条回复 最后回复
                                    1
                                    • terryT terry

                                      @johnnybegood IQ3实测和Q4差距不大吗?

                                      johnnybegoodJ
                                      johnnybegoodJ
                                      johnnybegood
                                      超凡大师
                                      编写于 最后由 johnnybegood 编辑
                                      #18

                                      @terry IQ3 实测跟 Q4_K_M 差距不太大, 跟 Q4_K_S 差不多,只要不是太小众的用法,那体感基本是一样一样的。 但是最稳的长程模型还是最少是 Q5_K_S, 所以一般来说我能用 IQ4 就用 IQ4,基本能达到 Q4.6 这样的感觉,尤其是文件名里面加了 UD 的, 那更没问题了。

                                      1 条回复 最后回复
                                      1
                                      • stxpnetS stxpnet

                                        做点实际的作品,看看速度和质量呢?

                                        請使用單個獨立的 HTML 文件,編寫一個基於 Three.js 的 3D 体素風格(Voxel Style)「寶塔花園」互動網頁。代碼必須包含完整的 HTML、CSS 和 JavaScript,並且可以直接在 Chrome 瀏覽器中運行。
                                        核心場景要求:
                                        1. 中式寶塔(Pagoda): 在場景中央建立一座多層(如 5 层或 9 层)的中式寶塔。外觀需具備體素方塊特徵,擁有層層收分的飛簷和寶頂結構。
                                        2. 禪意花園(Garden): 圍繞寶塔布置花園。包含幾棵盛開的體素粉色櫻花樹、環繞的綠色竹林、一條用方塊鋪成的小徑,以及一個清澈的池塘。
                                        3. 動態水體(Water): 池塘需有動態的水面微波效果,並設計一個簡單的體素小瀑布,水流有向下的粒子或位移效果。
                                        視覺與交互要求:
                                        1. 動態光影切換: 介面上設計一個按鈕(或自動循環),可在「清晨、正午、日落、深夜」四種晝夜環境光影(Lighting)之間切換,不同时段会有太阳或月亮在适当位置(月亮的盈缺为随机),寶塔的窗戶在深夜會發出暖黃色的光。
                                        2. 相機控制: 整合 OrbitControls,允許用戶通過鼠標進行旋轉、縮放和拖拽視角。
                                        3. 代碼規範: 所有 Three.js 庫(包括主庫、OrbitControls 等)請使用穩定且可用的 CDN 鏈接引入。代碼結構清晰,一次性生成完整可運行的單文件,不要使用省略號。
                                        4.先规划需求,然后再拆分组件模块,以经典的软件工程思想来完成本项目。 
                                        5.尽快做出MVP,减少视觉测试,处理所有语法或运行错误,如需测试可在最后阶段 邀请人类协助进行简单测试。
                                        
                                        kos orK
                                        kos orK
                                        kos or
                                        超凡大师
                                        编写于 最后由 kos or 编辑
                                        #19

                                        @stxpnet said:

                                        做点实际的作品,看看速度和质量呢?

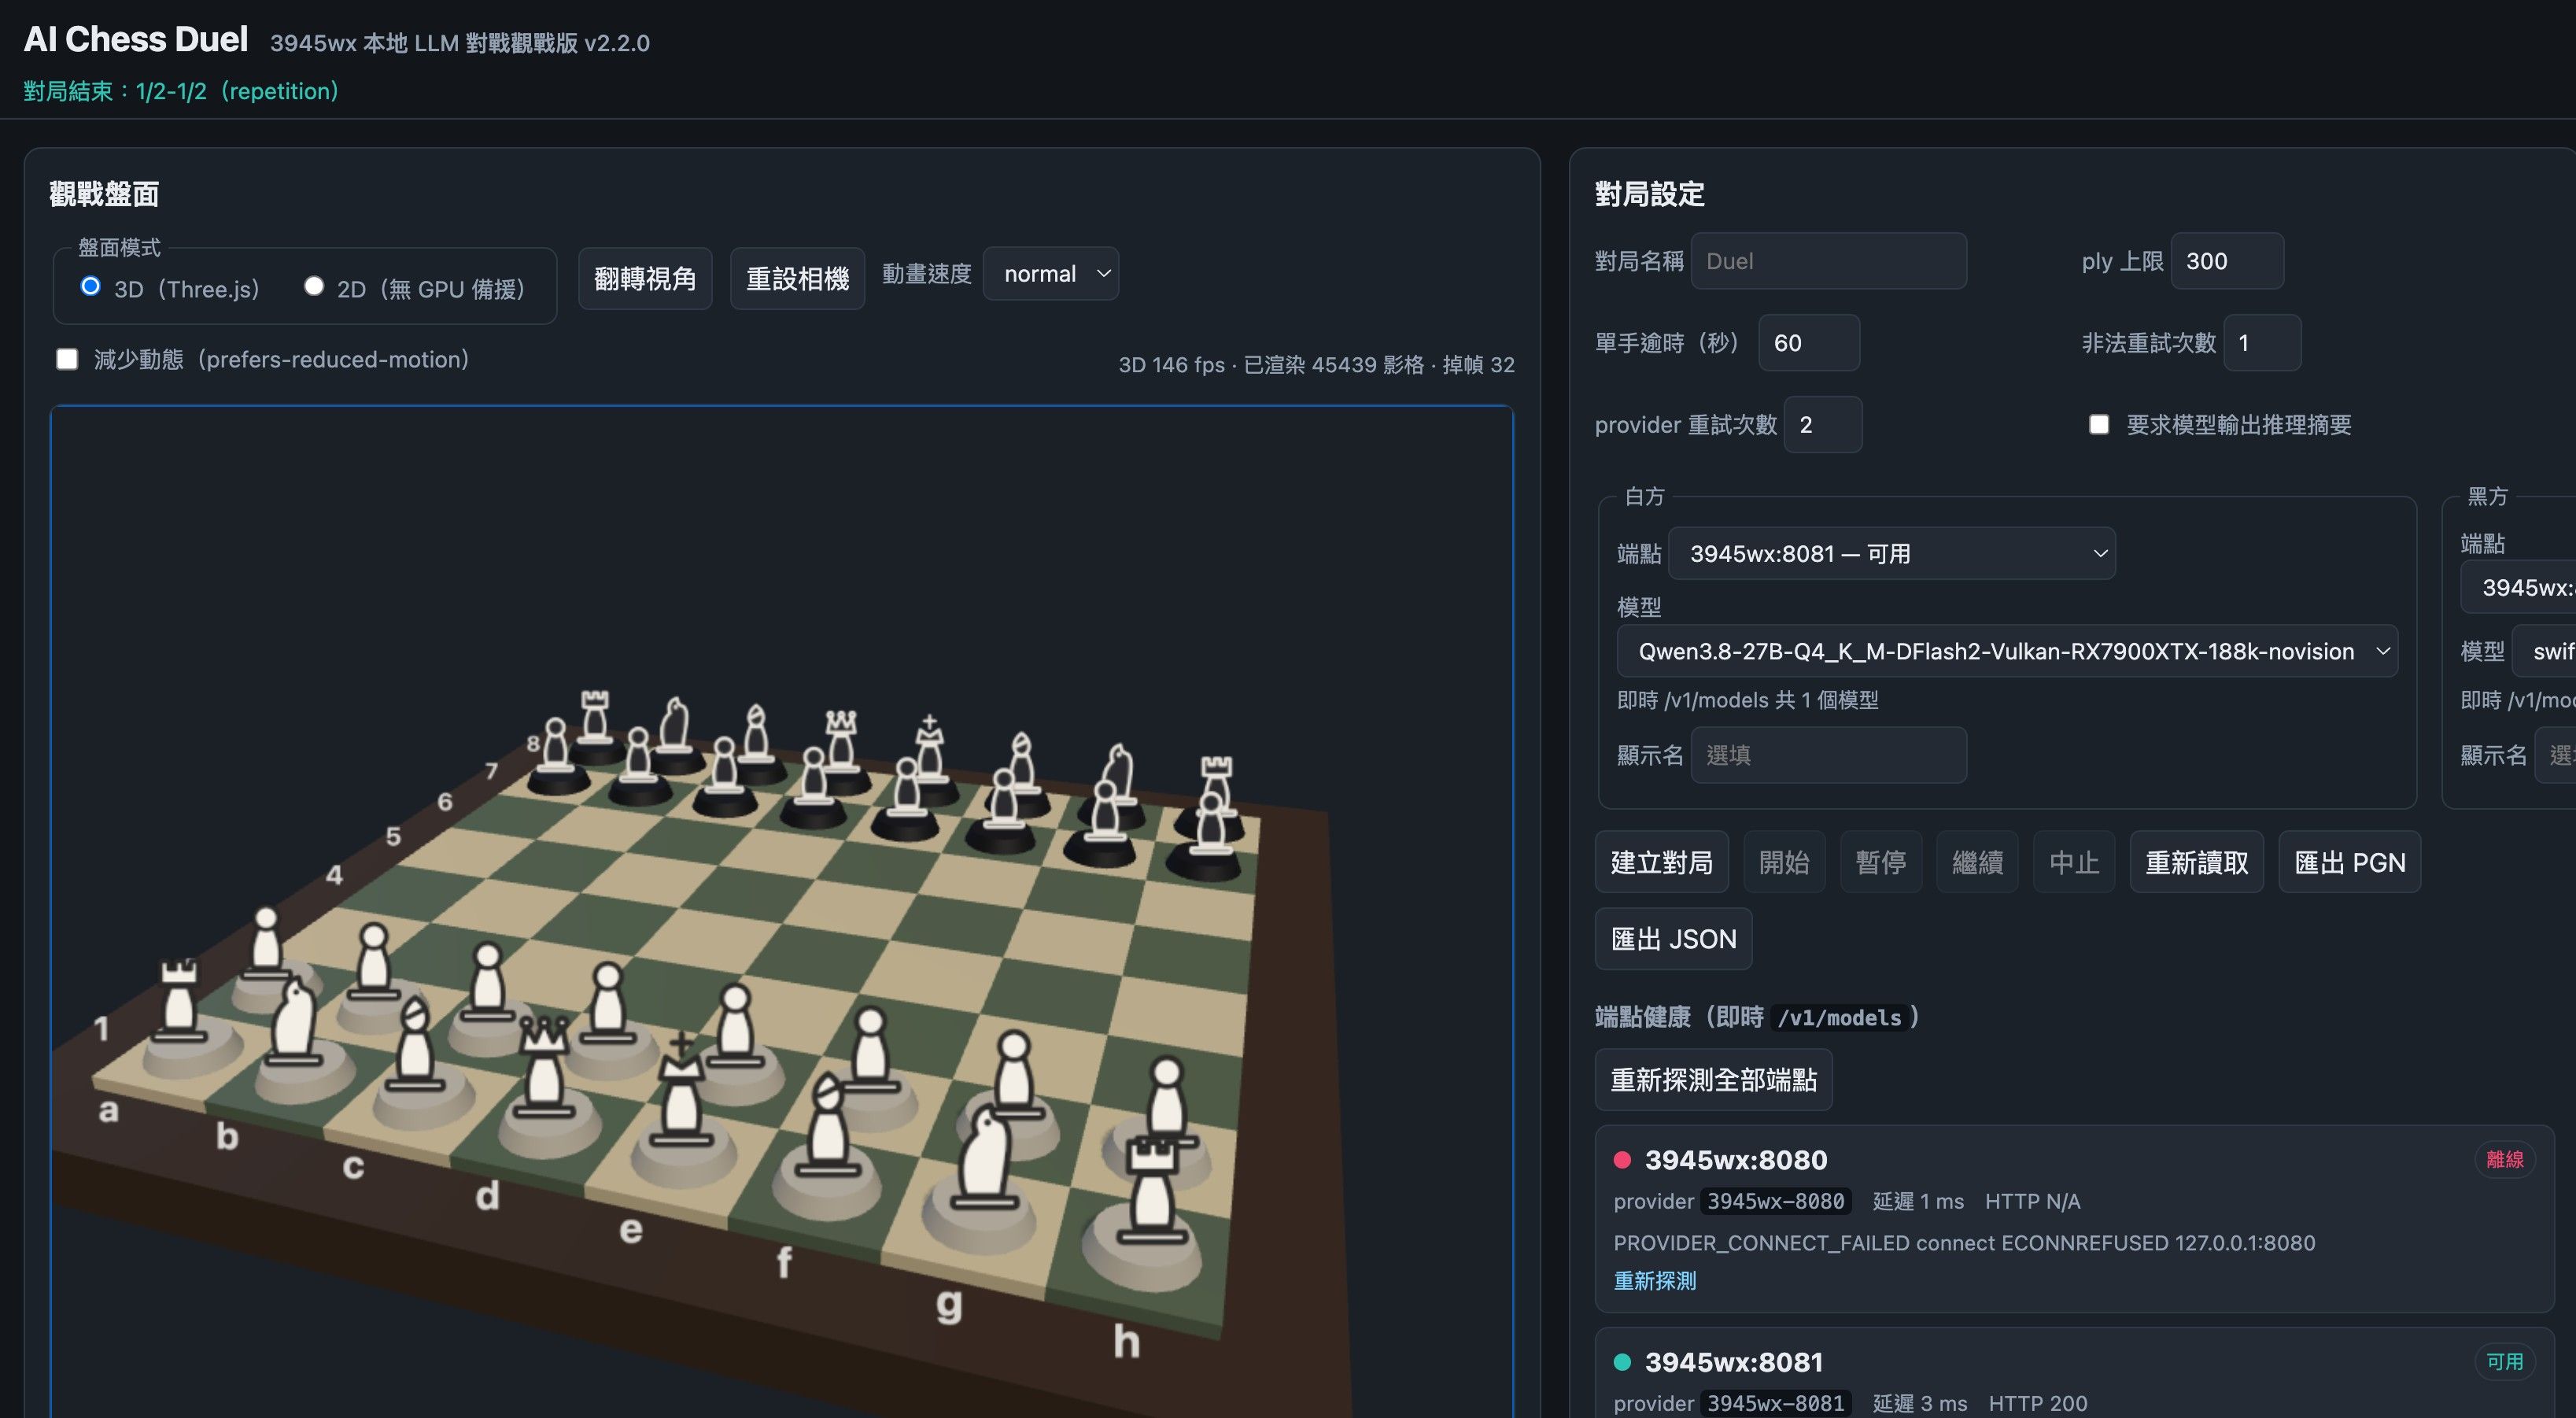
                                        RTX 5070 Ti - QFN-IQ3_XXS Reasoning High, 速度很慢 跑了4~5個小時, 但品質不錯

                                        AI 西洋棋對戰: 本地 AI Qwen3.8-27B-Q4-GPU2 (RX7900XTX 24G) vs. AI-QFN-GPU1 (RTX5070 Ti 16G)
                                        image.jpeg

                                        johnnybegoodJ 1 条回复 最后回复
                                        1
                                        • kos orK kos or

                                          @stxpnet said:

                                          做点实际的作品,看看速度和质量呢?

                                          RTX 5070 Ti - QFN-IQ3_XXS Reasoning High, 速度很慢 跑了4~5個小時, 但品質不錯

                                          AI 西洋棋對戰: 本地 AI Qwen3.8-27B-Q4-GPU2 (RX7900XTX 24G) vs. AI-QFN-GPU1 (RTX5070 Ti 16G)
                                          image.jpeg

                                          johnnybegoodJ
                                          johnnybegoodJ
                                          johnnybegood
                                          超凡大师
                                          编写于 最后由 johnnybegood 编辑
                                          #20

                                          @kos-or 我发现AI下棋很笨的, 总之我之前做了几个下棋游戏, 但是即使难度开到最高, 他们也战胜不了人,我感觉是提示词没有用对, 用什么提示词能让他们下棋的水平达到专业级的水平呢?

                                          kos orK 1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组