
【直播】4卡R9700从采购到调试
-
@张光璞 细说?
我感觉要就大显存150-200gb vram
不然也只是跑27b 有点浪费而且4x r9700 成本是几倍跳
-
@张光璞 细说?
我感觉要就大显存150-200gb vram
不然也只是跑27b 有点浪费而且4x r9700 成本是几倍跳
Q4的模型智力也就这样了。 我自己量化的Q8 模型双卡48g 显存只有80K上下文还要并发共享 。这没法用。
-
-
-
-
@Thanaots 应该不会比5000 pro 72gb 强
但是我这里1张rtx 5000 pro 72gb 可以买6张
如果我有钱当然选5000pro
但是我连买两张r9700 都舍不得 -
其实我一直很好奇pcie5 跑p2p 跟pcie4/3 跑 p2p 会差多少?
如果你入手了刚好可以跟网友分享的对比下了据我跟ai 了解
2张卡
如果单人用 pcie 4/5 decode prefill 几乎没影响
多人使用decode 也大概在少过10% 的差距 这样4张卡
Decode 多人使用大概10-15%
Prefill 单人 多人都在10-15%我感觉2张卡pcie4 完全能够个人玩家是用
pcie3 对比pcie5 就差点点 2 张卡都差10%
4张卡并行 不是普通玩家了 机箱散热都是另一个等级的跳跃当然以上讲着 r9700 或是 rtx5 series支持pcie5的显卡
这个我能给你个我用VLLM-OMNI测试H3跑视频的参考数据:
864×480、124 帧、24 fps、约 5.175 秒、20 步
TP2/U1,无 P2P(PCIE5X8)195.134 秒 (2卡)
TP2/U1,有 P2P 131.458 秒(2卡)
TP4/U1,有 P2P 91.836 秒(4卡)
TP2/U2,有 P2P 78.205 秒(4卡)我先买的Z890平台双卡怎么都没法成功P2P,然后加了两张卡买了16000多的PCIE5交换机。。。。。。
-
这个我能给你个我用VLLM-OMNI测试H3跑视频的参考数据:
864×480、124 帧、24 fps、约 5.175 秒、20 步
TP2/U1,无 P2P(PCIE5X8)195.134 秒 (2卡)
TP2/U1,有 P2P 131.458 秒(2卡)
TP4/U1,有 P2P 91.836 秒(4卡)
TP2/U2,有 P2P 78.205 秒(4卡)我先买的Z890平台双卡怎么都没法成功P2P,然后加了两张卡买了16000多的PCIE5交换机。。。。。。
@Kevin-Hyderich 什么卡? 16000 交换机... 买块全新主板+ddr5 都没那么贵吧
-
-
@Kevin-Hyderich 什么卡? 16000 交换机... 买块全新主板+ddr5 都没那么贵吧
@applejuice R9700,开始打算双卡的就买了Z890 270plus套装,后面又加的,不划算,这么一整套折腾下来可以买一张PRO 5000 72G了。。。。。
-
@applejuice R9700,开始打算双卡的就买了Z890 270plus套装,后面又加的,不划算,这么一整套折腾下来可以买一张PRO 5000 72G了。。。。。
-
@Kevin-Hyderich 省钱是花钱的开始
@applejuice 所以说一步到位最省钱,哈哈,不过也体验到了各种折腾的乐趣,当时交换机和A卡兼容不好我还扛着电脑跑到他们厂里去一起调了一天。。。。我这个支持5张卡,安慰自己说以后换卡还能用吧

-
-
-
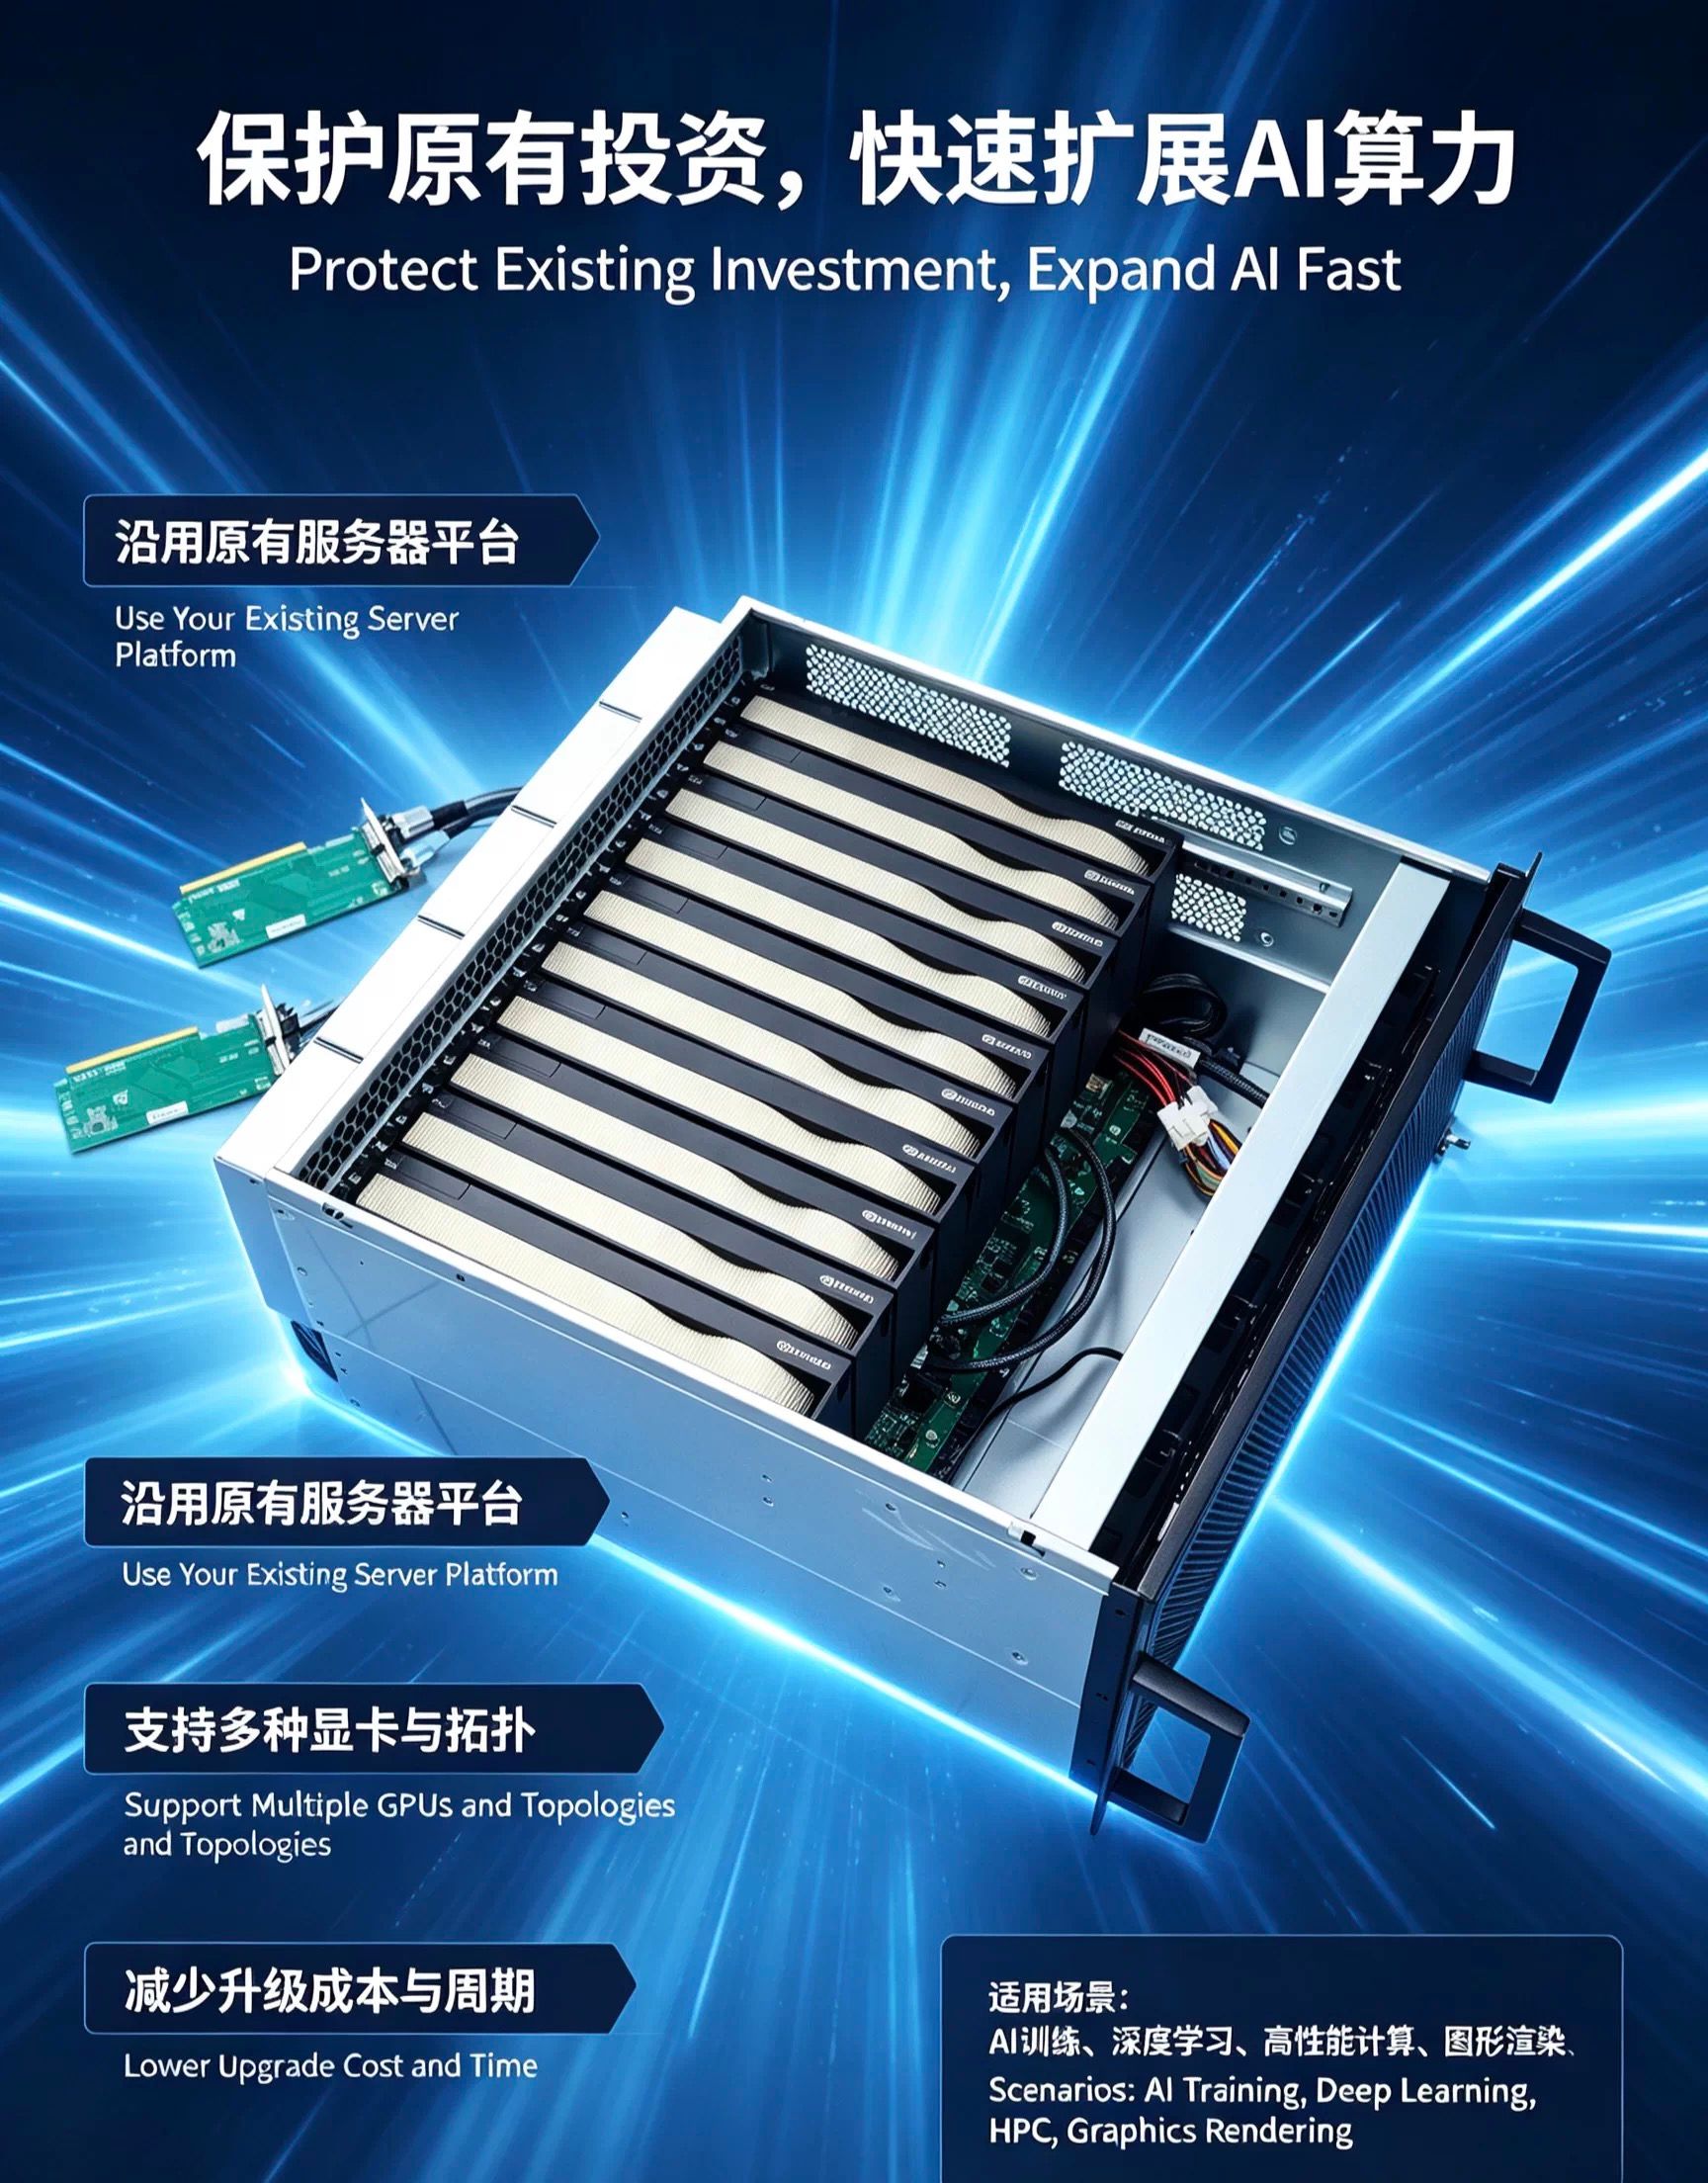
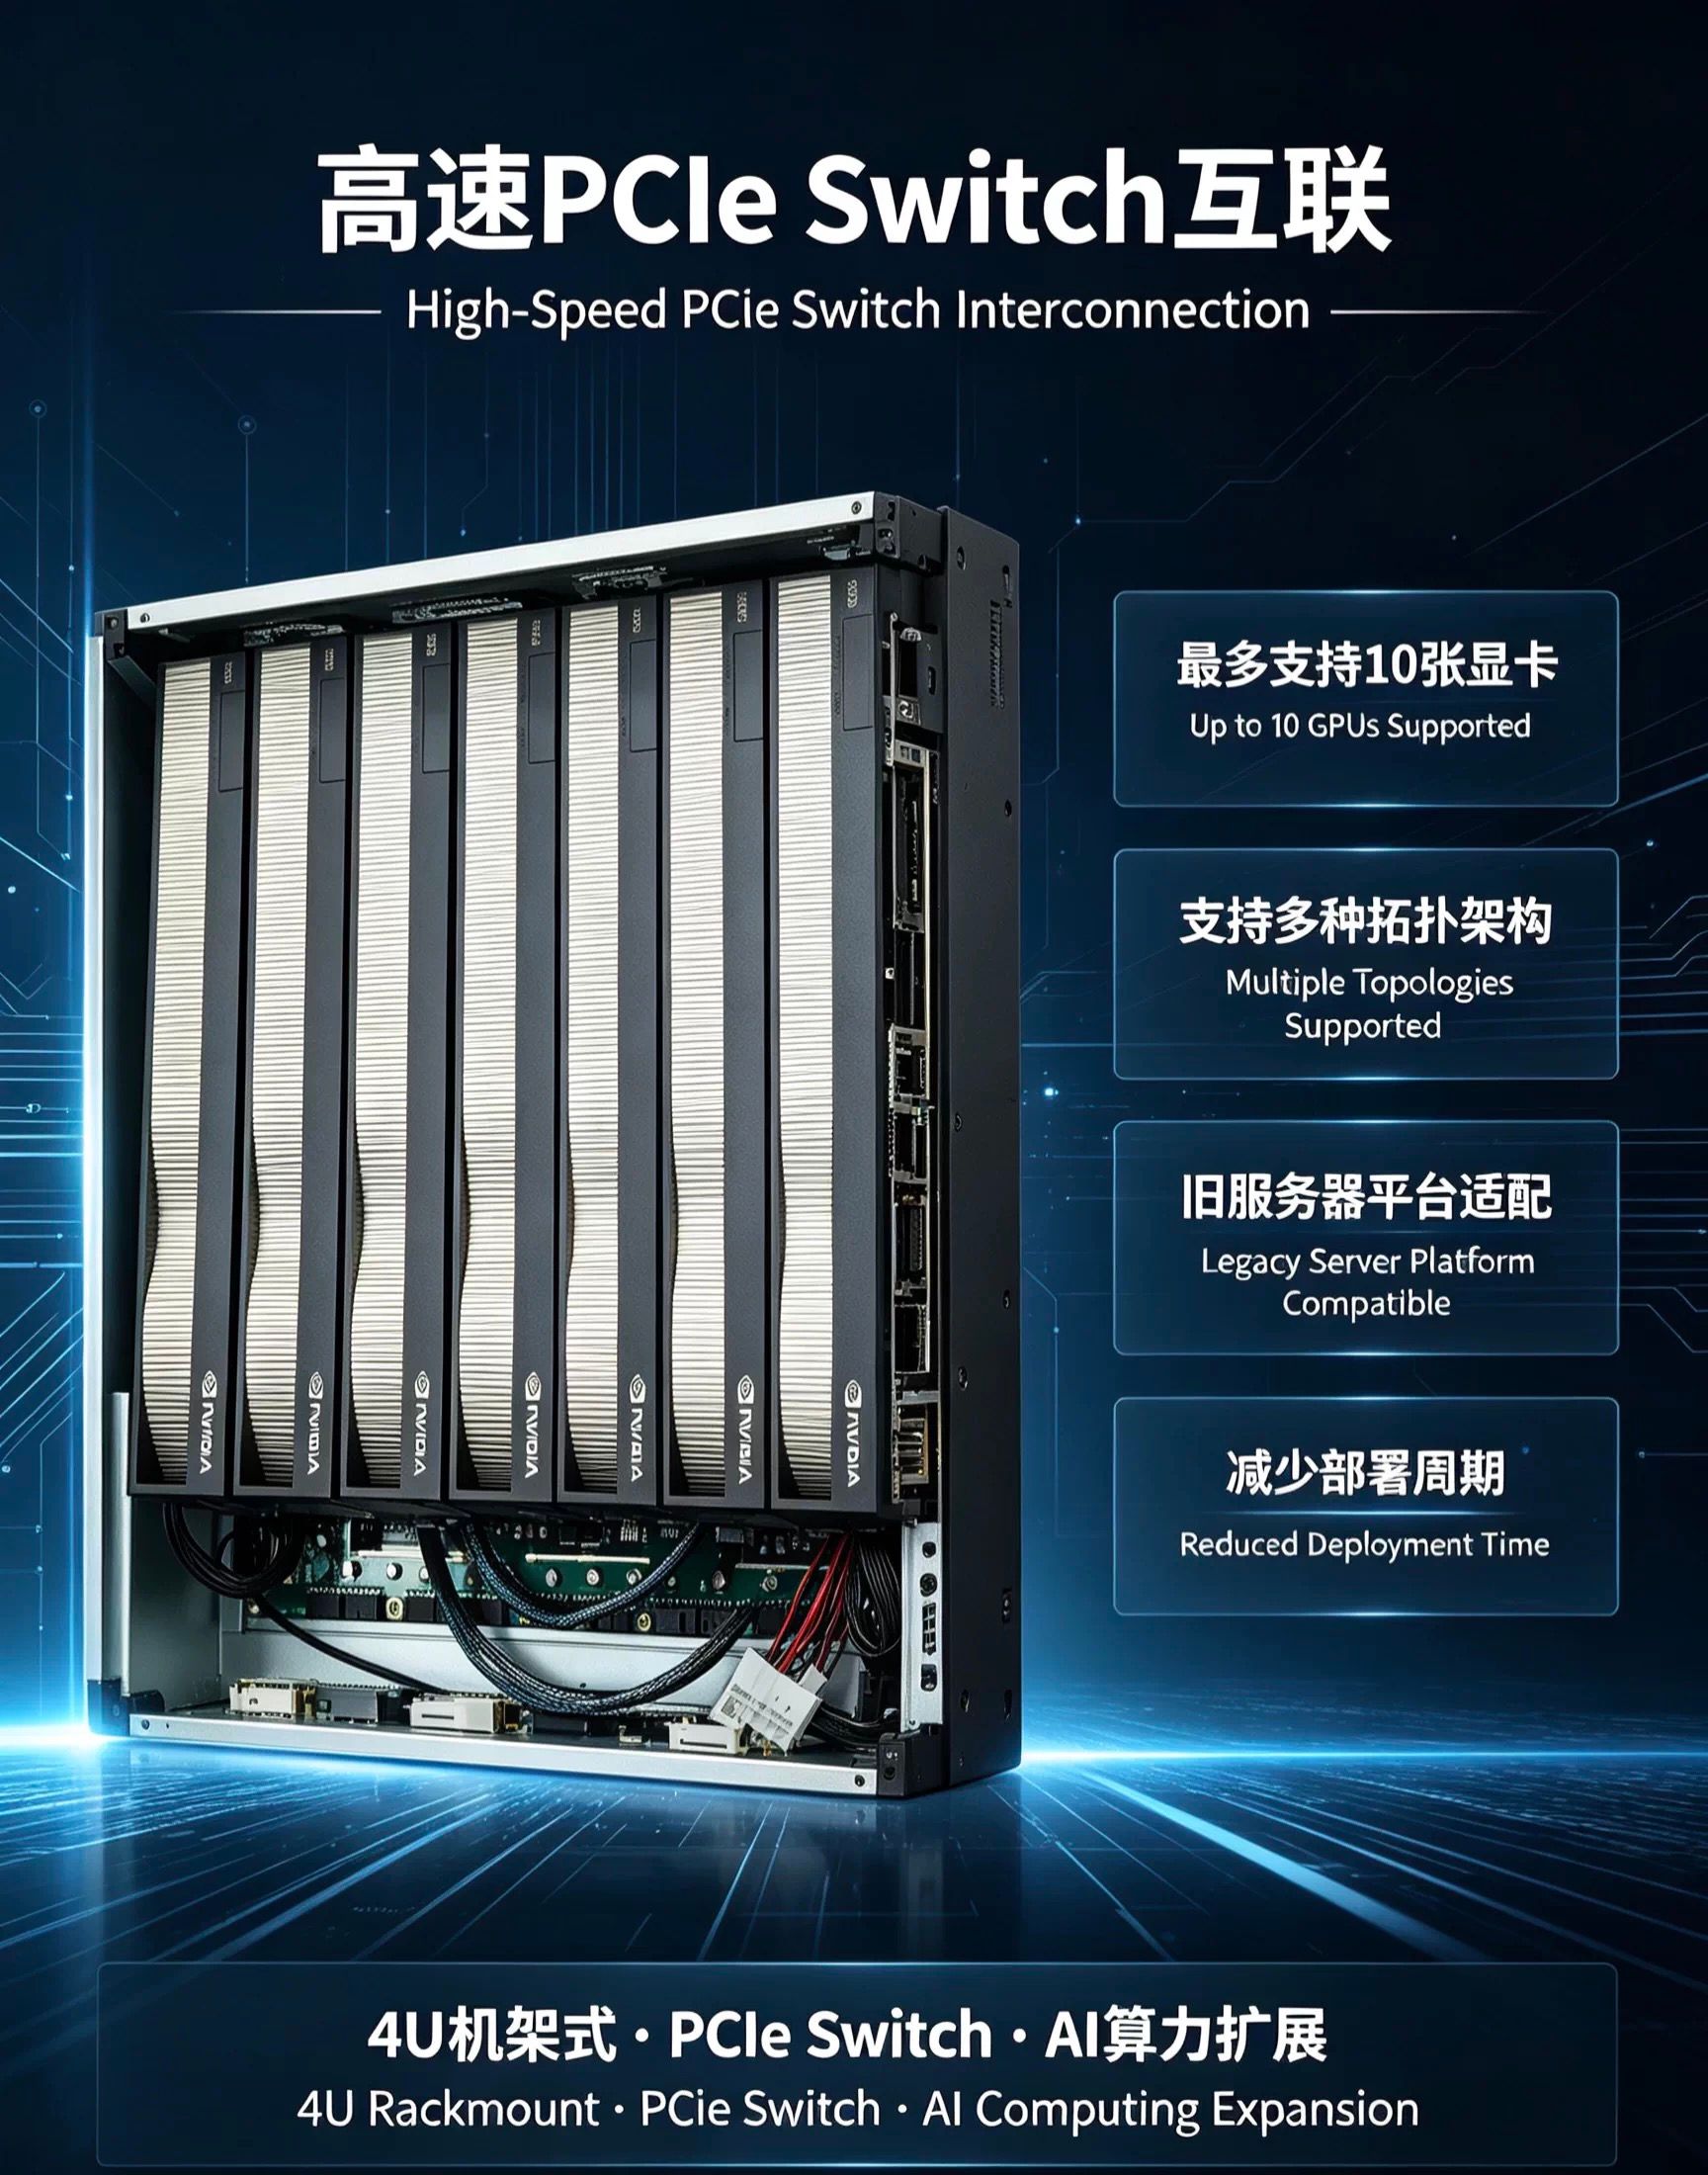
我在淘宝上有看到 pcie5.0x16 的外置显卡坞,好厉害,17000一个,
-
@张光璞 7900XTX 显存速度虽然快,而且便宜【现在也涨价了,3000多能买到我觉得还行】,但是可能真没有r9700好,因为不支持fp8啊,这个因素好像还是不能忽视。
我用朋友电脑混插 7900xtx 和 r9700 简单尝试了张量并行运算,并不理想。混插并不适合运行同一个模型。
-
@张光璞 7900XTX 显存速度虽然快,而且便宜【现在也涨价了,3000多能买到我觉得还行】,但是可能真没有r9700好,因为不支持fp8啊,这个因素好像还是不能忽视。
我用朋友电脑混插 7900xtx 和 r9700 简单尝试了张量并行运算,并不理想。混插并不适合运行同一个模型。
我是想把7900xtx 换掉
@张光璞 pro5000 不可能比 4张 r9700 强。
4张 r9700 虽然麻烦了点,空间、电源、散热更复杂,价格上 4张 r9700 是 ¥42400。
美国 9 月底实时低价下,4× R9700 比 1× RTX PRO 5000 48GB 便宜约 21%;
r9700 多卡不是线性 4 倍。公开 4 卡 R9700 测试里,8B 模型 TP1→TP2 约 1.7 倍,TP2→TP4 基本不再增长;14B 模型 TP2→TP4 约 1.4 倍。四卡提升主要来自容量和多并发,不是单用户延迟。
我觉得要跑 100GB 级显存模型,且接受 Linux/ROCm/多卡维护:4× R9700
如果不买2张以上的 pro5500,我都不会碰 n卡了。不想当冤大头。毕竟本地模型带来的经济效益无法支撑采购更多的 n 卡。
r9700够了。
-
这个价位,进可打 70B 模型,退可多卡并发 27B,在钱包和性能上还有其他选择吗?
核心规格表
项目 1× RTX PRO 5000 72GB 4× R9700 32GB 当前美国 GPU 价 约 $9,999.99,30 天低价约 $9,209.99 约 4×$1,700 = $6,800 显存 72GB GDDR7 ECC 4×32GB=128GB 聚合,非统一池 单卡/聚合带宽 1,344GB/s 4×640GB/s=2,560GB/s 理论聚合 FP8 dense 官方未公布;按 FP4 稀疏 2,064 推算约 516 TFLOPS,未确认 383 TFLOPS/卡,4 卡理论 1,532 TFLOPS FP8 sparse 官方未公布;按惯例推算约 1,032 TFLOPS,未确认 766 TFLOPS/卡,4 卡理论 3,064 TFLOPS AI 峰值 2,064 AI TOPS,FP4 稀疏口径 4×1,531=6,124 INT4 TOPS 理论口径 FP32 约 65 TFLOPS 4×47.8=191.2 TFLOPS 理论口径 功耗 300W 1,200W GPU,整机常需 1600W-2000W+ 安装 双槽单卡 4 张双槽卡,通常需 8 槽和 HEDT/服务器平台 软件 CUDA、CUDA-X、DCC、AI 生态最成熟 ROCm 已可用,但多卡、RCCL、内核和虚拟化调优更多 多卡效率 不涉及 TP2 对 8B 约 1.7 倍;14B TP2→TP4 约 1.4 倍 FP8 关键结论
- 单卡 FP8 纸面算力:
RTX PRO 5000 72GB可能略高,约比单张 R9700 高 30% 左右,但这是根据 FP4 推算,NVIDIA 官方未确认。 - 四卡 FP8 聚合纸面算力:
4×R9700约为1×RTX PRO 5000的 3 倍。 - 实际 FP8 推理不会线性达到 4 倍。PCIe 通信、张量并行、量化格式、Attention 内核和批量大小都会影响。
- 单用户、小模型、模型能塞进 72GB:
1×RTX PRO 5000 72GB通常体验更好,因为单卡带宽高、无多卡通信,CUDA 支持也更省事。 - 70B FP8、长上下文、多并发、120B MoE:
4×R9700更合适。70B FP8 权重本身接近 70GB,RTX 72GB 几乎没有 KV cache 余量,而 128GB 聚合显存更从容。
最终判断
- 看 FP8 理论算力:
4×R9700总量明显更高。 - 看单卡 FP8 效率:
1×RTX PRO 5000 72GB可能更强,但官方无 FP8 数字,只能按架构推算。 - 看实际部署:
72GB 够用选 RTX PRO 5000;需要 >72GB 或大并发选 4×R9700。 4×R9700的 FP8 优势真正成立的前提是软件能正确使用 4 卡并行,否则 128GB 不会自动合并。
来源:NVIDIA 官方数据表、AMD R9700 官方规格、Newegg 72GB 当前价、GPU PRIX R9700 价格。RTX 5000 的 FP8 数值为推算,标注未确认;AMD 384/766 TFLOPS 为官方口径。
- 单卡 FP8 纸面算力:
-
-
我这里 看 r9700 新卡 3200新币, rtx 5000 pro 72gb 20 2万新币
为什么我这里贵那么多
@applejuice 品牌和地区不一样,我买的瀚凯r9700,¥10600一张。



