跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next

Nvidia 雙卡 RTX5070 Ti 16G - Decode 最高 140 tok/s on Strata v0.1.31 - Swift-Qwen3.8-Flash-Next

已定时 已固定 已锁定 已移动 LLM讨论区
rtx5070多卡部署qwen-flash
35 帖子 6 发布者 1.2k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 kos or 编辑
    #1

    剛跑完雙卡RTX 5070 Ti 以下數據提供大家參考 (簡單基本測試)

    雙卡 RTX 5070 Ti 16G Decode :
    解題 : 127 tok/s
    Coding: 110~140 tok/s
    英文寫作 : 100 tok/s
    中文寫作 : 85 tok/s

    平台規格 :
    目標模型 :Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS
    推理引擎 :Strata v0.1.31 https://github.com/Niko1221/Strata/releases
    KV cache:INT8
    Context : 256 K

    CPU : AMD Threadripper Pro 3945WX (12C/24T)
    RAM : DDR4-2400 ECC 八通道 (153 GB/s 理論值)
    PCIe : 雙 PCIe 4.0 x 16 (32GB/s 理論值)
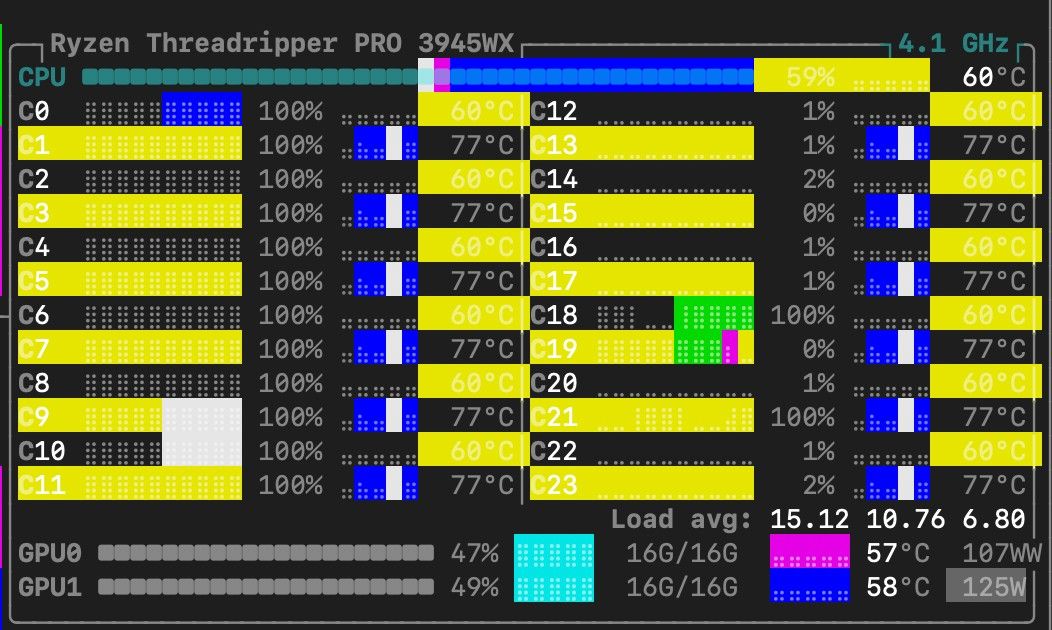
    image.jpeg

    Coding :

    strata] writing a tool call: write: 5750 of max 128000 tokens, 139.7 tok/s, 42 s
    [strata] writing a tool call: write: 5896 of max 128000 tokens, 139.8 tok/s, 43 s
    [strata] writing a tool call: write: 6047 of max 128000 tokens, 140.0 tok/s, 44 s
    [strata] writing a tool call: write: 6188 of max 128000 tokens, 140.1 tok/s, 45 s
    [strata] writing a tool call: write: 6319 of max 128000 tokens, 139.8 tok/s, 46 s
    [strata] writing a tool call: write: 6448 of max 128000 tokens, 139.6 tok/s, 47 s
    [strata] writing a tool call: write: 6595 of max 128000 tokens, 139.7 tok/s, 48 s
    [strata] writing a tool call: write: 6732 of max 128000 tokens, 139.7 tok/s, 49 s

    它這PP這麼快 也不知道怎麼辦到的 難道是IQ3_XXS 量化的關係?
    蠻適合用來整理大量文件
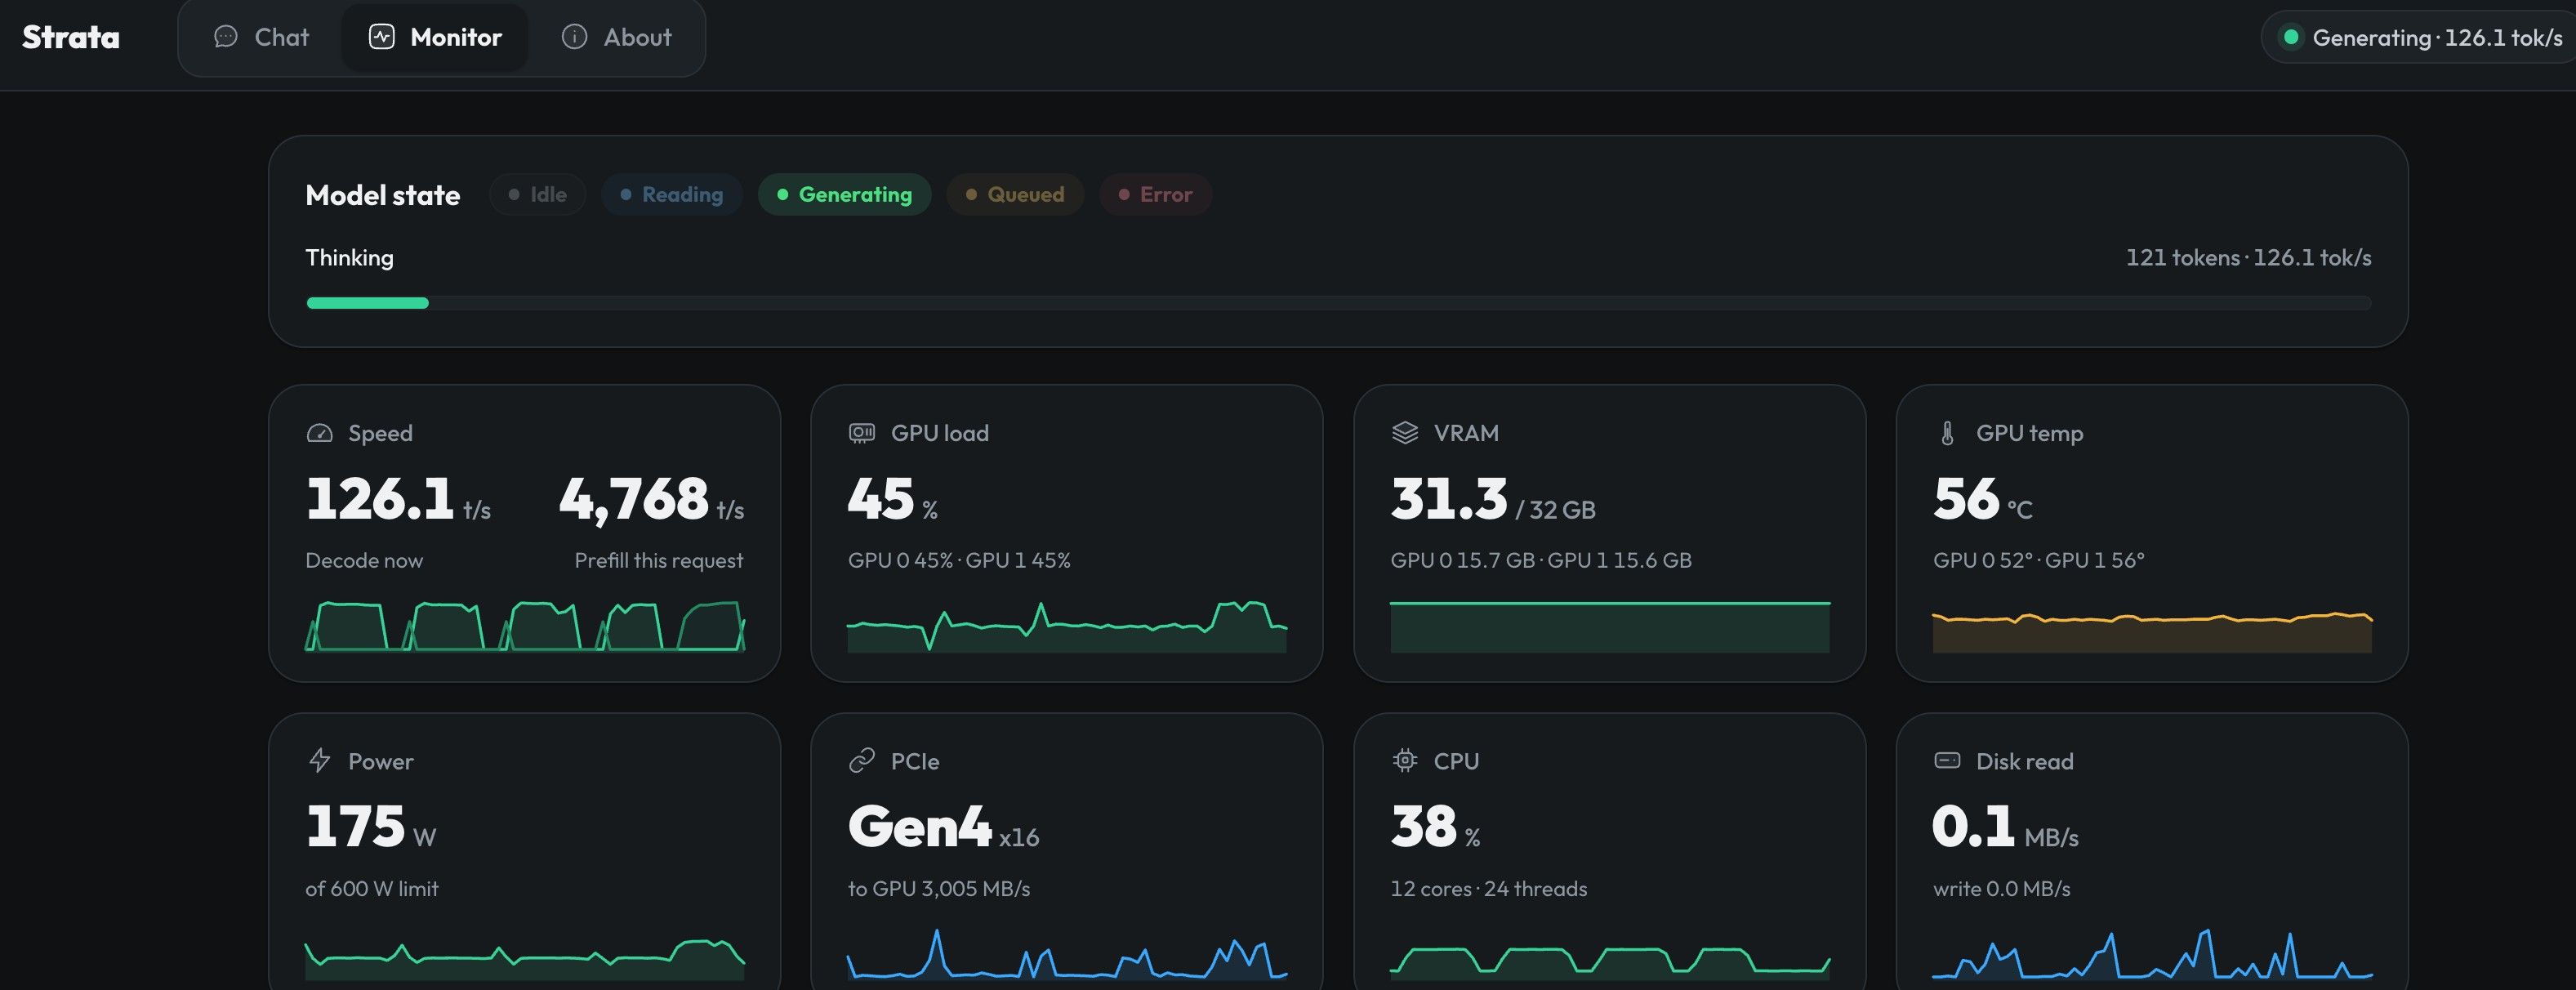
    image.jpeg

    1 条回复 最后回复
    4
    • terryT
      terryT
      terry
      易有太极
      编写于 最后由 编辑
      #2

      好起来了,单卡能玩流畅吗?

      油管:https://www.youtube.com/@抡锤者

      kos orK 1 条回复 最后回复
      0
      • terryT terry

        好起来了,单卡能玩流畅吗?

        kos orK
        kos orK
        kos or
        至尊皇帝
        编写于 最后由 编辑
        #3

        @terry

        單卡的數據也蠻漂亮的 PP增加了 70% ; 如果只有一個project 跑雙卡速度快些, 如果要同時做兩個project coding 跑兩個單卡

        單卡Strata v0.1.31 新版的效能表現

        Metric (median of 3 measured runs) / Strata版本 v0.1.20 單卡 v0.1.31 單卡 Change
        Prompt processing (PP) 1,025.8 tok/s 1,755.2 tok/s +71.11%
        Generation/decode (TG) 97.2 tok/s 95.1 tok/s -2.16%
        End-to-end benchmark request wall time 3.9829 s 2.7846 s -30.09%
        TTFT to first user-visible content 3.2814 s 1.9924 s -39.28%
        johnnybegoodJ 1 条回复 最后回复
        1
        • kos orK kos or

          @terry

          單卡的數據也蠻漂亮的 PP增加了 70% ; 如果只有一個project 跑雙卡速度快些, 如果要同時做兩個project coding 跑兩個單卡

          單卡Strata v0.1.31 新版的效能表現

          Metric (median of 3 measured runs) / Strata版本 v0.1.20 單卡 v0.1.31 單卡 Change
          Prompt processing (PP) 1,025.8 tok/s 1,755.2 tok/s +71.11%
          Generation/decode (TG) 97.2 tok/s 95.1 tok/s -2.16%
          End-to-end benchmark request wall time 3.9829 s 2.7846 s -30.09%
          TTFT to first user-visible content 3.2814 s 1.9924 s -39.28%
          johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          王侯将相
          编写于 最后由 johnnybegood 编辑
          #4

          @kos-or 我觉得跑两个单卡明显性价比更高,

          解題 : 127 tok/s
          Coding: 110~140 tok/s
          英文寫作 : 100 tok/s
          中文寫作 : 85 tok/s

          这个速度跟我单卡 3090 的速度几乎是一样的。

          johnnybegoodJ kos orK 2 条回复 最后回复
          1
          • johnnybegoodJ johnnybegood

            @kos-or 我觉得跑两个单卡明显性价比更高,

            解題 : 127 tok/s
            Coding: 110~140 tok/s
            英文寫作 : 100 tok/s
            中文寫作 : 85 tok/s

            这个速度跟我单卡 3090 的速度几乎是一样的。

            johnnybegoodJ
            johnnybegoodJ
            johnnybegood
            王侯将相
            编写于 最后由 编辑
            #5

            搞错了, 用 Strata的话, 应该是开不了两个单卡, cpu和内存都占着呢。。。

            kos orK 1 条回复 最后回复
            0
            • terryT
              terryT
              terry
              易有太极
              编写于 最后由 编辑
              #6

              CPU和内存才多少钱,洋垃圾顶起来。

              油管:https://www.youtube.com/@抡锤者

              A 1 条回复 最后回复
              1
              • johnnybegoodJ johnnybegood

                搞错了, 用 Strata的话, 应该是开不了两个单卡, cpu和内存都占着呢。。。

                kos orK
                kos orK
                kos or
                至尊皇帝
                编写于 最后由 编辑
                #7

                @johnnybegood said:

                cpu和内存都占着呢

                可以喔 跑得動,一個 instance 單卡提供45GB, 兩個共 90GB RAM
                CPU也可以 同時免強應付兩個 Strata + QFN

                1 条回复 最后回复
                0
                • johnnybegoodJ johnnybegood

                  @kos-or 我觉得跑两个单卡明显性价比更高,

                  解題 : 127 tok/s
                  Coding: 110~140 tok/s
                  英文寫作 : 100 tok/s
                  中文寫作 : 85 tok/s

                  这个速度跟我单卡 3090 的速度几乎是一样的。

                  kos orK
                  kos orK
                  kos or
                  至尊皇帝
                  编写于 最后由 编辑
                  #8

                  @johnnybegood said:

                  这个速度跟我单卡 3090 的速度几乎是一样的。

                  3090 價格又要起飛了 漲得真多 !!😳
                  SM count, memory bandwidth 3090 真的比較多

                  目前我也是覺得兩個單卡 性价比更高

                  johnnybegoodJ 1 条回复 最后回复
                  0
                  • terryT terry

                    CPU和内存才多少钱,洋垃圾顶起来。

                    A
                    A
                    applejuice
                    王侯将相
                    编写于 最后由 编辑
                    #9

                    @terry ddr4 有点贵

                    1 条回复 最后回复
                    0
                    • kos orK kos or

                      @johnnybegood said:

                      这个速度跟我单卡 3090 的速度几乎是一样的。

                      3090 價格又要起飛了 漲得真多 !!😳
                      SM count, memory bandwidth 3090 真的比較多

                      目前我也是覺得兩個單卡 性价比更高

                      johnnybegoodJ
                      johnnybegoodJ
                      johnnybegood
                      王侯将相
                      编写于 最后由 johnnybegood 编辑
                      #10

                      @kos-or 今天用3090+Strata+QFN IQ3_XXS, 一口气写了60几K代码 (256K上下文) , decode一开始90多,到后面越来越快,到最后冲到了160多 tok/s , 我又一次瘫坐在椅子上。

                      kos orK 1 条回复 最后回复
                      0
                      • johnnybegoodJ johnnybegood

                        @kos-or 今天用3090+Strata+QFN IQ3_XXS, 一口气写了60几K代码 (256K上下文) , decode一开始90多,到后面越来越快,到最后冲到了160多 tok/s , 我又一次瘫坐在椅子上。

                        kos orK
                        kos orK
                        kos or
                        至尊皇帝
                        编写于 最后由 kos or 编辑
                        #11

                        @johnnybegood said:

                        decode一开始90多,到后面越来越快,到最后冲到了160多 tok/s

                        好可怕 為何後面越來越快?
                        我猜測可能是 熱專家(hot experts)連續使用的關係(!?)

                        Strata 有KV Cache reuse/prefix reuse 這是NInfer 所欠缺的(沒記錯的話)

                        DSH decode 上到100以上, 都是幾行一起蹦出來的, 不是瀑布式cascading 文字

                        johnnybegoodJ 1 条回复 最后回复
                        0
                        • kos orK kos or

                          @johnnybegood said:

                          decode一开始90多,到后面越来越快,到最后冲到了160多 tok/s

                          好可怕 為何後面越來越快?
                          我猜測可能是 熱專家(hot experts)連續使用的關係(!?)

                          Strata 有KV Cache reuse/prefix reuse 這是NInfer 所欠缺的(沒記錯的話)

                          DSH decode 上到100以上, 都是幾行一起蹦出來的, 不是瀑布式cascading 文字

                          johnnybegoodJ
                          johnnybegoodJ
                          johnnybegood
                          王侯将相
                          编写于 最后由 编辑
                          #12

                          @kos-or 不知道, 就看着速度一点点涨上去, 必须长一点的代码才能涨到这个速度。 我感觉可能 coding对于这个模型来说, 就好像背诵答案一样,不怎么用思考, 越来越熟练。。。

                          kos orK 1 条回复 最后回复
                          0
                          • johnnybegoodJ johnnybegood

                            @kos-or 不知道, 就看着速度一点点涨上去, 必须长一点的代码才能涨到这个速度。 我感觉可能 coding对于这个模型来说, 就好像背诵答案一样,不怎么用思考, 越来越熟练。。。

                            kos orK
                            kos orK
                            kos or
                            至尊皇帝
                            编写于 最后由 编辑
                            #13

                            @johnnybegood

                            我剛剛得到一組雙卡的數字 優化的 MTP7, Prompt 13k :

                            • 最佳整體 screening candidate:spec 7
                              • 最低 TTFT:5.0524 s
                              • 最快 Prefill:3,264.2 tok/s
                              • 最高 Decode/TG:139.3 tok/s

                            我再次測看看

                            johnnybegoodJ YDMY 2 条回复 最后回复
                            0
                            • kos orK kos or

                              @johnnybegood

                              我剛剛得到一組雙卡的數字 優化的 MTP7, Prompt 13k :

                              • 最佳整體 screening candidate:spec 7
                                • 最低 TTFT:5.0524 s
                                • 最快 Prefill:3,264.2 tok/s
                                • 最高 Decode/TG:139.3 tok/s

                              我再次測看看

                              johnnybegoodJ
                              johnnybegoodJ
                              johnnybegood
                              王侯将相
                              编写于 最后由 编辑
                              #14

                              @kos-or 这个prefill真的是爽

                              1 条回复 最后回复
                              0
                              • kos orK kos or

                                @johnnybegood

                                我剛剛得到一組雙卡的數字 優化的 MTP7, Prompt 13k :

                                • 最佳整體 screening candidate:spec 7
                                  • 最低 TTFT:5.0524 s
                                  • 最快 Prefill:3,264.2 tok/s
                                  • 最高 Decode/TG:139.3 tok/s

                                我再次測看看

                                YDMY
                                YDMY
                                YDM
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #15

                                @kos-or

                                我沒時間玩,但有偷偷看,別吸引我😁

                                kos orK 1 条回复 最后回复
                                1
                                • A
                                  A
                                  applejuice
                                  王侯将相
                                  编写于 最后由 编辑
                                  #16

                                  3000 prefill 3090 可以做到吗? @johnnybegood 搞一搞

                                  johnnybegoodJ 1 条回复 最后回复
                                  0
                                  • A applejuice

                                    3000 prefill 3090 可以做到吗? @johnnybegood 搞一搞

                                    johnnybegoodJ
                                    johnnybegoodJ
                                    johnnybegood
                                    王侯将相
                                    编写于 最后由 编辑
                                    #17

                                    @applejuice 我在用双卡测试, 不过好像卡了一个 双卡 bug, #267 , 我可能得给Strata提一个 Issue

                                    1 条回复 最后回复
                                    0
                                    • YDMY YDM

                                      @kos-or

                                      我沒時間玩,但有偷偷看,別吸引我😁

                                      kos orK
                                      kos orK
                                      kos or
                                      至尊皇帝
                                      编写于 最后由 编辑
                                      #18

                                      @YDM

                                      以後有需要再安裝,小秘書能滿足目前的需求就夠了 😁
                                      因為大概2~3個月內"可能"又要換模型和引擎了 🙄
                                      我們的 RTX 5070 Ti 能用 棒棒的!

                                      Strata + QFN 對顯卡非常友善 很耐操 溫度都在55度以下,
                                      兩張卡各別消耗130W而已,因為CPU有幫忙分擔workload,
                                      也可以兩張單卡使用兩個QFN port 8080, 8081 各開一個,都夠用了

                                      fcmeF YDMY 2 条回复 最后回复
                                      1
                                      • kos orK kos or

                                        @YDM

                                        以後有需要再安裝,小秘書能滿足目前的需求就夠了 😁
                                        因為大概2~3個月內"可能"又要換模型和引擎了 🙄
                                        我們的 RTX 5070 Ti 能用 棒棒的!

                                        Strata + QFN 對顯卡非常友善 很耐操 溫度都在55度以下,
                                        兩張卡各別消耗130W而已,因為CPU有幫忙分擔workload,
                                        也可以兩張單卡使用兩個QFN port 8080, 8081 各開一個,都夠用了

                                        fcmeF
                                        fcmeF
                                        fcme
                                        王侯将相
                                        编写于 最后由 编辑
                                        #19

                                        @kos-or
                                        看了你的帖子以后,我也把我的5070Ti试了一下,PP2000左右/TG60-65(比R9700还好),我的机器是7820配双志强6252,12x8G DDR4 ecc,拉满了12通道,5070ti走Pcie3x16。
                                        你的应该是pcie4.0的吧,tg感觉比我的还快点。

                                        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                        kos orK 2 条回复 最后回复
                                        1
                                        • fcmeF
                                          fcmeF
                                          fcme
                                          王侯将相
                                          编写于 最后由 编辑
                                          #20

                                          哦,看到了,你的是tr平台pcie4.0x16,按说带宽翻倍应该tg更快,看来不是带宽瓶颈啊。这个模型感觉是比27B想事情更周到一丢丢。

                                          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组