
单卡7900XTX+llama.cpp+Vulkan+DFlash2+Qwen3.8-27B 速度终于上百了
-
搜了搜论坛,发现不少7900XTX极致优化的帖子,但一般都是魔改llama.cpp 或者双卡或者基于SGLang。我没太多精力去深究,一般倾向于用开箱即用的官方版本。
今天意外刷到 llama.cpp 的 spec : add DFlash2 support (local convolution + candidate selector)- #27342 已经在 8月底 merged。所以,llama.cpp已经官方支持DFlash2。Agent沟通一把后,马上开试:
本机硬件配置
项目 配置 CPU AMD 9600X RAM 32GB DDR5 OS Ubuntu 26.04 准备环境
- llama.cpp 下载到最新版,按标准流程编译
git clone https://github.com/ggml-org/llama.cpp cd llama.cpp cmake -B build -DGGML_VULKAN=ON -DCMAKE_BUILD_TYPE=Release cmake --build build --config Release -j$(nproc) --clean-first --target llama-cli llama-server llama-bench- 准备好主模型和DFlash2 Draft模型
#主模型用之前一直采用的unsloth 的 Qwen3.8-27B-UD-IQ4_XS.gguf # 新下载DFlash2 Draft模型 hf download z-lab/Qwen3.8-27B-DFlash2-GGUF Qwen3.8-27B-DFlash2-Q4_K_M.gguf --local-dir /models- 启动 llama.cpp 测试
llama-server \
  -m /models/Qwen3.8-27B-UD-IQ4_XS.gguf \
  -md /models/Qwen3.8-27B-DFlash2-Q4_K_M.gguf \
  --spec-draft-n-max 4 \
  -ngl 99 -fa on -np 1 \
  -c 163804 -ctk q8_0 -ctv q8_0 -b 2048 -ub 1024 \
  --host 0.0.0.0 --port 8080
简测结果
- spec-draft-n-max 取值3/4/5/6/7,分别测试2次,5最快,但4命中率最高,最后综合选了4。
- spec-draft-n-max 取4的情况下,分测3次,最终结果
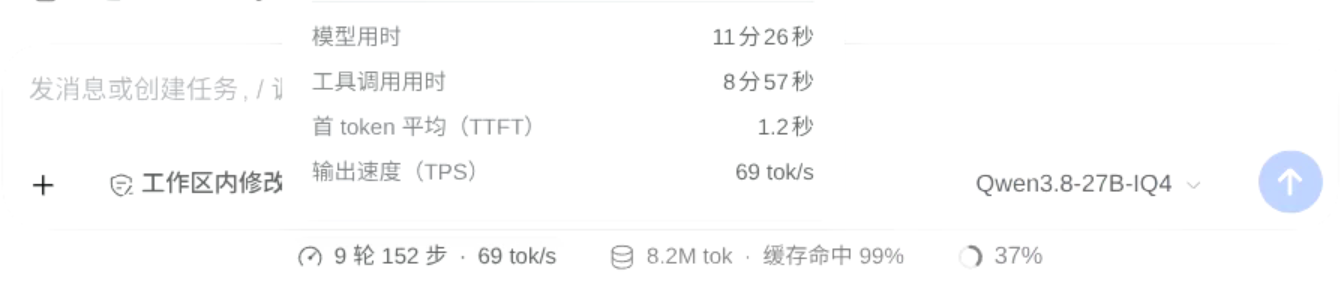
题型 速度均值 数学题 100+ 写作题 60+ 编程 90+ - 搭配dsh,走了一个频繁调动本地工具的长程任务,9轮152步之后,还能稳定在70tokens/s左右 ,很满意了。
注意事项
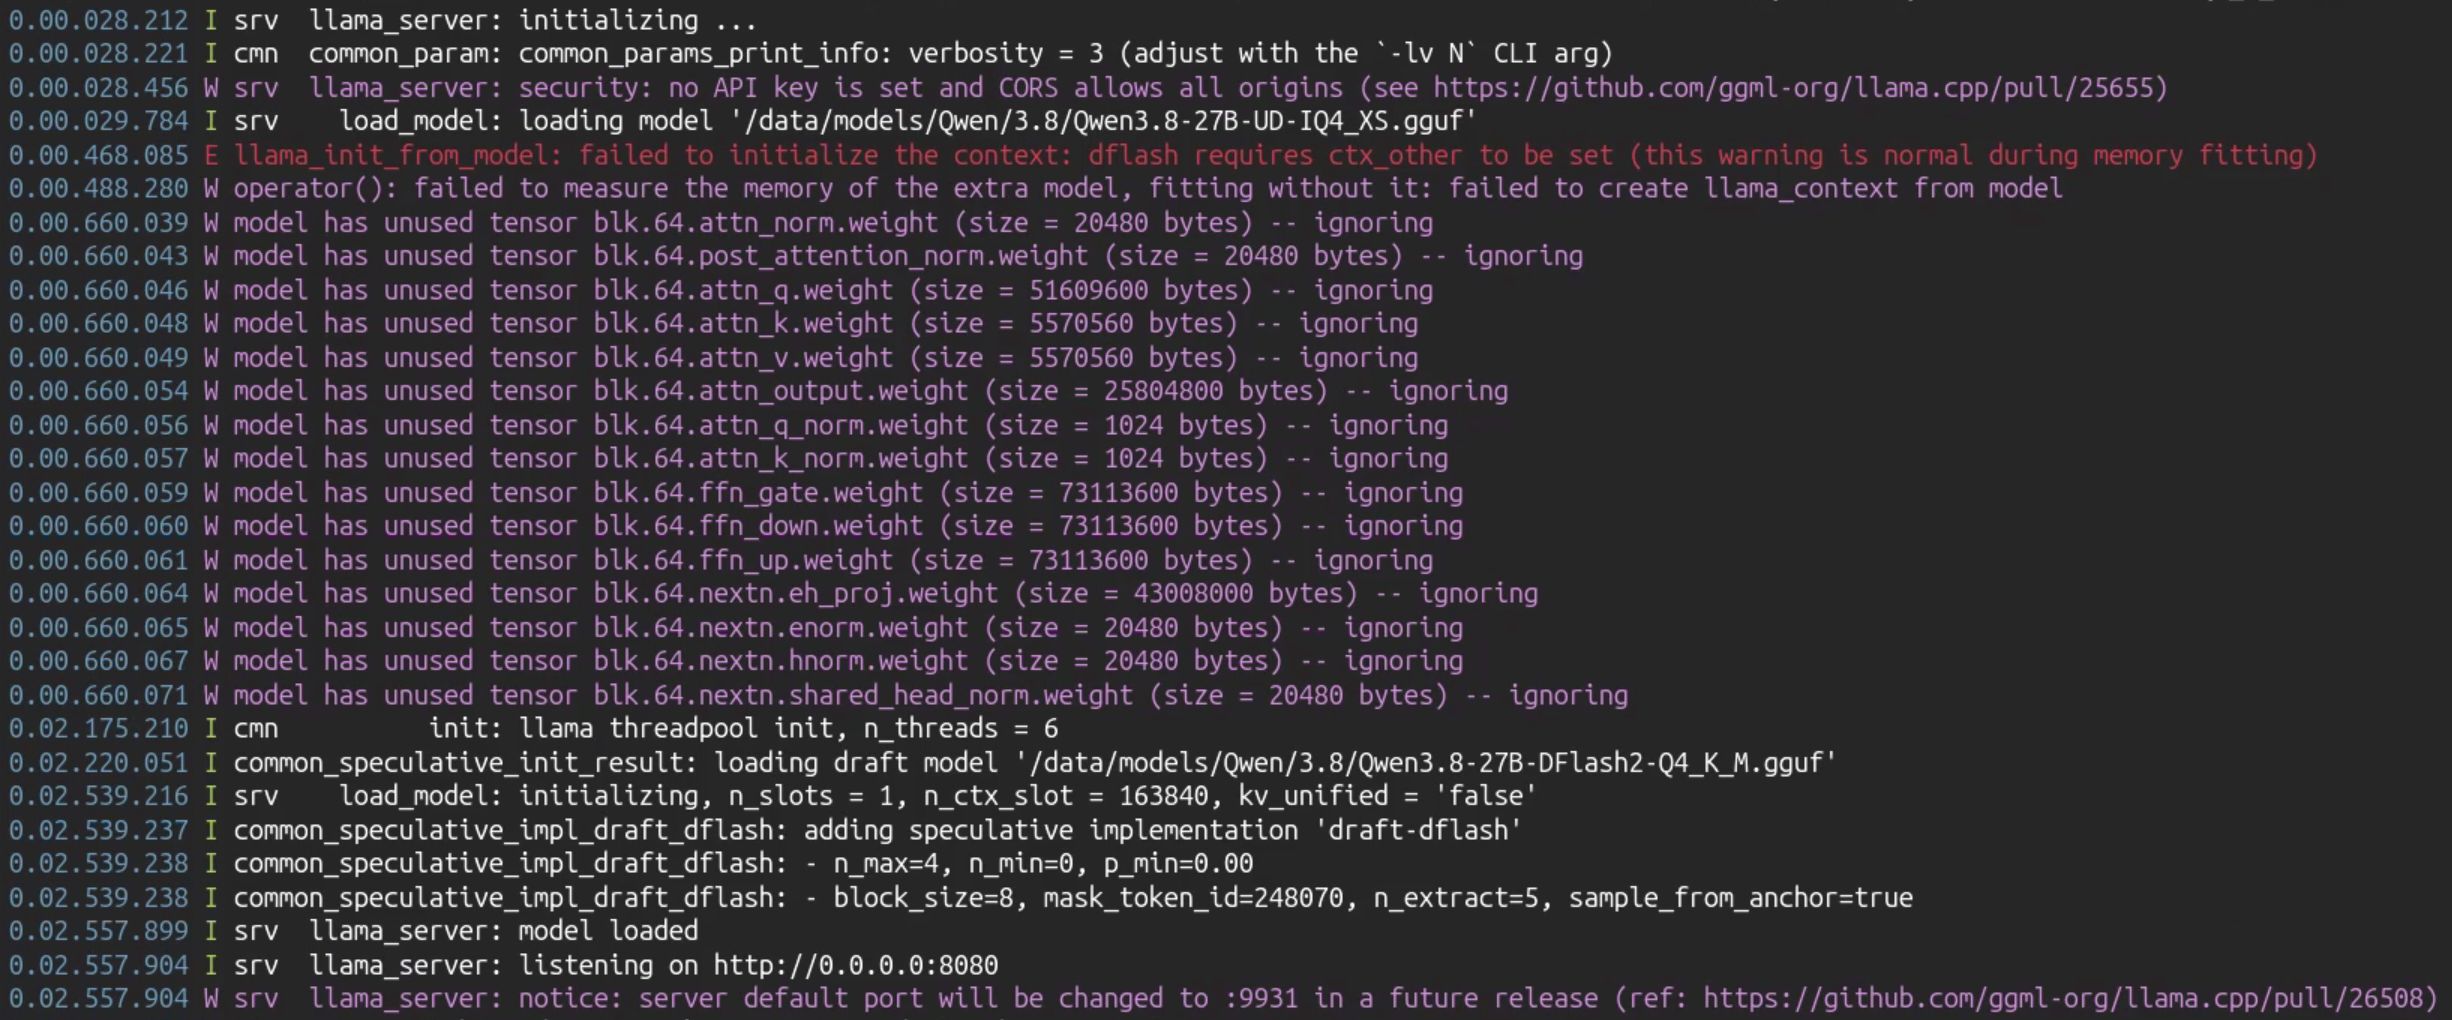
- llama.cpp 启动时会报错,无视就好
感谢各开源社区和大牛们的努力,每月每周都有惊喜!
-
-
-
-
-
-
-
-

