跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 单卡7900XTX+llama.cpp+Vulkan+DFlash2+Qwen3.8-27B 速度终于上百了

单卡7900XTX+llama.cpp+Vulkan+DFlash2+Qwen3.8-27B 速度终于上百了

已定时 已固定 已锁定 已移动 LLM讨论区
7900xtxllama.cppqwen-27b
9 帖子 6 发布者 591 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • C
    C
    Colt
    德高望重
    编写于 最后由 Colt 编辑
    #1

    搜了搜论坛,发现不少7900XTX极致优化的帖子,但一般都是魔改llama.cpp 或者双卡或者基于SGLang。我没太多精力去深究,一般倾向于用开箱即用的官方版本。

    今天意外刷到 llama.cpp 的 spec : add DFlash2 support (local convolution + candidate selector)- #27342 已经在 8月底 merged。所以,llama.cpp已经官方支持DFlash2。Agent沟通一把后,马上开试:

    本机硬件配置

    项目 配置
    CPU AMD 9600X
    RAM 32GB DDR5
    OS Ubuntu 26.04

    准备环境

    • llama.cpp 下载到最新版,按标准流程编译
    git clone https://github.com/ggml-org/llama.cpp
    cd llama.cpp
    cmake -B build -DGGML_VULKAN=ON -DCMAKE_BUILD_TYPE=Release
    cmake --build build --config Release -j$(nproc) --clean-first --target llama-cli  llama-server llama-bench
    
    • 准备好主模型和DFlash2 Draft模型
    #主模型用之前一直采用的unsloth 的 Qwen3.8-27B-UD-IQ4_XS.gguf
    
    # 新下载DFlash2 Draft模型
    hf download z-lab/Qwen3.8-27B-DFlash2-GGUF Qwen3.8-27B-DFlash2-Q4_K_M.gguf --local-dir /models
    
    • 启动 llama.cpp 测试
    llama-server \
      -m /models/Qwen3.8-27B-UD-IQ4_XS.gguf \
      -md /models/Qwen3.8-27B-DFlash2-Q4_K_M.gguf \
      --spec-draft-n-max 4 \
      -ngl 99 -fa on -np 1 \
      -c 163804 -ctk q8_0 -ctv q8_0 -b 2048 -ub 1024 \
      --host 0.0.0.0 --port 8080
    

    简测结果

    • spec-draft-n-max 取值3/4/5/6/7,分别测试2次,5最快,但4命中率最高,最后综合选了4。
    • spec-draft-n-max 取4的情况下,分测3次,最终结果
    题型 速度均值
    数学题 100+
    写作题 60+
    编程 90+
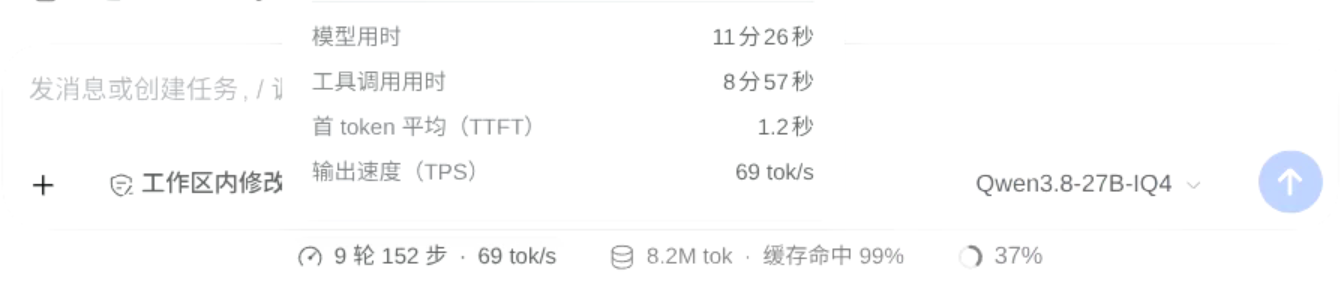
    • 搭配dsh,走了一个频繁调动本地工具的长程任务,9轮152步之后,还能稳定在70tokens/s左右 ,很满意了。
      Pasted 2026-09-30 at 11.30.48 PM.png

    注意事项

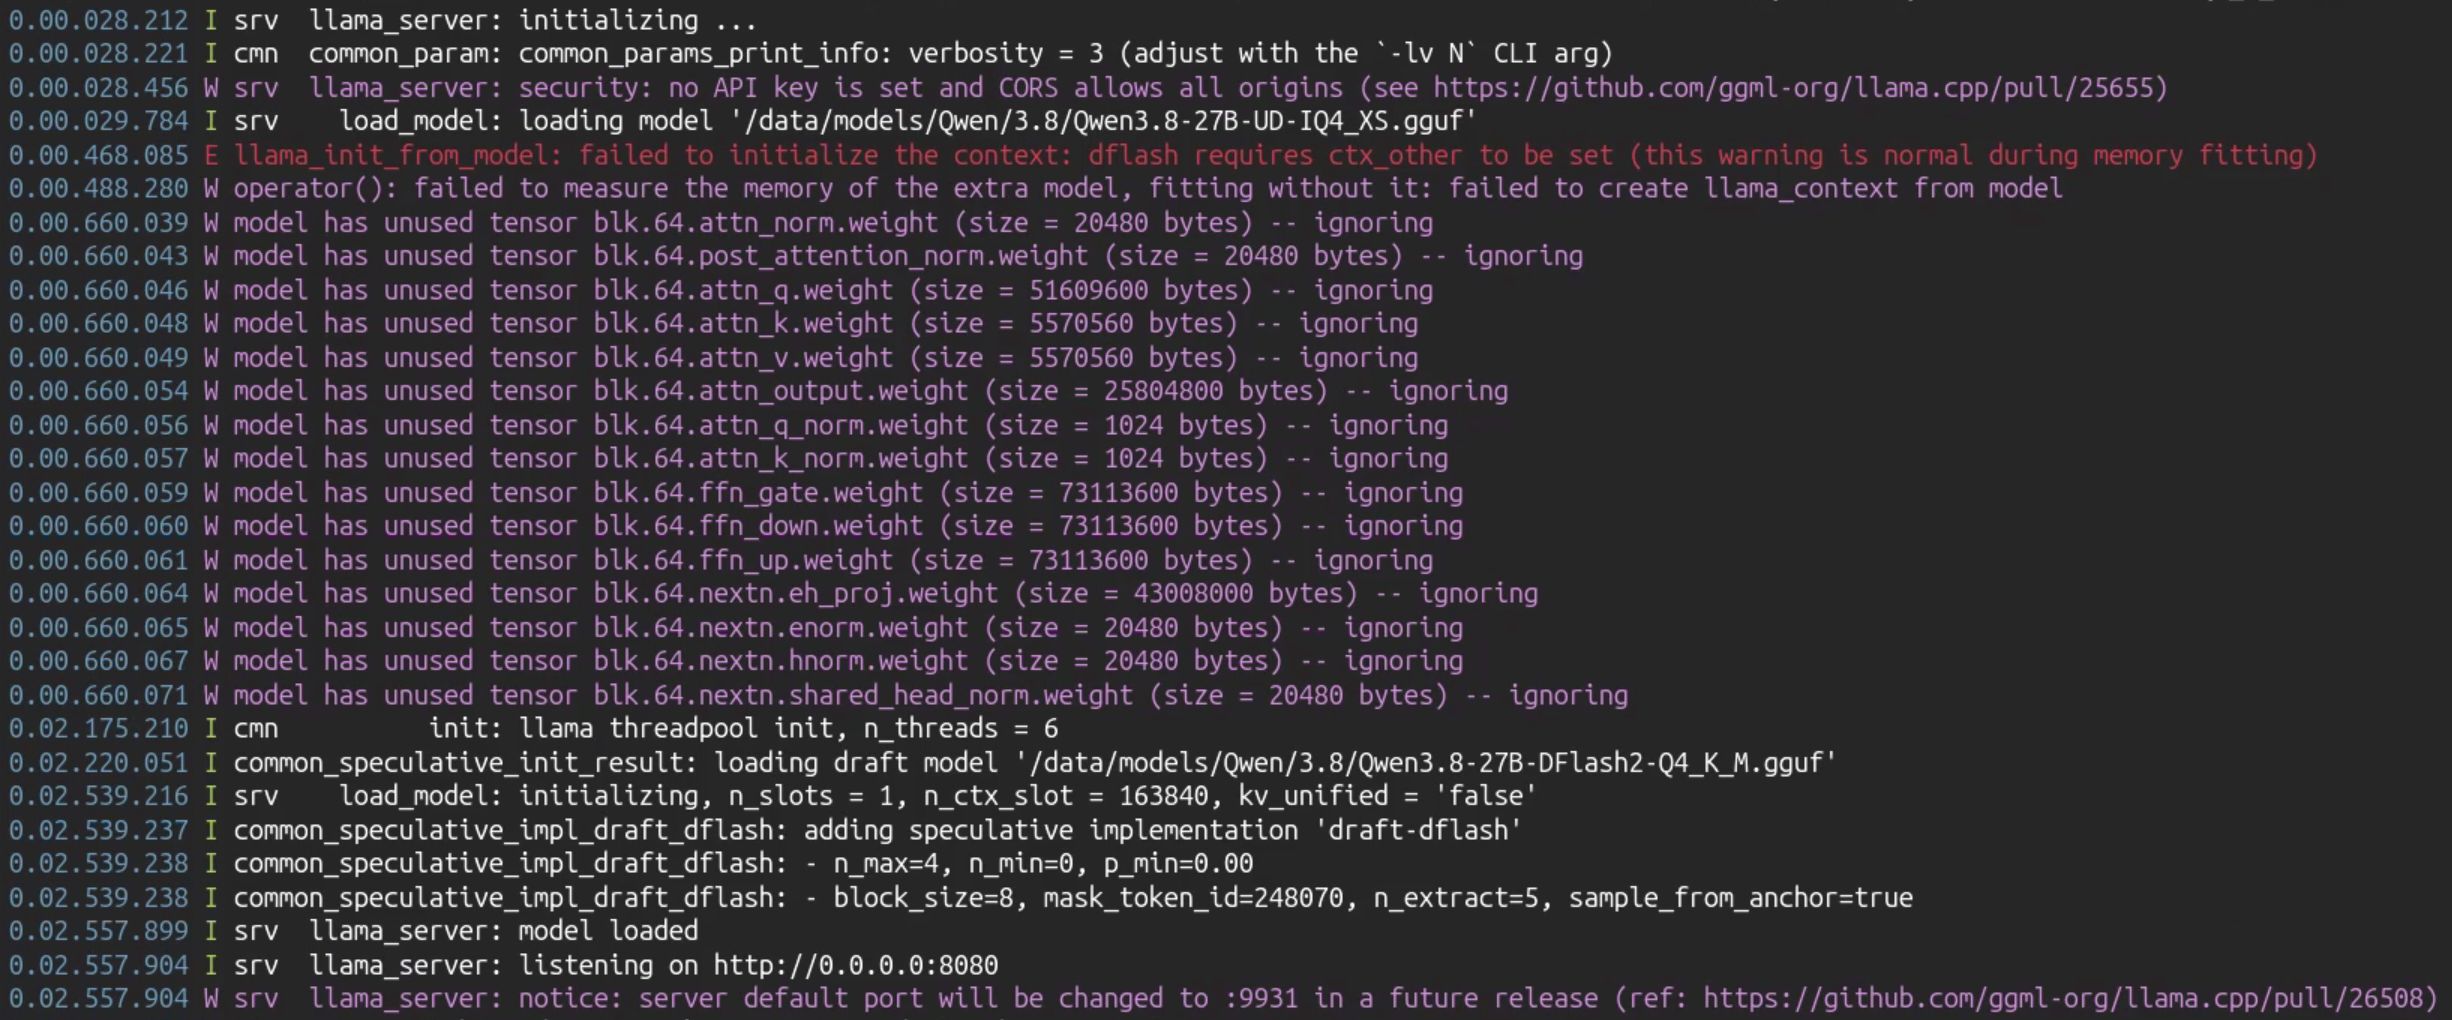
    • llama.cpp 启动时会报错,无视就好
      Pasted 2026-09-30 at 11.24.29 PM.jpg

    感谢各开源社区和大牛们的努力,每月每周都有惊喜!

    1 条回复 最后回复
    1
    • J Z 0J
      J Z 0J
      J Z 0
      编写于 最后由 编辑
      #2

      这个dflash是干什么的啊, 我试了下,跟你差不多设置,写代码只有50多tk/s。唯一不同是是我用的q4km, 你是IQ4 xs,小一点的模型能快真多吗? 我回头测一下

      dardeaw fengD C 2 条回复 最后回复
      0
      • J Z 0J J Z 0

        这个dflash是干什么的啊, 我试了下,跟你差不多设置,写代码只有50多tk/s。唯一不同是是我用的q4km, 你是IQ4 xs,小一点的模型能快真多吗? 我回头测一下

        dardeaw fengD
        dardeaw fengD
        dardeaw feng
        德高望重 劳动模范
        编写于 最后由 编辑
        #3
        此主題已被删除!
        1 条回复 最后回复
        0
        • J Z 0J J Z 0

          这个dflash是干什么的啊, 我试了下,跟你差不多设置,写代码只有50多tk/s。唯一不同是是我用的q4km, 你是IQ4 xs,小一点的模型能快真多吗? 我回头测一下

          C
          C
          Colt
          德高望重
          编写于 最后由 编辑
          #4

          @J-Z-0 DFlash2 针对不同的任务速度差别很大。而且命中率明显不如mtp。你可以多试试哪个最适合你的情况。

          C 1 条回复 最后回复
          0
          • C Colt

            @J-Z-0 DFlash2 针对不同的任务速度差别很大。而且命中率明显不如mtp。你可以多试试哪个最适合你的情况。

            C
            C
            Colt
            德高望重
            编写于 最后由 Colt 编辑
            #5

            另外,我的llama.cpp 启动参数加了

            --jinja --chat-template-file /models/chat_template.jinja --reasoning-format deepseek --reasoning-preserve --reasoning-effort low
            

            体感速度还会快一些。

            1 条回复 最后回复
            1
            • C
              C
              coin1860
              编写于 最后由 编辑
              #6

              Vulkan 在64k 以上上下文的pp 速度还是硬伤, 我试了一下tg 可以做到100 token/S , 但是在96k 的上下文prefill 的pp 速度只有300token/S了

              1 条回复 最后回复
              1
              • E
                E
                exllm
                德高望重
                编写于 最后由 编辑
                #7

                现在用vulkan dflash 跑 GSQ-Q3-S 256k上下文, 日常段任务解码可以到90t/s, 长任务编程40 ~ 60 t/s。 pp都是从900多1000一路掉到 400左右

                1 条回复 最后回复
                0
                • J Z 0J
                  J Z 0J
                  J Z 0
                  编写于 最后由 编辑
                  #8

                  看来模型体积还是影响很大的

                  1 条回复 最后回复
                  0
                  • E
                    E
                    Enigma
                    德高望重
                    编写于 最后由 编辑
                    #9

                    谢谢分享,回头去测试下

                    1 条回复 最后回复
                    0

                    你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                    厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                    有了你的建议,这篇帖子会更精彩哦 💗

                    注册 登录
                    回复
                    • 在新帖中回复
                    登录后回复
                    • 从旧到新
                    • 从新到旧
                    • 最多赞同


                    • 登录

                    • 登录或注册以进行搜索。
                    • 第一个帖子
                      最后一个帖子
                    0
                    • 版块
                    • 最新
                    • 标签
                    • 热门
                    • 用户
                    • 群组