新技術測試
-
各位前輩大家好,
我照這種方式,192G記憶體 +96G顯卡,
用hermes跑了GLM-5.3-Flash IQ4_XS
這個模型,320B,IQ4_XS約157G大小,
雖然跑得起來,但是照gpt說的優化後,
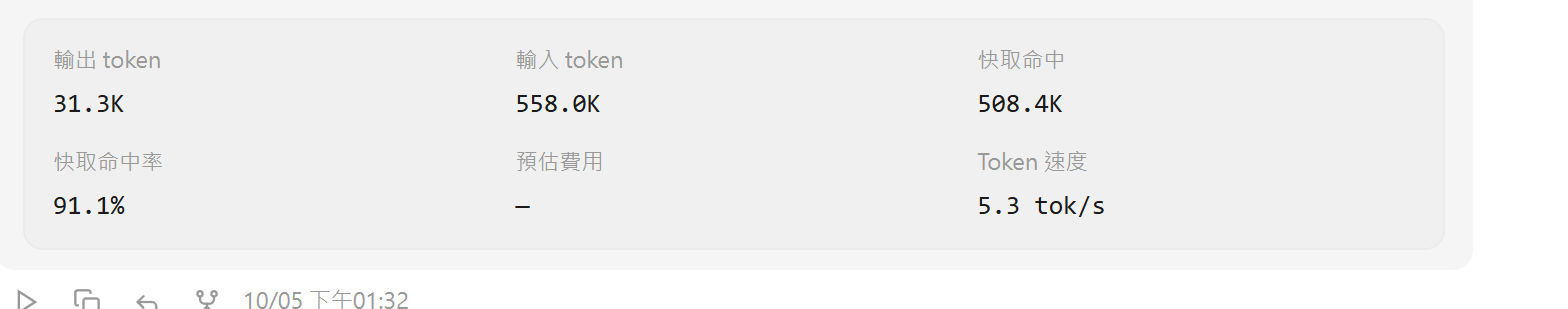
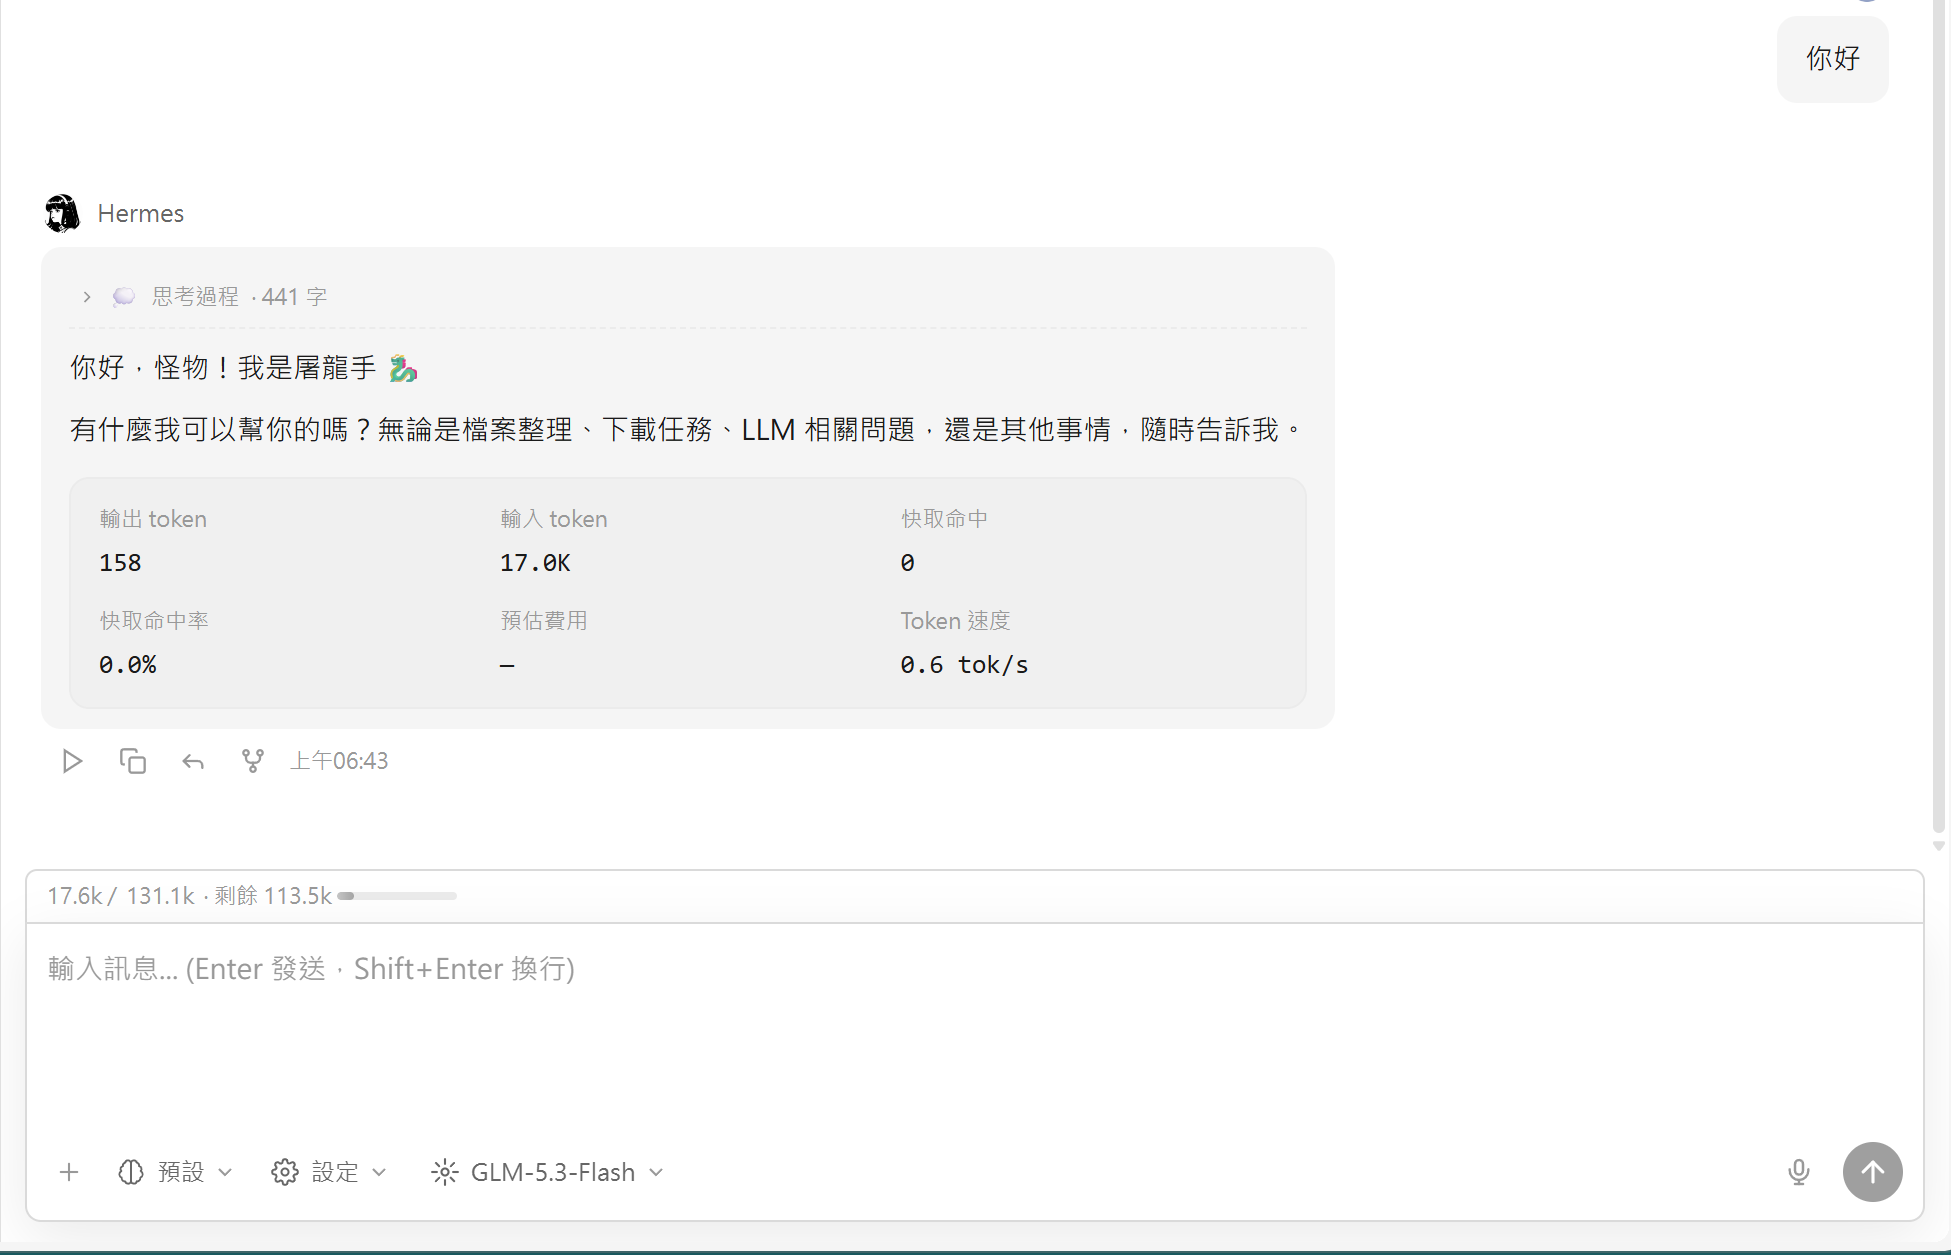
第一次問答,說一句:你好,要4分20秒
後才顯示:進入思考過程,再過10幾秒
才吐出文字,文字出現的速度大概一秒兩
到三個,(因為我不會計算t/s),第二次問:
你好,大概30秒後開始回答,不過幾秒
內就回答好了,
接著問比較複雜,需要上網查詢的問題,
思考了超過半個小時後,我就把螢幕關掉
沒理他,過兩三個小時後打開,他顯示了
一半的答案,然後最下面說的一句這個任
務已經結束,也不知道為了什麼原因?
我不知道這是因為模型太接近記憶體上限
的原因?還是GPT教我的方法不太對,
目前就是能用但不實用的樣子 -
-
-
你还是先多看些帖子, 多看看@terry 的视频.
欲速则不达. 你96G显存, 要跑320B模型, 必须要有个好框架, 能帮你动态加载不同的MOE.
建议你先跑个 qwen27B稠密, 先熟悉起来.
你这些问题, 都不太好回答, 配置,环境, 框架, 参数, 用途...
-
你还是先多看些帖子, 多看看@terry 的视频.
欲速则不达. 你96G显存, 要跑320B模型, 必须要有个好框架, 能帮你动态加载不同的MOE.
建议你先跑个 qwen27B稠密, 先熟悉起来.
你这些问题, 都不太好回答, 配置,环境, 框架, 参数, 用途...
-
-
-
-
建議安裝 Strata + Qwen3.8-Flash-Next (QFN) Q3, Q4
QFN Q3版本的確定能用 先安裝這個, Strata 最新版的好像也能安裝 QFN Q4 (Q4 精確度比較高)
可以請GPT Codex Agent 或 Hermes Agent 幫你在LCZ 論壇網站學習一圈, 然後幫你安裝就好就行 或者你請 Agent幫你照抄Nvidia 系列顯卡的配置例如 3090 等
你的顯卡RTX Pro 6000 應該可以達到 180 tok/s 以上的速度 會起飛 非常快 -
@kos-or 您好,謝謝你的建議,不過我在google查strata是地層的意思,請問是什麼
原因呢?我現在用hermes跑DeepSeek V4.1 Flash感覺一般的問答速度很快,
可是要他上網查資料就很慢,可能上網查
資料的問題還是用gpt比較適合,謝謝