
7900 XTX 的可能性探索|双卡篇(一): 魔改 SGLang + DFlash2 + HiCache,200+ t/s 与多 Agent 的丝滑体验
-
7900 XTX 的可能性探索|双卡篇(一): 魔改 SGLang + DFlash2 + HiCache,200+ t/s 与多 Agent 的丝滑体验
之前发的是单卡篇,现在开始水7900XTX双卡篇。
话说我给自己的双卡7900XTX这台机器目前配有四套日常生产配置,各有各的场景。但是我日常最愿意挂着的,还是魔改 SGLang + DFlash2 + HiCache这套。
场景 用哪套 日常主力、多文档切换、多Agent并发 魔改 SGLang 27B(跟以前发的帖子比,这是升级版,最新生产配置见末尾) 单卡推理,另一张卡出图 单卡 DanielMTP 27B(单卡篇一,最新生产配置见末尾) 要一个大模型做深度推理 Flash Next 125B(单卡篇四) 27B和Flash Next既要又要 双卡独立(双卡篇二) 这篇的重点不是"双卡比单卡快多少"——倒也不是说不快——但是我一两个月使用下来觉得真正决定体验的,是 SGLang 高并发速度和高速缓存命中带来的丝滑流畅的使用体验
 。
测试硬件与环境
项目 配置 CPU AMD Ryzen 5 9600X 主板 GIGABYTE B850 AI TOP AMD AM5 ATX 系统内存 64GB DDR5 GPU AMD Radeon RX 7900 XTX 24GB × 2 PCIe PCIe 4.0 x8(安装双卡后该槽位工作在 x8) OS Linux ROCm 7.2.3 两个后端在同一台机器上分别测试,模型不同:
单卡 DanielMTP 魔改 SGLang DFlash2 后端 llama.cpp HIP SGLang 模型 Qwen3.8-27B-Uncensored Q4_K_M(GGUF) Qwen3.8-27B W4A16 AutoRound GPTQ 卡 GPU0 单卡 (测试成绩是 PCIe 4.0 x8 下测的,单插还能更快些) 双卡 TP=2 视觉 支持(mmproj-F16) 模型带 vision_config
一、先看测试成绩
1.1 生成速度(TG)与首处理速度(PP)
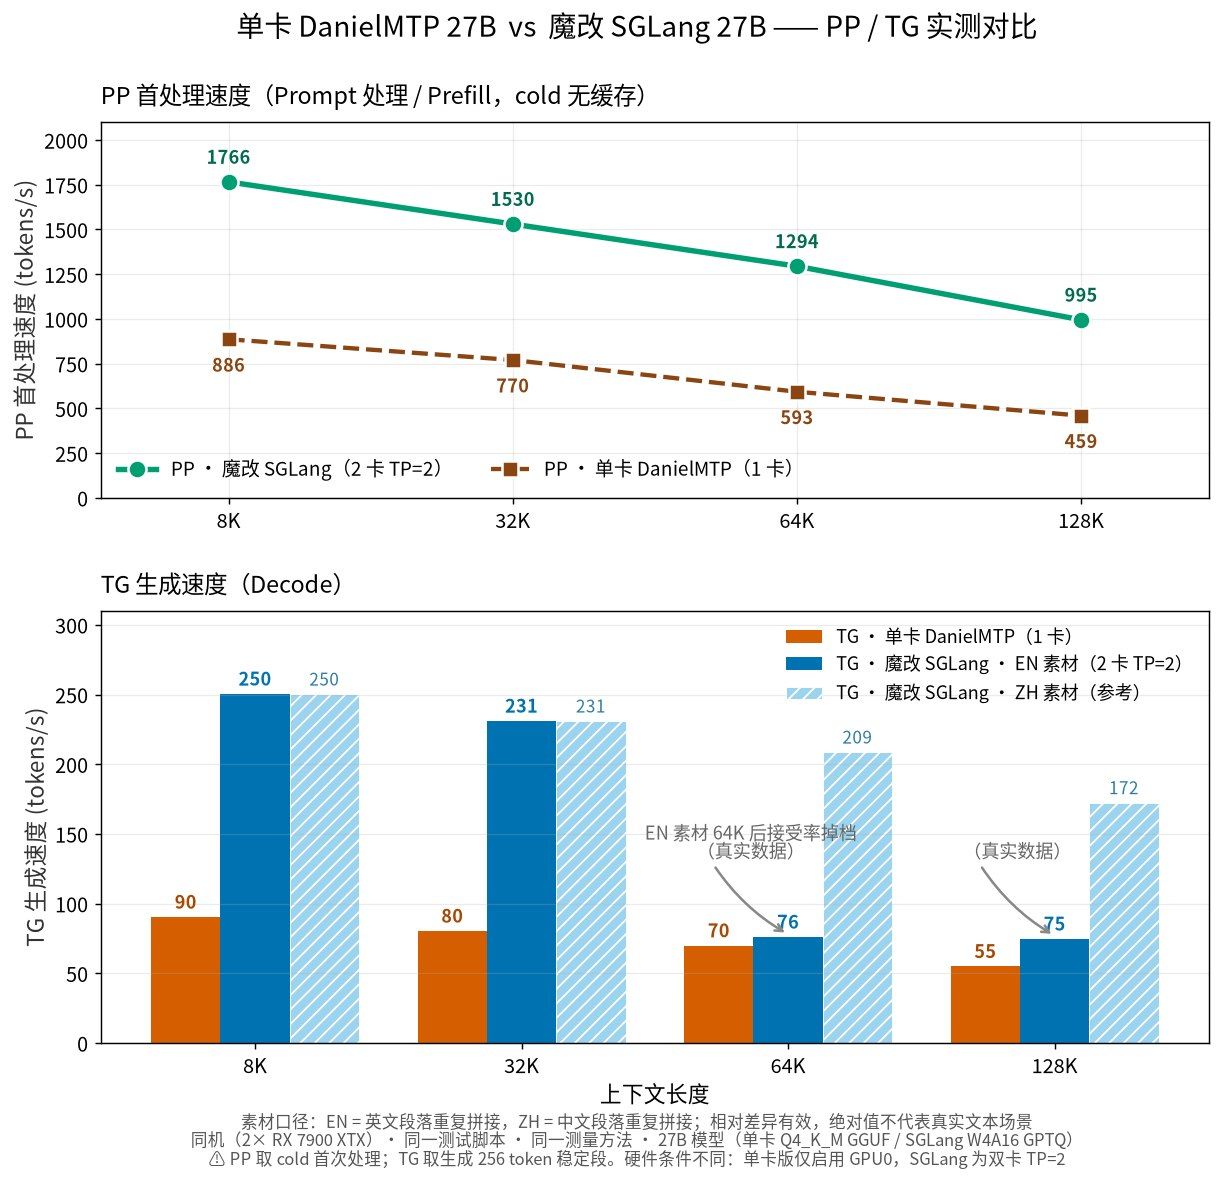
- 列表同一脚本、同一测量方法(但是很奇怪我发现SGLang的DFlash2对中英文敏感,英文prompt掉速):
上下文 PP 单卡 PP SGLang TG 单卡 (EN) TG SGLang (EN) TG SGLang (ZH) TG SGLang (CODE) 8K 886 t/s 1,766 t/s 90.3 t/s 250.4 t/s 250.4 t/s 250.2 t/s 32K 770 t/s 1,530 t/s 80.3 t/s 231.0 t/s 231.1 t/s 230.8 t/s 64K 593 t/s 1,294 t/s 69.8 t/s 76.0 t/s 208.8 t/s 209.5 t/s 128K 459 t/s 995 t/s 54.9 t/s 74.6 t/s 172.5 t/s 172.4 t/s 素材口径:EN = 英文段落重复拼接,ZH = 中文段落重复拼接。单卡侧只测了 EN。SGLang 在 EN 素材 64K 之后 TG 掉到 76 t/s(我也不理解为什么会这样

 ),换成中文素材或测coding则不掉档(208.8 / 172.5)。
1.2 缓存容量对比
单卡 DanielMTP 27B 魔改 SGLang DFlash2 27B 显存内KV 246K tokens 166K tokens 宿主内存 --cache-ram 24576(24 GB)hicache 332K tokens 合计 约 246K tokens 缓存池理论合计容量:约 498K tokens 超容量行为 CPU 空转卡死(原因不明) 优雅淘汰 两者的机制不同:llama.cpp 的
--cache-ram是把历史提示词的 KV 副本放在宿主内存(PR #16391 描述为 "extra slots"),命中时热插回显存,省掉重算;SGLang 的 HiCache 是分级缓存(L1 显存 + L2 宿主内存)。单卡"合计"取显存上限 246K,不与内存副本相加。二、实测对比
- 同一套测试脚本、同一组提示词、同样的测量方法,两边各跑一遍。
测试 1:连续处理 10 个不同的 3 万字文档,然后回头重问
单卡 DanielMTP 魔改 SGLang 第 1 轮(10 个文档) 每个约 39–40 秒 每个约 20 秒 第 2 轮(回头重问) 第 8 个卡死 10/10 全部命中 缓存命中后响应 无法测 0.35 – 0.52 秒 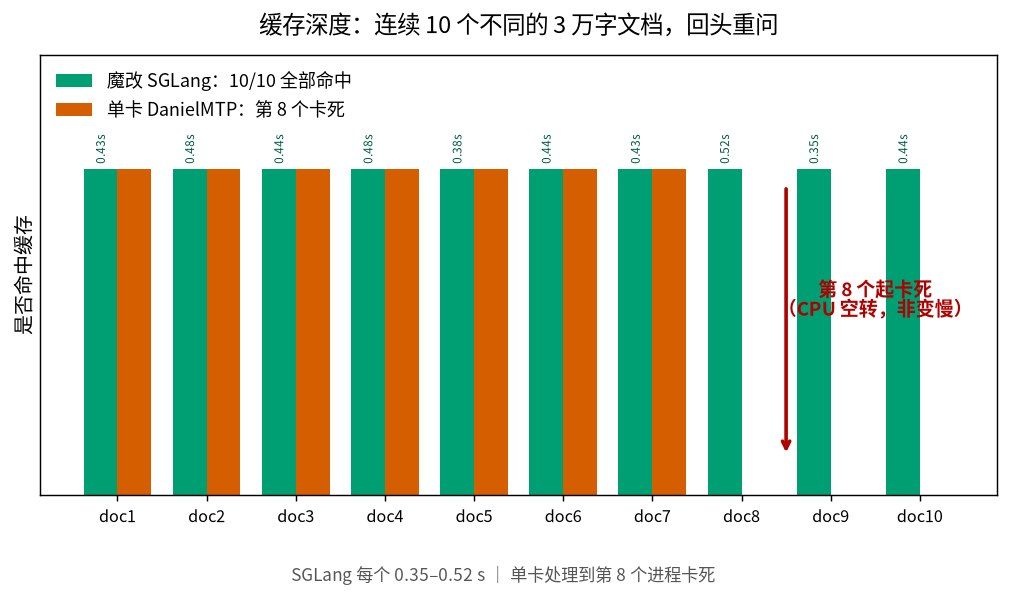
测试 2:同一个 3 万字提示重复请求
单卡 DanielMTP 魔改 SGLang 首次(无缓存) 38.8 秒 21.4 秒 第 2 次(命中) 1.10 秒 0.56 秒 加速比 约 35 倍 约 38 倍 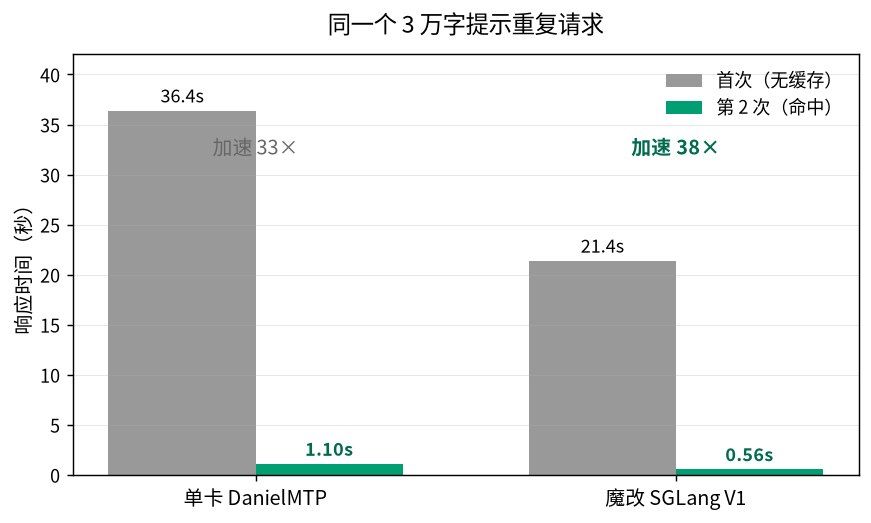
测试 3:并发(8K 提示,各生成 128 token)
并发数 单卡 DanielMTP 魔改 SGLang 1 24.9 t/s 24.9 t/s 2 82.0 t/s 307.0 t/s 4 82.1 t/s 353.0 t/s 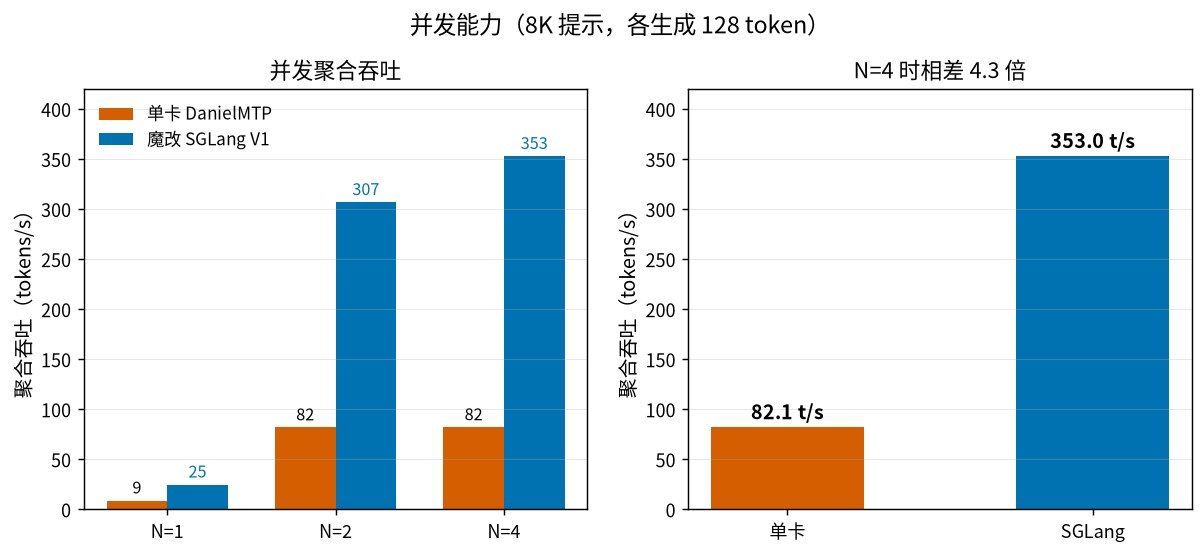
三、为什么我最后最常用的是 SGLang
不是因为它生成快——虽然它确实快(8K 有 250 t/s)。
是因为多并发,还有缓存命中后那个响应速度。
关于SGLang的多并发: N=4 时聚合 353 t/s,而单卡到 N=2 之后基本封顶在 82 t/s——因为它只有一张卡、一个 slot,请求只能排队。
关于高速缓存命中: 我上传一个 30K 文档,问一个问题,第一次要等 20 秒(模型算完 3 万个 token)。第二次再问同样的东西,缓存命中后约 0.35–0.52 秒完成响应。差了将近 40 倍。丝滑无感的体验。我双开的时候,经常要怀疑是不是 fallback 到 Deepseek Flash 了,输入
/status一看,妥妥的还是在本地 27B 上。这个差别在实际用的时候很直观:同一份文档反复问、多轮对话、切换几份材料——前面的内容基本都还在,不用重新算。而且吐字很快,响应迅速。SGLang 的这个高速缓存命中和响应速度真的很赞。
我的单卡 27B 那套加了
--cache-ram 24576其实缓存机制也有(约 35 倍加速),但容量小(24GB 宿主内存大约装 7 个 30K-token 文档)——而且我在测到第 8 个文档时它挂住了,进程 CPU 空转,只能强杀。 当然 27B 单卡在日常生活中不太容易碰到我这么变态的选手,一次非要喂它 10 个 30K 的大文件。饭要一口一口吃,单卡跑 27B 大家都知道怜香惜玉的,文件肯定会悠着点来喂,卡死这种极端的情况其实不常见。 ️ 这里要诚实说明三点:
- SGLang 我只测到 10 个文档,没测出它的上限。 准确说法是"至少能装 10 个",不是"上限就是 10 个"。
- 单卡那边 7 个是挂住点,不是"优雅淘汰点"。 这是 llama.cpp 超容量时的行为,跟 SGLang 的淘汰机制不一样。
- 这个挂住我还没定位到根因。 我最初的测试脚本里有大量短请求(tokenize)和长生成混跑,可能诱发了这个问题;后续需要干净的脚本复现才能下结论。这里先如实记录现象,不当结论。
四、几点踩坑记录
1. KV 量化必须对称。 K 和 V 要用同一种类型(
q4_0+q4_0,或q8_0+q8_0)。混搭会让 flash-attn 静默回退,慢 17–24%,而且不报错不警告。2. 单卡 llama.cpp 跑长上下文时,
--cache-ram对多文档反复切换很有价值。 它不是把当前 active KV 从显存溢出到内存,而是在宿主内存保存可复用的 KV cache 副本,后续命中时避免重新计算。我的配置给了 24GB RAM cache。3.
-fa on不能省。 不开会导致 KV 布局劣化 + 显存吃紧。
五、详细配置
5.1 魔改 SGLang 27B DFlash + HiCache(仅开 L1 和 L2,需要机器最好 64G 内存以上)
--model-path /data/models/Qwen3.8-27B-W4A16-AutoRound-GPTQ
--tp-size 2 --quantization gptq
--dtype bfloat16 --mamba-ssm-dtype bfloat16
--kv-cache-dtype auto --attention-backend triton
--mamba-backend triton --linear-attn-backend triton
--context-length 262144 --mem-fraction-static 0.83
--max-running-requests 4 --max-total-tokens 300000
--max-mamba-cache-size 24
--chunked-prefill-size 8192
--hicache-size 16 --hicache-ratio 2.0
--hicache-io-backend kernel
--hicache-host-memory-mode cache
--hicache-write-policy write_through
--enable-hierarchical-cache
--cuda-graph-bs-decode 1 2 4
--triton-attention-num-kv-splits 16
--reasoning-parser qwen3 --tool-call-parser qwen3_coder
--default-chat-template-kwargs '{"enable_thinking": false}'
--stream-interval 1 --trust-remote-code

# Speculative (DFLASH2)
--speculative-algorithm DFLASH
--speculative-draft-model-path /data/models/Qwen3.8-27B-DFlash2-W4A16
--speculative-num-draft-tokens 8
--speculative-draft-window-size 2048
5.2 单卡 DanielMTP(开了
--cache-ram,内存至少 32G)SERVER=/data/llamacpp-danielmtp-hipbuild/bin/llama-server -m /data/AI/models/llm/qwen38-27b-uncensored/Qwen3.8-27B-Uncensored-Q4_K_M.gguf --mmproj /data/AI/models/llm/qwen38-27b-uncensored/mmproj-F16.gguf --no-mmproj-offload --host 127.0.0.1 --port 8084 --ctx-size 245760 --parallel 1 -ngl 999 -dev ROCm0 --fit off --cache-type-k q4_0 --cache-type-v q4_0 --cache-ram 24576 --flash-attn on -b 1024 -ub 256 --spec-type draft-mtp --spec-draft-n-max 6 --jinja --chat-template-file /data/AI/models/llm/qwen-chat-template-fixed/chat_template.jinja --reasoning auto --reasoning-format deepseek --temp 0.2 --top-k 20 --top-p 0.9 --min-p 0.03 --repeat-penalty 1.05 --alias qwen38-27b-mtp-240k模型:Qwen3.8-27B-Uncensored Q4_K_M(15.65 GB,自带 MTP 头)
两个后端的模型与引擎来源
单卡 DanielMTP 魔改 SGLang 模型 Qwen3.8-27B-Uncensored Q4_K_M(GGUF,自带 MTP 头) Qwen3.8-27B W4A16 AutoRound GPTQ 模型基础 Qwen3.8-27B(去审查版) Qwen/Qwen3.8-27B 引擎 llama.cpp(daniel-mtp 分支编译) SGLang MTP 机制来源 ggml-org/llama.cpp 的通用 NextN/MTP 投机框架<br>PR #27836 · PR #28243 — Draft 模型 内置(GGUF 自带 blk.64.nextn.*,无需单独文件)incoai/Qwen3.8-27B-DFlash2
如果你也在折腾 7900 XTX,欢迎交流。我的水贴有不足之处或是您有更好的方案也请多提意见。
相关链接并致谢

-
@flyer666 大佬原帖:魔改 SGLang 双卡 TP
https://lcz.me/topic/1532
本文这套魔改 SGLang 双卡方案的主要来源,感谢 @flyer666 大佬的分享。 -
StevenChenSE / SGLang — gfx1100-support
https://github.com/StevenChenSE/sglang/tree/gfx1100-support#chinese
RX 7900 XTX / gfx1100 支持及相关优化代码。
-
-
-
-
,
B Ben Lee 引用了 此主题
-
-

