
续篇:单卡RTX5080跑Qwen3.8-27B,开关思考与 Q4性能对比
-
平台:Windows 11 + WSL2 Ubuntu 24.04、RTX 5080 16GB、本地 NInfer 版 Qwen3.8-27B。本文是上一篇部署与速度实测的续篇:这次看答题、代码和图文生成,还让本机 NInfer 答同一批 800 道选择题,与公开 Q4_K_M/BF16 逐题结果对照。Q4 与 BF16 未在本机运行。
上篇证明了这套配置能够跑起来,也测了 98K 长序列吞吐。读者更关心的下一问是:这约 3.953 BPW 的 NInfer 版,做实际任务时怎么样?开思考能否减少错误?和常见 Q4 到底能比到哪一步?
先说结论:在本机的两道可客观判分的复杂题上,关思考均答错,开思考均答对;代价是单次请求更慢、输出 token 更多。到了网页和 SVG,思考模式并不保证成品正确或好看。同一批 800 道题上,本机 NInfer 关思考答对 674 题(84.25%),公开 Q4_K_M 为 692 题(86.50%),BF16 为 696 题(87.00%)。但 NInfer 与公开结果的取答案协议不同,这个数字差异不能直接归因于量化或模型能力。
一、测试怎么做
本机仍运行同一个
qwen3_8_27b.ninfer文件和 NInfer 服务。复杂任务各请求一次,temperature=0;设置分别为reasoning_effort: "none"与"medium"。完整请求和原始响应均已留存。单题单次结果适合展示案例,不适合推断总体准确率。这里有一个必须说明的变量:**两组的输出上限并不完全相同。**排程和金额核算,关思考给 900 token,开思考给 2,500 token;科学 SVG 关思考给 3,400 token,开思考先给 3,400,截断后又补测 7,000;交互网页关思考给 4,100,开思考给 8,000。因此,这是“让思考有足够空间”的实用配置对照,不能把全部差异归因于思考开关。
二、两道有标准答案的题:开思考答对了
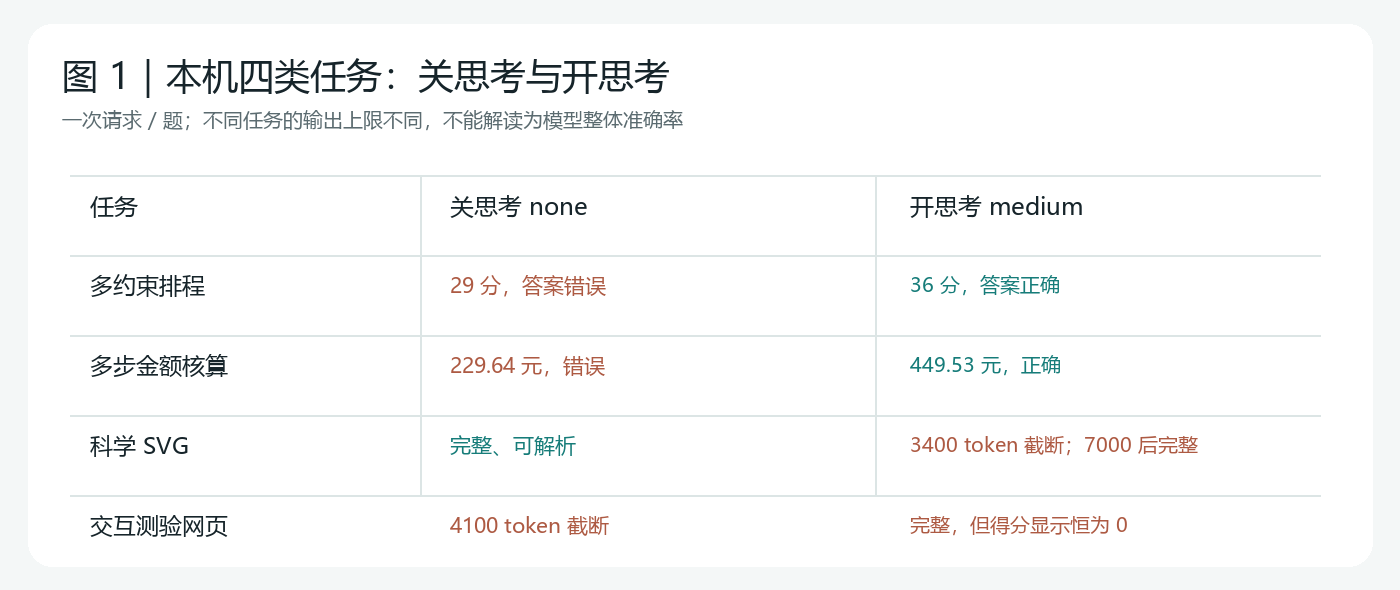
第一题是八个有时间冲突的任务,要求选出总分最高、格式严格的 JSON。正确结果是 B、D、F、H,共 36 分。关思考返回 A、C、E、G,共 29 分,还带了代码围栏;开思考返回了正确 JSON。
第二题是商品折扣、优惠券、税和运费的连续计算。正确过程是:折后商品 442.76 元,减券 412.76 元,税 24.77 元,加运费后合计 449.53 元。关思考给出 229.64 元,开思考得到 449.53 元。
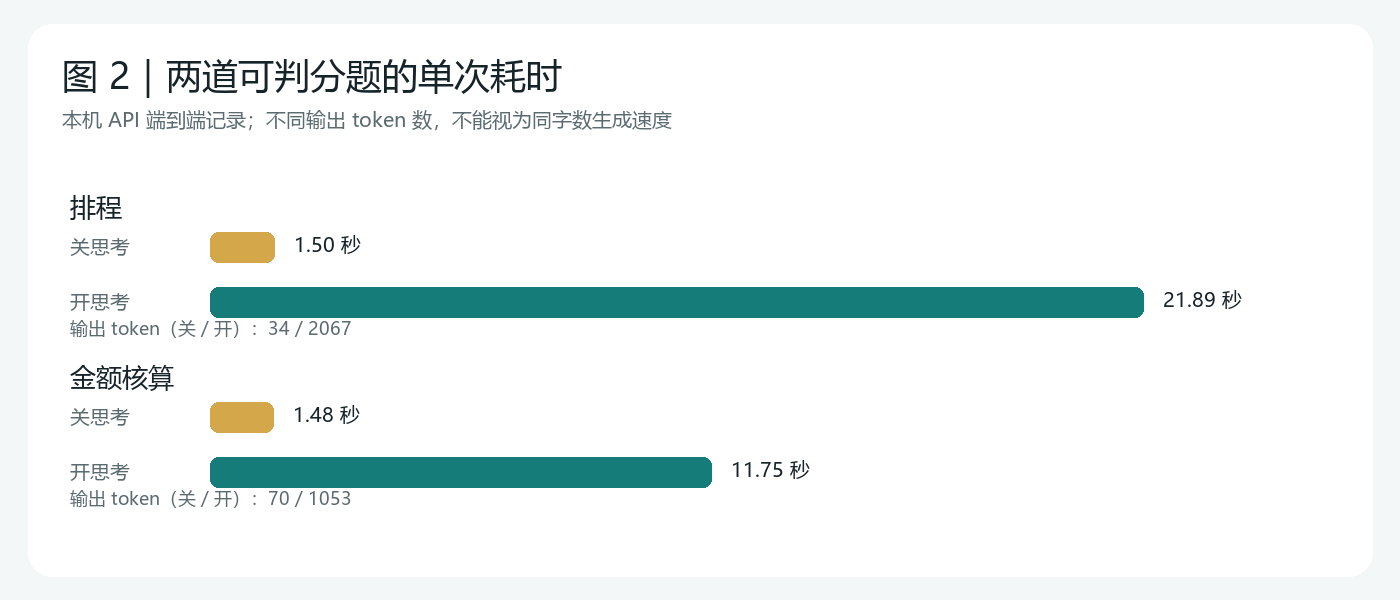
题目 关思考 开思考 正确答案 多约束排程 29 分,错误 36 分,正确 36 分 多步金额核算 229.64 元,错误 449.53 元,正确 449.53 元 开思考并非免费。两题的本机 API 端到端单次耗时分别从 1.50 秒到 21.89 秒、从 1.48 秒到 11.75 秒;输出 token 分别从 34 到 2,067、从 70 到 1,053。这是不同长度答案的一次请求记录,不能当作同字数解码速度,也不能推算平均性能损失。
三、代码与图文生成:思考也会犯错
科学 SVG 题要求画一张“光合作用”信息图并标全六个关键要素。关思考在 3,400-token 上限内输出完整、可解析的 SVG;开思考第一次在同样上限被截断,改为 7,000 token 后才完整。能否闭合文件与输出预算直接相关。
三题单选测验网页则呈现相反的边界:关思考在 4,100 token 被截断;开思考用 8,000 token 输出了完整页面,但代码先生成“得分:0/3”再累加分数,导致页面显示的得分始终是 0。单看 HTML 闭合和 JavaScript 语法,发现不了这种逻辑错误。
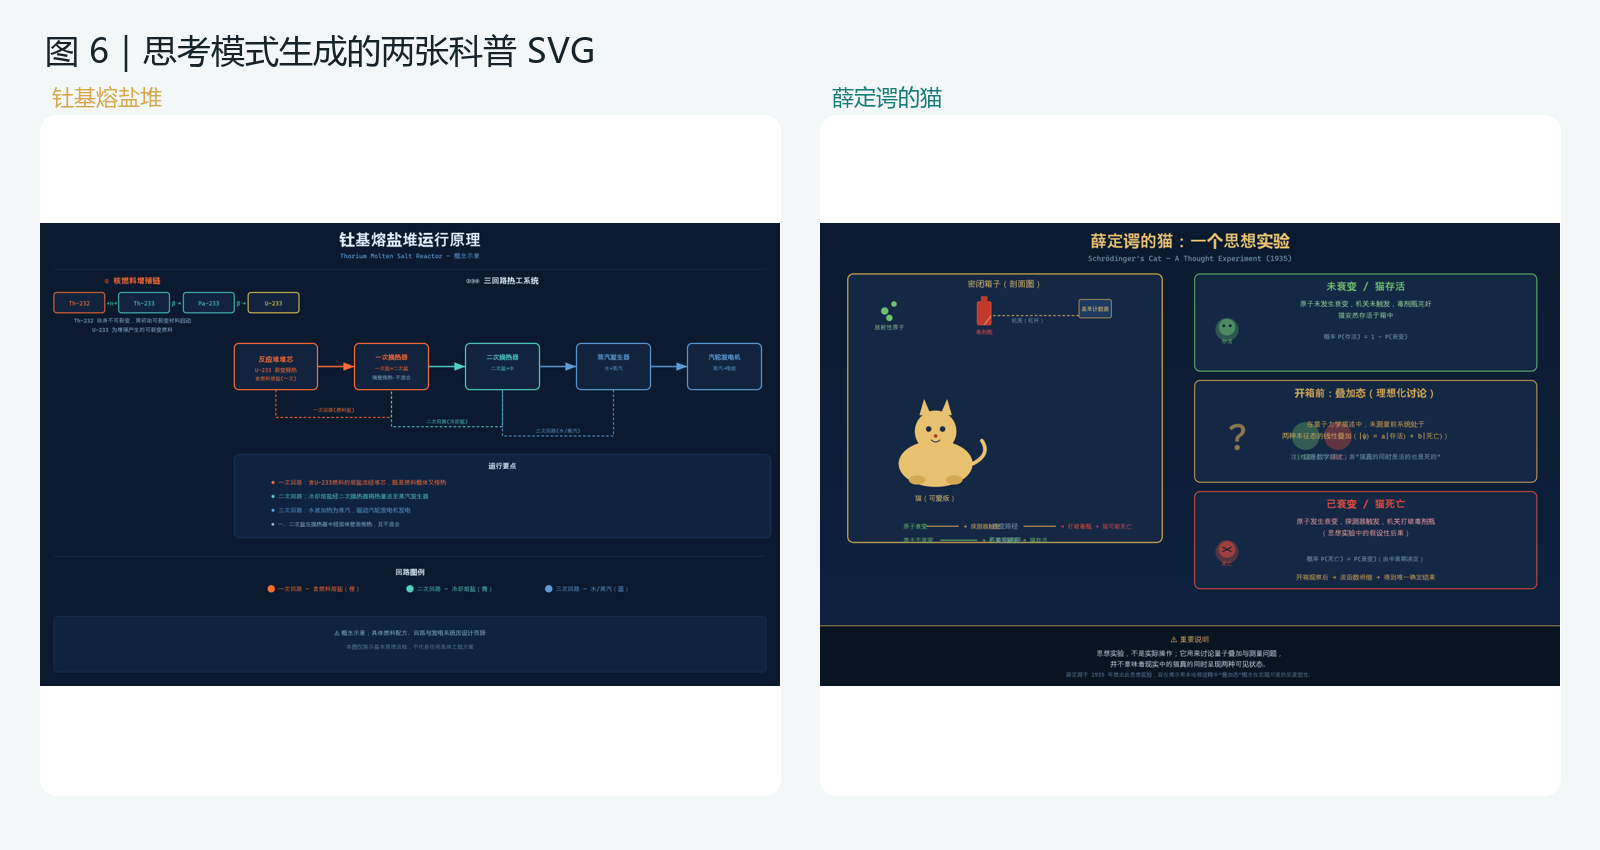
我还让本地模型分别在关思考和开思考下生成鹈鹕骑车、八卦文化、钍基熔盐堆、薛定谔的猫等 SVG/HTML。五个思考版文件都完整返回;三张 SVG 可解析并渲染,两张网页的脚本通过语法检查。但这些主题图不能当作严格盲测:部分提示词不完全相同,旧版和新版文件也有少量人工修正。下面截图用于展示成品风格与具体问题,不计算胜率。
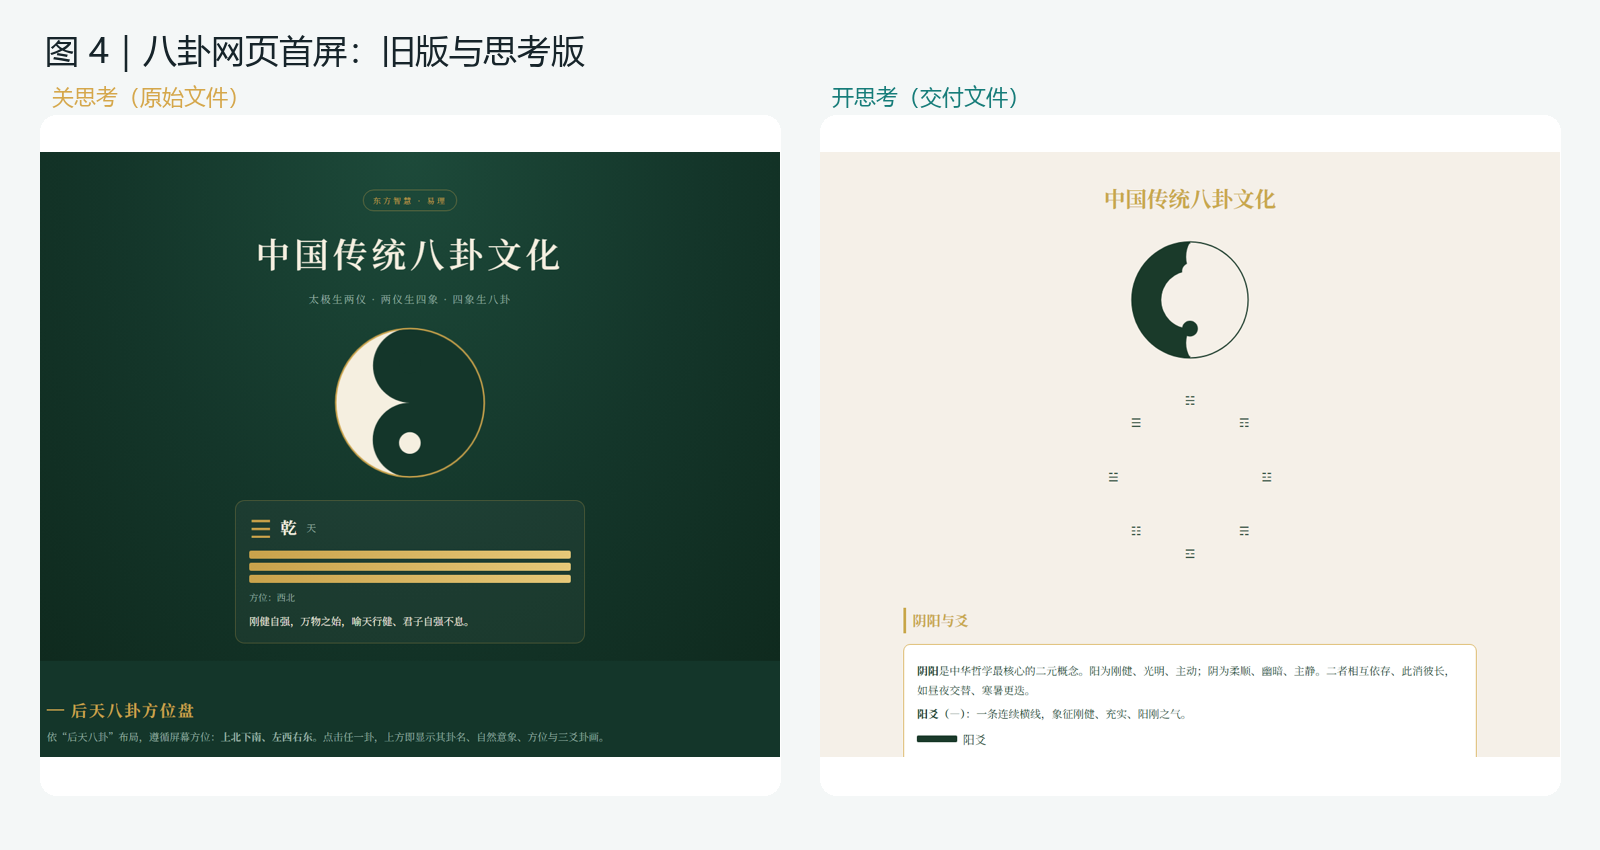
八卦网页尤其说明“开思考 ≠ 自动更好”。关思考版首屏层次更完整;开思考版更简洁,但原始代码把卦画三爻上下顺序倒置。交付文件已人工修正,截图展示的是修正后的版本。若直接发表模型原始输出,这个错误需要保留并指出。
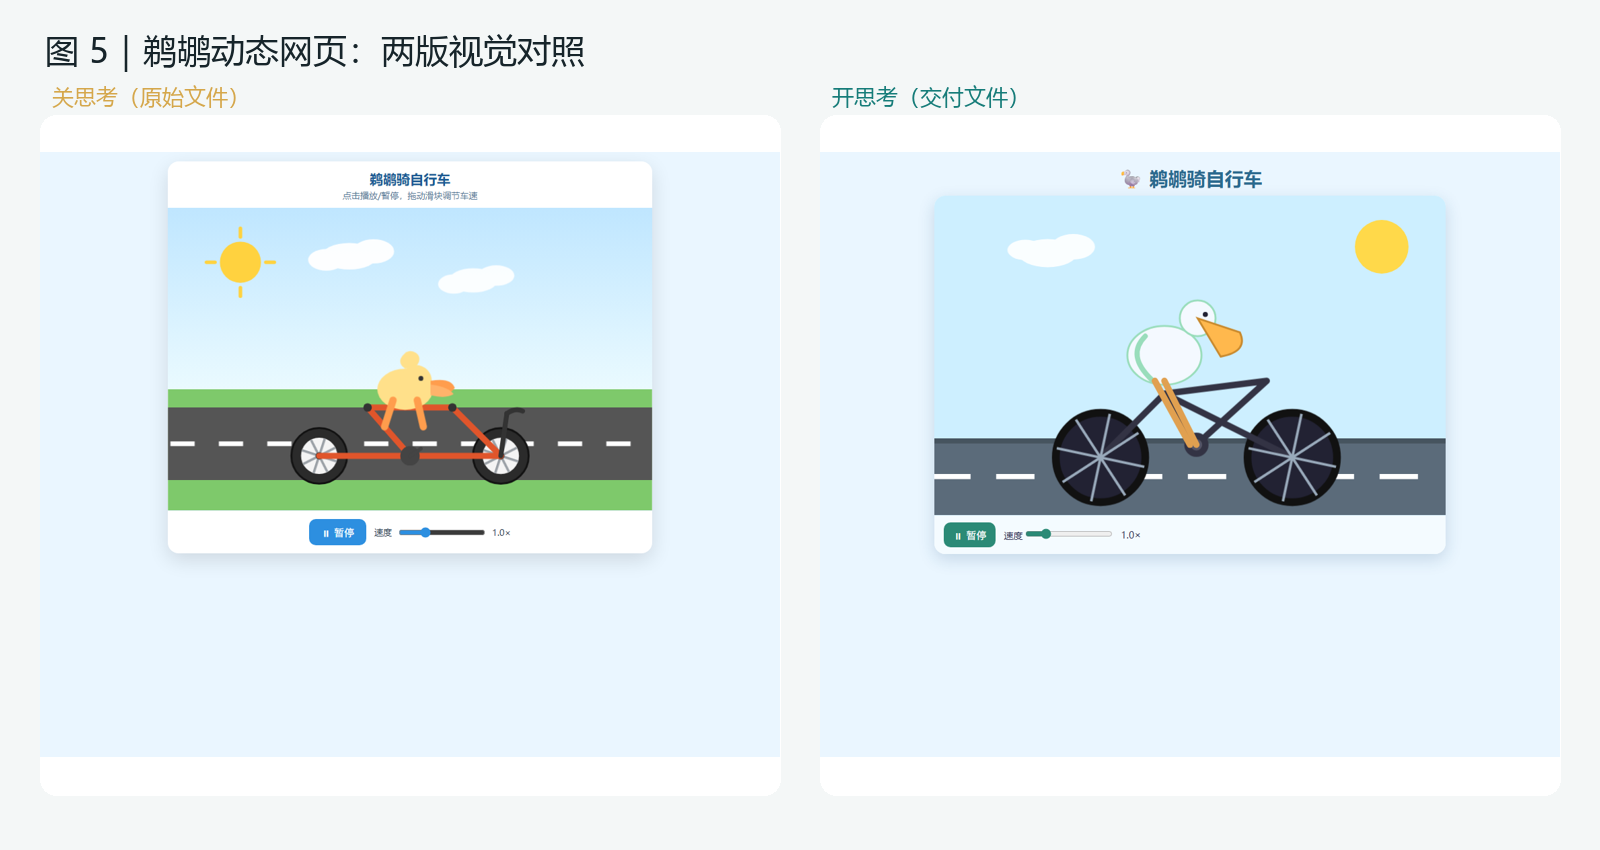
鹈鹕网页两版都能在本地打开,思考版的视觉不一定优于关思考版。单看截图也无法验证动画、暂停键和速度滑块的运行逻辑。科学图还需人工复核概念和标注,不能只凭 XML 可解析就认定准确。
四、同一批 800 道题:本机 NInfer 也参加
为补上本机成绩,我按 topabaem 的 Q4_K_M/BF16 评测使用的固定版本,重建了 MMLU 570 题与 ARC-Challenge 230 题。800 题的有序题目指纹是
a72515282c6fc20f34188b3102d99468ab2b02266105ed9c6e4ec405fbad8fd0,与公开评测一致;逐题标准答案也与公开的 Q4 原始记录逐项相同。接着用本机 NInfer 对这 800 题顺序作答,temperature=0、reasoning_effort="none"、最多 8 个输出 token,只接受单个 A/B/C/D 字母,其他输出按预设规则计错。同一批题 本机 NInfer(关思考) 公开 Q4_K_M 公开 BF16 MMLU(570 题) 455(79.82%) 472(82.81%) 476(83.51%) ARC-Challenge(230 题) 219(95.22%) 220(95.65%) 220(95.65%) 合计(800 题) 674(84.25%) 692(86.50%) 696(87.00%) 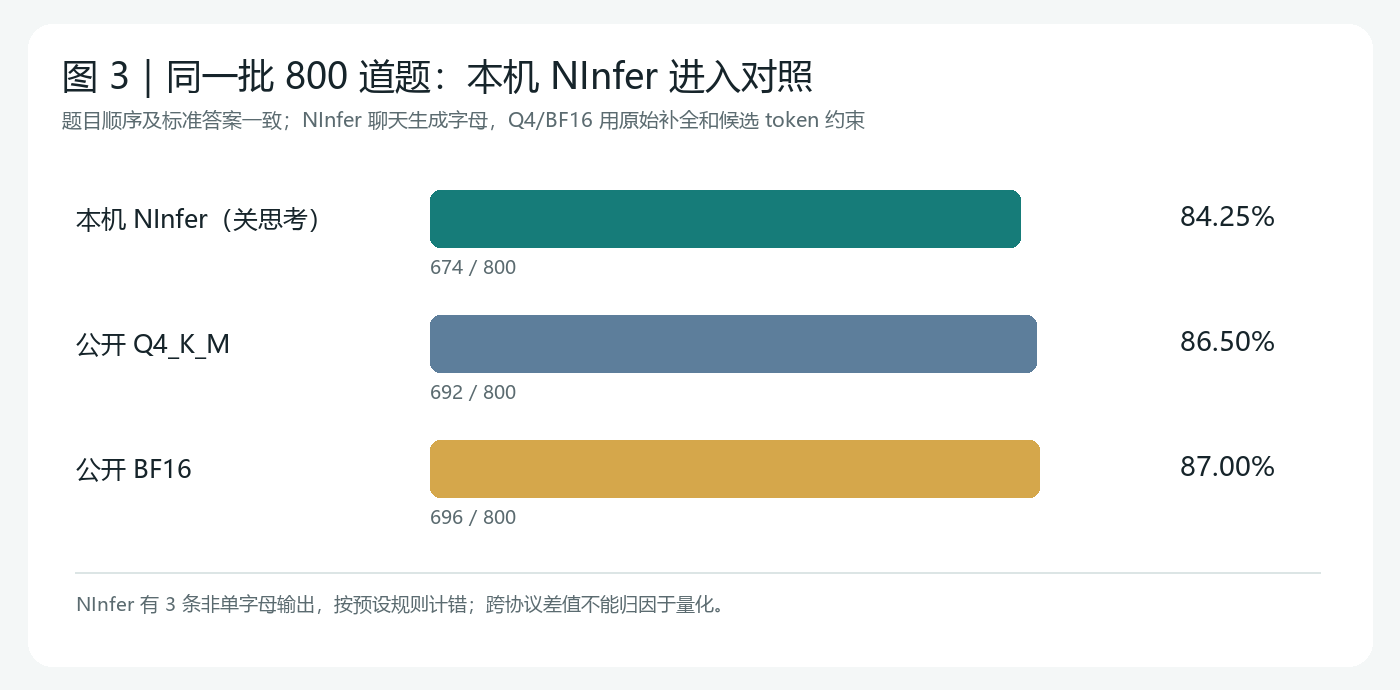
本机 NInfer 比公开 Q4_K_M 少答对 18 题,表面差 2.25 个百分点。其中 MMLU 相差 17 题,ARC 相差 1 题。NInfer 有 3 条输出不是单个字母,原文分别是
Anaphylaxis is a severe,、空字符串和Well,均按错误计入;没有事后替模型补选项。**最重要的边界是协议。**公开 Q4/BF16 用原始补全提示词,通过相同的选项 token bias 强制只从 A/B/C/D 选一项,再按首 token 评分;本机 NInfer 服务目前没有同样可用的原始补全和 token 概率接口,其
logit_bias字段虽能解析但不作用于生成。因此本机使用聊天接口、单字母指令和严格答案解析。题目与标准答案相同,提示词包装和选项约束不相同。这次测试真实反映了本机 NInfer 在该 API 用法下的表现,但不能据此宣称它的量化质量比 Q4_K_M 低 2.25 个百分点。本机用的是 ninfer-5080 发布的混合 Q3/Q4/Q5 NInfer 文件,约 3.953 BPW;公开 Q4_K_M 是另一套 GGUF 文件。Q4_K_M 与 BF16 在其同协议测试中相差 0.50 个百分点;这个结论仅适用于该文件与该题集。两边的显卡与推理框架也不同,公开吞吐数字不能与本机 tok/s 直接排名。
五、我的使用结论
日常改写、提纲和短回答,可以先关闭思考模式以减少等待;多约束排程、金额核算等需要逐步推演的任务,可以开启思考模式,并留足输出 token。网页、代码和科普图无论是否开启思考,都需要实际运行并人工核对。这台 RTX 5080 上的 NInfer 版已具备日常生产力价值,但思考模式并非无条件的质量开关。
在同一批 800 道选择题上,本机 NInfer 关闭思考模式答对 674 题(84.25%),公开 Q4_K_M 答对 692 题(86.50%)。两组结果使用相同题目和标准答案,但取答案方式不同:本机通过聊天接口生成选项字母,公开 Q4 测试则约束候选 token 后评分。这些数据展示了各自测试条件下的表现,阅读差值时应保留这一口径区别。
资料与口径:上一篇部署实测 · 本机 NInfer 模型卡 · Q4_K_M/BF16 同协议评测 · 公开逐题评测文件。本机 800 条逐题原始输出和结果已保存;每题只测一次,未进行多次重复。
-
-

