跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!

【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!

已定时 已固定 已锁定 已移动 热议 LLM讨论区
stratadeepseek本地模型
27 帖子 13 发布者 1.1k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • gao GaoG
    gao GaoG
    gao Gao
    编写于 最后由 编辑
    #9

    @david-chen 你牛

    1 条回复 最后回复
    0
    • fcmeF
      fcmeF
      fcme
      超凡大师
      编写于 最后由 编辑
      #10

      deepseek的ngram架构确实很好,Qwen这个flash就用了啊,部分内容以查代算。
      你这个一直再搞搞肯定是可以成功的,只不过工作量太大了,你要没有超级计算机的话

      johnnybegoodJ 1 条回复 最后回复
      0
      • fcmeF fcme

        deepseek的ngram架构确实很好,Qwen这个flash就用了啊,部分内容以查代算。
        你这个一直再搞搞肯定是可以成功的,只不过工作量太大了,你要没有超级计算机的话

        johnnybegoodJ
        johnnybegoodJ
        johnnybegood
        超凡大师
        编写于 最后由 编辑
        #11

        @fcme 是的, 要写10000行代码, 还不一定成功。确实没时间。从硬件分析角度来说, 其实也收益不会太大。

        fcmeF 1 条回复 最后回复
        1
        • johnnybegoodJ johnnybegood

          @fcme 是的, 要写10000行代码, 还不一定成功。确实没时间。从硬件分析角度来说, 其实也收益不会太大。

          fcmeF
          fcmeF
          fcme
          超凡大师
          编写于 最后由 编辑
          #12

          @johnnybegood
          确实,我花了两三天的时间想要把paiton框架用到的算子和内核移植到SGlang上面配合牛逼的缓存技术让本地跑27b的体验飞升。结果天不随我愿,虽然已经从官方版本的pp1100左右今天顶到了2350,TG也提高了大概35%左右,整体上已经几乎翻倍了,相比原生SGlang。但是还是不如paiton在vLLM下的绝对速度,最后各种尝试遍了以后发现还是内核支持的问题,哎,干这个工程量可就太大了,而且即使在AI时代有这个能力的人也不多吧。
          还是要看大神们发挥了。

          1 条回复 最后回复
          1
          • stxpnetS
            stxpnetS
            stxpnet
            超凡大师
            编写于 最后由 stxpnet 编辑
            #13

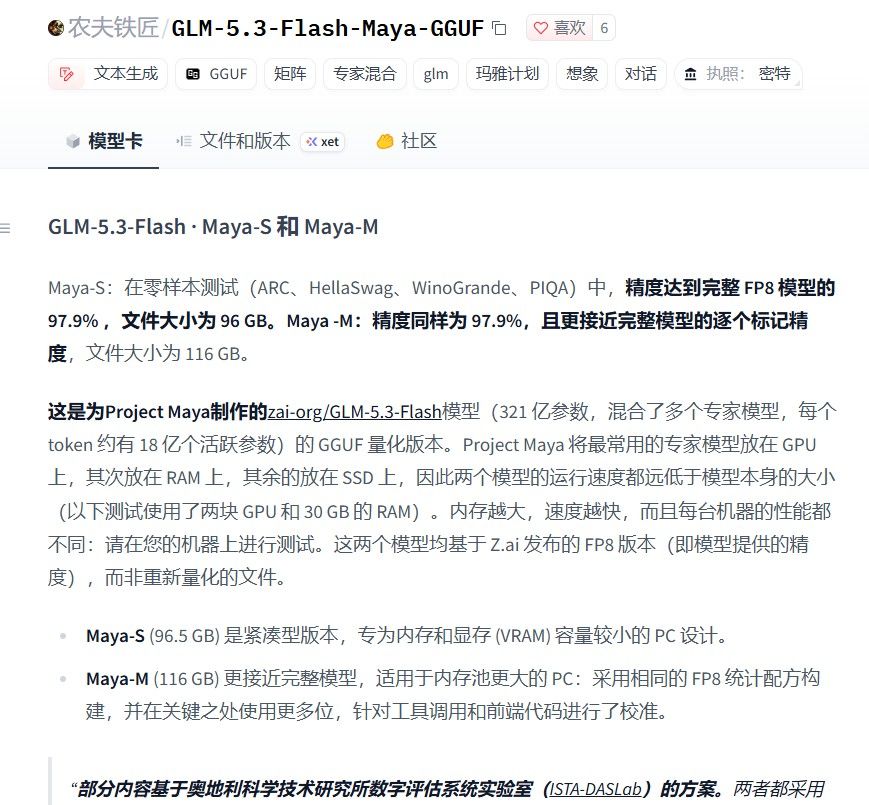
            image.jpeg

            https://huggingface.co/peasantsmith/GLM-5.3-Flash-Maya-GGUF
            有人已经做好了strata的fork了. 跑glm 5.3 flash,作者好像用的两张20系显卡.

            速度
            在两台配备 32GB 内存(30GB RAM)的 Tesla V100 上运行 Maya-S,并使用 Project Maya 进行测试:解码(写入答案)速度最高可达 40 个 token/s,支持 MTP 块草稿,即使在处理较长的上下文(60K tokens)时也能保持该速度;预填充(读取提示)速度最高可达 560 个 token/s。在一台配备 64GB RAM 的 Tesla V100 上:解码速度最高可达 19 个 token/s,预填充速度最高可达 370 个 token/s。 ./maya.sh --bench请以相同方式测试您的机器。

            运行它
            Project Maya(github.com/mw00/project-maya):使用一到两块 NVIDIA GPU,其余模型位于 RAM 和 SSD 上;图片通过上述视觉文件显示。./setup.sh下载、检查并设置 Maya-S;./setup.sh --setup --model Maya-M设置 Maya-M。
            llama.cpp构建支持 GLM-5.3-Flash ( glm5next),可将其作为任何 GGUF 加载。

            那些人一般用的claude code最强的套餐去改的这些框架.

            双卡3090 PCIE 4.0 16X/16X

            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
            1 条回复 最后回复
            1
            • gao GaoG
              gao GaoG
              gao Gao
              编写于 最后由 编辑
              #14

              看来用 智商 最高的大模型去 解决这类问题 实现拉一把小弟智商性能的 的渠道是可以打通的

              1 条回复 最后回复
              0
              • gao GaoG
                gao GaoG
                gao Gao
                编写于 最后由 编辑
                #15

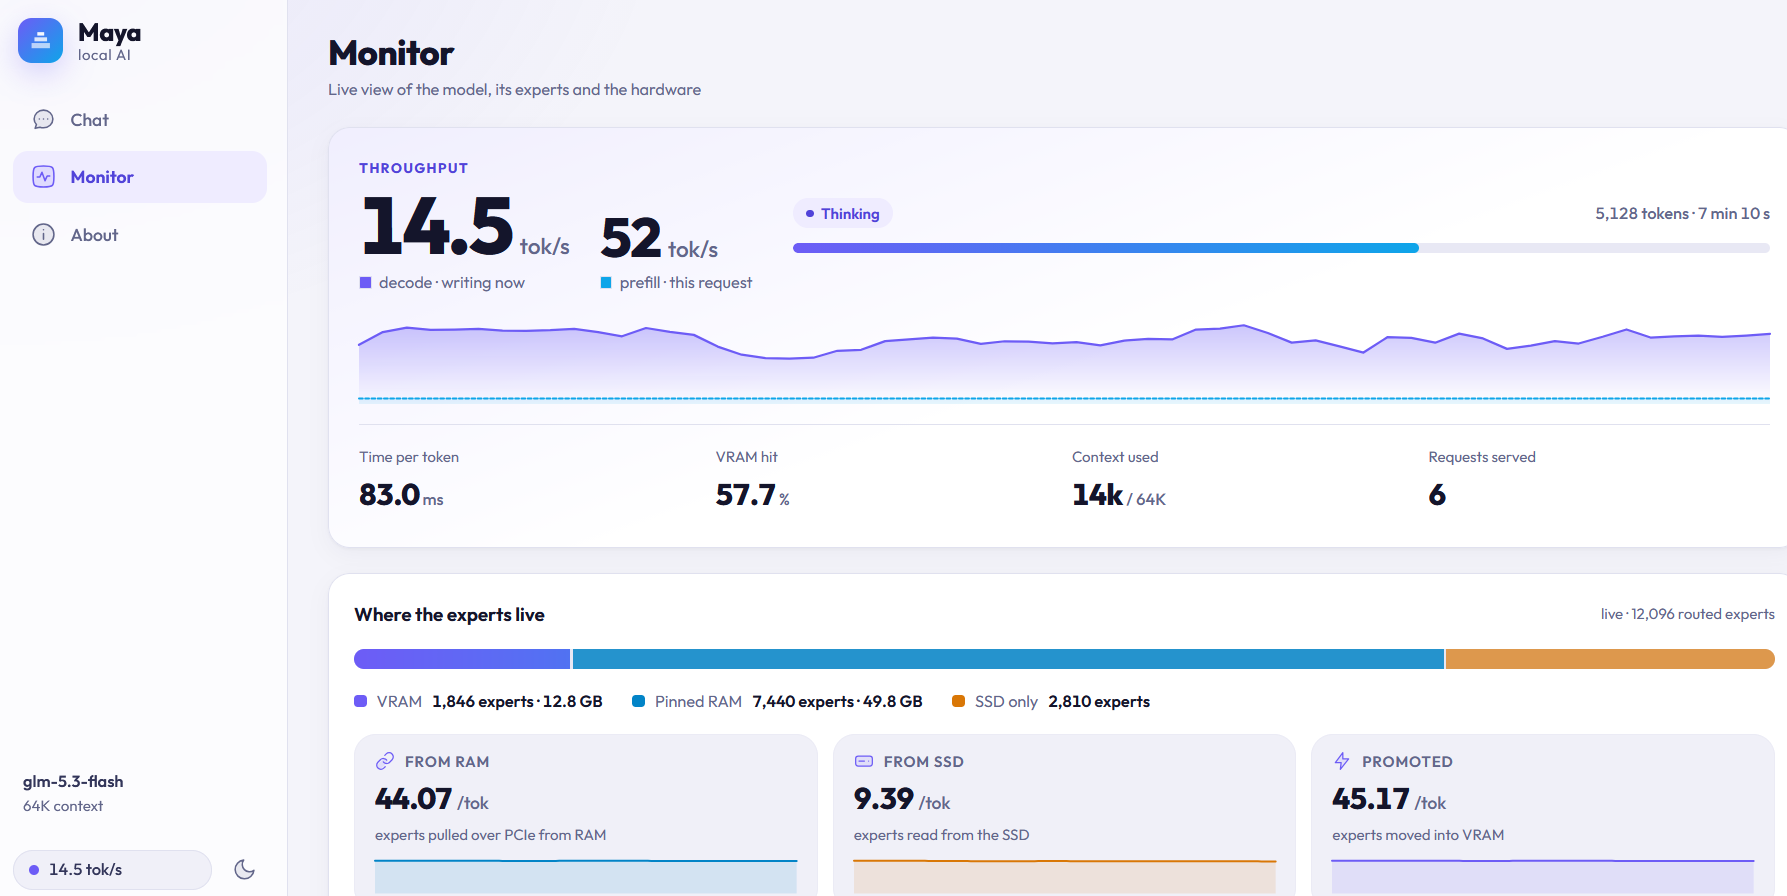
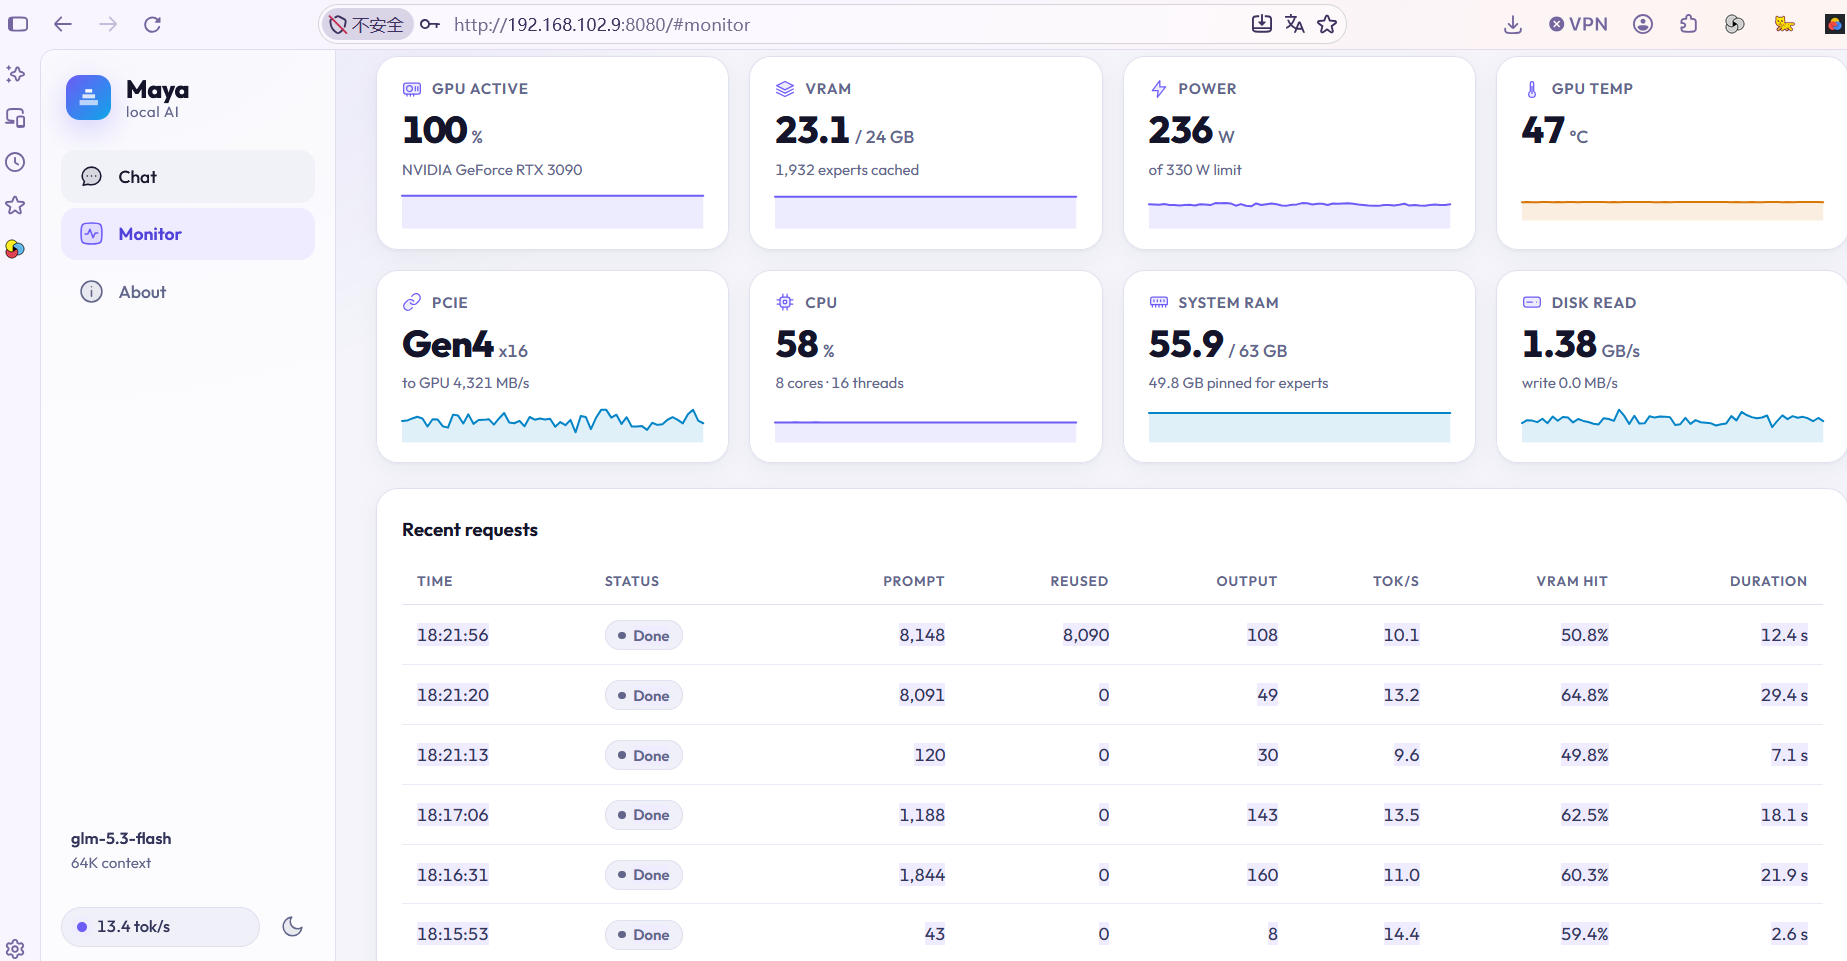
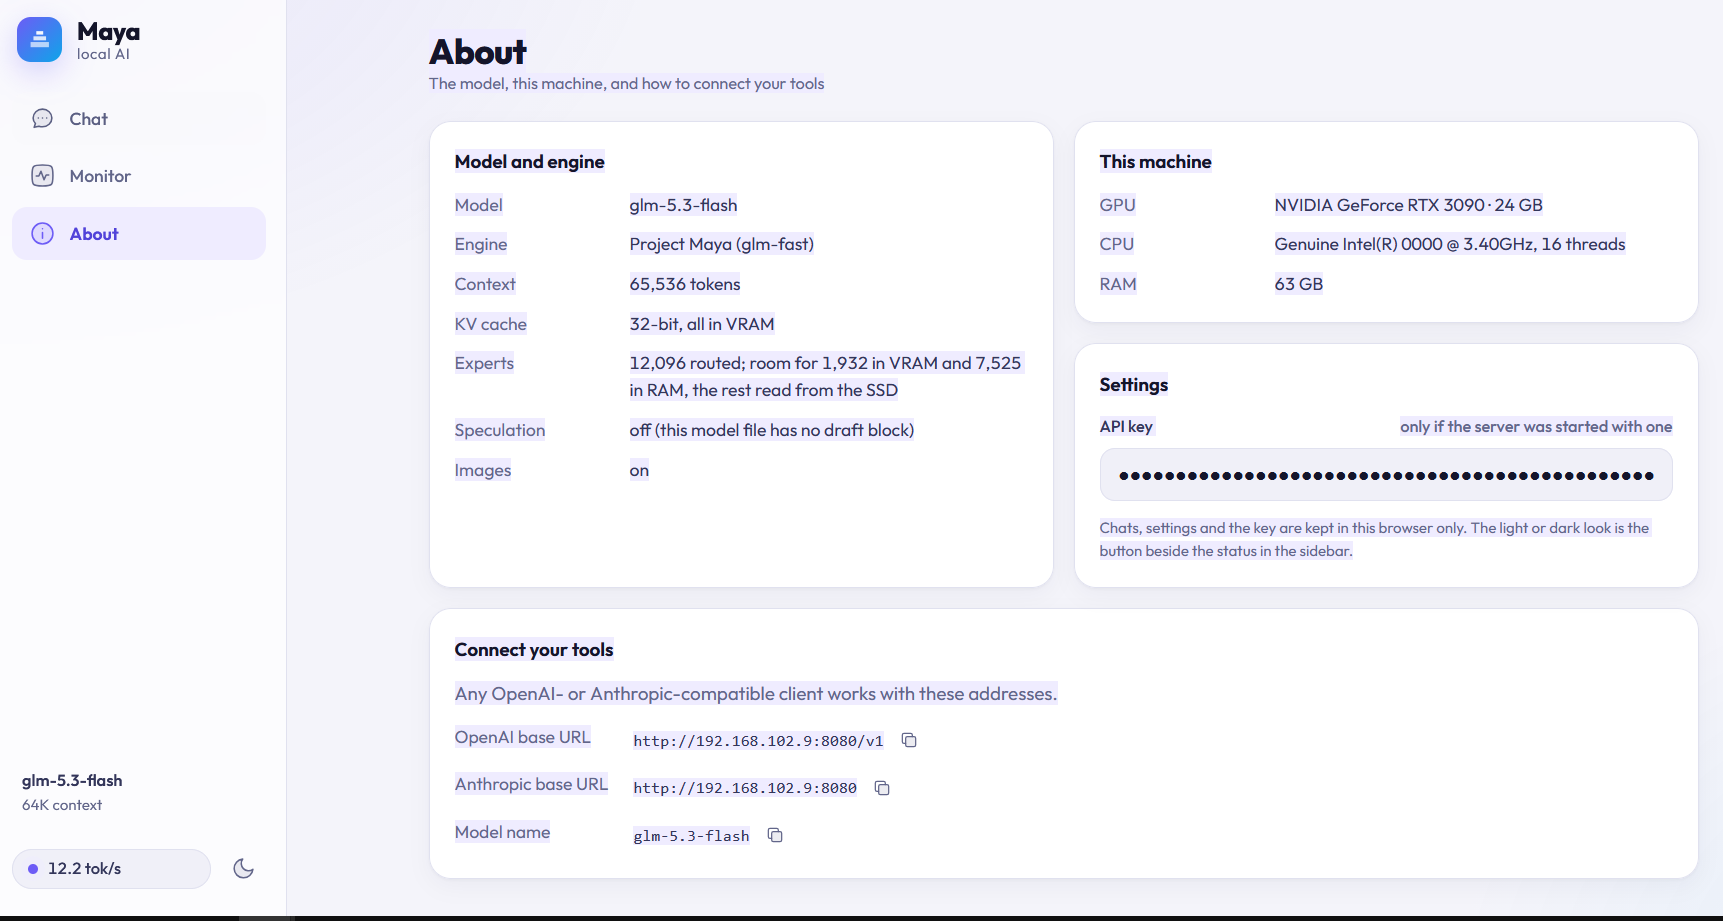
                @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                2026-10-08 18 24 57.png
                2026-10-08 18 24 57-2.png
                2026-10-08 18 24 57-3.png

                johnnybegoodJ stxpnetS J 3 条回复 最后回复
                1
                • gao GaoG gao Gao

                  @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                  2026-10-08 18 24 57.png
                  2026-10-08 18 24 57-2.png
                  2026-10-08 18 24 57-3.png

                  johnnybegoodJ
                  johnnybegoodJ
                  johnnybegood
                  超凡大师
                  编写于 最后由 编辑
                  #16

                  @gao-Gao 这。。。这个跟llama.cpp 0.6.0 直接跑也差不多了。

                  1 条回复 最后回复
                  0
                  • gao GaoG
                    gao GaoG
                    gao Gao
                    编写于 最后由 gao Gao 编辑
                    #17

                    @johnnybegood 不是,我估计我内存上到96GB ,把ssd上的全部加载到内存,速度会明显提升

                    1 条回复 最后回复
                    0
                    • ,johnnybegoodJ johnnybegood 引用了 此主题
                    • gao GaoG gao Gao

                      @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                      2026-10-08 18 24 57.png
                      2026-10-08 18 24 57-2.png
                      2026-10-08 18 24 57-3.png

                      stxpnetS
                      stxpnetS
                      stxpnet
                      超凡大师
                      编写于 最后由 编辑
                      #18

                      @gao-Gao 哈哈,这让我想起我之前在双路 XEON老机器 上面(16条16G DDR4 2133内存) 纯CPU跑122B的IQ4_XS模型,那里也能得到15-20T/S (用了proxmox的arc技术,把划64G给磁盘当缓存用,因此llama.cpp可以 秒速从内存里面读GGUF) 。
                      后来放弃了,速度真的太慢,不实用。 我感觉本地要40-50 T/S可以实用。 100T/S左右可以爽玩。

                      双卡3090 PCIE 4.0 16X/16X

                      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                      1 条回复 最后回复
                      0
                      • Ben LeeB
                        Ben LeeB
                        Ben Lee
                        超凡大师
                        编写于 最后由 编辑
                        #19

                        @johnnybegood "... 于是我跟AI一起把 Strata 的说明书和源码翻了一遍,又用脚本把 Huihui-DeepSeek-V4-Flash-BF16-abliterated-ds4-Q4_K.gguf 的 GGUF 头解开逐层比对。..." 大侠你是这么过国庆节的啊 😊

                        1 条回复 最后回复
                        0
                        • XiaoteX
                          XiaoteX
                          Xiaote
                          编写于 最后由 编辑
                          #20

                          🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!
                          奖励凭证:热议 +3 分 · 编号 h2153-363-1(系统自动发放,显示稍有延迟)

                          老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                          1 条回复 最后回复
                          0
                          • J
                            J
                            joker_chang
                            德高望重 劳动模范
                            编写于 最后由 joker_chang 编辑
                            #21

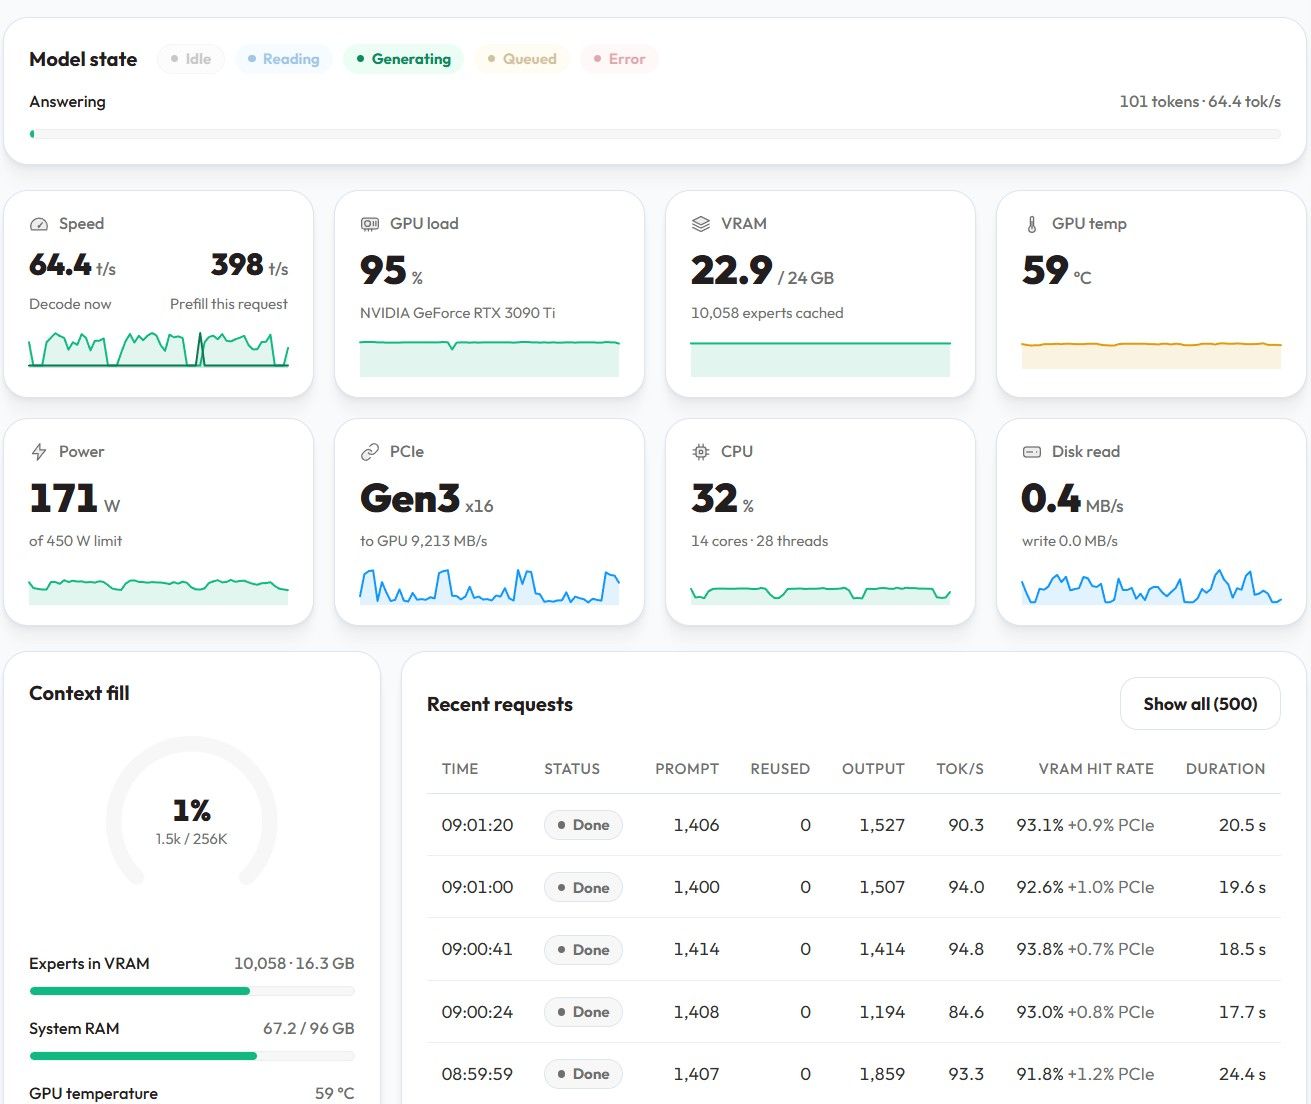
                            我整个国庆节,除了开车在路上的时间,剩下全是telegram操控Hermes在折腾Strata。

                            在看到这个贴子前,我也在网上搜索,有没有大神采用类似的技术,本地跑deepseek v4.1 flash。

                            看来还是我太贪心了~

                            补一张我本机Hermes 调用strata的运行数据图:
                            image.jpeg

                            1 条回复 最后回复
                            0
                            • gao GaoG gao Gao

                              @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                              2026-10-08 18 24 57.png
                              2026-10-08 18 24 57-2.png
                              2026-10-08 18 24 57-3.png

                              J
                              J
                              joker_chang
                              德高望重 劳动模范
                              编写于 最后由 编辑
                              #22

                              @gao-Gao 大佬,这个模型的能力如何?您有没有测试过?

                              1 条回复 最后回复
                              0
                              • gao GaoG
                                gao GaoG
                                gao Gao
                                编写于 最后由 gao Gao 编辑
                                #23

                                @joker_chang 我可不是大佬,我提升了内存到96G 测试下了速度还是不行,这个模型已经超过单卡3090的能力了,双卡我看论坛也有人发,速度也没有办法实际工作,我个人现在感觉 3090单卡+96GB或64GB 内存用 Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S ,128K上下文 parallel: 5 设置(刚开始运行会慢) + cc swtich +claude desktop 效果我目前感觉比 dsh 好,具体还要再使用一段时间. 随便提一下 Strata会把 cpu拉满(虽然显示50% 其实是100%功耗) 电费会很感人 我i7+4根32x2 16x2 +3090单卡限330w 整机最高实际功耗是500瓦

                                johnnybegoodJ A 2 条回复 最后回复
                                0
                                • gao GaoG gao Gao

                                  @joker_chang 我可不是大佬,我提升了内存到96G 测试下了速度还是不行,这个模型已经超过单卡3090的能力了,双卡我看论坛也有人发,速度也没有办法实际工作,我个人现在感觉 3090单卡+96GB或64GB 内存用 Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S ,128K上下文 parallel: 5 设置(刚开始运行会慢) + cc swtich +claude desktop 效果我目前感觉比 dsh 好,具体还要再使用一段时间. 随便提一下 Strata会把 cpu拉满(虽然显示50% 其实是100%功耗) 电费会很感人 我i7+4根32x2 16x2 +3090单卡限330w 整机最高实际功耗是500瓦

                                  johnnybegoodJ
                                  johnnybegoodJ
                                  johnnybegood
                                  超凡大师
                                  编写于 最后由 编辑
                                  #24

                                  @gao-Gao 其实就是能量守恒定律,消耗能量越高,说明性能发挥越充分,性能越强

                                  1 条回复 最后回复
                                  0
                                  • gao GaoG gao Gao

                                    @joker_chang 我可不是大佬,我提升了内存到96G 测试下了速度还是不行,这个模型已经超过单卡3090的能力了,双卡我看论坛也有人发,速度也没有办法实际工作,我个人现在感觉 3090单卡+96GB或64GB 内存用 Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S ,128K上下文 parallel: 5 设置(刚开始运行会慢) + cc swtich +claude desktop 效果我目前感觉比 dsh 好,具体还要再使用一段时间. 随便提一下 Strata会把 cpu拉满(虽然显示50% 其实是100%功耗) 电费会很感人 我i7+4根32x2 16x2 +3090单卡限330w 整机最高实际功耗是500瓦

                                    A
                                    A
                                    applejuice
                                    技术大牛 劳动模范
                                    编写于 最后由 编辑
                                    #25

                                    @gao-Gao 你是说strata 跑的时候会把cpu 拉满对吧?

                                    1 条回复 最后回复
                                    0
                                    • gao GaoG
                                      gao GaoG
                                      gao Gao
                                      编写于 最后由 编辑
                                      #26

                                      @applejuice 是的,很奇怪我看见别人windows下是50%,但是我linux下也显示50%,但是我测试cpu的功耗已经满125瓦,然后我用小米的智能插座也倒算出基本cpu也是满的.

                                      1 条回复 最后回复
                                      0
                                      • gao GaoG
                                        gao GaoG
                                        gao Gao
                                        编写于 最后由 编辑
                                        #27

                                        strata 2-3万元机器就能跑的很爽, 估计 GLM-5.3-Flash-Maya 需要5-8万的硬件组合了

                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组