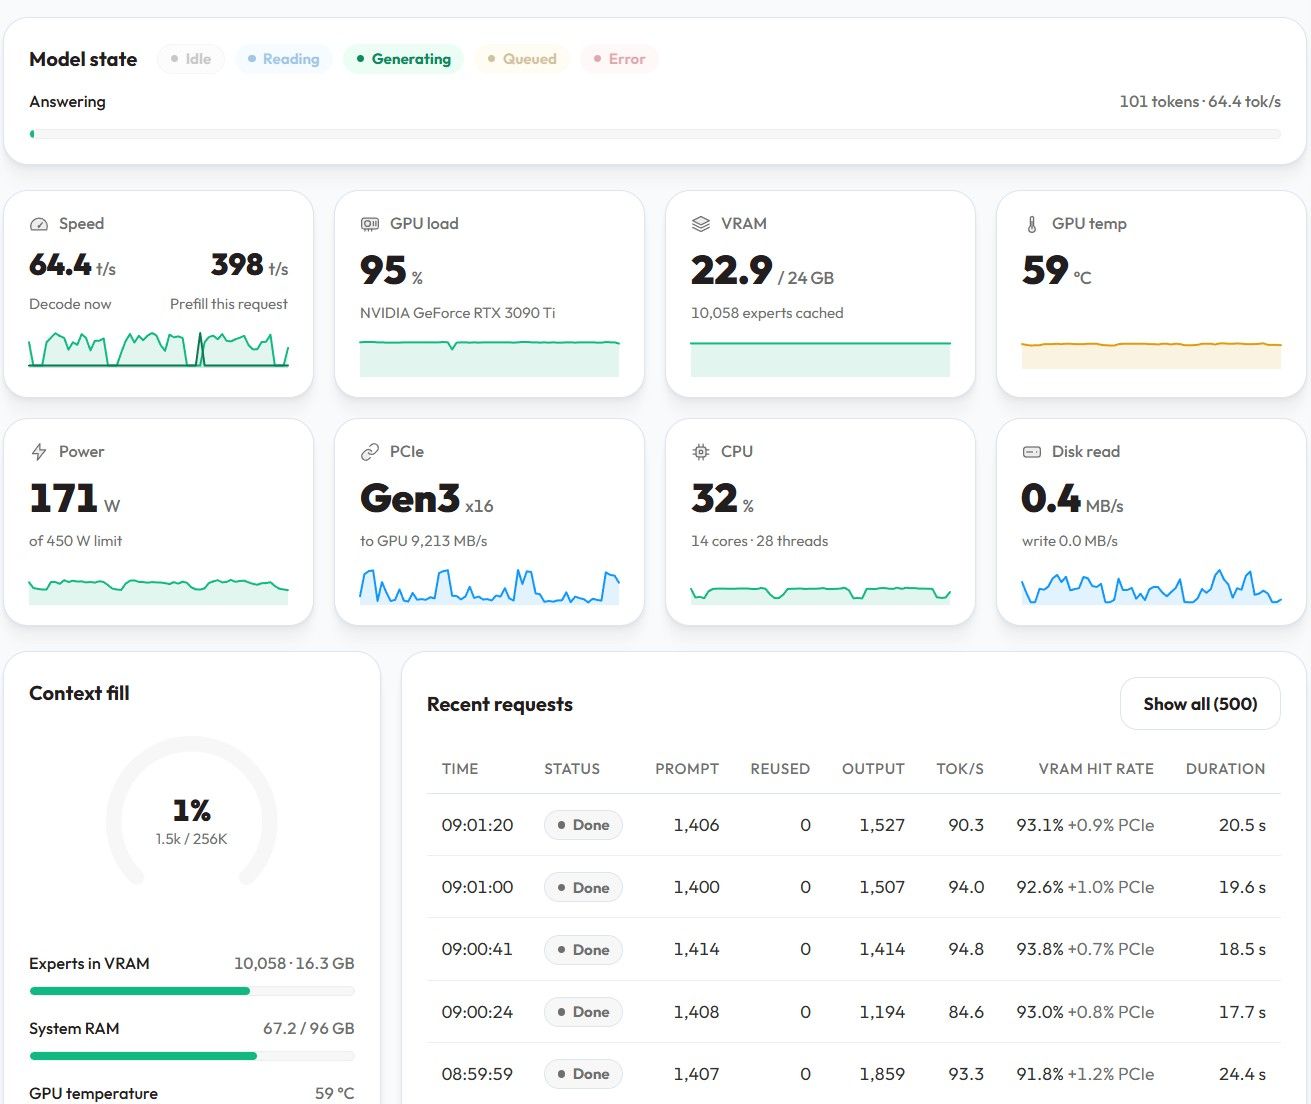
【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!
-
-
-
-
-
-
-
@david-chen 你牛
-
-
-
@fcme 是的, 要写10000行代码, 还不一定成功。确实没时间。从硬件分析角度来说, 其实也收益不会太大。
-
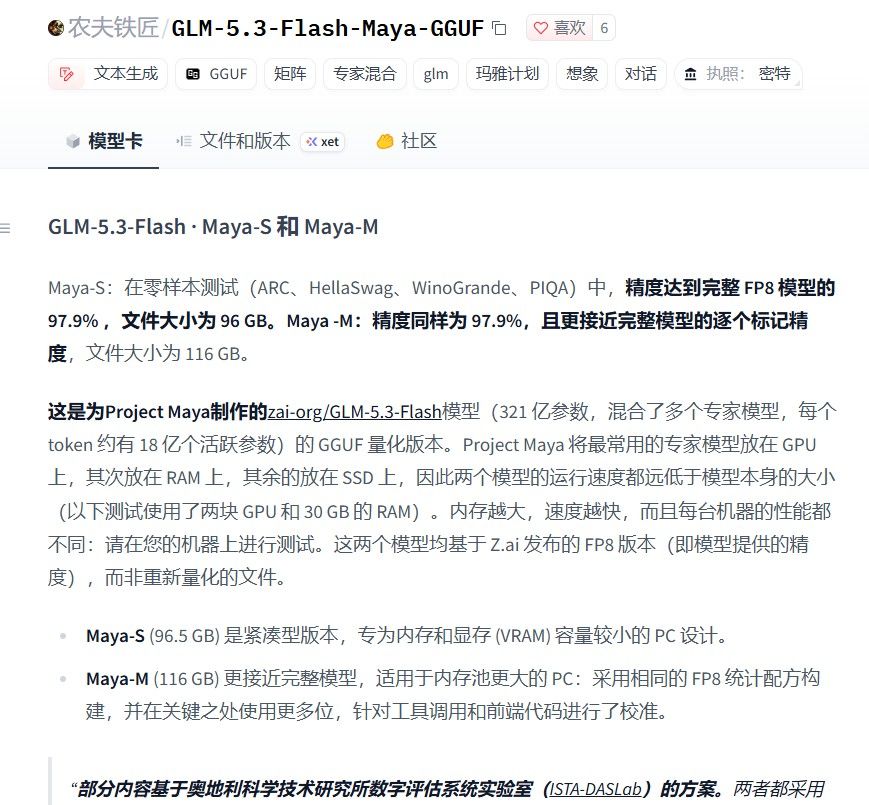
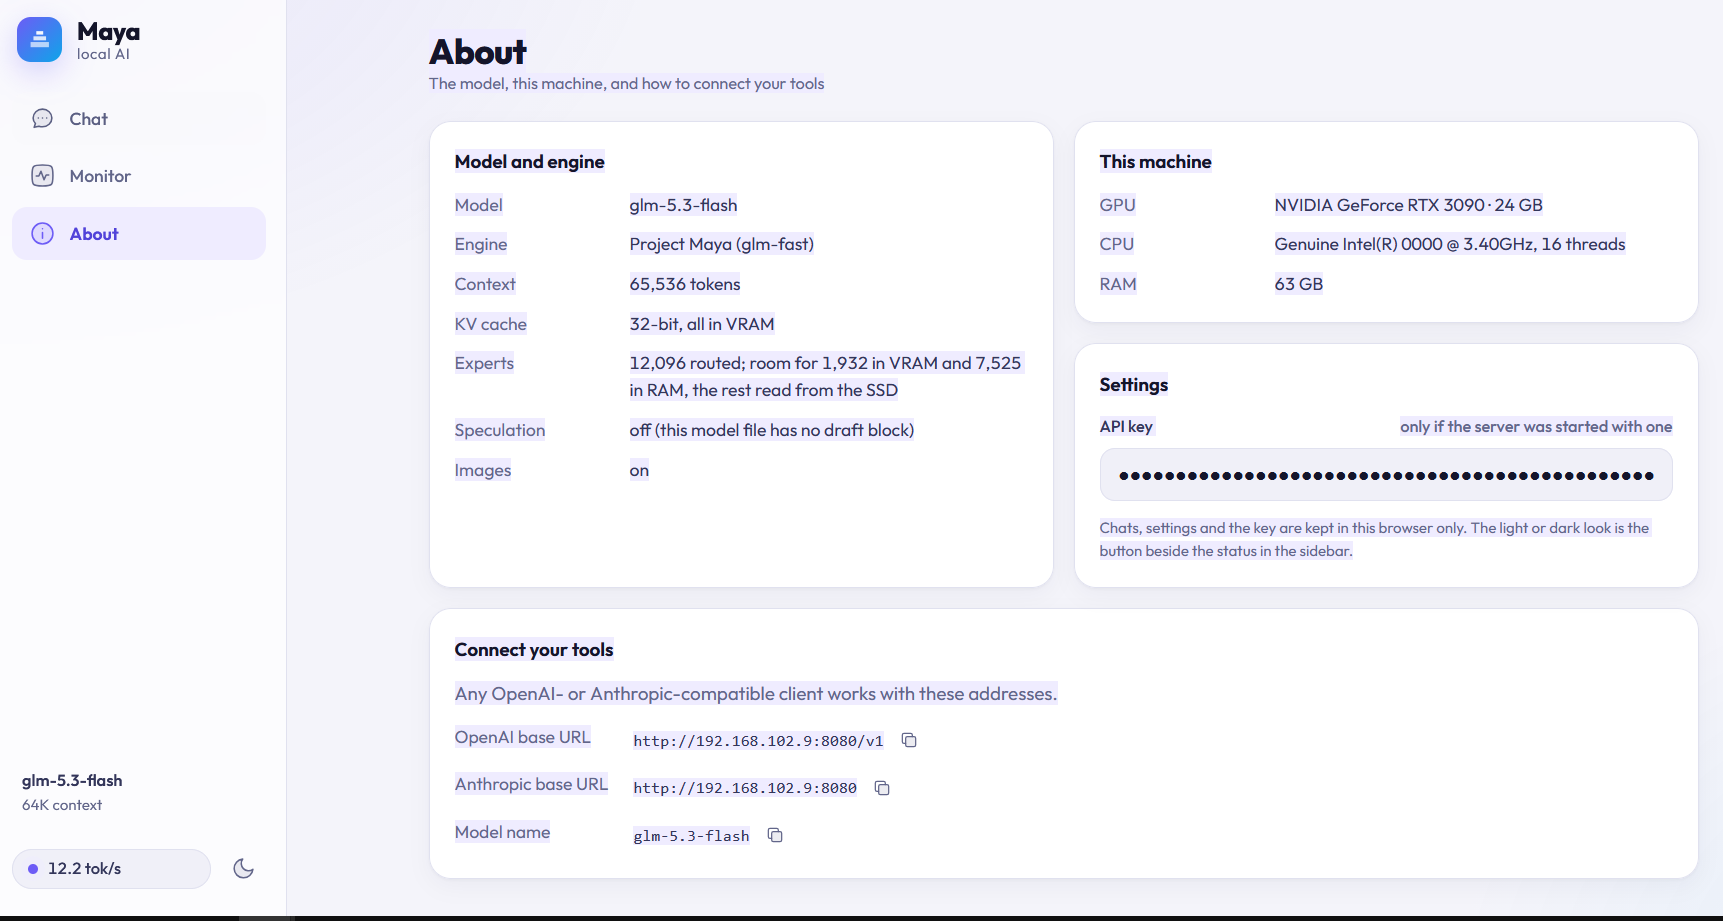
https://huggingface.co/peasantsmith/GLM-5.3-Flash-Maya-GGUF
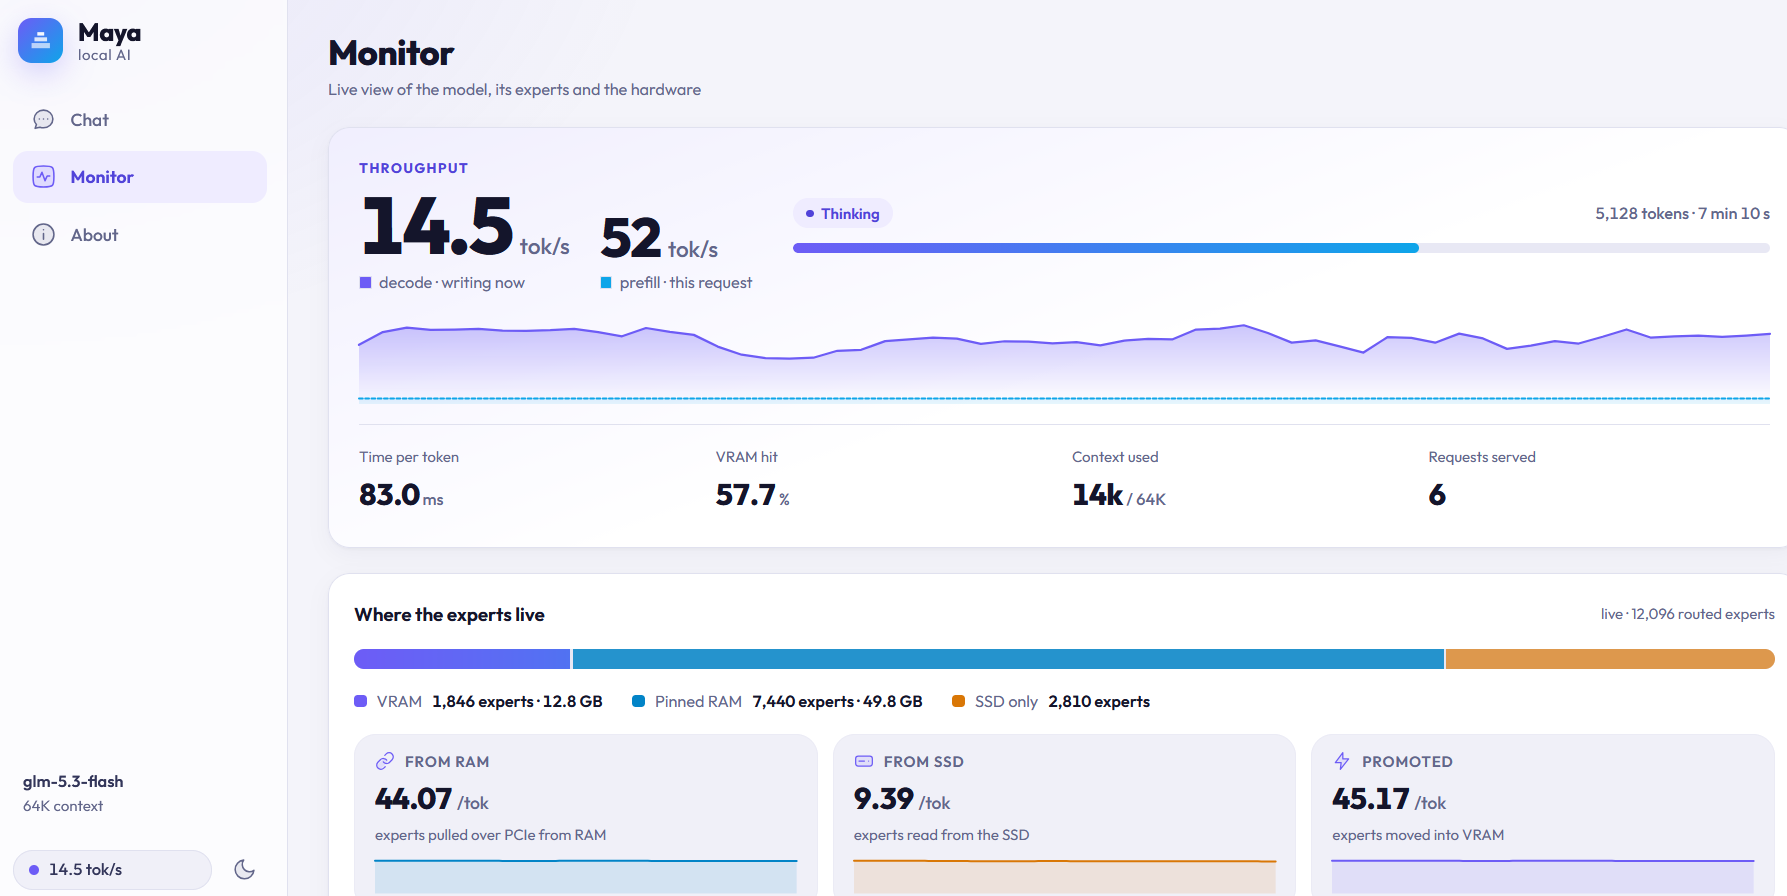
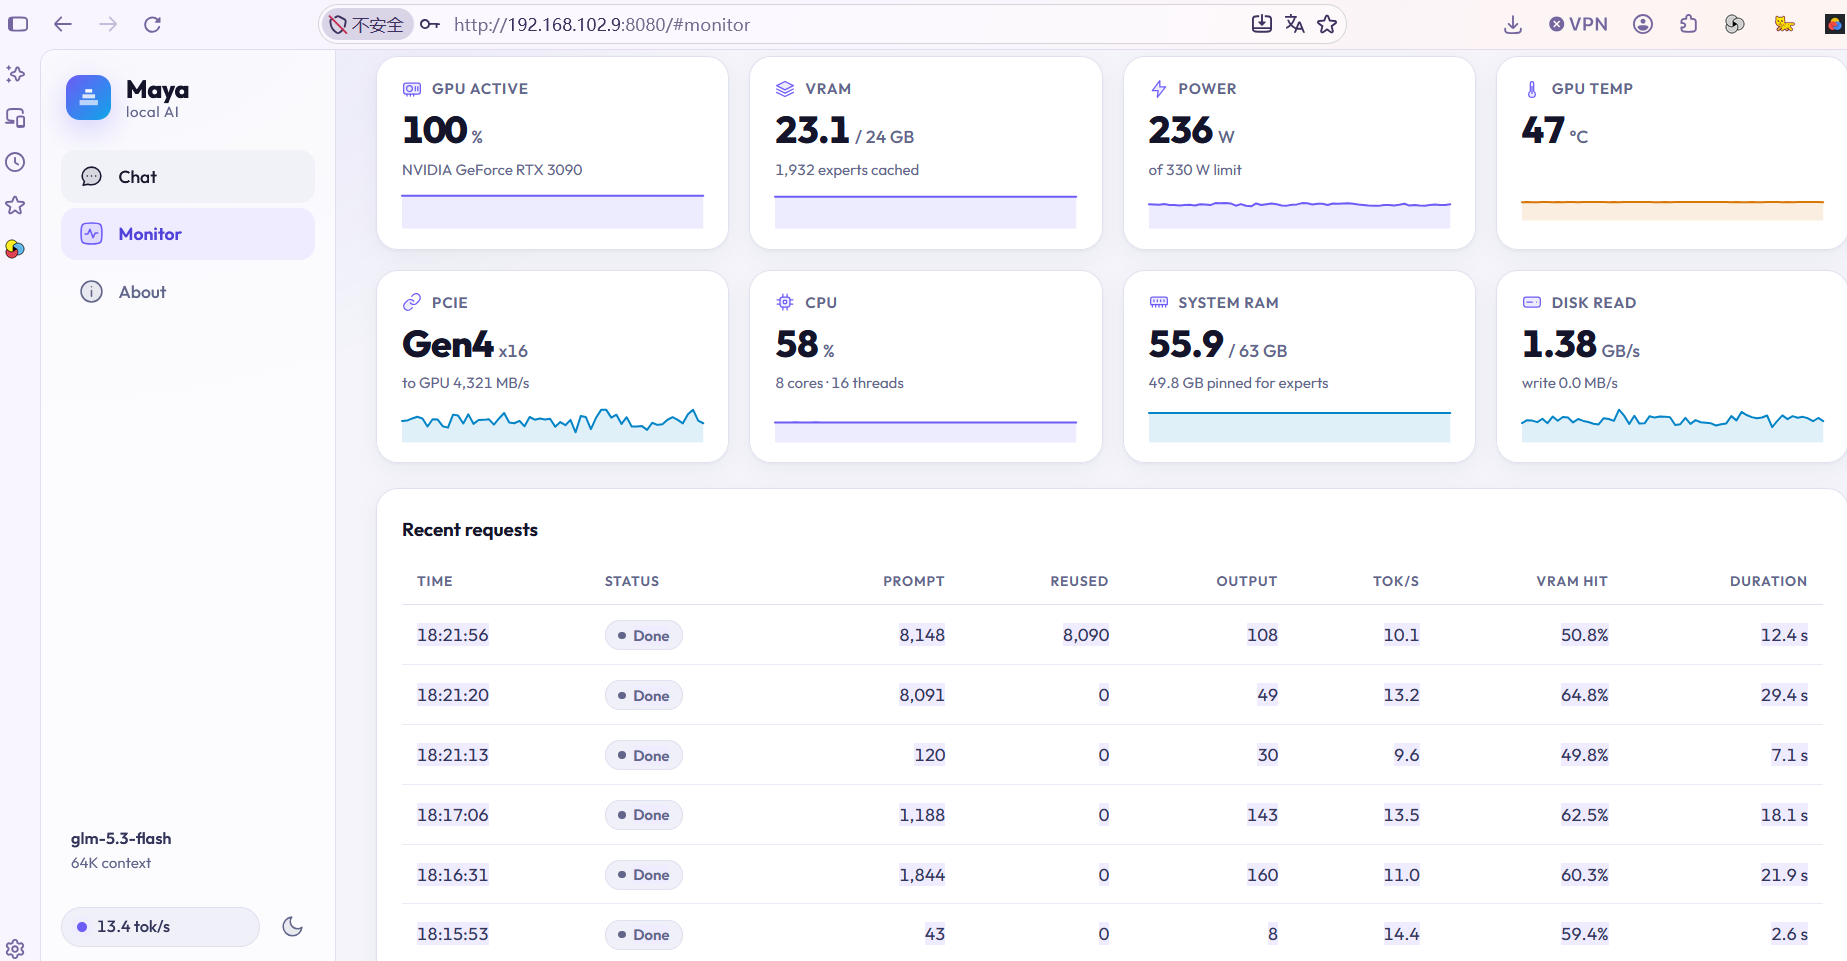
有人已经做好了strata的fork了. 跑glm 5.3 flash,作者好像用的两张20系显卡.速度
在两台配备 32GB 内存(30GB RAM)的 Tesla V100 上运行 Maya-S,并使用 Project Maya 进行测试:解码(写入答案)速度最高可达 40 个 token/s,支持 MTP 块草稿,即使在处理较长的上下文(60K tokens)时也能保持该速度;预填充(读取提示)速度最高可达 560 个 token/s。在一台配备 64GB RAM 的 Tesla V100 上:解码速度最高可达 19 个 token/s,预填充速度最高可达 370 个 token/s。 ./maya.sh --bench请以相同方式测试您的机器。运行它
Project Maya(github.com/mw00/project-maya):使用一到两块 NVIDIA GPU,其余模型位于 RAM 和 SSD 上;图片通过上述视觉文件显示。./setup.sh下载、检查并设置 Maya-S;./setup.sh --setup --model Maya-M设置 Maya-M。
llama.cpp构建支持 GLM-5.3-Flash ( glm5next),可将其作为任何 GGUF 加载。那些人一般用的claude code最强的套餐去改的这些框架.
-
-
-
-
@johnnybegood 不是,我估计我内存上到96GB ,把ssd上的全部加载到内存,速度会明显提升
-
,
 J johnnybegood 引用了 此主题
-
-
-
-
-








 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!