跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!

【瞎折腾】Strata 改源码去跑 DeepSeek V4 Flash?要不就试试!

已定时 已固定 已锁定 已移动 热议 LLM讨论区
stratadeepseek本地模型
27 帖子 13 发布者 1.1k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • johnnybegoodJ
    johnnybegoodJ
    johnnybegood
    超凡大师
    编写于 最后由 johnnybegood 编辑
    #1

    前一阵我在电脑上跑了 EXL3版的DeepSeek V4 Flash, 本地平均跑到 10-11tok/s, 最高的时候到了16tok/s, 我觉得我又行了, 当然这个速度还是一般, 后来出了Strata, 就玩了几天, 感觉不错, 就想着能不能给DeepSeek用, 于是我跟AI一起把 Strata 的说明书和源码翻了一遍,又用脚本把 Huihui-DeepSeek-V4-Flash-BF16-abliterated-ds4-Q4_K.gguf 的 GGUF 头解开逐层比对。下面是结论和证据。想看结论可以直接跳过全文。


    一、先搞清楚这两个东西分别是什么

    Strata 是什么

    一个推理引擎(不是模型),作者 Niko1221,MIT 协议,2026 年 9 月下旬开源。它只干一件事:

    把 Qwen3.8-Flash-Next(125B MoE,48 层,24,576 个专家,每个 token 只激活约 10 个)塞进一张 12GB 显存的消费级显卡。

    做法不是把模型压缩掉,而是把整台电脑当成一个分级仓库:

    层级 装什么 说明
    显存(热) 最常用的约 4,500 个专家 + 注意力 + 路由 + KV cache + MTP 草稿层 带宽约 672 GB/s
    内存(温) 全部 24,576 个专家 显存里没有的,CPU 就地算,和 GPU 并行
    硬盘(冷) 28.8 GB 的 n-gram 查找表(内存映射常驻) 每个 token 只读约 16 行,提前一步发读取请求

    在这个三级结构上再叠两招:

    • 量化:ISTA-DASLab 的 GSQ-RCO 方案,把权重压到 2–3 bit。Q2_0 档全部专家只要 34 GB 内存。
    • 原生 MTP(多 token 预测):小草稿层先猜几个 token,大模型一次验证。官方声称 1.6–1.8×,且输出内容不变。

    官方基准机是 RTX 5070 12GB + Ryzen 5 7600 + 64GB 内存:

    量化档 Decode Prefill
    Q2_0 94 tok/s 2,650 tok/s
    IQ3_XXS 62 tok/s 1,750 tok/s
    IQ3_S 53 tok/s 1,620 tok/s

    DeepSeek V4 Flash 是什么

    284B 总参数 / 13B 激活 / 256 个路由专家 + 1 个共享专家 / 43 层 / 1M 上下文 / MIT 授权。

    我的 Huihui-DeepSeek-V4-Flash-BF16-abliterated-ds4-Q4_K.gguf 是社区在 FP4 原生专家权重上做的 Q4_K 对齐版:

    153.33 GiB = 164,633,502,304 bytes
    

    注意这个体积。它是后面所有讨论的地基。


    二、实测 A:DeepSeek V4 Flash GGUF 到底长什么样

    用 Python 直接解 GGUF 头(gguf-py 的 GGUFReader),结果是:

    general.architecture = deepseek4
    1328 张量
    

    逐项拆开:

    项 值
    层数 43
    hidden size 4096
    注意力 MLA,64 Q heads / 1 KV head,k=v len 512
    LoRA rank q_lora_rank = output_lora_rank = 1024(8 组)
    专家 256 路由 + 1 共享,激活 6 个,专家 FF 维度 2048
    专家张量布局 3D 融合张量 ffn_{gate,up,down}_exps,形状 256×2048×4096
    专家量化 Q4_K,129 张,占 145.125 GiB(95%)
    其余 Q8_0 345 张 / 6.146 GiB,F16 359 张 / 2.041 GiB,I32 3,F32 492

    逐层组件矩阵(数了每一层有什么):

    组件 出现在几层
    MLA 注意力 43
    attn_compressor 41(层 2–42)
    sparse indexer 21(偶数层,top_k = 512)
    mHC hyper-connection 43
    attn_sinks 43
    路由专家 43
    router bias 40(层 3–42)
    hash 路由 tid2eid 3(层 0–2)

    它独有的机制:mHC hyper-connection、CSA/HCA 压缩器、sparse indexer、hash 路由、attn_sinks、sliding_window=128、rope yarn×16。

    它没有的机制:没有 PLE(per-layer embedding)表,也没有 n-gram 表。

    最后这一条,是整件事的关键。


    三、实测 B:Strata 的源码绑死了什么

    1. 架构守卫只认一个字符串

    // include/strata/artifact/gguf_reader.hpp:584
    // 只接受 general.architecture == "qwen4exp"
    

    模型是 deepseek4。第一个门就过不去。

    2. 几何常量写死在编译期,还散落 14 个文件

    include/strata/core/layout.hpp:27-59 里的 ModelGeometry 全是字面量(2560 / 48 层 / 512 / 640 / ssm_* / 24 / 2 / 256 …)。

    唯一从 GGUF 读出来的只有两个值:

    // src/generate.cpp:2395-2396
    expert_count       = <from gguf>;
    expert_used_count  = <from gguf>;
    

    同一组几何散落在 14 个文件里:

    src/prefill.cpp:93            src/kernels.cu:21
    include/strata/core/expert.hpp:34-45    include/strata/core/ngram.hpp:31-42
    include/strata/qsa.hpp:109-116          src/plan.hpp:24-58
    tools/pack_layer.py:40                  tools/iq_pack.py:202
    tools/mtp_rt.py:27                      tools/make_profile.py:33
    tools/strata_pack.py:234                tests/native_expert_bench.cpp:46
    include/strata/artifact/gguf_reader.hpp:576    include/native_ple_postops.hpp:6
    

    3. 层型是位置算术,不是查表

    // include/strata/core/layout.hpp:64
    bool is_qsa_layer() { return layer % q.gsa_interval == q.qsa_interval - 1; }
    // 实际效果:layer % 4 == 3
    

    也就是说,Strata 认为「每 4 层里第 4 层是特殊层」是数学规律,不是可配置项。

    4. 专家 blob 大小是编译期常量,还有硬性宽度检查

    // include/strata/core/expert.hpp:45
    constexpr BLOB = 1,382,400;
    
    // src/expert_source.cpp:2291
    // 宽度不等于 2560 直接拒绝
    

    Deepseek专家宽度是 4096。

    5. 注意力是最大障碍

    Strata 的 QSA 是一个稀疏 cell 选择器:

    indexer → topk_512 → gather → GQA
    

    topk_512 是单个 block 实现的,而且有上限:

    // include/strata/qsa.hpp:282-284
    kTopkMaxCells = 32768
    

    更麻烦的是 KV cache:

    // include/strata/qsa.hpp:63-71
    // KV cache 是明文 FP16 GQA — 没有压缩,没有 MLA
    

    而 DeepSeek V4 Flash 的 KV cache 恰恰是 MLA(MLA 就是为压缩 KV cache 而生的)。

    在 src/ 目录里搜这些关键词,零命中:

    sliding | MLA | kv_lora | compress
    

    四、为什么「改源码」这条路本身就不成立

    理由一:Strata 缺的是「机制」,不是「参数」

    把两边的机制清单摆在一起看:

    机制 Qwen3.8-Flash-Next(Strata 支持的) DeepSeek V4 Flash(你要跑的) Strata 里有没有
    层数 48 43 写死 48
    专家数 24,576 256 从 GGUF 读 ✅
    每 token 激活 ~10 6 从 GGUF 读 ✅
    专家粒度 小专家 大专家(2048×4096/个) 无概念
    n-gram / PLE 表 51B 表,28.8 GB 没有 核心机制,用不上
    注意力 明文 FP16 GQA MLA 64Q/1KV 无
    KV 压缩 无 CSA 4× / HCA 128× 无
    稀疏选择器 QSA(每 4 层) sparse indexer(偶数层) 有类似物但不是这个
    hyper-connection 无 mHC,43 层 无
    attn_sinks 无 43 层 无
    hash 路由 无 层 0–2 无

    最能说明问题的一行是 n-gram 表。

    Strata 的加速逻辑是:

    你只用到 24,576 个专家里的 10 个 → 一张巨大的查表告诉你「下一步大概会用哪几个」→ 提前从 SSD 预取 → 等路由真的问到的时候,数据已经在内存里了。

    这套东西成立的前提是:专家数量极多、单个专家极小、路由极度稀疏。

    DeepSeek V4 Flash 是 256 个专家、每个是大矩阵、激 6 个。它的瓶颈根本不是「预测哪个专家」,而是「专家张量本来就大」。Strata 那张表在这个形状上没有任何价值。

    理由二:Strata 的设计哲学就是「一个模型一个引擎」

    官方文档第一句就写死了:

    Strata runs one model, Qwen3.8-Flash-Next.

    这不是「暂时只支持一个」,是刻意的设计选择。作者把整个引擎的 kernel、内存布局、调度器都围绕这一个模型的形状去塑形。这正是它比通用引擎快的原因——

    社区里对它有个很准的称呼:「napkin runtime」(餐巾纸运行时)。一位开发者在实测对比里写道:

    在同一台 RTX 4070 12GB 的机器上,把 llama.cpp 调到极限是 27 tok/s;换 Strata,在 6 万 token 上下文下跑出 53.2 tok/s。

    差值不是来自更好的优化,而是来自放弃通用性。

    同一批「偏科引擎」还包括 ninfer、DwarfStar、Splash、llamAmpere、gufo——每一个都只服务一个模型 + 一类硬件。

    那到底要写多少代码?

    粗估:6,000–10,000 行新 C++/CUDA,用来实现一个 deepseek4 后端。

    而且要注意,这不是「在现有代码上加分支」。Strata 的几何常量是通过编译期字面量渗透进 kernel 的,加第二个架构意味着这些常量要全面泛化——而它们散落在 14 个文件里,其中一部分在 .cu 里直接影响性能假设。


    五、那正确的路怎么走

    路径 A:DwarfStar(ds4)—— 这就是为 DeepSeek V4 写的引擎

    最直接、最对症的一条路。 作者是 antirez(Salvatore Sanfilippo,Redis 的作者),MIT 协议,纯 C。

    官方定位:

    ds4 is intentionally narrow: it supports a small, opportunistic set of model families.
    Today that means DeepSeek V4 Flash and PRO, DeepSeek V4.1 Flash, GLM 5.x and Qwen3.8 Flash Next.

    后端已经不只 Metal 了:

    平台 内存要求 后端
    MacBook / Mac Studio 96GB+ Metal
    MacBook Pro 64GB Qwen3.8 Q2,或 V4 Flash via SSD streaming
    Mac Studio 512GB V4.1 q4 / PRO q2
    NVIDIA DGX Spark GB10 128GB CUDA (cuda-spark)
    通用 NVIDIA Linux 够跑该量化的 VRAM + RAM CUDA (cuda-generic)
    AMD Strix Halo 96–128GB 统一内存 ROCm

    可选模型档位:

    ./download_model.sh ds4f-q2        # Flash · 96–128GB
    ./download_model.sh ds4f-q2-q4     # Flash · q2 + 最后 6 层专家 q4
    ./download_model.sh ds4f-q4        # Flash · 4-bit · 256GB+
    ./download_model.sh ds4f-mxfp4     # Flash · 原生 MXFP4 专家 · ~156GB
    ./download_model.sh ds4f-dspark    # Flash · DSpark 投机解码支持文件
    

    路径 B:llama.cpp —— 通用、稳、但慢

    上游 llama.cpp 从 b9843 起支持 deepseek4 架构。官方 GGUF 已经现成:

    # MXFP4,约 155 GB,2 个分片
    llama-server -hf ggml-org/DeepSeek-V4-Flash-0731-GGUF:MXFP4
    

    路径 C:如果你还想用 Strata —— 就用它原本的模型

    Strata 就是为 Qwen3.8-Flash-Next 造的。本机在双卡上其实已经跑通了,实测数字也拿下过(热请求 ~140.8 tok/s 含 TTFT)。让它继续跑它擅长的模型,是收益最高、成本最低的选择。

    路径 D:如果只是想复刻 Strata 的调度思路

    Strata 真正值得抄的不是它的 CUDA kernel,而是调度层:

    • serve/server.py(7,517 行,零模型常量)
    • CUDA graph 捕获
    • VMM 弹性 arena
    • 专家缓存的 admit / never-evict 策略 + 按层准入窗口
    • CPU/GPU 专家瀑布(miss 在 CPU 上并行算,不阻塞 GPU)
    • MTP 投机框架
    • 多卡 peer experts

    这些是可以剥离出来挂到别的后端上的。但注意:调度框架能复用,调度参数不能。 专家槽位数量、准入窗口大小、预取深度,全都是按「24,576 个小专家、激活 10 个」调出来的。换成「256 个大专家、激活 6 个」,这些值必须重调。


    六、一句话总结

    问题 答案
    Strata 能通过改源码跑 DeepSeek V4 Flash 吗? 不能。
    是「改」还是「重写」? 重写一个 deepseek4 后端,粗估 6,000–10,000 行。
    重写完能跑吗? 不一定。
    那怎么办? 想跑 V4 Flash → 用 ds4(对症)或 llama.cpp(通用但慢)。想用 Strata → 就让它跑 Qwen3.8-Flash-Next。

    附:这件事背后更值得想的一个问题

    ##### 虽然没折腾成功吧, 但是我觉得也算是给大家一个科普,让大家知道为什么Strata只能跑Qwen3.8 Flash , 也大概知道一下原理。 对自己的硬件, 和后续的投资, 有一个清醒的认识。

    Strata 这类「偏科引擎」(社区叫 napkin runtime)最近集中出现,不是偶然。

    推理优化有一个很特殊的性质:它的目标函数异常清晰。

    输入:一个固定的权重文件 + token id
    约束:输出必须和参考实现在容差内一致
    目标:每秒更多 token、更少内存

    这种「可机器校验」的目标,让 AI coding agent 能围着硬件计数器反复迭代。结果是——写一个高性能推理引擎的成本,从「资深系统工程师几个月」降到了「几周甚至更短」。

    但代价也写在同一张纸上:目标越窄,优化越狠;模型一换代,引擎可能直接作废。

    有开发者立了一个可检验的预测:到 2027 年 4 月,这批偏科引擎里至少 4 个会连续 60 天没有任何提交。

    所以更可能的未来不是「偏科引擎取代通用引擎」,而是:

    通用引擎继续做格式、量化研究、各后端的参考 kernel,退成「零件库」;
    偏科引擎从里面拆零件,拼成一次性快消品。

    别跟推理引擎绑定。 真正稳定的那一层是它上面的接口——OpenAI / Anthropic 兼容的 HTTP API。引擎可以换,客户端不用动。


    1 条回复 最后回复
    2
    • kos orK
      kos orK
      kos or
      超凡大师
      编写于 最后由 编辑
      #2

      看來 QFN 专家数 24,576 小專家多 還是有好處的

      1 条回复 最后回复
      1
      • terryT
        terryT
        terry
        超级版主
        编写于 最后由 编辑
        #3

        挺折腾的,我弟,不过HaloGen当初只支持Qwen Flash,后来也能跑27B了,但好歹是一个家族。

        油管:https://www.youtube.com/@抡锤者

        johnnybegoodJ 1 条回复 最后回复
        0
        • terryT terry

          挺折腾的,我弟,不过HaloGen当初只支持Qwen Flash,后来也能跑27B了,但好歹是一个家族。

          johnnybegoodJ
          johnnybegoodJ
          johnnybegood
          超凡大师
          编写于 最后由 编辑
          #4

          @terry 我看现在Strata太热了, 很多人脑子一热, 就要买新显卡, 装新机器了。 但是没考虑 Strata的扩展性如何,所以我做了这个测试。 谁也不想几万块买了硬件, 最后只能跑这一个或者几个模型啊, 我觉得通用性也很重要, 最后结尾也说了, 不通用。 当然这些工具和方法日新月异, 趁硬件便宜多屯一些也是可以的, 只是现在的价格真不是太合适了。

          1 条回复 最后回复
          1
          • N
            N
            neo
            德高望重 劳动模范
            编写于 最后由 编辑
            #5

            附议你的想法,拿整机的能力去跑更大的模型,而不是只用GPU+VRAM,肯定是好事。qwen3.8-flash-next说到底是技术预览版,未来flash是否开源现在还难讲,strata未来是否支持deepseek这样的模型也是未知。如果到时qwen4-27B开源了,而falsh不开源,那又得回到原来27B的老路上了。所以只是升级下内存之类测试尝鲜flash-next还行,现在整机升级朝着这个方向走,感觉为时过早啊。

            1 条回复 最后回复
            0
            • V
              V
              vosrock
              德高望重 劳动模范
              编写于 最后由 编辑
              #6

              不早了,晚了又要买高价硬件

              1 条回复 最后回复
              0
              • gao GaoG
                gao GaoG
                gao Gao
                编写于 最后由 编辑
                #7

                有没有可能未来 新开源模型出来,自己用老模型+自定义Strata=新推理引擎+新模型 然后就能用了

                David ChenD 1 条回复 最后回复
                0
                • gao GaoG gao Gao

                  有没有可能未来 新开源模型出来,自己用老模型+自定义Strata=新推理引擎+新模型 然后就能用了

                  David ChenD
                  David ChenD
                  David Chen
                  德高望重 劳动模范
                  编写于 最后由 编辑
                  #8

                  @gao-Gao 不用未來,我已經在弄了 ☺

                  1 条回复 最后回复
                  1
                  • gao GaoG
                    gao GaoG
                    gao Gao
                    编写于 最后由 编辑
                    #9

                    @david-chen 你牛

                    1 条回复 最后回复
                    0
                    • fcmeF
                      fcmeF
                      fcme
                      超凡大师
                      编写于 最后由 编辑
                      #10

                      deepseek的ngram架构确实很好,Qwen这个flash就用了啊,部分内容以查代算。
                      你这个一直再搞搞肯定是可以成功的,只不过工作量太大了,你要没有超级计算机的话

                      johnnybegoodJ 1 条回复 最后回复
                      0
                      • fcmeF fcme

                        deepseek的ngram架构确实很好,Qwen这个flash就用了啊,部分内容以查代算。
                        你这个一直再搞搞肯定是可以成功的,只不过工作量太大了,你要没有超级计算机的话

                        johnnybegoodJ
                        johnnybegoodJ
                        johnnybegood
                        超凡大师
                        编写于 最后由 编辑
                        #11

                        @fcme 是的, 要写10000行代码, 还不一定成功。确实没时间。从硬件分析角度来说, 其实也收益不会太大。

                        fcmeF 1 条回复 最后回复
                        1
                        • johnnybegoodJ johnnybegood

                          @fcme 是的, 要写10000行代码, 还不一定成功。确实没时间。从硬件分析角度来说, 其实也收益不会太大。

                          fcmeF
                          fcmeF
                          fcme
                          超凡大师
                          编写于 最后由 编辑
                          #12

                          @johnnybegood
                          确实,我花了两三天的时间想要把paiton框架用到的算子和内核移植到SGlang上面配合牛逼的缓存技术让本地跑27b的体验飞升。结果天不随我愿,虽然已经从官方版本的pp1100左右今天顶到了2350,TG也提高了大概35%左右,整体上已经几乎翻倍了,相比原生SGlang。但是还是不如paiton在vLLM下的绝对速度,最后各种尝试遍了以后发现还是内核支持的问题,哎,干这个工程量可就太大了,而且即使在AI时代有这个能力的人也不多吧。
                          还是要看大神们发挥了。

                          1 条回复 最后回复
                          1
                          • stxpnetS
                            stxpnetS
                            stxpnet
                            超凡大师
                            编写于 最后由 stxpnet 编辑
                            #13

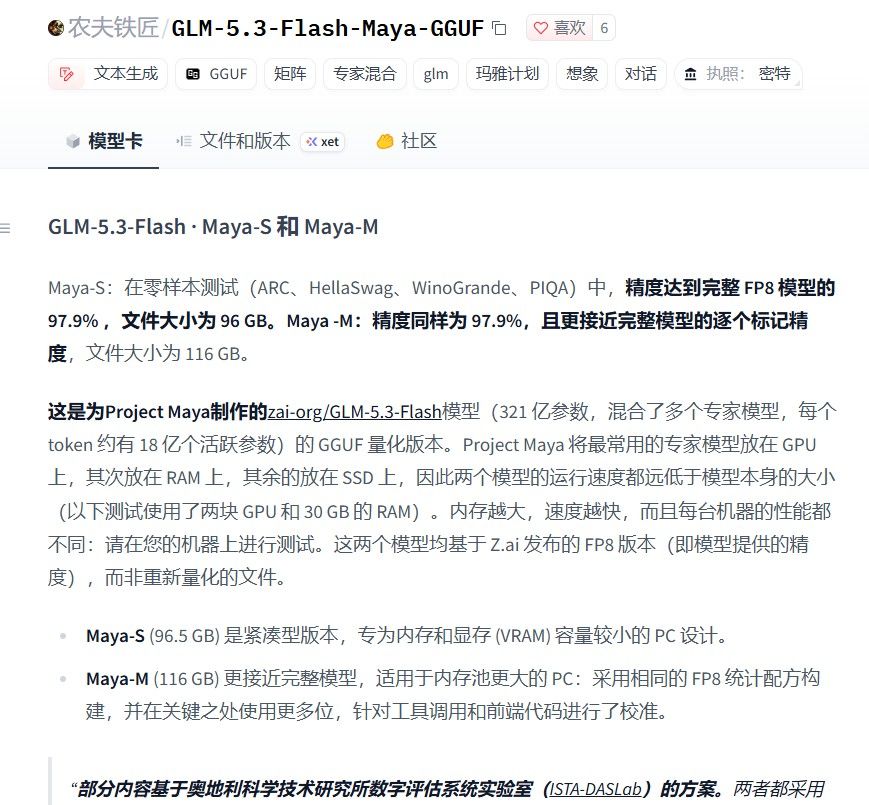
                            image.jpeg

                            https://huggingface.co/peasantsmith/GLM-5.3-Flash-Maya-GGUF
                            有人已经做好了strata的fork了. 跑glm 5.3 flash,作者好像用的两张20系显卡.

                            速度
                            在两台配备 32GB 内存(30GB RAM)的 Tesla V100 上运行 Maya-S,并使用 Project Maya 进行测试:解码(写入答案)速度最高可达 40 个 token/s,支持 MTP 块草稿,即使在处理较长的上下文(60K tokens)时也能保持该速度;预填充(读取提示)速度最高可达 560 个 token/s。在一台配备 64GB RAM 的 Tesla V100 上:解码速度最高可达 19 个 token/s,预填充速度最高可达 370 个 token/s。 ./maya.sh --bench请以相同方式测试您的机器。

                            运行它
                            Project Maya(github.com/mw00/project-maya):使用一到两块 NVIDIA GPU,其余模型位于 RAM 和 SSD 上;图片通过上述视觉文件显示。./setup.sh下载、检查并设置 Maya-S;./setup.sh --setup --model Maya-M设置 Maya-M。
                            llama.cpp构建支持 GLM-5.3-Flash ( glm5next),可将其作为任何 GGUF 加载。

                            那些人一般用的claude code最强的套餐去改的这些框架.

                            双卡3090 PCIE 4.0 16X/16X

                            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                            1 条回复 最后回复
                            1
                            • gao GaoG
                              gao GaoG
                              gao Gao
                              编写于 最后由 编辑
                              #14

                              看来用 智商 最高的大模型去 解决这类问题 实现拉一把小弟智商性能的 的渠道是可以打通的

                              1 条回复 最后回复
                              0
                              • gao GaoG
                                gao GaoG
                                gao Gao
                                编写于 最后由 编辑
                                #15

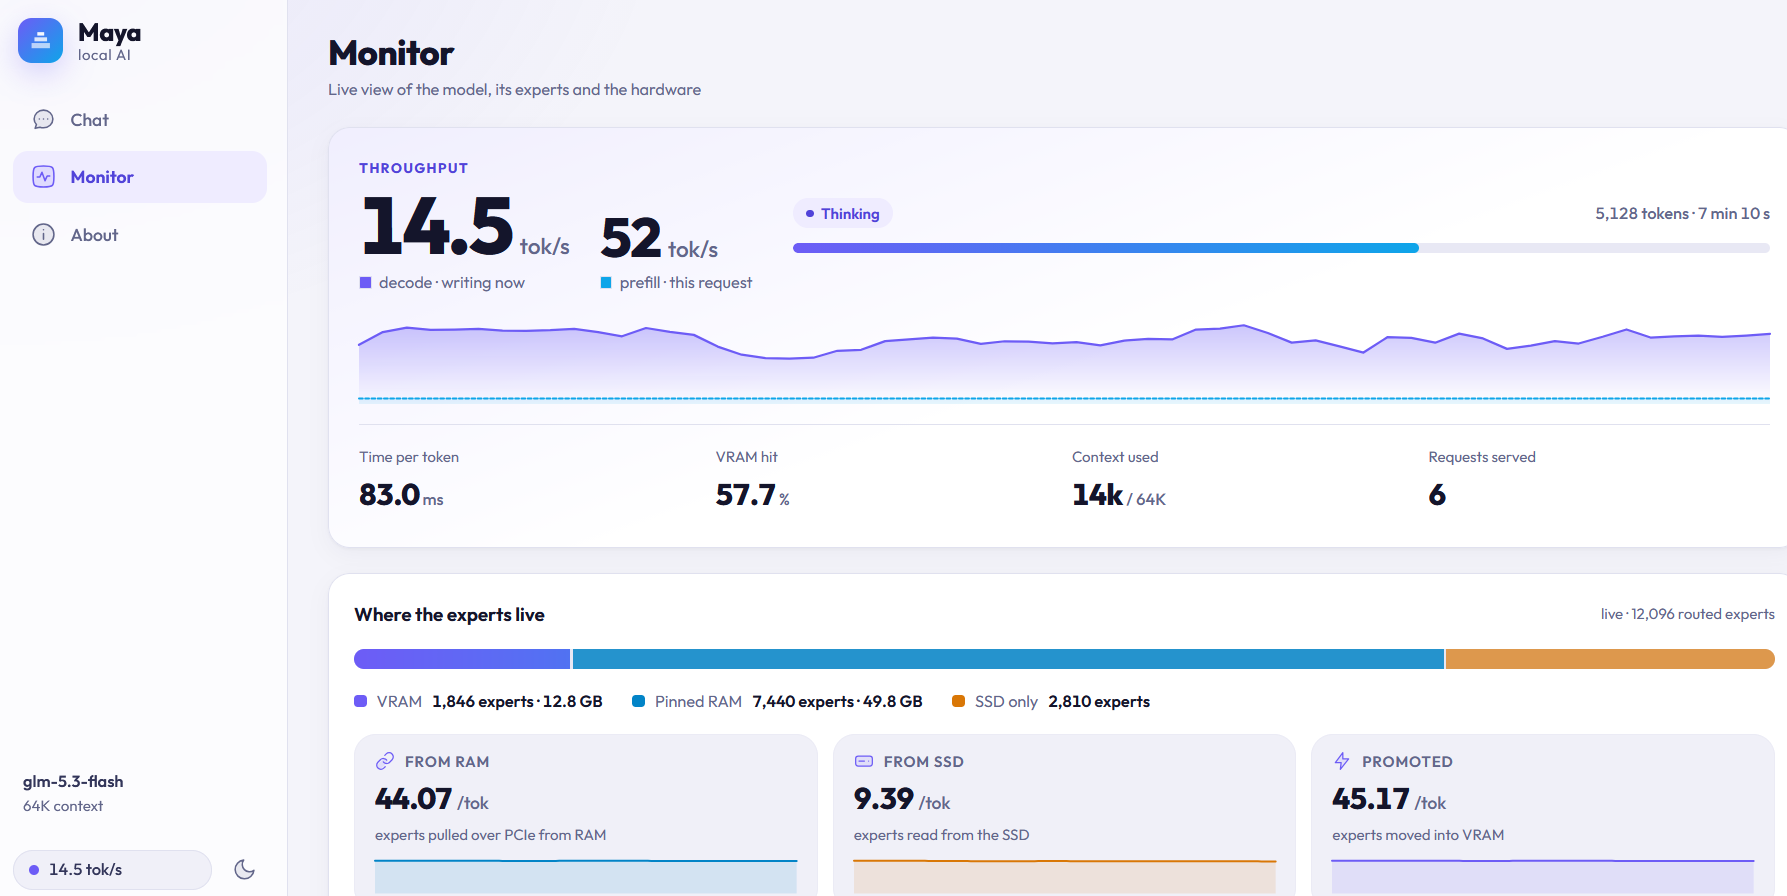
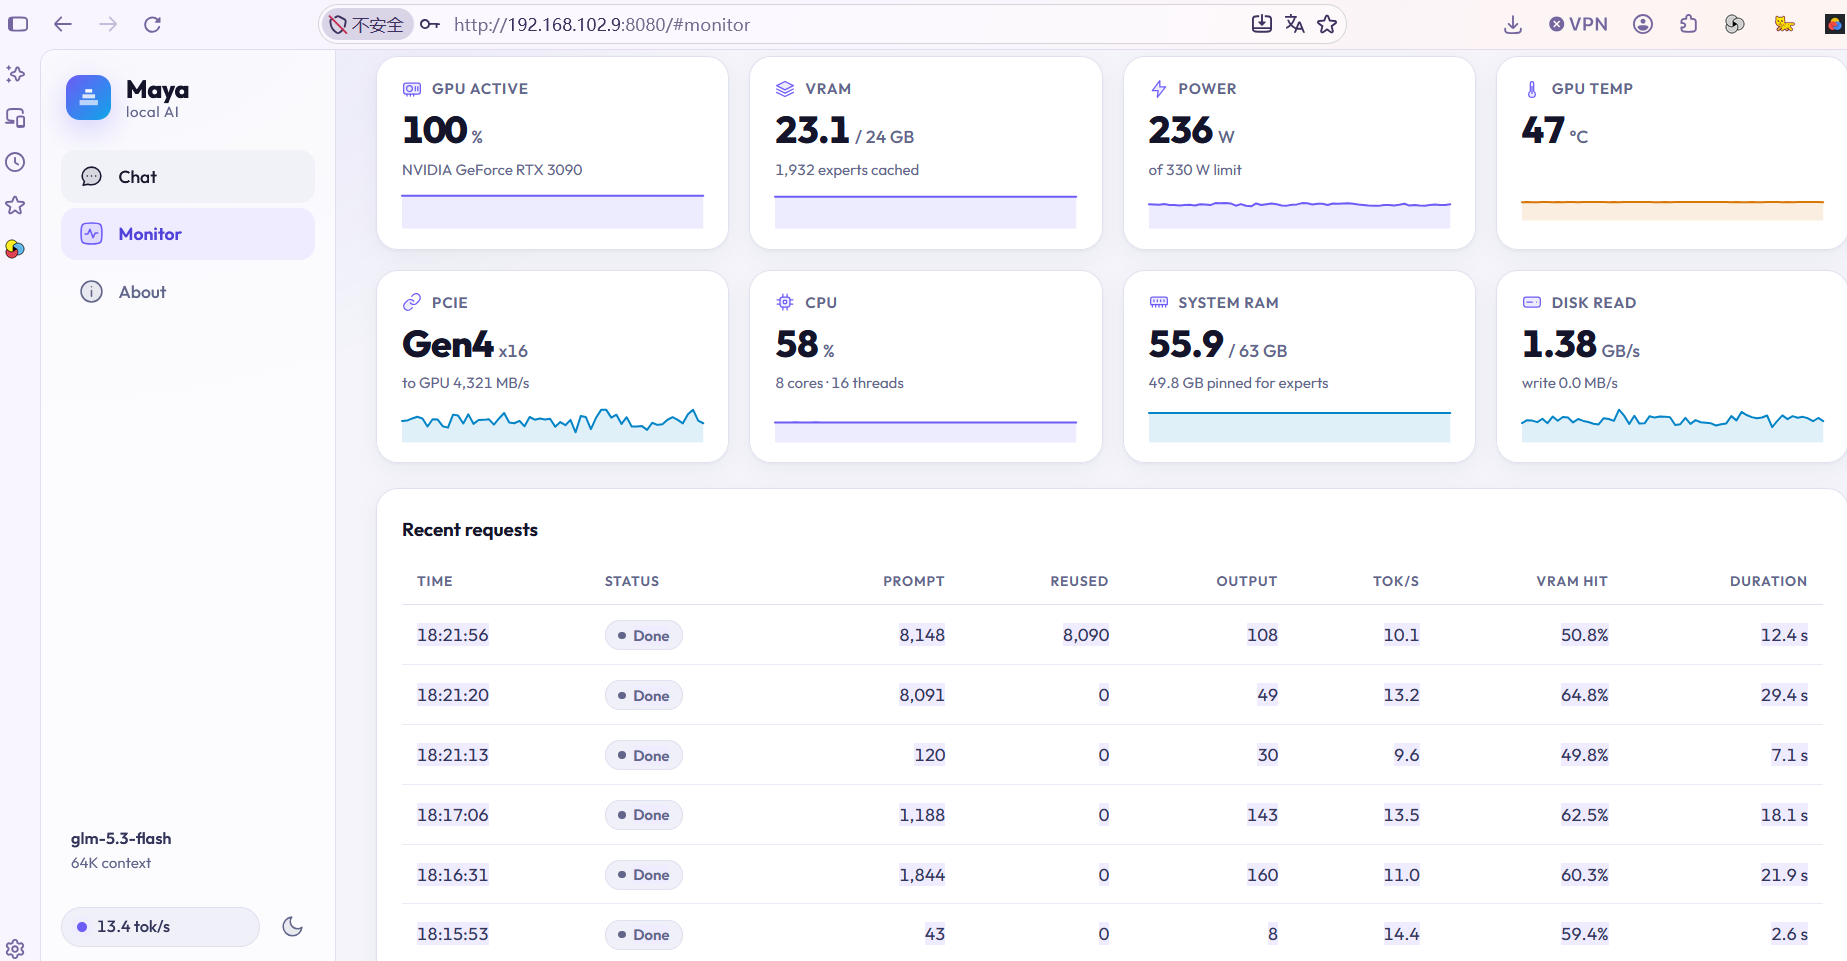
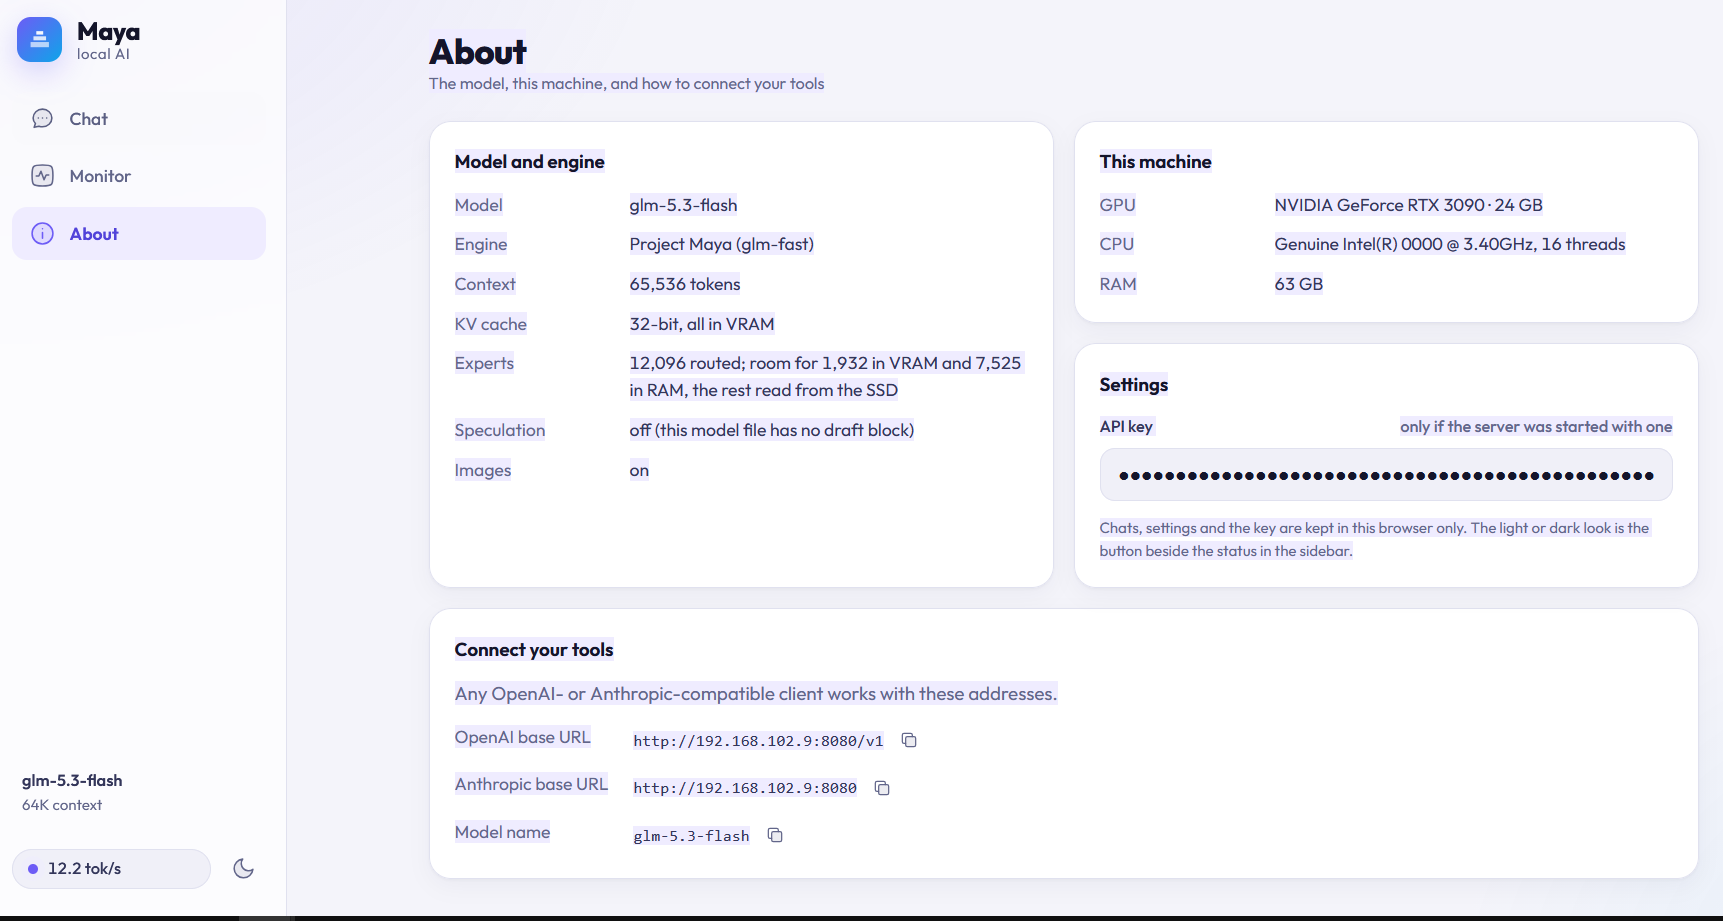
                                @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                                2026-10-08 18 24 57.png
                                2026-10-08 18 24 57-2.png
                                2026-10-08 18 24 57-3.png

                                johnnybegoodJ stxpnetS J 3 条回复 最后回复
                                1
                                • gao GaoG gao Gao

                                  @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                                  2026-10-08 18 24 57.png
                                  2026-10-08 18 24 57-2.png
                                  2026-10-08 18 24 57-3.png

                                  johnnybegoodJ
                                  johnnybegoodJ
                                  johnnybegood
                                  超凡大师
                                  编写于 最后由 编辑
                                  #16

                                  @gao-Gao 这。。。这个跟llama.cpp 0.6.0 直接跑也差不多了。

                                  1 条回复 最后回复
                                  0
                                  • gao GaoG
                                    gao GaoG
                                    gao Gao
                                    编写于 最后由 gao Gao 编辑
                                    #17

                                    @johnnybegood 不是,我估计我内存上到96GB ,把ssd上的全部加载到内存,速度会明显提升

                                    1 条回复 最后回复
                                    0
                                    • ,johnnybegoodJ johnnybegood 引用了 此主题
                                    • gao GaoG gao Gao

                                      @stxpnet 汇报下,单卡3090 24G 64G内存 64K上下文 Maya-S-v2-IQ2_XXS 不太会测试,仅供参考
                                      2026-10-08 18 24 57.png
                                      2026-10-08 18 24 57-2.png
                                      2026-10-08 18 24 57-3.png

                                      stxpnetS
                                      stxpnetS
                                      stxpnet
                                      超凡大师
                                      编写于 最后由 编辑
                                      #18

                                      @gao-Gao 哈哈,这让我想起我之前在双路 XEON老机器 上面(16条16G DDR4 2133内存) 纯CPU跑122B的IQ4_XS模型,那里也能得到15-20T/S (用了proxmox的arc技术,把划64G给磁盘当缓存用,因此llama.cpp可以 秒速从内存里面读GGUF) 。
                                      后来放弃了,速度真的太慢,不实用。 我感觉本地要40-50 T/S可以实用。 100T/S左右可以爽玩。

                                      双卡3090 PCIE 4.0 16X/16X

                                      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                      1 条回复 最后回复
                                      0
                                      • Ben LeeB
                                        Ben LeeB
                                        Ben Lee
                                        超凡大师
                                        编写于 最后由 编辑
                                        #19

                                        @johnnybegood "... 于是我跟AI一起把 Strata 的说明书和源码翻了一遍,又用脚本把 Huihui-DeepSeek-V4-Flash-BF16-abliterated-ds4-Q4_K.gguf 的 GGUF 头解开逐层比对。..." 大侠你是这么过国庆节的啊 😊

                                        1 条回复 最后回复
                                        0
                                        • XiaoteX
                                          XiaoteX
                                          Xiaote
                                          编写于 最后由 编辑
                                          #20

                                          🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                                          奖励凭证:热议 +3 分 · 编号 h2153-363-1(系统自动发放,显示稍有延迟)

                                          老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组