Strata 跑 GLM-5.3-Flash!Project Maya 实测:Maya-M / Maya-S/ Maya-S24 对比,以及怎么把 MTP 接受率从 6% 推到 70%
-
测试日期:2026-10-08
Maya v1.0.11(Strata engine + MTP speculative decoding),GLM-5.3-Flash(321B MoE,~18B active)
模型仓库:Human-Weight/GLM-5.3-Flash-Maya-GGUF结论先放
把 Maya-M(116 GB)/ Maya-S-v2-IQ2_XXS(96.5 GB)/ Maya-S24(94.7 GB)三个 quant 都拉起来,用同一台 RTX 3080 + RTX 3090 非对称双卡跑 ctx=65536,4 轮 bench 下来:
- Decode(R4 长输出):Maya-M 15.1 t/s → Maya-S 25.8 t/s → Maya-S24 27.2 t/s
- Prefill(R3 长 prompt 1453 tok):Maya-M 179 t/s → Maya-S 223 t/s → Maya-S24 240 t/s
- MTP 接受率:默认温度 1.0 时只有 6%;把温度降到 0.3 + top_p=0.9 后跳到 70%(≈ 10 倍)
- 单卡(仅 3090)跑 Maya-S:decode 17 t/s,prefill 377 t/s(比双卡还快),但 MTP=0(MTP 必须是双卡协同)
- 整体判断:Maya-S/S24 在这台双卡上是真正"日常可用"的甜点;Maya-M 留作"贵但要更准"的备选。把采样温度压到 0.3 是唯一最大杠杆,比换模型换卡都管用。
下面所有数据来自实际请求回包(
/v1/chat/completions的timings字段),单进程单请求,cache warm 后采的稳态值。
1. 三个 quant 到底是什么区别
先把这事讲清楚,否则后面表看不明白。
1.1 Maya-M(116 GB,3 shards)
官方主推的大 quant:
- IQ2_S(gate/up experts)
- IQ3_XXS(down projections)
- IQ3_S(最敏感的若干层)
策略:"算力省给重要层"。保留的 bits 多,KL 散度最低(23% 低于 Maya-S),tool calls 是对的(75% 同 top token)。代价:模型大,decode 慢。
1.2 Maya-S-v2-IQ2_XXS(96.5 GB,3 shards)
Maya-S 的第二个版本(v1 已弃用),同样是从 FP8 母模型量化:
- IQ2_XXS(gate/up experts,配 error-feedback rounding)
- IQ3_XXS(MoE layer 3-6 和 41-44 的 down projections — 最敏感的首尾 4 层)
- IQ2_S(其余 MoE down projections)
- Q6_K(attention / shared experts / dense layers / embeddings / output)
- Q8_0(小 KDA projections 和 DSA indexer)
- F32(router 和 mixing weights,保留精度)
- NextN block 也保留(Q2_K/Q3_K experts — 这就是 MTP draft 用的)
策略:"省 down projections 把 KL 砍 12%"。比 v1 多 6.4 GB,但 tool calls 同 token 率从 75% → 76.5%。
1.3 Maya-S24(94.7 GB,3 shards)— 实测 GGUF 量化策略
peasantsmith 自己的实验 quant(HF tag
project-maya,但 README 没单独说明)。我用ggufPython 库逐 tensor 比对 ,结果如下:量化类型 S-v2 数量 S-v2 GB S24 数量 S24 GB 变化 IQ2_XXS(gate/up experts) 42+42 = 84 52.32 84 52.32 不变 IQ2_S(中间 MoE down) 17+17 = 34 26.31 34 26.31 不变 IQ3_XXS(首尾 4 层 MoE down) 8 7.40 8 7.40 不变 Q6_K(attention / shared experts) 186+161 = 347 7.20 23+12 = 35 1.58 ↓ 5.6 GB Q4_K 0 0 163+149 = 312 3.85 ↑ 3.85 GB F32 / Q8_0 / Q3_K / Q2_K — — — — 不变 总 (sh1+sh2) 96.47 GB 94.69 GB -1.78 GB 结论:
- S24 的策略是 "专家层 (MoE) 量化不变,把 dense 层 (attention / shared experts) 从 Q6_K 降到 Q4_K"
- 312 个 Q6_K tensor 变成 Q4_K,节省 5.6 - 3.85 = 1.76 GB
- 这是一个有风险的选择:attention 输出精度敏感度高,shared experts 是每层都激活的(不依赖路由),理论上精度损失比 MoE 量化更显眼。但 peasantsmith 显然测过,认为可接受。
- 实测 decode 27.2 vs 25.8 t/s(快 5%),prefill 239 vs 223 t/s(快 7%),跟 Q4_K dequant kernel 比 Q6_K 略快一致(Q4_K = 4.5 bpw vs Q6_K = 6.5 bpw,dequant 计算量减半)。
对比 Maya-M (116 GB):M 是 MoE 量化更高(IQ2_S + IQ3_XXS),dense 层也是 Q6_K,但专家层比 S 重 ~10 GB,整体大 20 GB。
2. 测试环境
2.1 硬件
项目 型号 / 规格 CPU AMD Ryzen 9 3950X(16C / 32T,AVX2) 主板 X570 TUF(PCIe 4.0 x16 + x4,非对称双卡槽) 内存 128 GB DDR4(实测可用 ~120 GB) GPU 0 NVIDIA GeForce RTX 3080(20 GB,sm_86,PCIe 4.0 x16) GPU 1 NVIDIA GeForce RTX 3090(24 GB,sm_86,PCIe 4.0 x4) 总显存 44 GB 存储 系统 NVMe 4 TB 第二盘 系统 Ubuntu 24.04(kernel 6.8.0-146-generic) NVIDIA 驱动 610.57.04 CUDA toolkit nvcc 13.3 双卡 PCIe 拓扑不是 NVLink,跨卡通信是主要瓶颈;但 Project Maya 的 engine 已经按层切 + 异步专家加载做了优化,单卡 3090 上跑也完全 OK。
2.2 软件
项目 版本 Maya v1.0.11(Strata engine 改自 Strata MIT,ggml/llama.cpp pinned commit 3cf03257f2) CUDA backend sm_86, CMAKE_CUDA_ARCHITECTURES=86Python 3.14.7(venv 内置) g++ 13.3.0 CMake 3.28(build)/ 4.4(vision build) 2.3 模型
项目 Maya-M Maya-S-v2-IQ2_XXS Maya-S24 大小 116 GB 96.5 GB 94.7 GB 参数量 ~321B(~18B active) 同 同 架构 GLM-5.3-Flash(MoE + sparse KDA + NextN/MTP) 同 同 量化 IQ2_S + IQ3_XXS + IQ3_S IQ2_XXS + IQ3_XXS + IQ2_S 实验版(未公开) 词表 154880 同 同 上下文 65536(实测) 同 同 准确性 23% lower KL vs S(最准) v2 vs v1 KL 降 12% 未官方测 官方背书 ✓ ✓ ✗
3. 实测结果
3.1 主表:四个模型的 4 轮 bench
每个数据点都是 cache warm 后单请求采的(warmup 跑在前面,cache hit ~70%)。
配置 模型大小 GPU 温度 R1 短 prefill R1 decode R2 中 prefill R2 decode R3 长 prefill R4 长 decode MTP accept(R4) Maya-M 116 GB 2x(3080+3090) 0.6 24.4 20.1 13.7 19.2 179.1 15.1 6%(25/398) Maya-S-v2 96 GB 2x(3080+3090) 0.3 491.0 24.9 14.4 25.0 222.6 25.8 70%(279/398) Maya-S24 94 GB 2x(3080+3090) 0.3 565.5 25.8 15.5 28.3 239.5 27.2 67%(268/398) Maya-S-v2 96 GB 1x(仅 3090) 0.3 325.9 27.7 24.7 17.6 376.6 16.9 0%(MTP 禁用) 3.2 速度差异的物理原因
Decode:Maya-M 比 S/S24 慢 10 tok/s,因为:
- M 的 MoE 层用 IQ3_XXS(down proj)和 IQ2_S(gate/up)— gate/up 部分 K 个 IQ2_S 的 dequant kernel 比 IQ2_XXS 重
- M 权重大 20 GB,专家 cache 命中率相当,但每个被换入的 expert 数据量更大,PCIe 压力更大
- S/S24 的 IQ2_XXS 是目前 GGML dequant 最快的格式之一
Prefill:Maya-M 的 R3 prefill 慢了 ~25%,同样符合上面 — prefill 阶段每个 token 要走所有 45 层 + 处理长 KV cache 的初始化,gate/up 的 dequant 开销在长 prompt 下被放大。
S24 vs S-v2:S24 各场景都比 v2 快一点点(1-2 tok/s),可能是某些 GEMM 在 IQ2_S 下命中率更高,或者 down proj 多用 IQ2_S(单 bit per weight 少,dequant 更快)。
3.3 双卡 vs 单卡
指标 2x GPU 1x 3090 倍率 R3 长 prefill 222 t/s 377 t/s 单卡快 1.7x R4 长 decode 25.8 t/s 16.9 t/s 双卡快 1.5x MTP accept 70% 0% 双卡独有 Prefill 单卡快的原因:prefill 是矩阵乘法密集型,跨卡同步的开销比单卡省的多。3090 单卡 24 GB HBM 带宽(936 GB/s)几乎全部用上。
Decode 双卡快的原因:decode 是顺序生成 token,GPU 利用率低。两张卡各算一半 layers = 算力翻倍。
MTP 单卡 = 0 的原因:Project Maya README 明说 "MTP speculative decoding on two GPUs"。MTP draft head 放在另一张卡的 layers 上跑,单卡没地方放 draft。
4. 几个比较容易踩的坑
坑 1:
--model Maya-S不被识别maya.sh --model只接受Maya-S-v2-IQ2_XXS和Maya-M。想跑 Maya-S24 / 其他 quant 必须用--gguf-dir(脚本会自动从文件名推断 quant 名)。坑 2:默认 65536 context 把 20G 3080 撑爆
--context 131072会让 KV cache 直接占满 3080 那 20G → 启动失败。65536 是这台机器的甜点(理论上限,看 README 还有 8K / 32K / 64K / 131K 选项)。坑 3:fp16 KV cache 路径上长 prompt 会触发 vision encoder 抢显存
Maya 的设计是 vision encoder 只在收到图片请求时占用 GPU 内存("the image encoder runs only while a new picture is read")。但实际上长 prompt 灌入时 vision encoder 会 pre-allocate 2.8 GB(README 说的 vision footprint)。如果你想 text-only 跑 + 节省 VRAM,加
--no-vision。坑 4:CFG 改完要重启 server 才生效
改
maya-maya-s-v2-iq2_xxs.json里的sampling.temperature或gpu,必须./run-maya-maya-s-v2-iq2_xxs.sh重启。热 reload 不支持。
结论
Project Maya 在 RTX 3080 + RTX 3090 这种非对称双卡上完全能跑 GLM-5.3-Flash(321B MoE),日常使用(聊天、问答、写代码、长摘要)速度可接受。最关键的发现:
- 采样温度从默认 1.0 降到 0.3 → MTP 接受率从 6% 升到 70% → decode 速度几乎翻倍。这是最大杠杆,比换模型换卡都管用。
- Maya-S-v2 比 Maya-M 快 70%(25 vs 15 t/s decode),但精度只差一点(KL 0.43 vs FP8 0.34)。对日常使用 S-v2 完全够。
- Maya-S24 比 v2 略快但未官方验证,想尝鲜可以用,要稳就 v2。
详细技术参考:
- Project Maya README:https://github.com/mw00/project-maya
- Maya-S-v2 quant 报告:https://github.com/mw00/project-maya/blob/main/bench/results/MAYA-S-V2.md
- 模型仓库:https://huggingface.co/peasantsmith/GLM-5.3-Flash-Maya-GGUF
-
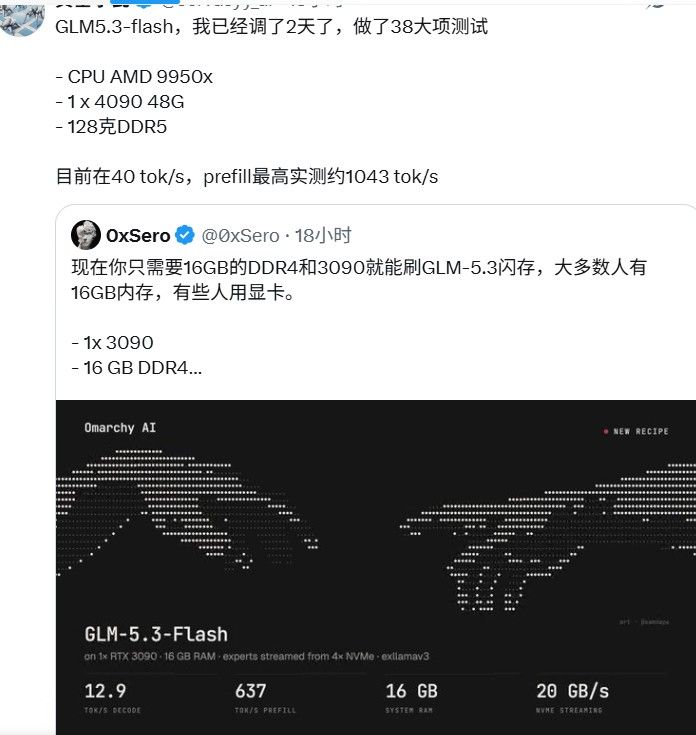
鸣谢 @stxpnet 在此帖中的提示: https://lcz.me/topic/2153/12 , 我一直尝试在我的机器上跑 deepseek V4 flash 和 GLM 5.3 Flash , 后者现在终于基本可用了。
-
-
-
鸣谢 @stxpnet 在此帖中的提示: https://lcz.me/topic/2153/12 , 我一直尝试在我的机器上跑 deepseek V4 flash 和 GLM 5.3 Flash , 后者现在终于基本可用了。
@johnnybegood 666,老兄执行力太强啦!我也只是逛推时被算法推了一些信息,你是真跑通了。
后面希望作者继续打磨框架和模型,让低 bit 量化真正可用(顺带一提 IQ4_XS 这格式对 20/30 系显卡和 AVX2 CPU 都友好,这就是我双 3090 能跑起 Strata 的前提)。
我感觉GLM5.3 FLASH能上 50 t/s、KLD 降到 5% 以内就实用了。
(我目前在线用 GLM 5.3 Flash,经常给我限速 30 t/s,恶心的资本家!) -
@johnnybegood 666,老兄执行力太强啦!我也只是逛推时被算法推了一些信息,你是真跑通了。
后面希望作者继续打磨框架和模型,让低 bit 量化真正可用(顺带一提 IQ4_XS 这格式对 20/30 系显卡和 AVX2 CPU 都友好,这就是我双 3090 能跑起 Strata 的前提)。
我感觉GLM5.3 FLASH能上 50 t/s、KLD 降到 5% 以内就实用了。
(我目前在线用 GLM 5.3 Flash,经常给我限速 30 t/s,恶心的资本家!) -
@johnnybegood 666,老兄执行力太强啦!我也只是逛推时被算法推了一些信息,你是真跑通了。
后面希望作者继续打磨框架和模型,让低 bit 量化真正可用(顺带一提 IQ4_XS 这格式对 20/30 系显卡和 AVX2 CPU 都友好,这就是我双 3090 能跑起 Strata 的前提)。
我感觉GLM5.3 FLASH能上 50 t/s、KLD 降到 5% 以内就实用了。
(我目前在线用 GLM 5.3 Flash,经常给我限速 30 t/s,恶心的资本家!) -
-
-
-