跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !

llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !

已定时 已固定 已锁定 已移动 LLM讨论区
llama.cppdeepseekglm
13 帖子 8 发布者 445 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT
    terryT
    terry
    超级版主
    编写于 最后由 terry 编辑
    #2

    关键还是prefill增量计算的问题,有没有达到高可用度,没有它就还是入门级选手。

    油管:https://www.youtube.com/@抡锤者

    1 条回复 最后回复
    0
    • stxpnetS
      stxpnetS
      stxpnet
      超凡大师
      编写于 最后由 编辑
      #3

      推上有人拿strata 说事,埋怨llama.cpp,vllm,sglang的人都在干嘛.

      双卡3090 PCIE 4.0 16X/16X

      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
      张光璞张 1 条回复 最后回复
      0
      • imbiplaza ASUSI
        imbiplaza ASUSI
        imbiplaza ASUS
        谪仙人
        编写于 最后由 编辑
        #4

        告诉llama.cpp那帮人,事实证明,我们真的需要把整个模型load 去vram 才能跑得快吗?

        1 条回复 最后回复
        0
        • C
          C
          comeN
          编写于 最后由 编辑
          #5

          30以下真的不可用啊,开思考50以上才能接受

          1 条回复 最后回复
          0
          • 懒人烘培懒
            懒人烘培懒
            懒人烘培
            德高望重 劳动模范
            编写于 最后由 编辑
            #6

            我主力还是用SGLang,当然用strata也有部署

            双 7900 XTX:模型本地跑,Token 随便烧!

            terryT 1 条回复 最后回复
            1
            • stxpnetS stxpnet

              推上有人拿strata 说事,埋怨llama.cpp,vllm,sglang的人都在干嘛.

              张光璞张
              张光璞张
              张光璞
              技术大牛 劳动模范
              编写于 最后由 编辑
              #7

              @stxpnet 说:

              推上有人拿strata 说事,埋怨llama.cpp,vllm,sglang的人都在干嘛.

              Strata 现在一天两更,太疯狂了。 我整了个计划任务自动抓取跟AMD 相关的性能优化,其他都略过。

              懒人烘培懒 1 条回复 最后回复
              0
              • 懒人烘培懒 懒人烘培

                我主力还是用SGLang,当然用strata也有部署

                terryT
                terryT
                terry
                超级版主
                编写于 最后由 编辑
                #8

                @懒人烘培 俺也一样

                油管:https://www.youtube.com/@抡锤者

                1 条回复 最后回复
                0
                • 张光璞张 张光璞

                  @stxpnet 说:

                  推上有人拿strata 说事,埋怨llama.cpp,vllm,sglang的人都在干嘛.

                  Strata 现在一天两更,太疯狂了。 我整了个计划任务自动抓取跟AMD 相关的性能优化,其他都略过。

                  懒人烘培懒
                  懒人烘培懒
                  懒人烘培
                  德高望重 劳动模范
                  编写于 最后由 编辑
                  #9

                  @张光璞 Strata更新确实很勤~是好事哈~

                  双 7900 XTX:模型本地跑,Token 随便烧!

                  1 条回复 最后回复
                  0
                  • johnnybegoodJ johnnybegood

                    llama.cpp 0.6.0 最新版出了, https://github.com/ggml-org/llama.cpp

                    增加了很多模型支持, 把本地几个大个子模型又跑了一遍, 感触颇深, 之前跑这几个模型, 要么需要专门的软件和架构, 要么需要单独编译PR, 要么需要跑 EXL3 版, 总之每个模型想正常跑起来还是很折腾 , 现在 0.6.0 一出, 都可以直接跑, 毫无障碍, 改改启动参数就行了。

                    配置: 3090 24G+3080 20G, 128G DDR4 3600MHz

                    1、DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix-0731.gguf

                    ----跑出 20tok/s , 实测对话编程都挺流畅的,虽然文件名是 IQ2, 但是核心部分还是 Q8的, 挺好用。

                    2、DeepSeek-V4-Flash-0731-UD-IQ3_S-00001-of-00004.gguf

                    ----跑出 17tok/s

                    3、GLM-5.3-Flash-UD-IQ3_XXS-00001-of-00004.gguf

                    ----跑出 12tok/s , GLM好像优化的还不太好

                    不管怎么说, 这些之前认为的庞然大物,在我这种一般消费级的电脑上,可以跑起来了,也能较为流畅地进行交互,我觉得已够了,有时候大模型不一定是用来干重活儿的,可以把它当个知识库或者参谋来用,也挺好,这个时候我不需要它很快, 只要够聪明, 知识量够大就行了。

                    E
                    E
                    exe127
                    劳动模范
                    编写于 最后由 编辑
                    #10

                    @johnnybegood
                    想請教一下,
                    我下載了: llama-b11475-bin-win-vulkan-x64
                    模型是: Qwen3.8-27B-UD-Q4_K_XL

                    命令:
                    @echo off
                    title Qwen3.8-27B XL 131K MTP
                    .\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
                    pause

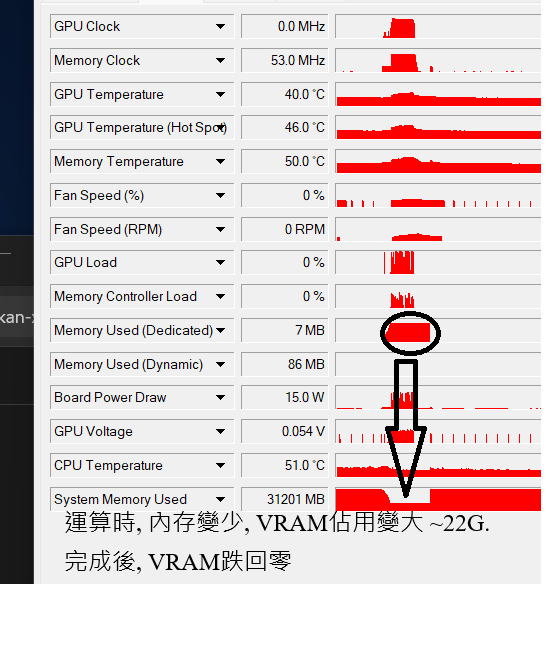
                    我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙
                    66ecb3b5-ab85-4074-b421-1175ce31de9b.png

                    johnnybegoodJ 2 条回复 最后回复
                    0
                    • E exe127

                      @johnnybegood
                      想請教一下,
                      我下載了: llama-b11475-bin-win-vulkan-x64
                      模型是: Qwen3.8-27B-UD-Q4_K_XL

                      命令:
                      @echo off
                      title Qwen3.8-27B XL 131K MTP
                      .\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
                      pause

                      我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙

                      66ecb3b5-ab85-4074-b421-1175ce31de9b.png

                      johnnybegoodJ
                      johnnybegoodJ
                      johnnybegood
                      超凡大师
                      编写于 最后由 编辑
                      #11

                      @exe127 -ngl 去掉 , -fit 弄成on再试试

                      E 1 条回复 最后回复
                      0
                      • johnnybegoodJ johnnybegood

                        @exe127 -ngl 去掉 , -fit 弄成on再试试

                        E
                        E
                        exe127
                        劳动模范
                        编写于 最后由 编辑
                        #12

                        @johnnybegood 謝謝, 我先回去試一下. 我的這個現象就是OOM嗎? 不知為何生成token 也可以有~50左右. 感覺還算很可以

                        1 条回复 最后回复
                        0
                        • E exe127

                          @johnnybegood
                          想請教一下,
                          我下載了: llama-b11475-bin-win-vulkan-x64
                          模型是: Qwen3.8-27B-UD-Q4_K_XL

                          命令:
                          @echo off
                          title Qwen3.8-27B XL 131K MTP
                          .\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
                          pause

                          我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙

                          66ecb3b5-ab85-4074-b421-1175ce31de9b.png

                          johnnybegoodJ
                          johnnybegoodJ
                          johnnybegood
                          超凡大师
                          编写于 最后由 编辑
                          #13
                          此主題已被删除!
                          1 条回复 最后回复
                          0

                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                          有了你的建议,这篇帖子会更精彩哦 💗

                          注册 登录
                          回复
                          • 在新帖中回复
                          登录后回复
                          • 从旧到新
                          • 从新到旧
                          • 最多赞同


                          • 登录

                          • 登录或注册以进行搜索。
                          • 第一个帖子
                            最后一个帖子
                          0
                          • 版块
                          • 最新
                          • 标签
                          • 热门
                          • 用户
                          • 群组


