
llama.cpp 0.6.0 出了,继续跑我的 Deepseek V4 和 GLM5.3 Flash !
-
-
告诉llama.cpp那帮人,事实证明,我们真的需要把整个模型load 去vram 才能跑得快吗?
-
-
-
-
-
-
llama.cpp 0.6.0 最新版出了, https://github.com/ggml-org/llama.cpp
增加了很多模型支持, 把本地几个大个子模型又跑了一遍, 感触颇深, 之前跑这几个模型, 要么需要专门的软件和架构, 要么需要单独编译PR, 要么需要跑 EXL3 版, 总之每个模型想正常跑起来还是很折腾 , 现在 0.6.0 一出, 都可以直接跑, 毫无障碍, 改改启动参数就行了。
配置: 3090 24G+3080 20G, 128G DDR4 3600MHz
1、DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2-imatrix-0731.gguf
----跑出 20tok/s , 实测对话编程都挺流畅的,虽然文件名是 IQ2, 但是核心部分还是 Q8的, 挺好用。
2、DeepSeek-V4-Flash-0731-UD-IQ3_S-00001-of-00004.gguf
----跑出 17tok/s
3、GLM-5.3-Flash-UD-IQ3_XXS-00001-of-00004.gguf
----跑出 12tok/s , GLM好像优化的还不太好
不管怎么说, 这些之前认为的庞然大物,在我这种一般消费级的电脑上,可以跑起来了,也能较为流畅地进行交互,我觉得已够了,有时候大模型不一定是用来干重活儿的,可以把它当个知识库或者参谋来用,也挺好,这个时候我不需要它很快, 只要够聪明, 知识量够大就行了。
@johnnybegood
想請教一下,
我下載了: llama-b11475-bin-win-vulkan-x64
模型是: Qwen3.8-27B-UD-Q4_K_XL命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
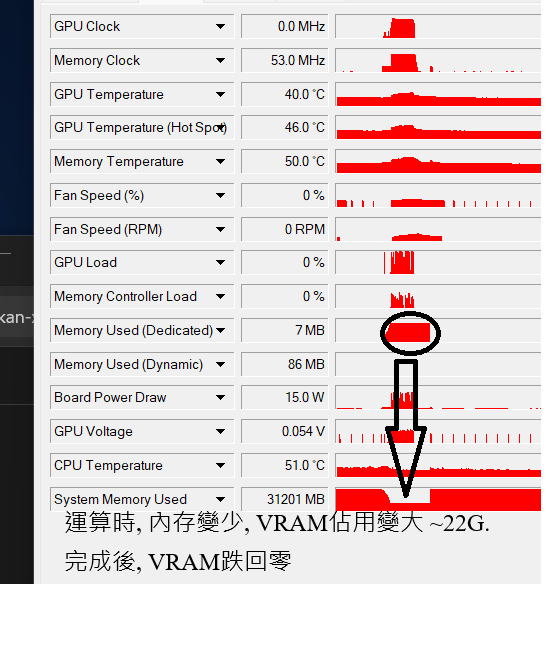
pause我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙
-
@johnnybegood
想請教一下,
我下載了: llama-b11475-bin-win-vulkan-x64
模型是: Qwen3.8-27B-UD-Q4_K_XL命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
pause我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙
-
@exe127 -ngl 去掉 , -fit 弄成on再试试
-
@johnnybegood
想請教一下,
我下載了: llama-b11475-bin-win-vulkan-x64
模型是: Qwen3.8-27B-UD-Q4_K_XL命令:
@echo off
title Qwen3.8-27B XL 131K MTP
.\llama-server.exe -m .\models\Qwen3.8-27B-UD-Q4_K_XL.gguf --model-draft .\models\mtp-Qwen3.8-27B-Q4_0.gguf -dev Vulkan1 -ngl 99 --fit off -c 131072 -ub 256 --cache-type-k q4_0 --cache-type-v q4_0 -np 1 --spec-type draft-mtp --spec-draft-n-max 2 --flash-attn on --host 0.0.0.0 --port 8080 --jinja
pause我在win11啟動模型後, 奇怪的是模型加載完成後, 會由VRAM搬到內存, VRAM此刻清零, 內存使用量暴升. 當發問問題時, VRAM才回升, 你可以看圖 ( System Memory 對比 Memory Used) , 是不是我的設定上有問題呢? 模型不能留在VRAM內. 我試過把上下文改成32k (將-c 131072 調整為 -c 32768) 情況同樣發生. 問了Gemini也解決不了. 謝謝大神幫忙
此主題已被删除!




