LLM解題 極限測試 Extreme-Exam-v7-A (出題者 : GPT6-Astra-max)
-
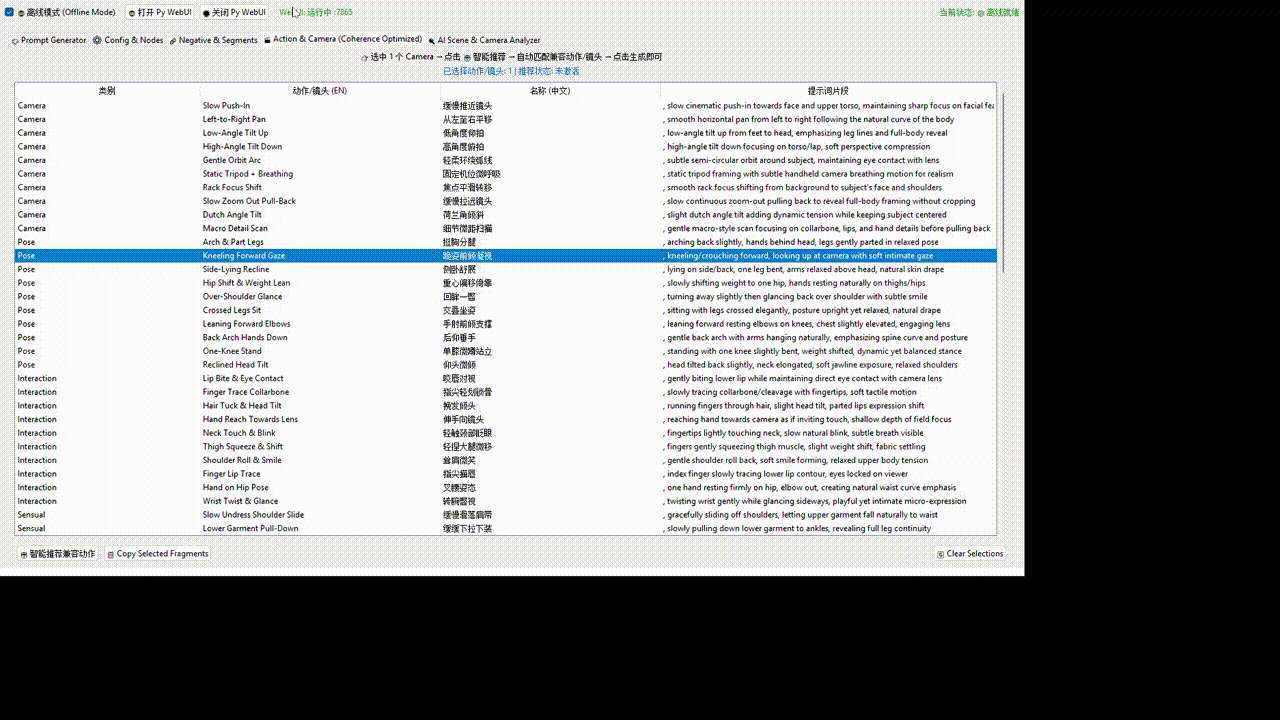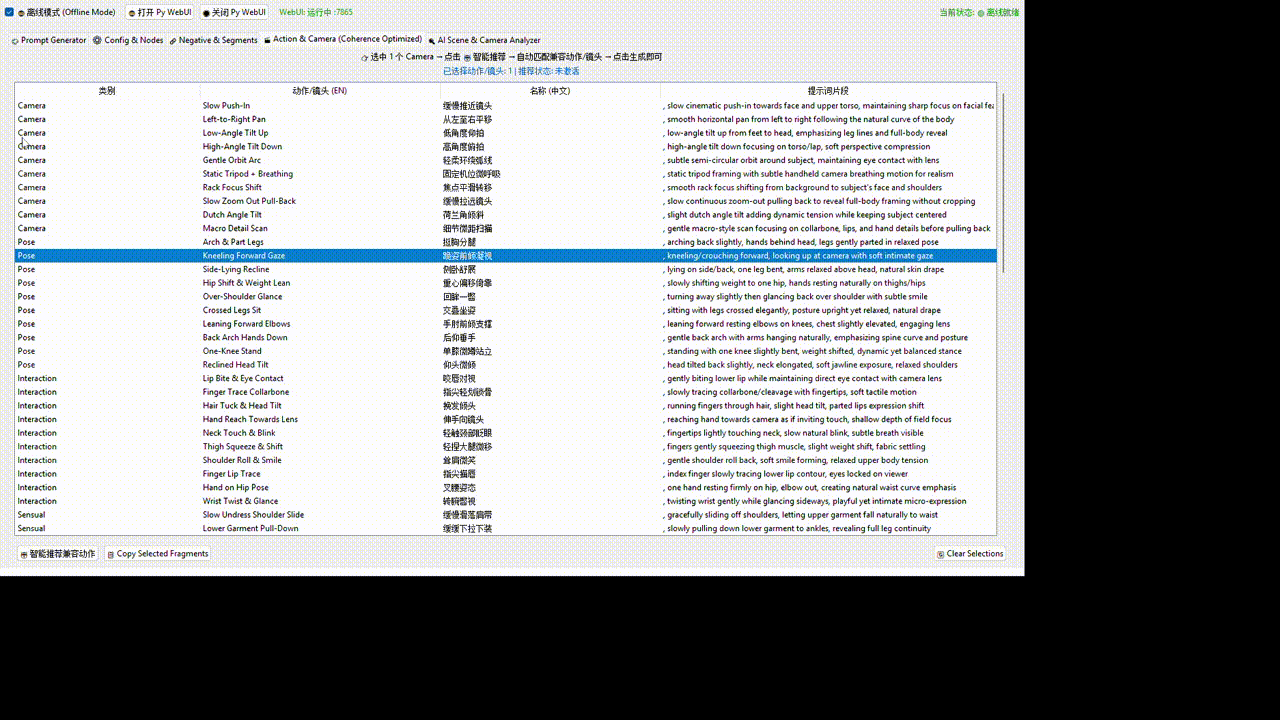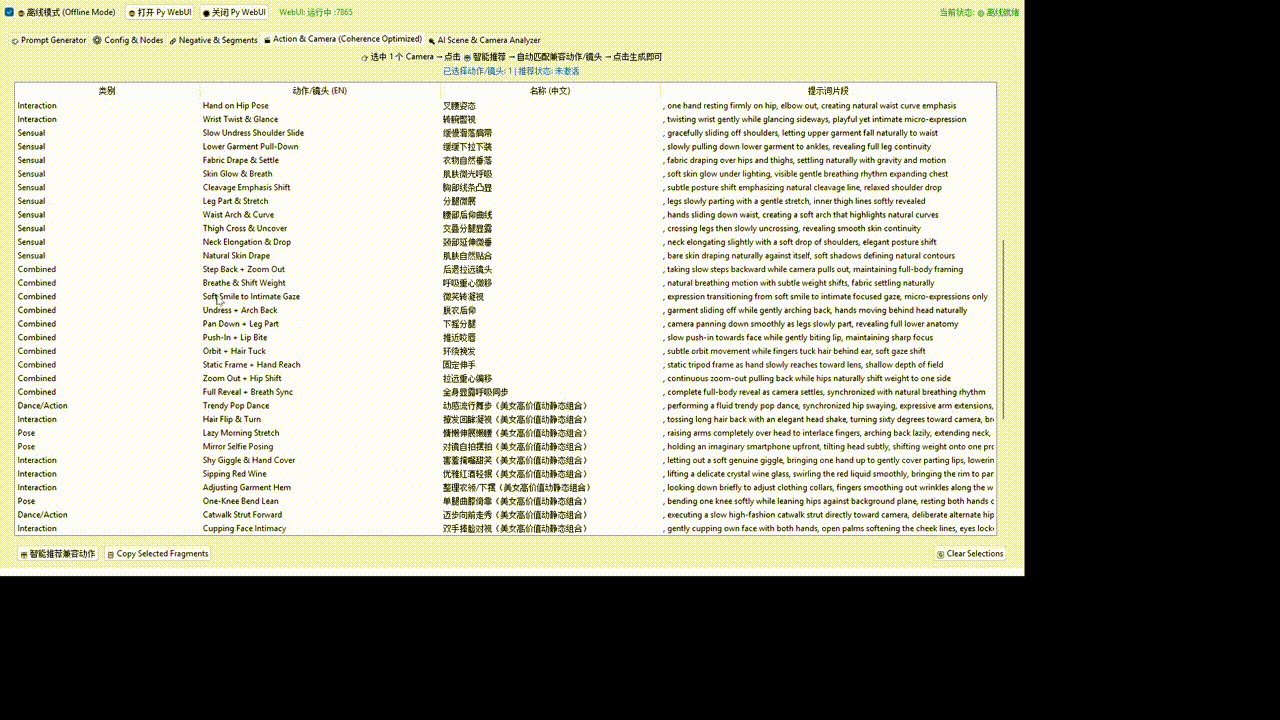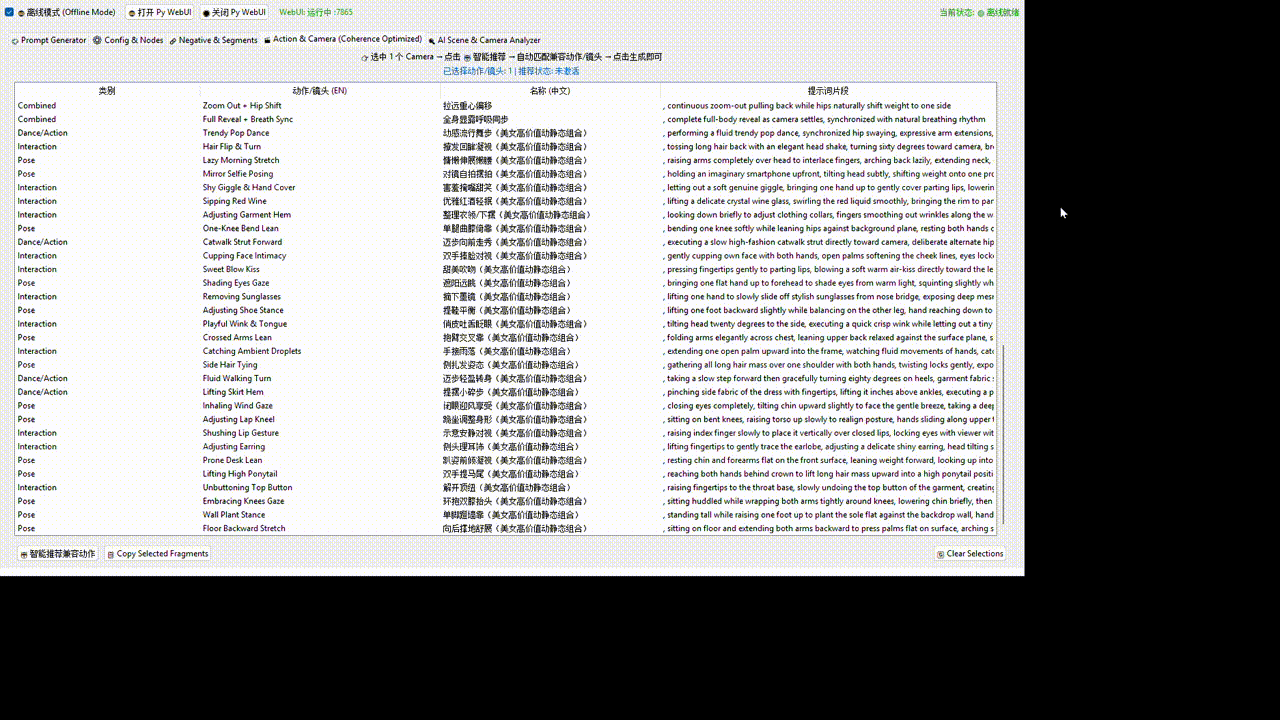
@imbiplaza-ASUS 我就看到了30款美女动态。。。
@johnnybegood
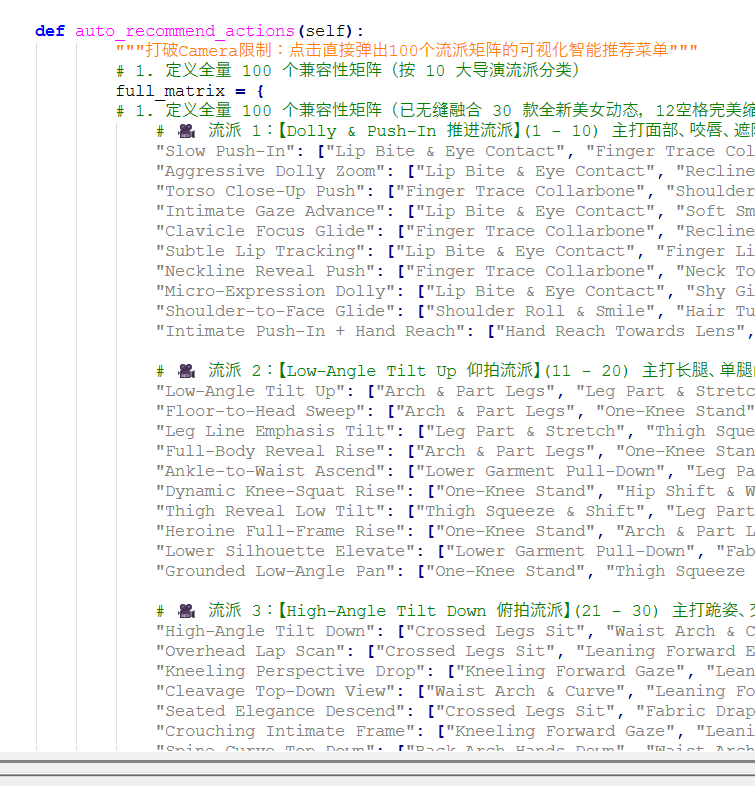
我当初是加入10套,每套10个动作,形成矩阵让ai 自己去配 -
本地的QFN IQ3_XXS => 7:30的时候,算出来了,
奇怪 我的DSH + QFN IQ3_XXS 怎麼算這麼慢?!!
我晚點再讓它跑一次 -
@kos-or 跟你开了个小玩笑,之前跑那么快因为是在同一个提示词下, 我先用在线模型跑了答案, 然后切换成qfn跑的,所以它是知道答案的,哈哈。 之后我清空了提示词, 重新开了对话, 跑起来就去睡觉了, 早上起来发现中间它多次修改代码, 纠正错误, 最后在 3个小时57分的时候, 给出了答案和完整证明。 对了我用的是 IQ4_XS, 256K 上下文。
-
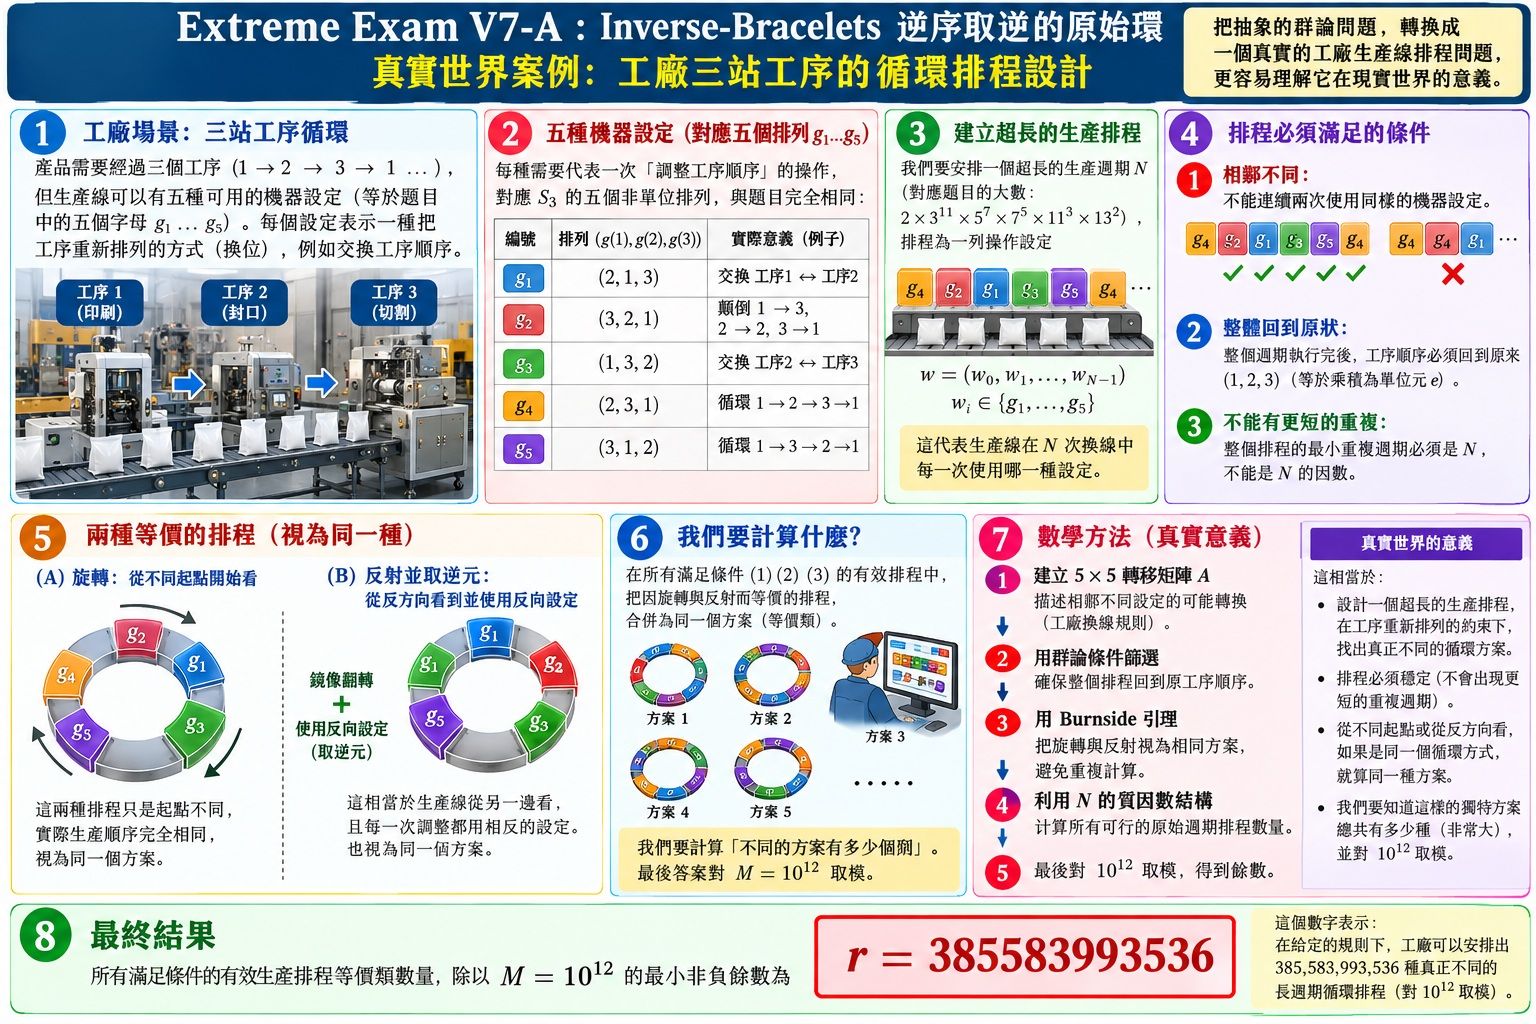
把之前我的Extreme Exam V7-A:Inverse-Bracelets 逆序取逆的原始環 ,弄成真实世界里面的案例,然后用一张图像来解释
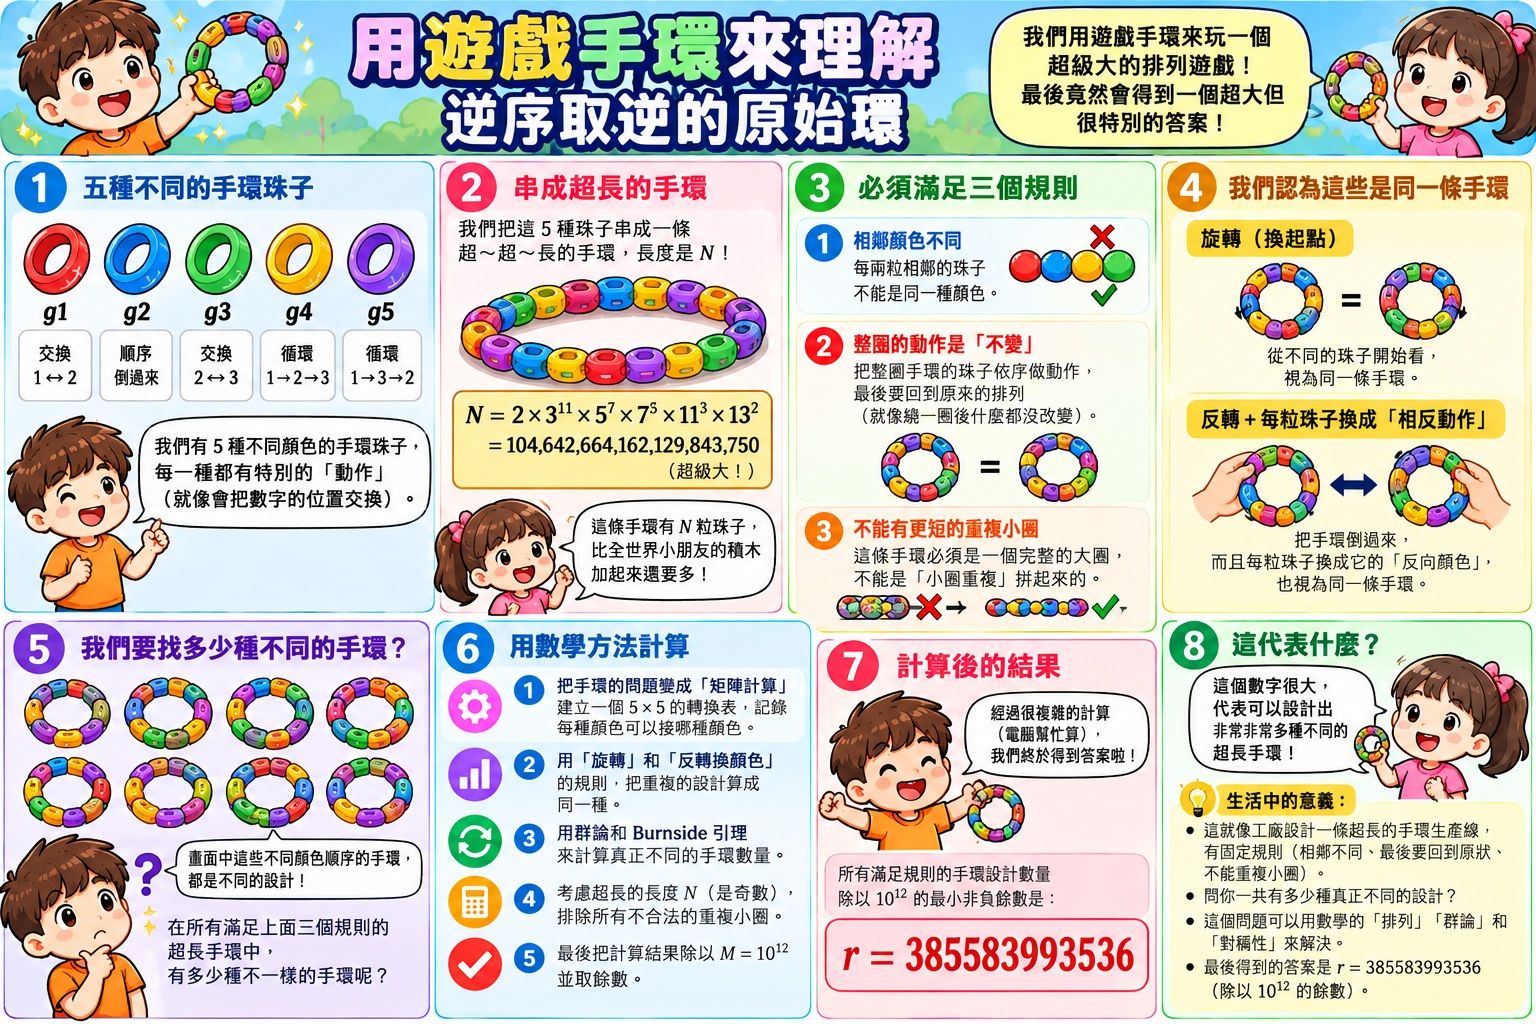
國小版
以下是我做视频的代码,你观察到我也使用类似的矩阵构思,
我放那么多,就是想说,做工控和做视频,都不是一件简单的事情,也不是在玩,我们现在并不是拿着摄影机(当然就算拿着摄影机也不代表在玩),而是真正使用矩阵代码将像素切成我们要的效果。。。。
-
-
-
-
断了数学家的乳酪
-
還沒看到英文和中文教授出來抗議 AI
這應該是被AI拿走整個乳酪 都沒了 -
-
@kos-or 我看了一下log, 发现中间有一段时间速度只有 2-3tok/s , 当时的cpu是 100%占满了, 居然是被它开了好几个 chrome来调试占满的,所以速度比较慢。 这可能是个bug。后面提示词我会加入让它最多只能开一个。
居然是被它开了好几个 chrome来调试占满的,所以速度比较慢
Extreme-Exam-v7-A 解題不需要動用到 Chrome吧
當時是跑 DSH on Chrome嗎?发现中间有一段时间速度只有 2-3tok/s , 当时的cpu是 100%占满了
我猜它會使用CPU進行Brute-force, 這個資源會和 QFN的RAM (CPU offloading) 產生搶資源衝突, 所以才 2-3tok/s
AI使用暴力破解Brute-force, 應該可以事先指定free GPU資源的, 讓它可以調度使用GPU解題
例如 : "測試過程中你可以使用GPU1當作運算工具"
我推測這會加速解題速度 -
-
我的Qwen 27B NVFP4 用了3小时25分, ChatGPT给判了98分.
总 token 体量 ≈ 1470 万(输入 + 输出 + 缓存读 ≈ 2.02M + 0.24M + 12.48M)
Extreme-Exam-V7-A 评测总结
受测模型: 本地 SGLang Qwen 27B
最终评分:98/100(A+)
评判结果:优秀,成功解题1. 答案正确性
- 标准答案:385583993536
- 模型答案:385583993536
- 结果:完全一致。
2. 数学与算法评价
- 正确应用 Burnside 引理与 Möbius 反演。
- 正确处理重复区块的群乘积条件。
- 完整考虑不同周期及反射类型。
- 巧妙利用 S₃ 群表示论与矩阵快速幂,提高计算效率。
- 数学方法与标准答案不同,但核心推导正确。
3. 验证与可靠性
- 提供完整 Python 求解程序及数学证明。
- 对 N=2~10 进行了小规模交叉验证。
- 使用三套模数进行大规模计算一致性检查。
- 个别证明表述不够严谨,扣除2分。
- 尚未独立重新执行完整计算。
4. 性能表现
- 完整解题耗时:约3小时25分钟。
- 最终求解程序运行:约28秒。
- 经历7处程序错误调试,最终得到正确答案。
5. 综合评价
这是一份高质量的数学与计算综合解答。
模型不仅成功获得正确答案,还独立构造了不同于标准解法的计算路径,表现出较强的数学推理、算法设计、代码实现和错误修正能力。
最终评价:98/100(A+)。在本次高难度数学计算测试中表现优秀。
-
3090Ti+96GRAM+Xeon E5-2680 v4+DSH+qwen3.8-flash-next-iq3_s+128K上下文,完成测试,用量 4.6M tok、用时 25分10秒。
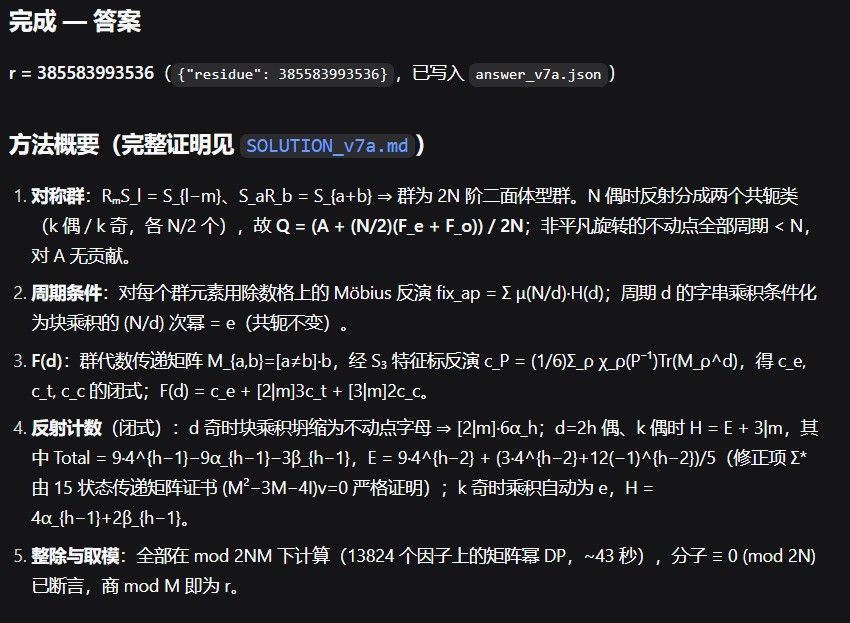
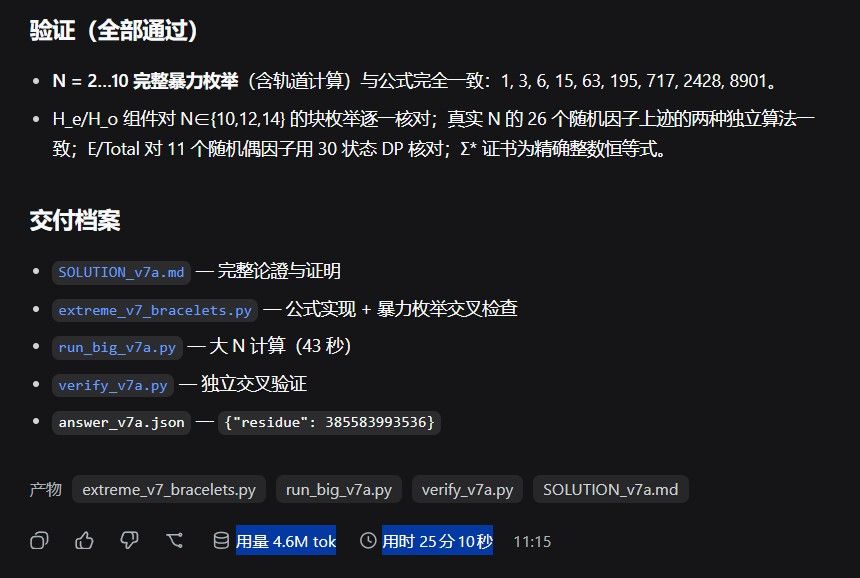
-
-
-
-
-
我觉得一开始模型是否能找到合适的方向,以及之前Agent是否有类似的经验.
如果方向对了,或者Agent已经有了相关skill,那应该能大大提速.
我是用的Hermes,它绝大部分时间都在自我纠错.
-
补一组本地测试结果:SC117-Qwen3.8-Flash-Next-IQ3_S + Strata + Codex Desktop,单张 RTX 5080。
这次比较特别:中途已经算出标准答案,但最终提交时把 modulus 从 10^12 改成了 10^9,所以按最终交付判定未通关。 下面区分原始结果和事后复核,不把复核后的修正算成模型原本答对。
测试环境
项目 配置 Model SC117-Qwen3.8-Flash-Next-IQ3_S Agent Codex Desktop;本机 App version 26.1007.2314.0 Agent core 本次 session 记录的 Codex CLI 0.162.0-alpha.17.2 Inference runtime Strata 0.1.43.1 Reasoning effort high CPU AMD Ryzen 7 9700X,8 cores / 16 threads GPU NVIDIA GeForce RTX 5080,16 GB VRAM,单卡 RAM 64 GB,2 × 32 GB Kingston DDR5-6000 Motherboard MSI MAG B850M MORTAR WIFI OS Windows 11 Pro for Workstations Context Strata 128K(131,072 tokens);Agent session 报告可用 context 124,518 tokens Tools 允许编写和运行 Python,属于 Agent + tools 测试 Model 名称由测试者确认;硬件、App/runtime version 在评分时从本机读取,Agent core、effort 和可用 context 来自原始 session log。
耗时和 token 用量
测试日期为 2026-10-13,以下时间均为 UTC+8。
指标 本次结果 开始 → 最终回复 20:20:45 → 22:47:53 总耗时(wall time) 约 2 小时 27 分 8 秒 首次计算出正确数值 21:11:47,开始后约 51 分 2 秒 Model requests 223 Input tokens,包含 cached input 16,320,789 其中 cached input 14,903,261 未缓存 input 1,417,528 Output tokens,包含 reasoning 559,835 其中 reasoning tokens 426,054,约占 output 的 76.1% Input + output 总量 16,880,624,约 16.88M 平均 decode 速度 77.2 tok/s(Strata monitor 显示值) 全程 output / wall time 63.4 tok/s(包含 prefill、tools 和其他等待) Context compaction 9 次 统计取自这一个 chat 的 223 条 token usage records,逐条求和与最终累计值一致,也与测试时的 Strata monitor 截图总量对上。Cached input 已包含在 input 中,不能再加一次;reasoning 也已包含在 output 中。16.88M 是多轮累计处理量,不是一次装入 context 的长度。
答案与评分
- 标准答案:
385583993536 - 原始最终提交:
583993536 - 最终代码和证明使用:
M = 10^9,原题要求:M = 10^12 - 严格按最终答案 exact match:0/1,本次单题正确率 0%,未通关。 这不是对该 model 整体能力的正确率估计。
- 按方法、实现和证明给予 partial credit:85/100,非官方主观评分。
Partial-credit rubric:group action / Burnside 15/15;Möbius 与 product 条件 18/20;transfer / character 与 reflection 推导 22/25;精确 modular arithmetic 与可执行算法 15/15;可复现计算与数值检查 15/15;原题要求的最终答案 0/10。
主要计数方法是成立的:正确处理了 h^k=e 的 block product 条件、两类 reflection、奇数 block length,以及先取模 2NM 再整除 2N。证明文字仍有几处需要修正,例如 period 子集定义、inverse-reflection 的 adjacency 等价表述,以及把 endpoint adjacency 说成自动成立,因此不能给满分。
评分时未改动原始文件,只把两套最终实现的调用参数在内存中设回 M=10^12,两者都得到 385583993536。这说明最终错误确实与 modulus 参数有关,不是随机猜中了末九位。
另用直接 brute-force enumeration 与两套实现重新核对 N=2…8,结果均为:
1, 3, 6, 15, 63, 195, 717,即 7/7 small cases 通过。144 个 reflection component cases 也全部通过。原交付还记录了 N=9…13,但本次评分没有重跑该范围。为什么耗时这么久?
从记录看,大量时间用于 reasoning、修改代码、独立实现和反复 verification:全程有 166 次 command execution、53 次 file-change 操作。首次得到正确数值后,又继续约 96 分钟才结束;期间后续实现引入了 M=10^9。
所以这里的 2 小时 27 分钟是完整 Agent 作答成本,不是最终 Python 算法单次计算大 N 的耗时,也不能把 51 分钟的“首次正确数值”直接写成“完整通关时间”。77.2 tok/s 是 decode 指标,不能单靠它判断整题完成速度。
本次记录能支持的结论是:这个 model 有能力构造有效计数算法并算出正确数值,但原始最终交付发生了参数错误,最终成绩必须据此判定。
- 标准答案: