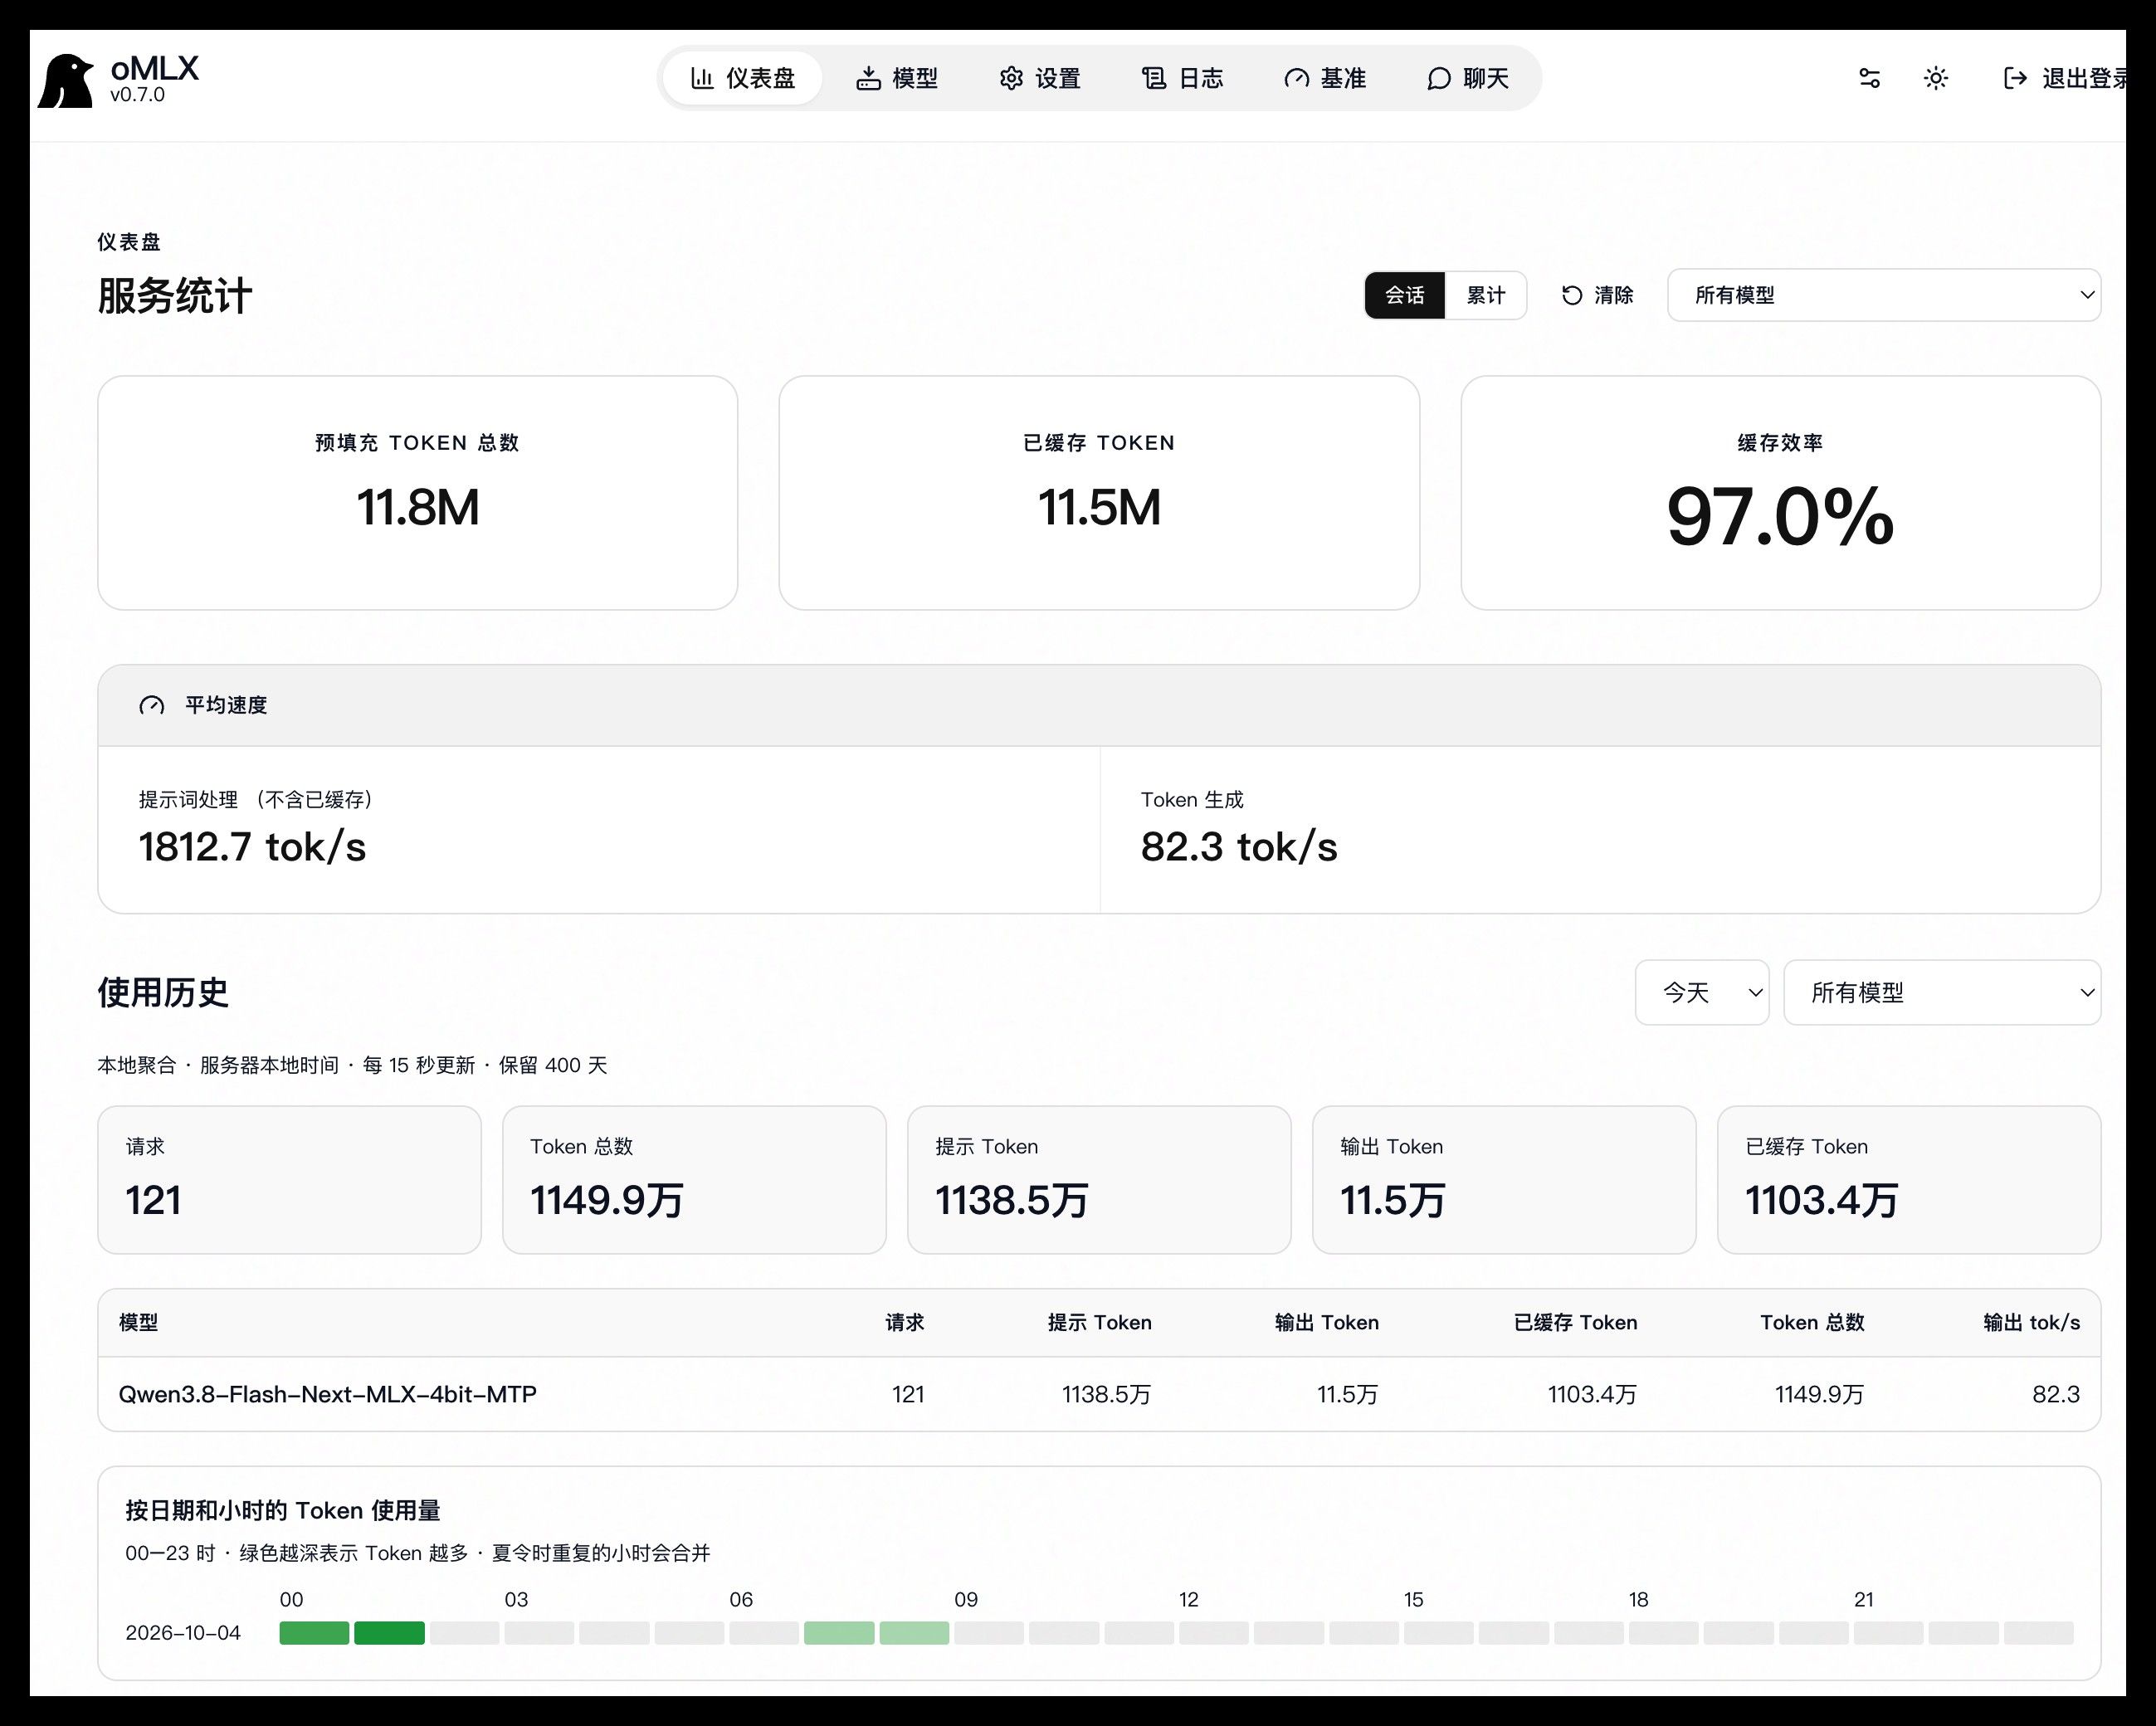
【直播】二次开发R9700单卡用SGLang跑Qwen3.8-27B成功! TTFT0.9s/PP2000/TG100tps(代码)!体验丝滑
-
@dardeaw-feng
所以AI时代即使小众的硬件也能优化出不错的速度,小众生态的表现也会越来越好的。再等个原生的mxfp4内核替换现在的PP速度就能到4000级别了,到那时SGlang在9700上就可以完爆paiton/vLLM方案了,现在还是互有胜负。 -
@dardeaw-feng
所以AI时代即使小众的硬件也能优化出不错的速度,小众生态的表现也会越来越好的。再等个原生的mxfp4内核替换现在的PP速度就能到4000级别了,到那时SGlang在9700上就可以完爆paiton/vLLM方案了,现在还是互有胜负。MAC M5 Ultra 256g 现在也被优化的速度不错了。 有ai帮助都可以慢慢的优化到极致
-
-
-
-
@张光璞
哦,那使用体验也相当不错了,只不过相比价格,性价比不高。如果看中体积的话,那就没办法了,只有迈克。
我的5070ti现在跑起来应该是在一千四五的pp速度,然后生成是在55~60的样子。 -
-
-
-
-
-
-
-
@applejuice
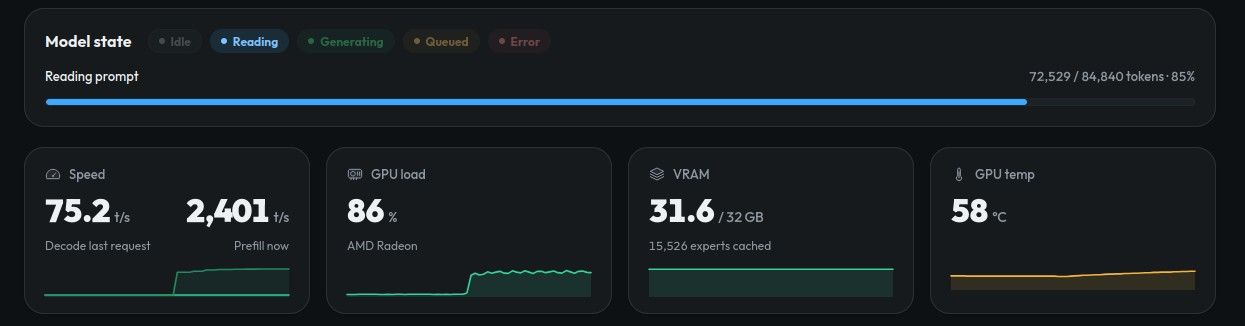
IQ3_XXS,IQ3_S我的RAM太少,我只有32G,我是把整個N-GARM都放在SSD才能跑IQ3_XXS,PP的速度有個地方要優化AI查詢做過的優化,27XX就是個峰值,幾乎都保持在249X~251X之間。
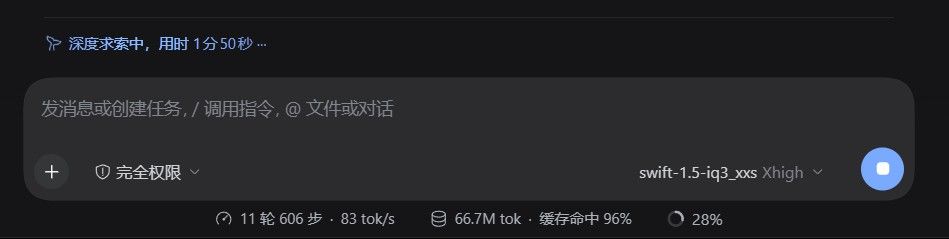
DECODE 50~130之間,DSH上的均值是80左右。已啟用的 prefill 優化(iq3_xxs 與 swift-iq3_xxs 兩個 config 的 env 區塊一致)
- STRATA_HIPBLASLT_TUNING → tools/hip/gfx1201-hipblaslt-100200.txt(34 行 = 32 個 geometry 標頭)— log 實際確認 hipBLASLt tuning enabled (32 rows, gfx1201, version 100200)
- STRATA_HIP_WMMA=1 — log 確認 prompt attention on matrix cores on (gfx1201)
- STRATA_PREFILL_MMQ=1 — prompt experts 走矩陣核心
- STRATA_SELECT_WMMA=1 — prefill-only 路徑選擇(+1.5%)
- STRATA_PF_FUSED=1 — log 確認 prompt experts on the fused int8 kernels (STRATA_PF_FUSED=1, #136)
- STRATA_IO_THREADS=32 — expert 讀取並行
- STRATA_GFX12_CHUNK=0 — 關掉 0.1.43 的 16384 chunk 預設(避免釘住 RAM 導致 OOM)
- engine 0.1.43.1,--prefill auto、--kv int8、--kv-resident 32768、--resident-experts(mlock 被拒,pageable fallback 正常)
未啟用(刻意避開):STRATA_PREFILL_RING=96(A/B 較慢)、STRATA_SH_STREAM、STRATA_STAGE_PIN、STRATA_GDN_CHUNKED(此卡無收益)。
上次實測的冷啟動 prefill 吞吐(serial、無緩存):59.6K tokens → 2,728.8 / 2,758.5 tok/s,比 skill 記錄的 96.6K→1616 參考值高很多(fused 核心 + tuning 表的效果)。decode 約 67-86 tok/s,drafts 接受率 ~80-90%(893/1163 這筆偏低,屬正常波動)
-
看了都想把3090 卖掉
-
@Charly-Cheng
感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。 -
@Charly-Cheng
感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。 -
@Charly-Cheng
感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。 -
@fcme 终于等到了! 所以现在楼主会选SGLANG还是paiton当主力?
@alan.lgv60
Paiton, 因为我用了一段我的那个方案,那个响应确实是快,但是跑起长一点的任务来讲,还是整体上要慢一些。等有人做出像paiton的这么牛逼的kernal以后再移植过去的话,就可以全面超越原版Paiton并秒杀毛坯SGlang了。 -
@alan.lgv60
Paiton, 因为我用了一段我的那个方案,那个响应确实是快,但是跑起长一点的任务来讲,还是整体上要慢一些。等有人做出像paiton的这么牛逼的kernal以后再移植过去的话,就可以全面超越原版Paiton并秒杀毛坯SGlang了。