跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【直播】二次开发R9700单卡用SGLang跑Qwen3.8-27B成功! TTFT0.9s/PP2000/TG100tps(代码)!体验丝滑

【直播】二次开发R9700单卡用SGLang跑Qwen3.8-27B成功! TTFT0.9s/PP2000/TG100tps(代码)!体验丝滑

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
r9700sg-langqwen-27b
65 帖子 12 发布者 2.5k 浏览 5 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • paul houP
    paul houP
    paul hou
    体面乡绅 硕果累累
    编写于 最后由 paul hou 编辑
    #50

    現在都是用QFN了,QFN = D80,P2500 ,27B = D105,P3500,這點效能差距還是能接受的。

    fcmeF 1 条回复 最后回复
    0
    • paul houP paul hou

      現在都是用QFN了,QFN = D80,P2500 ,27B = D105,P3500,這點效能差距還是能接受的。

      fcmeF
      fcmeF
      fcme
      王侯将相
      编写于 最后由 编辑
      #51

      @paul-hou
      这个是用什么框架跑出来的?是用r9700吗?

      https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

      paul houP 1 条回复 最后回复
      0
      • fcmeF fcme

        @paul-hou
        这个是用什么框架跑出来的?是用r9700吗?

        paul houP
        paul houP
        paul hou
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #52

        @fcme

        我寫反了,就是VLLM和STRATA而已,都是單片R9700。

        A 1 条回复 最后回复
        0
        • paul houP paul hou

          @fcme

          我寫反了,就是VLLM和STRATA而已,都是單片R9700。

          A
          A
          applejuice
          王侯将相
          编写于 最后由 编辑
          #53

          @paul-hou 说:

          @fcme

          我寫反了,就是VLLM和STRATA而已,都是單片R9700。

          xxs? 还是s?
          你的prefill 是我的2.5倍

          paul houP 1 条回复 最后回复
          0
          • A applejuice

            @paul-hou 说:

            @fcme

            我寫反了,就是VLLM和STRATA而已,都是單片R9700。

            xxs? 还是s?
            你的prefill 是我的2.5倍

            paul houP
            paul houP
            paul hou
            体面乡绅 硕果累累
            编写于 最后由 paul hou 编辑
            #54

            @applejuice
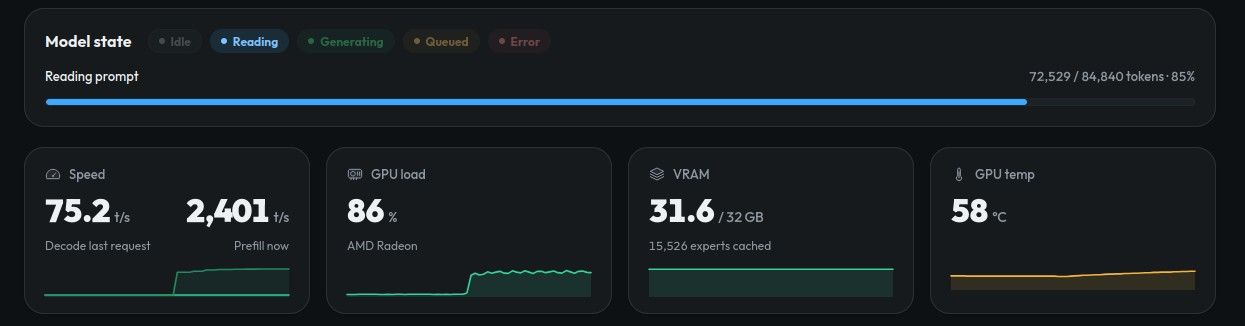
            IQ3_XXS,IQ3_S我的RAM太少,我只有32G,我是把整個N-GARM都放在SSD才能跑IQ3_XXS,PP的速度有個地方要優化

            AI查詢做過的優化,27XX就是個峰值,幾乎都保持在249X~251X之間。
            DECODE 50~130之間,DSH上的均值是80左右。

            已啟用的 prefill 優化(iq3_xxs 與 swift-iq3_xxs 兩個 config 的 env 區塊一致)

            • STRATA_HIPBLASLT_TUNING → tools/hip/gfx1201-hipblaslt-100200.txt(34 行 = 32 個 geometry 標頭)— log 實際確認 hipBLASLt tuning enabled (32 rows, gfx1201, version 100200)
            • STRATA_HIP_WMMA=1 — log 確認 prompt attention on matrix cores on (gfx1201)
            • STRATA_PREFILL_MMQ=1 — prompt experts 走矩陣核心
            • STRATA_SELECT_WMMA=1 — prefill-only 路徑選擇(+1.5%)
            • STRATA_PF_FUSED=1 — log 確認 prompt experts on the fused int8 kernels (STRATA_PF_FUSED=1, #136)
            • STRATA_IO_THREADS=32 — expert 讀取並行
            • STRATA_GFX12_CHUNK=0 — 關掉 0.1.43 的 16384 chunk 預設(避免釘住 RAM 導致 OOM)
            • engine 0.1.43.1,--prefill auto、--kv int8、--kv-resident 32768、--resident-experts(mlock 被拒,pageable fallback 正常)

            未啟用(刻意避開):STRATA_PREFILL_RING=96(A/B 較慢)、STRATA_SH_STREAM、STRATA_STAGE_PIN、STRATA_GDN_CHUNKED(此卡無收益)。

            上次實測的冷啟動 prefill 吞吐(serial、無緩存):59.6K tokens → 2,728.8 / 2,758.5 tok/s,比 skill 記錄的 96.6K→1616 參考值高很多(fused 核心 + tuning 表的效果)。decode 約 67-86 tok/s,drafts 接受率 ~80-90%(893/1163 這筆偏低,屬正常波動)
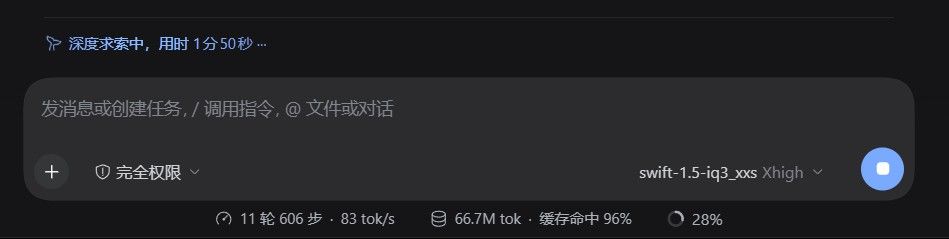
            image.jpeg
            image.jpeg

            1 条回复 最后回复
            0
            • A
              A
              applejuice
              王侯将相
              编写于 最后由 编辑
              #55

              看了都想把3090 卖掉

              1 条回复 最后回复
              0
              • Charly ChengC Charly Cheng

                @fcme 说:

                @terry
                会的,弄好了我也git一下,回馈社群!

                看你的帖子,我讓27B部署不起來。天天來看下,等你等你發帖。

                fcmeF
                fcmeF
                fcme
                王侯将相
                编写于 最后由 编辑
                #56

                @Charly-Cheng
                感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。

                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                paul houP alan.lgv60A Charly ChengC 3 条回复 最后回复
                1
                • fcmeF fcme

                  @Charly-Cheng
                  感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。

                  paul houP
                  paul houP
                  paul hou
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #57

                  @fcme
                  感謝分享,裝來試試看。

                  1 条回复 最后回复
                  1
                  • fcmeF fcme

                    @Charly-Cheng
                    感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。

                    alan.lgv60A
                    alan.lgv60A
                    alan.lgv60
                    编写于 最后由 编辑
                    #58

                    @fcme 终于等到了! 所以现在楼主会选SGLANG还是paiton当主力?

                    fcmeF 1 条回复 最后回复
                    0
                    • alan.lgv60A alan.lgv60

                      @fcme 终于等到了! 所以现在楼主会选SGLANG还是paiton当主力?

                      fcmeF
                      fcmeF
                      fcme
                      王侯将相
                      编写于 最后由 编辑
                      #59

                      @alan.lgv60
                      Paiton, 因为我用了一段我的那个方案,那个响应确实是快,但是跑起长一点的任务来讲,还是整体上要慢一些。等有人做出像paiton的这么牛逼的kernal以后再移植过去的话,就可以全面超越原版Paiton并秒杀毛坯SGlang了。

                      https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                      alan.lgv60A 1 条回复 最后回复
                      0
                      • fcmeF fcme

                        @alan.lgv60
                        Paiton, 因为我用了一段我的那个方案,那个响应确实是快,但是跑起长一点的任务来讲,还是整体上要慢一些。等有人做出像paiton的这么牛逼的kernal以后再移植过去的话,就可以全面超越原版Paiton并秒杀毛坯SGlang了。

                        alan.lgv60A
                        alan.lgv60A
                        alan.lgv60
                        编写于 最后由 编辑
                        #60

                        @fcme 那我要等抄作业!
                        但老实说,现时的 Paiton 已经很好了。

                        fcmeF 1 条回复 最后回复
                        0
                        • alan.lgv60A alan.lgv60

                          @fcme 那我要等抄作业!
                          但老实说,现时的 Paiton 已经很好了。

                          fcmeF
                          fcmeF
                          fcme
                          王侯将相
                          编写于 最后由 编辑
                          #61

                          @alan.lgv60
                          对,我现在是R9700跑27B,5070ti配合大内存跑flash next 也能到2100/80左右,其实个人使用也够了。
                          后续换工作了使用强度高了就搞双卡R9700,顶到8000/215就爽歪歪了。

                          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                          terryT 1 条回复 最后回复
                          0
                          • fcmeF fcme

                            @alan.lgv60
                            对,我现在是R9700跑27B,5070ti配合大内存跑flash next 也能到2100/80左右,其实个人使用也够了。
                            后续换工作了使用强度高了就搞双卡R9700,顶到8000/215就爽歪歪了。

                            terryT
                            terryT
                            terry
                            易有太极
                            编写于 最后由 terry 编辑
                            #62

                            @fcme

                            https://lcz.me/projects/local/amd-r9700-sglang-maxx
                            放这个,论坛给你做了个专页,😂

                            油管:https://www.youtube.com/@抡锤者

                            fcmeF 1 条回复 最后回复
                            0
                            • terryT terry

                              @fcme

                              https://lcz.me/projects/local/amd-r9700-sglang-maxx
                              放这个,论坛给你做了个专页,😂

                              fcmeF
                              fcmeF
                              fcme
                              王侯将相
                              编写于 最后由 编辑
                              #63

                              @terry
                              哎呦,受宠若惊!
                              因为中间引用了很多第三方的工作成果,所以说这个某种程度上不是一个完整的库,只是一个给各位的AI agent的一个执行说明书。

                              https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                              1 条回复 最后回复
                              0
                              • fcmeF fcme

                                @Charly-Cheng
                                感谢捧场,看我的签名档吧,已经发布了,希望你可以顺利复现。

                                Charly ChengC
                                Charly ChengC
                                Charly Cheng
                                编写于 最后由 Charly Cheng 编辑
                                #64

                                @fcme

                                終於完成。也稍微了解你的波折。
                                拿到專案之後,我發給hermes使用千問27b的模型,繼續未完成的部署,然後就跑去睡了一覺,早上起來想說睡一覺,應該部署好吧。結果確實是部署成功了,但是因為模型生成的階段會生成亂碼,所以還持續的不斷在除錯,無止境的除錯,最後我忍不住把它關了,整個大約跑了將近12小時除錯100多個版本,還無法解決生成亂碼的問題。
                                我將strata的專案升級到0.1.44.1版本,使用Q4KXL模型,繼續除錯部署。大約花了5小時。終於除錯完成可以正常生成。接下來下指令,打開投機解碼,啟動hicache 。結果如下:

                                📋 進度回報

                                ✅ 投機解碼 — 已啟用並驗證

                                • DFLASH + DFlash2 draft(5 層 BF16)
                                • 踩到一個新坑並解決:draft 預設繼承 target 的 r4d_mxfp4 量化 → draft 權重載入鏈同樣錯亂 → warmup 直接 GPU 硬體異常(HSA 0x1016)崩潰。解法:--speculative-draft-model-quantization unquant(repo 生產配方是 AWQ target 所以沒踩到,我們是 MXFP4 target 才會觸發)
                                • 實測:accept len 2.4~4.3、decode 37~64 tok/s(無投機時 26.5 → 增益 ~1.4-2.4×)
                                • 正確性:17×23=391 ✅

                                ❌ HiCache — 確定無法啟用(ROCm 缺 kernel)
                                三層根因,全部實測:

                                1. kernel io-backend:需要 sgl_kernel.get_device_accessible_ptr(HIP 的 host 指標 ≠ device 指標,CUDA UVA 不需要)— 映像內 sgl-kernel 沒編這個符號,重編需 AOT ROCm 工具鏈
                                2. 我用 ctypes hipHostGetDevicePointer 補上後,init 通過(host pool 8.91GB 分配成功、hicache_attached=True)→ 執行期仍 HSA 崩潰:transfer_kv_direct 的 pinned-memory DMA 路徑在 RDNA4 上壞(SGLANG_RDNA4_DISABLE_STORE_CACHE=1 就是上游已知 store-cache bug 的標記)
                                3. direct io-backend 也一樣崩

                                結論:HiCache 在此 RDNA4 堆疊不可用,已從 compose 註解移除。 這是引擎/驅動層限制,非配置問題。

                                ⚠️ 代價:KV pool 縮水(投機解碼的 trade-off)
                                無投機
                                • KV pool: 301,936 tokens

                                DFLASH + BF16 draft
                                • KV pool: 79,008 tokens(draft 權重 1.48GB + 雙份 KV pool 擠壓)

                                邊界測試已按 79K 重新排程掃描點(40K/60K/70K/76K/79K/82K/90K),跑完後接 100K+ 多輪長鏈測試 — 但先講清楚:若你要 100K+ 生產上下文,投機解碼和長上下文在單卡上互斥,到時用數據決定取捨。


                                結論:目前r9700。

                                1. 使用vllm-radiance 推理引擎跑qwen 3.8-27b, 速度與穩定度都不錯,上下文邊界能有180k,跑長鏈任務,沒有衰退問題。
                                2. Paiton 9月底 200k 版本,上下文召回率,穩定只能到128k,再大的上下文就容易不穩定,簡單的意思來說,就是超過128k的上下文,邏輯比較會跑偏,長鏈任務感覺有衰減,不知是否是錯覺,感覺沒有vllm-radiance穩定順暢。
                                3. Paiton 10月初版本,還沒測試,聽說可以併發,速度還不錯,但是要降智3%。現在都在想辦法提升智力,正在測試Strata,之後有興趣再來測試。
                                  4.sglan 能開hicache 之後再來折騰。
                                fcmeF 1 条回复 最后回复
                                1
                                • Charly ChengC Charly Cheng

                                  @fcme

                                  終於完成。也稍微了解你的波折。
                                  拿到專案之後,我發給hermes使用千問27b的模型,繼續未完成的部署,然後就跑去睡了一覺,早上起來想說睡一覺,應該部署好吧。結果確實是部署成功了,但是因為模型生成的階段會生成亂碼,所以還持續的不斷在除錯,無止境的除錯,最後我忍不住把它關了,整個大約跑了將近12小時除錯100多個版本,還無法解決生成亂碼的問題。
                                  我將strata的專案升級到0.1.44.1版本,使用Q4KXL模型,繼續除錯部署。大約花了5小時。終於除錯完成可以正常生成。接下來下指令,打開投機解碼,啟動hicache 。結果如下:

                                  📋 進度回報

                                  ✅ 投機解碼 — 已啟用並驗證

                                  • DFLASH + DFlash2 draft(5 層 BF16)
                                  • 踩到一個新坑並解決:draft 預設繼承 target 的 r4d_mxfp4 量化 → draft 權重載入鏈同樣錯亂 → warmup 直接 GPU 硬體異常(HSA 0x1016)崩潰。解法:--speculative-draft-model-quantization unquant(repo 生產配方是 AWQ target 所以沒踩到,我們是 MXFP4 target 才會觸發)
                                  • 實測:accept len 2.4~4.3、decode 37~64 tok/s(無投機時 26.5 → 增益 ~1.4-2.4×)
                                  • 正確性:17×23=391 ✅

                                  ❌ HiCache — 確定無法啟用(ROCm 缺 kernel)
                                  三層根因,全部實測:

                                  1. kernel io-backend:需要 sgl_kernel.get_device_accessible_ptr(HIP 的 host 指標 ≠ device 指標,CUDA UVA 不需要)— 映像內 sgl-kernel 沒編這個符號,重編需 AOT ROCm 工具鏈
                                  2. 我用 ctypes hipHostGetDevicePointer 補上後,init 通過(host pool 8.91GB 分配成功、hicache_attached=True)→ 執行期仍 HSA 崩潰:transfer_kv_direct 的 pinned-memory DMA 路徑在 RDNA4 上壞(SGLANG_RDNA4_DISABLE_STORE_CACHE=1 就是上游已知 store-cache bug 的標記)
                                  3. direct io-backend 也一樣崩

                                  結論:HiCache 在此 RDNA4 堆疊不可用,已從 compose 註解移除。 這是引擎/驅動層限制,非配置問題。

                                  ⚠️ 代價:KV pool 縮水(投機解碼的 trade-off)
                                  無投機
                                  • KV pool: 301,936 tokens

                                  DFLASH + BF16 draft
                                  • KV pool: 79,008 tokens(draft 權重 1.48GB + 雙份 KV pool 擠壓)

                                  邊界測試已按 79K 重新排程掃描點(40K/60K/70K/76K/79K/82K/90K),跑完後接 100K+ 多輪長鏈測試 — 但先講清楚:若你要 100K+ 生產上下文,投機解碼和長上下文在單卡上互斥,到時用數據決定取捨。


                                  結論:目前r9700。

                                  1. 使用vllm-radiance 推理引擎跑qwen 3.8-27b, 速度與穩定度都不錯,上下文邊界能有180k,跑長鏈任務,沒有衰退問題。
                                  2. Paiton 9月底 200k 版本,上下文召回率,穩定只能到128k,再大的上下文就容易不穩定,簡單的意思來說,就是超過128k的上下文,邏輯比較會跑偏,長鏈任務感覺有衰減,不知是否是錯覺,感覺沒有vllm-radiance穩定順暢。
                                  3. Paiton 10月初版本,還沒測試,聽說可以併發,速度還不錯,但是要降智3%。現在都在想辦法提升智力,正在測試Strata,之後有興趣再來測試。
                                    4.sglan 能開hicache 之後再來折騰。
                                  fcmeF
                                  fcmeF
                                  fcme
                                  王侯将相
                                  编写于 最后由 编辑
                                  #65

                                  @Charly-Cheng
                                  对,我这个里面就没开hicache,我忘了它具体和一个什么冲突来着。这个是纯速度向的调教。因为速度提起来了以后cache就没那么重要了。尤其做连续任务的时候。
                                  我最后用回paiton还是因为它绝对速度是最快的。

                                  https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                  1 条回复 最后回复
                                  0

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组