
-
常用指标与术语
缩写 英文全称 中文解释 主要看什么 PP Prompt Processing 提示词处理 / Prefill 模型处理输入上下文的速度,通常以 tok/s 表示 TG Text Generation 文本生成 / Decode 模型持续生成输出 Token 的速度,通常以 tok/s 表示 TTFT Time To First Token 首 Token 延迟 从发出请求到收到第一个输出 Token 的时间 TPOT Time Per Output Token 平均每个输出 Token 的耗时 反映持续生成阶段的平均延迟,通常以 ms/token 表示 ITL Inter-Token Latency Token 间延迟 相邻流式输出之间的时间间隔,用于观察卡顿和尾延迟 TPS Tokens Per Second 每秒 Token 数 模型每秒生成多少 Token E2E End-to-End Latency 端到端总耗时 从请求发出到完整响应结束的总时间 C1 / C2 / C4 / C8 Concurrency 1 / 2 / 4 / 8 并发数 1 / 2 / 4 / 8 同时存在多少个推理请求 QPS / RPS Queries / Requests Per Second 每秒请求数 Serving 场景下单位时间能处理多少请求 Goodput Goodput 有效吞吐量 在满足延迟或 SLO 要求前提下真正有效完成的吞吐量 VRAM Video Random Access Memory 显存占用 模型、KV Cache 和推理过程占用多少 GPU 显存 简单理解:**PP 看“吃得快不快”,TTFT 看“多久开口”,TG/TPS 看“说得快不快”,ITL 看“会不会卡”,E2E 看“整件事多久做完”。
引言
今年 AI 大爆发,各种新模型、推理框架和新玩法层出不穷。
作为一个非技术专业的 AI 爱好者,我很依赖论坛里的实测数据来减少自己摸索和试错的时间。但看得越多,也越发现一个问题:
大家测速的口径并不统一。
很多时候,如果只看到一句——特别是视频网站里为了吸引眼球的标题:这个模型跑到了150 t/s
但不知道:
- Prefill 还是 Decode?
- Context 多长?
- Output 多长?
- Cache 有没有命中?
- Concurrency 是多少?
这个数字其实很难横向比较。
甚至我自己不同时期测出来的数据,Agent 都会时不时提醒我:
测试口径不同,不能直接横向比较。
于是我认真找了一圈现成方案,发现 GitHub 上其实已经有几套相当成熟的 测速Benchmark。
所以我的想法变成了:
完全没必要自己重新发明一套“大一统标准”,而应该根据不同测试目的,直接引用成熟工具。
结论先行
先看自己想测什么,再选择对应 Benchmark。
测 GPU / 量化 / Kernel 裸性能
→ llama.cpp / llama-bench

测 OpenAI API / 实际聊天体验
→ GuideLLM

测多并发 / Serving / 饱和点
→ Kubernetes SIG inference-perf

测最终客户端体验
→ MLPerf Client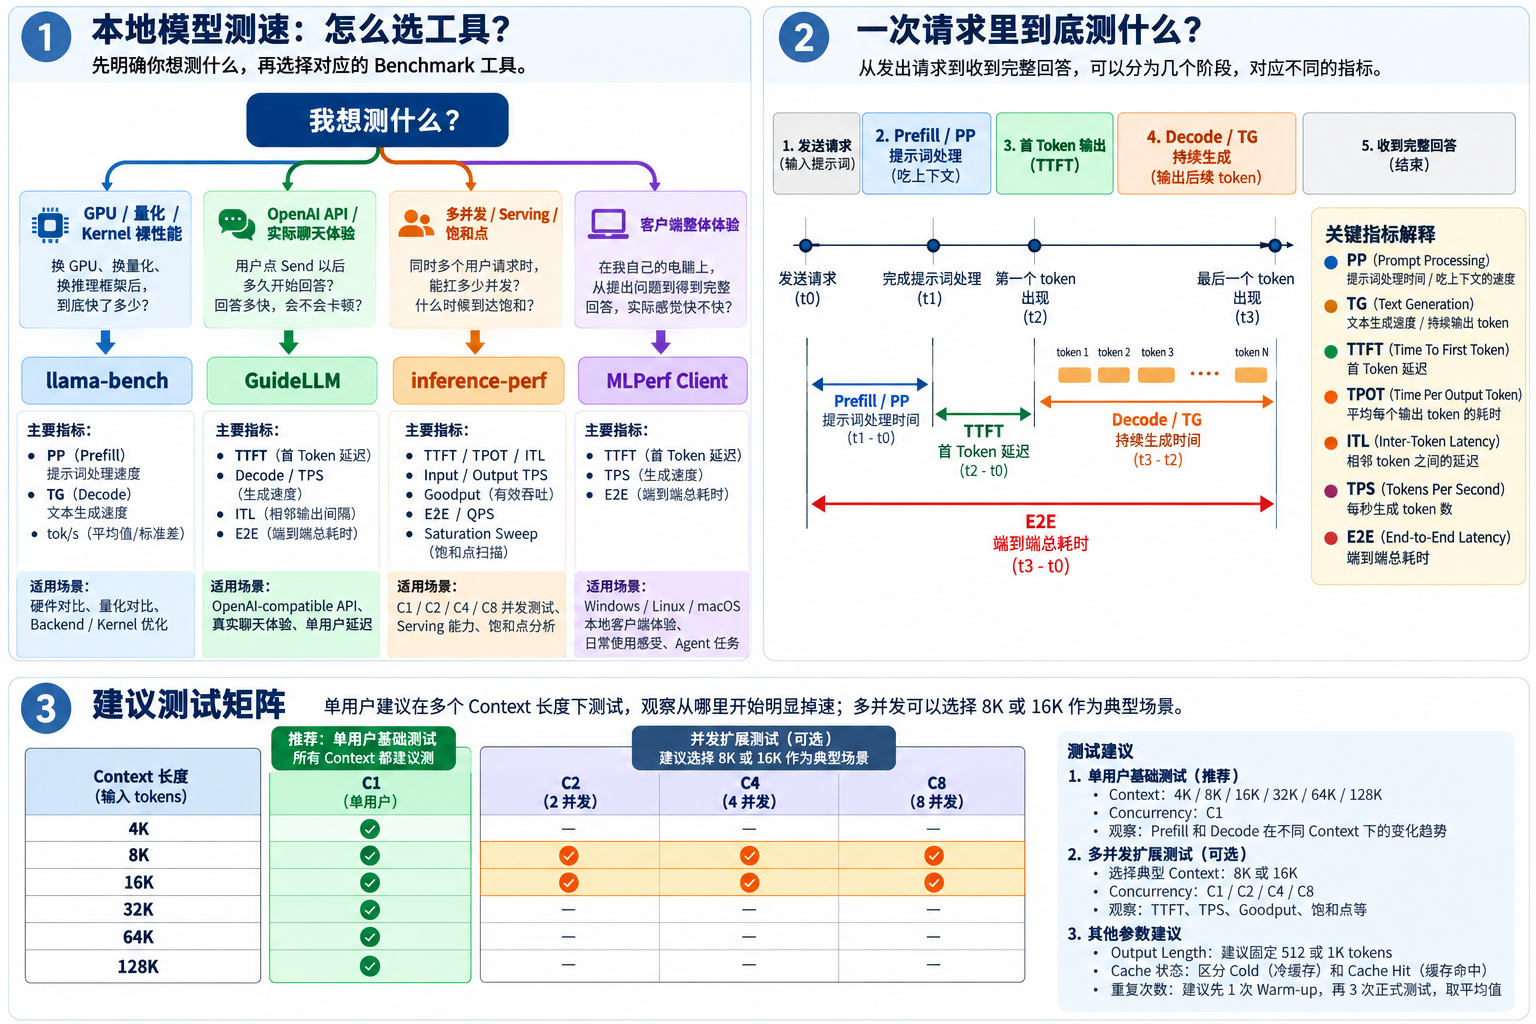
1. 裸性能:llama-bench
llama.cpp官方的llama-bench,本身就明确区分:- PP:Prompt Processing
- TG:Text Generation
支持指定 Context Depth、重复测试,并报告平均 tok/s 和标准差;默认每项重复 5 次。官方还明确说明,它不把 tokenization 和 sampling 时间计入测试。
GitHub:
llama.cpp / llama-benchhttps://github.com/ggml-org/llama.cpp/tree/master/tools/llama-bench
所以如果只是想知道:
换了 GPU、量化、Backend、Kernel 后,到底快了多少?
我觉得直接用
llama-bench最合适。报告范例
Context PP / Prefill TG / Decode VRAM 4K 3,250 tok/s 101.2 tok/s 40.8GB 8K 3,180 tok/s 100.1 tok/s 41.3GB 16K 3,020 tok/s 98.7 tok/s 42.2GB 32K 2,850 tok/s 96.4 tok/s 44.2GB 64K 2,510 tok/s 91.8 tok/s 46.0GB 128K 2,020 tok/s 82.5 tok/s 47.1GB 测试环境:
项目 设置 模型 Qwen3.8-27B 量化 Q4_K_M 推理框架 llama.cpp GPU RX 7900 XTX 24GB ×2 CPU Ryzen 5 9600X 内存 64GB Backend ROCm Output 512 tokens 重复次数 5
2. API / 实际使用:GuideLLM
GuideLLM 是 vLLM 项目下的独立 Benchmark 工具,主要面向真实 LLM Deployment 测试,支持不同 Backend、Dataset、Metrics 和输出格式。
GitHub:
GuideLLMhttps://github.com/vllm-project/guidellm
这类测试更适合看:
TTFT
Decode / TPS
TPOT
ITL
E2E
也就是:
用户点 Send 以后多久开始回答、回答多快、会不会卡顿。
报告范例
Context TTFT Decode / TPS TPOT ITL P50 ITL P99 E2E VRAM 4K 0.21s 121 tok/s 8.3ms 8.1ms 12.4ms 4.5s 41.0GB 8K 0.34s 120 tok/s 8.3ms 8.2ms 13.1ms 4.7s 41.8GB 16K 0.84s 118 tok/s 8.5ms 8.3ms 14.7ms 5.2s 43.0GB 32K 1.61s 113 tok/s 8.8ms 8.7ms 17.9ms 6.1s 44.7GB 64K 3.42s 104 tok/s 9.6ms 9.4ms 23.8ms 8.4s 46.1GB 128K 7.10s 91 tok/s 11.0ms 10.7ms 35.2ms 13.0s 47.3GB 测试条件:
项目 设置 Output Length 512 tokens Concurrency C1 Requests 10 / 档 Warm-up 1 Cache Cold API OpenAI-compatible
3. 多并发 / Serving:inference-perf
Kubernetes SIG 的
inference-perf更进一步,本身就是为了标准化推理 Benchmark 工具和指标。它直接支持:
TTFT
TPOT
ITL
Input / Output TPS
Goodput
并发 / QPS
Saturation Sweep
并支持 vLLM、SGLang、TGI 和 OpenAI-compatible Endpoint。
GitHub:
Kubernetes SIG / inference-perfhttps://github.com/kubernetes-sigs/inference-perf
如果测:
C1 / C2 / C4 / C8或者想知道一台机器到底能扛多少并发,我觉得直接用这个更合适。
报告范例
固定一个典型 Context,例如 8K 或 16K:
Concurrency TTFT Output TPS TPOT ITL P99 Goodput 备注 C1 0.42s 121 8.3ms 13ms 100% 正常 C2 0.51s 214 9.4ms 17ms 100% 正常 C4 0.93s 318 12.6ms 31ms 96% 基本稳定 C8 2.70s 352 22.8ms 86ms 71% 明显排队 测试条件:
项目 设置 Context 8K Output 512 tokens Cache Cold Test Duration 60s / 档 推理引擎 vLLM GPU RX 7900 XTX ×2 测试结论:
项目 结果 推荐稳定并发 C4 饱和区间 C4–C8 最大吞吐 352 output tok/s 明显排队开始 C8
4. 最终用户体验:MLPerf Client
MLPerf Client 是 MLCommons 面向个人电脑和客户端 AI 推理的 Benchmark,支持 Windows、Linux、macOS,也覆盖 LLM、本地硬件和不同 Execution Backend 的测试。
GitHub:
MLPerf Clienthttps://github.com/mlcommons/mlperf_client
这类测试更接近:
最终用户实际感觉到底快不快。
报告范例
项目 结果 设备 Desktop PC 操作系统 Windows 11 CPU Ryzen 5 9600X GPU RX 7900 XTX 内存 64GB Backend / Execution Provider 本地执行 Warm-up 1 Iterations 5 TTFT 0.61s TPS 82.7 tok/s E2E 7.1s 峰值 VRAM 22.6GB
那论坛大家发帖分享什么?
我个人的想法是,不管用了哪一种 Benchmark,至少把下面这些信息写出来:
类别 项目 硬件 GPU / CPU / 内存 / 主板 模型 模型名 / 量化 / 推理引擎 测试条件 Context / Output Length / Concurrency / Cache 状态 结果 Prefill / TTFT / Decode / VRAM 如果用了 MTP / Speculative Decoding,再加:
项目 结果 Acceptance Rate Accepted Tokens
Context 建议
单用户测试,我比较倾向:
4K / 8K / 16K / 32K / 64K / 128K这样不仅能看到“最高速度”,还能观察:
Context 从哪里开始明显掉速。
并发则不一定每个 Context 都跑,可以单独选一个典型 Context,比如 8K 或 16K:
C1 / C2 / C4 / C8
摘要表
无论用哪套 Benchmark,一张摘要应该是大家喜闻乐见的:
模型 Quant Engine GPU Context Output C Cache Prefill TTFT Decode VRAM Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 4K 512 C1 Cold 3,250 t/s 0.22s 122 t/s 41GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 8K 512 C1 Cold 3,180 t/s 0.35s 121 t/s 42GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 16K 512 C1 Cold 2,900 t/s 0.84s 118 t/s 43GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 32K 512 C1 Cold 2,730 t/s 1.62s 113 t/s 45GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 64K 512 C1 Cold 2,410 t/s 3.41s 104 t/s 46GB Qwen3.8-27B W8A8 SGLang 7900 XTX ×2 128K 512 C1 Cold 1,980 t/s 7.08s 91 t/s 47GB 这样即使后面的完整报告格式不同,最关键的数据仍然可以快速横向比较。
总之
本地模型测速可以不需要重新发明 Benchmark。更合理的做法,是根据不同场景和需求直接引用成熟工具,再用大家喜闻乐见的基本格式分享成果。
具体怎么跑,请参见附件:
《本地模型测速一键执行指南》
本地模型测速一键执行指南_SOP完整版_2026-10-13.md
其中分别提供:
llama-bench
GuideLLM
inference-perf
MLPerf Client
的一键复制 Agent Prompt 和测试模板,其中也结合了本人在实际测试中的一些经验教训。。
友情提示:网络下载任何文件,请注意安全。
本文仅分享一些个人对本地模型测速的思考,暂不涉及模型质量评测部分。抛砖引玉,欢迎大家补充、指正和交流。
2026-10-13
-
,
 T terry 固定了此主题
-
,T terry 将此主题从 AI Agent 移至此处
-
-
-
- 这两个文件都是 UTF8, 无BOM. 下载下来一般的文本编辑器都可以正确读取.
- 点击在浏览器里显示, 我的Chrome也是乱码, 这个是http头的响应问题, 浏览器没有正确识别到编码.
- 这和我们浏览器的缺省编码设置也有关系, 我的safari一开始也是乱码, 后来我把缺省编码改为 UTF-8, safari 显示就正常了. 不过 chrome 好像没有这个选项.
@terry 以下是AI 总结:
【问题反馈】upload.lcz.me 上的 .md 文件,浏览器直接打开是乱码
现象
用 Chrome 直接打开https://upload.lcz.me/uploads/d6f7505a-4080-4b9f-aa32-6f7a9a786ed5.md这类 .md 文件,中文全部显示成乱码。排查
- 文件本身是正常的 UTF-8(无 BOM),下载到本地用文本编辑器打开中文完全正常;
- 但服务端返回的响应头是
Content-Type: text/markdown,没有带; charset=utf-8; - “没有 BOM + 没有 charset 声明”,浏览器只能去猜编码,猜错(如按 GBK)就乱码。
建议修复
把该类文件的响应头改成:Content-Type: text/markdown; charset=utf-8(或
text/plain; charset=utf-8)这样所有浏览器都会明确按 UTF-8 解码,彻底解决乱码,不用用户手动处理文件。
临时规避(用户侧):把文件保存为“UTF-8 带 BOM”也能让浏览器正确识别,但这只是绕开,服务端加上 charset 才是根治。
-
【补充对比】lcz.me 正常响应头都带 charset,只有上传存储里的文件缺
来源 Content-Type 带 charset? lcz.me论坛主页(NodeBB)text/html; charset=utf-8
upload.lcz.me/根 404 页(Cloudflare)text/plain;charset=UTF-8upload.lcz.me/uploads/xxx.md(上传文件)text/markdown
这是典型的 Cloudflare R2 / S3 对象存储直发文件特征:按扩展名推断出
text/markdown,但不会自动补charset。整站正常页面都带 charset,唯独上传存储里的文件缺,是这一层的配置缺口。建议修复(任选其一):
- 上传 .md 等文本类文件时显式设置
Content-Type: text/markdown; charset=utf-8(或text/plain; charset=utf-8); - 在 Cloudflare 对
upload.lcz.me的text/*响应加一条 Transform 规则,统一补上; charset=utf-8。
- 上传 .md 等文本类文件时显式设置
-
【补充对比】lcz.me 正常响应头都带 charset,只有上传存储里的文件缺
来源 Content-Type 带 charset? lcz.me论坛主页(NodeBB)text/html; charset=utf-8upload.lcz.me/根 404 页(Cloudflare)text/plain;charset=UTF-8upload.lcz.me/uploads/xxx.md(上传文件)text/markdown这是典型的 Cloudflare R2 / S3 对象存储直发文件特征:按扩展名推断出
text/markdown,但不会自动补charset。整站正常页面都带 charset,唯独上传存储里的文件缺,是这一层的配置缺口。建议修复(任选其一):
- 上传 .md 等文本类文件时显式设置
Content-Type: text/markdown; charset=utf-8(或text/plain; charset=utf-8); - 在 Cloudflare 对
upload.lcz.me的text/*响应加一条 Transform 规则,统一补上; charset=utf-8。
- 上传 .md 等文本类文件时显式设置
-
-
-
- 这两个文件都是 UTF8, 无BOM. 下载下来一般的文本编辑器都可以正确读取.
- 点击在浏览器里显示, 我的Chrome也是乱码, 这个是http头的响应问题, 浏览器没有正确识别到编码.
- 这和我们浏览器的缺省编码设置也有关系, 我的safari一开始也是乱码, 后来我把缺省编码改为 UTF-8, safari 显示就正常了. 不过 chrome 好像没有这个选项.
@terry 以下是AI 总结:
【问题反馈】upload.lcz.me 上的 .md 文件,浏览器直接打开是乱码
现象
用 Chrome 直接打开https://upload.lcz.me/uploads/d6f7505a-4080-4b9f-aa32-6f7a9a786ed5.md这类 .md 文件,中文全部显示成乱码。排查
- 文件本身是正常的 UTF-8(无 BOM),下载到本地用文本编辑器打开中文完全正常;
- 但服务端返回的响应头是
Content-Type: text/markdown,没有带; charset=utf-8; - “没有 BOM + 没有 charset 声明”,浏览器只能去猜编码,猜错(如按 GBK)就乱码。
建议修复
把该类文件的响应头改成:Content-Type: text/markdown; charset=utf-8(或
text/plain; charset=utf-8)这样所有浏览器都会明确按 UTF-8 解码,彻底解决乱码,不用用户手动处理文件。
临时规避(用户侧):把文件保存为“UTF-8 带 BOM”也能让浏览器正确识别,但这只是绕开,服务端加上 charset 才是根治。
-
-
-
,系统 取消固定了此主题
-
,
B Ben Lee 引用了 此主题


