
双96GB显存、48GB内存:DeepSeek V4.1 Flash 1017 跑上 Strata,还差哪些 Gap?
-
之前在双 RTX PRO 6000 跑 Qwen3.8-Flash-Next 的帖子里,补充过我为什么选择 Strata:两张卡各有 96GB 显存,但系统内存只有 48GB,两张卡都限制在 300W,主要考虑长期安静开机,不是满功耗刷分。
最近想在同一台机器上尝试 DeepSeek-V4.1-Flash-1017。查了一圈源码后,发现已经有 Strata 的 DeepSeek V4.1 社区分叉,不一定要从零移植。想开个帖子讨论:基于现有实现,距离“双卡、大显存、小 RAM、NVMe 后备”跑好 1017,还剩哪些 Gap?
先说边界:我目前跑通的是 Qwen + Strata,以及之前的 DeepSeek-V4-Flash-0731 + vLLM-Moet;没有在 Strata 系分叉上跑通 V4.1,更没有实测 1017。下面是源码、配置和作者报告整理,不是我的新跑分,也不是一套已经验证可用的配方。

为什么想保留 Strata 这条路线
我在原帖的补充里解释过,Strata 吸引我的不是“完全绕过 RAM”,而是可以用有限的主机缓冲,把专家权重分批搬进 GPU cache;已放进 GPU 的部分,不必再在主机内存里常驻一整份专家副本。
现有 Qwen 配置中,全部 24,576 个专家进了双卡 GPU cache。这是它在我机器上表现不错的重要前提,不能直接推导成更大的 DeepSeek 也会一样快。数据仍要经过主机内存,不是 SSD 直接传显存;RAM budget 也不是整个进程的内存上限。
我的诉求是尽量避免为了加载模型,先准备超大主机内存,或者再生成一套几百 GB 的转换缓存。checkpoint 文件大于 48GB,本身不能证明跑不了;关键是加载峰值、常驻分配和临时转换分别占多少。
已有社区实现,不必从零写整个后端
官方上游 Strata 没有 DeepSeek V4.1 后端,不代表 Strata 生态没有。 目前最值得评估的是这两个项目:
1. Jackwwg83/Strata-DS
项目:Strata-DS,检查版本
a46eeba。已经有独立的 V4.1 计算图和 CUDA kernels、EXL3 专家分层、磁盘 Engram、批量 prefill、DSpark、服务接口,以及相关测试。源码里有显式专家 RAM 预算,允许设为零,不能简单理解成“必须在 CPU 常驻一整份专家权重”。
但还不能原样照搬:
- 作者主要验证的是单卡笔记本;上游 Qwen 支持多卡,不能直接算作这个 DeepSeek 后端已经支持双卡。
- 公开笔记本配方实际占约 54 GiB 主机内存,仍超过我这台机器的可用 RAM。
- 公开速度包含跳过部分低排名专家的有损优化;作者也披露了输出分布变化,尤其中文更明显。不能直接当作严格执行同一量化模型的速度。
- 它仍需要额外生成 pack。文档的安装磁盘预算约为 342GB 下载 + 120GB pack。按张量、专家读取可以控制打包内存,但并没有消除额外磁盘副本。
2. Indras-Mirror/Xolotl
项目:Xolotl,原名 Strata-DSV4.1,检查版本
7375e30。已经有 V4.1 引擎、GSQ 量化工具链、三层专家缓存、磁盘 Engram、DSpark、FP4 KV 和服务适配。量化与正确性检查工具尤其值得参考。
限制也要一起看:作者主要在 4090 + 90GB RAM 上验证,部分配置使用约 60 GiB pinned arena。源码允许限制 arena,但调小后在我这台机器上的峰值和性能没有验证。还有改变专家选择的缓存感知路由偏置,需要与严格路由分开看;现成模型带有 Uncensored 标识,也不能直接当成官方 1017。
两个仓库根许可证都是 MIT,方便研究和改造;具体引入的第三方组件与模型权重仍要分别核对许可、保留声明。我目前只检查了这些源码和文档,没有本机复现,也没有找到这两个项目明确验证 1017 的证据。
六类 Gap:适配检查清单,不是六项都要重写
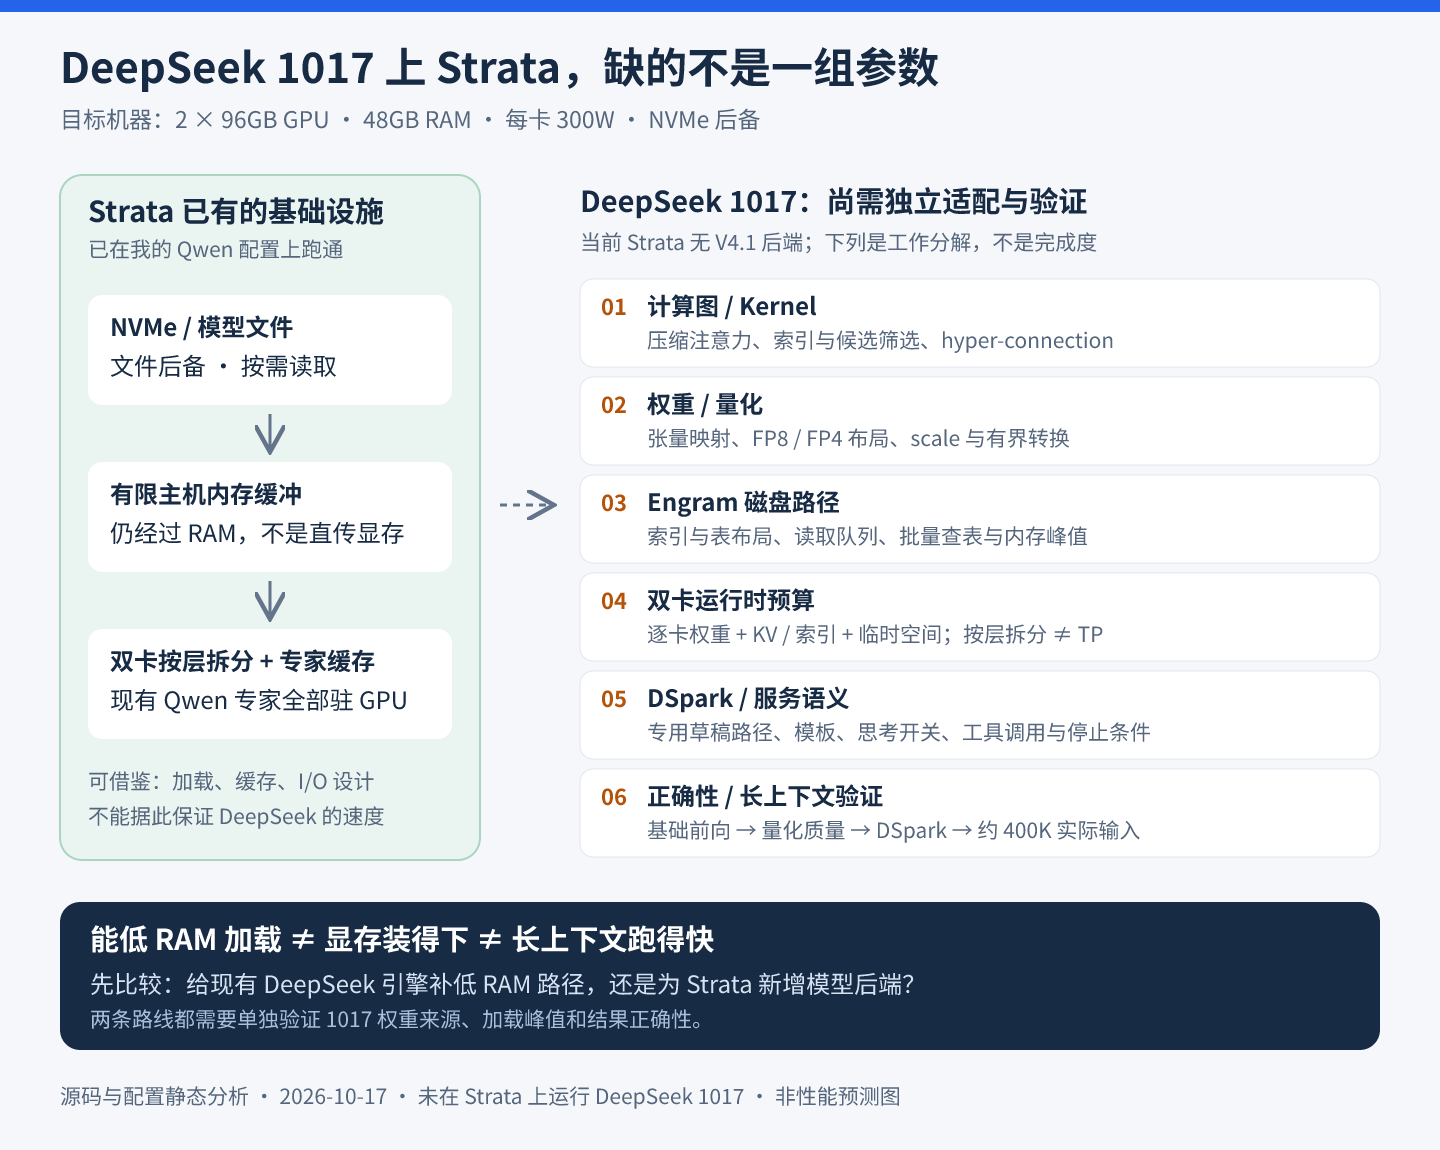
图中“Strata”指官方上游;社区分叉已实现其中不少模块。右侧六项是针对 1017 和我的硬件仍需逐项核对的清单,不代表全部需要从零开发。
1. 架构兼容:先确认 1017 相对旧 V4.1 的差异
检查的官方 Strata 上游版本只识别
qwen4exp和qwen35moe;1017 官方配置是DeepseekV41ForCausalLM,涉及压缩注意力、KV/index 来源层、候选块筛选、hyper-connection 和 Engram 等结构,不能直接套 Qwen 前向。但社区分叉已经实现了 V4.1 的后端。现在更合理的第一步是对照旧 V4.1 与 1017 的参考实现、张量结构和编码文件,确认哪些模块可以直接沿用、哪些语义需要修改,而不是重新实现一遍全部算子。
2. 权重与量化:1017 来源是首要门槛
1017 官方 checkpoint 使用 safetensors,配置包含 FP8、分块 scale 和 FP4 专家。现有分叉分别走 EXL3/pack 或 GSQ/GGUF 等路径,格式并不互换。
即使计算图兼容,也需要明确基于 1017 权重制作的量化,验证张量映射、scale、布局和质量。旧 V4.1 量化换个模型名称,不会变成 1017。 如果自己量化,还要单独核算校准、转换的 RAM/VRAM 峰值,以及额外磁盘空间;运行时低 RAM,不代表量化也自动低 RAM。
3. Engram:已有磁盘实现,重点是长 prompt 下的边界
1017 配置在第 1、14 层设置 Engram。现有分叉已提供磁盘查表路径,不需要仅凭 Qwen 的 PLE 经验重新猜一套。
仍要验证 1017 的索引、表布局与 scale 是否匹配,以及长 prompt 下读取队列、staging buffer、pinned memory 和 page cache 的峰值。mmap 只是映射机制,不自动等于物理内存占用有界。
4. 双卡与低 RAM:这是我的硬件适配重点
两张 96GB 不能当成一张统一的 192GB 显卡。每张卡都要分别容纳分配给它的权重、KV/索引状态、草稿和临时空间。
我更想利用显存优势:尽量让量化计算权重常驻两张 GPU,Engram 留在 NVMe,RAM 只承担有限缓冲。 不能直接照搬那些为 24GB 显卡优化的大 CPU 专家池方案。
双卡分层还要处理 V4.1 跨层共享的 KV/index 状态,不能只在中间层切一刀。按层拆分与 TP 也不是同一种方式;我这台机器还有 PCIe x8/x8 的约束,需要结合具体路径测。至于两张卡能否把某种量化和运行时状态全部放下,目前不能保证。
5. DSpark 与服务:复用已有实现,但要分阶段验证
两个项目已有相关实现,能减少不少工作。我的顺序仍是先关推测解码,验证基础前向和严格路由,再接 DSpark,检查接受率、结果和实际加速。
tokenizer、chat template、思考开关、tool calling、停止条件也要对照 1017 验证。服务端有兼容 API,不代表模型语义自动兼容;视觉可以后置。
6. 正确性与长上下文:不把有损优化混进基线
首先关闭跳专家、缓存感知路由偏置等会改变计算结果的优化。即便关闭这些,同一量化与原始权重也未必质量一致,CPU/GPU 数值路径还可能存在差异,需要分别检查。
对我而言,最终目标不是“启动成功、输出几句话”,而是约 400K 实际上下文下还能稳定干活。至少分开记录:
- 冷/热启动 RAM 峰值、逐卡显存、swap 使用与额外 pack 大小;
- 与可信参考实现对照的 logits/困惑度或任务结果;
- 量化后的中文、代码、工具调用和长上下文质量;
- 逐级加长输入后的 TTFT、prefill、decode 和内存增长;
- 同为每卡 300W、相同输入输出长度和并发口径下的速度。
配置上限写 1M,不等于实际填满 1M 测过;一条 200 tok/s 的截图,也不能代表所有任务。
其他项目可以帮到什么
- DS41RT:作者已有双 RTX PRO 6000、EXL3 2-bit、无额外 Spark 的报告,是双卡执行和缓存设计的重要对照。但在我这台 48GB RAM 机器上的加载峰值、1017 量化来源与正确性仍待验证。
- DwarfStar:可以参考独立实现与质量验证思路,不代表其硬件配方能直接套用。
- llama.cpp 的 V4.1 工作:可以参考转换、算子和模型语义;相关工作不会自动成为 Strata 分叉已经具备的能力。
论坛两篇四台 GB10 的报告也很有参考价值,感谢分享:SparkRing 无交换机环、MiaAI-Lab 配方。它们支持了磁盘 Engram 这条路线的可行性,但都是早期 V4.1,不是 1017;四台机器的统一内存容量也不能直接类比双卡 + 48GB RAM,作者报告的速度我没有复现。
想请教大家
我现在的判断是:不必先从官方 Strata 重写整个 DeepSeek 后端,更值得优先评估已有社区分叉,再补 1017、双卡驻留和低 RAM 的缺口。 这仍然不是换一组启动参数就能保证成功,但工作范围比从零移植小得多。
如果有人已经做过相关尝试,尤其想了解:
- 有没有明确基于 1017、适配双 96GB 卡,且启动不需要上百 GB 主机内存的量化与引擎组合?
- 有没有给这些 Strata 社区后端实现双卡驻留的工作,尤其是跨层 KV/index 的处理?
- 48GB RAM 下,哪些分配最容易跑出专家预算之外?如何减少 pack 与原始权重的重复存储?
欢迎贴具体版本、启动峰值和测试口径。比起先追最高 tok/s,我更想先确认一条能稳定复现、长期开着用的路线。

源码与配置参考
-
我近期准备在这台双 RTX PRO 6000、48GB RAM 的机器上实际尝试一下。
初步打算先评估 Strata-DS,参考 Xolotl 和 DS41RT,不急着从官方 Strata 从零写后端。先核对 1017 的权重结构和量化来源,再测短上下文、加载峰值及逐卡显存;正确性基线会先关闭跳专家、缓存感知路由偏置等有损优化。
后面再看双卡驻留、DSpark,以及逐级加长上下文。目标仍是尽量让计算权重留在 GPU、Engram 留在 NVMe,RAM 只承担有限缓冲,但目前不能保证能实现,更不能提前承诺速度。
跑通或踩坑都会回来更新,记录具体版本、量化、每卡 300W 下的速度和内存占用。有做过相关尝试的朋友,也欢迎分享经验。
-
之前在双 RTX PRO 6000 跑 Qwen3.8-Flash-Next 的帖子里,补充过我为什么选择 Strata:两张卡各有 96GB 显存,但系统内存只有 48GB,两张卡都限制在 300W,主要考虑长期安静开机,不是满功耗刷分。
最近想在同一台机器上尝试 DeepSeek-V4.1-Flash-1017。查了一圈源码后,发现已经有 Strata 的 DeepSeek V4.1 社区分叉,不一定要从零移植。想开个帖子讨论:基于现有实现,距离“双卡、大显存、小 RAM、NVMe 后备”跑好 1017,还剩哪些 Gap?
先说边界:我目前跑通的是 Qwen + Strata,以及之前的 DeepSeek-V4-Flash-0731 + vLLM-Moet;没有在 Strata 系分叉上跑通 V4.1,更没有实测 1017。下面是源码、配置和作者报告整理,不是我的新跑分,也不是一套已经验证可用的配方。
为什么想保留 Strata 这条路线
我在原帖的补充里解释过,Strata 吸引我的不是“完全绕过 RAM”,而是可以用有限的主机缓冲,把专家权重分批搬进 GPU cache;已放进 GPU 的部分,不必再在主机内存里常驻一整份专家副本。
现有 Qwen 配置中,全部 24,576 个专家进了双卡 GPU cache。这是它在我机器上表现不错的重要前提,不能直接推导成更大的 DeepSeek 也会一样快。数据仍要经过主机内存,不是 SSD 直接传显存;RAM budget 也不是整个进程的内存上限。
我的诉求是尽量避免为了加载模型,先准备超大主机内存,或者再生成一套几百 GB 的转换缓存。checkpoint 文件大于 48GB,本身不能证明跑不了;关键是加载峰值、常驻分配和临时转换分别占多少。
已有社区实现,不必从零写整个后端
官方上游 Strata 没有 DeepSeek V4.1 后端,不代表 Strata 生态没有。 目前最值得评估的是这两个项目:
1. Jackwwg83/Strata-DS
项目:Strata-DS,检查版本
a46eeba。已经有独立的 V4.1 计算图和 CUDA kernels、EXL3 专家分层、磁盘 Engram、批量 prefill、DSpark、服务接口,以及相关测试。源码里有显式专家 RAM 预算,允许设为零,不能简单理解成“必须在 CPU 常驻一整份专家权重”。
但还不能原样照搬:
- 作者主要验证的是单卡笔记本;上游 Qwen 支持多卡,不能直接算作这个 DeepSeek 后端已经支持双卡。
- 公开笔记本配方实际占约 54 GiB 主机内存,仍超过我这台机器的可用 RAM。
- 公开速度包含跳过部分低排名专家的有损优化;作者也披露了输出分布变化,尤其中文更明显。不能直接当作严格执行同一量化模型的速度。
- 它仍需要额外生成 pack。文档的安装磁盘预算约为 342GB 下载 + 120GB pack。按张量、专家读取可以控制打包内存,但并没有消除额外磁盘副本。
2. Indras-Mirror/Xolotl
项目:Xolotl,原名 Strata-DSV4.1,检查版本
7375e30。已经有 V4.1 引擎、GSQ 量化工具链、三层专家缓存、磁盘 Engram、DSpark、FP4 KV 和服务适配。量化与正确性检查工具尤其值得参考。
限制也要一起看:作者主要在 4090 + 90GB RAM 上验证,部分配置使用约 60 GiB pinned arena。源码允许限制 arena,但调小后在我这台机器上的峰值和性能没有验证。还有改变专家选择的缓存感知路由偏置,需要与严格路由分开看;现成模型带有 Uncensored 标识,也不能直接当成官方 1017。
两个仓库根许可证都是 MIT,方便研究和改造;具体引入的第三方组件与模型权重仍要分别核对许可、保留声明。我目前只检查了这些源码和文档,没有本机复现,也没有找到这两个项目明确验证 1017 的证据。
六类 Gap:适配检查清单,不是六项都要重写
图中“Strata”指官方上游;社区分叉已实现其中不少模块。右侧六项是针对 1017 和我的硬件仍需逐项核对的清单,不代表全部需要从零开发。
1. 架构兼容:先确认 1017 相对旧 V4.1 的差异
检查的官方 Strata 上游版本只识别
qwen4exp和qwen35moe;1017 官方配置是DeepseekV41ForCausalLM,涉及压缩注意力、KV/index 来源层、候选块筛选、hyper-connection 和 Engram 等结构,不能直接套 Qwen 前向。但社区分叉已经实现了 V4.1 的后端。现在更合理的第一步是对照旧 V4.1 与 1017 的参考实现、张量结构和编码文件,确认哪些模块可以直接沿用、哪些语义需要修改,而不是重新实现一遍全部算子。
2. 权重与量化:1017 来源是首要门槛
1017 官方 checkpoint 使用 safetensors,配置包含 FP8、分块 scale 和 FP4 专家。现有分叉分别走 EXL3/pack 或 GSQ/GGUF 等路径,格式并不互换。
即使计算图兼容,也需要明确基于 1017 权重制作的量化,验证张量映射、scale、布局和质量。旧 V4.1 量化换个模型名称,不会变成 1017。 如果自己量化,还要单独核算校准、转换的 RAM/VRAM 峰值,以及额外磁盘空间;运行时低 RAM,不代表量化也自动低 RAM。
3. Engram:已有磁盘实现,重点是长 prompt 下的边界
1017 配置在第 1、14 层设置 Engram。现有分叉已提供磁盘查表路径,不需要仅凭 Qwen 的 PLE 经验重新猜一套。
仍要验证 1017 的索引、表布局与 scale 是否匹配,以及长 prompt 下读取队列、staging buffer、pinned memory 和 page cache 的峰值。mmap 只是映射机制,不自动等于物理内存占用有界。
4. 双卡与低 RAM:这是我的硬件适配重点
两张 96GB 不能当成一张统一的 192GB 显卡。每张卡都要分别容纳分配给它的权重、KV/索引状态、草稿和临时空间。
我更想利用显存优势:尽量让量化计算权重常驻两张 GPU,Engram 留在 NVMe,RAM 只承担有限缓冲。 不能直接照搬那些为 24GB 显卡优化的大 CPU 专家池方案。
双卡分层还要处理 V4.1 跨层共享的 KV/index 状态,不能只在中间层切一刀。按层拆分与 TP 也不是同一种方式;我这台机器还有 PCIe x8/x8 的约束,需要结合具体路径测。至于两张卡能否把某种量化和运行时状态全部放下,目前不能保证。
5. DSpark 与服务:复用已有实现,但要分阶段验证
两个项目已有相关实现,能减少不少工作。我的顺序仍是先关推测解码,验证基础前向和严格路由,再接 DSpark,检查接受率、结果和实际加速。
tokenizer、chat template、思考开关、tool calling、停止条件也要对照 1017 验证。服务端有兼容 API,不代表模型语义自动兼容;视觉可以后置。
6. 正确性与长上下文:不把有损优化混进基线
首先关闭跳专家、缓存感知路由偏置等会改变计算结果的优化。即便关闭这些,同一量化与原始权重也未必质量一致,CPU/GPU 数值路径还可能存在差异,需要分别检查。
对我而言,最终目标不是“启动成功、输出几句话”,而是约 400K 实际上下文下还能稳定干活。至少分开记录:
- 冷/热启动 RAM 峰值、逐卡显存、swap 使用与额外 pack 大小;
- 与可信参考实现对照的 logits/困惑度或任务结果;
- 量化后的中文、代码、工具调用和长上下文质量;
- 逐级加长输入后的 TTFT、prefill、decode 和内存增长;
- 同为每卡 300W、相同输入输出长度和并发口径下的速度。
配置上限写 1M,不等于实际填满 1M 测过;一条 200 tok/s 的截图,也不能代表所有任务。
其他项目可以帮到什么
- DS41RT:作者已有双 RTX PRO 6000、EXL3 2-bit、无额外 Spark 的报告,是双卡执行和缓存设计的重要对照。但在我这台 48GB RAM 机器上的加载峰值、1017 量化来源与正确性仍待验证。
- DwarfStar:可以参考独立实现与质量验证思路,不代表其硬件配方能直接套用。
- llama.cpp 的 V4.1 工作:可以参考转换、算子和模型语义;相关工作不会自动成为 Strata 分叉已经具备的能力。
论坛两篇四台 GB10 的报告也很有参考价值,感谢分享:SparkRing 无交换机环、MiaAI-Lab 配方。它们支持了磁盘 Engram 这条路线的可行性,但都是早期 V4.1,不是 1017;四台机器的统一内存容量也不能直接类比双卡 + 48GB RAM,作者报告的速度我没有复现。
想请教大家
我现在的判断是:不必先从官方 Strata 重写整个 DeepSeek 后端,更值得优先评估已有社区分叉,再补 1017、双卡驻留和低 RAM 的缺口。 这仍然不是换一组启动参数就能保证成功,但工作范围比从零移植小得多。
如果有人已经做过相关尝试,尤其想了解:
- 有没有明确基于 1017、适配双 96GB 卡,且启动不需要上百 GB 主机内存的量化与引擎组合?
- 有没有给这些 Strata 社区后端实现双卡驻留的工作,尤其是跨层 KV/index 的处理?
- 48GB RAM 下,哪些分配最容易跑出专家预算之外?如何减少 pack 与原始权重的重复存储?
欢迎贴具体版本、启动峰值和测试口径。比起先追最高 tok/s,我更想先确认一条能稳定复现、长期开着用的路线。
源码与配置参考
-
@lunarmoon26 等待你的评测。 其实我也一直在想, 本地辛辛苦苦跑起 DeepSeek V4 这种模型的意义是什么?
@johnnybegood 完全同意 跑起来最多能证明能输出>=1 tok/s不能干任何事。
能稳定干活 作为subagent的LLM 能降低延迟或成本 增加效果(这只能通过eval那一套东西来测)才是本地部署的作用
今后的重点是Eval,而不是“我觉得他好像挺聪明” -
,
 T terry 固定了此主题
-
-
@xiaopbro 这个模型763B参数 Q4要500GB硬盘非常大
准备蹲一波unsloth或者HuggingFace上几个大神的Q2 Q3模型
持续关注中:https://huggingface.co/unsloth/DeepSeek-V4.1-Flash-1017-GGUF -
,系统 取消固定了此主题


