跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. 電腦的HERMES讀取GB10的模型

電腦的HERMES讀取GB10的模型

已定时 已固定 已锁定 已移动 随便聊聊
gb10hermesdgxspark
14 帖子 6 发布者 147 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • benton yiB
    benton yiB
    benton yi
    贵族大夫 硕果累累
    编写于 最后由 编辑
    #4

    还差4根QSFP56-200G连接线。先买好硬件,再组NCCL,有交换机就正常配置,没有交换机按环形配置,让在线模型去github找最新的recipe。10块20块的api钱总是不能省的。

    1 条回复 最后回复
    1
    • 怪物怪 怪物

      @Tony-Wang 您好,我的HERMES沒有雲端模型,用Codex跟Claude桌面板可以嗎?
      該怎麼跟他說呢?謝謝

      Tony WangT
      Tony WangT
      Tony Wang
      易有太极
      编写于 最后由 Tony Wang 编辑
      #5

      @怪物 说:

      @Tony-Wang 您好,我的HERMES沒有雲端模型,用Codex跟Claude桌面板可以嗎?
      該怎麼跟他說呢?謝謝

      原则上也可以, 不过codex和claude缺省对本地操作的限制很多. 直接操作你的机器有点儿麻烦.

      你去买一点儿Deepseek的api token, 100-200元人民币, 把它配置到你的hermes的模型里面. 就够用很久了. 我上次用Hermes+deepseek v4 flash 给我安装SGlang Qwen3.8 27B, 一共用了1.7元 RMB. 日常的轻量级任务, 还是用 Hermes+本地llm, 节省费用.

      下面是Hermes+27B 自动生成, 供你参考, 你把下面的内容, 和任务书, 丢给Hermes.

      配置:

      Hermes 支持 OpenAI 兼容接口,在模型面板里加一个自定义 provider——base URL 填 https://api.deepseek.com/v1,模型填 deepseek-flash,key 填你的 API key。顺便说一句,deepseek-flash 就是你想要本地跑的那个模型:DeepSeek-V4.1-Flash-1017,支持 tool calls,跑这种长 agent 任务正合适。

      配好之后,你跟 Hermes 这么说(把 4 个 IP 填上):

      我有 4 台 GB10,IP 分别是 ×××、×××、×××、×××,我需要把它们 4 台串起来部署 DeepSeek-V4.1-Flash。按我给你的任务书执行:每一步把进度写进 task-log.md,断线了能接着跑。

      要点:

      • 前置检查:Hermes 主机到 4 台 GB10 的免密 ssh、环形线已布好、有可用在线模型 API——缺一项就停下来报,不许猜
      • 阶段一: 强制先调研后动手:官方渠道核实参数/精度/未审查版、算 512GB 装不装得下、找 GB10 多机最新 recipe(NCCL 环形 + 推理框架选型),出 plan.md 给主人过目
      • 阶段二/三:逐机盘点 → 安装 → 下载模型 → nccl-tests 验证带宽 → 起服务 → 真实请求验收 + 确认 4 台都参与 + 记性能数字
      • 红线:重启/清数据先问、不自己花钱、每步写 task-log.md 可断点续跑、实测不了就如实报不许编

      任务书:

      lcz-2532-任务书.md

      1 条回复 最后回复
      1
      • Tony WangT
        Tony WangT
        Tony Wang
        易有太极
        编写于 最后由 编辑
        #6

        又让 Hermes 上网查了, 补两个问题的答案. 这部分内容, 你也给你的Hermes.

        1. 去审查版, 有.

        最对口 1017 的:

        • dealignai/DeepSeek-V4.1-Flash-1017-UNCENSORED-FP8: 就是 1017 官方 checkpoint 做的权重级 abliteration (逐层消融拒绝方向), 非量化衍生, 非 jailbreak, 非 LoRA, 和官方版权节兼容 — 能加载官方版的就能加载它. 510GB, FP8+FP4, 1M 上下文, 视觉 / 工具 / 思考档位都保留, MMLU 掉 3.86pp. Gated repo, Hermes 要先申请一下权限.
        • AtomicChat/DeepSeek-V4.1-Flash-1017-Uncensored-GGUF: 同一套消融打进 GGUF (3.58bpw 磁盘约 335GB), 还附带一个 rank-1 LoRA adapter — 挂在任意 1017 GGUF 上就有去审查效果. 需要带 V4.1 支持的 llama.cpp (unsloth full-stack pin, 上游还没合并).

        基础版 (9 月版) 的去审查版下载量最大的是 dealignai/DeepSeek-V4.1-Flash-UNCENSORED-FP8 (51.4K 下载).

        2. 4 台 + 无交换机环接, 有现成 recipe.

        NVIDIA 官方论坛上的 christopherowen/spark-ds41f, 正好就是你这台配置: vLLM, 4×Spark TP4 环接, all-to-all 自动绕开无交换机的环形拓扑, 生产环境就在跑 DeepSeek-V4.1-Flash-1017, 1M 上下文, 16 并发序列. 任务书第一阶段的"找最新 recipe", 让它从这个 repo 起手.

        选去审查版要注意:

        • 原生 FP8 是 510GB, 光权重就快吃完 4×128GB, KV cache 很紧. 想要宽裕看量化去审查版 (EXL3 2.9bpw 约 270GB, 或上面的 GGUF).
        • 第三方权重产物: 下载后校验完整性, 隔离环境跑.
        • 去审查后没有安全兜底, 输出全是你自己的责任.
        • MMLU 掉约 4pp, 是去审查的代价, 可接受.
        怪物怪 1 条回复 最后回复
        1
        • Tony WangT Tony Wang

          又让 Hermes 上网查了, 补两个问题的答案. 这部分内容, 你也给你的Hermes.

          1. 去审查版, 有.

          最对口 1017 的:

          • dealignai/DeepSeek-V4.1-Flash-1017-UNCENSORED-FP8: 就是 1017 官方 checkpoint 做的权重级 abliteration (逐层消融拒绝方向), 非量化衍生, 非 jailbreak, 非 LoRA, 和官方版权节兼容 — 能加载官方版的就能加载它. 510GB, FP8+FP4, 1M 上下文, 视觉 / 工具 / 思考档位都保留, MMLU 掉 3.86pp. Gated repo, Hermes 要先申请一下权限.
          • AtomicChat/DeepSeek-V4.1-Flash-1017-Uncensored-GGUF: 同一套消融打进 GGUF (3.58bpw 磁盘约 335GB), 还附带一个 rank-1 LoRA adapter — 挂在任意 1017 GGUF 上就有去审查效果. 需要带 V4.1 支持的 llama.cpp (unsloth full-stack pin, 上游还没合并).

          基础版 (9 月版) 的去审查版下载量最大的是 dealignai/DeepSeek-V4.1-Flash-UNCENSORED-FP8 (51.4K 下载).

          2. 4 台 + 无交换机环接, 有现成 recipe.

          NVIDIA 官方论坛上的 christopherowen/spark-ds41f, 正好就是你这台配置: vLLM, 4×Spark TP4 环接, all-to-all 自动绕开无交换机的环形拓扑, 生产环境就在跑 DeepSeek-V4.1-Flash-1017, 1M 上下文, 16 并发序列. 任务书第一阶段的"找最新 recipe", 让它从这个 repo 起手.

          选去审查版要注意:

          • 原生 FP8 是 510GB, 光权重就快吃完 4×128GB, KV cache 很紧. 想要宽裕看量化去审查版 (EXL3 2.9bpw 约 270GB, 或上面的 GGUF).
          • 第三方权重产物: 下载后校验完整性, 隔离环境跑.
          • 去审查后没有安全兜底, 输出全是你自己的责任.
          • MMLU 掉约 4pp, 是去审查的代价, 可接受.
          怪物怪
          怪物怪
          怪物
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #7

          @Tony-Wang 太感謝您了,我自己都不知道該怎麼問AI,
          我把你說的全部餵給HERMES試試,謝謝

          benton yiB 1 条回复 最后回复
          0
          • 怪物怪 怪物

            @Tony-Wang 太感謝您了,我自己都不知道該怎麼問AI,
            我把你說的全部餵給HERMES試試,謝謝

            benton yiB
            benton yiB
            benton yi
            贵族大夫 硕果累累
            编写于 最后由 benton yi 编辑
            #8

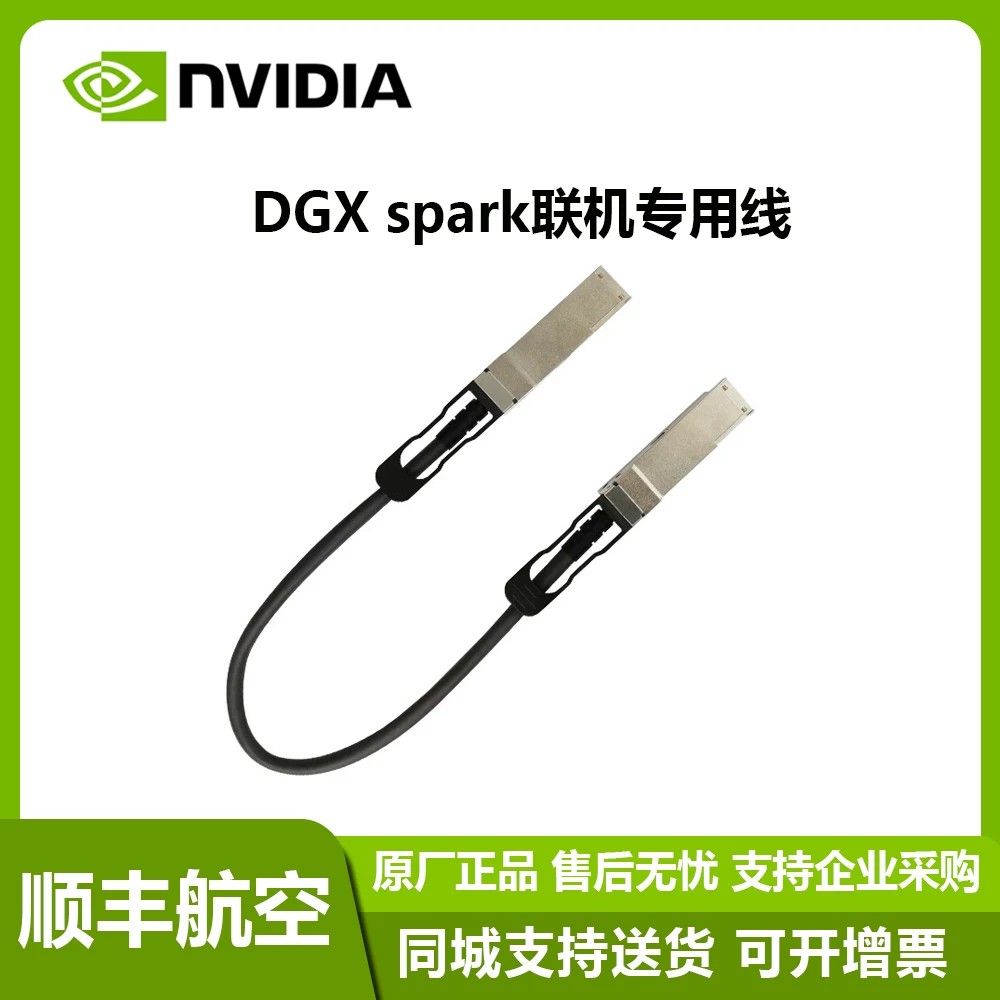
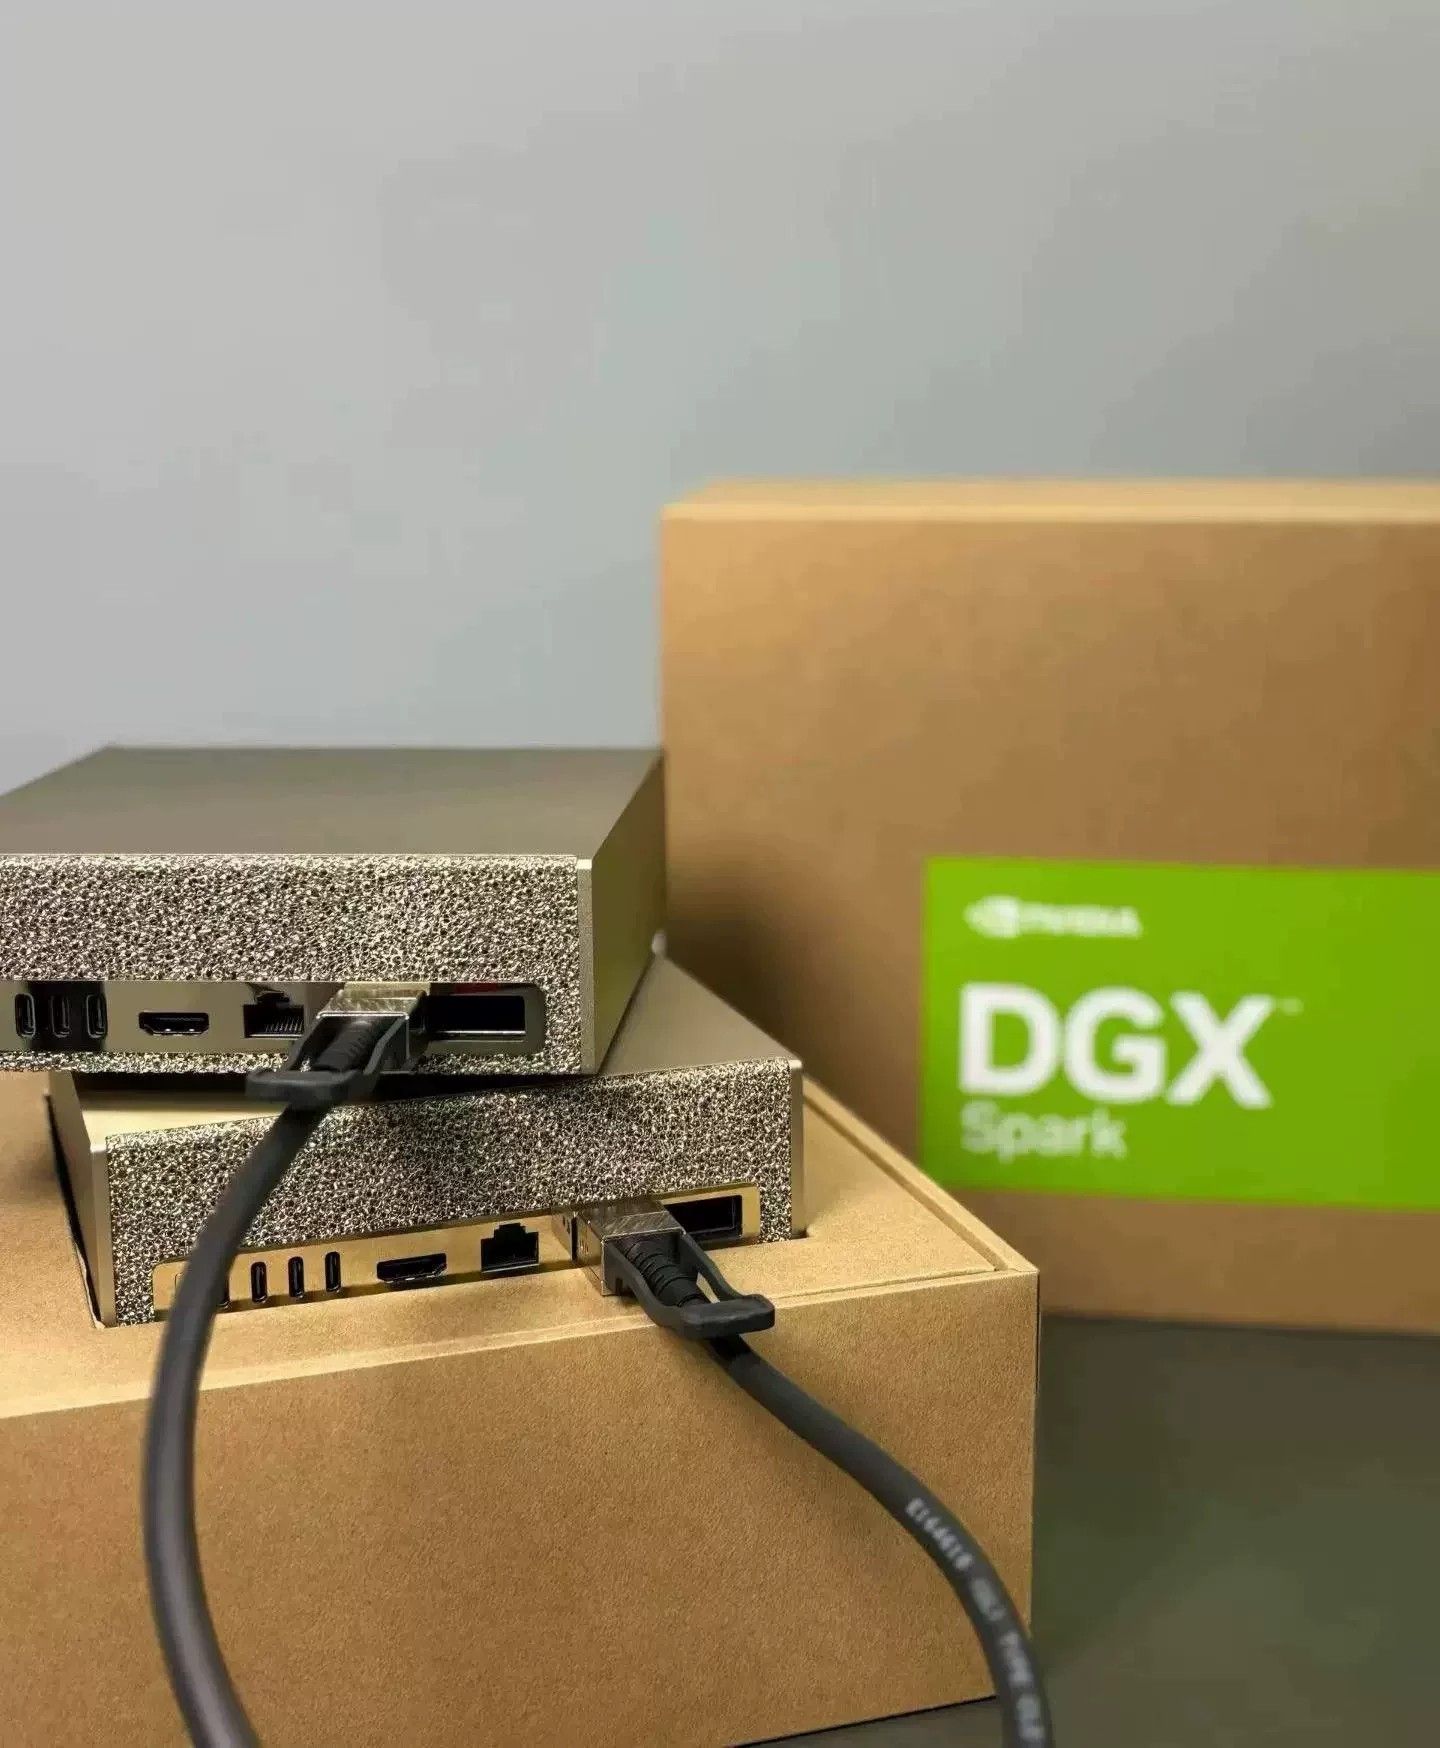
            @怪物 你现在接好了在线模型也做不了@tony-wang 列的这些事。差4根线,长这样:
            image.jpeg
            image.jpeg
            RJ45网线组不了NCCL网络,万兆也不行

            怪物怪 1 条回复 最后回复
            1
            • stxpnetS
              stxpnetS
              stxpnet
              王侯将相
              编写于 最后由 stxpnet 编辑
              #9

              楼主似乎在台湾,上X去找就行了。
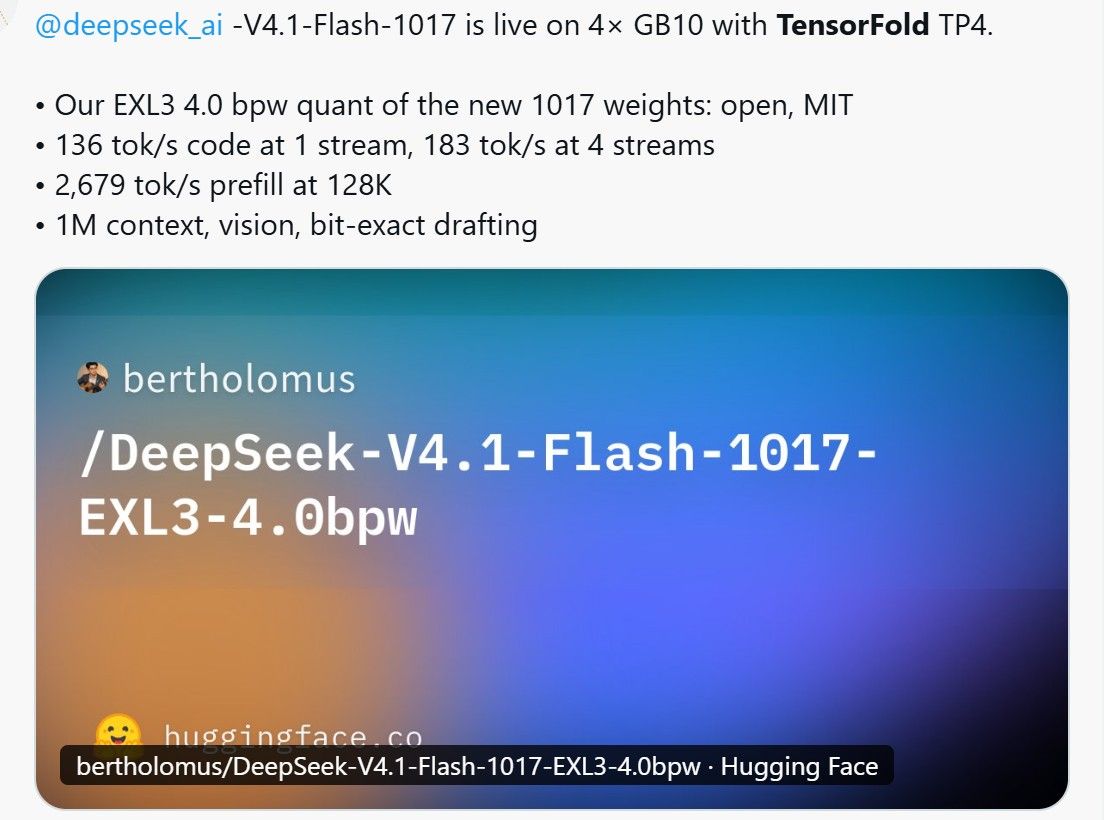
              我目测,最好的应该是tensor fold了,基本是dgx spark的专属框架+模型:

              {671C9AB6-18FB-4909-8BD7-49145562A319}.jpeg
              这速度基本上有一台24小时自动印TOKEN机了。

              双卡3090 PCIE 4.0 16X/16X

              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
              怪物怪 1 条回复 最后回复
              1
              • benton yiB benton yi

                @怪物 你现在接好了在线模型也做不了@tony-wang 列的这些事。差4根线,长这样:
                image.jpeg
                image.jpeg
                RJ45网线组不了NCCL网络,万兆也不行

                怪物怪
                怪物怪
                怪物
                体面乡绅 硕果累累
                编写于 最后由 编辑
                #10

                @benton-yi 有的,我有買CRS804的交換機跟線,不過台灣全面缺貨,我花了2倍的錢在淘寶買了一台,還沒寄來,我現在是想先把要下載安裝的都裝好,謝謝

                1 条回复 最后回复
                1
                • stxpnetS stxpnet

                  楼主似乎在台湾,上X去找就行了。
                  我目测,最好的应该是tensor fold了,基本是dgx spark的专属框架+模型:

                  {671C9AB6-18FB-4909-8BD7-49145562A319}.jpeg
                  这速度基本上有一台24小时自动印TOKEN机了。

                  怪物怪
                  怪物怪
                  怪物
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #11

                  @stxpnet 好的,來研究一下X推特,謝謝

                  1 条回复 最后回复
                  0
                  • 怪物怪 怪物

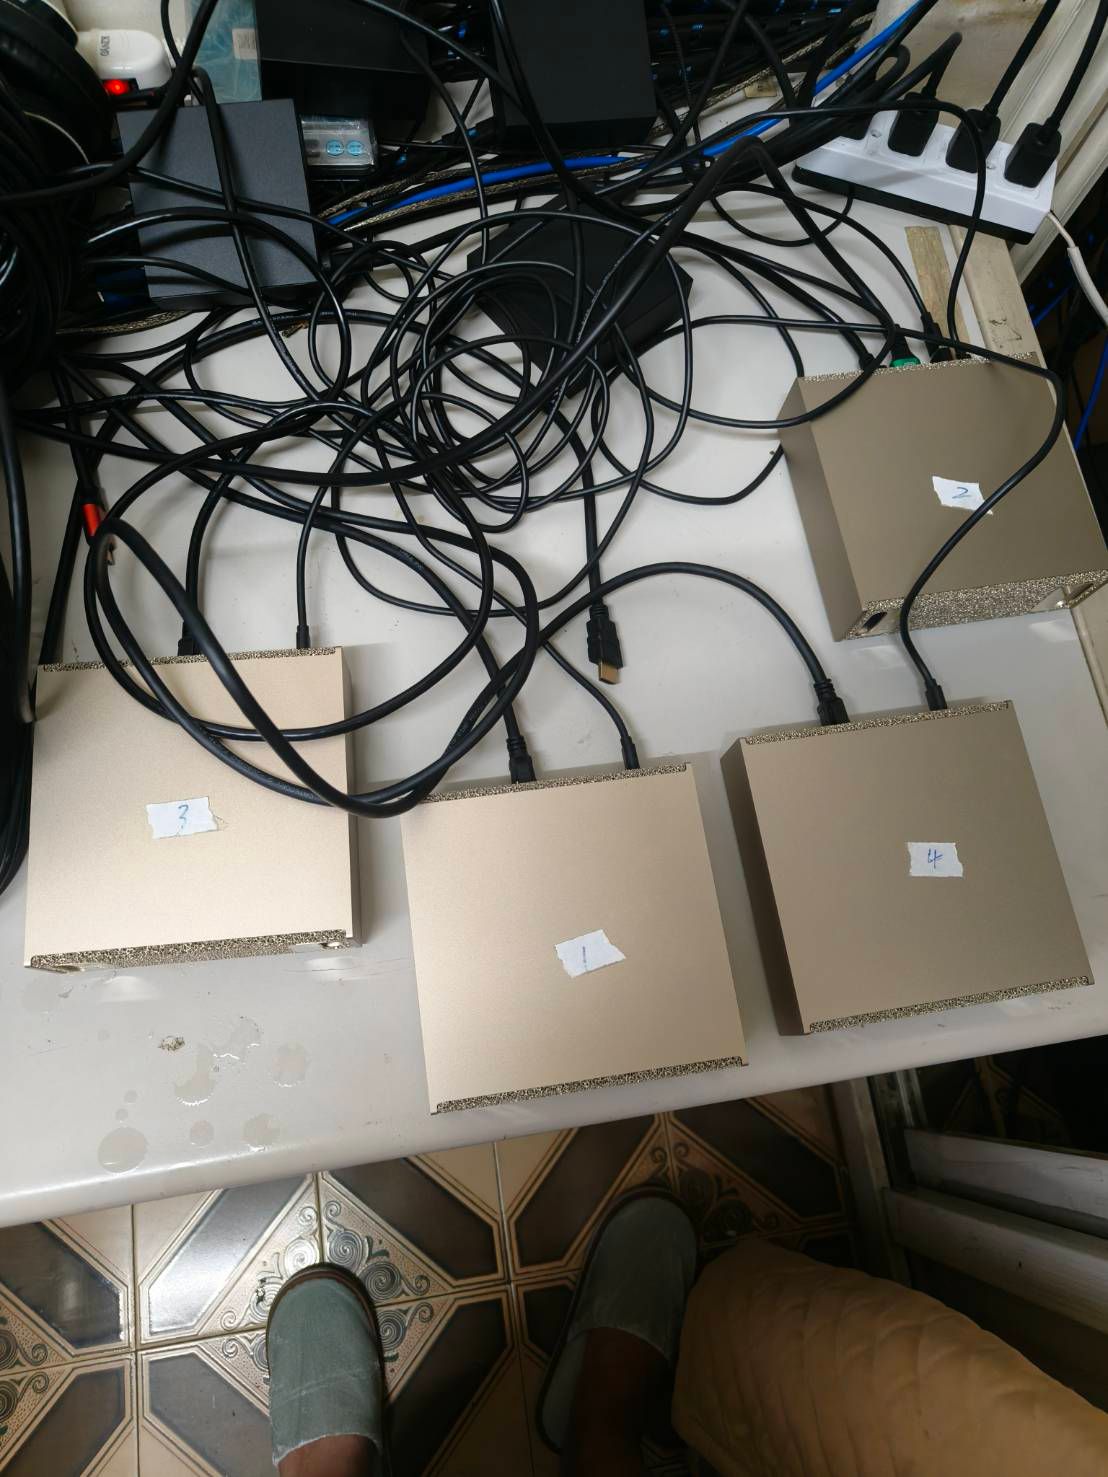
                    忙了一天,終於把4台的基本安裝設定好了,
                    請問各位前輩,
                    接下來要下載哪一個版本的deepseek v4 1 flash 1017
                    比較適合4台串聯呢?這一版的有無審查版本了嗎?
                    我想透過電腦的HERMES來讀取4台GB10的模型
                    有這方面的實例可以參考嗎?
                    謝謝大家
                    79330.jpg

                    johnnybegoodJ
                    johnnybegoodJ
                    johnnybegood
                    王侯将相
                    编写于 最后由 johnnybegood 编辑
                    #12

                    @怪物 你真是个魔术师, 前一阵说要变出厉害的装备, 今天就有了。 厉害厉害。 可以看着个视频, 讲的比较清楚

                    Youtube Video

                    至于模型, 我建议先把原版模型跑起来, 测试一下, 然后再跑去审查的。

                    1 条回复 最后回复
                    1
                    • Tony WangT
                      Tony WangT
                      Tony Wang
                      易有太极
                      编写于 最后由 编辑
                      #13

                      @怪物

                      其实,

                      1. 你只要多跟AI聊天, 把你的情况, 你想做什么告诉它, 让它上网搜索, 核实, 并给你相应的方案.
                      2. 然后把相应的方案给Agent, 让它再细化一遍. 最后再让Agent去执行.
                      3. 长线的复杂任务, 最好让在线模型去执行, 它们的上下文比较长, 跑起来不容易出错. 智力也会高一点点.
                      terryT 1 条回复 最后回复
                      1
                      • ,gao GaoG gao Gao 引用了 此主题
                      • Tony WangT Tony Wang

                        @怪物

                        其实,

                        1. 你只要多跟AI聊天, 把你的情况, 你想做什么告诉它, 让它上网搜索, 核实, 并给你相应的方案.
                        2. 然后把相应的方案给Agent, 让它再细化一遍. 最后再让Agent去执行.
                        3. 长线的复杂任务, 最好让在线模型去执行, 它们的上下文比较长, 跑起来不容易出错. 智力也会高一点点.
                        terryT
                        terryT
                        terry
                        易有太极
                        编写于 最后由 terry 编辑
                        #14

                        @Tony-Wang 我哥你说什么都对,你是社区哲学家,科学家是我弟 @imbiplaza-asus 。
                        你俩一个是社区康德,一个是社区达文西。
                        卧龙凤雏皆不世之材,得一可安天下,兄弟我看来是要发家了。

                        油管:https://www.youtube.com/@抡锤者

                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组