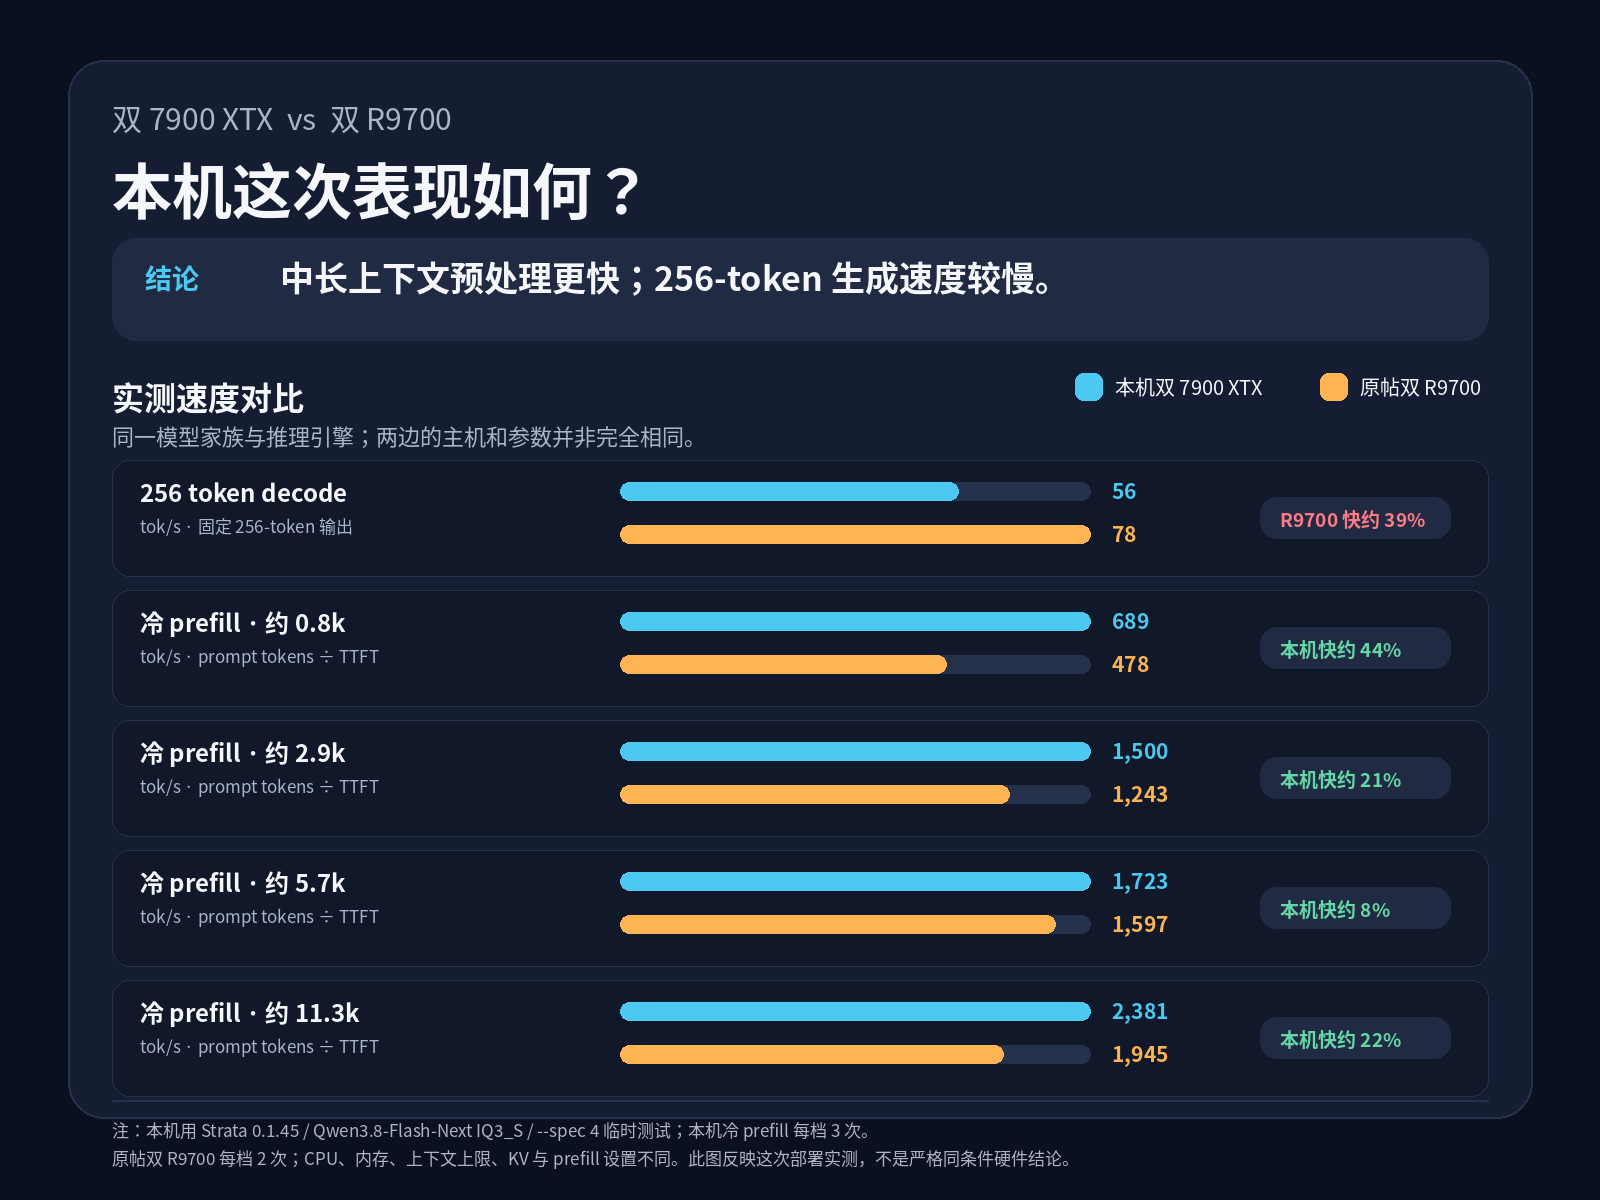
測試 雙R9700, X99, qwen3.8-flash-next-iq3_s
-
-
有几个问题想确定:
听闻x99 不能支援多卡tp?
实时pcie 3.0 传输峰值是多少,
可否设定单卡走满GPU 100%, 第二张只是占用vram,不涉及计算的话,跟现在的GPU0 69%+GPU1 46%,生成速度 ts 会不会有很大的差别 -
我就是想gen3是我需要考虑的最重要的原因,何况我的5060ti 原生只能x8,放入gen3 会不会只剩下残值
-
,
G gao Gao 引用了 此主题
-
-
为什么你这个2张r9700 速度有点差
@applejuice
兩張 R9700 速度不一,是因為模型層(layer)分配不均,不是 PCIe 或記憶體頻寬問題。具體分析如下:
層數分配:模型共 48 層,GPU0 接 0–23 層(24 層),GPU1 接 24–47 層(24 層)。
GPU 使用率:GPU0 約 69% 負載,GPU1 約 46%,明顯不均。
根本原因:模型並行策略(TP=2)將層數平均分給兩卡,但由於模型結構非對稱(例如前半段計算較重),導致 GPU0 負載更高。
硬體狀態:兩卡皆為 R9700,34.2 GB VRAM,無 PCIe 或記憶體瓶頸(無明顯頻寬差異)。
結論:不均是預期的層分配結果,非效能問題。若需平衡負載,可調整層數分配或使用更對稱的模型結構。(補充:這與 GPU 硬體或 PCIe 通道無關,兩卡皆全速運作。)
-
-
-
-
@XXX 试试radiance 呗 如果这样的速度就不值得我入手第2张了 strata 两张卡不一定会同时用完 tp 会现在一张卡跑完再丢给另一张卡 但是strata 是不是这样我就不清楚了 没仔细看过
他這速度跟單卡一樣,應該是沒設定好。
-
-