【 爆卖理由+2】双7900 XTX Strata IQ3_S:262K Prefill 6,264 可抄作业
-
前后用的是同一款模型(文章):Qwen3.8-Flash-Next GSQ-RCO IQ3_S,同一台 Ryzen 5 7500F + 双 RX 7900 XTX 主机。这次提升来自 Strata 引擎和运行参数的一整套调整,不是更换量化或模型。
262K Prefill 对比
配置 Prefill Decode 测试条件 优化前 5,243.9 tok/s 约 91.7 tok/s 固定 261,880 输入 + 256 输出;关闭检查点;16K 分块及对应调优表 优化后 6,263.9 tok/s 117.0 tok/s 261,880 输入 + 256 输出;日常配置;两轮中位数 变化 +19.5% +27.6% 两组测试条件不同,见下方说明 优化后的 262K Prefill 为优化前的约 1.19 倍。不过,5,243.9 是关闭检查点的单项调优确认值;6,263.9 来自目前日常配置的七档测试。因此这两个数值可作前后参考,不能视为完全同条件的严格 A/B。作为更接近同口径的日常基准,旧版检查点开启时 262K Prefill 是 5,147.1 tok/s;对比当前 6,263.9,提升约 21.7%。
七档 Prefill:优化前后
以下以两次正式六档/七档测试中都有的上下文长度作比较,速度单位 tok/s,均为两轮中位数。
输入长度 优化前 优化后 提升 32K 3,572 5,857 +64.0% 64K 4,459 6,301 +41.3% 85K 4,530 6,515 +43.8% 128K 5,020 6,545 +30.4% 262K 5,147 6,264 +21.7% 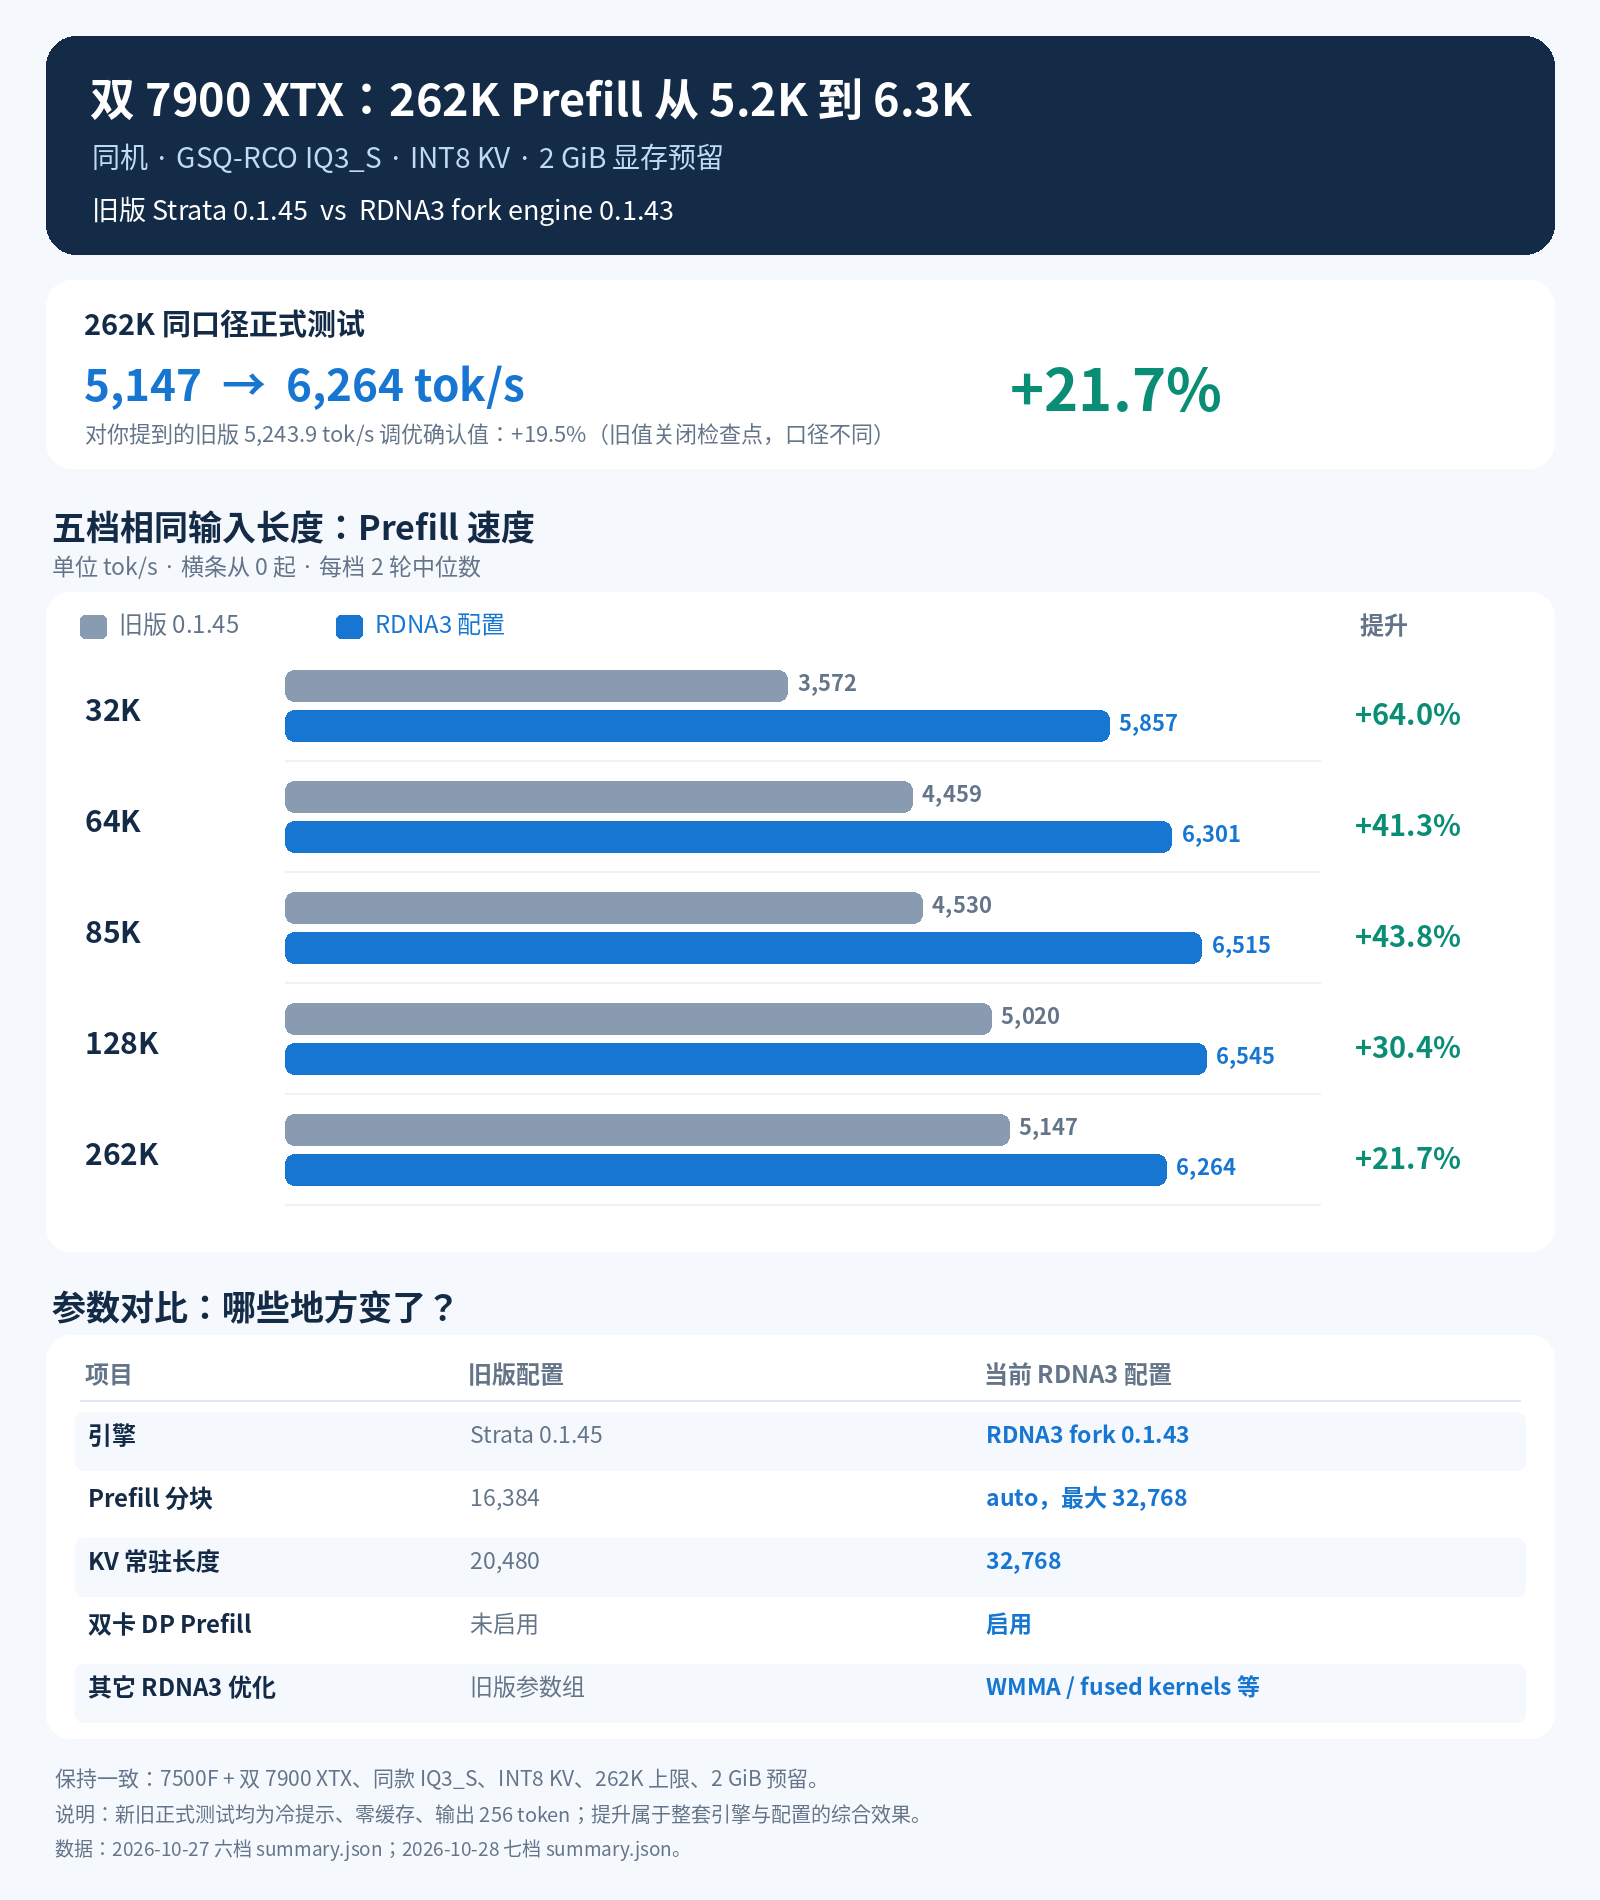
32K 到 262K 各档都更快,但提升幅度随上下文增长而收窄。8K 和 16K 是新一轮新增档位,旧测试没有对应数据,因此不列百分比。
主要参数变化
项目 优化前 优化后 Strata 引擎 上游 0.1.45 RDNA3 fork,engine 0.1.43 Prefill 固定 16,384 分块 auto,自动分块上限 32,768KV 常驻长度 20,480 32,768 双卡 DP Prefill 未启用 启用 RDNA3 专项路径 旧参数组 启用 WMMA、融合算子等 RDNA3 路径 hipBLASLt 调优表 gfx1100 100401 gfx1100 100401,沿用并配合新引擎配置 KV 类型 / 显存预留 INT8 / 2,048 MiB INT8 / 2,048 MiB 模型 / GPU / 主机 IQ3_S / 双 RX 7900 XTX / Ryzen 5 7500F 相同 优化后完整配置(可复现)
测试平台和版本
CPU: AMD Ryzen 5 7500F,6 核 12 线程
GPU: RX 7900 XTX × 2,gfx1100,HIP,GPU 编号 [0, 1]
RAM: 96 GB
OS: Ubuntu 24.04.5
Strata: RDNA3 fork,engine 0.1.43
Source commit: fc8f82334239199cd3cfcfa5ab5b8ac09827d19b
Model: Qwen3.8-Flash-Next GSQ-RCO IQ3_S
Context: 262144
KV: INT8
hipBLASLt: gfx1100 / 100401 tuning table
Layer split: 24 / 24
VRAM reserve: `--vram-reserve-mib 2048`
引擎启动参数
把路径替换成自己的 Strata 和 Strata-data 路径。配置模板附件已经包含下面这些参数,可直接改模板中的路径:
--pack /path/to/Strata-data/packs/iq3_s \
--native /path/to/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf \
--ple-gguf /path/to/Strata-data/models/IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf \
--expert-profile /path/to/iq3s-rdna3-assets/expert-profile.bin \
--prefill auto \
--spec-min-p 0.5 \
--mtp /path/to/Strata-data/mtp/rt \
--max-context 262144 \
--kv int8 \
--ple-io direct \
--stats \
--pool-workers 8 \
--expert-cache auto \
--ple-row-cache 1048576 \
--kv-resident 32768 \
--pipeline-windows 2 \
--mtp-q4 all \
--mtp-window 4096 \
--pcie-frac 0 \
--spec 3 \
--vram-reserve-mib 2048 \
--layer-split 24
完整环境变量
下列值用于优化后的测试配置。
STRATA_HIPBLASLT_TUNING指向附件中的调优表;STRATA_DP_PREFILL=1开启双卡 DP Prefill。STRATA_HIPBLASLT_TUNING=/path/to/iq3s-rdna3-assets/gfx1100-hipblaslt-100401-262k-20261026.txt STRATA_RDNA_MMVQ_WAVE=3 STRATA_PEER_TRANSPORT=host STRATA_HIP_WMMA=1 STRATA_SELECT_WMMA=1 STRATA_PREFILL_CPU_SHARE=auto STRATA_HC_Q8=0 STRATA_PREFILL_AUTO_MAX=32768 STRATA_PREFILL_RING=384 STRATA_PREFILL_MMQ_TILE_ROWS=32 STRATA_ROUTE_TAIL_SKIP=0 STRATA_HEAD_MIX_MULTI=1 STRATA_ONE_TOKEN_COMMIT=0 STRATA_AUX_CPUS=off STRATA_GR_RDNA=1 STRATA_GR_RDNA_Q8=1 STRATA_RDNA_Q6K=1 STRATA_GR_RDNA_A8=1 GPU_MAX_HW_QUEUES=8 STRATA_PREFILL_SMALL_RING=96 STRATA_PREFILL_SMALL_MAX=4096 STRATA_QFUSE=1 STRATA_COMBINE_CPU=1 STRATA_VERIFY_QDEDUP=1 STRATA_WAIT_FUSE=1 STRATA_ROUTE_PUBLISH=1 STRATA_GR_INJ_UP=1 STRATA_PF_FUSED=1 STRATA_STAGER_RING=64 STRATA_PREFILL_CPU_SHARE_MAX=1024 STRATA_GR_FUSED=1 STRATA_GDN_HEAD=1 STRATA_GDN_CHUNKED=1 STRATA_GDN_CHUNK_GDV=0 STRATA_PA_KLDS=1 STRATA_GDN_PP=1 STRATA_GDN_CONVL2=1 STRATA_GDN_NOY=1 STRATA_PF_GEMM=1 STRATA_PF_PAD=1 STRATA_HC_UPMIX=1 STRATA_PF_HCDOWN=1 STRATA_FUSE_CONVAB=1 STRATA_PA_FAST=1 STRATA_PF_GROUP_RES=1 STRATA_PF_F16=2 STRATA_KV_HOST_DMA=1 STRATA_DP_PREFILL=1安装、构建和启动
-
使用 RDNA3 fork 的固定 commit,安装 HIP 依赖,并准备双卡 gfx1100 构建:
git clone https://github.com/nicejunjie/Strata-rdna3.git cd Strata-rdna3 git checkout fc8f82334239199cd3cfcfa5ab5b8ac09827d19b cmake -S . -B build-rdna3 \ -DCMAKE_BUILD_TYPE=Release \ -DSTRATA_ENABLE_HIP=ON -DSTRATA_ENABLE_CUDA=OFF \ -DCMAKE_HIP_ARCHITECTURES=gfx1100 cmake --build build-rdna3 --target strata -j2 -
按 Strata 安装流程准备 Qwen
IQ3_S模型分片、iq3_spack/tokenizer 和 MTP runtime。附件提供本次测试所用的 expert profile、hipBLASLt 调优表、JSON 配置模板与测速脚本;模型权重和 MTP 文件需自行准备。AMD HIP 的依赖和运行时可按仓库docs/AMD_HIP.md的 Install with setup 部分安装;本文为锁定测试版本,使用上面的固定 commit 和 CMake 命令构建。 -
打开 JSON 模板,把其中
/path/to/...替换为实际路径。模板默认只监听127.0.0.1。在 Strata 仓库目录启动服务:.venv/bin/python serve/server.py \ --engine strata \ --config /path/to/strata-iq3s-rdna3-262k-template.json \ --port 8081 -
等待
http://127.0.0.1:8081/v1/status显示loaded: true、engine: 0.1.43、context: 262144,再开始测试。测试时不要同时发送其它请求。
复测速度
附件中的
benchmark_5090_method.py使用 Strata tokenizer 和 chat template 生成目标长度的冷提示,每轮输出上限 256 tokens。运行:.venv/bin/python /path/to/benchmark_5090_method.py \ --root /path/to/Strata-rdna3 \ --pack /path/to/Strata-data/packs/iq3_s \ --url http://127.0.0.1:8081 \ --out ./bench-iq3s-rdna3 \ --targets 8192,16384,32768,65536,87040,128000,261880 \ --runs 2核对每轮
prompt_tokens等于目标长度、缓存复用为 0、输出为 256 tokens。Prefill tok/s 按新读入 token 数除以引擎 prompt 用时;Decode tok/s 按实际生成 token 数除以引擎 decode 用时;表中报告两轮中位数。85K 目标的 tokenizer 实际长度是 87,039;262K 目标实际为 261,880。附件清单:
strata-iq3s-rdna3-262k-template.json、benchmark_5090_method.py、assets/expert-profile.bin、gfx1100 hipBLASLt 100401 调优表,以及本文引用的两张 PNG。profile 和调优表来自本次测试,其他机器若使用不同模型文件或 hipBLASLt 版本,应重新核实兼容性。逐项参数 A/B:哪项影响最大?
在当前 RDNA3 fork 上一次只改一个参数,其他设置保持不变。对照是日常配置:Prefill
auto(最大 32K)、kv-resident 32768、DP Prefill 开启。每档输入 261,880 或 128,000 tokens,缓存命中 0、输出 256 tokens。单项变化 128K Prefill 相对 auto 262K Prefill 相对 auto 当前 auto / KV 32K / DP 开 6,532 基线 6,264 基线 固定 Prefill 16K 6,308 −3.4% 5,961 −4.8% KV 常驻改为 20K 6,389 −2.2% 6,265 +0.0% DP Prefill 关闭 5,274 −19.2% 5,508 −12.1% 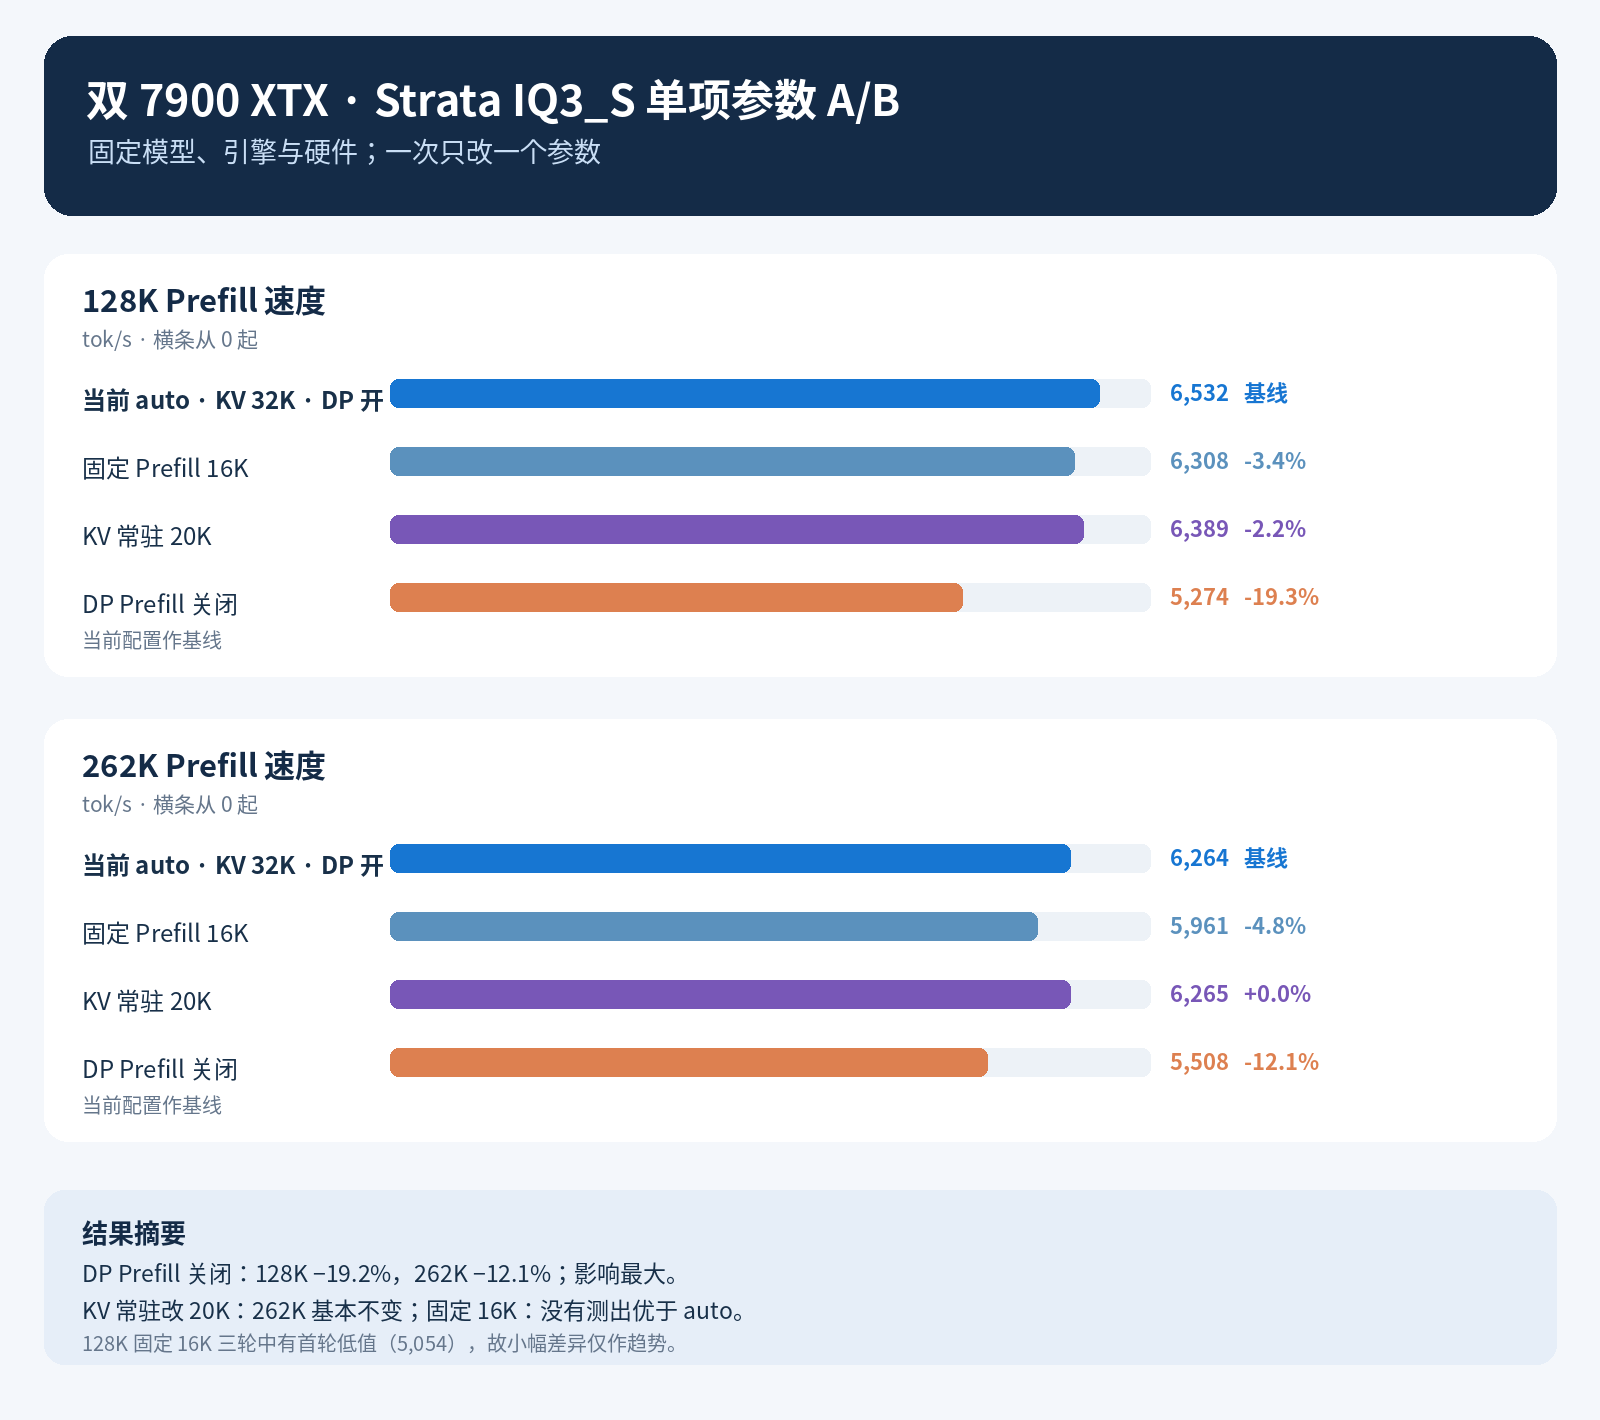
目前的判断:
- DP Prefill 有明显收益。 关闭后 128K 和 262K Prefill 分别下降约 19% 和 12%;保留开启。
- KV 常驻从 32K 降到 20K 没有可见 Prefill 收益。 262K 几乎完全相同,继续使用 32K。
- 固定 16K 分块没有显示出比 auto 更快。 262K 低约 4.8%;128K 中位数低约 3.4%,但首轮较慢、后两轮聚集在约 6.3K,和 auto 的运行范围有重叠。这部分只看作趋势,当前保留 auto。
复测方法与边界
优化前后正式上下文测试均为冷提示、缓存命中 0、每轮生成 256 tokens,每档两轮取中位数。262K 实际输入为 261,880 tokens。逐项 A/B 使用当前 RDNA3 fork,128K 的 auto 和固定 16K 补测各三轮,其余单项每档两轮。固定 16K 128K 组首轮明显低于后两轮,所以表中给中位数和图中范围,并避免把小幅差距解读成确定优势。
前后版本的总提升仍属于整套引擎与配置的综合成绩;这里的 A/B 只估计当前 fork 内三个开关的独立影响。它不能把旧版 0.1.45 到 RDNA3 fork 的全部提升分摊给这几个参数。长时间稳定性还没有做。
测试平台:Ryzen 5 7500F、双 RX 7900 XTX(gfx1100)、96 GB RAM、HIP;Qwen3.8-Flash-Next GSQ-RCO IQ3_S;262,144 context;INT8 KV;显存预留 2 GiB。优化前数据及调优说明来自前一轮六档测试,优化后数据来自 RDNA3 fork 七档测试。
-
-
-
-
-
-
-
-
-
@懒人烘培 我机子上运行的strata两轮调优都是跟着你的方案走的。区别的是pp 6000 token/秒是属于单任务的极限优化。我这边是两组两槽最高四任务并发。所以 做不了这么极致。但从数据上说,也是非常 不错了。
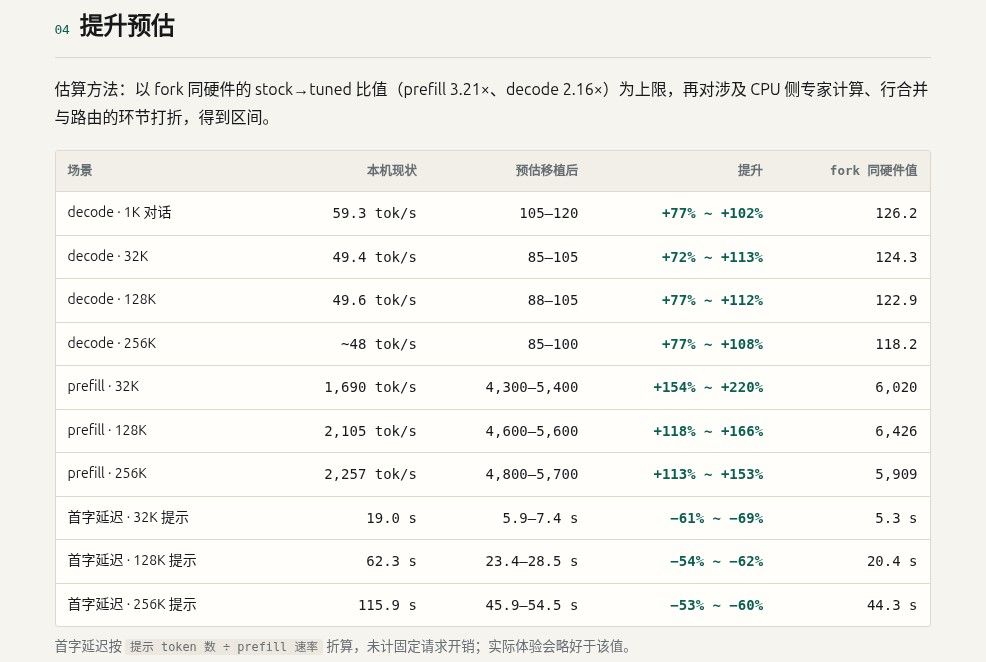
给你这边做个补充,走你这边优化路线多任务并发的优化数据。你不用特地去跑了。
-
@懒人烘培 我机子上运行的strata两轮调优都是跟着你的方案走的。区别的是pp 6000 token/秒是属于单任务的极限优化。我这边是两组两槽最高四任务并发。所以 做不了这么极致。但从数据上说,也是非常 不错了。
给你这边做个补充,走你这边优化路线多任务并发的优化数据。你不用特地去跑了。
-
-
@懒人烘培 謝謝! 我的設置基本上同你一樣但是如果我 GPU_MAX_HW_QUEUES=8 就會發生空轉問題, 就算strata 不在運作中GPU仍然會100% load, 但如果我將GPU_MAX_HW_QUEUES=6就不會有空轉問題, 你有同樣的問題嗎? 先多謝師兄指教
@Eric-Seto 刚刚实测,沿用本机 Strata RDNA3 0.1.43 配置,只临时改变队列数。每组完成两次生成,生成结束后各观察 45 秒,结果如下(中位数):
状态 GPU0 占用 / 功耗 GPU1 占用 / 功耗 Strata 未启动 1% / 11 W 0% / 19 W GPU_MAX_HW_QUEUES=8,生成结束100% / 69 W 100% / 106 W GPU_MAX_HW_QUEUES=6,生成结束100% / 77 W 0% / 18 W Strata 进程退出后 1% / 14 W 0% / 20 W 我这边双 7900 XTX 也复现了。设为 8,生成结束后双卡仍持续显示 100% 占用;改为 6,第二张卡恢复空闲,但第一张卡仍显示 100%。关闭 Strata 进程后两张卡都恢复正常。功耗也明显下降,因此不只是占用率显示的问题。
双 7900 XTX:模型本地跑,Token 随便烧!
-
@Eric-Seto 刚刚实测,沿用本机 Strata RDNA3 0.1.43 配置,只临时改变队列数。每组完成两次生成,生成结束后各观察 45 秒,结果如下(中位数):
状态 GPU0 占用 / 功耗 GPU1 占用 / 功耗 Strata 未启动 1% / 11 W 0% / 19 W GPU_MAX_HW_QUEUES=8,生成结束100% / 69 W 100% / 106 W GPU_MAX_HW_QUEUES=6,生成结束100% / 77 W 0% / 18 W Strata 进程退出后 1% / 14 W 0% / 20 W 我这边双 7900 XTX 也复现了。设为 8,生成结束后双卡仍持续显示 100% 占用;改为 6,第二张卡恢复空闲,但第一张卡仍显示 100%。关闭 Strata 进程后两张卡都恢复正常。功耗也明显下降,因此不只是占用率显示的问题。
-
@懒人烘培 我去,我还以为我上面的显卡温度太高被烤出毛病了,原来大家都有这个情况。。。哈哈
-
@Simon-Li-0 不得,显卡没有这么脆弱,刚使用双7900XTX的时候,由于没有控制好温度,一卡长时间在110°满载,最后优化后就好了。
-
@懒人烘培 我上面这张卡100+,下面的才80+,正常能差15-20度
-
@Simon-Li-0 哦,你那只要不几个小时连续满载,应该问题不大,夏天温度应该还要高点。可以把单卡功率锁定在300W或者250W试试,看看温度有没有改善
@懒人烘培 用strata非常合适,他不会一直满功耗,双卡27B是真顶不住,跑起来就直接110度纹丝不动。

-
@Simon-Li-0 不得,显卡没有这么脆弱,刚使用双7900XTX的时候,由于没有控制好温度,一卡长时间在110°满载,最后优化后就好了。
-
@Eric-Seto 不是的,烘焙老哥在说我的显卡温度高的问题,这个空转问题是另一回事,还没找到怎么解决
-