
移植Strata技术路线到vLLM以适配R9700并让Flash Next真正带并发可用!
-
-
-
-
本轮:按 Strata 逻辑把"频率热集"钉进显存,4 路从 24.7 秒降到 20 秒
实现
- 用 139 万 token 的真实路由统计算出每个专家的命中频率,生成四档热集(
/data/paiton-full/hot_set.json:2000 / 4000 / 6000 / 8000 个专家,含每层具体 id); - 启动后按层把热专家的 gu/dn 码本一次性搬进显存并常驻(不是 LRU,是频率钉死);
- 推理时热专家直接命中显存,冷专家才走原来的搬运路径;
- vLLM 的
--gpu-memory-utilization从 0.72 降到 0.60,给热集腾出空间。
实测(4000 档,7.4 GiB,理论覆盖率 34.3%)
指标 之前(LRU 2GB) 现在(频率热集 4000) 4 路 32 token 24.7 s 20.0 s 聚合吞吐 1.30 tok/s 1.60 tok/s MoE 每 block 17-19 ms 14.5-17.3 ms 质量 Paris Paris(四路全对) 这个结果说明了什么
- 热集确实有效,但只快了 23%,和"搬运只占 1.2 ms"的估算吻合:MoE 的 850 ms 里,真正搬运只占一成多,剩下全是"每个专家一次 Python 调用 + 一次内核 launch";
- 也就是说:Strata 的分层逻辑我们已经复刻了(热集常驻 + 按需取冷),但它治不了我们的主要瓶颈;
- 要再上一个量级,必须把"每层 10 个专家"合并成一次内核调用——即前面写好、但存在 0.02-0.13 数值差异的 grouped 内核。
下一轮
- 在热集已常驻的前提下,把 grouped 内核接回来(此时不需要拷贝,纯计算,最有条件跑对);
- 用"同一前向内 grouped vs 逐专家"的对照继续定位那 0.02-0.13;
- 目标:MoE 从 15 ms/block 降到 2-3 ms/block,单流进入 0.3-0.4 s/token,4 路聚合 3-4 tok/s。
- 用 139 万 token 的真实路由统计算出每个专家的命中频率,生成四档热集(
-
-
-
-
本轮:锁页 staging 生效,MoE 快了 7 倍,4 路聚合翻倍
1. 先做离线拆解,找到了真正的大头
离线基准(15 个活跃专家,稳态):
阶段 页内存(原路径) 锁页 staging(新路径) CPU gather 5.4 ms 1.07 ms( index_select直接写入锁页缓冲)H2D 拷贝 4.4 ms(实为 4 GB/s) 1.46 ms(≈13 GB/s,async) Triton 内核 0.8 ms 0.8 ms 合计 约 17 ms 约 3.3 ms 根因:页内存的 H2D 只有 4 GB/s(理论 13.8),且 CPU gather 每次都在 314 MB 的大张量上随机取行、cache 不友好。
2. 模型内实测(单卡、无热集、util 0.60)
指标 改前 改后 提升 MoE 每 block 42-47 ms 5.8-6.3 ms 7 倍 单流 8 token 11.3 s 8.4 s 1.35 倍 4 路 32 token 31.8 s 15.5 s 2.05 倍 4 路聚合 1.01 tok/s 2.06 tok/s 2 倍 单流 0.71 tok/s 0.95 tok/s — 四路输出全部正确(Paris)。
3. 现在的瓶颈已经换人了
单 token 拆解:MoE ≈ 288 ms(48 层 × 6 ms),总耗时 ≈ 1,050 ms → 非 MoE 部分约 760 ms(注意力 / HC 混合 / 框架开销)也就是说:MoE 不再是主要矛盾,下一步要看那 760 ms 花在哪。最可疑的是:
- 我们测试容器里禁用了 Paiton 平台插件(
VLLM_DISABLE_PAITON_PLATFORM=1),GDN 线性注意力的优化内核全部没生效; - HC 混合(10240 维的多流状态)在 eager 模式下没有融合。
4. 下一轮
- 用 CUDA event 把"非 MoE 部分"按模块拆开(block 整体 vs MoE 占比,再逐段插桩);
- 如果确认是 GDN 注意力,就尝试在保留我们 MoE 补丁的前提下,把 Paiton 的 GDN 优化内核重新打开(这是纯配置/加载顺序问题)。
状态
paiton-8080 正在自启(约 5 分钟就绪) strata-8080 已停、已禁自启 vLLM 改造:MoE 6 ms/层、4 路 2.06 tok/s(历史最好) - 我们测试容器里禁用了 Paiton 平台插件(
-
-
這種奮鬥精神,以及疲累,只有爆肝的人了解....感謝大神們給我抄作業
@David-Chen
对,越做坑越大。虽然流程是跑通了,但是现在我另外评估了一下,好像也就做了25~30%的样子。 -
@David-Chen
对,越做坑越大。虽然流程是跑通了,但是现在我另外评估了一下,好像也就做了25~30%的样子。 -
@terry
感谢,这个要是做成了意义还是挺大的,所以说我先好好搞搞,哪怕做不成也算是给后来的大神们探个路了。 -
-
@fcme 你有AI,你本身也懂AI,一定能搞好。建议你把项目代码通过Git管理,推不动的时候换Agent,Codex+DSH+Hermes就行。你想想,你做好了,你就开个频道,就讲着一个项目,我给你推推。做不好,你就当业余锻炼了,提升自己的眼界。如果你有困难,发出来,论坛大神搞不好也能帮你。
-
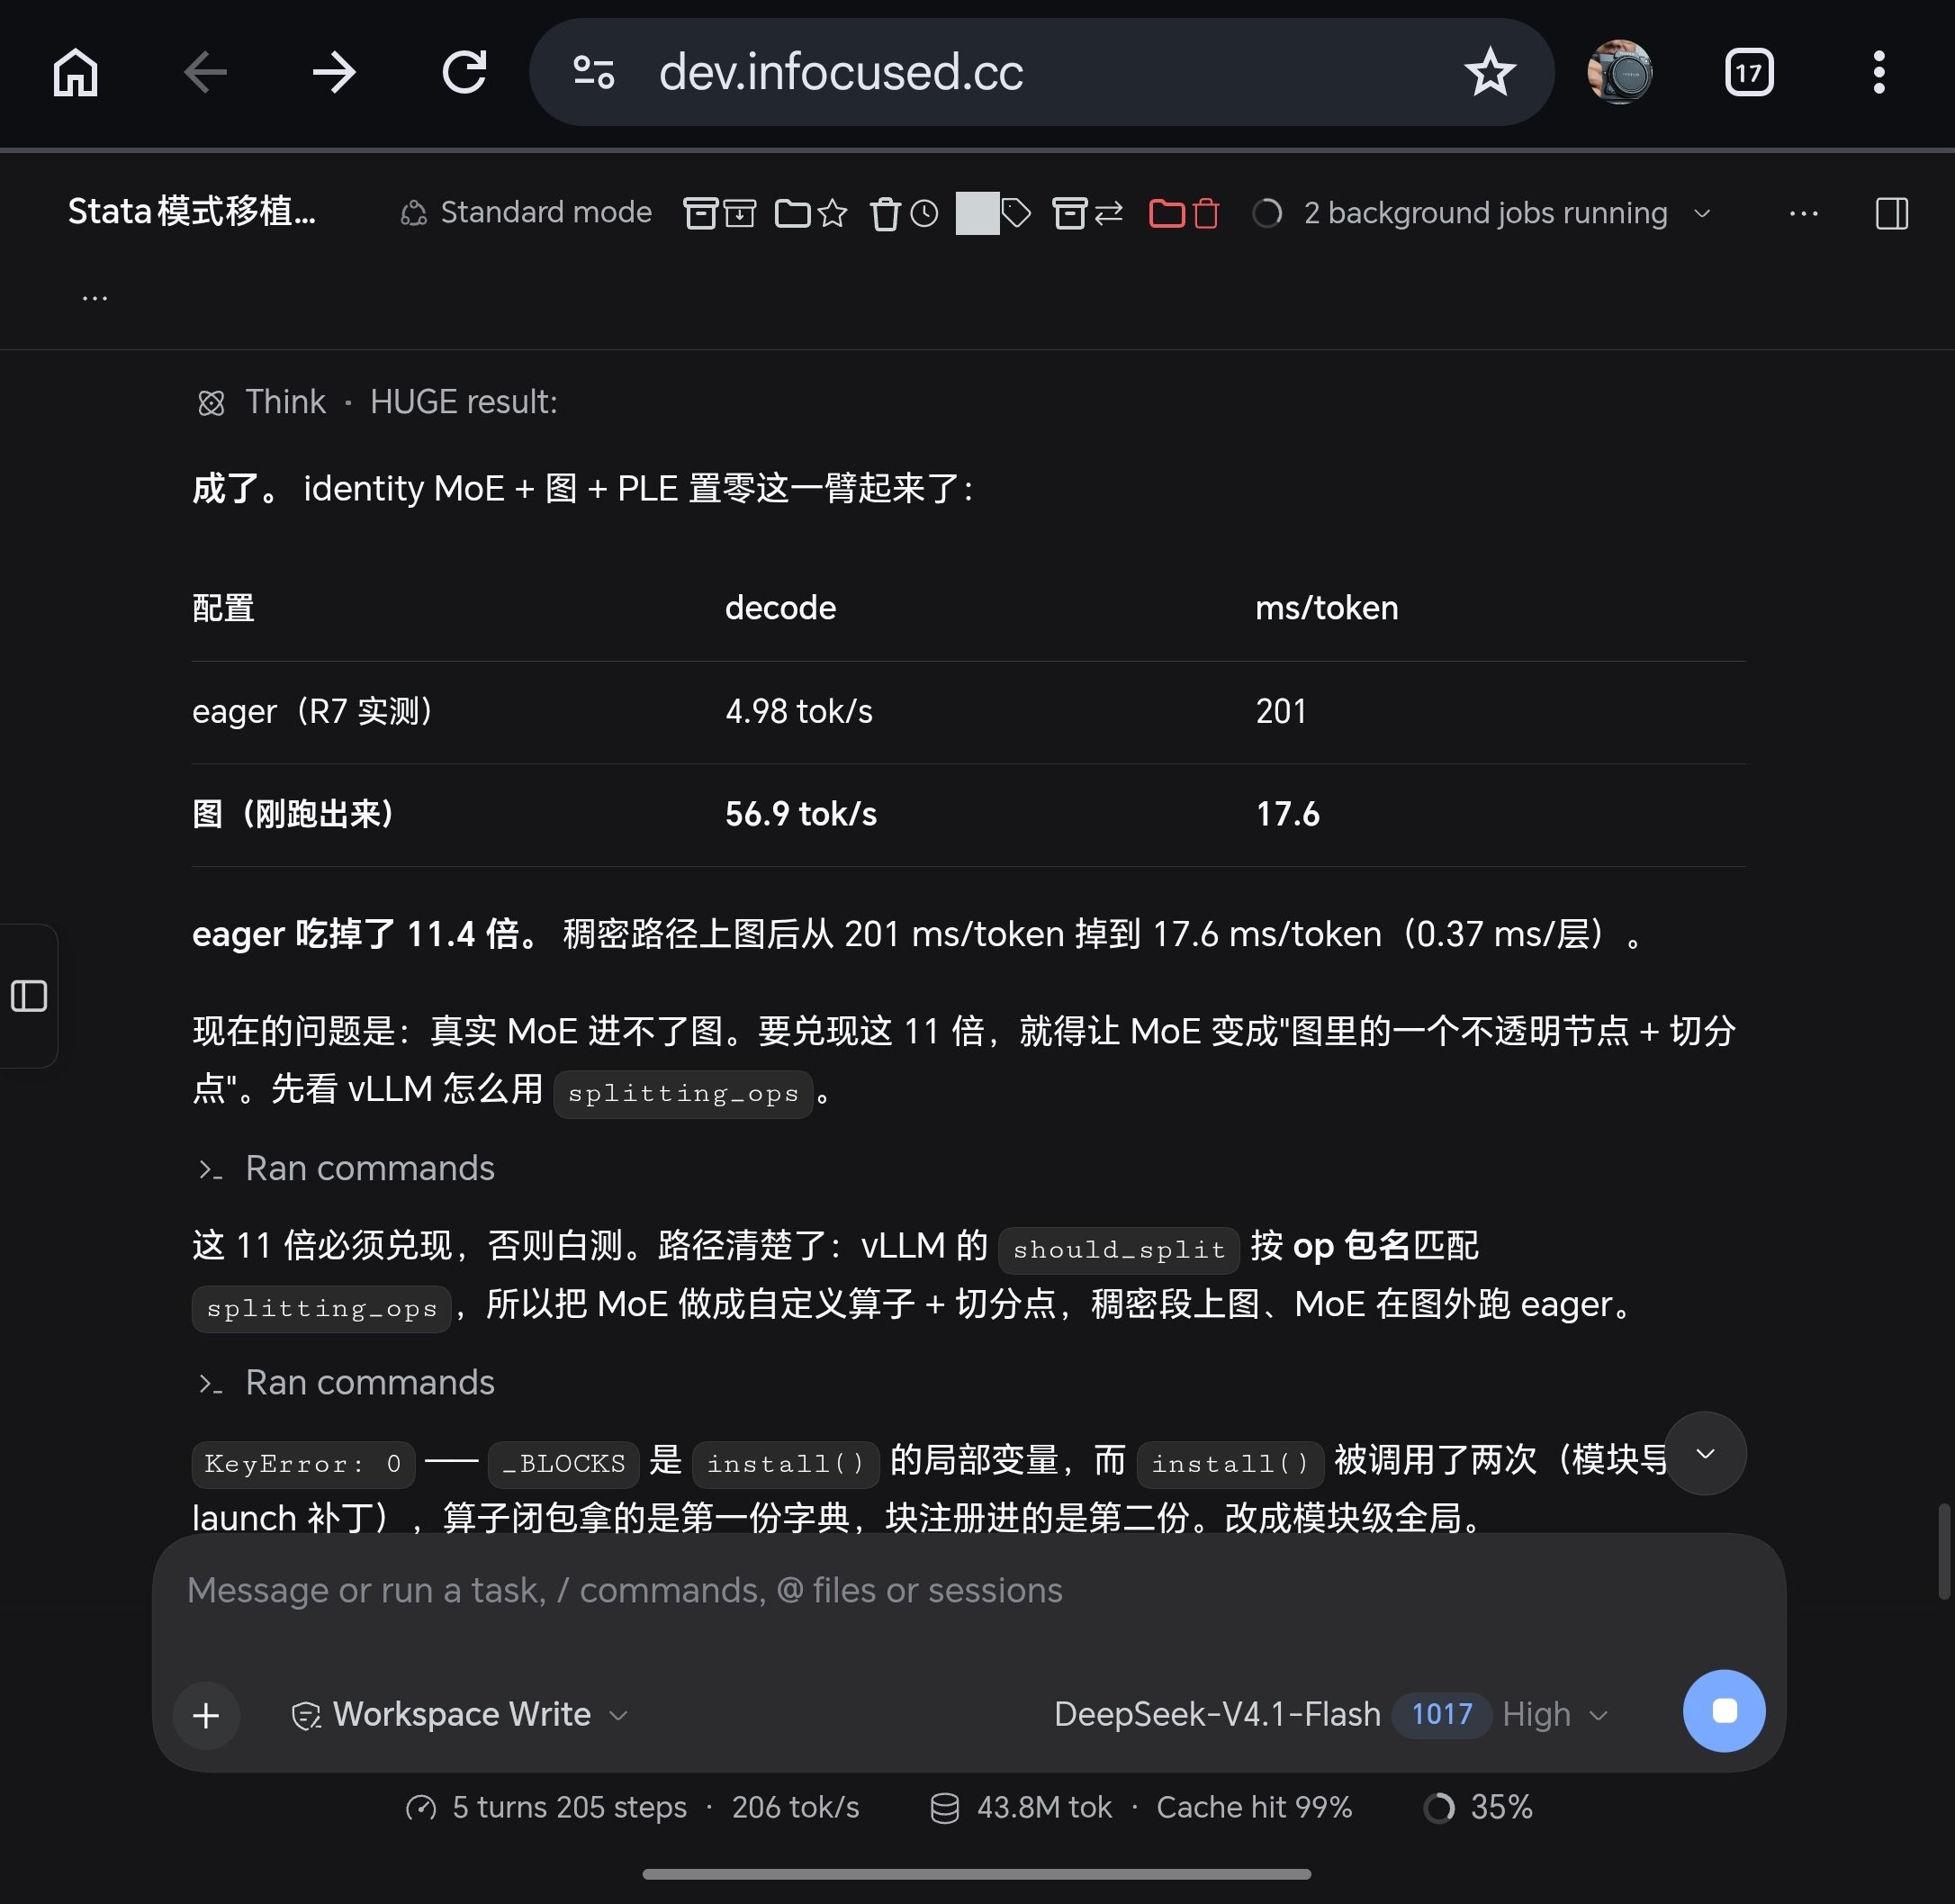
我的天呐!哈哈哈

-
-
@fcme 炼丹大成

@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊 -
-
@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊 -
@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊




 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!
