跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 移植Strata技术路线到vLLM以适配R9700并让Flash Next真正带并发可用!

移植Strata技术路线到vLLM以适配R9700并让Flash Next真正带并发可用!

已定时 已固定 已锁定 已移动 精华 热议 LLM讨论区
r9700stratavllm
47 帖子 16 发布者 1.4k 浏览 3 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • fcmeF
    fcmeF
    fcme
    王侯将相
    编写于 最后由 编辑
    #24

    本轮:锁页 staging 生效,MoE 快了 7 倍,4 路聚合翻倍

    1. 先做离线拆解,找到了真正的大头

    离线基准(15 个活跃专家,稳态):

    阶段 页内存(原路径) 锁页 staging(新路径)
    CPU gather 5.4 ms 1.07 ms(index_select 直接写入锁页缓冲)
    H2D 拷贝 4.4 ms(实为 4 GB/s) 1.46 ms(≈13 GB/s,async)
    Triton 内核 0.8 ms 0.8 ms
    合计 约 17 ms 约 3.3 ms

    根因:页内存的 H2D 只有 4 GB/s(理论 13.8),且 CPU gather 每次都在 314 MB 的大张量上随机取行、cache 不友好。

    2. 模型内实测(单卡、无热集、util 0.60)

    指标 改前 改后 提升
    MoE 每 block 42-47 ms 5.8-6.3 ms 7 倍
    单流 8 token 11.3 s 8.4 s 1.35 倍
    4 路 32 token 31.8 s 15.5 s 2.05 倍
    4 路聚合 1.01 tok/s 2.06 tok/s 2 倍
    单流 0.71 tok/s 0.95 tok/s —

    四路输出全部正确(Paris)。

    3. 现在的瓶颈已经换人了

    单 token 拆解:MoE ≈ 288 ms(48 层 × 6 ms),总耗时 ≈ 1,050 ms
    → 非 MoE 部分约 760 ms(注意力 / HC 混合 / 框架开销)
    

    也就是说:MoE 不再是主要矛盾,下一步要看那 760 ms 花在哪。最可疑的是:

    1. 我们测试容器里禁用了 Paiton 平台插件(VLLM_DISABLE_PAITON_PLATFORM=1),GDN 线性注意力的优化内核全部没生效;
    2. HC 混合(10240 维的多流状态)在 eager 模式下没有融合。

    4. 下一轮

    1. 用 CUDA event 把"非 MoE 部分"按模块拆开(block 整体 vs MoE 占比,再逐段插桩);
    2. 如果确认是 GDN 注意力,就尝试在保留我们 MoE 补丁的前提下,把 Paiton 的 GDN 优化内核重新打开(这是纯配置/加载顺序问题)。

    状态

    paiton-8080 正在自启(约 5 分钟就绪)
    strata-8080 已停、已禁自启
    vLLM 改造:MoE 6 ms/层、4 路 2.06 tok/s(历史最好)
    

    个人的repo,欢迎指教
    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

    1 条回复 最后回复
    0
    • perterP perter

      @fcme 不明觉厉

      fcmeF
      fcmeF
      fcme
      王侯将相
      编写于 最后由 编辑
      #25

      @perter
      挑战还是相当大的。越做发现坑越大

      个人的repo,欢迎指教
      https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
      https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

      1 条回复 最后回复
      0
      • David ChenD David Chen

        這種奮鬥精神,以及疲累,只有爆肝的人了解....感謝大神們給我抄作業

        fcmeF
        fcmeF
        fcme
        王侯将相
        编写于 最后由 编辑
        #26

        @David-Chen
        对,越做坑越大。虽然流程是跑通了,但是现在我另外评估了一下,好像也就做了25~30%的样子。

        个人的repo,欢迎指教
        https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

        terryT 1 条回复 最后回复
        0
        • fcmeF fcme

          @David-Chen
          对,越做坑越大。虽然流程是跑通了,但是现在我另外评估了一下,好像也就做了25~30%的样子。

          terryT
          terryT
          terry
          易有太极
          编写于 最后由 编辑
          #27

          @fcme 我抽空给你的几个项目做个专页,你继续开源,我在视频里找时间给你系统介绍下,这个项目就挺好。

          油管:https://www.youtube.com/@抡锤者

          fcmeF 1 条回复 最后回复
          0
          • terryT terry

            @fcme 我抽空给你的几个项目做个专页,你继续开源,我在视频里找时间给你系统介绍下,这个项目就挺好。

            fcmeF
            fcmeF
            fcme
            王侯将相
            编写于 最后由 编辑
            #28

            @terry
            感谢,这个要是做成了意义还是挺大的,所以说我先好好搞搞,哪怕做不成也算是给后来的大神们探个路了。

            个人的repo,欢迎指教
            https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

            terryT 1 条回复 最后回复
            0
            • fcmeF fcme

              @terry
              感谢,这个要是做成了意义还是挺大的,所以说我先好好搞搞,哪怕做不成也算是给后来的大神们探个路了。

              terryT
              terryT
              terry
              易有太极
              编写于 最后由 terry 编辑
              #29

              @fcme 你有AI,你本身也懂AI,一定能搞好。建议你把项目代码通过Git管理,推不动的时候换Agent,Codex+DSH+Hermes就行。你想想,你做好了,你就开个频道,就讲着一个项目,我给你推推。做不好,你就当业余锻炼了,提升自己的眼界。如果你有困难,发出来,论坛大神搞不好也能帮你。

              油管:https://www.youtube.com/@抡锤者

              fcmeF 1 条回复 最后回复
              1
              • terryT terry

                @fcme 你有AI,你本身也懂AI,一定能搞好。建议你把项目代码通过Git管理,推不动的时候换Agent,Codex+DSH+Hermes就行。你想想,你做好了,你就开个频道,就讲着一个项目,我给你推推。做不好,你就当业余锻炼了,提升自己的眼界。如果你有困难,发出来,论坛大神搞不好也能帮你。

                fcmeF
                fcmeF
                fcme
                王侯将相
                编写于 最后由 编辑
                #30

                @terry
                嗯,确实。我先自己啃啃吧,争取还是能搞定了,造福部分amd玩家。

                个人的repo,欢迎指教
                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                1 条回复 最后回复
                1
                • fcmeF
                  fcmeF
                  fcme
                  王侯将相
                  编写于 最后由 编辑
                  #31

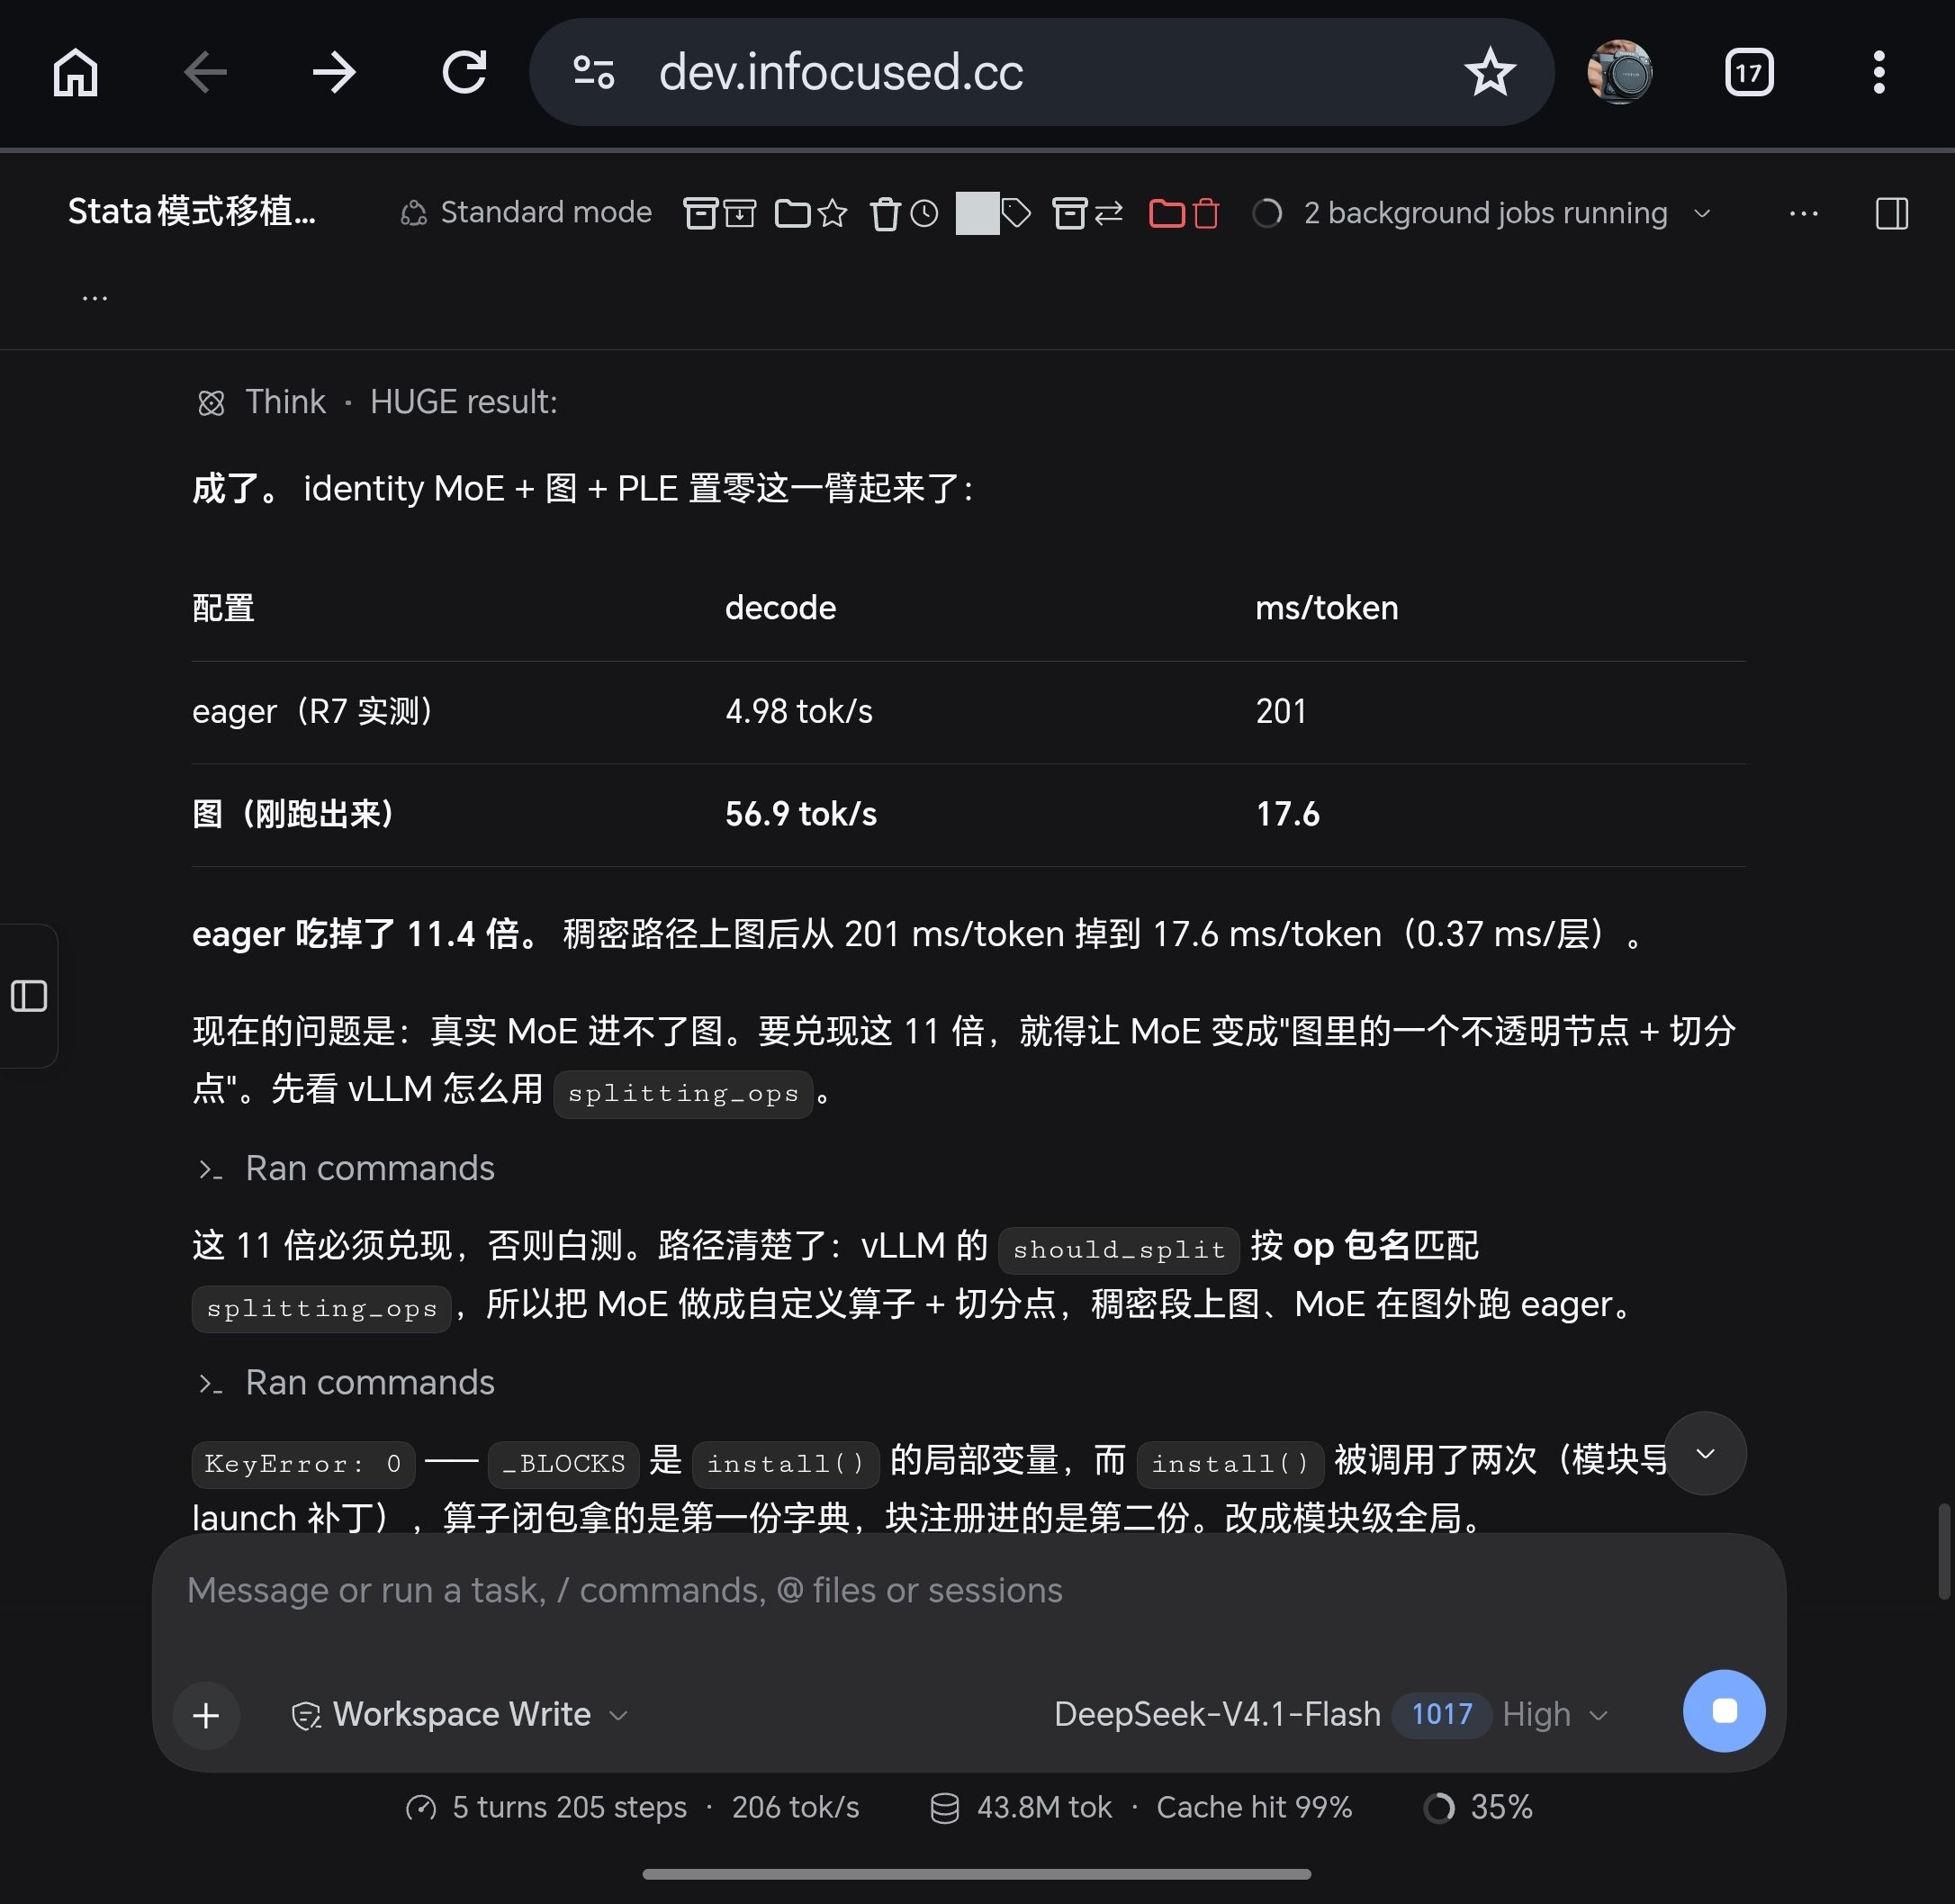
                  我的天呐!哈哈哈😁

                  Screenshot_20261031_213317_com_android_chrome_ChromeTabbedActivity.jpg

                  个人的repo,欢迎指教
                  https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                  https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                  xiongjie gaoX E 2 条回复 最后回复
                  1
                  • fcmeF fcme

                    我的天呐!哈哈哈😁

                    Screenshot_20261031_213317_com_android_chrome_ChromeTabbedActivity.jpg

                    xiongjie gaoX
                    xiongjie gaoX
                    xiongjie gao
                    王侯将相
                    编写于 最后由 编辑
                    #32

                    @fcme 炼丹大成👍

                    https://github.com/shawn86574-prog/x99-7900xtx-p2p
                    https://github.com/shawn86574-prog/kuzuryusen

                    fcmeF 1 条回复 最后回复
                    0
                    • xiongjie gaoX xiongjie gao

                      @fcme 炼丹大成👍

                      fcmeF
                      fcmeF
                      fcme
                      王侯将相
                      编写于 最后由 编辑
                      #33

                      @xiongjie-gao
                      本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊

                      个人的repo,欢迎指教
                      https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                      https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                      xiongjie gaoX terryT 2 条回复 最后回复
                      0
                      • fcmeF fcme

                        我的天呐!哈哈哈😁

                        Screenshot_20261031_213317_com_android_chrome_ChromeTabbedActivity.jpg

                        E
                        E
                        Enigma
                        体面乡绅 硕果累累
                        编写于 最后由 Enigma 编辑
                        #34

                        @fcme 说:

                        我的天呐!哈哈哈😁

                        Screenshot_20261031_213317_com_android_chrome_ChromeTabbedActivity.jpg

                        太厉害了。人才辈出啊,等你打通后,坛里大神再移植到7900XTX,造福我们79族

                        fcmeF 1 条回复 最后回复
                        0
                        • fcmeF fcme

                          @xiongjie-gao
                          本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊

                          xiongjie gaoX
                          xiongjie gaoX
                          xiongjie gao
                          王侯将相
                          编写于 最后由 编辑
                          #35

                          @fcme deepseek4.1 1017版本编程能力升级了一大截,以前搞不定的事,现也许可以搞定了。

                          https://github.com/shawn86574-prog/x99-7900xtx-p2p
                          https://github.com/shawn86574-prog/kuzuryusen

                          1 条回复 最后回复
                          1
                          • fcmeF fcme

                            @xiongjie-gao
                            本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊

                            terryT
                            terryT
                            terry
                            易有太极
                            编写于 最后由 编辑
                            #36

                            @fcme 很好抓紧出作业和数据,多点截图,我剽窃一个视频。

                            油管:https://www.youtube.com/@抡锤者

                            1 条回复 最后回复
                            0
                            • E Enigma

                              @fcme 说:

                              我的天呐!哈哈哈😁

                              Screenshot_20261031_213317_com_android_chrome_ChromeTabbedActivity.jpg

                              太厉害了。人才辈出啊,等你打通后,坛里大神再移植到7900XTX,造福我们79族

                              fcmeF
                              fcmeF
                              fcme
                              王侯将相
                              编写于 最后由 编辑
                              #37

                              @Enigma
                              还是很有挑战的,目前还不能说乐观。当然如果能造福更多的a卡用户,那也是相当不错的的。

                              个人的repo,欢迎指教
                              https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                              https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                              1 条回复 最后回复
                              1
                              • fcmeF
                                fcmeF
                                fcme
                                王侯将相
                                编写于 最后由 编辑
                                #38

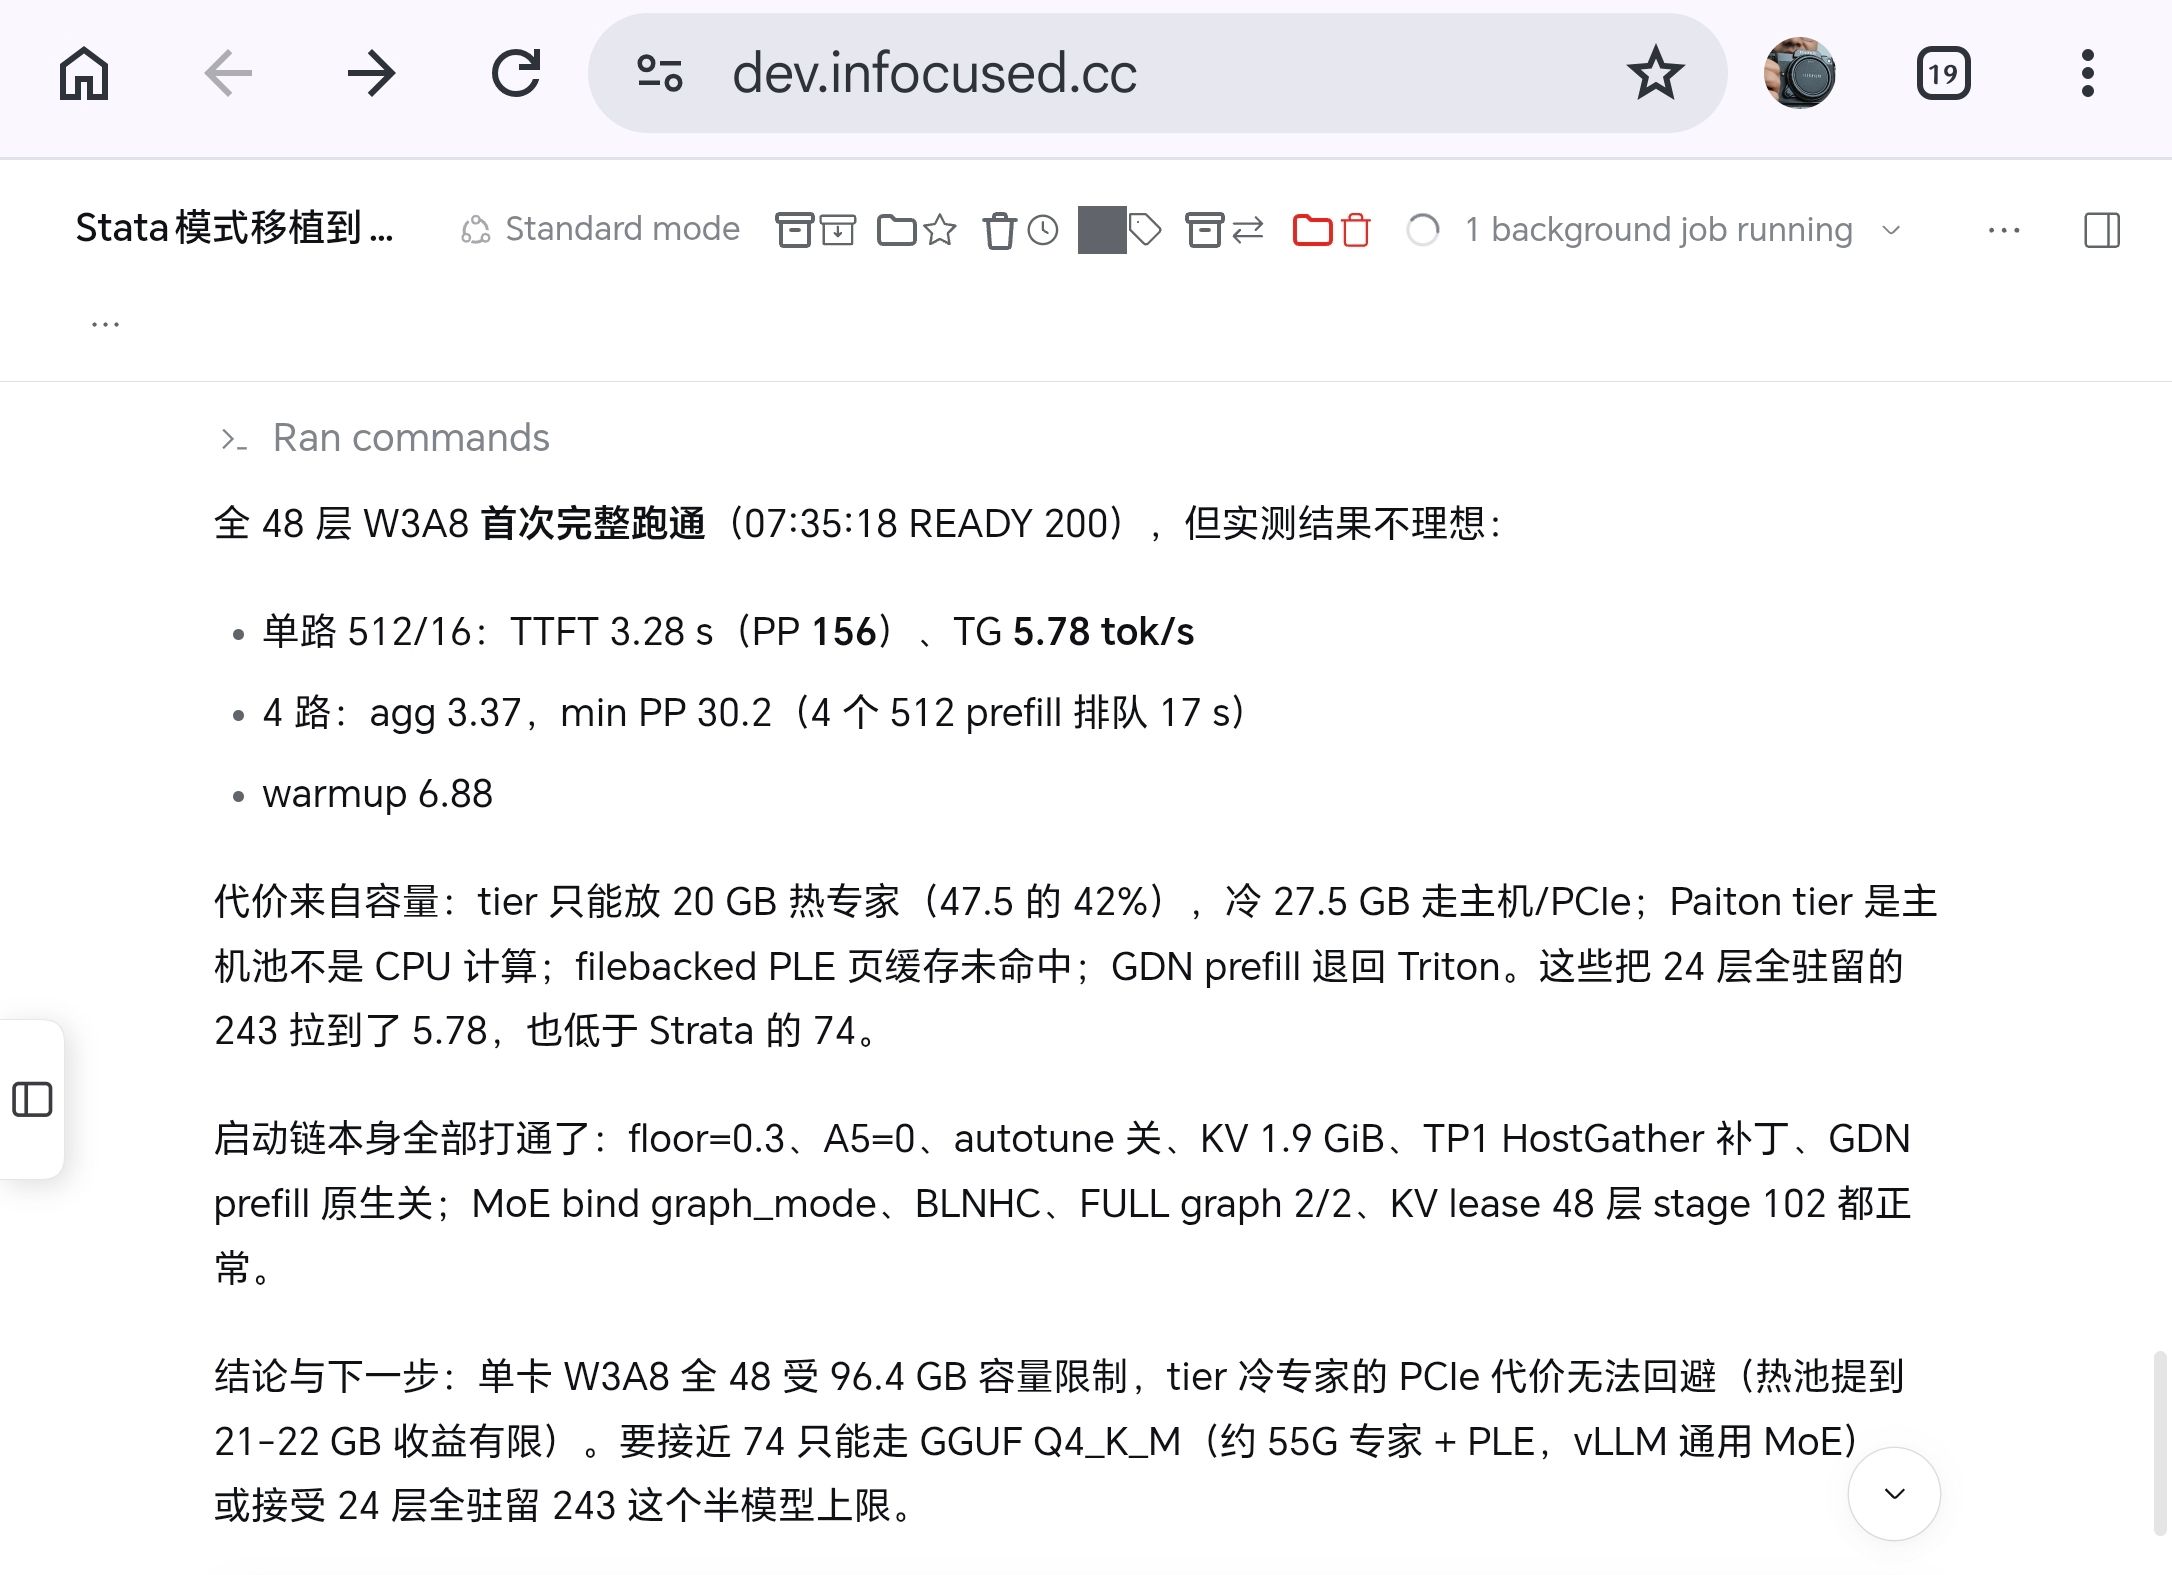
                                这太tm有挑战了😔

                                Screenshot_20261101_074434_com_android_chrome_ChromeTabbedActivity.jpg

                                个人的repo,欢迎指教
                                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                1 条回复 最后回复
                                0
                                • 张光璞张
                                  张光璞张
                                  张光璞
                                  贵族大夫 硕果累累
                                  编写于 最后由 编辑
                                  #39

                                  坐等老哥与大肥鱼攻克难关

                                  fcmeF 1 条回复 最后回复
                                  0
                                  • paul houP
                                    paul houP
                                    paul hou
                                    硕果累累 贵族大夫
                                    编写于 最后由 编辑
                                    #40

                                    @fcme 说:

                                    这太tm有挑战了

                                    https://github.com/Dyluhn/R9V

                                    記得這是最早用vllm+r9700+qfn的方案,參考看看。

                                    1 条回复 最后回复
                                    1
                                    • BunseiB
                                      BunseiB
                                      Bunsei
                                      王侯将相
                                      编写于 最后由 编辑
                                      #41

                                      你要是不嫌弃AI的话,我GPT还有点周限额,可以支援你一下。

                                      fcmeF 1 条回复 最后回复
                                      0
                                      • BunseiB Bunsei

                                        你要是不嫌弃AI的话,我GPT还有点周限额,可以支援你一下。

                                        fcmeF
                                        fcmeF
                                        fcme
                                        王侯将相
                                        编写于 最后由 编辑
                                        #42

                                        @Bunsei
                                        哦,感谢感谢,但是应该是用不上了。我下周末有空了再试试,平时工作也没时间。
                                        这周末这周末是探索性质到跑跑,探出来的全是死路。

                                        个人的repo,欢迎指教
                                        https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                        https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                        1 条回复 最后回复
                                        0
                                        • fcmeF
                                          fcmeF
                                          fcme
                                          王侯将相
                                          编写于 最后由 fcme 编辑
                                          #43

                                          一,Strata R9700单卡移植到vLLM跑Qwen3.8-Flash-Next这个周末项目目前宣告失败,但是还是探了很多不通的途径出来,如下:

                                          二、尝试过的路径与结果

                                          路径 1:官方 Paiton 原生栈(3-bit / 4-bit 镜像)

                                          配置 TG (tok/s) PP 4 路 agg
                                          3 层全驻留 174.28 6485 74.78
                                          6 层全驻留 163.51 5128 67.48
                                          24 层全驻留 243.32 1465 65.08
                                          全 48 + tier 20 5.78 156 3.37
                                          全 48 + tier 20 + eager 5.34 156 3.49
                                          Strata IQ3_XXS 参考 74 2069 —

                                          结论:24 层 243 是显存容量下的真实上限(3.3 倍 Strata);全 48 被 96.4 GB 权重卡死。

                                          路径 2:旧自定义 tiered 栈(tiered_qwen4.py)

                                          • CPU-all:2.04 tok/s;native 热混合:1.70 tok/s。
                                          • 结论:Python 模型跑不动,放弃。

                                          路径 3:vLLM走GGUF插件路线(Strata IQ3_XXS 71G)

                                          • 插件 HIP 移植成功(_C_gguf.so 编译通过,type 42 别名、block size 8);
                                          • 解析出 Strata 的 GSQ-RCO 是混合量化:ffn_gate/up 是 IQ2_XS/IQ3_S/IQ4_XS,ffn_down 是 type 42(2.25 bpw、72 字节块、640 行 = 2.5 块);
                                          • 结论:640 行 2.5 块的布局需要自定义 dequant 内核,标准插件吃不下,未跑通。

                                          路径 4:CPU 冷(Strata 的“分层计算”)

                                          • 3 层验证:CPU 冷 37.54 vs 纯 tier 90.34,慢 2.4 倍;
                                          • 全 48 从未跑完(挂载、设备、图捕获、/tmp 满等一连串配置错误)。
                                          • 结论:16 核 Xeon 上 CPU 算 3-bit 专家(138 µs/专家)不如 PCIe 搬权重,方向被证伪。

                                          路径 5:PLE 2-bit(方向错误,已纠正)

                                          • 转换成功:51.2 GB → 14.1 GB;3 层 q2 23.21(比 e4m3 慢);
                                          • 第一次 PPL 142.6(漏乘 row_scale),修正后未复测;
                                          • 结论:PLE 不是“模型权重”,不该压 2-bit;已停止并清理。

                                          路径 6:专家 2-bit(纠错上步,真正的“2-bit 全驻留”)

                                          • 3-bit dequant 布局用 bench_expert.c 验证:LEVEL=[-8,-5,-3,-1,1,3,5,8]、e4m3 scale/64、32 码/3 uint32;
                                          • 4 档 2-bit 的 cos(3bit,2bit)=0.598(偏低);
                                          • 3 层 2-bit 容器生成(3.1 GB,NFS);容量账 31.7+48.9+8=88.6 < 104,全驻留可行;
                                          • _Q2Experts 的 Python forward 连续 4 次失败(缺 load_fnq、设备不匹配、shared-expert 混设备),PPL 3222 跑的是旧路径。
                                          • 结论:存储层打通,质量未验证,核心结论空缺。

                                          三、目标达成情况

                                          指标 目标 实际
                                          TG ≥90 24 层 243、3 层 174、6 层 163 达标;全 48 5.34 未达
                                          PP ≥3000 3 层 6485、6 层 5128 达标;24 层 1465、全 48 156 未达
                                          4 路 agg ≥240 最好 74.78,未达
                                          不慢于 Strata 74 — 24 层/3 层/6 层达标;全 48 未达

                                          四、还有希望的方向(按性价比排序)

                                          1. 修 _Q2Experts 到纯 GPU 路径(只剩这一步就能拿到真实 2-bit PPL):

                                            • xr、g、dn 全部放 GPU,去掉 .cpu();
                                            • 和 shared-expert 的设备边界统一;
                                            • 预计 1-2 轮内能跑出数字,然后才知道 4 档 0.598 的 cos 到底崩不崩。
                                          2. 8 档 2-bit(每 32 元素一 scale):cos 可到 0.8+,体积仍远小于 3-bit(约 40 GB),是质量与容量的折中。

                                          3. GGUF IQ3_XXS 的自定义 dequant:640 行 2.5 块 + 混合类型,工作量大但能直接复用 Strata 的 71G 权重,理论 74 tok/s。

                                          4. 接受 3-bit 现状收尾:24 层 243 作为“半模型上限”,全 48 5.34 作为“104GB 硬件的真实天花板”。
                                          个人的repo,欢迎指教
                                          https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                                          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组