移植Strata技术路线到vLLM以适配R9700并让Flash Next真正带并发可用!
-
-
@fcme 你有AI,你本身也懂AI,一定能搞好。建议你把项目代码通过Git管理,推不动的时候换Agent,Codex+DSH+Hermes就行。你想想,你做好了,你就开个频道,就讲着一个项目,我给你推推。做不好,你就当业余锻炼了,提升自己的眼界。如果你有困难,发出来,论坛大神搞不好也能帮你。
-
我的天呐!哈哈哈

-
-
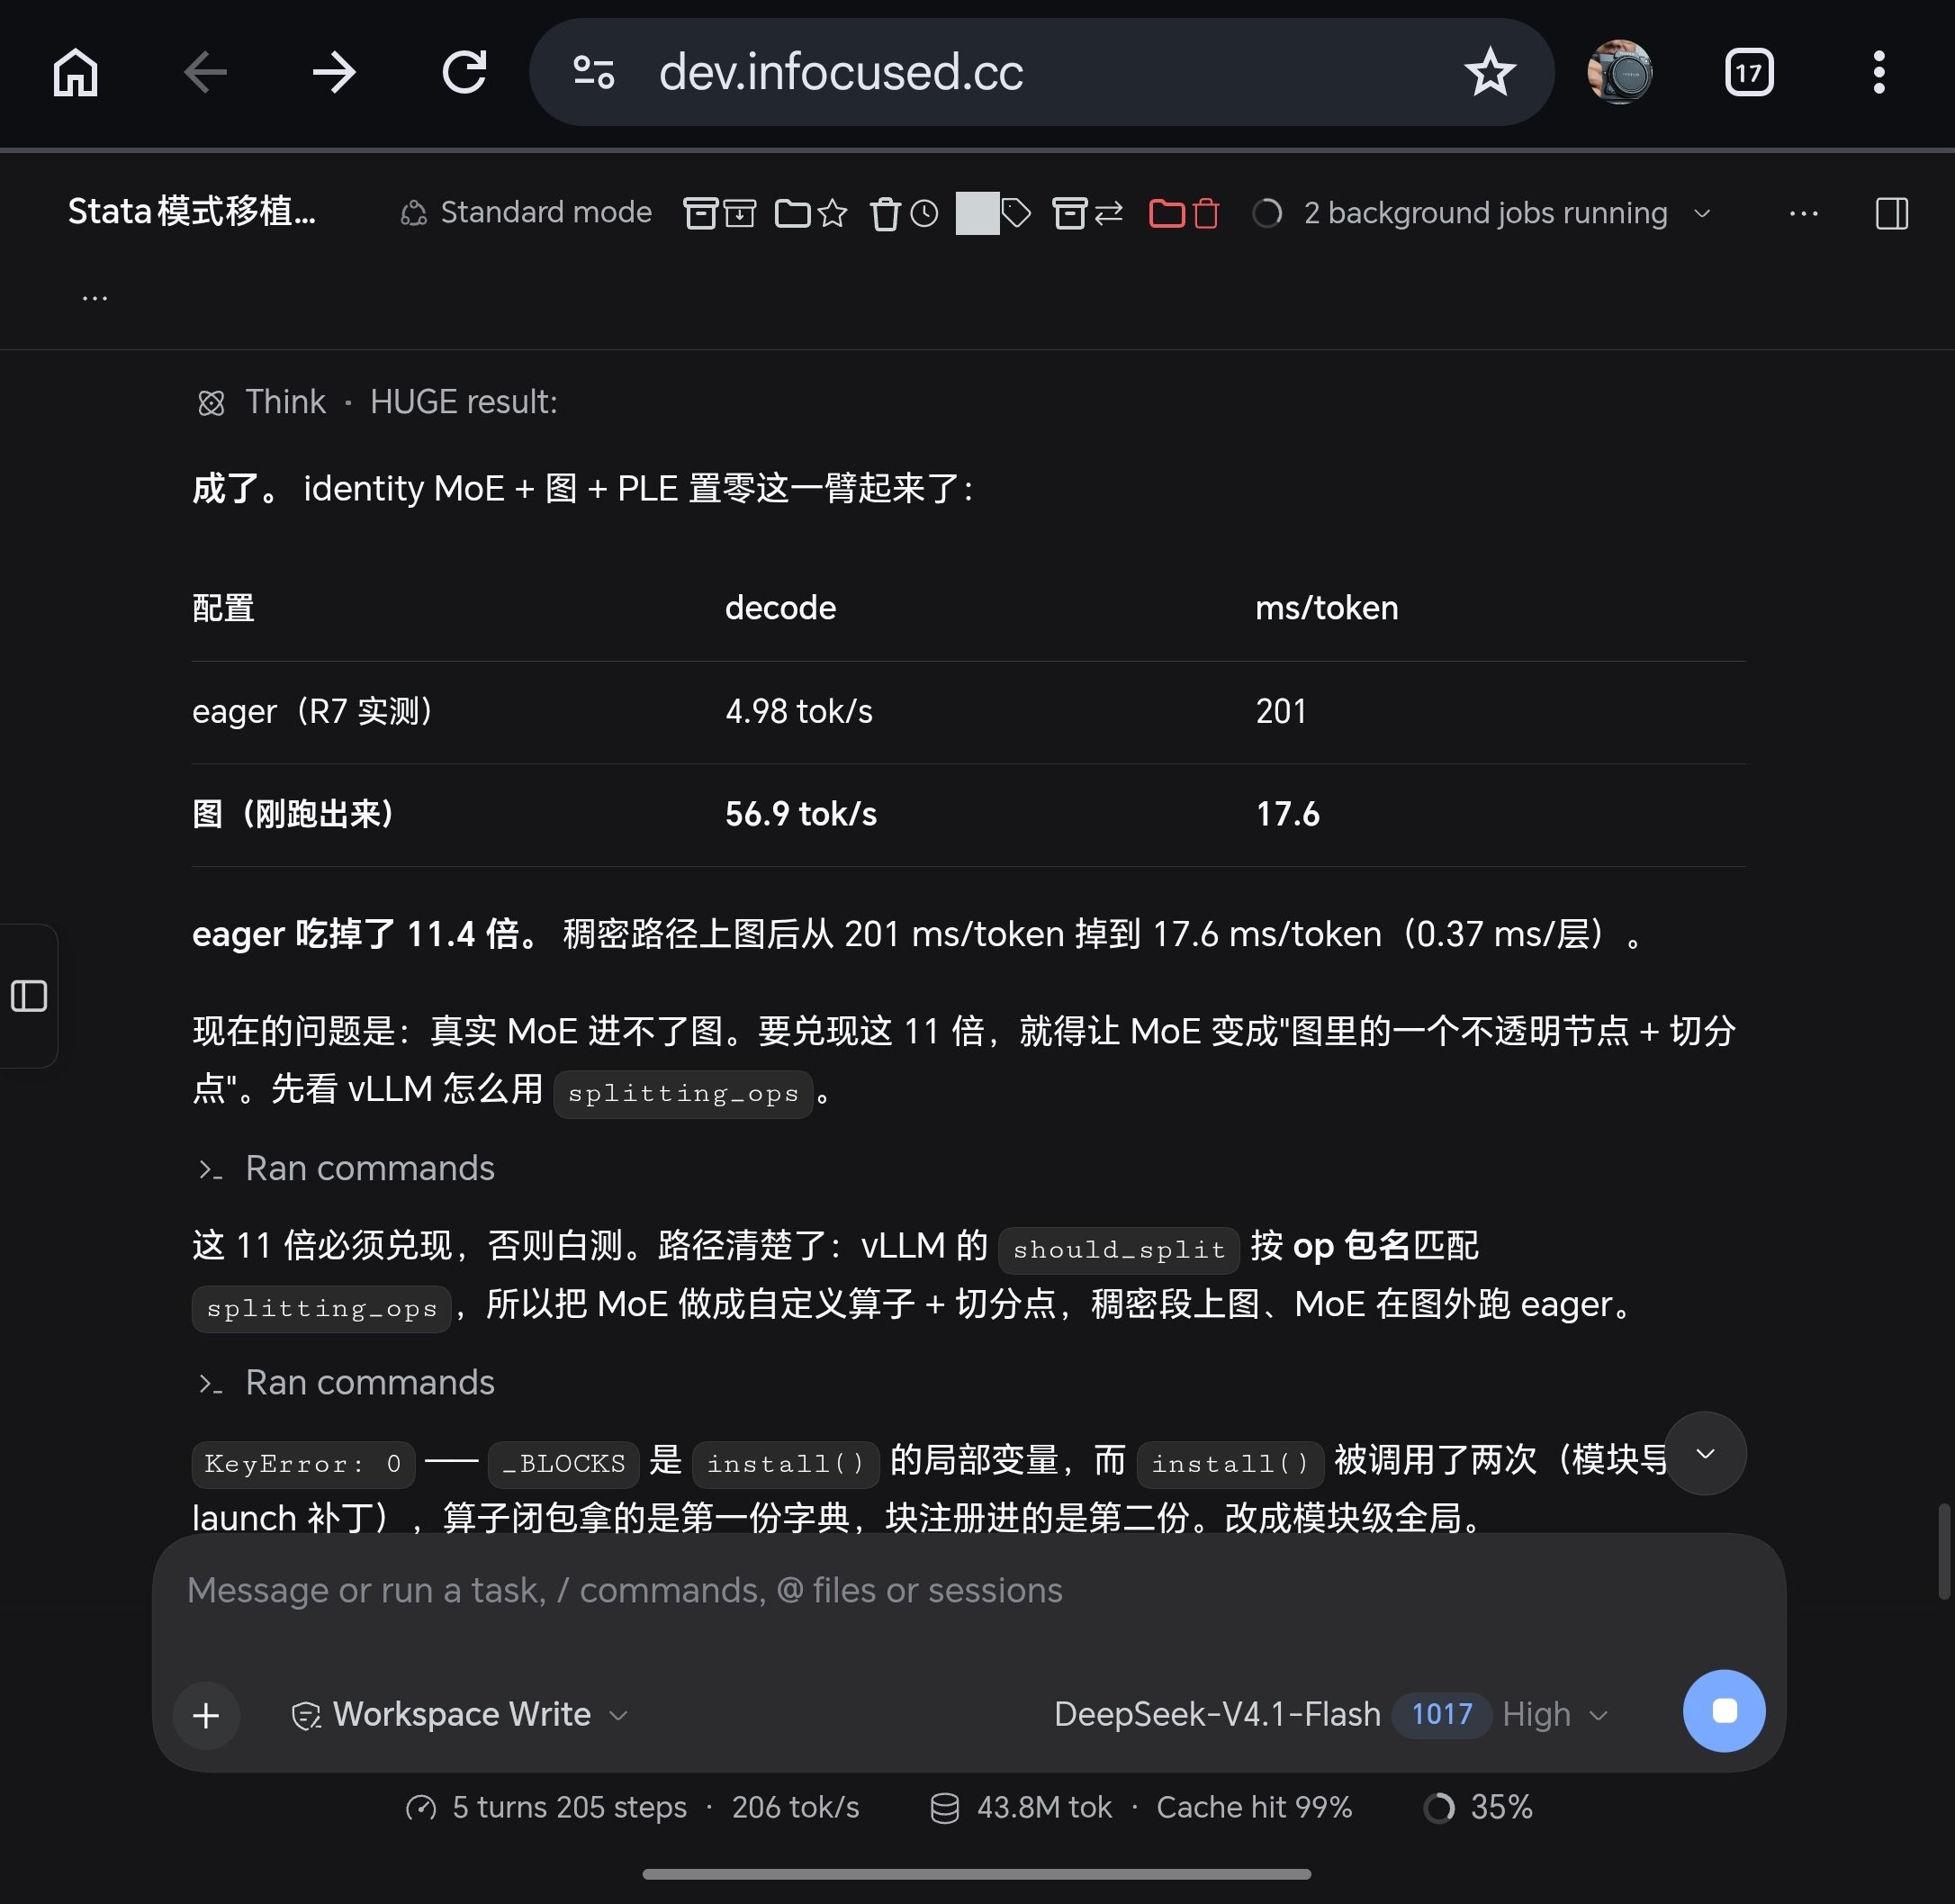
@fcme 炼丹大成

@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊 -
-
@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊 -
@xiongjie-gao
本来搞得我都没有信心了,好好梳理了一遍思路以后居然有新发现,还是要有耐心啊 -
-
-
-
-
-
-
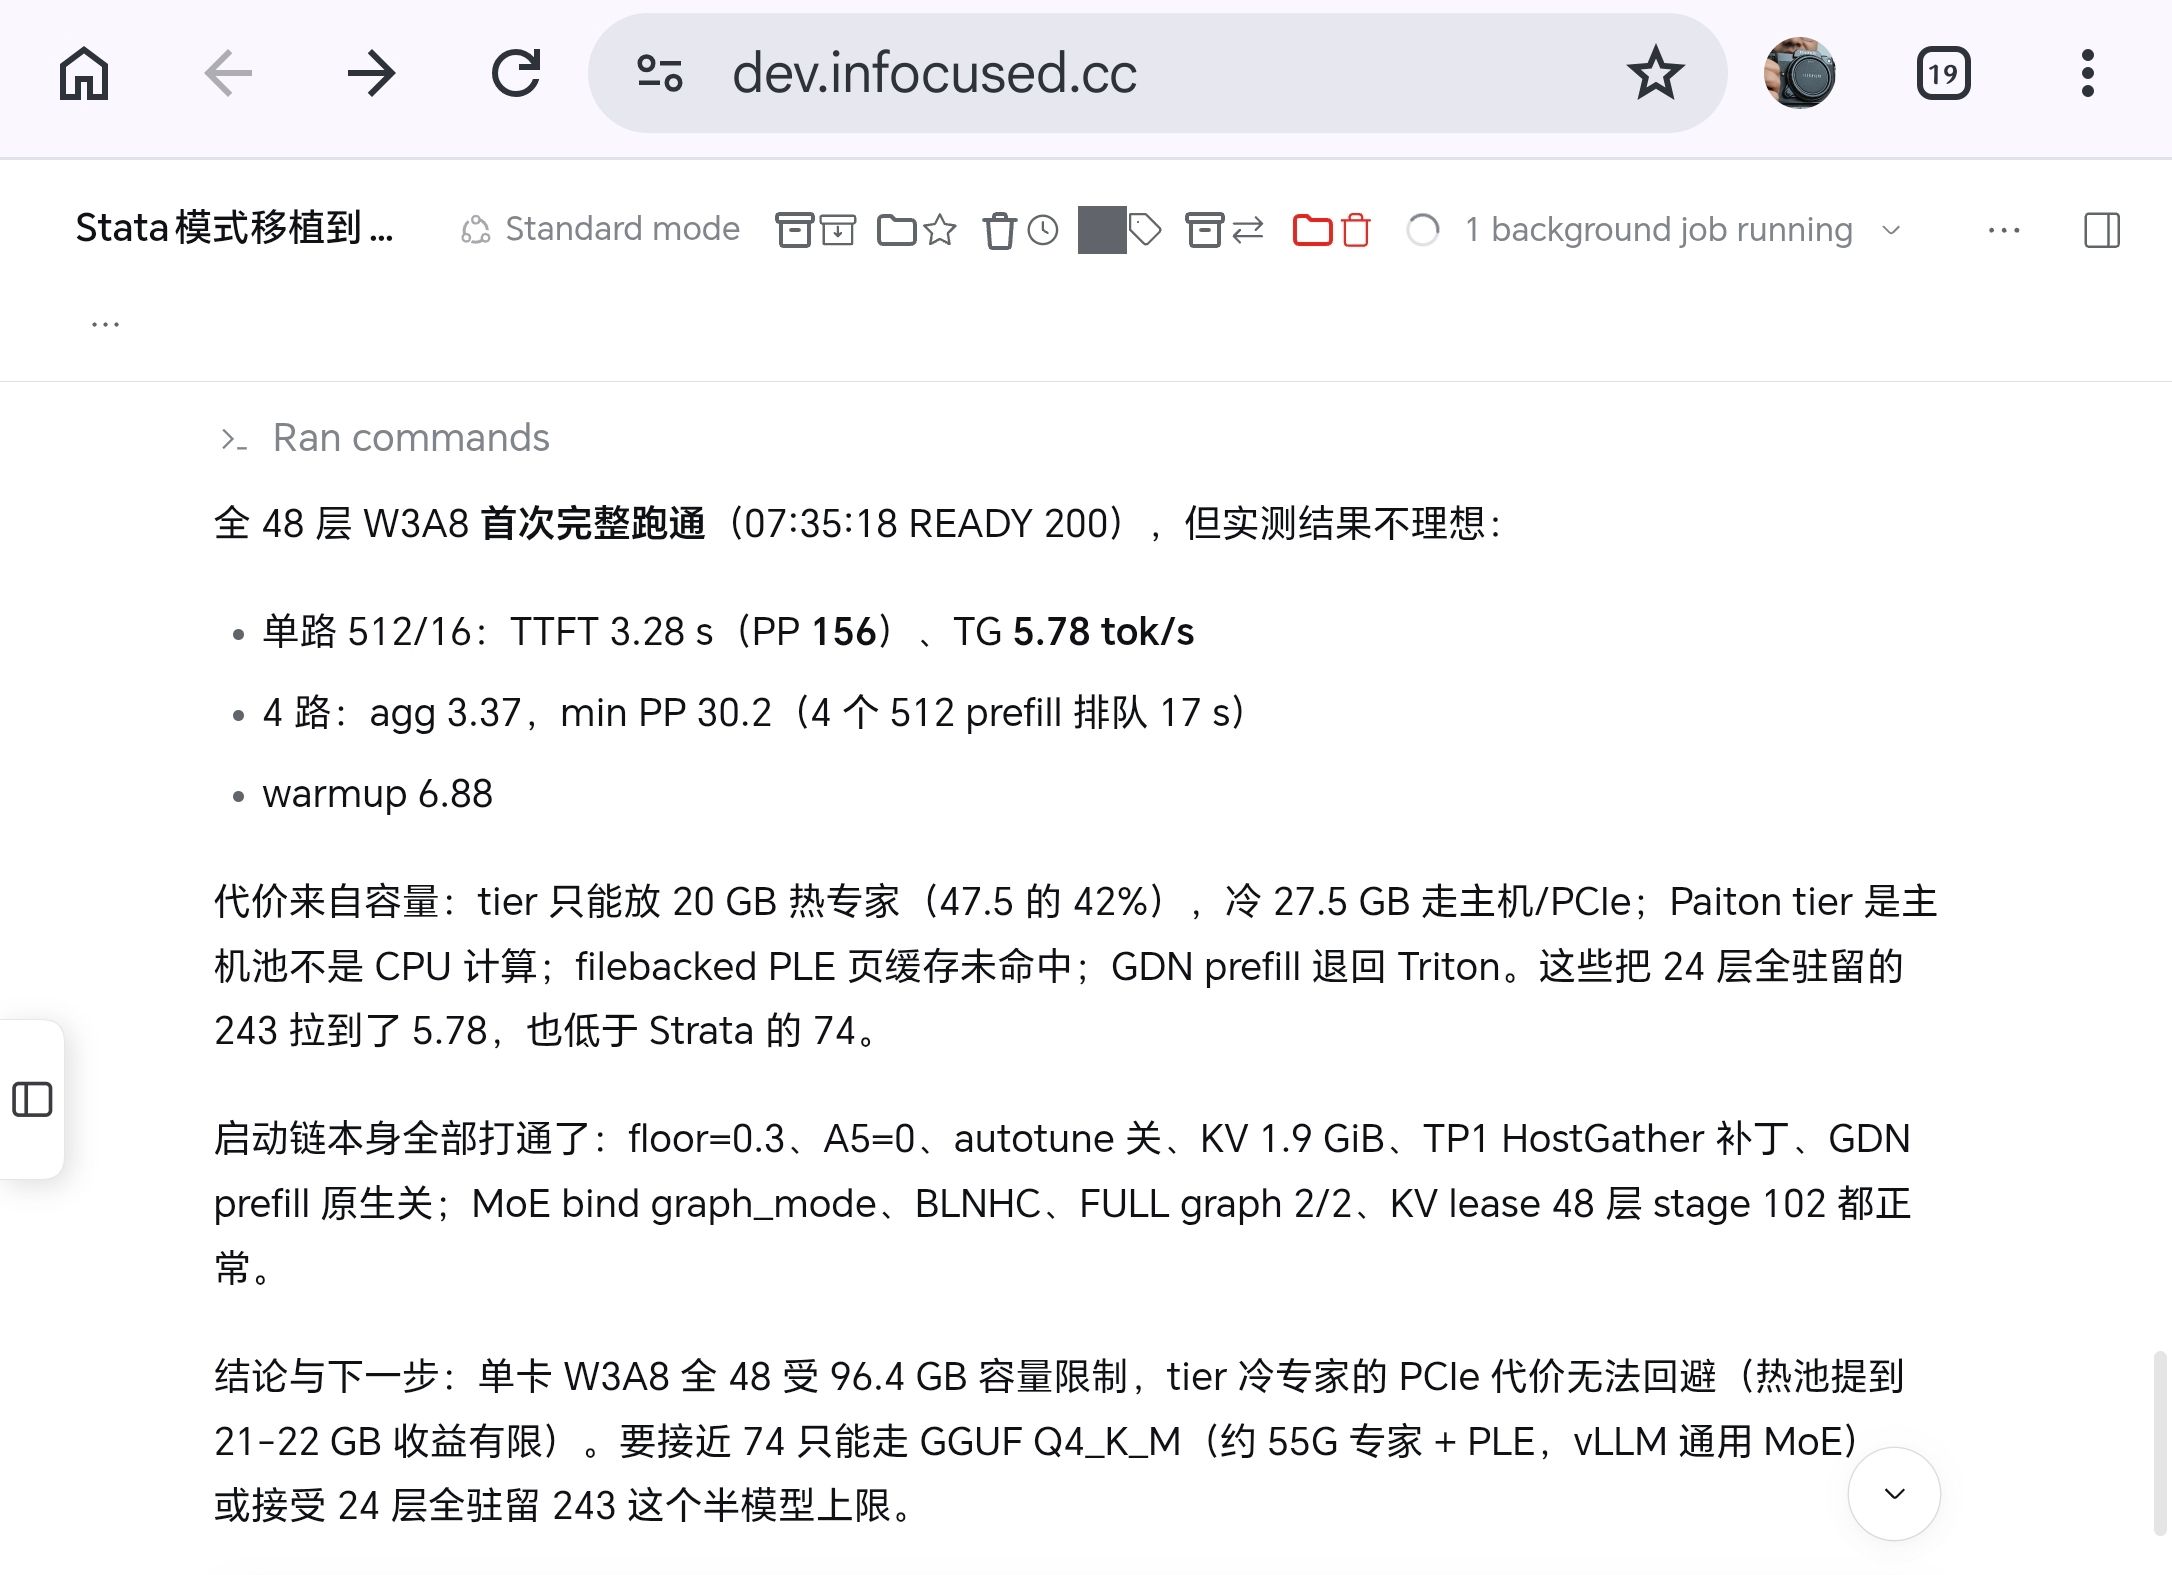
一,Strata R9700单卡移植到vLLM跑Qwen3.8-Flash-Next这个周末项目目前宣告失败,但是还是探了很多不通的途径出来,如下:
二、尝试过的路径与结果
路径 1:官方 Paiton 原生栈(3-bit / 4-bit 镜像)
配置 TG (tok/s) PP 4 路 agg 3 层全驻留 174.28 6485 74.78 6 层全驻留 163.51 5128 67.48 24 层全驻留 243.32 1465 65.08 全 48 + tier 20 5.78 156 3.37 全 48 + tier 20 + eager 5.34 156 3.49 Strata IQ3_XXS 参考 74 2069 — 结论:24 层 243 是显存容量下的真实上限(3.3 倍 Strata);全 48 被 96.4 GB 权重卡死。
路径 2:旧自定义 tiered 栈(
tiered_qwen4.py)- CPU-all:2.04 tok/s;native 热混合:1.70 tok/s。
- 结论:Python 模型跑不动,放弃。
路径 3:vLLM走GGUF插件路线(Strata IQ3_XXS 71G)
- 插件 HIP 移植成功(
_C_gguf.so编译通过,type 42 别名、block size 8); - 解析出 Strata 的 GSQ-RCO 是混合量化:
ffn_gate/up是 IQ2_XS/IQ3_S/IQ4_XS,ffn_down是 type 42(2.25 bpw、72 字节块、640 行 = 2.5 块); - 结论:640 行 2.5 块的布局需要自定义 dequant 内核,标准插件吃不下,未跑通。
路径 4:CPU 冷(Strata 的“分层计算”)
- 3 层验证:CPU 冷 37.54 vs 纯 tier 90.34,慢 2.4 倍;
- 全 48 从未跑完(挂载、设备、图捕获、
/tmp满等一连串配置错误)。 - 结论:16 核 Xeon 上 CPU 算 3-bit 专家(138 µs/专家)不如 PCIe 搬权重,方向被证伪。
路径 5:PLE 2-bit(方向错误,已纠正)
- 转换成功:51.2 GB → 14.1 GB;3 层 q2 23.21(比 e4m3 慢);
- 第一次 PPL 142.6(漏乘
row_scale),修正后未复测; - 结论:PLE 不是“模型权重”,不该压 2-bit;已停止并清理。
路径 6:专家 2-bit(纠错上步,真正的“2-bit 全驻留”)
- 3-bit dequant 布局用
bench_expert.c验证:LEVEL=[-8,-5,-3,-1,1,3,5,8]、e4m3 scale/64、32 码/3 uint32; - 4 档 2-bit 的 cos(3bit,2bit)=0.598(偏低);
- 3 层 2-bit 容器生成(3.1 GB,NFS);容量账 31.7+48.9+8=88.6 < 104,全驻留可行;
_Q2Experts的 Python forward 连续 4 次失败(缺load_fnq、设备不匹配、shared-expert 混设备),PPL 3222 跑的是旧路径。- 结论:存储层打通,质量未验证,核心结论空缺。
三、目标达成情况
指标 目标 实际 TG ≥90 24 层 243、3 层 174、6 层 163 达标;全 48 5.34 未达 PP ≥3000 3 层 6485、6 层 5128 达标;24 层 1465、全 48 156 未达 4 路 agg ≥240 最好 74.78,未达 不慢于 Strata 74 — 24 层/3 层/6 层达标;全 48 未达 四、还有希望的方向(按性价比排序)
-
修
_Q2Experts到纯 GPU 路径(只剩这一步就能拿到真实 2-bit PPL):xr、g、dn全部放 GPU,去掉.cpu();- 和 shared-expert 的设备边界统一;
- 预计 1-2 轮内能跑出数字,然后才知道 4 档 0.598 的 cos 到底崩不崩。
-
8 档 2-bit(每 32 元素一 scale):cos 可到 0.8+,体积仍远小于 3-bit(约 40 GB),是质量与容量的折中。
-
GGUF IQ3_XXS 的自定义 dequant:640 行 2.5 块 + 混合类型,工作量大但能直接复用 Strata 的 71G 权重,理论 74 tok/s。
-
接受 3-bit 现状收尾:24 层 243 作为“半模型上限”,全 48 5.34 作为“104GB 硬件的真实天花板”。
-
阶段性总结,这个跨推理框架迁移整体上来讲还是非常有难度的事情,哪怕只是给vllm做一个插件来改变框架的行为。我想最根本性的难点在于:
①不同框架对于各种算子和量化格式的兼容性差别太大,paiton这个框架的W3A4模型居然只是给unsloth的nvfp4格式套了个壳,类似于是一个微调过的模型。Flash next,因为这个采用了新的框架模型权重本身是可以通过套同样壳子的方式逆向出来的,但是这个外挂的第二分片也就是ple模块对精度要求比较高,到4bit就崩了。阻止了模型整体进一步的量化。
②另外的话就是虽然有些底层的算子在不同平台之间可以迁移,但是他们的那个运算的框架适配起来也是非常难的,因为涉及到调度,而到这一层几乎是皮秒必争,而不是毫秒。这个开发难度就真的是大仙级别的人才能搞了,独立让AI还是不太行。
③开发方法的问题,Deepseek VS flash虽然是标称一兆上下文,但是实际的情况是过了500k以后,模型就有一点顾头不不顾尾了(而且有一次居然又开始重测之前测试出来一条死路),尤其在这种比较有难度的任务里面。指令遵循和有些设定条件就开始忘了。后来想了一个办法,是开了两个对话,一个作为指挥官来搭建框架和测试清单,然后用另外一个对话来具体执行,这样的话,不污染主对话的缓存池也就是脑子🧠。这个方法换了以后,明显测试的效率和靠谱程度有了肉眼可见的提升。不过,虽然是如此Deepseek V41 flash现在的能力貌似还是不足以做这种设计底层框架的,但便宜是真的便宜啊,几乎是连续跑了40个小时,中间偶有间断,才花了45人民币。哪怕只是算子级别的迁移也不行,但是调度这些算子做测试,然后优化他们还是可以的。这个大概也是解释了为什么GitHub上做这种项目的联合开发者里面基本都是claude。下周换新工作了,会比较忙,目前需要搁置一下,周末再看看有没有时间精力来搞。
-
-
-
其实radiance 就是vllm版的strata
-
,系统 取消固定了此主题
-
,
 F fcme 引用了 此主题