
【双R9700折腾记】Radiance MiniMax-H3 相当于87% PRO 6000性能!那么代价是什么?
-
本来这篇帖子是想发一个双R9700 经过调优 Minimax-H3 端到端速度约为Pro 6000的87.8%~ 结果 @williamlouis 老哥一句“硬件指标在那呢!(https://lcz.me/post/29621 ) ” 把我点醒了,对呀,单看纸面算力把3张R9700绑在一起都不一定是Pro 6000 的对手,又看到 @hanber121 老哥的这个回复(https://lcz.me/post/29727 ),5090的速度竟然比Pro6000还快?不兑,这里面必有蹊跷!
于是我暂时放下了“肘击老师傅!” 的念头,认真复盘了一遍Radiance模型究竟用了什么精度,参考视频实际送进去了多少信息,锁页内存到底藏住了什么开销... 也就有了这篇文章!
先把结论放在这儿: 87.8%的成绩是没问题的,但它是两套特定工作流的采样吞吐比,不是双R9700拥有PRO6000的87.8%同精度算力,更不是87.8%的画质。低精度注意力、参考预算、主机内存和工程复杂度共同构成了它的取舍。
一、配置信息
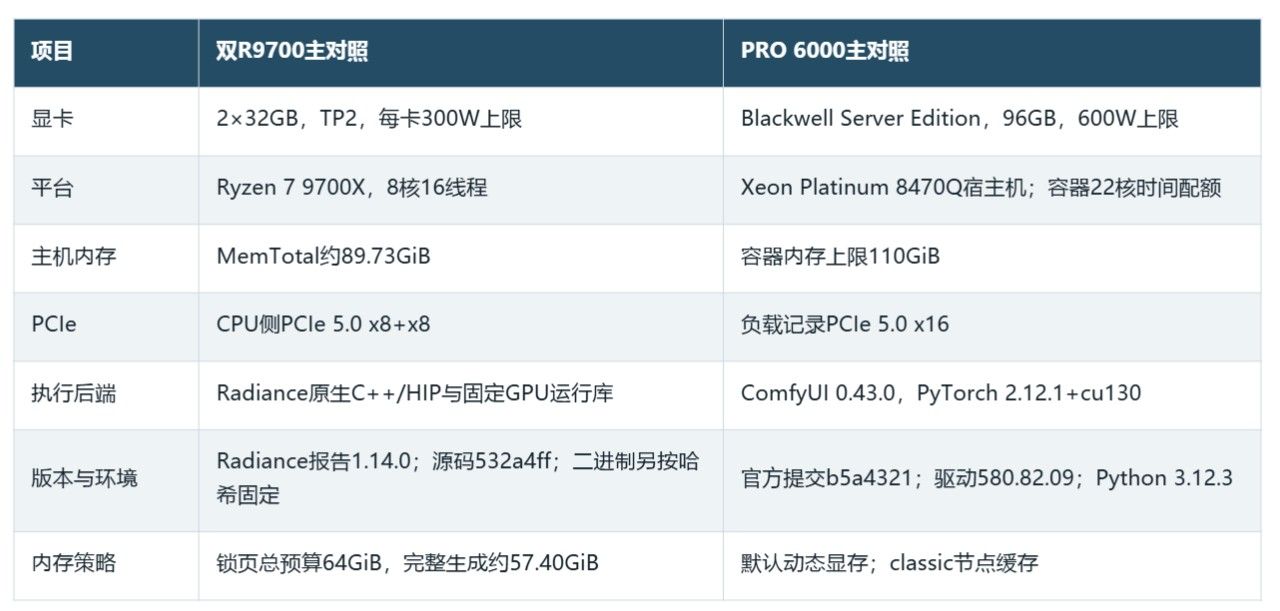
PRO 6000主对照关闭预览与外部自定义节点,使用官方原生节点、PyTorch Attention,INT8、NVFP4与Flash SDPA均做过真实GPU小算子预检。
两边Qwen-VL来自同一NVFP4-AWQ文件,但R9700这套构建先展开为BF16再计算。
音频VAE为同一FP32来源,视频VAE则是R侧FP16来源、BF16/FP32执行,对比PRO的INT8 ConvRot。
二、87.8%的成绩到底是怎么来的?
先拿出之前调优后测试的结果,主对照使用5张参考图片、1段参考视频和视频原配音轨。两边的原始素材与提示词相同,输出都是1344×768、226帧、24fps,约9.42秒。采用RES multistep采样器、simple调度,实际20次模型评估,CFG为1,没有使用八步Turbo LoRA。
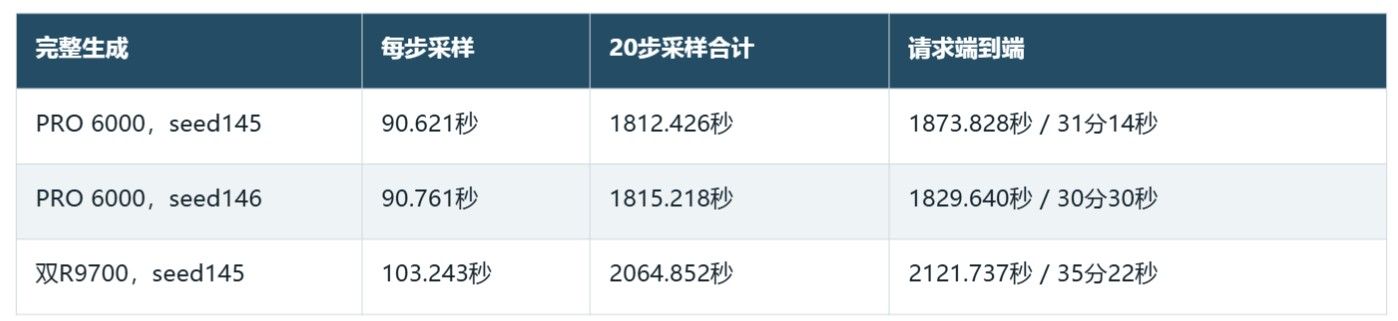
计算方法是90.621÷103.243=87.775%。固定工作量下,吞吐与耗时成反比。所以“达到87.8%的采样性能”和“耗时增加13.9%”可以同时成立。端到端的吞吐比约88.3%,耗时增加约13.2%
比对视频:
看到这可能有些锤友会说了,这不速度挺好的吗,楼主你到底想表达什么意思?

别急,我们继续!
三、Radiance这个引擎究竟在干什么
本轮使用的Radiance,是原生服务核心、模型架构插件、设备算子库和转换后的.rad模型容器共同工作的推理
引擎。它把H3的请求接收、参考媒体准备、编码、采样、解码与内存放置串成原生流程。它的优势需要从这
些具体实现看。(而并不是所谓的 C++语言实现上比Python快~ )
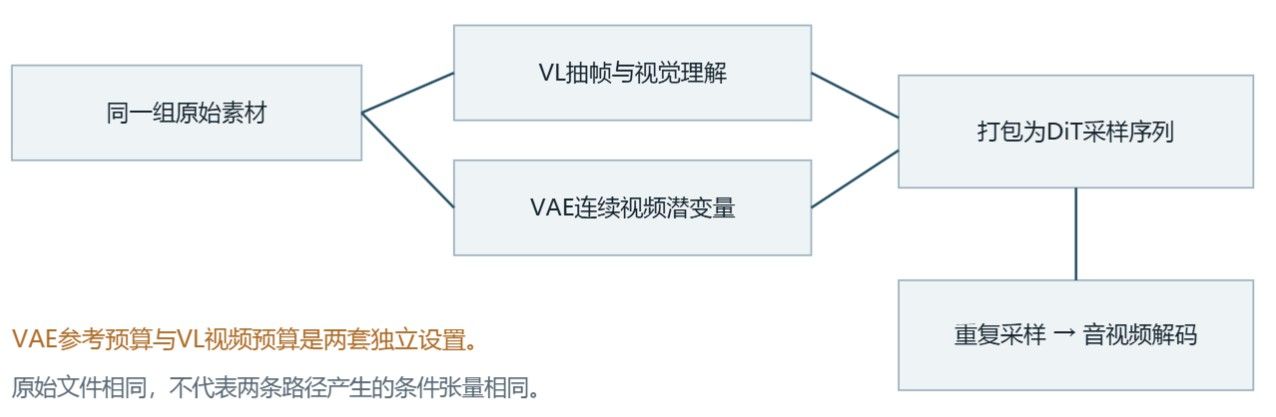
H3收到参考素材后,会做两份用途不同的“笔记”。
VL编码器负责结合提示词看懂参考,例如:画面里有哪些人物、是什么场景、正在做什么动作。视频VAE则把画面压缩成模型能处理的内部表示,保留可供参考的外观、构图和动作变化。参考声音也会经过音频VAE处理。这些信息会一起参与生成。
生成视频时,模型会带着这些参考反复计算,一轮轮更新画面和声音。所谓“50层DiT”,可以理解成50道加工工序,每一步采样都要经过这些工序。我们测试的20步,就是完整处理20轮。
而注意力,是这个过程中让不同信息互相联系的一项关键计算。 可以粗略理解为,生成某个人物、某个动作时,应该关注参考里的哪些信息,以及怎样把这些信息用起来。参考越多、序列越长,这部分计算就越重。
PRO基准使用BF16注意力,而Radiance的快速路径则把其中两部分主要计算分别放到了INT8和FP8上。低精度可以换来速度(也是87.8%的来源),但会改变计算数值,对最终画面影响多大,大家可以见第二部分的参考视频。
最后Radiance中还有“分块”和“缩小”相关的操作,分块类似把一张大图拆开加工,完成后拼回去,缩小则会先减少画面细节...
PS:之前的版本,Radiance会对参考视频进行缩小,@hanber121 老哥有在这里提到( https://lcz.me/post/29509 )此次测试我已处理了这个问题,默认不会对视频进行缩小。
所以,比较生成速度时,除了看输出是不是1MP、跑了多少步,还得看实际用了什么计算精度,以及模型到底看到了多少参考信息。
在核查过程中,最关键的发现是原先约103秒的R9700路径与PRO并没有使用相同注意力算术。PRO正式基准使用BF16注意力,而双R9700旧路径使用INT8的QK计算与FP8的PV计算。张量在算子入口或出口标成BF16,不能证明内部乘法也全部是BF16。
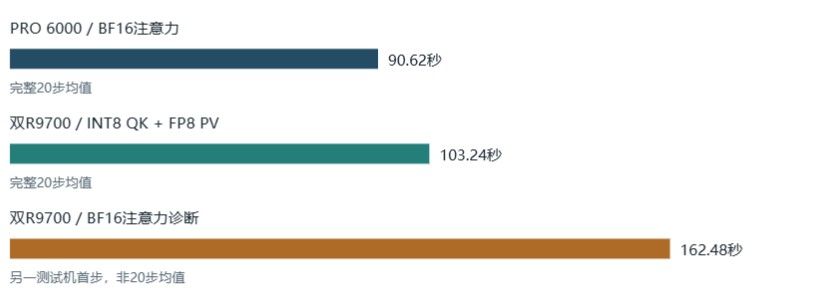
在重新补齐对照时,旧低精度路径前两步平均104.09秒。独立BF16路径首次完整评估为162.48秒,四份完整状态均为有限值。它清楚说明,注意力算术的选择会显著改变速度。
仅按这次首步看,162.48比同机旧路径均值多约56%耗时。若拿历史PRO的90.62秒作参照,162.48至165秒相当于约55%至56%的采样吞吐,而不是87.8%。
低精度注意力不是原罪。它是可以被明确选择、测试和公布的速度/数值取舍。但问题在于:不能把低精度路径的成绩包装成同BF16算术的硬件比较,也不能从一次输出偏离,直接证明低精度必然导致动作失败。本轮尚未完成控制其他变量的多样本画质消融。
另一个容易混淆的点是权重精度。R9700的DiT来自FP8 scaled,PRO来自INT8 ConvRot,两种量化不是同一种数值误差,也不是可以只看“都是8位”就视为等价!
四、真正有效果的工程收益
当然,这一顿折腾不能说所有的收益都是靠降低精度换来的~ 本轮最明确的工程收益,是视频VAE编码中的1×1×1投影GPU实现。原路径有部分投影落到CPU,反复设备/主机交接。把它留在GPU,可以减少搬运与同步,而不必降低参考尺寸。
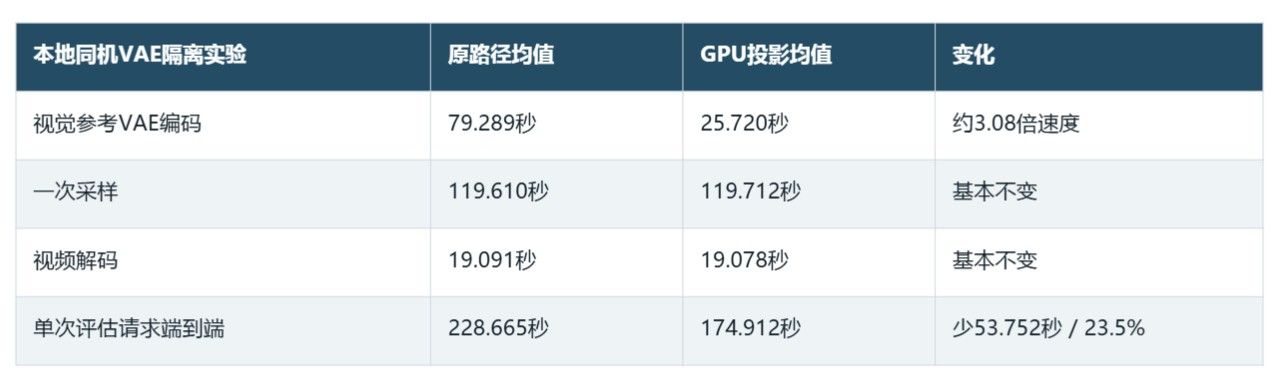
这组A/B各两次,只有一次实际采样,用来隔离VAE开销,不是20步总生成成绩。
实现保留原始FP32权重与FP32累加、BF16输入输出,还处理了CPU后端尾行采用不同归约顺序的细节。本次五图、视频、参考音频以及一次评估后的生成潜变量,最终都通过逐字节一致性检查。
修复不必要的CPU回退,正确安排计算与搬运,保持固定输入与数值验收。它们体现的是引擎工程能力,而不是参考预算或精度的让步。
五、显存换入
这轮测试里,我觉得值得保留的一项成果,就是权重换入,把部分模型权重放在系统内存里,需要时再搬进显存,确实可以明显降低显存占用,而且这次测到的速度损失很小。
原理也不难理解。显卡计算当前这一层时,提前准备下一层的权重,让搬运和计算同时进行。只要数据能及时送到,显卡就不用一直停下来等。
为了看看这个办法到底怎么样,我在R9700显卡上,主动减少常驻显存的权重,比较了三种放置方式:
- 这部分权重留在显存。
- 放在锁页内存,需要时搬进显存。
- 放在普通内存,通过保留的锁页缓冲等路径完成搬运。
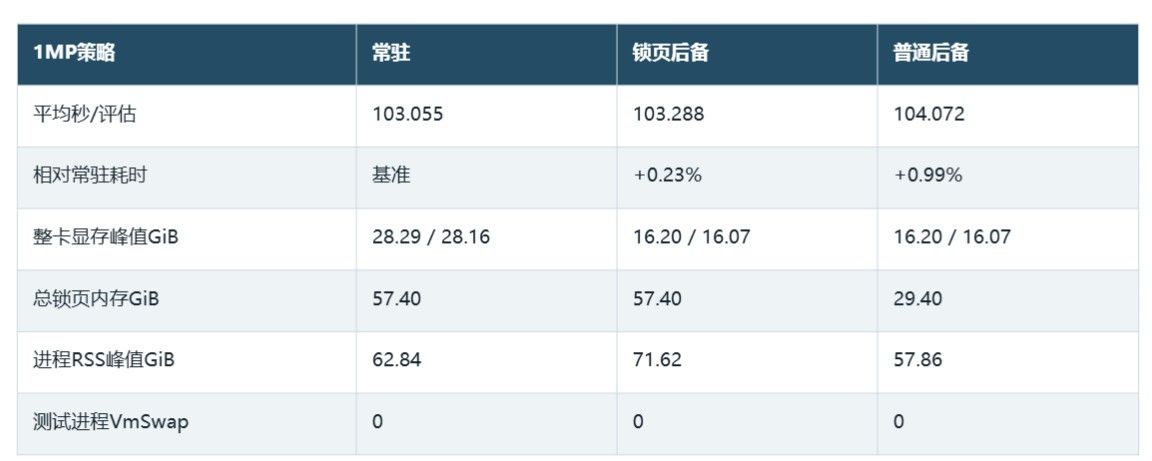
三种方案的采样均值分别约为103.06、103.29和104.07秒/步。相比这部分权重常驻显存,锁页换入多约0.23%,普通内存后备多约0.99%。
0.23%已经接近测试波动,可以理解为这次几乎持平。与此同时,整卡显存峰值从两张卡各约28GiB,降到了约16.20和16.07GiB。对显存紧张的任务来说,这个变化比零点几秒的速度差更有意义。
不过,如果单独比较锁页和普通内存,差距就没那么抢眼了:每步只差约0.78秒。
普通方案的总锁页用量还从约57.4GiB降到了29.4GiB。这里减少的是被固定锁住的内存容量,权重本身依然占系统内存,只是没有把这部分权重也长期锁住。
另外,约16.2GiB的峰值,是在32GB物理卡上测出来的,不能直接宣布16GB显卡已经能跑。至于9070XT、9060这些更小显存的配置,目前只能作为后续适配方向,得另外检查工作区、缓冲和整条生成流程。
4MP负载
再把输出提高到2688×1536、226帧。PRO侧记录到约72.13GiB显存峰值,而双R9700则每卡约29.27GiB,并配合主机内存放置权重。
PS:双方都只取两次完成评估,没有最终解码视频。
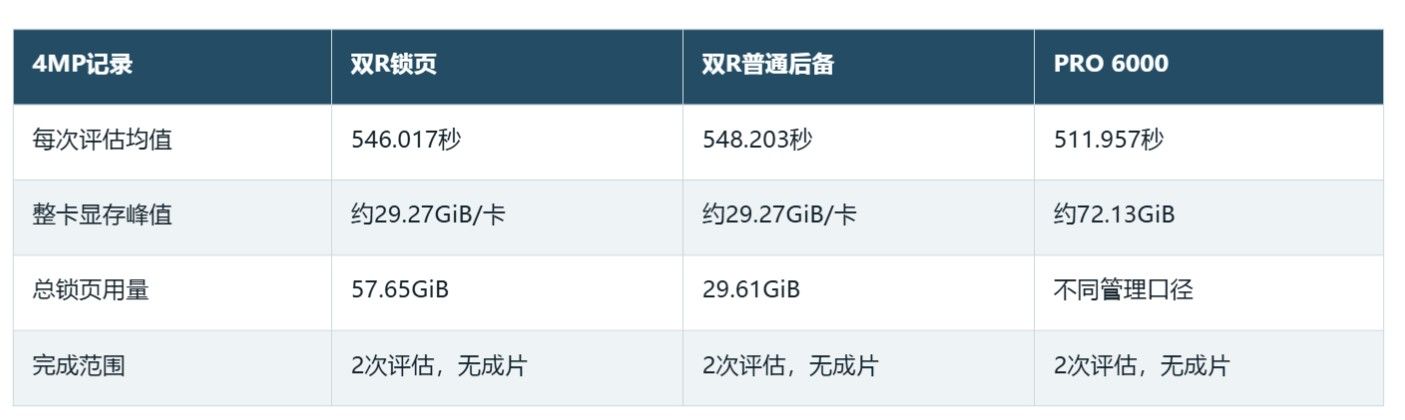
双R9700的锁页方案平均约546秒/步,普通内存后备约548秒/步,相差两秒多,约0.40%。总锁页用量则从约57.65GiB降到了29.61GiB。
每张卡约7.72GiB这类权重放在主机内存,双卡合计约15.44GiB。显存中给它们设置的轮换空间预算约为每卡1.66GiB,随着计算推进,一批批搬进来使用。
引擎记录的这部分搬运量,每次评估双卡合计约15.44GiB,两次约30.87GiB。它不包含显卡直接读取主机内存,以及两卡通信产生的全部流量。
为什么每步搬这么多,速度还没明显被拖住?
一个重要条件是:这一轮计算本身就要九分钟左右,有很长的时间可以提前准备下一批数据。
画面和序列变大后,注意力计算量明显增加,同一个模型的权重容量却没有跟着同比增加。计算相对搬运更重,就更有机会把搬运安排在计算期间完成。
当然,这个结果也有边界,那就是大量中间计算数据主要仍留在显存里!
所以:
权重换入确实帮我们省下了显存;在这组长序列H3短测里,普通权重后备配合必要的锁页缓冲,也已经表现得很好。
至于哪些数据必须锁住、锁多少最合适,仍值得继续精简和验证。
结语
这一轮折腾下来,多少有点意外之喜。原本只是想让双R9700跑好H3,结果从生成速度一路查到精度、参考信息和内存搬运,莫名其妙积累了一些调优经验。
对推理这些事,也算有点祛魅了,显卡大概性能上限是啥心里也有数了。这次也让我更清楚,自己能借助AI做到哪些事情~
最后,折腾归折腾,留下来的代码、记录和经验,下一次总能用上一点。
附录一、显卡实际算力
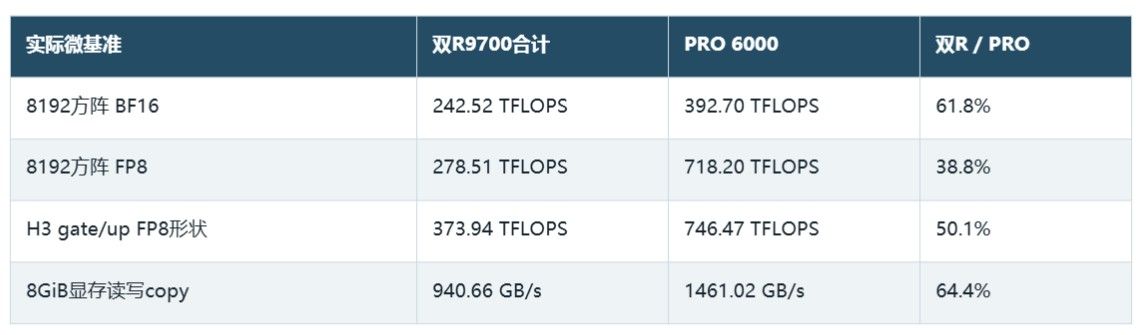
我另外做过矩阵、显存读写和算子剖析。下表的双R9700来自历史租赁服务器,是两卡同时执行独立算子的吞吐合计,不含完整TP矩阵计算的通信成本。输入分布、库和缩放路径也有差别,因此它适合解释瓶颈,不适合直接作为硬件绝对排名。
-
等这卡便宜些,我真有想法入手一张,测7900XTX+RX 9700异构组合
我猜想,各项指标上会有惊喜
到时来抄你作业 -
-
AMD只能是目前市场决定的产物。年初确实是无奈之选。
还是等A100 等洋垃圾到货吧。
目前的价格AMD没有什么性价比。Intel更是个憨憨。
个人意见,目前真没什么值得入手的卡。
PS5 价格都被炒作起来了。tmd。资本真是邪恶。
默默的打打游戏。清闲等待千问4.0.个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
等这卡便宜些,我真有想法入手一张,测7900XTX+RX 9700异构组合
我猜想,各项指标上会有惊喜
到时来抄你作业 -
我现在正有两张rtx 3060 12g , 看看是否可以研究一下,
如果能够吊打原有的nvidia 24g 显卡。。。。 -
AMD只能是目前市场决定的产物。年初确实是无奈之选。
还是等A100 等洋垃圾到货吧。
目前的价格AMD没有什么性价比。Intel更是个憨憨。
个人意见,目前真没什么值得入手的卡。
PS5 价格都被炒作起来了。tmd。资本真是邪恶。
默默的打打游戏。清闲等待千问4.0. -
@williamlouis 没辙,这个行情太臭了。 要不是入坑的早(6月),我现在估计怕不是只能玩V100了。
-
手动折腾不动。AI折腾几次就无趣了。
烧token烧流量。看个结果。
说实话不如写个程序工作。让模型干还多跑电费。模型判定执行和程序判定执行效果是一样的。程序只需要几M的内存。模型显卡跑的嗡嗡叫。时间久了很烦。和我的工作有关。不搞音视频。目前模型的能力优势不大。让本地模型写东西,最后还得给它插屁股。我的感觉是更累了。不如直接烧钱给在线的。
最后保留pro 5000 算是保命卡。应对不知道会不会出现的算力危机!个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
手动折腾不动。AI折腾几次就无趣了。
烧token烧流量。看个结果。
说实话不如写个程序工作。让模型干还多跑电费。模型判定执行和程序判定执行效果是一样的。程序只需要几M的内存。模型显卡跑的嗡嗡叫。时间久了很烦。和我的工作有关。不搞音视频。目前模型的能力优势不大。让本地模型写东西,最后还得给它插屁股。我的感觉是更累了。不如直接烧钱给在线的。
最后保留pro 5000 算是保命卡。应对不知道会不会出现的算力危机! -
-
-
翻出去用海外的API就好了。我用的DS和kimi 都是外面的API。就是支付需要USD。
-
我现在正有两张rtx 3060 12g , 看看是否可以研究一下,
如果能够吊打原有的nvidia 24g 显卡。。。。 -
两张rtx 3060 12g
RTX 3060 12g 的規格好像不錯 性價比蠻高的?
但是都沒人討論過 -
-
等这卡便宜些,我真有想法入手一张,测7900XTX+RX 9700异构组合
我猜想,各项指标上会有惊喜
到时来抄你作业@xiongjie-gao 我弟你有那么有钱,人帅,D又大,说话又好听,我就等着白嫖你的数据呢
-
@xiongjie-gao 我弟你有那么有钱,人帅,D又大,说话又好听,我就等着白嫖你的数据呢
@terry 老哥你正常些。

在宁波上海,你这样的说话方式我们统称为“嫖”。
数据随便嫖,人就别嫖了 -
-
@terry 老哥你正常些。
在宁波上海,你这样的说话方式我们统称为“嫖”。
数据随便嫖,人就别嫖了




 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!
