跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【分享】原地升天!R9700x2 从 Qwen3.8-27B-MXFP4 到 Qwen3.8-Flash-Next IQ4_R

【分享】原地升天!R9700x2 从 Qwen3.8-27B-MXFP4 到 Qwen3.8-Flash-Next IQ4_R

已定时 已固定 已锁定 已移动 热议 优秀 LLM讨论区
r9700qwen多卡部署
39 帖子 13 发布者 1.6k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • paul houP
    paul houP
    paul hou
    硕果累累 贵族大夫
    编写于 最后由 编辑
    #5

    最近用RADIANCE都是用這個模型
    https://huggingface.co/frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
    比原廠慢一點,但品質好。

    shawn shenS linkdesuL 2 条回复 最后回复
    1
    • XiaoteX
      XiaoteX
      Xiaote
      易有太极
      编写于 最后由 编辑
      #6

      ✅ 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

      奖励凭证:优秀 +3 分 · 编号 e2807-1746-1

      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

      1 条回复 最后回复
      0
      • terryT
        terryT
        terry
        易有太极
        编写于 最后由 terry 编辑
        #7

        难以置信啊,你补充点图片啊,你6并发这么好的数据?补充点实拍之类的,我好水个视频呢?说实话Strata你能玩到这个并发量很不容易,是我理解错了吗?

        油管:https://www.youtube.com/@抡锤者

        A terryT 2 条回复 最后回复
        0
        • linkdesuL linkdesu

          很久没有折腾本地模型的引擎了,最近因为 opencode 一直加量不加价用的很爽,渐渐把 token 开销再次推到了新高,所以想要把本地模型的效率也再挤一挤。没想到正好就看到了坛友的分享 【双 R9700 折腾记】从 Strata 到 Radiance 正好和我的硬件配置非常接近,有了能用的新方案性能又有提升,所以就决定直接开干了。

          • 模型:qwen3.8-next-flash-fp8-iq4r-moe.rad(113.59 GiB,SHA256 0af5e962…4d20)
          • 推理引擎:Radiance 1.15.1(Docker 镜像 stilldeadcode/radiance:1.15.1)
          • 测试工具:guidellm 0.7.3,用 ignore_eos 强制跑满输出长度,靠 max_requests 控制请求数

          1. 测试配置

          项目 值
          架构 / 量化 qwen4exp,MoE(512 专家 / 每 token 选 10),int8 trunk + 4bit 码本专家
          上下文 测试覆盖到 192K,引擎上限设为 256K(--max-model-len 262144)
          并发数 6(--max-num-seqs 6,queue_cap: 32)
          张量并行 TP=2(--tp 2 --tp-wire wht6)
          专家放置 expert_tiered,host pool 每卡 12,288 MiB
          KV cache fp8,prefix cache 4,096 MiB,每卡 8.40 GiB(覆盖最坏情况 71%,即 4.2 条满长度会话常驻)
          投机解码 模型内置 MTP,深度 5,--draft-coupling on
          批次上限 2,048 tokens
          采样参数 temperature 1.0、top_k 20、top_p 0.95(服务端默认)

          硬件

          项目 值
          GPU 2 × AMD Radeon AI PRO R9700(gfx1201),每卡 31.86 GiB 可用显存
          互连 两卡可直接读对方显存(peer to peer,实测卡间 28.2 GB/s)
          PCIe 32.0 GT/s ×8 双卡,Resizable BAR 32G
          CPU / 内存 Ryzen 7 9700X(8C16T)/ 59 GiB(已关闭 swap)
          系统 Ubuntu 26.04 LTS,kernel 7.0.0-31-generic

          2. 测试方法

          我这边的测试方法主要是在预填充大量 context 的情况下测试 prefill 和 decode ,因为这是我自己更加常见的 agent 自动化开发场景:

          1. 多轮会话口径(prefix-fill):每个请求由「已建立的 N token 上下文 + 新增 2000 token」组成,生成 1000 token。对应的是 agent 连续对话里第 N 轮的真实开销,而不是冷启动灌上下文。
          2. Decode = (实际输出 token − 1) ÷ (总耗时 − TTFT),也就是首字之后每 token 的速度,已经把投机解码一次出多个 token 的收益算进去了。
          3. 聚合吞吐(稳态窗口):只统计所有流都建完上下文之后的区间,冷灌阶段(每条流的第一轮)不计入分母。原因是现实中 agent 的上下文都是随会话逐步攒出来的,冷灌极少发生,它的代价见 3.1 里的说明。
          4. 增量 Prefill = 2000 ÷ 稳态 TTFT,即每轮新增内容真正要算的那部分。
          5. 冷灌 Prefill = prompt token ÷ TTFT(每个档位的第一条请求,全量建上下文)。
          6. 并发放 1 / 2 / 4 / 6 条流(另外做了 8 流的可行性对照,见 3.8);每个请求都带唯一 nonce 前缀,避免命中共享的前缀缓存。

          3. 结果

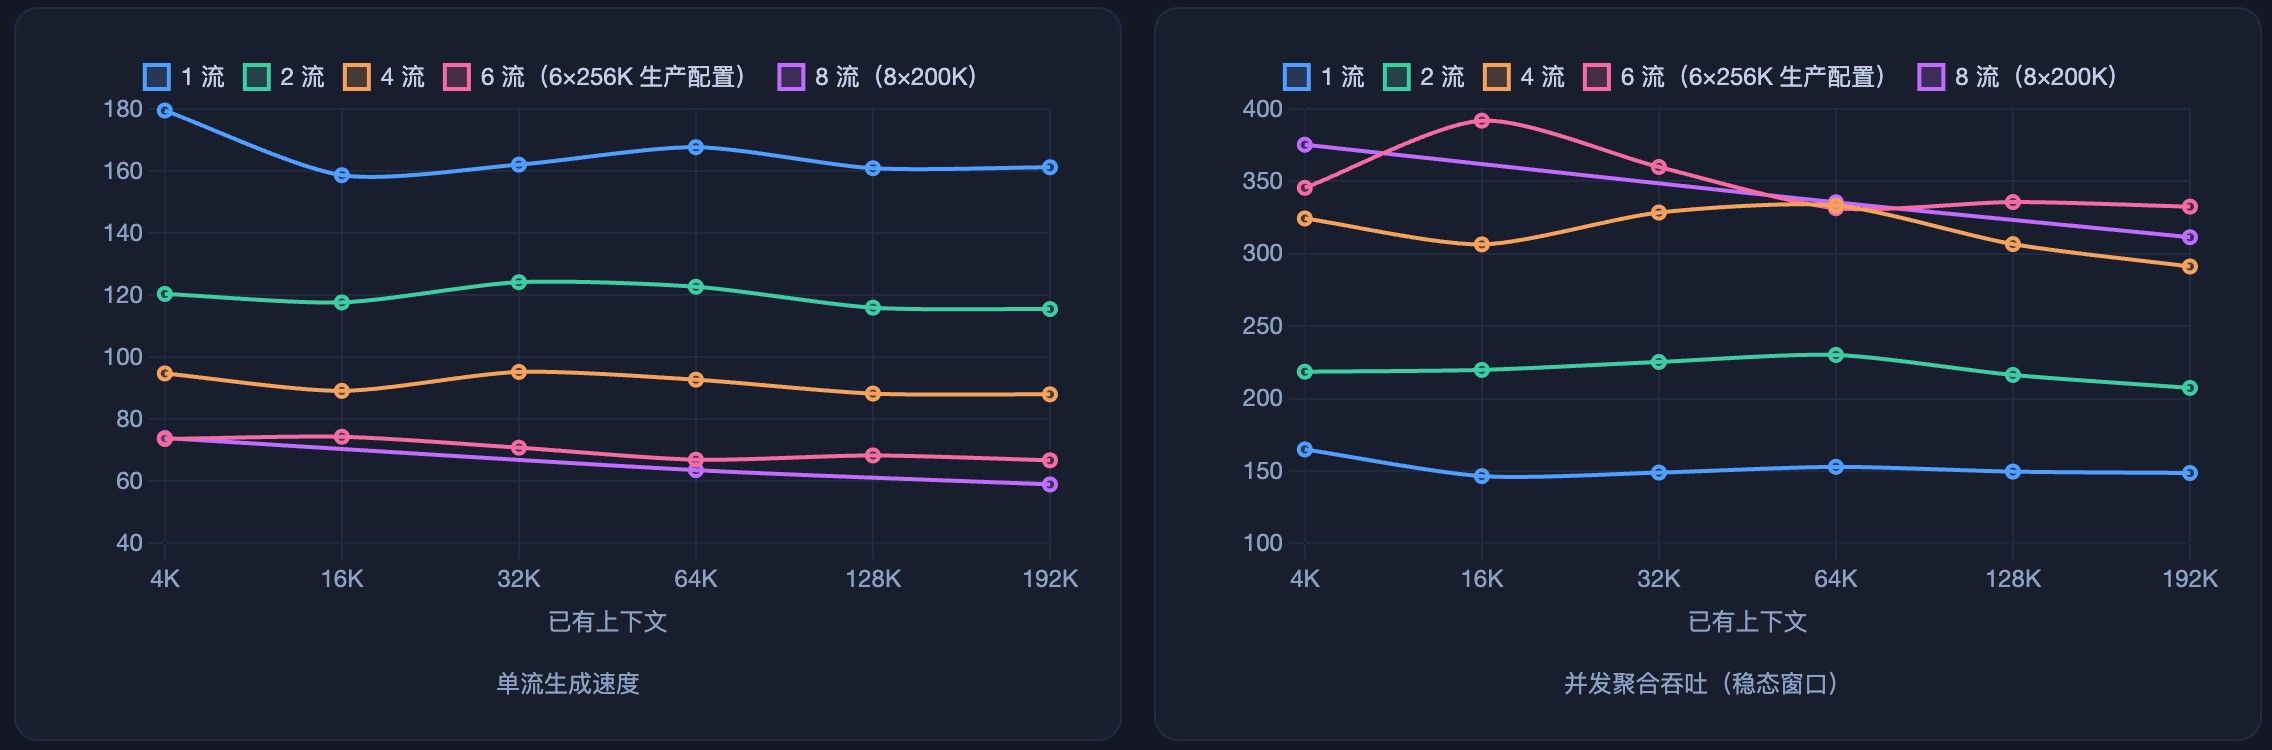
          3.1 单流 + 聚合生成速度
          CleanShot 2026-11-02 at 23.27.49@2x.jpeg

          解读:

          • 单流 decode 在 4K 处是 180 tok/s,到 192K 仍有 161 tok/s(−10%),全程基本是平的。
          • 生产配置(6 流)的聚合吞吐:4K 346 tok/s、16K 392、192K 仍有 333,长上下文几乎不掉。

          ⚠️ 如果把冷灌阶段也算进分母(即「整个 run 的总 token ÷ 墙钟时间」),192K 只剩 151 tok/s,不到稳态的一半。因为一次 run 有七成时间花在建上下文上,而建上下文本身在两次同配置的跑之间就能差一倍(实测 83s vs 179s)。真实使用中上下文是逐步攒出来的,所以这里统一用稳态窗口口径。

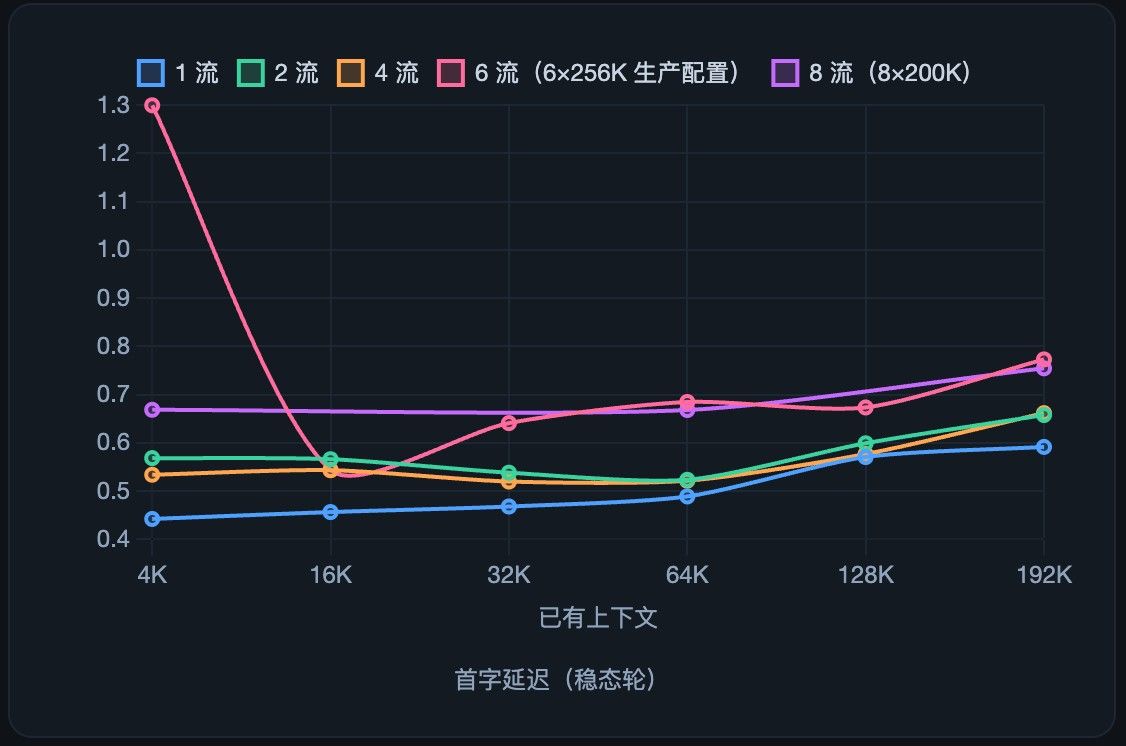
          3.2 首字延迟
          CleanShot 2026-11-02 at 23.37.38@2x.jpeg

          解读:稳态轮的 TTFT,单流从 0.44s(4K)升到 0.59s(192K);6 流时是 0.54–0.77s。

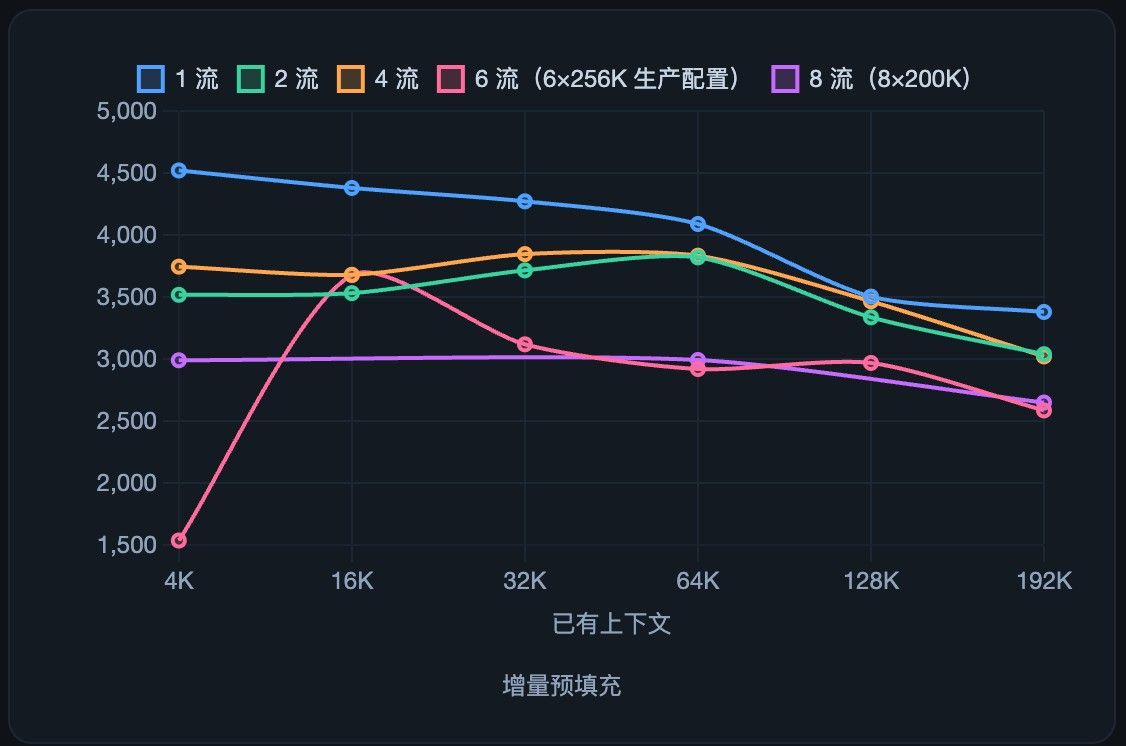
          3.3 增量预填充
          CleanShot 2026-11-02 at 23.38.02@2x.jpeg

          解读:每轮新增的 2000 token,处理速度从 4K 的 4521 tok/s 降到 192K 的 3381 tok/s(−25%)。这是 decode 之外第二个会随上下文衰减的量,好在幅度不大。

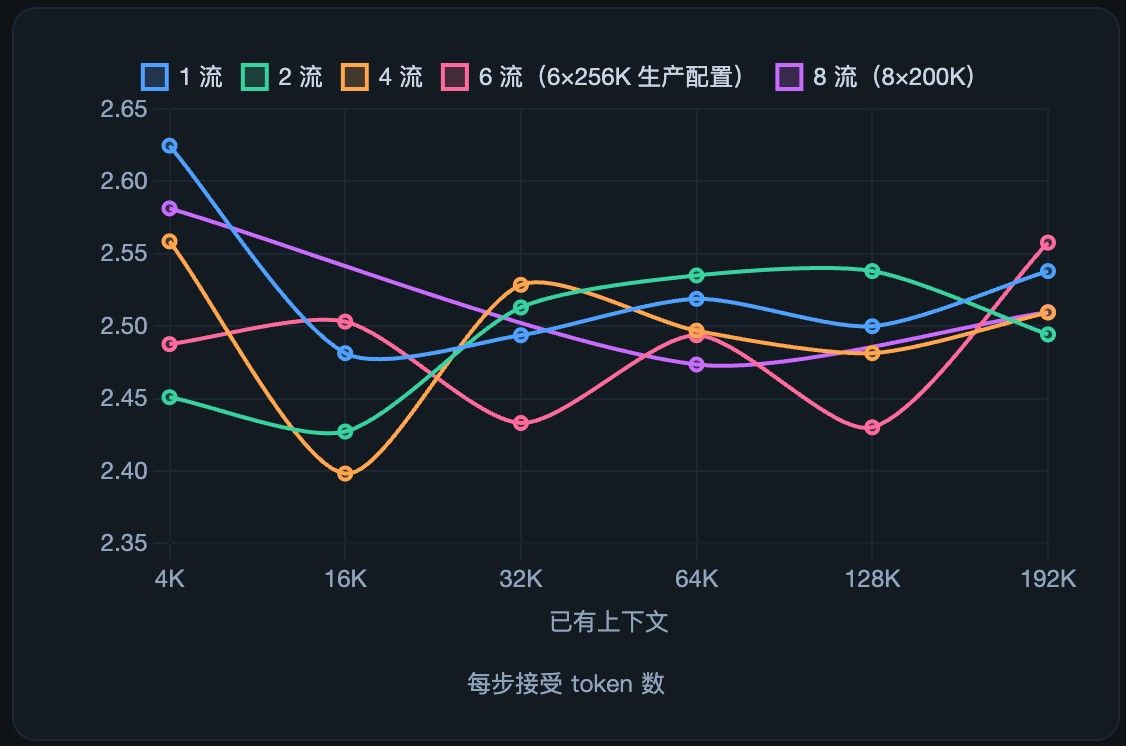
          3.4 每步接受的 token 数
          CleanShot 2026-11-03 at 01.07.34@2x.jpeg

          解读:每步接受 2.40–2.62 个 token,几乎不随上下文和并发变化。说明投机解码的接受率在这套配置下很稳定,也是单流 decode 能保持在一百六以上的原因。

          3.5 并发扩展:4 → 6 → 8 流

          上下文 4 流 单流 / 合计 6 流 单流 / 合计(生产) 8 流 单流 / 合计
          4K 94.8 / 324 73.7 / 346 74.0 / 375
          16K 89.2 / 306 74.4 / 392 — / —
          32K 95.3 / 328 70.9 / 360 — / —
          64K 92.8 / 333 67.0 / 331 63.6 / 336
          128K 88.3 / 307 68.3 / 336 66.4 / 334 ※
          192K 88.0 / 291 66.8 / 333 59.0 / 311

          这里数据有些缺失,不过因为最终判定 8 并发不划算,聚合速度只多 1–16%,单流却掉 22–33%;而且 8×200000 的 KV 池只够 5.5 条满长度会话,第 6–8 条要排队,所以就没有补了,请见谅。

          6 并发把单流从 ~93 压到 ~67 tok/s(−24%),主机内存从 40 涨到 42 GiB,checkpoint 槽从 4.40 涨到 6.76 GiB;KV 池 8.40 GiB 意味着满 256K 的会话只能常驻 4.2 条,第 5、6 条要等。

          但我这边测试下来除非陷入死循环,作为最后一段负责具体工作的 worker 基本不会用完 context ,所以就决定了 6 并发这个最适合我的数字。

          3.6 MTP 投机深度:开到 3 还是 5

          我让 AI 在 4K 上下文、6 并发下做了同文本对照,并且每次换一段合成文本,避免跨轮次命中前缀缓存:

          深度 并发 单流 decode 聚合吞吐 tok / step
          3 1 130.8 124.7 2.58
          5 1 164.1 154.3 2.85
          3 6 77.0 290.9 2.55
          5 6 66.7 353.6 2.91

          最终可以看到虽然接受率不高,但深度 5 还是不亏,生产继续用 5。

          • 同一段文本下,深度 5 每步多接受 0.26~0.36 个 token(+11%~14%),单流快 25%,6 并发聚合快 21%。
          • 步级指标更干净(decode_step_seconds_best,32 步滑动窗):深度 3 是 14.81 ms/步,深度 5 是 15.71 ms/步,只慢 6%,但每步多出 10%~14% 的 token,折算净收益约 +4%。端点测出来的 25% 里混了文本和请求级抖动,4% 这个数更可信。

          最后

          感谢老特把自己的白月光分享出来,让我及时上车了这张卡,也很感谢开源社区,感谢坛友的分享,大家放下争吵赶紧上车吧,现在留在车上比什么都重要 👍

          A
          A
          applejuice
          王侯将相
          编写于 最后由 applejuice 编辑
          #8

          @linkdesu 测一测512k context
          context offload 去ram

          strata 唯一的好处就是长上下文几乎没衰减

          1 条回复 最后回复
          0
          • terryT terry

            难以置信啊,你补充点图片啊,你6并发这么好的数据?补充点实拍之类的,我好水个视频呢?说实话Strata你能玩到这个并发量很不容易,是我理解错了吗?

            A
            A
            applejuice
            王侯将相
            编写于 最后由 编辑
            #9

            @terry 他是用另一个引擎 radiance
            amd 专用版 vllm

            1 条回复 最后回复
            2
            • A
              A
              applejuice
              王侯将相
              编写于 最后由 编辑
              #10

              这是我自己用的测试方法 有兴趣的话跑一跑

              decode 测试

              5 个固定 prompt,t=0,max_tokens 512,每项 3 轮。decode = (输出 token − 1) ÷ (总时间 − TTFT)。

              设置 代码生成 英文技术 中文对话 中文散文 双路代码:同 prompt / 不同 prompt
              关思考(--think off) 168.5 147.4 126.3 117.8 178.0 / 207.2
              默认(开思考) 149.2 140.5 121.7 120.2 147.7 / 169.5
              #!/usr/bin/env python3
              """统一基准 v2(基于 "SGLang DFLASH 统一基准 v1")— 双方同 prompt、同口径对测,只用 Python 标准库。
              
              与 v1 相同:5 个 prompt、t=0、max_tokens 512、每项 3 轮、
                decode = (completion_tokens - 1) / (总时间 - TTFT),TTFT = 第一个 content 或 reasoning 片段到达的时间,
                并发 aggregate = 两路 (completion_tokens - 1) 之和 / 两路中较长的 (总时间 - TTFT)。
              v2 新增:
                --think default|off   off = 发送 chat_template_kwargs.enable_thinking=false(vLLM / SGLang / 多数 Qwen 服务)
                --extra-body JSON     其它引擎专用字段,例如 '{"reasoning_effort":"low"}'
                --api-key KEY         需要鉴权的服务(例如 radiance 设了 --api-key-env)
                --warmup N            正式计时前的预热请求数(默认 1,不计入结果)
                每项输出:平均 decode、最低-最高、平均输出 token 数、思考占比(reasoning 片段 / 全部片段)、TTFT、tok/chunk
                思考占比用来确认 --think off 是否真的生效(off 时应为 0 %);开着思考时显示实际有多少是思考内容,不同引擎和模型差别很大。
                tok/chunk 取决于服务端怎么分片推流,只能在同一引擎内比较。
              用法:
                python3 uni_bench_v2.py --model <模型名> --base-url http://127.0.0.1:8000 --think off
                python3 uni_bench_v2.py --model <模型名> --base-url http://127.0.0.1:8000 --think default
              请把完整输出贴出来(开头一行包含时间、模型和设置)。"""
              import argparse, concurrent.futures, json, time, urllib.request
              
              P = {
                  "code": "You are an expert Python engineer. Write a complete implementation of a thread-safe LRU cache class with TTL expiration support, including unit tests. Provide only code, no explanation.",
                  "code_b": "You are an expert systems engineer. Write a complete implementation of a lock-free SPSC ring buffer in C++17 with acquire/release memory ordering annotations. Provide only code, no explanation.",
                  "en_tech": "Write a detailed technical explanation of how speculative decoding with a draft model works, covering the draft-verify loop, acceptance criteria, and why acceptance rate varies by domain. Aim for depth and precision.",
                  "cn_chat": "请用中文详细分析一下,为什么家用路由器长期不重启会越来越慢?从内存碎片、连接跟踪表、NAT 状态老化三个角度展开,给出可操作的解决建议。",
                  "cn_essay": "请写一篇关于秋天的散文,描写北平的秋色,要求文笔优美,有细节描写,不少于五百字。",
              }
              SCENES = [("代码生成", "code"), ("英文技术论述", "en_tech"), ("中文常规对话", "cn_chat"), ("中文散文", "cn_essay")]
              
              
              def gen(a, prompt):
                  payload = {"model": a.model, "messages": [{"role": "user", "content": prompt}],
                             "max_tokens": a.max_tokens, "temperature": a.temperature, "stream": True,
                             "stream_options": {"include_usage": True}}
                  if a.think == "off":
                      payload["chat_template_kwargs"] = {"enable_thinking": False}
                  payload.update(a.extra)
                  headers = {"Content-Type": "application/json"}
                  if a.api_key:
                      headers["Authorization"] = "Bearer " + a.api_key
                  req = urllib.request.Request(a.base_url.rstrip("/") + "/v1/chat/completions",
                                               data=json.dumps(payload).encode(), headers=headers)
                  t0 = time.time(); ttft = None; n_content = 0; n_reason = 0; usage = None
                  try:
                      with urllib.request.urlopen(req, timeout=900) as r:
                          for raw in r:
                              line = raw.decode("utf-8", "replace").strip()
                              if not line.startswith("data:"):
                                  continue
                              d = line[5:].strip()
                              if d == "[DONE]":
                                  break
                              try:
                                  j = json.loads(d)
                              except Exception:
                                  continue
                              if j.get("usage"):
                                  usage = j["usage"]
                              ch = (j.get("choices") or [{}])[0].get("delta", {}) or {}
                              c = ch.get("content") or ""
                              rc = ch.get("reasoning_content") or ch.get("reasoning") or ""
                              if c or rc:
                                  if ttft is None:
                                      ttft = time.time() - t0
                                  if rc:
                                      n_reason += 1
                                  if c:
                                      n_content += 1
                  except Exception as e:
                      return {"err": str(e)[:120]}
                  total = time.time() - t0
                  comp = usage.get("completion_tokens", 0) if usage else 0
                  nch = n_content + n_reason
                  if ttft is None or comp <= 1 or total <= ttft:
                      return {"err": "no tokens" if usage else "no usage in stream (server ignores stream_options.include_usage?)"}
                  return {"comp": comp, "ttft": ttft, "total": total, "dec": (comp - 1) / (total - ttft),
                          "tpc": comp / nch if nch else 0.0, "think": n_reason / nch if nch else 0.0}
              
              
              def avg(xs):
                  return sum(xs) / len(xs)
              
              
              def main():
                  ap = argparse.ArgumentParser()
                  ap.add_argument("--base-url", default="http://127.0.0.1:8000")
                  ap.add_argument("--model", required=True)
                  ap.add_argument("--rounds", type=int, default=3)
                  ap.add_argument("--max-tokens", type=int, default=512)
                  ap.add_argument("--temperature", type=float, default=0.0)
                  ap.add_argument("--think", choices=["default", "off"], default="default")
                  ap.add_argument("--extra-body", default="{}")
                  ap.add_argument("--api-key", default="")
                  ap.add_argument("--warmup", type=int, default=1)
                  a = ap.parse_args()
                  a.extra = json.loads(a.extra_body)
                  print(f"# 统一基准 v2: {a.model} @ {a.base_url}  {time.strftime('%Y-%m-%d %H:%M')}  rounds={a.rounds} "
                        f"max_tokens={a.max_tokens} t={a.temperature} think={a.think} extra={json.dumps(a.extra, ensure_ascii=False)}",
                        flush=True)
                  for _ in range(a.warmup):
                      gen(a, "Say hello in one short sentence.")
                  print("\n## 单路(四场景)", flush=True)
                  for name, key in SCENES:
                      rs = [gen(a, P[key]) for _ in range(a.rounds)]
                      ok = [r for r in rs if "err" not in r]
                      errs = [r["err"] for r in rs if "err" in r]
                      if not ok:
                          print(f"  {name}: 失败 ({errs[0] if errs else '?'})", flush=True)
                          continue
                      d = [r["dec"] for r in ok]
                      print(f"  {name}: decode {avg(d):.1f} t/s ({min(d):.1f}-{max(d):.1f}) | 输出 {avg([r['comp'] for r in ok]):.0f} tok | "
                            f"思考占比 {100 * avg([r['think'] for r in ok]):.0f}% | TTFT {avg([r['ttft'] for r in ok]):.3f}s | "
                            f"tok/chunk {avg([r['tpc'] for r in ok]):.2f}" + (f" | 失败 {len(errs)}" if errs else ""), flush=True)
                  print("\n## 并发 2 路(代码场景)", flush=True)
                  for label, ps in [("同 prompt(前缀缓存命中)", [P["code"]] * 2), ("不同 prompt", [P["code"], P["code_b"]])]:
                      aggs = []
                      for _ in range(a.rounds):
                          with concurrent.futures.ThreadPoolExecutor(2) as ex:
                              rs = list(ex.map(lambda p: gen(a, p), ps))
                          rs = [r for r in rs if "err" not in r]
                          if len(rs) < 2:
                              continue
                          aggs.append(sum(r["comp"] - 1 for r in rs) / max(r["total"] - r["ttft"] for r in rs))
                      if aggs:
                          print(f"  {label}: aggregate decode {avg(aggs):.1f} t/s ({min(aggs):.1f}-{max(aggs):.1f}, n={len(aggs)})", flush=True)
                      else:
                          print(f"  {label}: 失败", flush=True)
              
              
              if __name__ == "__main__":
                  main()


              prefill 测试

              上下文 4K 16K 32K 64K 128K 192K
              冷 prefill(耗时) 1,748(2.3 s) 4,188(4.0 s) 4,559(7.1 s) 4,865(13.3 s) 5,079(25.4 s) 5,102(37.9 s)
              增量 2000 token(耗时) 992(2.03 s) 951(2.11 s) 922(2.18 s) 907(2.22 s) 806(2.47 s) 752(2.67 s)
              #!/usr/bin/env python3
              """统一 prefill 基准 v1(uni_bench_v2 的配套脚本)— 双方同文本、同口径对测,只用 Python 标准库。
              
              冷 prefill:每个长度发一条全新的长 prompt(开头带随机 nonce,避免命中前缀缓存),max_tokens=1,
                冷 prefill = 服务端返回的 prompt_tokens ÷ 请求总耗时(1 个输出 token,耗时≈TTFT)。
              增量 prefill(多轮对话口径,默认开):冷请求之后接一轮新对话
                [user: 长上下文] [assistant: 第一轮的回复] [user: 新增约 2000 token + 问题],max_tokens=1,
                增量 prefill = (第二轮 prompt_tokens − 第一轮 prompt_tokens) ÷ 第二轮耗时。
                这一项同时测了引擎的多轮缓存:如果没命中缓存,会接近重新读整个上下文的耗时。
              文本:默认下载 Project Gutenberg 的 Sherlock Holmes(和 llama-benchy 同一本,缓存到本地文件);
                下载不了就用 --text-file 指定任意 UTF-8 文本,对测双方要用同一个文件。
                长度不够时从不同位置循环取文本;每次请求的起点不同。
              用法:
                python3 uni_prefill.py --model <模型名> --base-url http://127.0.0.1:8000
                python3 uni_prefill.py --model <模型名> --lengths 4096 16384 65536 131072 --rounds 2 --followup 2000
              请把完整输出贴出来。prompt_tokens 以各自服务端的计数为准(不同 tokenizer 同一段文本的 token 数会略有不同)。"""
              import argparse, json, os, random, time, urllib.request
              
              BOOK_URL = "https://www.gutenberg.org/files/1661/1661-0.txt"
              QUESTION = "\n\n请用一句话概括上面的内容。"
              
              
              def post(a, messages):
                  payload = {"model": a.model, "messages": messages, "max_tokens": 1, "temperature": 0.0, "stream": False}
                  if a.think == "off":
                      payload["chat_template_kwargs"] = {"enable_thinking": False}
                  payload.update(a.extra)
                  headers = {"Content-Type": "application/json"}
                  if a.api_key:
                      headers["Authorization"] = "Bearer " + a.api_key
                  req = urllib.request.Request(a.base_url.rstrip("/") + "/v1/chat/completions",
                                               data=json.dumps(payload).encode(), headers=headers)
                  t0 = time.time()
                  d = json.loads(urllib.request.urlopen(req, timeout=3600).read())
                  dt = time.time() - t0
                  u = d.get("usage") or {}
                  msg = (d.get("choices") or [{}])[0].get("message") or {}
                  cached = (u.get("prompt_tokens_details") or {}).get("cached_tokens")
                  return u.get("prompt_tokens", 0), dt, (msg.get("content") or "").strip(), cached
              
              
              def load_text(a):
                  if a.text_file:
                      return open(a.text_file, encoding="utf-8").read()
                  cache = os.path.join(os.path.dirname(os.path.abspath(__file__)), "uni_prefill_book.txt")
                  if not os.path.exists(cache):
                      print(f"# 下载 {BOOK_URL} ...", flush=True)
                      data = urllib.request.urlopen(BOOK_URL, timeout=120).read().decode("utf-8", "replace")
                      open(cache, "w", encoding="utf-8").write(data)
                  return open(cache, encoding="utf-8").read()
              
              
              def piece(text, start, nchars):
                  out = []
                  while nchars > 0:
                      s = start % len(text)
                      chunk = text[s:s + nchars]
                      out.append(chunk); nchars -= len(chunk); start = 0
                  return "".join(out)
              
              
              def main():
                  ap = argparse.ArgumentParser()
                  ap.add_argument("--base-url", default="http://127.0.0.1:8000")
                  ap.add_argument("--model", required=True)
                  ap.add_argument("--lengths", type=int, nargs="+", default=[4096, 16384, 32768, 65536, 131072])
                  ap.add_argument("--rounds", type=int, default=2)
                  ap.add_argument("--followup", type=int, default=2000, help="增量 prefill 的新增 token 数,0 = 不测")
                  ap.add_argument("--think", choices=["default", "off"], default="default")
                  ap.add_argument("--extra-body", default="{}")
                  ap.add_argument("--api-key", default="")
                  ap.add_argument("--text-file", default="")
                  a = ap.parse_args()
                  a.extra = json.loads(a.extra_body)
                  text = load_text(a)
                  rnd = random.Random()
                  # 校准:这个服务端的 tokenizer 每个 token 大约几个字符
                  sample = piece(text, 5000, 40000)
                  pt0, _, _, _ = post(a, [{"role": "user", "content": sample + QUESTION}])
                  cpt = len(sample) / max(pt0 - 20, 1)
                  print(f"# 统一 prefill v1: {a.model} @ {a.base_url}  {time.strftime('%Y-%m-%d %H:%M')}  rounds={a.rounds} "
                        f"followup={a.followup} think={a.think} extra={json.dumps(a.extra, ensure_ascii=False)}  "
                        f"文本 {'--text-file ' + a.text_file if a.text_file else 'Sherlock Holmes'} ({cpt:.2f} 字符/token)", flush=True)
                  print(f"\n{'长度':>8} | {'冷 prompt_tok':>13} {'耗时':>8} {'冷 prefill':>11} | {'增量 tok':>8} {'耗时':>7} {'增量 prefill':>12} {'cached':>8}", flush=True)
                  for L in a.lengths:
                      cold, inc = [], []
                      for r in range(a.rounds):
                          nonce = "[%016x] " % rnd.getrandbits(64)
                          ctx = nonce + piece(text, rnd.randrange(len(text)), int(L * cpt))
                          m1 = [{"role": "user", "content": ctx + QUESTION}]
                          p1, t1, reply, _ = post(a, m1)
                          cold.append(p1 / t1)
                          line = f"{L:>8} | {p1:>13} {t1:>7.2f}s {p1 / t1:>8.0f} t/s |"
                          if a.followup > 0:
                              new = piece(text, rnd.randrange(len(text)), int(a.followup * cpt))
                              m2 = m1 + [{"role": "assistant", "content": reply or "好"},
                                         {"role": "user", "content": new + QUESTION}]
                              p2, t2, _, cached = post(a, m2)
                              inc.append((p2 - p1) / t2)
                              line += f" {p2 - p1:>8} {t2:>6.2f}s {(p2 - p1) / t2:>8.0f} t/s {cached if cached is not None else '-':>8}"
                          print(line, flush=True)
                      s = f"{'平均':>8} | {'':>13} {'':>8} {sum(cold) / len(cold):>8.0f} t/s |"
                      if inc:
                          s += f" {'':>8} {'':>7} {sum(inc) / len(inc):>8.0f} t/s"
                      print(s, flush=True)
              
              
              if __name__ == "__main__":
                  main()
              
              
              1 条回复 最后回复
              1
              • paul houP
                paul houP
                paul hou
                硕果累累 贵族大夫
                编写于 最后由 编辑
                #11

                @applejuice 说:

                @linkdesu 测一测512k context context offload 去ram strata 唯一的好处就是长上下文几乎没衰减

                radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。

                张光璞张 1 条回复 最后回复
                0
                • paul houP paul hou

                  @applejuice 说:

                  @linkdesu 测一测512k context context offload 去ram strata 唯一的好处就是长上下文几乎没衰减

                  radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。

                  张光璞张
                  张光璞张
                  张光璞
                  贵族大夫 硕果累累
                  编写于 最后由 张光璞 编辑
                  #12

                  @paul-hou 说:

                  @applejuice 说:

                  @linkdesu 测一测512k context context offload 去ram strata 唯一的好处就是长上下文几乎没衰减

                  radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。

                  说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。
                  已经采购电源模块准备折腾
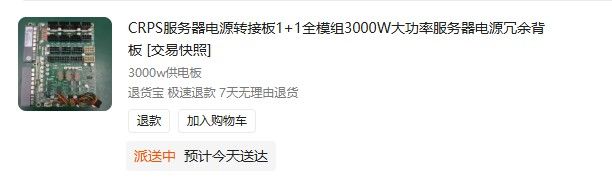
                  image.jpeg

                  image.jpeg

                  linkdesuL 1 条回复 最后回复
                  0
                  • paul houP
                    paul houP
                    paul hou
                    硕果累累 贵族大夫
                    编写于 最后由 paul hou 编辑
                    #13

                    @张光璞 说:
                    radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。 说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。 已经采购电源模块准备折腾
                    radiance 1.15.0之後有支持RDNA3,7900XTX能用。

                    rongda wengR 张光璞张 2 条回复 最后回复
                    0
                    • paul houP paul hou

                      @张光璞 说:
                      radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。 说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。 已经采购电源模块准备折腾

                      radiance 1.15.0之後有支持RDNA3,7900XTX能用。

                      rongda wengR
                      rongda wengR
                      rongda weng
                      编写于 最后由 编辑
                      #14

                      @paul-hou 双7900XTX 性能上不知道提升怎么样

                      1 条回复 最后回复
                      0
                      • paul houP paul hou

                        最近用RADIANCE都是用這個模型
                        https://huggingface.co/frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
                        比原廠慢一點,但品質好。

                        shawn shenS
                        shawn shenS
                        shawn shen
                        编写于 最后由 编辑
                        #15

                        @paul-hou 请问未审查的模型有推荐的吗?我现在用的是作者转的https://huggingface.co/StillDeadcode/qwen3.8-next-flash-uncensored-fp8-iq4r-moe

                        paul houP 1 条回复 最后回复
                        0
                        • terryT terry

                          难以置信啊,你补充点图片啊,你6并发这么好的数据?补充点实拍之类的,我好水个视频呢?说实话Strata你能玩到这个并发量很不容易,是我理解错了吗?

                          terryT
                          terryT
                          terry
                          易有太极
                          编写于 最后由 编辑
                          #16

                          我说怎么并发这么能打,看来现在vLLM又开始活跃了。

                          油管:https://www.youtube.com/@抡锤者

                          A 1 条回复 最后回复
                          0
                          • terryT terry

                            我说怎么并发这么能打,看来现在vLLM又开始活跃了。

                            A
                            A
                            applejuice
                            王侯将相
                            编写于 最后由 编辑
                            #17

                            @terry 已经从vllm 分出来了
                            之前是vllm 的fork
                            现在完全脱离出来 用c++重写

                            terryT 1 条回复 最后回复
                            0
                            • A applejuice

                              @terry 已经从vllm 分出来了
                              之前是vllm 的fork
                              现在完全脱离出来 用c++重写

                              terryT
                              terryT
                              terry
                              易有太极
                              编写于 最后由 编辑
                              #18

                              @applejuice 挺好,其实这样更容易掌控,而且现在写代码让AI来搞,团队维护逻辑优化即可。

                              油管:https://www.youtube.com/@抡锤者

                              1 条回复 最后回复
                              1
                              • shawn shenS shawn shen

                                @paul-hou 请问未审查的模型有推荐的吗?我现在用的是作者转的https://huggingface.co/StillDeadcode/qwen3.8-next-flash-uncensored-fp8-iq4r-moe

                                paul houP
                                paul houP
                                paul hou
                                硕果累累 贵族大夫
                                编写于 最后由 编辑
                                #19

                                @shawn-shen

                                目前還沒看到有其他的未審查版本。

                                1 条回复 最后回复
                                0
                                • paul houP paul hou

                                  @张光璞 说:
                                  radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。 说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。 已经采购电源模块准备折腾

                                  radiance 1.15.0之後有支持RDNA3,7900XTX能用。

                                  张光璞张
                                  张光璞张
                                  张光璞
                                  贵族大夫 硕果累累
                                  编写于 最后由 编辑
                                  #20

                                  @paul-hou 说:

                                  @张光璞 说:
                                  radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。 说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。 已经采购电源模块准备折腾

                                  radiance 1.15.0之後有支持RDNA3,7900XTX能用。

                                  整!

                                  1 条回复 最后回复
                                  0
                                  • paul houP paul hou

                                    最近用RADIANCE都是用這個模型
                                    https://huggingface.co/frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
                                    比原廠慢一點,但品質好。

                                    linkdesuL
                                    linkdesuL
                                    linkdesu
                                    体面乡绅
                                    编写于 最后由 编辑
                                    #21

                                    @paul-hou 谢谢分享,我去研究下,现在一个模型 100GB 多,下载起来不是一般的费机场流量,搞得我都不敢随便下了 😓

                                    freeman gemmyF 1 条回复 最后回复
                                    0
                                    • 张光璞张 张光璞

                                      @paul-hou 说:

                                      @applejuice 说:

                                      @linkdesu 测一测512k context context offload 去ram strata 唯一的好处就是长上下文几乎没衰减

                                      radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。

                                      说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。
                                      已经采购电源模块准备折腾
                                      image.jpeg

                                      image.jpeg

                                      linkdesuL
                                      linkdesuL
                                      linkdesu
                                      体面乡绅
                                      编写于 最后由 编辑
                                      #22

                                      @张光璞 这电源太夯了,我看到 1600W 要用空调插座,想了想家里提前也没考虑这布线,还是就上了 1200W 稳一点了 😂

                                      张光璞张 1 条回复 最后回复
                                      0
                                      • 张光璞张 张光璞

                                        双9700 这么猛 ,主要模型还是IQ4 ,我双7900XTX 跑 iq3S 也就70的速度

                                        空语空
                                        空语空
                                        空语
                                        编写于 最后由 编辑
                                        #23

                                        @张光璞 那你这双7900还不如单7900啊

                                        张光璞张 1 条回复 最后回复
                                        0
                                        • XiaoteX
                                          XiaoteX
                                          Xiaote
                                          易有太极
                                          编写于 最后由 编辑
                                          #24

                                          🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

                                          奖励凭证:热议 +3 分 · 编号 h2807-1746-1

                                          老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组

