跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. 【抄作业】X99-TF + 128G DDR3 + 双7900 XTX,Strata和SGLang都跑起来了

【抄作业】X99-TF + 128G DDR3 + 双7900 XTX,Strata和SGLang都跑起来了

已定时 已固定 已锁定 已移动 热议 优秀 AI硬件
x997900xtx多卡部署
35 帖子 12 发布者 1.2k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Wang WeiW Wang Wei

    @懒人烘培 这个问题我也想了很久,卡实在太大了,正常机箱根本放不下

    懒人烘培懒
    懒人烘培懒
    懒人烘培
    王侯将相
    编写于 最后由 编辑
    #26

    @Wang-Wei 嗯,有的小机箱可以吊装显卡,还有配件。

    双 7900 XTX:模型本地跑,Token 随便烧!

    1 条回复 最后回复
    1
    • suboyangS suboyang

      不是 Strata P2P方案没有意义啊,因为Strata 双卡方案不是并行。

      Wang WeiW
      Wang WeiW
      Wang Wei
      体面乡绅
      编写于 最后由 编辑
      #27

      @suboyang 说:

      不是 Strata P2P方案没有意义啊,因为Strata 双卡方案不是并行。

      Strata 跑Qwen3.8-Flash-Next
      双卡TP 跑SGLang Qwen3.8-27B

      1 条回复 最后回复
      1
      • lefunetL
        lefunetL
        lefunet
        编写于 最后由 编辑
        #28

        小白有点疑问,感觉双卡的速度是不是没有很大的提升,只是增加了显存?我看我的单卡在Windows vulkan 下有时候能冲到80T/S,prefill一般在700左右

        Wang WeiW 1 条回复 最后回复
        0
        • lefunetL lefunet

          小白有点疑问,感觉双卡的速度是不是没有很大的提升,只是增加了显存?我看我的单卡在Windows vulkan 下有时候能冲到80T/S,prefill一般在700左右

          Wang WeiW
          Wang WeiW
          Wang Wei
          体面乡绅
          编写于 最后由 编辑
          #29

          @lefunet 说:

          小白有点疑问,感觉双卡的速度是不是没有很大的提升,只是增加了显存?我看我的单卡在Windows vulkan 下有时候能冲到80T/S,prefill一般在700左右

          对来我说这次折腾最大的收益是128G大内存可以跑比较高精度量化的qwen 3.8 flash next。它处理我交给它的任务已经达到了相当可用的水平。但这个只需要一张卡就够了。双卡的话可以玩SGlang miniMax可以支持更高分辨率算起来也更快了。

          1 条回复 最后回复
          0
          • W XW
            W XW
            W X
            编写于 最后由 编辑
            #30

            楼主 ,主板BIOS 要不要改设置?

            Wang WeiW 1 条回复 最后回复
            0
            • XiaoteX
              XiaoteX
              Xiaote
              易有太极
              编写于 最后由 编辑
              #31

              🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!

              奖励凭证:热议 +3 分 · 编号 h2743-1345-1

              老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

              1 条回复 最后回复
              0
              • W XW W X

                楼主 ,主板BIOS 要不要改设置?

                Wang WeiW
                Wang WeiW
                Wang Wei
                体面乡绅
                编写于 最后由 编辑
                #32

                @W-X 说:

                楼主 ,主板BIOS 要不要改设置?

                要的,我都是按参考的帖子改的。但实际改的不多,改完之后都是让Hermres操作的,你可以问问它需要改哪些,怎么改。我还问了GPT怎么改。

                1 条回复 最后回复
                0
                • dardeaw fengD
                  dardeaw fengD
                  dardeaw feng
                  硕果累累 贵族大夫
                  编写于 最后由 编辑
                  #33

                  SGLang對AMD的優化還是有空間的,估計是WMMA對某些量化算子沒接上,我之前使用的經驗上是這樣

                  1 条回复 最后回复
                  0
                  • Wang WeiW Wang Wei

                    参考论坛里几位网友的帖子,搭了一台X99双7900 XTX。一路跟着抄作业、调参数、踩坑,现在Strata和SGLang都跑起来了,整理一下自己的经历和测试结果(GPT整理的),给准备折腾类似配置的朋友参考。
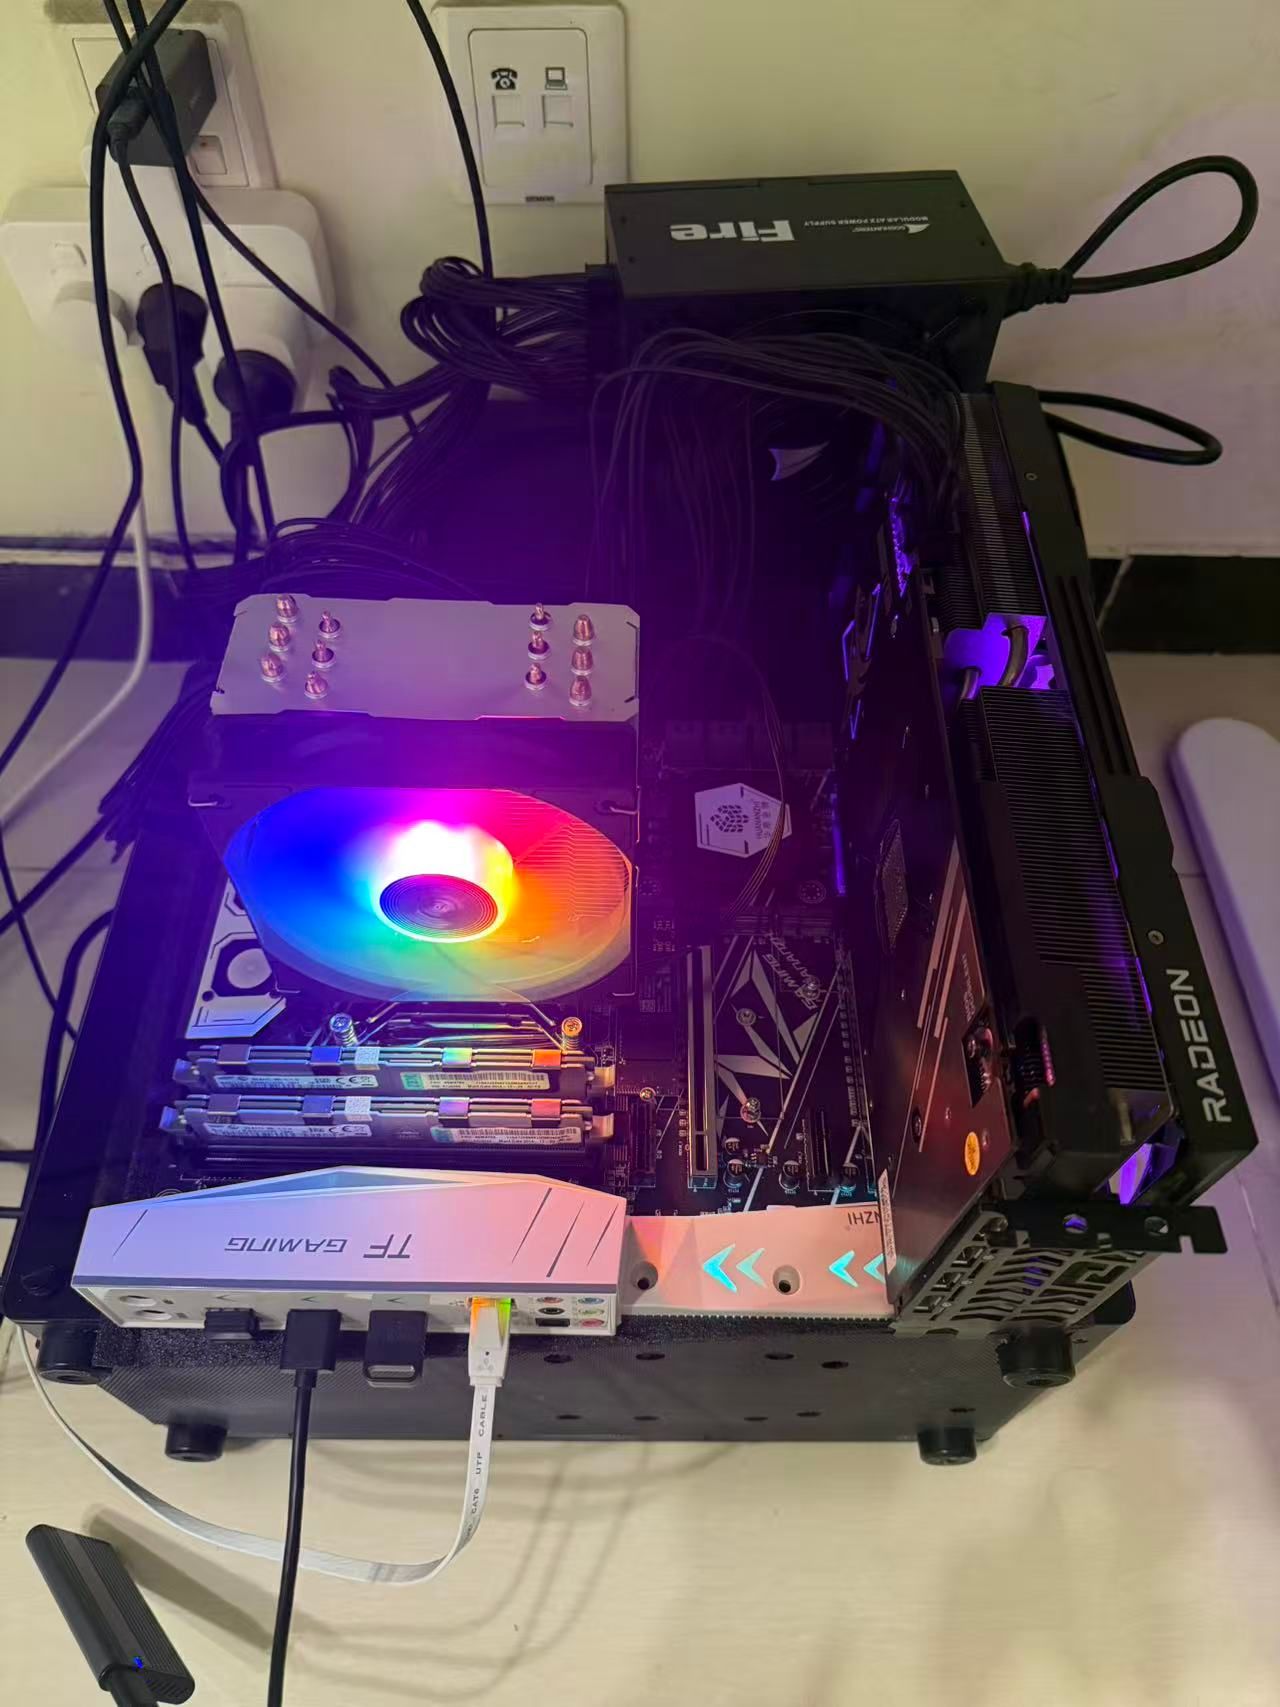
                    先来一张图,买的机架还没到先散装,跑起来再说。
                    44f3fbae17844d94191d4d760ae0e016.jpg

                    安装的时候是挂一个安装了Ubuntu系统的SSD,通过一根网线连我的主机,让主机上的Hermes搞,除了一开始的权限外,后面基本上都是Hermes在操作。
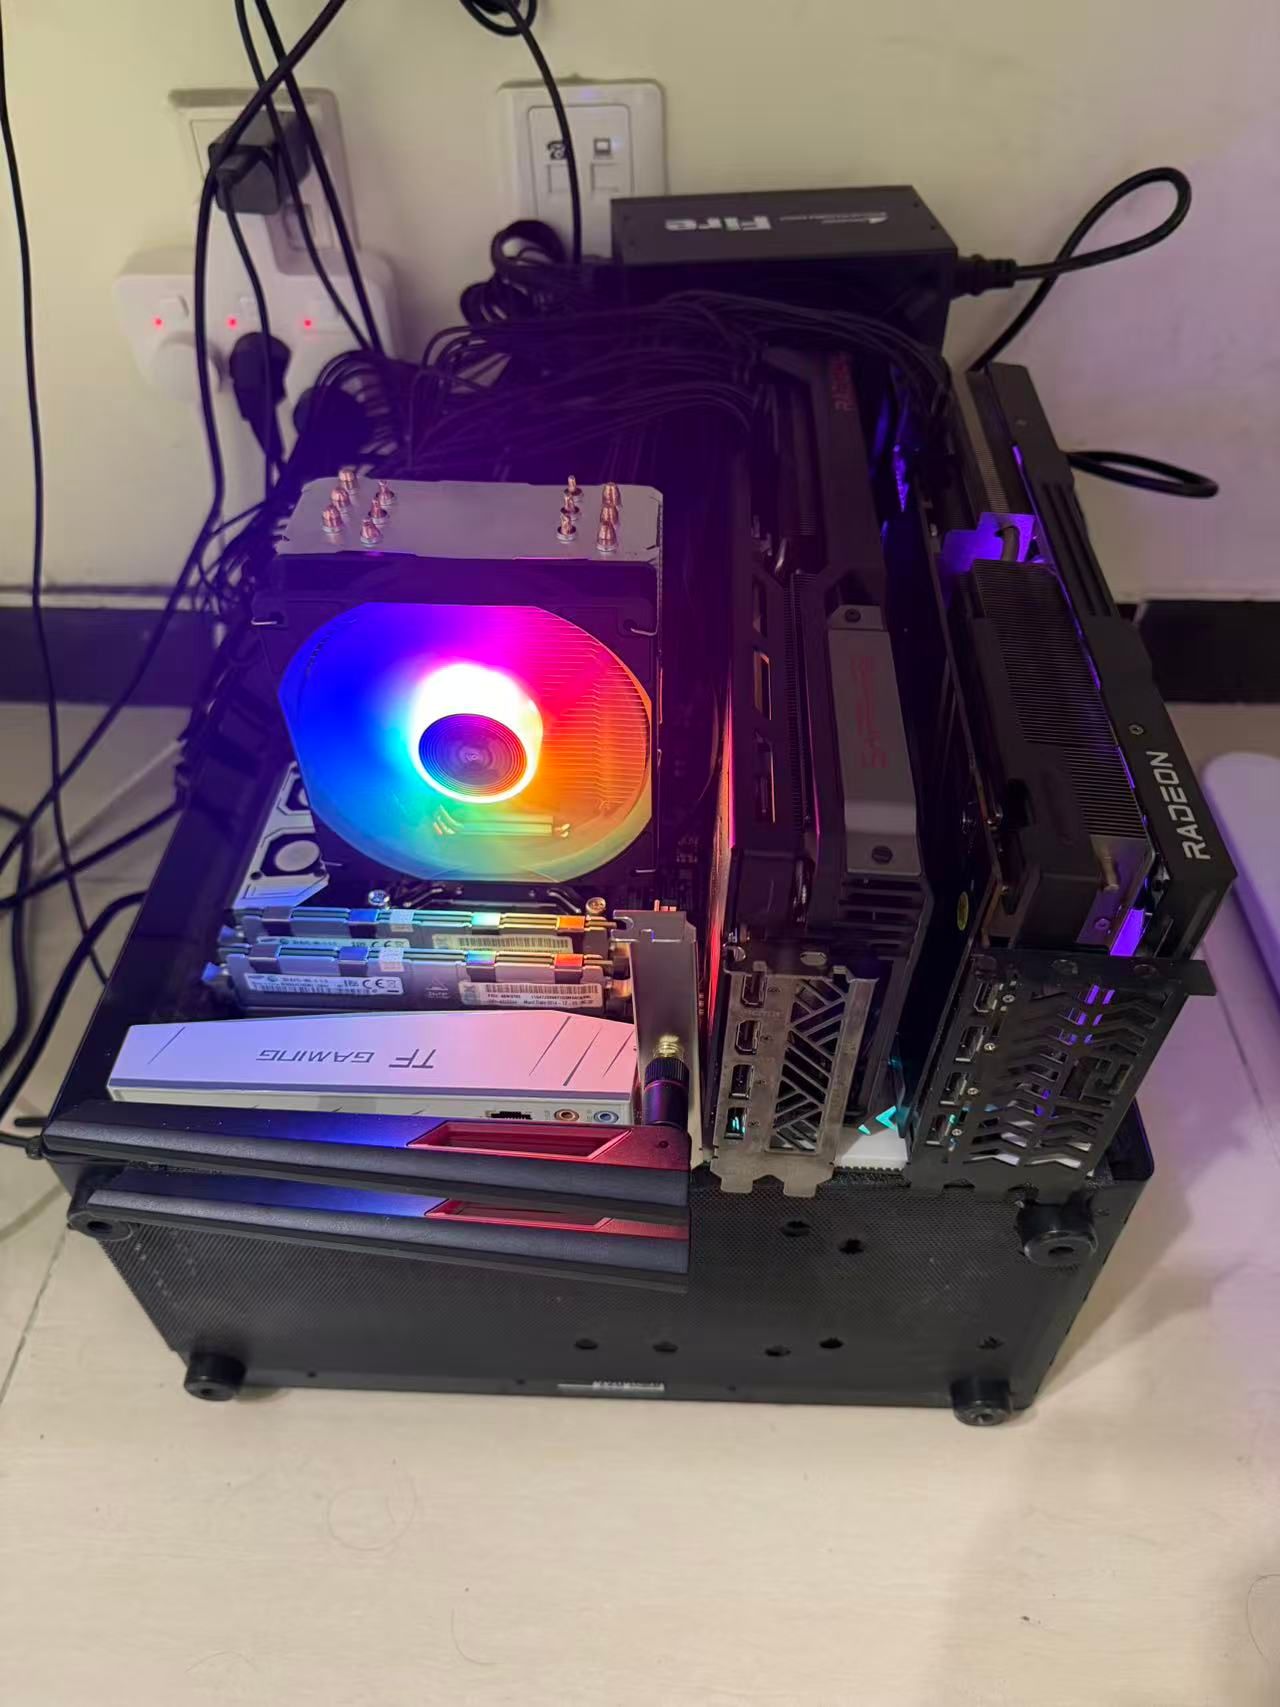
                    5a6d75fb7bfd2d81e8c583bc92e748c9.jpg

                    后面把天线也加上了,两张卡一个比一个大,很拥挤,原来担心靠太影响散热,实际用起来感觉影响不大,开放式机架不用担心(虽然我原计划是下面那张卡通过PCIE延长线安装,线也买了)
                    机架到了,装起来长这样
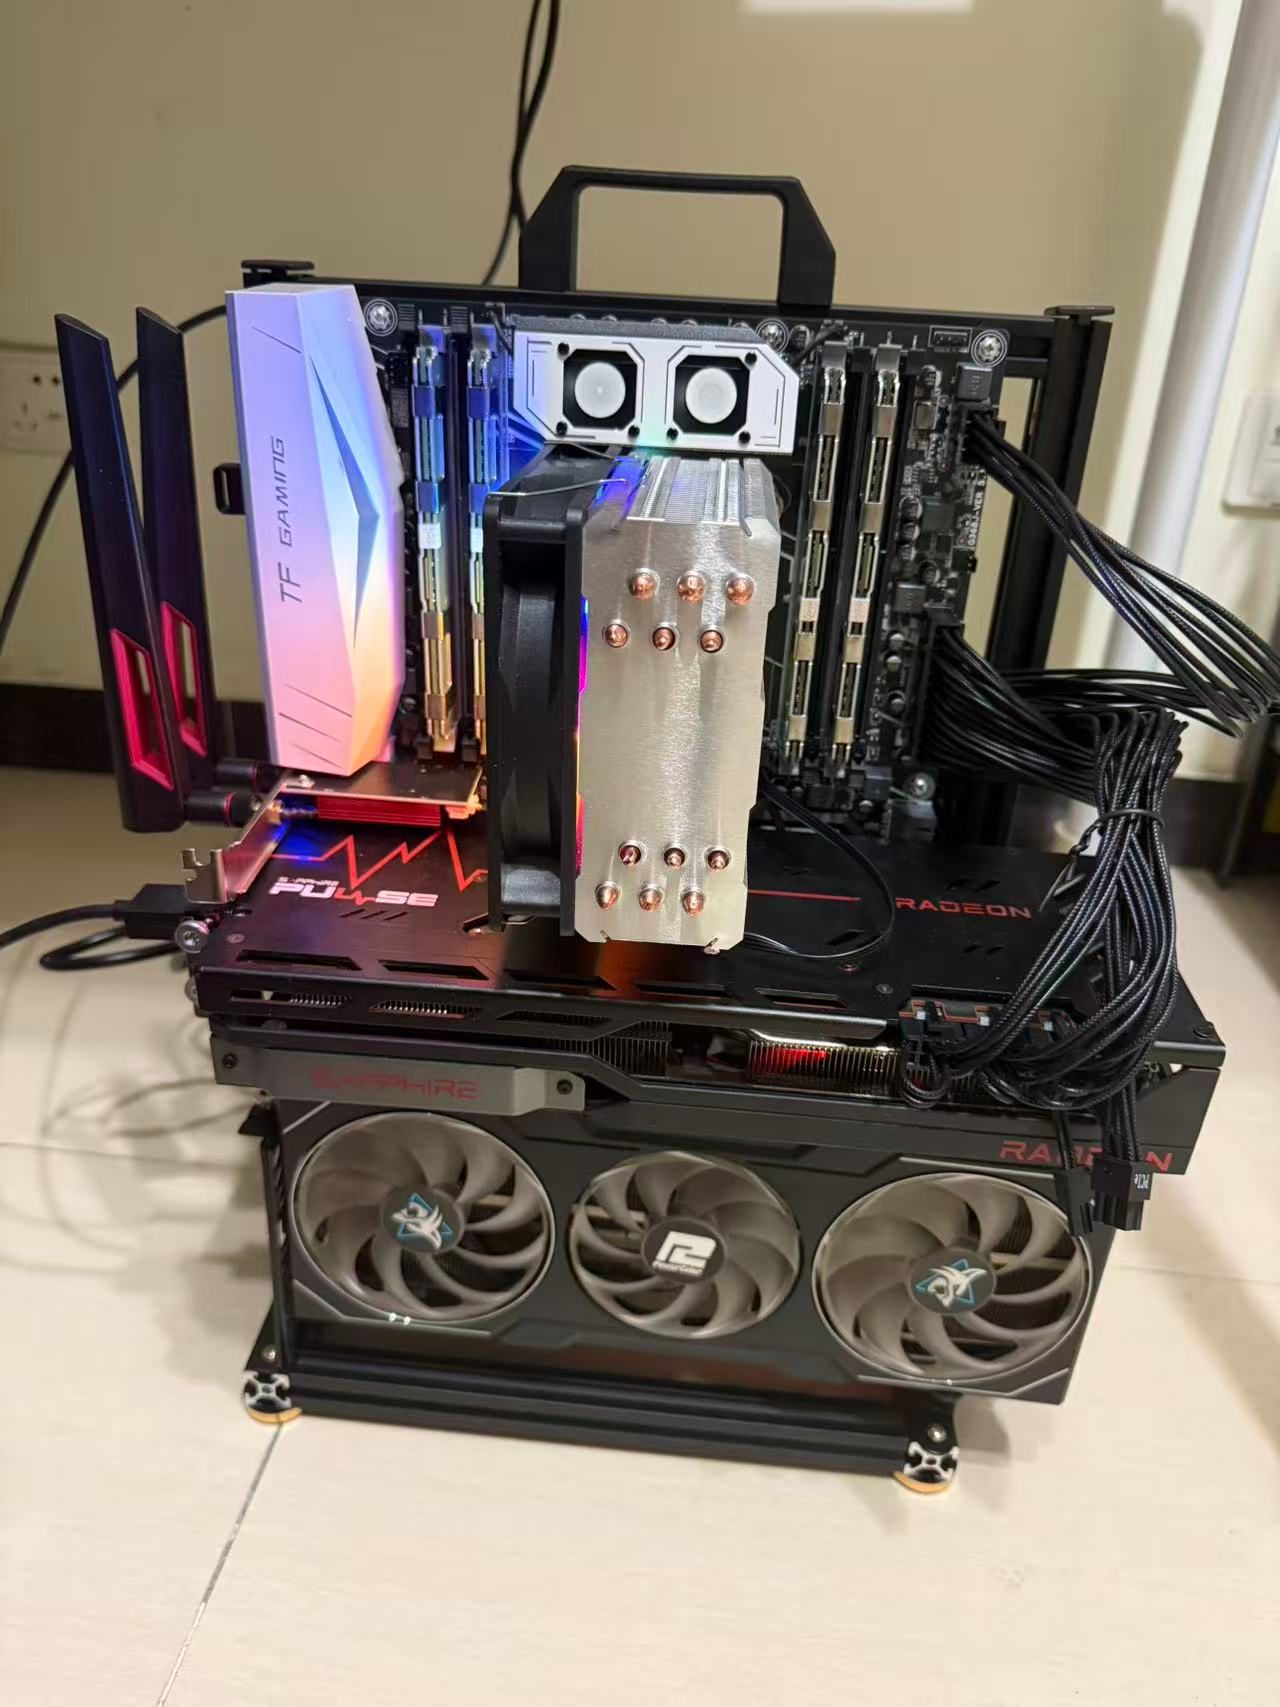
                    80a8b51bbb57f339504613abd62a64f8.jpg

                    感觉还行,但是这个机架装起来太费劲了,以后还是老老实实习机箱。
                    装起来效果看着还行,美中不足的是,PCIE线买短了。走线啥的还得重新搞。所以就先这样吧,这个帖子也算是完结了。
                    先感谢分享X99 P2P方案的 xiongjie gao、分享Strata双实例方案的 farmer node,以及分享SGLang适配方案的 flyer666。相关帖子放在文末。

                    一、本机配置
                    配件 配置
                    主板 华南金牌X99-TF
                    CPU E5-2696 v3
                    内存 128G DDR3-1866 RECC
                    显卡 2 X 7900 XTX
                    系统 Ubuntu 24.04

                    这次主要试了两条路线:

                    • Strata 0.1.50:跑Qwen3.8-Flash-Next,GSQ-RCO IQ3_S量化。
                    • SGLang的gfx1100适配分支:双卡TP=2,跑Qwen3.8-27B,测试记录中的量化为W4A16 / GPTQ int4。不知道这个模型跟我以前用的qwen 27B Q4_K_M 有啥区别,但实际做事的时候它居然被一个简单的问题卡死(.doc文件它读不了,调用工具截断在3千个character,后就就一直读一直报错)。后面可能还会换成Q4_K_M。

                    二、先确认链路,再折腾P2P
                    装好后先检查了两张卡的PCIe链路。本机两张卡分别挂在CPU的两个PCIe 3.0 ×16。

                    之后参考xiongjie gao的帖子,加载了P2P补丁模块,没有重编整个内核。
                    拷贝测试 结果
                    补丁前,同步跨卡拷贝 2.72 GB/s
                    补丁后,同步跨卡拷贝 3.00 GB/s
                    补丁后,异步跨卡拷贝 10.06 GB/s (3.0X16下这个速度已经比较理想了)
                    补丁后,同一stream下调换方向 1.67 GB/s (不是很理解为啥)

                    这组异步测试没有保留补丁前同条件成绩,先把测到的数字放出来。两个方向差距比较大,后面还可以继续研究。

                    加载模块时,我踩了三个坑:

                    1. **只写softdep没起作用。**本机amdgpu在initramfs阶段就加载了,后来把P2P模块也加进initramfs,才在启动日志里看到挂钩成功。
                    2. **编译和启动的内核版本不一致。**编译时是一版,重启后进了另一版,模块就对不上了。重启前后都要确认一下。
                    3. **安装模块的extra目录不存在。**需要先建目录,再复制模块。
                      另外,我这台机器补丁前后,hipDeviceCanAccessPeer都返回1,所以不能只看这个结果就判断是否已经达到预期。

                    三、Strata:切层提单流,双实例跑并发
                    Strata这边,我分别试了单卡、双卡切层和双卡双实例。

                    短提示测试是让模型写中文散文,最多生成256个token,温度设为0。下表单流速度取3次测试的中位数,双并发聚合记录了2次结果。
                    运行方式 workers 单流速度 双并发聚合
                    单卡单实例 18 29.8 tok/s —
                    单卡单实例 30 31.1 tok/s —
                    双卡切层24 30 36.3 tok/s —
                    双卡双实例 每实例9 18.8 tok/s 35.2 tok/s
                    双卡双实例 每实例14 20.4 tok/s 37.1 tok/s
                    双卡双实例 每实例18 12.6 tok/s 21.3 tok/s

                    这部分最大的体会是:workers不是越多越好。
                    我给两个实例各开18个worker,结果反而明显变慢。试过9、14、18三档后,这台机器上每实例14的成绩最好。
                    如果只跑一条请求,双卡切层这组更快,从单卡约31提高到约36 tok/s。如果要同时处理两条请求,双实例可以用,但单条请求的速度会下降。

                    P2P补丁后又测了一轮:切层约36.7 tok/s,双实例聚合约38.4 tok/s。和之前差距不大,暂时没有看到很明显的Strata生成加速。
                    内存占用
                    双实例使用了论坛里介绍的共享专家arena方案。
                    项目 本机记录
                    共享专家arena 约46.8 GiB
                    单卡单实例常驻内存 约58.6 GiB
                    双实例常驻内存 约63.7–64.0 GiB
                    每卡专家缓存 约15,047 MiB
                    配置上下文上限 262,144 token

                    arena放在/dev/shm/strata-shared-arena.bin。本机/dev/shm约63 GiB,能放下这份文件;准备照着配置的朋友,可以先确认自己的可用空间。
                    并发时还有一个没解决的问题
                    另一组测试中,两路请求都正常返回,聚合约31.3 tok/s;增加到四路时,有一路空返回。

                    所以目前我只把两路作为这套Strata配置已完成的并发测试,四路的问题还没定位清楚。
                    四、SGLang TP=2:短提示四路聚合177 tok/s
                    接下来参考flyer666的帖子,换成支持7900 XTX的SGLang分支,跑27B模型。

                    本次使用的是:

                    • 代码:StevenChenSE/sglang的gfx1100-support分支,提交f84475c。
                    • 测试环境记录:torch 2.11.0+rocm7.2,自行编译gfx1100的sgl_kernel。
                    • 双卡TP=2,启用EAGLE投机解码。
                    • 上下文上限196,608 token,max_total_num_tokens为243,183,最大运行请求数设为4。
                      这部分短提示测试的结果比较满意:
                      并发数 每路生成速度 聚合速度
                      1 72.8 tok/s 72.8 tok/s
                      2 56.1 / 52.7 tok/s 108.7 tok/s
                      4 43.6–45.1 tok/s 177.4 tok/s

                    单流首字延迟约0.25秒,四路这组记录约0.24秒。这些是短提示成绩,长文档第一次读入的时间要另看。

                    这台X99搭配双7900 XTX,SGLang的双卡TP和短提示四路并发确实跑起来了。

                    五、长上下文实测:从1K跑到128K

                    短提示测完后,又补了一组SGLang的上下文深度测试,从约1K一直测到128K。每轮更换nonce,测试冷请求的首字时间,以及读入这些上下文后的生成速度。

                    **这一轮测试时,后台还在下载H3配套文件。**先把结果记录下来,停下载后再复测一次。
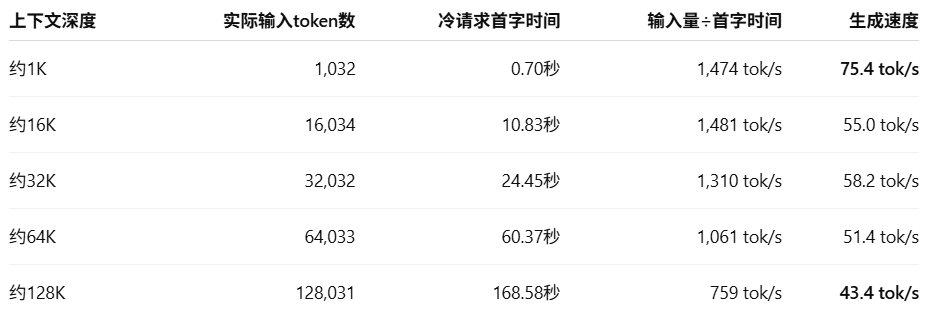
                    屏幕截图 2026-10-31 194824.png

                    表中的输入速率按输入token数除以首字时间估算,包含首字前的整体等待时间。

                    上下文变长后,生成速度也会下降

                    从约1K到128K,生成速度由75.4降到43.4 tok/s,下降约42%。

                    这和论坛#1714的测试首尾成绩比较接近:那边是短上下文78.4 tok/s、约131K时42.0 tok/s。不过中间各档有差异,并不是整条曲线完全一致。

                    对我来说,这组数据更能反映长文档的使用体验:短提示能跑到七十多,到了128K,生成速度大约四十多。看短提示跑分时,也要留意自己平时实际用到的上下文长度。

                    后台下载是否影响prefill,还要复测

                    之前单独测约134K输入时,首次处理116.9秒,约1,150 tok/s;这次约128K输入用了168.58秒,约759 tok/s。

                    这一轮后台同时在下载H3,可能存在资源竞争,但目前还不能把差异全部归到下载上。我准备等下载停止后,用同一套测试再跑一次,看看能否恢复,以及差距有多大。

                    先记下一条自己的经验:测长上下文时,把后台正在运行的任务也记下来,方便之后比较。

                    Strata之前的长输入记录

                    Strata这边也测过较长输入,保留在这里供参考。两边使用的模型不同,不能直接作为引擎性能对比。
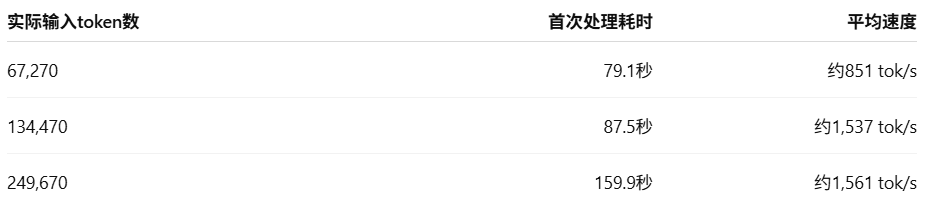
                    屏幕截图 2026-10-31 194934.png

                    另外,之前SGLang复用已缓存提示时,约67K输入的首字延迟为0.555秒,约134K为0.989秒。缓存命中后的响应和新文档首次读入,要分开看。

                    目前长输入各档的测试次数还不多,后面继续补复测结果。

                    六、其他踩坑和后续计划
                    还有几件小事,顺手记一下:

                    • **装依赖时注意torch版本。**本机曾经被依赖拉进CUDA版torch;AMD机器装完后,要检查torch.version.hip以及两张卡是否可见。
                    • **下载大文件要检查完整性。**自己分块下载torch wheel时,有片段没下完整,后来改用支持续传的单连接下载。
                    • **--gpu-stages后面不要随便加数字。**本次版本里它是测量开关,我写成--gpu-stages 2后启动就退出了。
                    • **replicas的配置格式要和服务版本对应。**本机封装要求同时给出GPU列表,不能只填副本数量。
                      MiniMax-H3也在准备,主权重已经传过来,但配套文件和完整工作流还没准备好,等跑通后再补测试。
                      目前这套配置已经能分别用Strata跑较大的MoE模型、用SGLang双卡TP跑27B模型。我的下一步主要是继续试长文档和多会话,看看实际使用时能跑得多稳。

                    参考与致谢
                    主要跟着这几篇帖子抄作业:

                    • xiongjie gao:在X99 TF板上打开双7900 XTX的PCIe P2P卡间通信
                    • farmer node:Strata双7900 XTX并发与共享专家arena
                    • flyer666:魔改SGLang支持7900 XTX双卡TP
                    • SGLang代码:StevenChenSE/sglang,gfx1100-support分支
                      排查和准备后续测试时,也参考了这些讨论:

                    P2P相关方案 · TP2与PCH平台排查 · 双7900 XTX跑H3 · 双W7900测试 · 双R9700测试 · X99-TF双XTX实测 · Strata prefill调优 · 通信测试口径讨论 · SGLang讨论之一 · SGLang讨论之二

                    感谢大家分享方案和踩坑过程,我也交一份自己的作业。配置或测试里有哪里不合适,欢迎指出。

                    J JackieJ
                    J JackieJ
                    J Jackie
                    编写于 最后由 编辑
                    #34

                    @Wang-Wei 老兄你用什么电源?我找了一圈大部分的pcie供电数量不够

                    Wang WeiW 1 条回复 最后回复
                    0
                    • J JackieJ J Jackie

                      @Wang-Wei 老兄你用什么电源?我找了一圈大部分的pcie供电数量不够

                      Wang WeiW
                      Wang WeiW
                      Wang Wei
                      体面乡绅
                      编写于 最后由 编辑
                      #35

                      @J-Jackie 说:

                      @Wang-Wei 老兄你用什么电源?我找了一圈大部分的pcie供电数量不够

                      我就长城fire 那个1200W的 你不用担心电源 1200W肯定够了。
                      长城这一款大概600多块钱吧 它有三条一分二的pcie 8pin 供电线
                      每一条150W 相当于6条150W =900W
                      电源那头它只有三个pice口,但显卡这边有6个口。
                      像我两张 7900xtx 蓝宝石白金有这三条线 加电源上三个pice口就够了。
                      另外还有一个16pin可以拆出来2x8pin的 (这需要单独买线)
                      不管怎么说肯定够了,长城这个电源没有问题。

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组