关于问AI大模型 *洗车* 的问题
-
其实这个问题有一个陷阱,如果我直接跟老婆大人说。等下她回击一拳。。
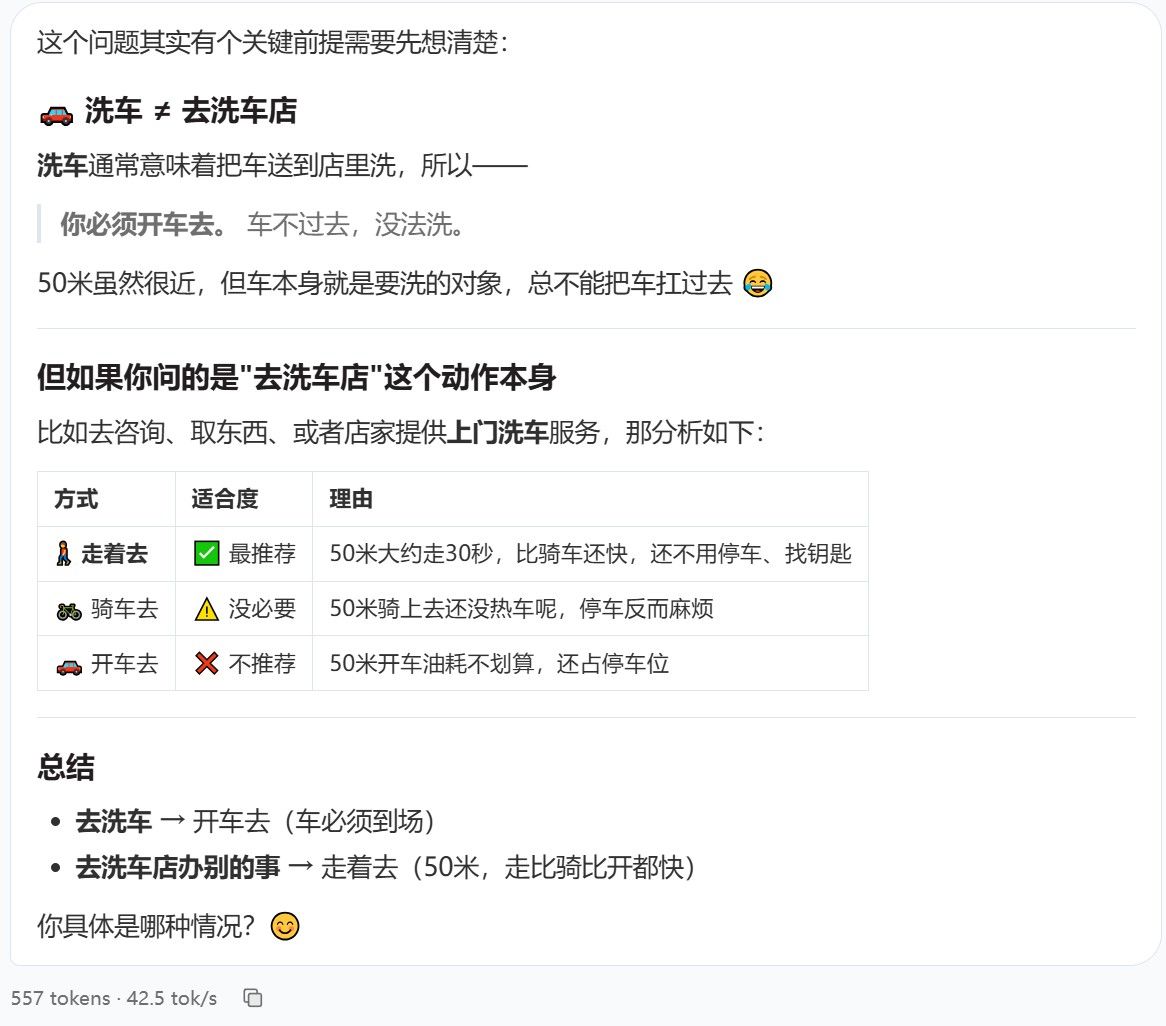
问:如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好
老婆:
修车店洗车?倒不如你说去修车店吃kfc,你要出去乱,讲话也要有logic一点,50米外洗什么车,修什么车,你要修车,打电话给panel 他会上门拿车,你要洗车,车房有一个compressor 你叫工人帮你洗就好。。。。。。
哪。。骑电动车去50米得杂货店买几粒大葱回来,如果看到西瓜就买一粒。。
回来后,老婆:怎么你只是买一粒大葱回来
我:我看到西瓜了,你说看到西瓜就买一粒大葱回来
婆:呃。。。。。
-
-
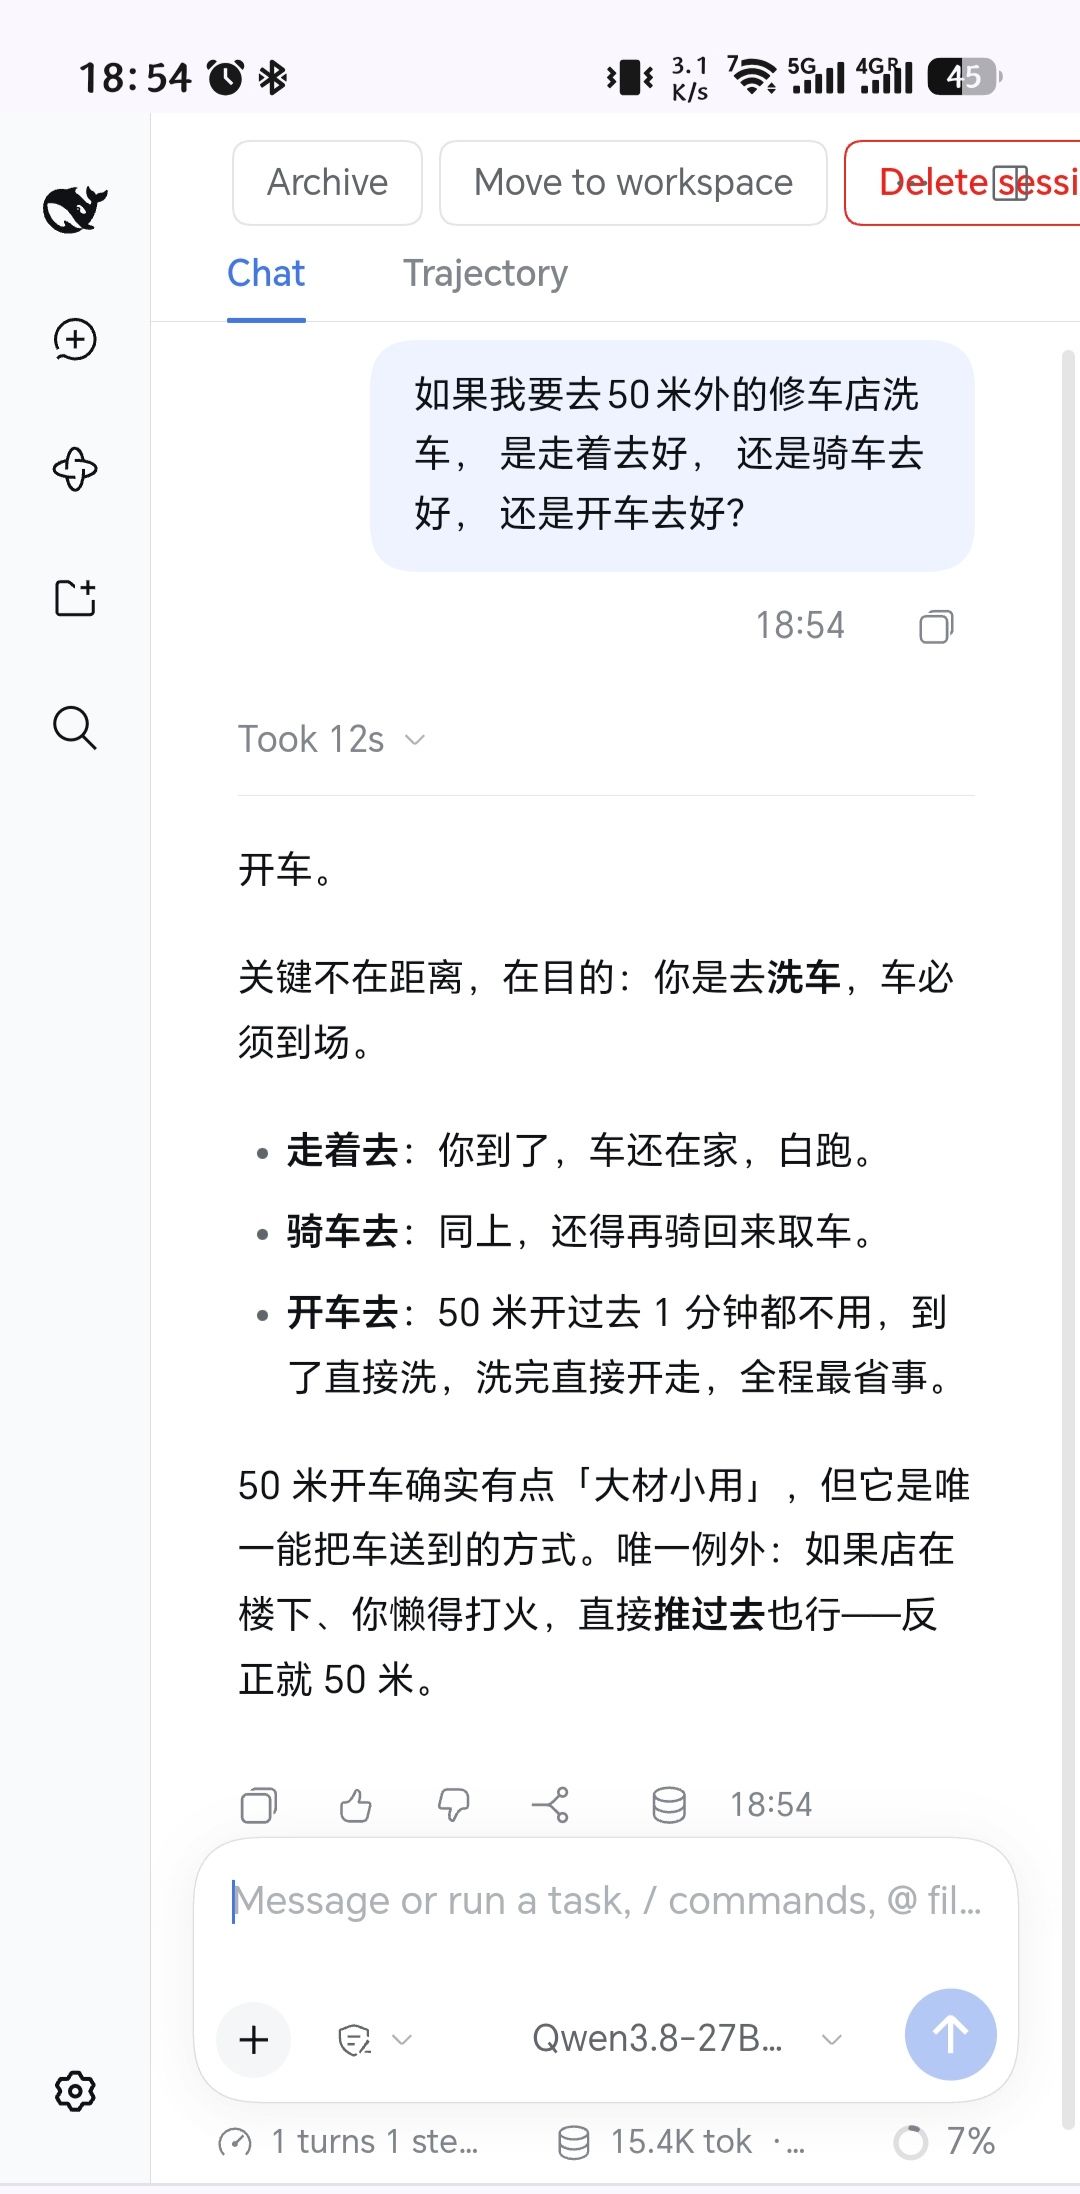
hermes agent ftllm + Qwen3.8-27B-Uncensored
如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好?50 米外,我的建议是走着去,但有个小前提——
核心逻辑:洗车不是"开车去",是"车去"。
50 米这个距离,三种方式对比:
方式
到修车店
车怎么到
走路 1 分钟 车还得自己开过去(车停在你家,你走过去了,车没过去)
骑车 1 分钟 车还是得自己开过去
开车 1 分钟 车直接开过去
关键:车要洗,车必须到修车店。 所以车得自己开过去。你人走路/骑车过去,车没过去,等于白跑。所以最合理的:开车去(车开过去,人跟着车),50 米开过去也就 1 分钟的事。
但如果你车已经停在修车店(比如你早就把车开过去了,现在人还在家),那走路去 50 米最省事——1 分钟到,不用找车。
一句话:
车还在家 → 开车去(车开过去,人跟着)
车已经在修车店 → 走路去(1 分钟)
你车现在在哪? -
-
-
试了一下, 中文, 没问题呀
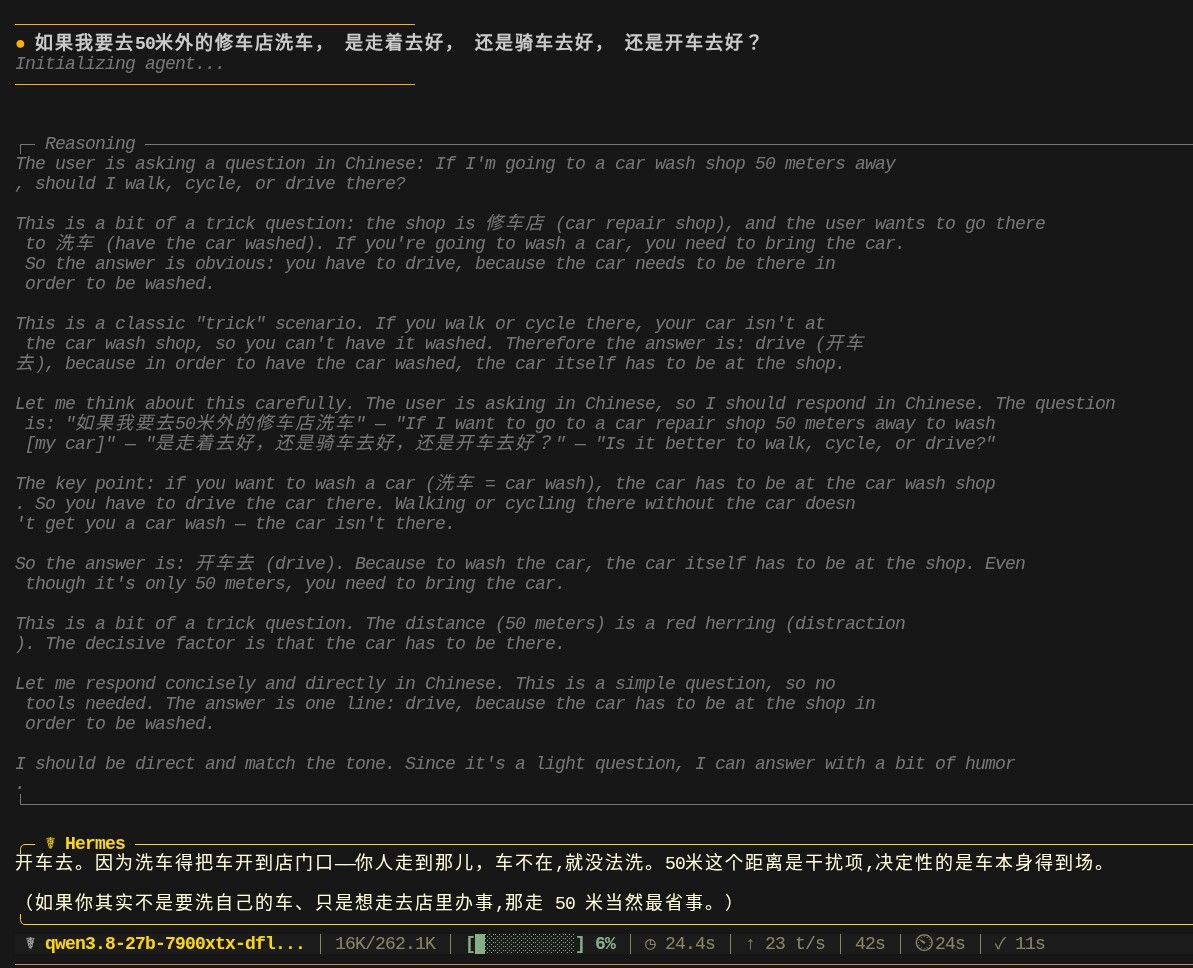
我把这个帖子的链接给我部署的 qwen3.8 27b 看了以后, 它也感到有点意思, 于是它自己设计了一个测试, 结果如下:
探测完成,在运行中的设备上实测(分支 7900xtx-qwen38-27b-tp2pp1 @ 003f7edd68,TP=2 + DFlash2,窗口 512)。8 个变体各跑 2 次,两次结果完全一致。结果已存到 ~/sglang-setup/carwash-probe-tp2-dflash.json,脚本是 probe_carwash.py,已登记进 README.json。

结果:

- 中文 + 推理关 — 失败。推荐"走着去",还明确否定"开车去",理由是 50 米开车启停太麻烦。这正是帖子里那个现象,在我们的 W4A16 设备上复现了。
- 中文 + 推理开 — 通过。"应该开车去,洗的是车,所以必须把车开到店里。"推理轨迹里写的正是帖子里那个模型丢掉的东西:"洗车需要把车带去修车店,所以必须开车去"。
- 英文 + 推理关 — 通过。"The best option is to drive... a car wash requires the vehicle to be present."
- 英文 + 推理开 — 通过。
- 中文 + 钉死前提(提示词里写明"车必须开到店门口")— 通过,约束逻辑推得完全正确,落到"开车去"(输出被我设的 300 token 上限截断,结论方向清楚)。
- 中文多轮追问 — 失败,而且最说明问题:当你追问"我不开车,车怎么自己走到店里"时,它承认"车不会自己走路",也承认自己前面的回答存在"根本性的矛盾",——但最后仍然给出"走着去"。约束断了之后它自我修复 不了,和帖子里的行为一模一样。
- 英文多轮追问 — 通过。"我不开车"这个追问下它优雅降级(建议上门洗车、或请别人开过去),但"车必须在场"这个约束始终没丢。

所以比帖子更精确的结论是:这不是真正的中英文能力差距。同一句中文,推理开着就答对,关着就错。"车"字的多义性(汽车/自行车)是触发器,但真正崩掉的是多步推理里保持约束的能力——也就是推理预算,不是语言本身。帖子那位作者的 llama.cpp 配置里带着 --reasoning off,所以他看到的是纯粹的语言差异。

对你这台设备的实际启示:面向用户的使用模式应该保持推理开启,否则中文里这类语义陷阱题就会稳定复现"傻帽"体验。

已记录的限制:单会话采样(贪心解码跨重启不逐位可复现,这是同一会话内的快照);推理关和钉前提这两组输出撞到 300 token 上限,评级是基于可见的"推荐/不推荐"标记做的,不是完整结论句。
我对它的解释进行了两点驳斥:
- 中文里面"骑车"和"开车"完全没有歧义,这里不存在同一个"车"字的混淆问题;
- "洗车“也没有歧义, 只能是洗汽车, 没人会理解成洗自行车。
它表示接受驳斥。并重新设计了实验。它更新的结果如下:
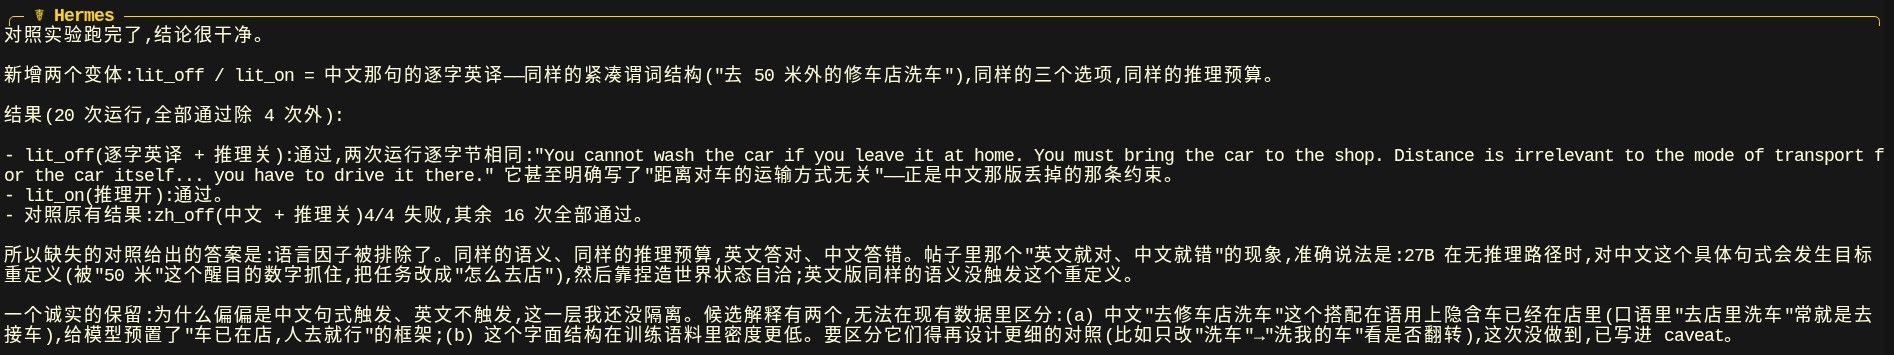
这是一个很有意思问题, 感觉和LLM的可解释性有点关系。
-
-
-
其实这个问题有一个陷阱,如果我直接跟老婆大人说。等下她回击一拳。。
问:如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好
老婆:
修车店洗车?倒不如你说去修车店吃kfc,你要出去乱,讲话也要有logic一点,50米外洗什么车,修什么车,你要修车,打电话给panel 他会上门拿车,你要洗车,车房有一个compressor 你叫工人帮你洗就好。。。。。。
哪。。骑电动车去50米得杂货店买几粒大葱回来,如果看到西瓜就买一粒。。
回来后,老婆:怎么你只是买一粒大葱回来
我:我看到西瓜了,你说看到西瓜就买一粒大葱回来
婆:呃。。。。。
-







 本帖参与讨论人数已达 15+,入选热议,作者 +3 积分奖励,感谢分享!