新手求助|X99-8D3双路+双7900XTX Z30机箱放不下双卡,外置显卡方案求推荐
-
换主板是正解。
通过你的问题说明硬件你是新手。尽量用简单的组装方案最好。
重点:2个CPU 对 本地AI的算力没什么作用。单CPU就够了。这个双CPU方案没什么可取之处。个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
换主板是正解。
通过你的问题说明硬件你是新手。尽量用简单的组装方案最好。
重点:2个CPU 对 本地AI的算力没什么作用。单CPU就够了。这个双CPU方案没什么可取之处。@williamlouis 因为我第一次DIY组机会有遇到一定风险的觉悟,以及商家那买的的机箱、电源、硬盘这些都是新件退货对他们来说应该会有损害(虽然他们客服也有点不专业),尽量还是能用则用,所以还是感谢建议!
-
第一次组装电脑,同时也是新手发帖,如果格式不对或其他问题,欢迎指正。
目前已购买:
显卡2张:东哥一手蓝宝石7900xtx超白金,东哥拍拍蓝宝石7900xtx超白金
主板cpu:X99-8D3+2666V32+四铜管风扇2
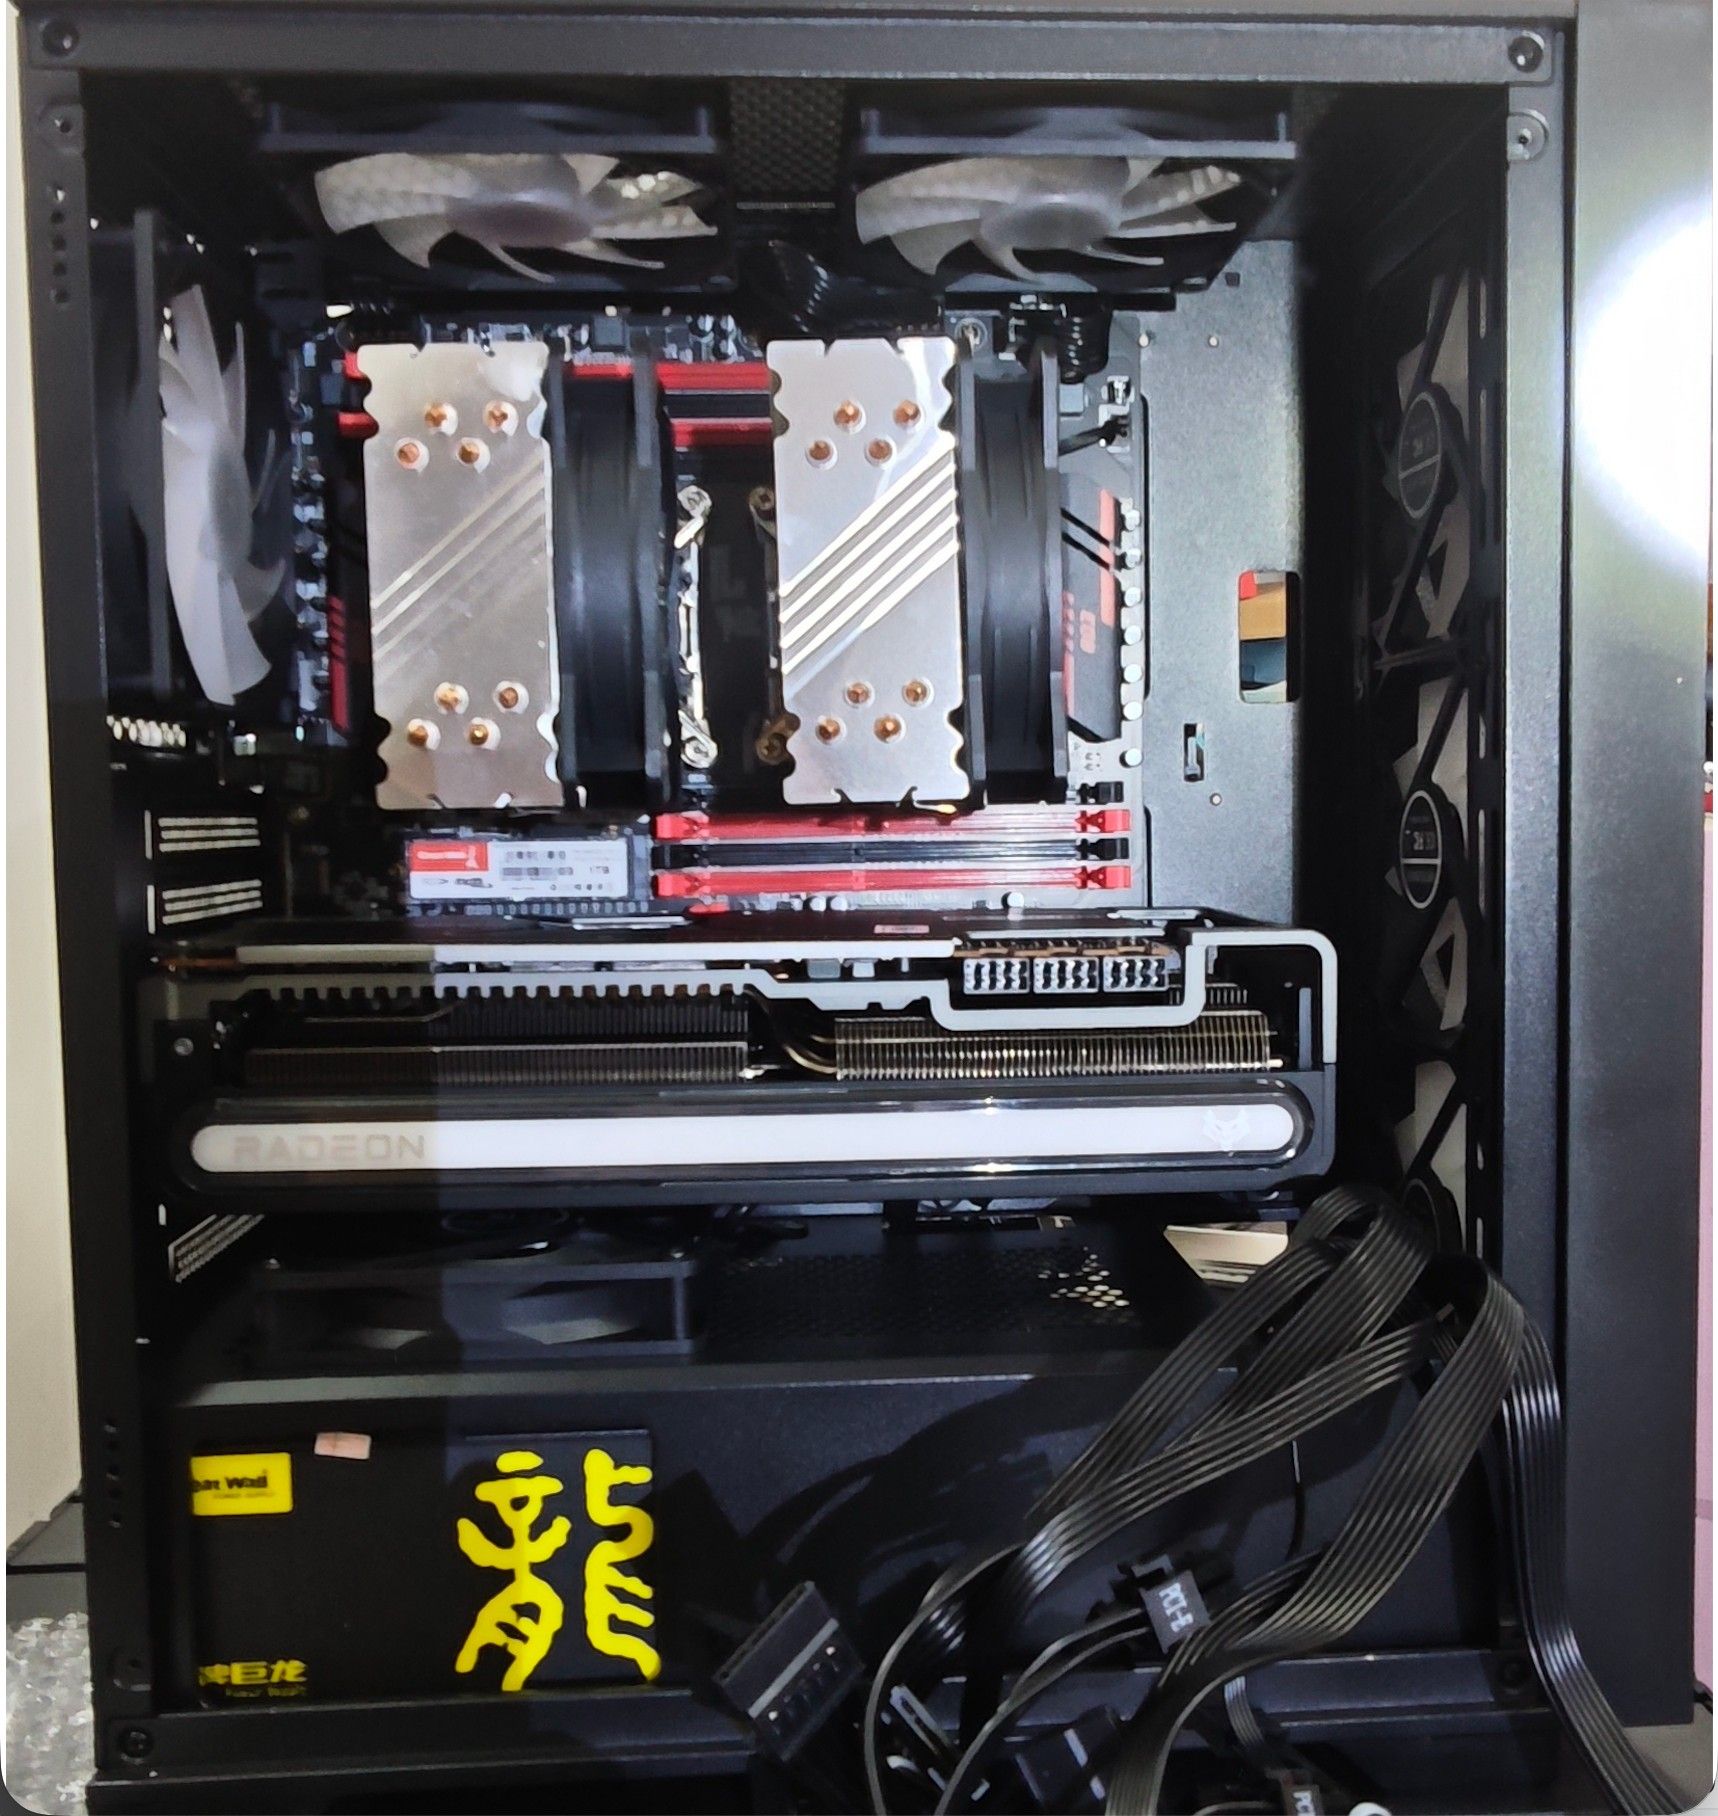
机箱:找客服配置的“华南金牌Z30机箱台式电脑侧透DIY游戏机箱360水冷支持双路X99/X79主板ATX/E-ATX Z30机箱”,我前提有跟客服说2张xtx,但事实证明遇到不专业的客服了,这个机箱放一张显卡就把第2个显卡卡槽挡住了
电源:找客服配置的 长城GW-EPS1250DA(90+),目前是3条显卡一拖二供电线
硬盘:找客服配置的 长城pcie3.0 nvme m.2 1TB
内存:闲鱼买的三星32G DDR3 1866MHz(PC3-14900L) 4Rx4 ECC REG,带散热马甲 4条目前内存条还没到,昨晚安装显卡的时候发现2张显卡没可能放进机箱,1张显卡已经挡住第2张显卡卡槽,紧急下单了pcieX16 3.0延长线2条,已经做好了最坏2个显卡都放机箱外面的准备。但外置显卡如何放?就打个显卡支架放外面就行吗?大家有什么推荐么?
另外又看到有些评论提及似乎这个主板不支持双卡TP,这个是真的么?
2026-09-12_09-46-47.png
-
@terry 感谢推荐!开放机箱因为家里有养猫猫毛乱飞所以用不起来。
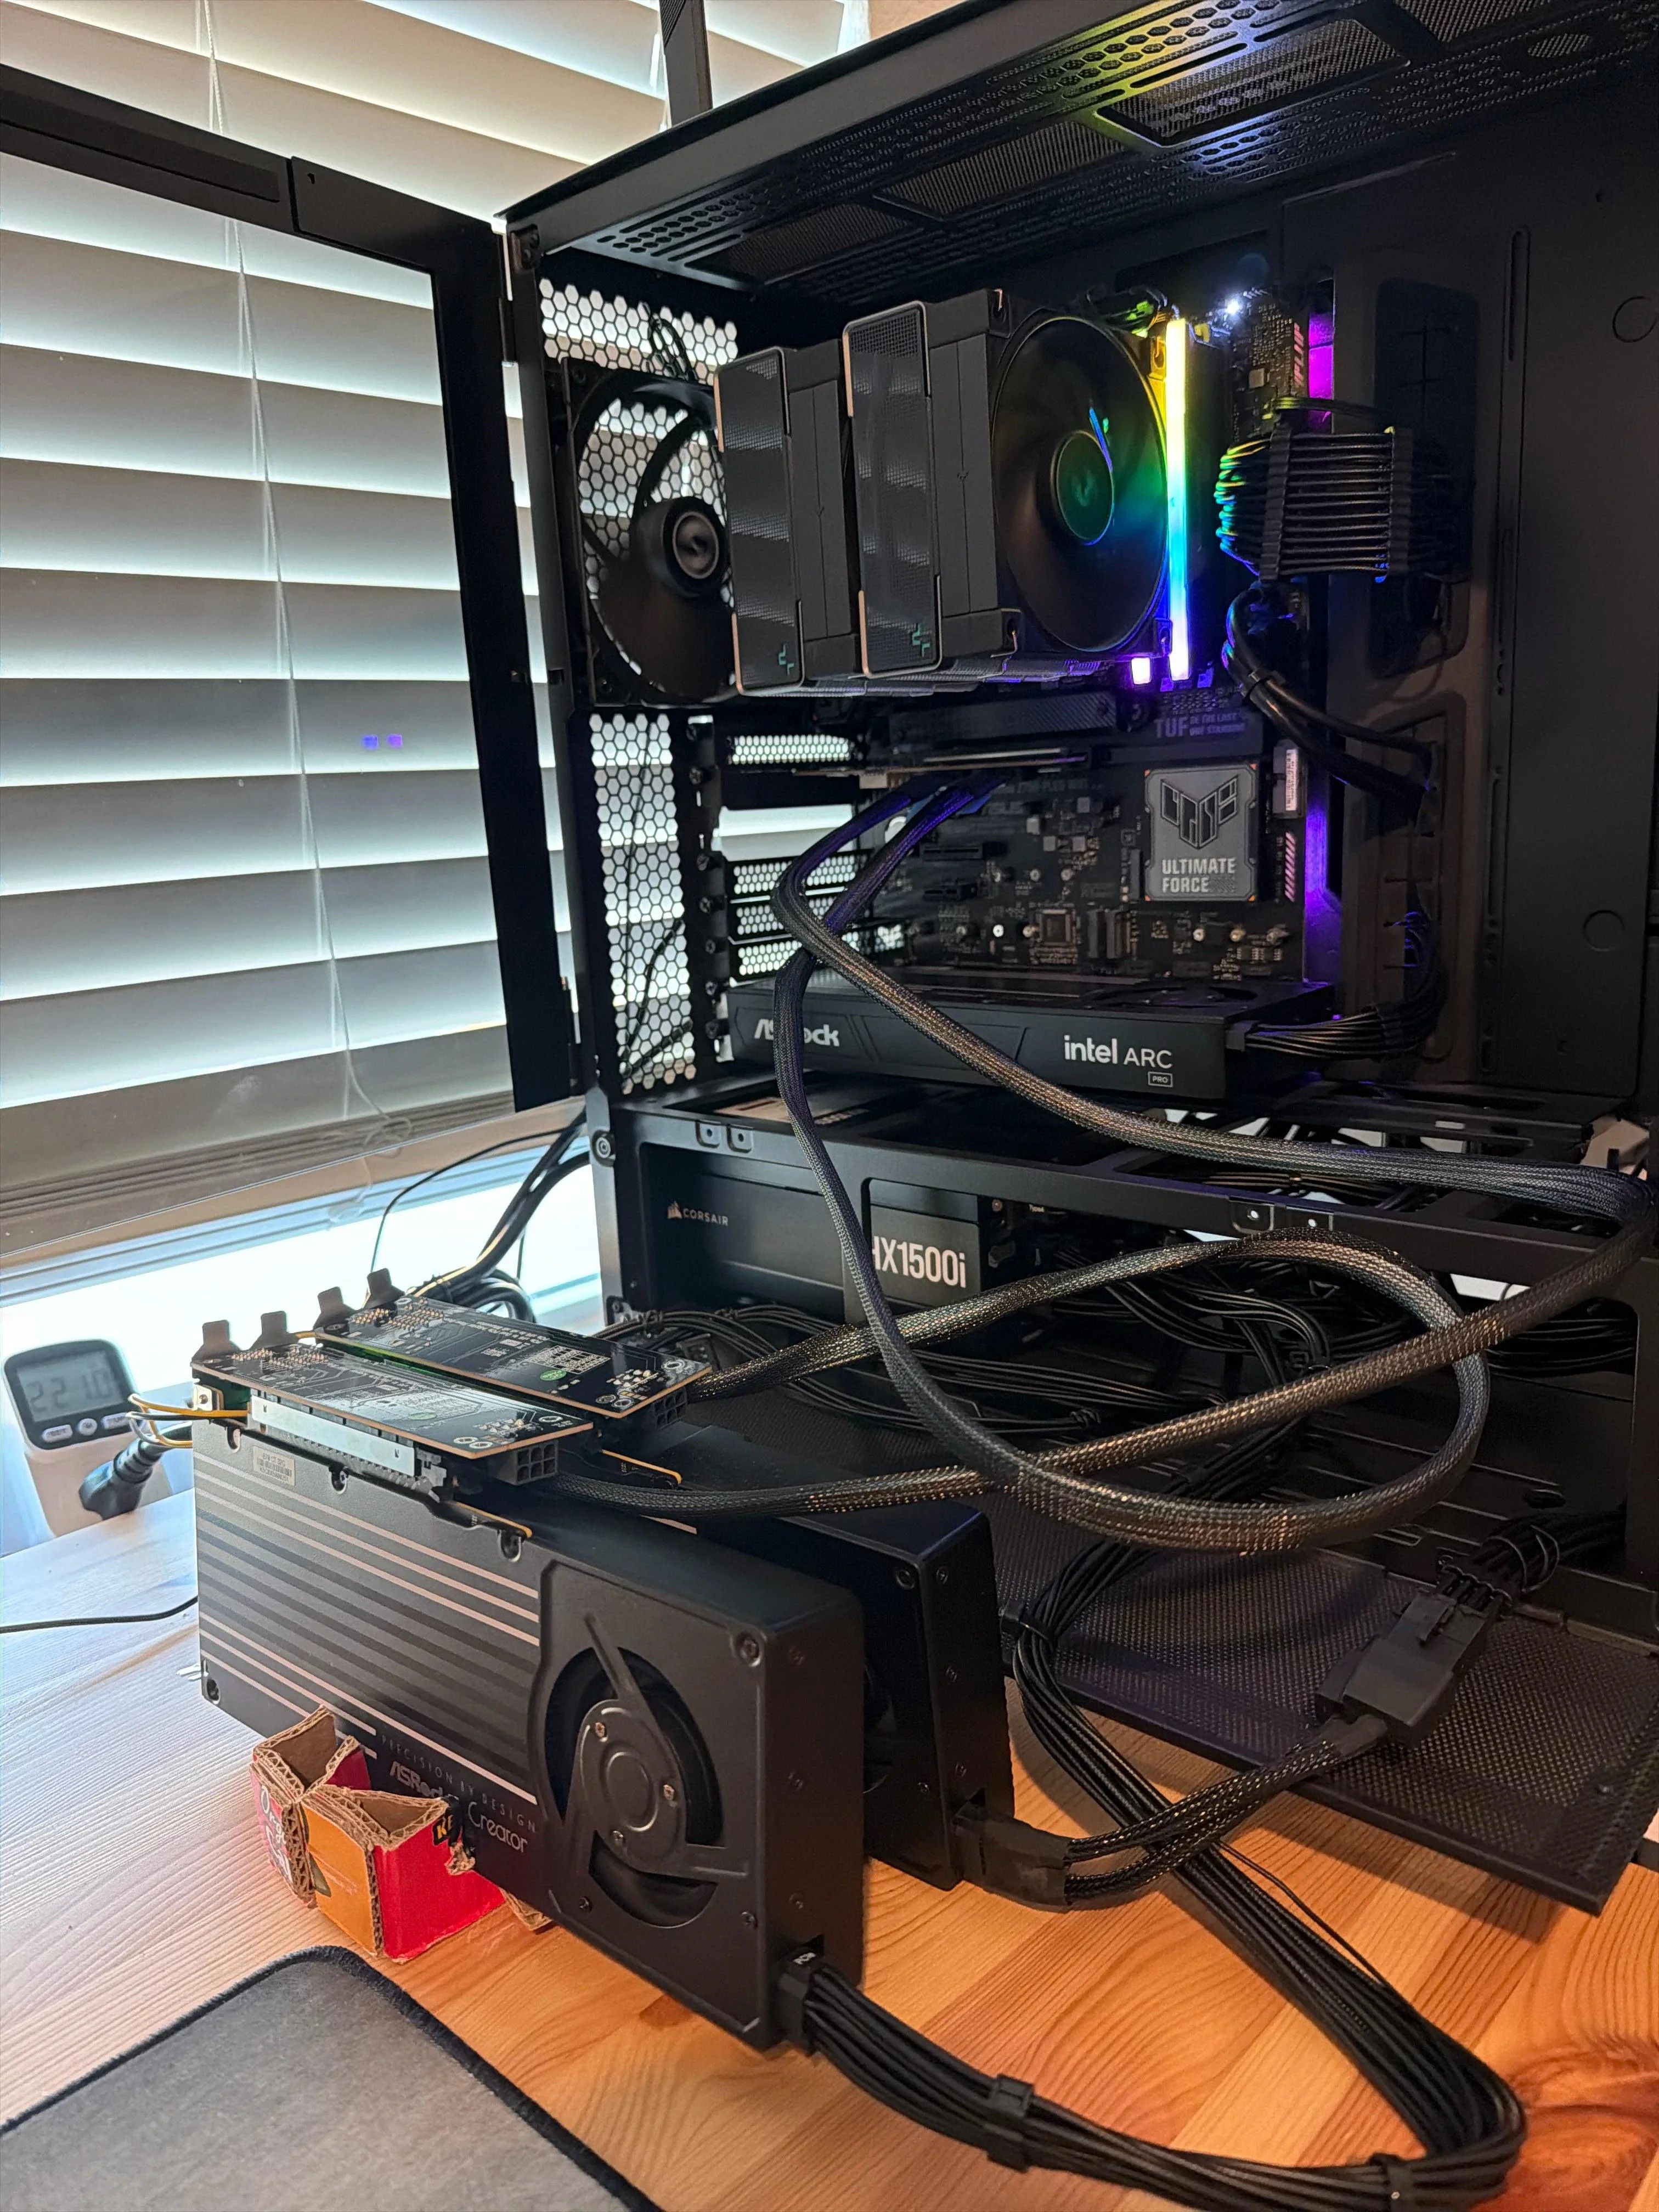
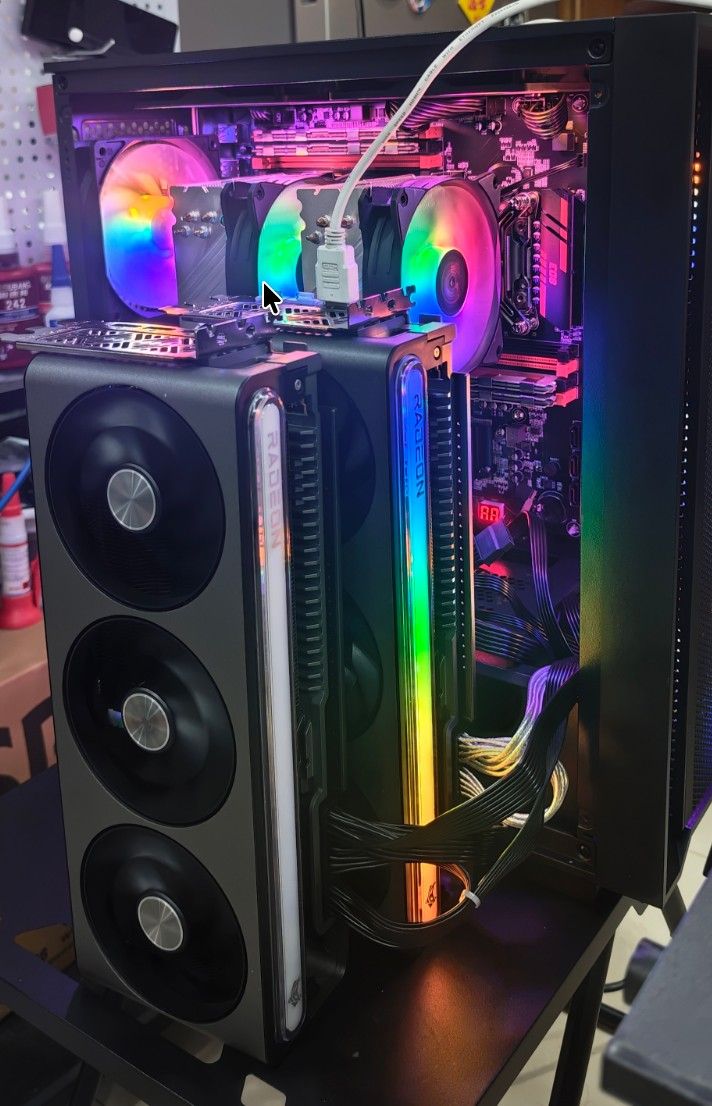
下午在尝试先把2张显卡放机箱外面,然后尝试用蹩脚的小白建模能力建一个显卡架子,不过因为电源线长度原因,原本箱横着放的,结果得并列竖着放,下午白建模了,后面得重新建模,最后再封箱。
目前已经安装了ubuntu24,bios改了几个配置后双卡也能启动了。之前一度以为是电源功率不足启动的问题,幸好还行。开始尝试部署大模型ing
-
楼上这个折纸工艺有点意思
-
對, 一條線有 x8 , 一張GPU接一條線就 PCIe 4/5 x 8 , 一張GPU 接兩條就 PCIe 4/5 x 16
我遇到一樣的問題 可能要走 eGPU方案一 :我大概選這個方案 速度可以維持 x 16, 也能彈性調整成 2 GPUs x 8
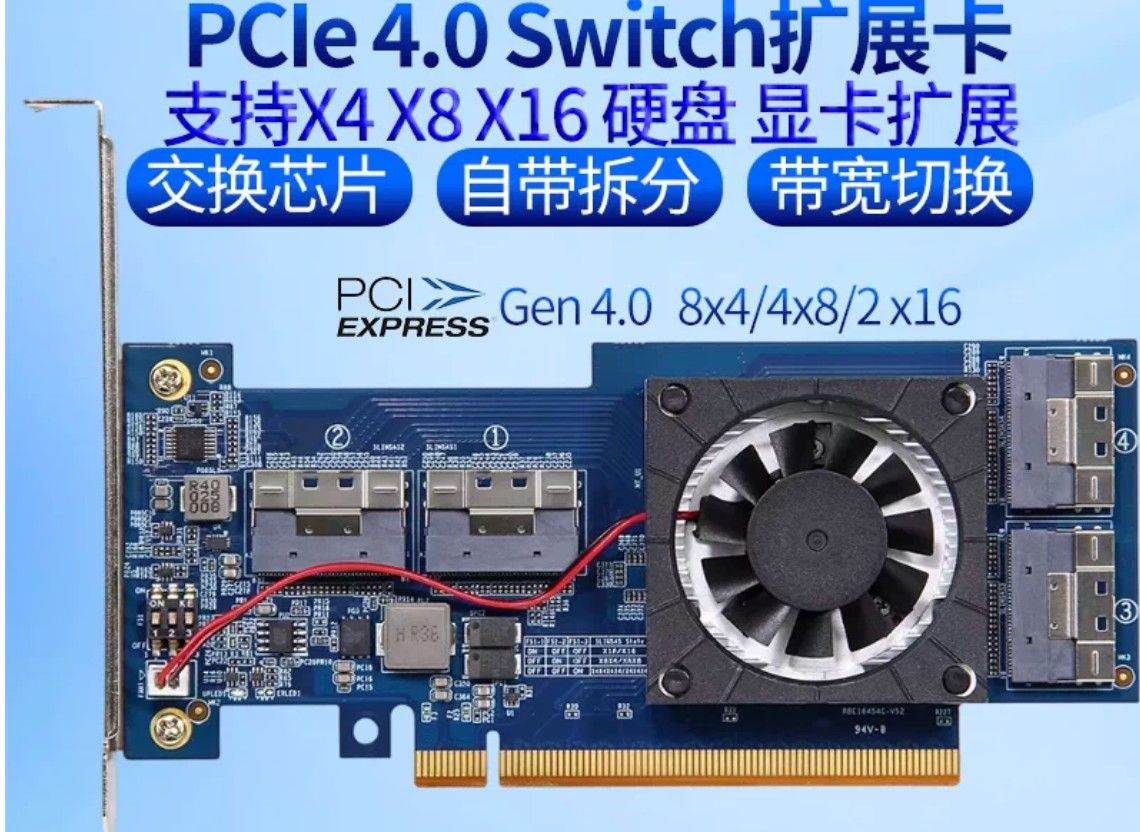
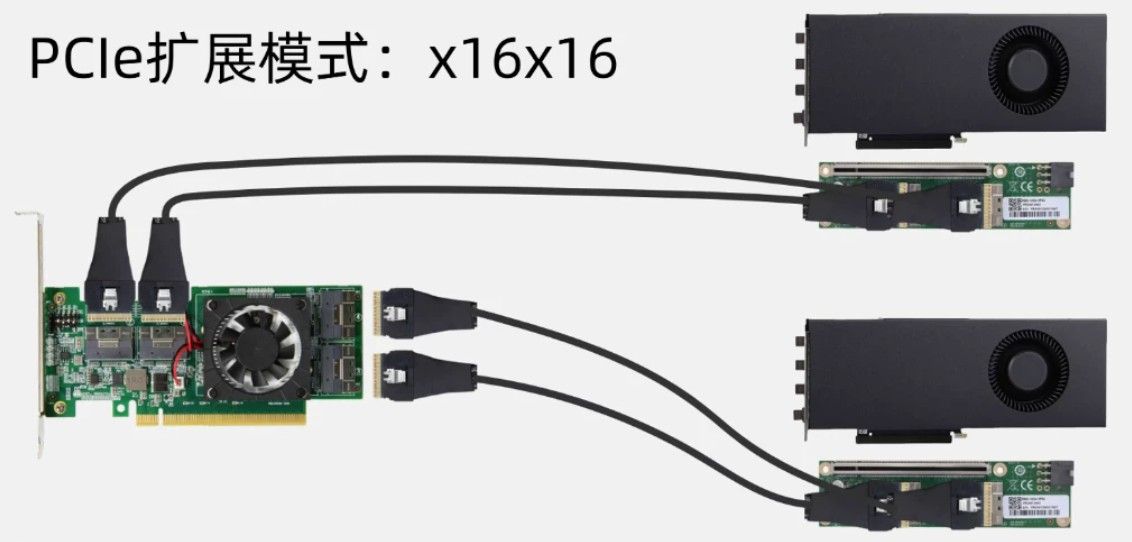
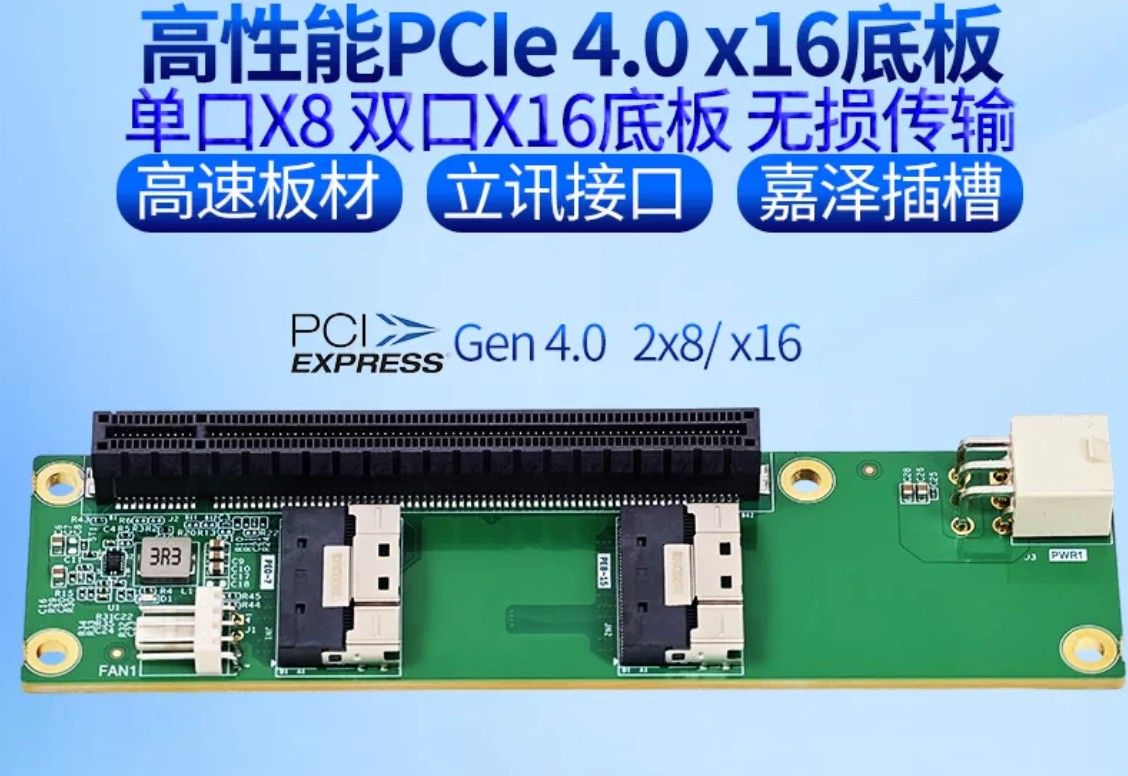
少一個安裝支架 這個底盤大一點 或許可行 , 看能不能找到更大一點裝GPU 更穩 甚至裝兩顆GPUs
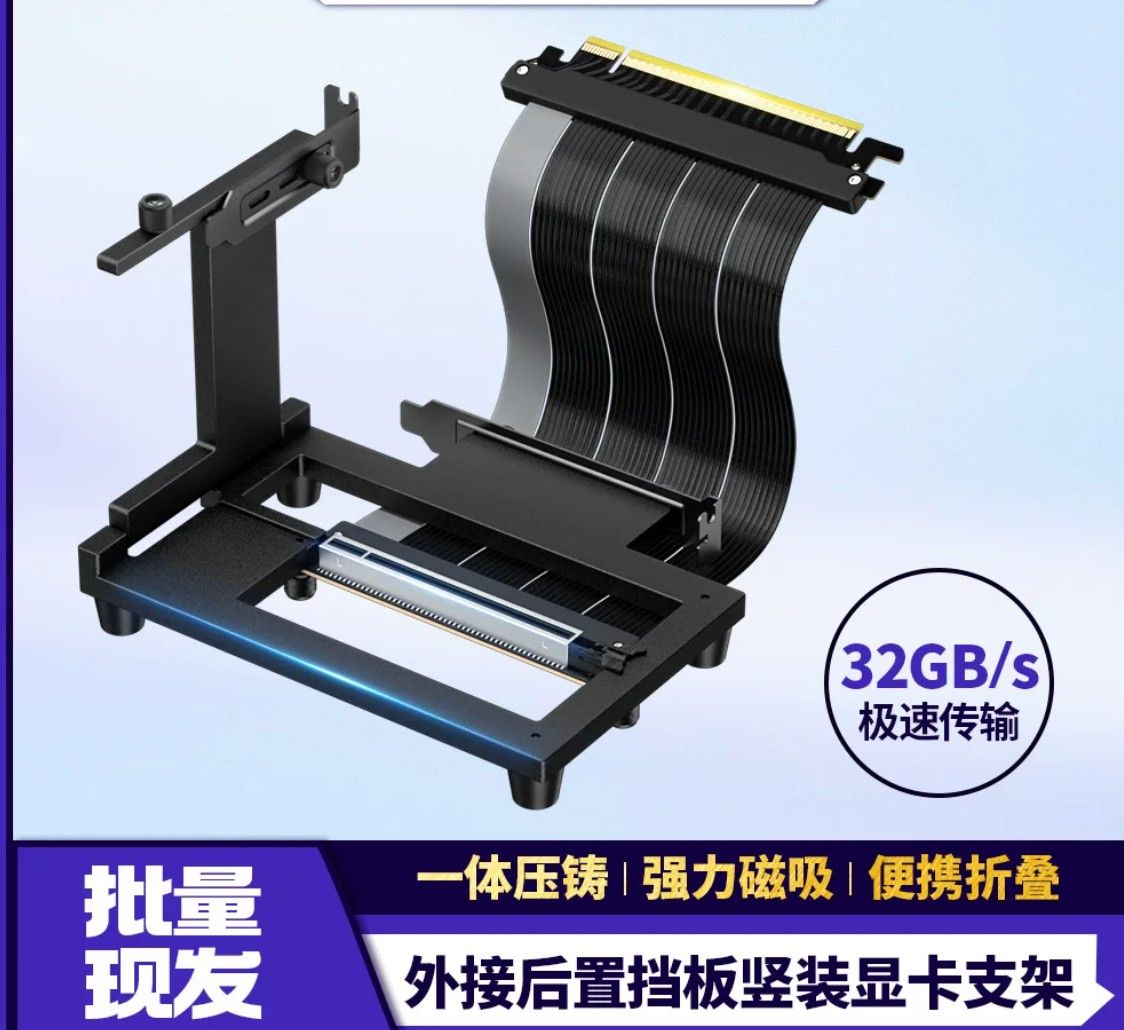
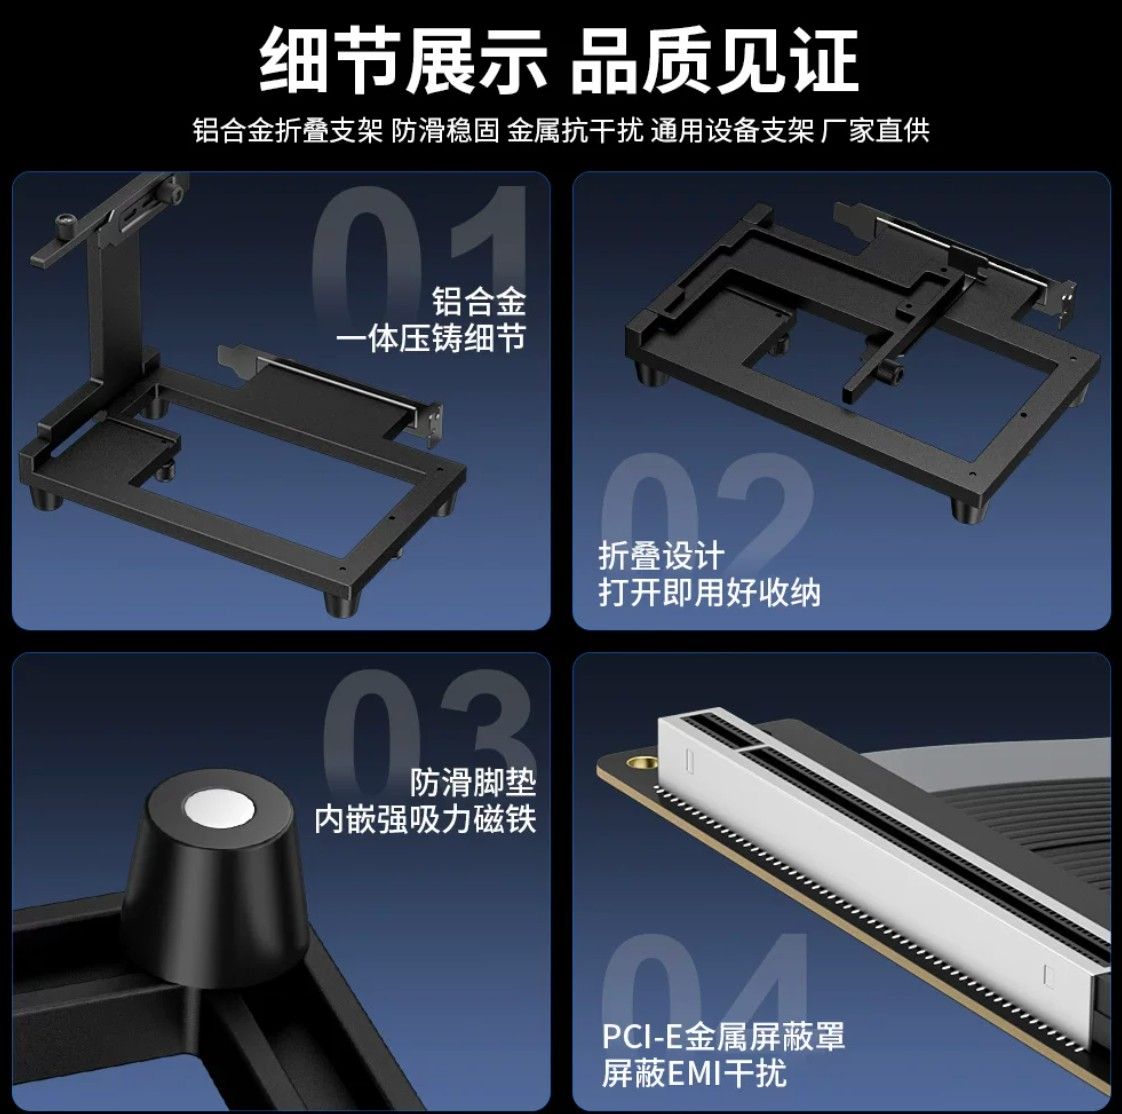
方案二 :
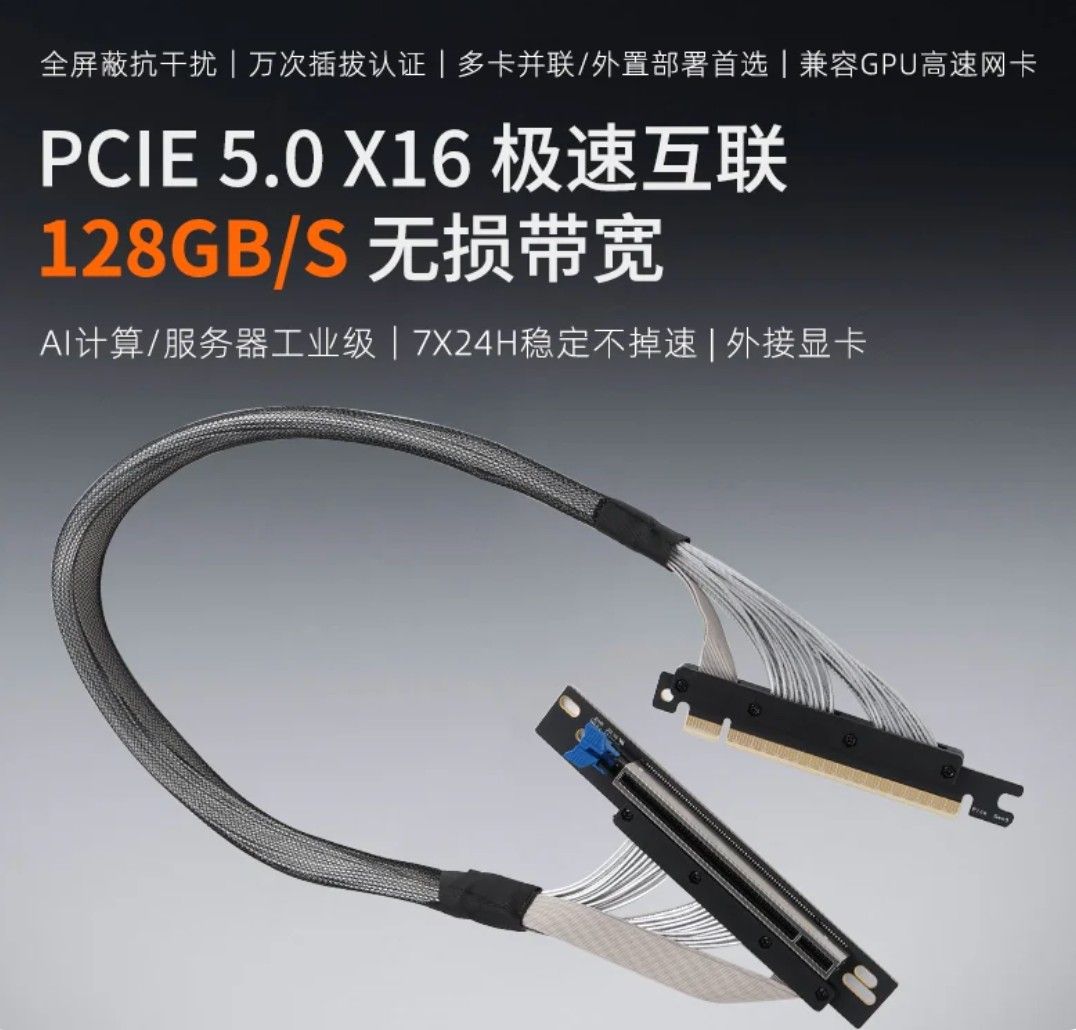
方案三 :
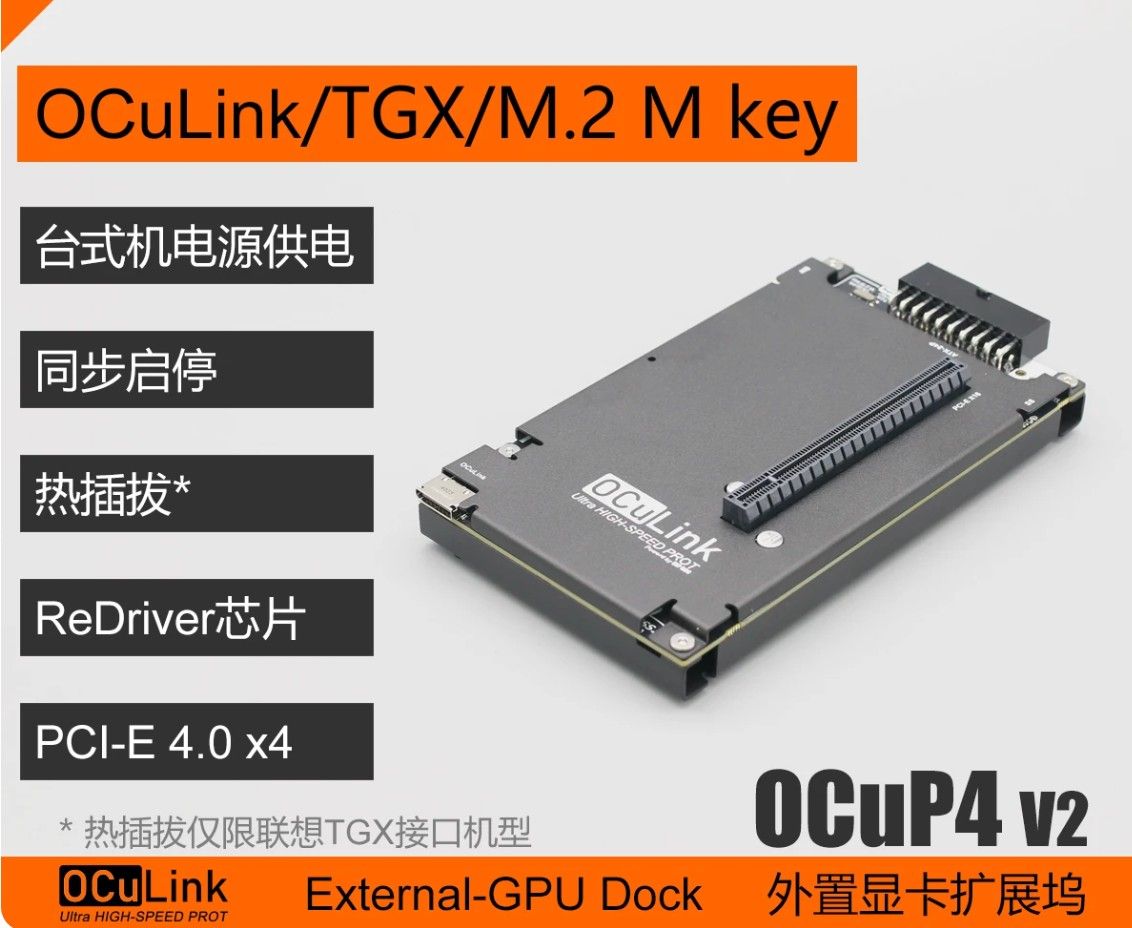
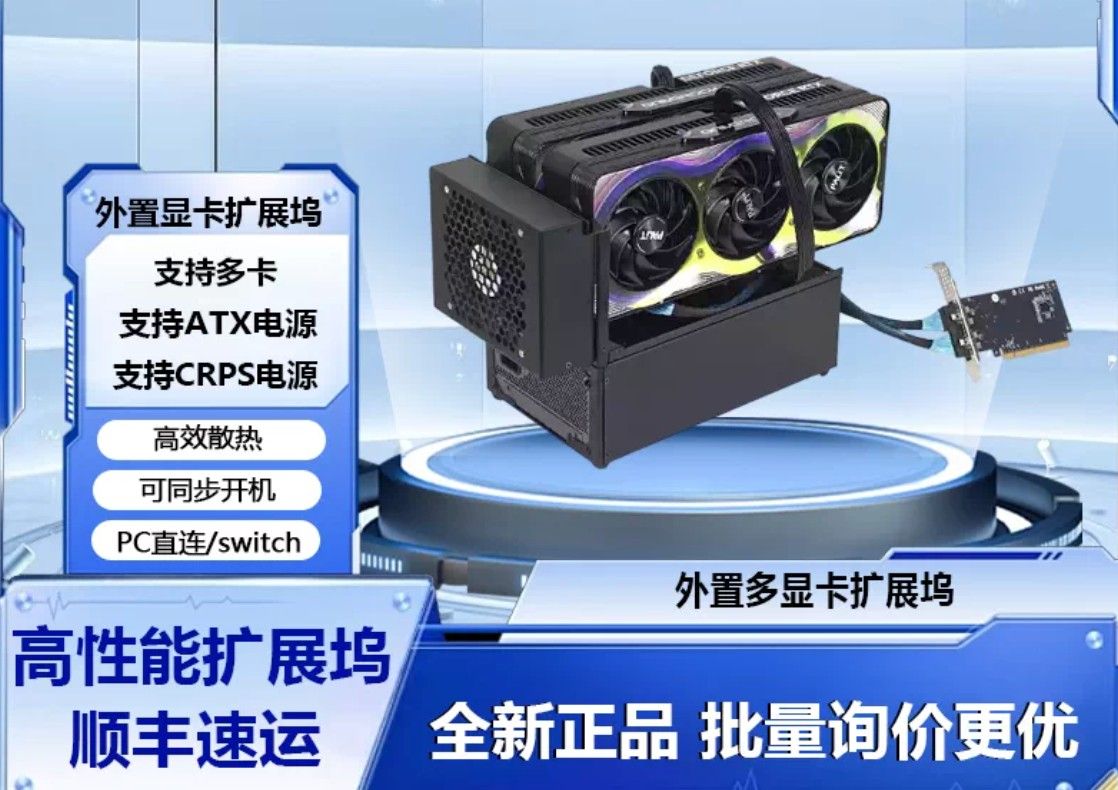
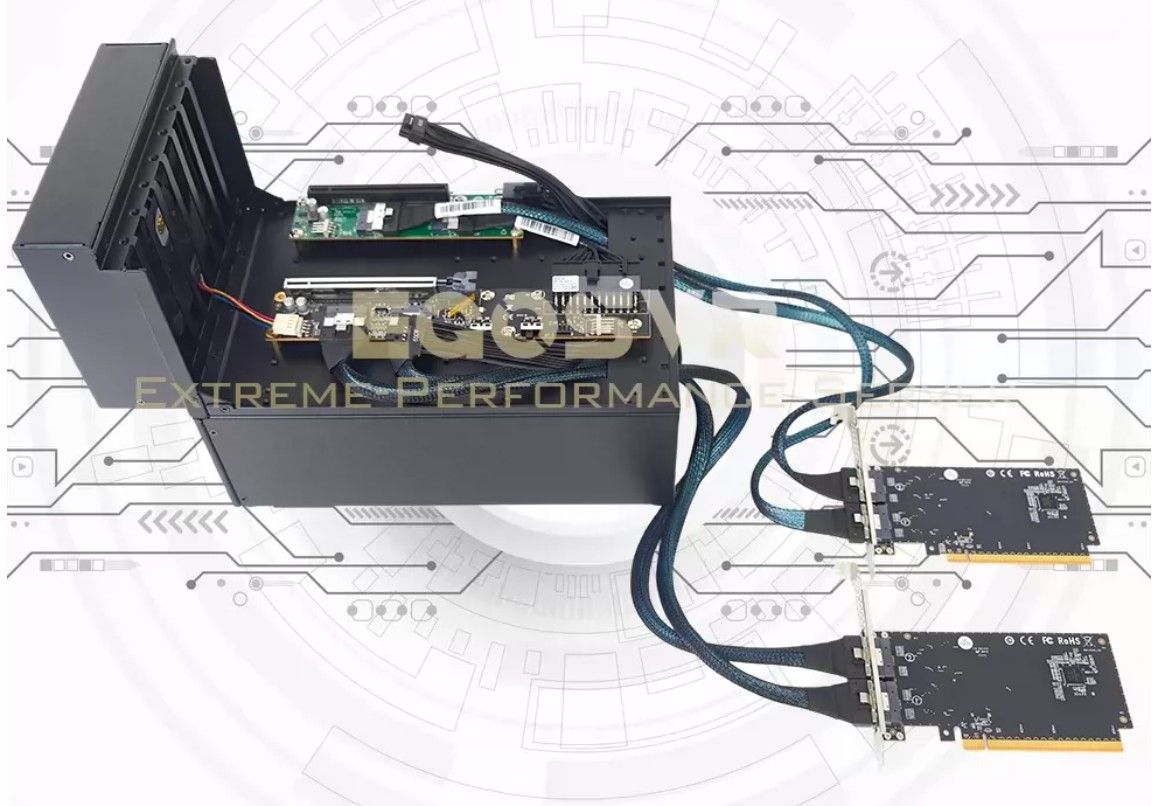
补一句区分两种东西,新手容易混:
- 拆分卡(bifurcation):靠主板/CPU 支持 PCIe bifurcation,把 x16 电气拆成 x8+x8 或 x4×4,卡上只是走线、没有芯片。X99 平台支持很有限,要看具体插槽和 BIOS。
- PCIe 交换卡(PLX/PEX 芯片):卡上自带 switch,不依赖主板拆分,上游一个 x16 可扇出多个 x8/x16,带宽共享。代价是贵、加延迟,很多老 switch 只到 PCIe 3.0。
- 外置走线:OCuLink(x4/x8)、SlimSAS(x8)、MCIO 都是把 PCIe 引出机箱的方案,线材和转接会再吃掉信号余量,长线不一定稳。
给浔雨:显卡竖装加自己弯线比上交换卡便宜,先把双卡跑起来;真要外置,单卡推理 x8 够用,只有跑 TP/多卡 P2P 时才需要在意根桥白名单和交换拓扑。
-
终于基于之前的硬件配置成功跑起来了,和之前win11下面单张24g的llama.cpp的速度和并发相比简直是质的飞跃。
感谢@terry @flyer666 还有帖子中的各位朋友的帮助!目前证明x99这张可以跑tp来着,接下来就是把我的显卡打个架子放放好~
# 启动服务
python -m sglang.launch_server \
  --model-path $MODEL_PATH \
  --host 0.0.0.0 \
  --port 8080 \
  --served-model-name qwen3.8-27b \
  --tp-size 2 \
  --quantization gptq \
  --dtype bfloat16 \
  --mamba-ssm-dtype bfloat16 \
  --kv-cache-dtype bfloat16 \
  --attention-backend triton \
  --context-length 196608 \
  --mem-fraction-static 0.90 \
  --max-running-requests 4 \
  --max-mamba-cache-size 20 \
  --cuda-graph-bs-decode 1 2 4 \
  --triton-attention-num-kv-splits 16 \
  --chunked-prefill-size 2048 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --default-chat-template-kwargs "$THINKING_CONFIG" \
  --speculative-algorithm dflash \
  --speculative-draft-model-path $DRAFT_MODEL_PATH \
  --speculative-draft-model-quantization compressed-tensors \
  --speculative-num-draft-tokens 8 \
  --speculative-draft-window-size 2048 \
  --sleep-on-idle
当前运行状态
模型: Qwen3.8-27B-W4A16-AutoRound-GPTQ
草稿模型: Qwen3.8-27B-DFlash2-W4A16
张量并行: TP=2
显存使用: GPU0 98%, GPU1 98%
温度: GPU0 63°C, GPU1 54°C
功耗: GPU0 210W, GPU1 213W
思考模式: low (1024 tokens)
推测解码: DFlash2 (8 draft tokens)操作系统 Ubuntu 24.04.5 LTS (Noble Numbat)
硬件配置:
双卡 RX 7900 XTX (24GB x 2)
1250W 电源稳定运行
X99 平台,Above 4G Decoding 必须开启软件栈:
ROCm 7.2.4 + PyTorch 2.13.0
SGLang gfx1100-support 分支
DFlash2 推测解码(提速 ~70%)0 2 0x744c, 45251 66.0°C 203.0W N/A, N/A, 0 32Mhz 96Mhz 14.9% auto 0.0W 99% 0%
1 3 0x744c, 9479 56.0°C 215.0W N/A, N/A, 0 0Mhz 96Mhz 0% auto 0.0W 98% 0%