
7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比
-
@terry @flyer666 @farmer-node @laobenxiong @墙内人
各位大佬,今天继续给大家汇报一下这两天折腾 SGLang 的进展。先说句实话,我现在都不知道自己哪来的勇气。一个纯小白,在这个论坛里混了三个月,现在居然就敢大包大揽接下这么一个技术含量挺高的测试,回头想想,多少有点自不量力。结果这两天果然被现实狠狠地打脸。各种之前根本没想到的问题一个接一个冒出来,搞得我抓耳挠腮、鼻青脸肿,折腾了一天一夜多,整个人都有点焦头烂额了。
首先就是ROCm 7.2 升级到 7.14 带来的编译问题和系统兼容问题,vLLM的识图也一度崩了,最离谱的是,后来发现硬件这边居然也在捣乱。先是 CPU 温度超过警戒值,后来排查下来,怀疑和散热器压紧程度、接触状态有关;接着两张显卡温度也一度冲得很高,又牵扯出上下卡位、风道以及两张卡之间热量互相影响的问题。这些因素叠在一起,导致我最开始跑出来的结果甚至有点违反预期。
老特前不久的视频里很明确地说过,SGLang 相比 vLLM 是更高一档的存在。我第一轮测出来 vLLM 更占优势,更不用说vLLM可以Int8 KV量化,SGlang只能BF16。要不是我一直紧跟特哥的视频,我当时可能还真就信了,所以第一反应不是下结论,交作业,而是立马警惕,是不是我哪里搞错了?
带着这个怀疑,我训着AI(也是跟老特学的)把整套测试重新审了一遍,结果还真发现了降频、温度干扰以及测试方案本身的一些漏洞。后来又花了很多时间,把温度、驱动、配置、测试方法这些干扰项一个一个排掉。折腾到刚才,总算拿到了一组我自己看完以后比较放心能拿得出手的结果。毕竟发出来的东西还是要负责的,不能随便浪费大家时间。
下面直接上数据。
一、先汇报 PR #34058 / N=1 的实际结果
先把上次大家比较关心的这件事交代一下。
我这次实际按 PR #34058 对应的 N=1 路线继续用了下来。
结论很直接:
目前已经达到我认为可以投入实际生产使用的状态。双 7900 XTX 的 SGLang 路线正式打通,flyer666大神牛B!!!
而且不是“能启动、能跑请求”这种意义上的可用。在我后面重新做完的正式测试里,SGLang 已经不只是恢复正常,很多和我真实 Agent 工作负载相关的项目,实际表现已经超过了之前我用的很顺手的vLLM。(这个也是跟着flyer666大神的帖子 ”双卡7900xtx VLLM qwen3.8 爽玩agent pp1600 tg 160+ (附 mtp/7900xtx全攻略)” 学到的。 Respect!https://lcz.me/topic/1363 )
尤其是:
- 长期 Agent 追加轮
- 多个 64K 请求并发
- 文本→图片→再返回文本
- 64K decode
所以在我现在这套双 7900 XTX / ROCm 7.14 / Qwen3.8-27B 环境里,我已经把SGLang正式部署为我的生产环境。
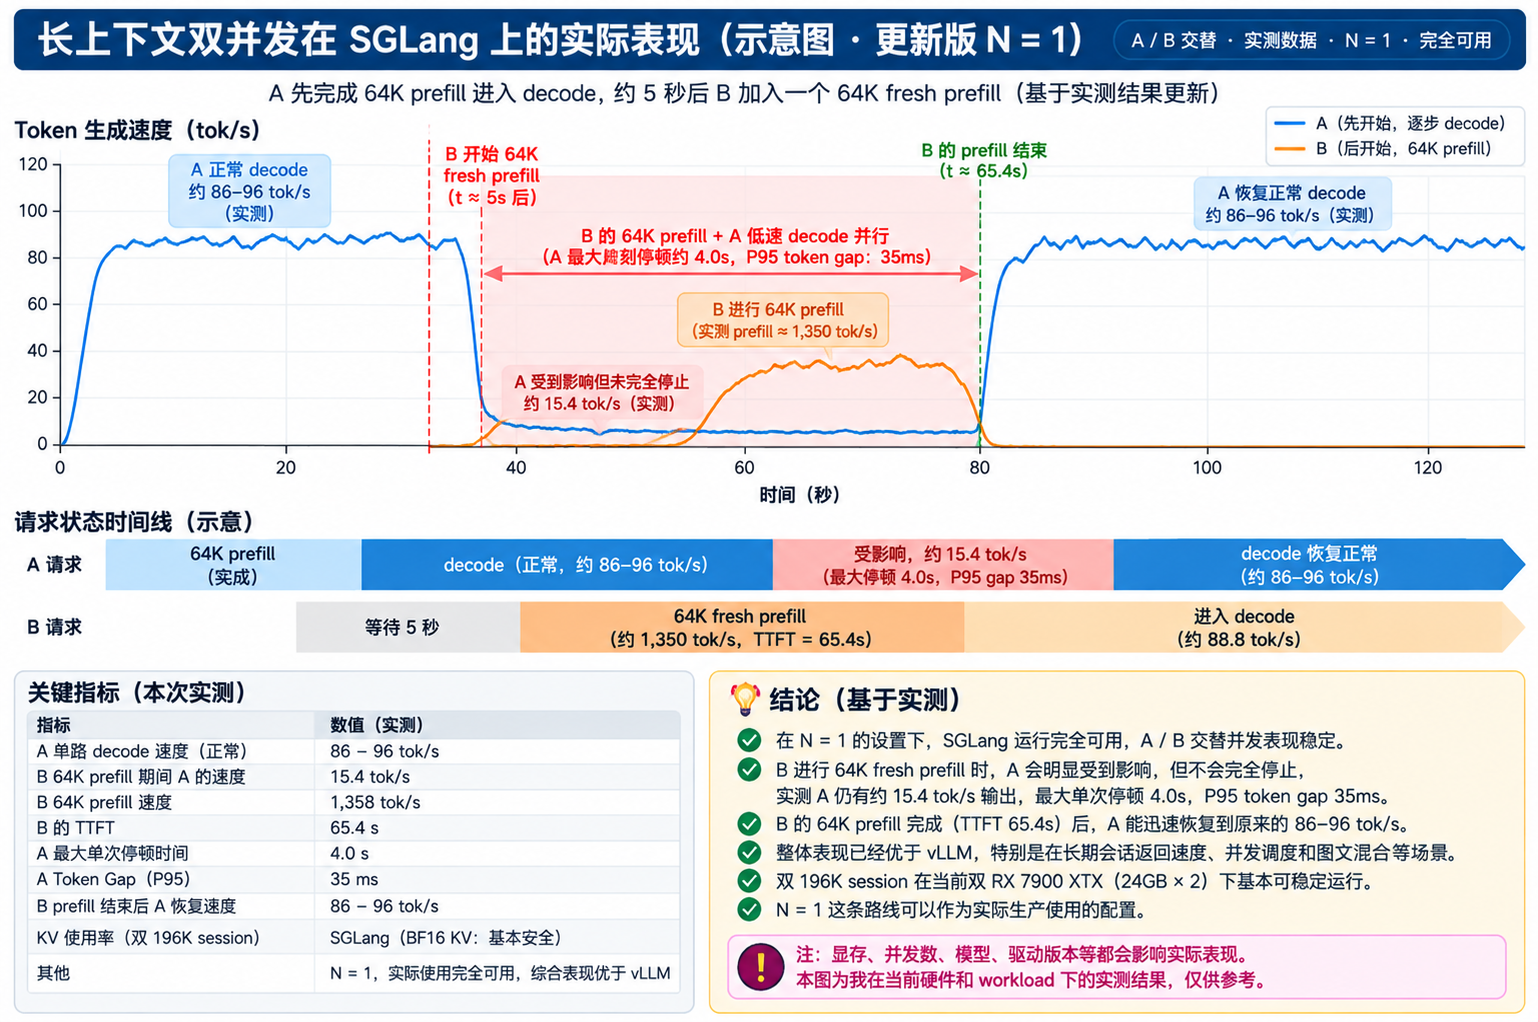
注: N=1 后,64K fresh prefill 不再把正在 decode 的 Agent 完全饿死,但重 prefill 仍会造成显著性能下降。这其实也很合理。B 的 64K fresh prefill 本身就是一个非常重的 GPU 任务,它进来以后会大量占用算力和带宽。双卡总资源固定,A 的 decode 被挤压是正常的;N=1 做到的是不让 A 完全没饭吃。
下面汇报测试细节,欢迎批评指正
二、测试平台
硬件环境
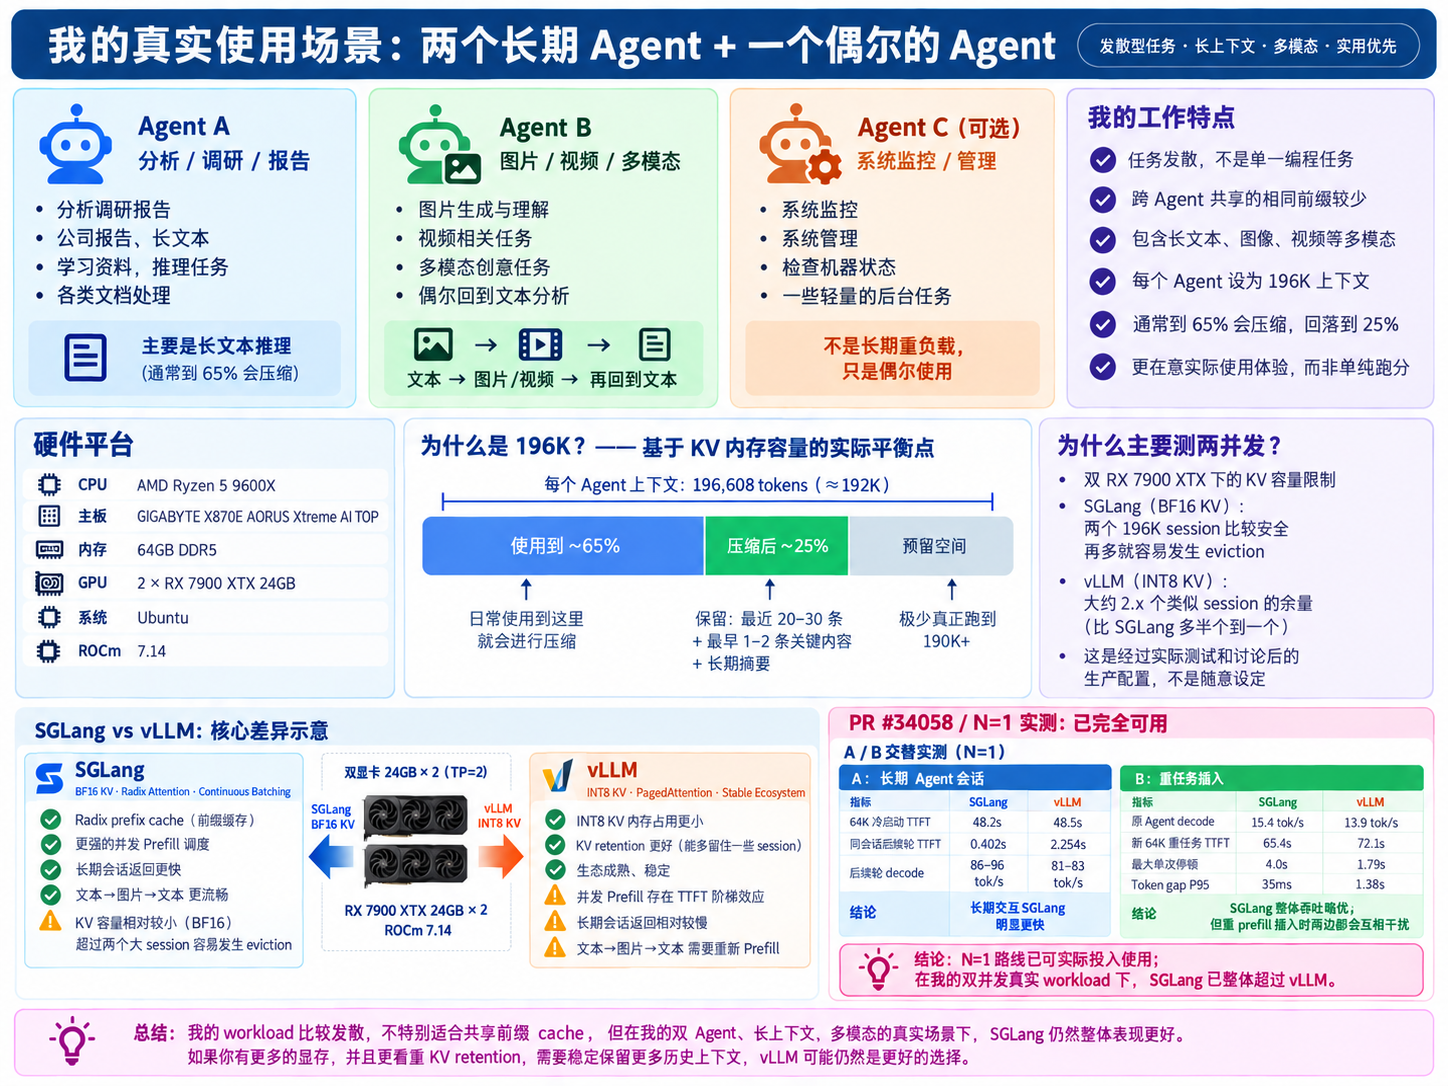
项目 配置 CPU AMD Ryzen 5 9600X 主板 GIGABYTE X870E AORUS Xtreme AI TOP 内存 64GB DDR5 GPU 1 ASRock Radeon RX 7900 XTX 24GB GPU 2 Sapphire PULSE Radeon RX 7900 XTX 24GB 并行方式 双卡 TP=2 系统 Ubuntu ROCm 7.14 模型 Qwen3.8-27B-W4A16-AutoRound-GPTQ 最大上下文 196,608 tokens(约 192K) 两套生产配置
项目 SGLang vLLM Tensor Parallel TP=2 TP=2 模型 同一 W4A16 AutoRound checkpoint 同一 W4A16 AutoRound checkpoint KV dtype BF16 / auto INT8 int8_per_token_head最大上下文 196,608 196,608 Attention Triton TRITON_ATTN Speculative EAGLE MTP=3 最大并发设置 4 running requests max-num-seqs=128 GPU Memory 生产配置 0.95 ROCm 7.14 / gfx1100 适配 7.14 / gfx110x 独立 MM 环境 这里先声明一下:这不是完全归一化的学术 benchmark。 我测的不是“把所有参数强行改成完全一样以后,哪一个 scheduler 理论上更强”。
打通这条 SGLang 路线以后,我真正想测的其实很简单:同样的硬件、同样的模型、同样的 196K 上下文目标,SGLang 和 vLLM 到底哪个更适合我真实的 Agent 使用场景。
三、我的真实使用场景
这个部分其实比单纯的 benchmark 数字更重要。我的机器不是拿来给多个人同时跑 API 的。大多数时间,我就是自己用两个长期 Agent。
Agent A:分析 / 推理
主要做:
- 分析
- 调研
- 公司报告
- 长文本
- 学习资料
- 各类推理任务
Agent B:创意 / 多模态
主要做:
- 图片
- 视频
- 多模态
- 创意任务
- 偶尔回到文本分析
偶尔的 Agent C
第三个 Agent 在我的NAS上,主要负责:
- 系统监控
- 系统管理
- 检查所有机器状态
- 远程唤醒
- 家庭智能助手
- 一些比较轻量的后台任务(邮件,提醒,定期搜寻资料等)
但三路长期重负载不是我的常态。
为什么我最终把 Context 定在 196K?
每一个 Agent 我都配置到:196,608 tokens,约 192K。
这个数字不是随便拍脑袋定的。主要是结合双 7900 XTX 的实际 KV 容量,反复讨论以后选出来的生产平衡点。
在我现在的配置下:
SGLang
因为还是 BF16 KV,所以 KV 空间比较紧。196K 65%压缩阈值这个设定下:
两个长期 Agent 基本是比较安全的。
再加入第三个大 Context session,就开始很容易发生 eviction。
vLLM
vLLM 使用 INT8 KV,KV 容量明显大一些。从这次实际测试表现看,大致可以理解成:
比 SGLang 多出半个到一个 session 的余量。
也就是大约 2.x 个类似长期上下文的空间,而不是无限增加。
所以最终对我来说,196K + 双 Agent 本身就是一个经过取舍以后比较合理的生产点。(注意,Qwen3.8 27B的雷霆大思考是病,得治,网上有药)
后端 KV dtype 可用 KV 池 SGLang BF16 / auto 约 263K tokens vLLM INT8 int8_per_token_head约 295K tokens
而且我的 Agent 不会真的一路堆到 196K
我的Hermes Agent压缩机制大约到 65% context 左右就会压缩。压缩以后回落到大约 25%,同时保留:
- 最近约 20–30 条重要消息
- 最早 1–2 条关键内容
- 压缩后的长期摘要
所以现实里我根本不会经常跑到 190K+。这也是为什么这次 196K 极限测试因为测试载荷多了几个 token 而作废以后,我没有再专门补测。对我的生产场景意义不大。
我的 workload 和 Coding Agent 其实不太一样
还有一点必须特别说明。我的工作比较发散,两个Agent大多数时间都算是“脉冲式”推理,基本没有双路满载的情况。具体来说 -
一个 Agent 可能正在做:
公司分析、报告、调研、长文本推理
另一个 Agent 可能已经跑去:
做图、做视频、看图片、多模态
所以这并不像很多 Coding Agent:
- system prompt 类似
- tool schema 类似
- repository 内容高度重复
- 大量代码 prefix 可以反复共享
我的两个主 Agent 之间,真正完全相同的大段业务 prefix 并没有那么多。所以从这个角度讲:
我的 workload 其实并不是特别“照顾”SGLang prefix cache 的 workload。远远没有发挥SGLang高效缓存命中的实力
同一个 Agent 自己继续聊天,cache reuse 当然非常明显。但跨 Agent 的共享命中率不会像 Coding / 大规模同质 Agent 那么高。我平时使用两个 Agent 的任务内容差异较大,因此跨 Agent 可复用的大段 prefix 不多,新任务更容易表现为 fresh prefill,而不是高比例 prefix hit,如果你的 workload 是:
- Coding Agent
- 多个 Agent 共用同一套 tools
- 大量相同 system prompt
- 大量重复 repository/context
- 显存又比我的双 24GB 更充裕
那么我认为 SGLang 的 prefix cache 优势反而可能比我这里体现得更充分。
四、核心结果
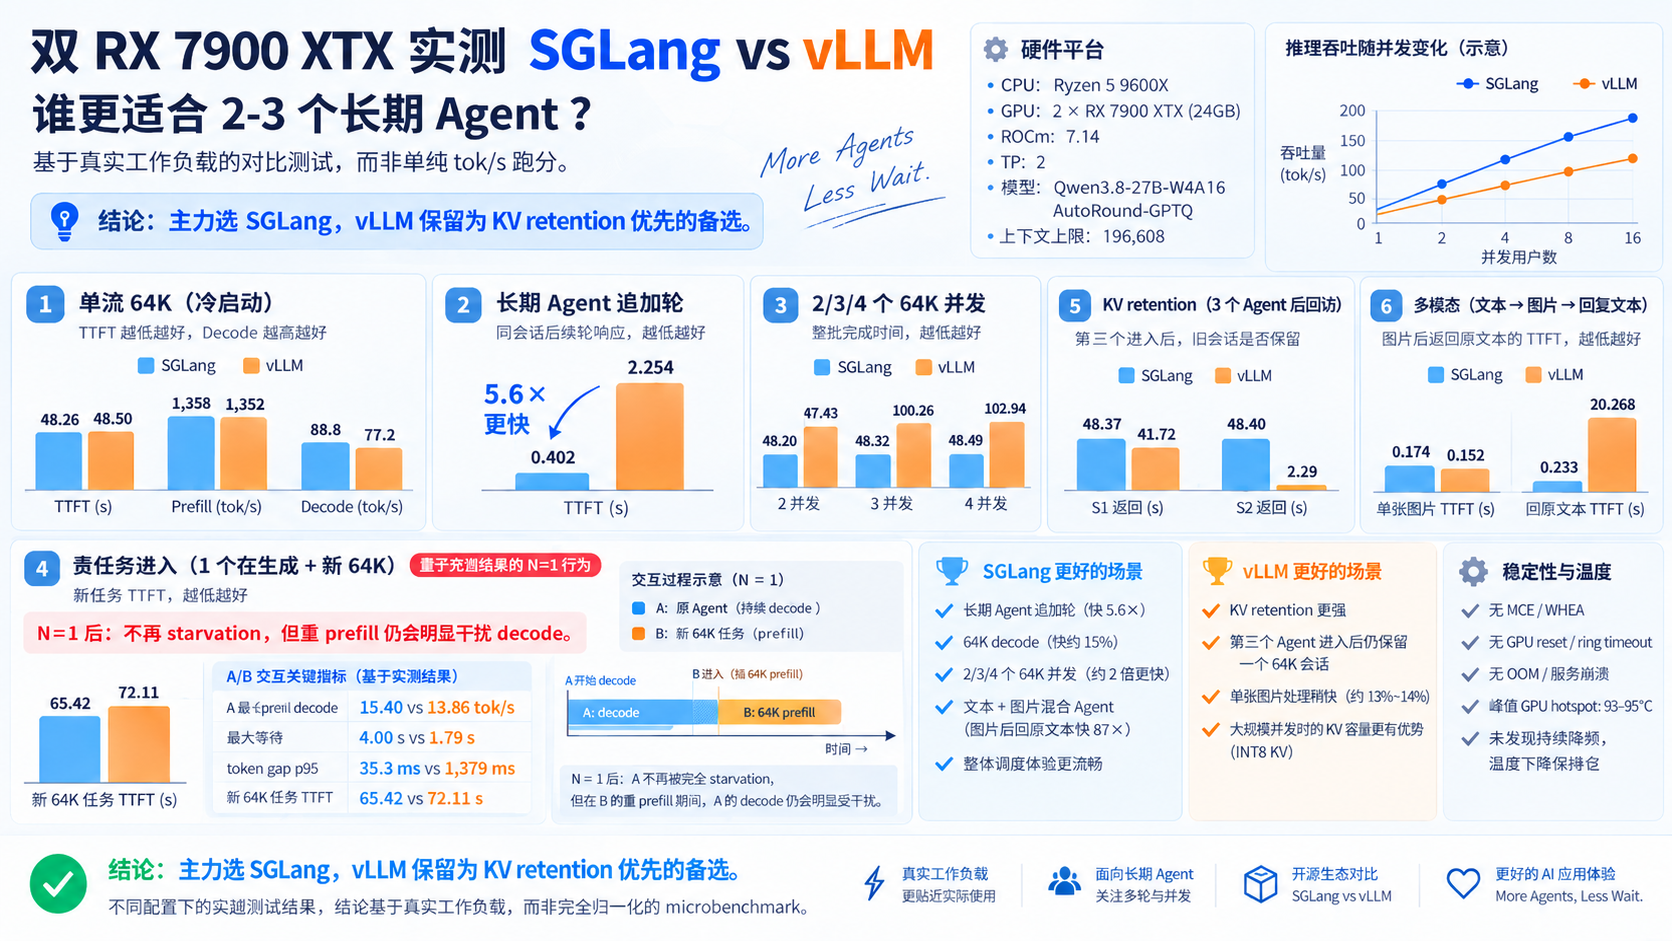
1. 单流:两边差距其实不大
32K Cold Prefill
指标 SGLang vLLM TTFT 20.00s 20.30s Prefill 1,640 tok/s 1,615 tok/s Decode 99.0 tok/s 94.5 tok/s 32K 基本可以认为打平。
64K Cold Prefill
指标 SGLang vLLM TTFT 48.26s 48.50s Prefill 1,358 tok/s 1,352 tok/s Decode 88.8 tok/s 77.2 tok/s Prefill 还是几乎一样。但 64K Decode:> SGLang 领先大约 15%。
2. 长期 Agent:这里开始真正拉开
两个 64K 长期 Session 建好以后,继续原来的会话:
指标 SGLang vLLM 64K 冷启动 ~48.2s ~48.5s 后续轮 TTFT 0.402s 2.254s 后续轮 Decode 86–96 tok/s 81–83 tok/s 这是我最看重的项目之一。
0.402 秒 vs 2.254 秒。
SGLang 后续轮响应大约快:
5.6 倍。
这已经不是 benchmark 表格上好看一点的问题。
长期 Agent 每天真正用的时候,0.4 秒和 2.2 秒的体感完全不一样。
3. 一个 Agent 正在 Decode,另一个突然进来一个 64K 重任务
指标 SGLang vLLM 原 Agent Decode 15.4 tok/s 13.9 tok/s 新 64K TTFT 65.4s 72.1s 最大单次停顿 4.0s 1.79s Token Gap P95 35ms 1.38s vLLM 最大那一下停顿更短。
但 SGLang:
- 原 Agent 吞吐更高
- 新任务完成更快
- 大多数 token 输出更连续
所以综合下来,我还是判 SGLang 略胜。
不过这个测试也证明了一件很现实的事情: 显存能解决“装不装得下”,解决不了无限算力。
三路、四路都同时真正 Decode 的时候,两张 7900 XTX 的总算力就在那里,不可能每一路都保持单流速度。我自己用短上下文的三个Agent实测时,已经感觉到明显卡顿了,算力瓶颈开始显现。
4. KV Retention:这一项 vLLM 明确赢
加入第三个 Agent 后:
SGLang
两个原来的 64K Session 回来:
- ~48.4s
- ~48.4s
基本都需要重新 Prefill。
vLLM
一个大部分被驱逐。
另一个还能:
~2.29s
所以这一项:
vLLM 明显胜出。
但这里要再次提醒:
- vLLM = INT8 KV
- SGLang = BF16 KV
这很大程度上就是 KV 容量的直接差异。
如果以后 SGLang 的 8-bit KV 在 gfx1100 / ROCm 上稳定打通,这一项我认为非常值得重新测。顺带说一句,这两天折腾的时候倒是误打误撞把 FP8 KV 给跑通了,只不过现在速度慢得比较明显,肯定还有坑,暂时谈不上实用,flyer666大神也尝试过了也还没搞定,但是AMD社区发展很快,后面我继续盯着看有没有大神们的分享。
5. 2 / 3 / 4 个 64K 同时进入
这是我这轮最惊讶的结果之一。
并发 SGLang 整批完成 vLLM 整批完成 2 48.2s 97.4s 3 48.3s 100.3s 4 48.5s 102.9s SGLang 基本是:
大家一起进来,差不多一起出去。
vLLM 则出现明显 TTFT 阶梯:
- 2 并发:48 → 97s
- 3 并发:48 → 97 → 100s
- 4 并发:48 → 97 → 100 → 103s
至少在我这套双 RX 7900 XTX TP2 环境下:
SGLang 并发 Prefill 调度明显占优。
注:这一组输出只有 2 tokens,因此主要衡量 64K 并发 prefill、TTFT 和整批 wall-clock,不代表 2/3/4 路持续 decode 吞吐。
6. 多模态
单独看一张图片:
指标 SGLang vLLM TTFT 0.174s 0.152s 总耗时 0.363s 0.311s 纯视觉:vLLM 略快。 但是我真正的 Agent 工作方式通常是:
长文本 → 看图识图 → 再回原来的长文本
图片之后返回原文本:
- SGLang:0.233s
- vLLM:20.268s
这里差距就完全不是一个量级了。所以:
单图:vLLM 略胜。
真实文本 + 视觉长期 Agent:SGLang 明显胜。
五、最后结论
先声明:
这个结论只代表我的硬件和 workload,不代表所有人。
如果你的显存更大、长期并发 session 更多,而且 KV retention 的优先级高于交互延迟,那么 vLLM 的 INT8 KV 路线依然非常有吸引力。我的结论并不是“vLLM 不行”,而是 在我的 workload 权重下,SGLang 更合适。我的真实使用前提已经决定了选择:
- 常态就是两个长期 Agent
- 第三个 Agent 只是偶发监控/管理,用云端模型花不了多少钱
- 每个 Agent 虽然设到 196K,但 65% 左右就会主动压缩
- 工作内容发散,不是大量重复 Coding Prefix
- 更在意长期 Session 返回速度和双并发体验
在这个前提下:
我最后选择 SGLang 做主力。
因为对我最常发生的场景来说,它已经表现出:
- 64K Decode 更快
- 长期 Session 返回明显更快
- 双/三/四 64K 并发 Prefill 更强
- 文本→图片→文本工作流明显更顺
而 vLLM 最大的优势:KV retention 在我的生产策略里反而不是最高优先级。如果以后 SGLang 能把 gfx1100 下稳定的 INT8 KV 打通,那我认为它目前最明显的短板也基本补上了。
最后还有一个问题我后面很想继续测: > 1 个双卡 TP2 SGLang > vs > 2 个单卡独立实例 到底双卡协同能不能真正做到:
1 + 1 > 2
这个我觉得比继续追几十个 tok/s 更有意思。对了,这次主要围绕 SGLang、vLLM 和 llama.cpp 三条本地推理路线展开。当前这一轮先完成了 SGLang vs vLLM 的正式对比,llama.cpp 因为双卡实现方式不同(layer split,不是 TP=2),我准备单独开一轮测试,避免混在一起造成误导。特哥一直鼓励我发新帖,我正在弄,弄好了我一起发我的本论坛处女楼主贴。
最后聊点题外话。
感谢 AI 治好了我的“电子阳痿”。无比怀念当年天天晚上工会活动,我法师准时上线,和一帮兄弟姐妹一起开荒魔兽世界的日子——美好、热血,也确实挺不务正业。现在年纪大了,游戏买了一大堆,全躺在硬盘里吃灰,删又不舍得删,打开玩又确实意兴阑珊。
结果这几个月折腾 AI,居然又找回了当年那种感觉:白天上班,晚上回来折腾机器、编译、跑模型、改参数、看视频、查日志,一不小心又干到下半夜。
区别只是当年开荒的是副本,现在开荒的是 ROCm、SGLang、vLLM、llama.cpp,还有各种自建 Skill。
更妙的是,这次在家天天熬夜的理由还格外冠冕堂皇——“学习 AI、研究新技术、提升生产力”。连申请显卡经费审批都顺利了不少,居然和当年的高手们“名正言顺申请 5090以便在特殊时期更好的上网课”那种窃喜和偷感共情了。
仔细想想,人其实没怎么变,只是当年折腾装备、插件和副本,现在折腾显卡、推理框架和 Agent。还是那个毛病:一旦找到新坑,就总想往深里挖。
搞不懂就查,跑崩了就重来,偶尔折腾出一个能用的结果,那个爽感还真和当年首杀 Boss 有点像。
游戏还是继续吃灰吧。现在这个“副本”,感觉还够我开荒一阵子。
-
,
 T terry 固定了此主题
-
这个帖子本来是发在 @flyer666 大佬的《魔改 SGLANG 支持 7900XTX 双卡 TP,TTFT <1s,平均 TG 80–100,4 并发 TG 200/sec》这篇神级帖子下面的一条我的水贴:
https://lcz.me/topic/1532?_=1789171714063
受宠若惊,被老特分叉置顶到了这里。既然单独成帖了,我也顺手把前面几处容易误导大家的地方补充和勘误一下。
-
首先要特别说明,魔改 SGLANG 支持 7900XTX 双卡 TP 这条路线,是 @flyer666 9 月 6 日发的高含金量原创,链接就是上面这篇。大家一定要先去拜读,然后狠狠点赞。
-
其次,回复 @geekyang 和 @懒人烘培 两位朋友:不好意思哈,我前面把主板型号写错了。我的实际主板是 GIGABYTE B850 AI TOP,当时大约 $320,并不是 GIGABYTE X870E AORUS Xtreme AI TOP(约 $1070)。
-
我选 B850 AI TOP 最主要的原因,就是双显卡同时插上以后,两条槽可以跑 x8/x8,对双 7900 XTX 这种玩法比较合适。缺点也很明显:DDR5 现在这个价格确实有点离谱。不过考虑到后面本地部署,尤其是 MoE、CPU offload、HiCache 这类玩法都会越来越吃系统内存,最后还是狠狠心上了 2×32GB,总共 64GB DDR5。现在回头看,这 64GB 还真没白上。要是只有 32GB,后面很多新玩法,包括大模型 CPU offload、长上下文缓存、HiCache L2 这类东西,基本就玩不开了。
然后补充下上面那个帖子的背景,希望对感兴趣的朋友有所参考和帮助。
我原来一直用的是7900XTX双卡 + vLLM,也是跟着 @flyer666 大佬之前这篇帖子折腾的:https://lcz.me/topic/1363 。用得非常顺手。
上周末看到 @flyer666 大佬这篇双 7900 XTX + SGLang 的帖子,测试数据实在太漂亮,当时确实有点兴奋,马上就想把自己的双卡也迁过去试试。结果 SGLang 部署起来以后,很快就碰到了一个特别明显的问题:
一个 Agent 正在正常输出时,另一个 Agent 一旦进来做长 prompt prefill,前面的 Agent 会出现几十秒完全没有 token 输出。也就是说我的两个Hermes Agent同时卡死无反应,短则几十秒,长达几分钟。但是单Agent完全没有问题,提升明显。
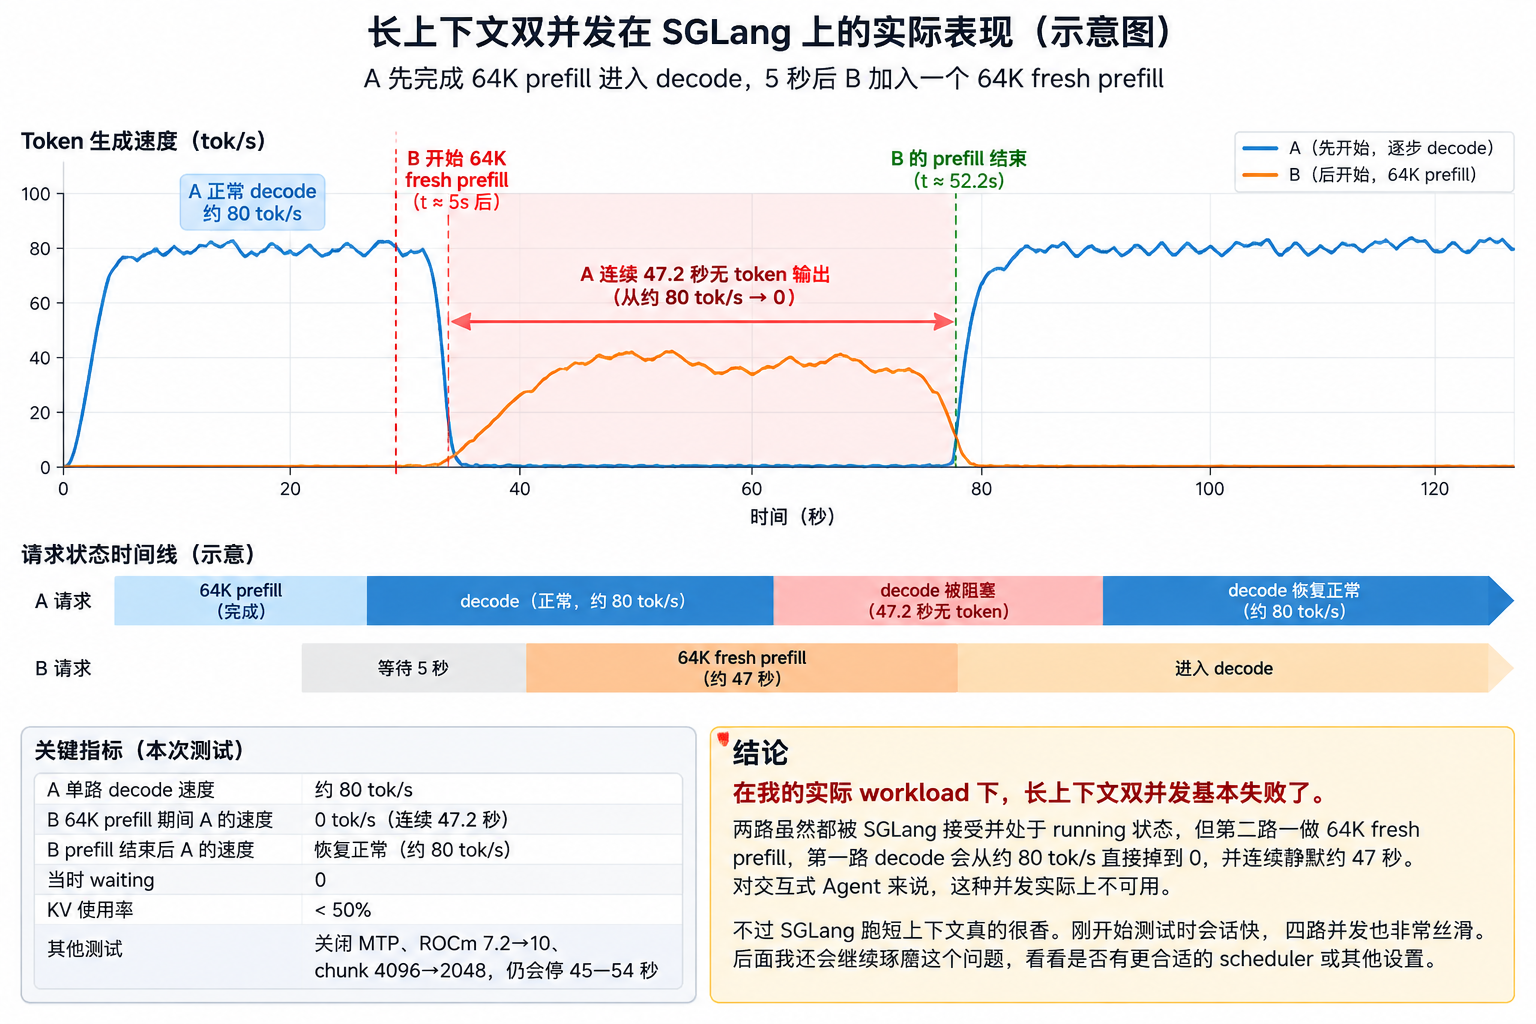
对我自己的使用场景来说,这个问题很严重。我平时不是只跑一个请求,而是有两个长期 Hermes Agent。一个 Agent 正在正常工作的时候,另一个 Agent 很可能突然带着很长的上下文进来。双卡跑不了并发,钱岂不是白花了?
最开始我还以为是双 7900 XTX 的算力不够,或者是 TP、ROCm、speculative decoding 哪一层出了问题。后来一路查资料、翻 issue 和 PR,才发现 SGLang 上游其实已经有人专门处理过这个问题。关键就是:PR #34058 https://github.com/sgl-project/sglang/pull/34058
这里面有一条和 scheduler 调度有关的改动,同时还有一个刚刚发布的的新参数:
--max-consecutive-prefill-batches N它的作用可以简单理解为:
限制 scheduler 连续执行 prefill 的次数,给已经处于 decode 状态的请求留出调度机会。
这个开关对我的实际使用体验产生了非常明显的变化。我当时专门设计了一个双并发测试来模拟自己的真实场景。
测试环境:
双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV
场景是:
Agent A 已经带着 64K 上下文持续 decode
→ 5 秒后 Agent B 加入
→ Agent B 执行 64K fresh prefill在原始状态下(不加这个参数,或者这个参数N=0),A 会出现非常明显的 starvation(算力饿死),就是卡死不动了。对我这种双长期 Agent 的工作方式来说,这基本就等于:
SGLang 在默认调度下不可用。
找到 PR #34058 以后,我把
--max-consecutive-prefill-batches从 N=1 一直测试到 N=16。实测结果如下:
N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s  1
4.04s 49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 结果非常直观可观。
N=1 基本就是我这个场景下的甜点位。
B 的 64K TTFT 几乎没有受到明显影响:
- 原版:49.43s
- N=1:49.48s
但 A 的最大断流时间:
- 原版:47.23s
- N=1:4.04s
等于从接近 50 秒,直接压到了约 4 秒。也就是说,现在我的B Agent如果带着64K上下文进来,原来的A只卡顿4秒,然后恢复吐字,这几乎不可察。
当然了,这里有一点我觉得特别值得强调。
打开 N=1 以后,并不是说 A 就完全不受影响了。B 在做 64K fresh prefill 的时候,两张 7900 XTX 的算力还是要被抢走,所以 A 的 decode 速度还是会明显下降(实测值 80 tok/s 降到 15 tok/s)。
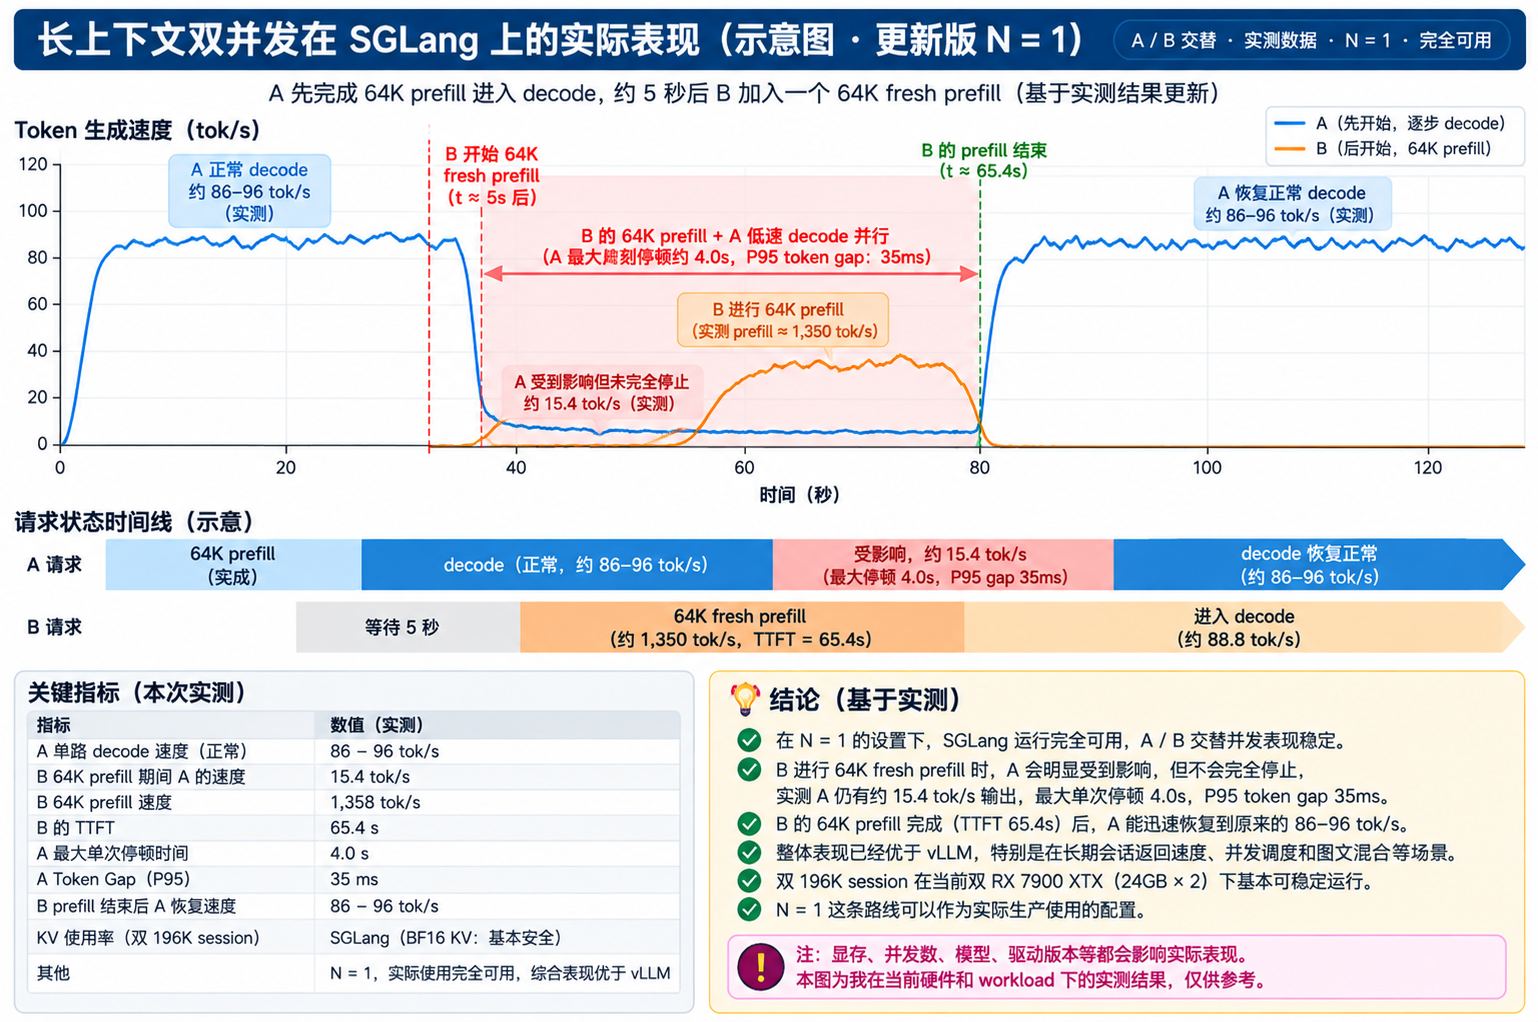
也就是说:
N=1 解决的是 starvation,不是 compute contention。
但是,它解决的是行不行的问题:
“另一个长 prefill 一进来,我这个 Agent 几十秒完全不出字。”
至此确定SGLang在我的这种“双7900XTX”加“双Hermes Agent各196K上下文”这个环境中完全可用了,这才引发了上面那个帖子的定量分析,到底vLLM和SGLang哪个更适合我,以及数据是多少。
换个说人话的版本,请勿对号入座哈
老特当年也风光过,坐奔驰,开宝马,最爱秋天的第一杯奶茶。
所谓时来天地皆同力,运去英雄不自由。如今龙游浅水,潜龙伏渊,论成败,人生豪迈,大不了重头再来。
于是招兵买马,雇了帅哥小特跑业务,请了一个漂亮小姐姐做财务。
一个负责挣钱,一个负责管钱。这算是 -- 双卡并行?
小特是真正的劳动模范,财务小姐姐也是秀外慧中。按理说,这男女搭配,干活不得效率翻倍?
都怪老特太抠门,不舍得团建投入,破冰不到位,怪不得小特这两天总是浮想联翩。
从大门到小姐姐工位的距离大约是49秒。每天早晨财务小姐姐带着一阵小香风款款经过,小特的CPU就瞬间被某个高优先级进程劫持。
小姐姐49秒不入座,小特的心49秒不降落。
财务小姐姐也是宝宝心里有苦倒不出。
每当小特经过,小姐姐的心里也总是一阵七上八下,小特又不是老特,他要是来加微信,我是拒绝呢,还是拒绝呢?
小特的工位到厕所的距离是49秒,小姐姐的魂也跟着柳飘飘了49秒。
感情你俩互相给自己心里加戏,让老子我的钱包白白受到一万点暴击是吧。
老特的人生,本来已经修炼到了莫听穿林打叶声,何妨吟啸且徐行的新境界。谁怕?怕谁?老子花钱雇了你们两个人,怎么着加法还变成减法了?是可忍,孰不能忍?
老特于是口吐莲花,感化得小特心服口服,心悦诚服。小特也是很有潜质的好苗子,老特本来的大招是老子蜀道山,结果根本不用数到三,数到一小特就已经脱胎换骨,改头换面,重新做人了。
从此小姐姐再进办公室,小特的心坚硬到只会跟着高跟鞋清脆的咔哒声动 4 秒。剩下的 45 秒里,风动,心不动。小特心无旁骛的样子——那真是,认真的男人最帅。
小特这一投入,小姐姐对他也顿时另眼相看。以后走过路过不怕错过,相看两不厌,只有敬亭山。
从此天下太平,工作融洽。男女搭配,终于成果加倍。
老特端着泡满枸杞的保温杯站在门口,看着两个人终于各司其职,露出了资本家久违的微笑。
这,就叫 结构化浪起来(SGLang) 的管理调度。
这,就是我 Scheduler 的硬实力。
-
-
AMD Ryzen 5 9600X 如何支持双卡PCIE x16 的?PCIE 不够啊。而且GIGABYTE X870E AORUS Xtreme AI TOP 这个主板是不是太贵了。
@Geekyang 9600X 不是给两张卡各 16 lanes,而是把 CPU 的 16 条显卡 lanes 拆成 x8/x8;B850 AI TOP 支持这种 bifurcation。
Ryzen 5 9600X 本身有 24 条可用 PCIe 5.0 lanes;其中 16 条 PEG lanes 可以由主板做 bifurcation,拆成 x8 + x8。AMD 官方给 9600X 的规格也是 28 条 native / 24 条 usable PCIe lanes。:contentReference[oaicite:0]{index=0}
我这块 GIGABYTE B850 AI TOP 正好支持这种分法:
- 第一条 PCIEX16:单卡时最高 x16
- 第二条 PCIEX8:最高 x8
- 两张卡同时插时,第一条会从 x16 降到 x8
- 最终就是 PCIe 5.0 x8 + x8
技嘉官方手册也明确写了:PCIEX16 和 PCIEX8 共享带宽,双卡时 PCIEX16 最高以 x8 运行。:contentReference[oaicite:1]{index=1}
是不是我前面如果哪里写成了“双 x16”,那是表达不严谨,准确说法应该是:
双物理 x16 插槽,CPU 直连,双卡运行时 x8/x8。
对 7900 XTX 做 TP2 来说,这也是我当初选这块板的主要原因之一。
-
@懒人烘培 不好意思,写错了,我的主板其实是 GIGABYTE B850 AI TOP。两张 7900 XTX 装上去还是太挤了,卡间距连一个槽位都不到。双卡满载时发热很严重,连带着 CPU 温度也跟着遭殃。目前的解决方案是加装两个高压风扇:一个从两卡缝隙中间往里吹风,另一个顺着 CPU 风扇的气流方向,同时兼顾吹 CPU 和中间那张 7900 XTX 的背面。这样调整后,满载长时间跑推理时,显卡和 CPU 温度都能稳定在警戒线以下,不会触发降频。另外,我7900XTX锁功耗墙了,大概是从330W降到了305W(最低能降的数字)。
-
这个帖子本来是发在 @flyer666 大佬的《魔改 SGLANG 支持 7900XTX 双卡 TP,TTFT <1s,平均 TG 80–100,4 并发 TG 200/sec》这篇神级帖子下面的一条我的水贴:
https://lcz.me/topic/1532?_=1789171714063
受宠若惊,被老特分叉置顶到了这里。既然单独成帖了,我也顺手把前面几处容易误导大家的地方补充和勘误一下。
-
首先要特别说明,魔改 SGLANG 支持 7900XTX 双卡 TP 这条路线,是 @flyer666 9 月 6 日发的高含金量原创,链接就是上面这篇。大家一定要先去拜读,然后狠狠点赞。
-
其次,回复 @geekyang 和 @懒人烘培 两位朋友:不好意思哈,我前面把主板型号写错了。我的实际主板是 GIGABYTE B850 AI TOP,当时大约 $320,并不是 GIGABYTE X870E AORUS Xtreme AI TOP(约 $1070)。
-
我选 B850 AI TOP 最主要的原因,就是双显卡同时插上以后,两条槽可以跑 x8/x8,对双 7900 XTX 这种玩法比较合适。缺点也很明显:DDR5 现在这个价格确实有点离谱。不过考虑到后面本地部署,尤其是 MoE、CPU offload、HiCache 这类玩法都会越来越吃系统内存,最后还是狠狠心上了 2×32GB,总共 64GB DDR5。现在回头看,这 64GB 还真没白上。要是只有 32GB,后面很多新玩法,包括大模型 CPU offload、长上下文缓存、HiCache L2 这类东西,基本就玩不开了。
然后补充下上面那个帖子的背景,希望对感兴趣的朋友有所参考和帮助。
我原来一直用的是7900XTX双卡 + vLLM,也是跟着 @flyer666 大佬之前这篇帖子折腾的:https://lcz.me/topic/1363 。用得非常顺手。
上周末看到 @flyer666 大佬这篇双 7900 XTX + SGLang 的帖子,测试数据实在太漂亮,当时确实有点兴奋,马上就想把自己的双卡也迁过去试试。结果 SGLang 部署起来以后,很快就碰到了一个特别明显的问题:
一个 Agent 正在正常输出时,另一个 Agent 一旦进来做长 prompt prefill,前面的 Agent 会出现几十秒完全没有 token 输出。也就是说我的两个Hermes Agent同时卡死无反应,短则几十秒,长达几分钟。但是单Agent完全没有问题,提升明显。
对我自己的使用场景来说,这个问题很严重。我平时不是只跑一个请求,而是有两个长期 Hermes Agent。一个 Agent 正在正常工作的时候,另一个 Agent 很可能突然带着很长的上下文进来。双卡跑不了并发,钱岂不是白花了?
最开始我还以为是双 7900 XTX 的算力不够,或者是 TP、ROCm、speculative decoding 哪一层出了问题。后来一路查资料、翻 issue 和 PR,才发现 SGLang 上游其实已经有人专门处理过这个问题。关键就是:PR #34058 https://github.com/sgl-project/sglang/pull/34058
这里面有一条和 scheduler 调度有关的改动,同时还有一个刚刚发布的的新参数:
--max-consecutive-prefill-batches N它的作用可以简单理解为:
限制 scheduler 连续执行 prefill 的次数,给已经处于 decode 状态的请求留出调度机会。
这个开关对我的实际使用体验产生了非常明显的变化。我当时专门设计了一个双并发测试来模拟自己的真实场景。
测试环境:
双 7900 XTX + SGLang gfx1100 + TP2 + MTP3 + BF16 KV
场景是:
Agent A 已经带着 64K 上下文持续 decode
→ 5 秒后 Agent B 加入
→ Agent B 执行 64K fresh prefill在原始状态下(不加这个参数,或者这个参数N=0),A 会出现非常明显的 starvation(算力饿死),就是卡死不动了。对我这种双长期 Agent 的工作方式来说,这基本就等于:
SGLang 在默认调度下不可用。
找到 PR #34058 以后,我把
--max-consecutive-prefill-batches从 N=1 一直测试到 N=16。实测结果如下:
N A 最大断流 B 64K TTFT 0(原版) 47.23s 49.43s 14.04s 49.48s 2 7.70s 49.21s 3 11.70s 49.05s 4 13.80s 49.37s 8 25.76s 49.24s 16 47.05s 49.24s 结果非常直观可观。
N=1 基本就是我这个场景下的甜点位。
B 的 64K TTFT 几乎没有受到明显影响:
- 原版:49.43s
- N=1:49.48s
但 A 的最大断流时间:
- 原版:47.23s
- N=1:4.04s
等于从接近 50 秒,直接压到了约 4 秒。也就是说,现在我的B Agent如果带着64K上下文进来,原来的A只卡顿4秒,然后恢复吐字,这几乎不可察。
当然了,这里有一点我觉得特别值得强调。
打开 N=1 以后,并不是说 A 就完全不受影响了。B 在做 64K fresh prefill 的时候,两张 7900 XTX 的算力还是要被抢走,所以 A 的 decode 速度还是会明显下降(实测值 80 tok/s 降到 15 tok/s)。
也就是说:
N=1 解决的是 starvation,不是 compute contention。
但是,它解决的是行不行的问题:
“另一个长 prefill 一进来,我这个 Agent 几十秒完全不出字。”
至此确定SGLang在我的这种“双7900XTX”加“双Hermes Agent各196K上下文”这个环境中完全可用了,这才引发了上面那个帖子的定量分析,到底vLLM和SGLang哪个更适合我,以及数据是多少。
换个说人话的版本,请勿对号入座哈
老特当年也风光过,坐奔驰,开宝马,最爱秋天的第一杯奶茶。
所谓时来天地皆同力,运去英雄不自由。如今龙游浅水,潜龙伏渊,论成败,人生豪迈,大不了重头再来。
于是招兵买马,雇了帅哥小特跑业务,请了一个漂亮小姐姐做财务。
一个负责挣钱,一个负责管钱。这算是 -- 双卡并行?
小特是真正的劳动模范,财务小姐姐也是秀外慧中。按理说,这男女搭配,干活不得效率翻倍?
都怪老特太抠门,不舍得团建投入,破冰不到位,怪不得小特这两天总是浮想联翩。
从大门到小姐姐工位的距离大约是49秒。每天早晨财务小姐姐带着一阵小香风款款经过,小特的CPU就瞬间被某个高优先级进程劫持。
小姐姐49秒不入座,小特的心49秒不降落。
财务小姐姐也是宝宝心里有苦倒不出。
每当小特经过,小姐姐的心里也总是一阵七上八下,小特又不是老特,他要是来加微信,我是拒绝呢,还是拒绝呢?
小特的工位到厕所的距离是49秒,小姐姐的魂也跟着柳飘飘了49秒。
感情你俩互相给自己心里加戏,让老子我的钱包白白受到一万点暴击是吧。
老特的人生,本来已经修炼到了莫听穿林打叶声,何妨吟啸且徐行的新境界。谁怕?怕谁?老子花钱雇了你们两个人,怎么着加法还变成减法了?是可忍,孰不能忍?
老特于是口吐莲花,感化得小特心服口服,心悦诚服。小特也是很有潜质的好苗子,老特本来的大招是老子蜀道山,结果根本不用数到三,数到一小特就已经脱胎换骨,改头换面,重新做人了。
从此小姐姐再进办公室,小特的心坚硬到只会跟着高跟鞋清脆的咔哒声动 4 秒。剩下的 45 秒里,风动,心不动。小特心无旁骛的样子——那真是,认真的男人最帅。
小特这一投入,小姐姐对他也顿时另眼相看。以后走过路过不怕错过,相看两不厌,只有敬亭山。
从此天下太平,工作融洽。男女搭配,终于成果加倍。
老特端着泡满枸杞的保温杯站在门口,看着两个人终于各司其职,露出了资本家久违的微笑。
这,就叫 结构化浪起来(SGLang) 的管理调度。
这,就是我 Scheduler 的硬实力。
问题基本不在双卡链路,在 SGLang 的调度:一条长 prefill 会整段占住 GPU,期间 decode 请求排不进去,所以你看到的「另一个 Agent 几十秒没 token」是 prefill 抢跑,不是卡死。
先查启动参数里的 chunked prefill:
--chunked-prefill-size调小(比如 2048/4096,别用 -1),让长 prompt 分块跑,decode 在块与块之间插队,卡顿会从「几十秒」压到单块量级- 看你这版有没有
--enable-mixed-chunk,开了才能 prefill/decode 同批 --max-prefill-tokens也压低,防止单批过大- 顺手对比
--schedule-policy lpm和fcfs:lpm 命中前缀省算力,但新请求做长 prefill 时更容易抢
你测 vLLM 那轮体感更稳,很大概率就是 vLLM 默认开了 chunked prefill。压测时同时看
sglang:num_queue_reqs和 TTFT 分位,如果卡顿期间排队数在涨,就坐实是调度而不是 hang。B850 AI TOP 的 x8/x8 对 TP2 没问题,TP 每层一次 AllReduce,PCIe 5.0 x8 足够;两卡贴太近降频会把 prefill 拖长,反而放大这个卡顿,你加风扇、锁 305W 的方向是对的。
-
-
@Geekyang 9600X 不是给两张卡各 16 lanes,而是把 CPU 的 16 条显卡 lanes 拆成 x8/x8;B850 AI TOP 支持这种 bifurcation。
Ryzen 5 9600X 本身有 24 条可用 PCIe 5.0 lanes;其中 16 条 PEG lanes 可以由主板做 bifurcation,拆成 x8 + x8。AMD 官方给 9600X 的规格也是 28 条 native / 24 条 usable PCIe lanes。:contentReference[oaicite:0]{index=0}
我这块 GIGABYTE B850 AI TOP 正好支持这种分法:
- 第一条 PCIEX16:单卡时最高 x16
- 第二条 PCIEX8:最高 x8
- 两张卡同时插时,第一条会从 x16 降到 x8
- 最终就是 PCIe 5.0 x8 + x8
技嘉官方手册也明确写了:PCIEX16 和 PCIEX8 共享带宽,双卡时 PCIEX16 最高以 x8 运行。:contentReference[oaicite:1]{index=1}
是不是我前面如果哪里写成了“双 x16”,那是表达不严谨,准确说法应该是:
双物理 x16 插槽,CPU 直连,双卡运行时 x8/x8。
对 7900 XTX 做 TP2 来说,这也是我当初选这块板的主要原因之一。
-
@Geekyang 9600X 不是给两张卡各 16 lanes,而是把 CPU 的 16 条显卡 lanes 拆成 x8/x8;B850 AI TOP 支持这种 bifurcation。
Ryzen 5 9600X 本身有 24 条可用 PCIe 5.0 lanes;其中 16 条 PEG lanes 可以由主板做 bifurcation,拆成 x8 + x8。AMD 官方给 9600X 的规格也是 28 条 native / 24 条 usable PCIe lanes。:contentReference[oaicite:0]{index=0}
我这块 GIGABYTE B850 AI TOP 正好支持这种分法:
- 第一条 PCIEX16:单卡时最高 x16
- 第二条 PCIEX8:最高 x8
- 两张卡同时插时,第一条会从 x16 降到 x8
- 最终就是 PCIe 5.0 x8 + x8
技嘉官方手册也明确写了:PCIEX16 和 PCIEX8 共享带宽,双卡时 PCIEX16 最高以 x8 运行。:contentReference[oaicite:1]{index=1}
是不是我前面如果哪里写成了“双 x16”,那是表达不严谨,准确说法应该是:
双物理 x16 插槽,CPU 直连,双卡运行时 x8/x8。
对 7900 XTX 做 TP2 来说,这也是我当初选这块板的主要原因之一。
-
@懒人烘培 不好意思,写错了,我的主板其实是 GIGABYTE B850 AI TOP。两张 7900 XTX 装上去还是太挤了,卡间距连一个槽位都不到。双卡满载时发热很严重,连带着 CPU 温度也跟着遭殃。目前的解决方案是加装两个高压风扇:一个从两卡缝隙中间往里吹风,另一个顺着 CPU 风扇的气流方向,同时兼顾吹 CPU 和中间那张 7900 XTX 的背面。这样调整后,满载长时间跑推理时,显卡和 CPU 温度都能稳定在警戒线以下,不会触发降频。另外,我7900XTX锁功耗墙了,大概是从330W降到了305W(最低能降的数字)。
-
5mm 间距基本等于没有风道,两卡夹缝里的空气被反复加热,上面那张吸的是下面卡的排气,热是必然。尾部加风扇有帮助,但要看是「往夹缝送风」还是「往外抽热风」:
- 夹缝只有 5mm,14cm 扇塞不进去,风压也不够,效果有限;开放式散热的卡,最有效的是从机箱前面往两卡之间送一股定向风,或用导风罩把夹缝热气引出去。
- 根本解法是拉开间距(PCIe 延长线/转接、换板距更大的机箱),或上水冷/涡轮卡。垂直、吊装主要是避免热空气堆积,有用但不是根因。
- 别靠手感判断,看数据:nvidia-smi dmon -s pucvt,分别看两卡温度、功耗和降频原因。一般到 80-83℃ 才开始明显降频,先确认是不是真撞了温度墙。
建议先只把一张卡拉开距离跑一次对比,数据比加扇子直观。
-
-
@懒人烘培 我也是,随时准备搞根PCI延长线把显卡移出来,我是开放式机架,方便。 https://lcz.me/topic/1363/3 flyer666大佬这个帖子里有发图,他的双7900XTX就是延长线引出来了,放在机架上方,四面通风。


