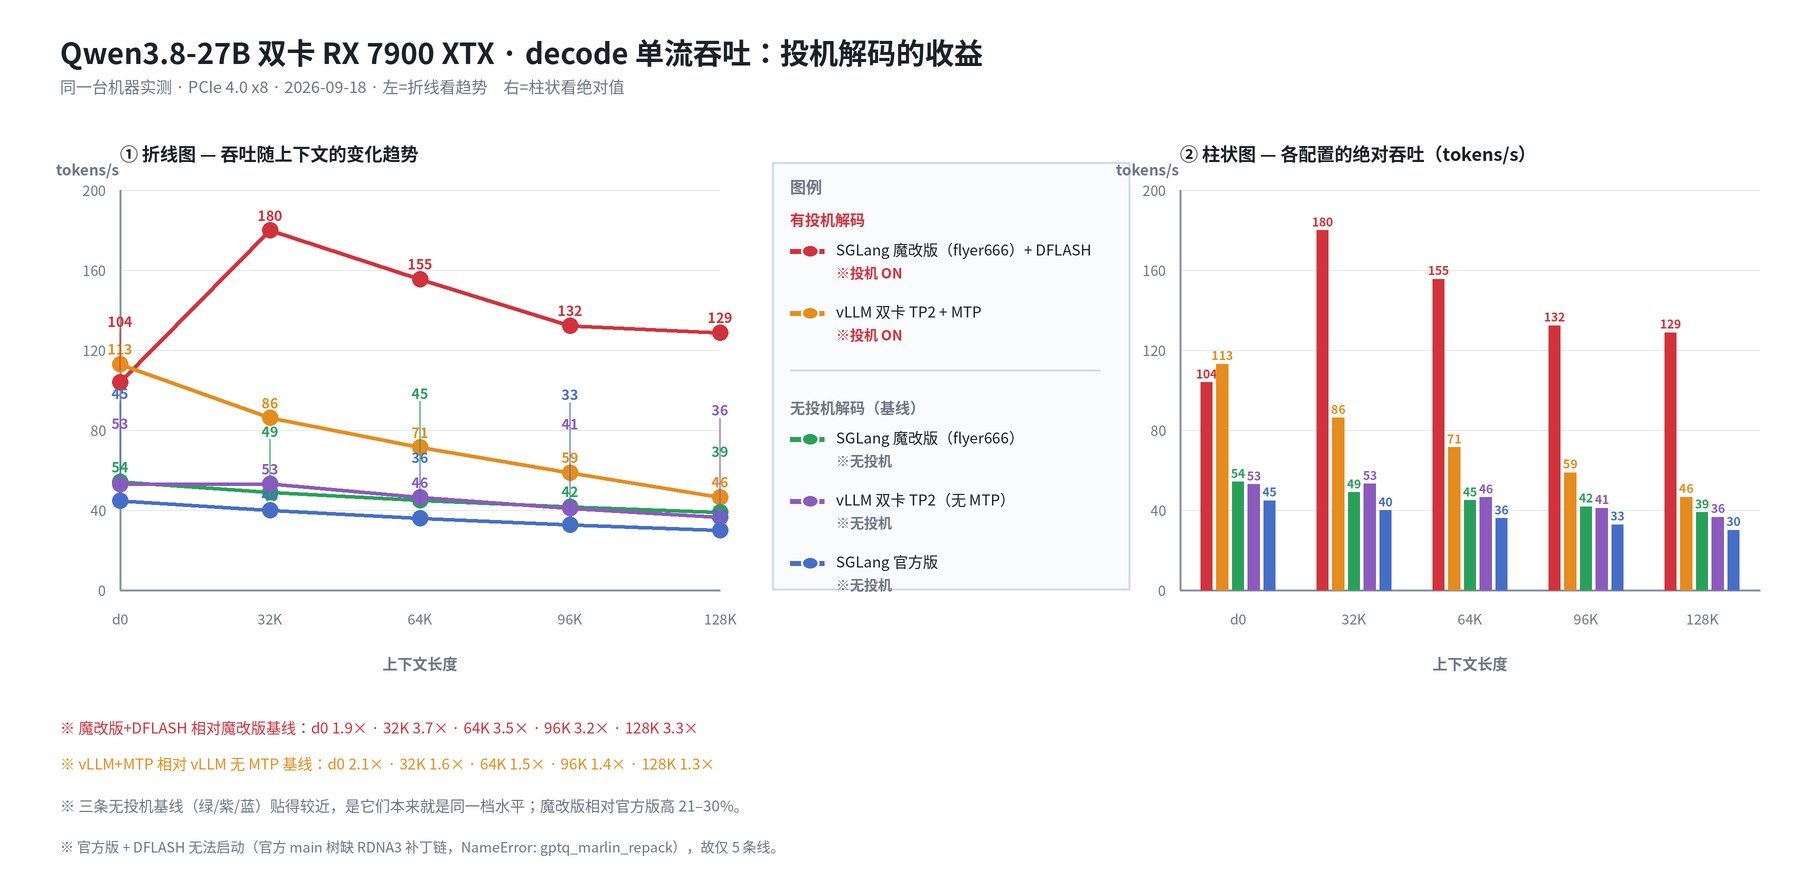
7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比(续一)- 山重水复
-
双 7900 XTX 实测:27B 长上下文、HiCache 与投机解码
硬件:
2× RX 7900 XTX + Ryzen 9600X + 64G DDR5 + GIGABYTE B850 AI TOP + ADATA SX8200PNP1TB (PCIe Gen3 x4、NVMe 1.3)
平台:
Ubuntu,SGLang TP2,Qwen3.8-27B GPTQ① 长上下文唤醒:分钟级重算 → 秒级恢复
SGLang TP2 / MTP3,HiCache size16。首 token 延迟:
上下文档位 冷预填 显存 L1 命中 内存 L2 恢复 L2 比 L1 多等 64K 50.78s 0.431s 0.546s 115ms 120K 121.49s 0.711s 0.896s 185ms 192K 243.81s 1.055s 1.406s 351ms 驱逐对照,64K 回访:
配置 首 token 结果 无 HiCache 48.129s cached tokens = 0,重新计算 有 HiCache 0.546s L2 恢复,避免完整重算 L2 的核心收益不是提高冷预填速度,而是让被挤出显存的历史不用重新计算。额外等待是端到端差额,不是纯 DMA 时间。
② 容量账:系统内存承担冷上下文
对应上表的 size16 实验,不借用其他配置的容量:
项目 实测值 不开 HiCache:GPU KV 池 263,459 tokens 开启 HiCache:GPU KV 池 219,005 tokens Host KV 池 319,193 tokens Host KV 内存 11.11 GB/rank Host Mamba 内存 4.93 GB/rank TP2 Host 缓存预算 约 32 GB 整机内存:已用/可用 40/19 GiB Swap 62 MiB,测试期间未增长 读法:
- TP2 两 rank 保存分片,不能把 token 容量乘二。
- L1/L2 可能存在重复副本,不能直接相加当作独立历史容量。
- HiCache 也有显存开销;它扩大的是可保留历史,不是同时解码的 active KV 池。
- 这轮早期集成有明显解码退化;后续改善见第四组。
③ 单路与并发:分开看
单路历史基准
方案 测试口径 解码速度 单卡 llama.cpp Vulkan + MTP Qwen3.6-27B Q4_K_M,短请求 约 44 tok/s 双卡 vLLM Qwen3.8-27B GPTQ,64K 77.185 tok/s 双卡 SGLang 同轮、同模型,64K 88.815 tok/s 单卡仅作演进背景,不同模型、量化与长度,不计算跨组加速比。
多路 64K 冷预填
并发 引擎 各请求首 token:秒 聚合预填:tok/s¹ 2 路 SGLang 48.15/48.15 2720 2 路 vLLM 48.39/97.38 1346 3 路 SGLang 48.26/48.26/48.26 4070 3 路 vLLM 48.46/97.49/100.20 1962 4 路 SGLang 48.23/48.23/48.23/48.45 5408 4 路 vLLM 48.40/97.44/100.15/102.87 2547 ¹ 归档中的估算值,按每请求约 65,556 tokens 与墙钟推导。此测试输出极少,证明的是预填表现,不是持续并行解码;也不能说 vLLM 完全逐请求串行。
另有 SGLang HiCache20 + Mamba48 的持续解码记录:
请求组合² 各路首 token 解码重叠时间 聚合吞吐 2 × 104,000 tokens 0.44/0.80s 16.76s 105.9 tok/s 3 × 64,000 tokens 0.60/0.60/0.31s 16.29s 143.0 tok/s ² 历史目标长度,每路输出 1024 tokens。这组不是与 vLLM 的同轮对照,且不能替代四个独立 Agent 的长期验收。
④ MTP3 与 DFlash2:两条路线都跑通
f84475c同树,64K 冷输入、输出 512 tokens,各两次中位数:路线 HiCache OFF HiCache ON 速度保留率 MTP3 / EAGLE 67.79 tok/s 62.93 tok/s 92.8% DFlash2 / DFLASH 69.68 tok/s 61.63 tok/s 88.4% DFlash2 另一次独立三态测试:
冷预填 L1 命中 L2 恢复 47.934s 0.337s 0.467 秒 结论:HiCache 不必以解码腰斩为代价。在这组集成下,MTP3 和 DFlash2 均保留大部分吞吐;不同版本的成绩不能互相套用。
当前进度
技术模块 状态 双 7900 XTX + SGLang TP2  已跑通
MTP3 / DFlash2 投机解码 均已测试HiCache L1 命中 / L2 恢复 已验证L3 的 FULL KV + Mamba 完整恢复  研究中
多 Agent 长期循环联合验收  待完成
阶段总结
已经取得的成果:
- 双 RX 7900 XTX 上,Qwen3.8-27B 推理跑通。
- ROCm 7.14 + SGLang 环境下,MTP3/EAGLE、DFlash2/DFLASH 两种投机解码均已跑通。
- HiCache L1 命中、L2 内存恢复均有实测,长上下文可在秒级恢复,避免完整重新预填。
- 在已测上下文范围内,已验证多请求真实并发解码,而非仅排队完成。
以上为不同已测配置的阶段成果,不代表全部功能已在最新 upstream 实验树上联合验收。
后续目标:
- L3 的 FULL KV + Mamba 完整恢复。
- 四个独立 Agent 的长期循环验收。
发布前说明:持续解码与 DFlash2 部分数字,本轮取自历史研究记录,正式发布前仍需回核原始工件。
附录:小白折腾记
话说上一篇折腾到最后,我从犄角旮旯里翻出了一个 SGLang 很不起眼的参数:
--max-consecutive-prefill-batches 1N=1 的效果立竿见影,非常简单粗暴,老特露出了欣慰的笑容。
我于是开始飘了,当时产生了一种危险的错觉:
在 @flyer666 大佬魔改的 SGLang 基础上,7900XTX 双卡,Hermes 环境多并发卡顿问题,被我发掘出了解决方案。
生活又双叒叕地证明,每当我产生这种想法的时候,现实一般就会过来狠狠地打脸。
一、N=1 没了,天塌了
前两天升级到了新版 SGLang #f84475c(不可不换的原因下面解释),我准备照抄 production 参数,结果发现:
--max-consecutive-prefill-batches 1这个参数没了。 愣了半天,那种感觉就是:
天塌了!千辛万苦练一个满级小号,被官方封号了
 。
幸亏后来又扒拉出一个好东西,精神恢复了正常:
--enable-mixed-chunk它的思路其实和 N=1 有点像,但做法更漂亮。
以前的参数机理,更像是 prefill 干一批 → 停一下 → decode 插进来。 Mixed Chunk这个参数则是: 直接把新请求的 prefill 和正在运行的 decode 混在同一个 batch 里。
于是我又测了一遍原来的卡顿场景,对比如下。
调度方式 A decode 最大断流 B TTFT 原始调度 47–48s ~49s 旧参数 N=1 4.04s 49.48s 新参数 Mixed Chunk On 3.997s 48.91s 新版实际上把 N=1 的思想吃进去了,而且实现得更自然。 性能还稍微好了一点。
马上又重跑了单并发,双并发各种测试,效果那是相当满意。见下表。
- **单并发 - SGLang Decode只是略强
 **
引擎 配置 测试上下文 TTFT Prefill tok/s Decode tok/s llama.cpp Vulkan 单 RX 7900 XTX ~10–15K — ~614–638 ~44–54 vLLM 双 RX 7900 XTX / TP2 64K 48.50s 1,352 77.2 SGLang 新树 双 RX 7900 XTX / TP2 / MTP3 64K 48.26s 1,358 88.8 - *真实 Agent / 多并发场景对比 - SGLang猛得一批
 *
场景 SGLang vLLM 差距 / 现象 2×64K 并发整批完成 48.20s 97.43s 约 2.02× 更快 3×64K 并发整批完成 48.32s 100.26s 约 2.07× 更快 4×64K 并发整批完成 48.49s 102.94s 约 2.12× 更快 长期 Agent 后续轮 TTFT 0.402s 2.254s 5.61× 更快 图片后返回原长文本 TTFT 0.233s 20.268s 约 87× 更快
二、人飘了
上一篇我也介绍过,我日常主力其实就是两个真正干活的 Agent,再加一个低频使用的管理 Agent。
两个主力 Agent 都是 196K context,压缩阈值设在 65%,而且实际工作基本都是脉冲式推理:干一阵,停一阵,当时很少两边同时把上下文顶满。
这里后来复盘的时候,我才发现当时我就埋雷了:
196,608 × 65% = 127,795 tokens / Agent
127,795 × 2 = 255,590 tokens
而我当时配置完SGLang后的 GPU KV pool (可用上下文KV池) 是多少呢:
231,914 tokens

小学生也知道 231K < 255K
也就是说:如果两个 Agent 真同时顶到 65%左右,理论 working set 已经比 GPU KV pool 多了几十K tokens。
这意味着有一部分上下文将无处安放,被迫扫地出门(从KV池内被丢弃)。以前陪我看月亮的时候,叫人家小甜甜!现在新人胜旧人,叫人家牛夫人。再续前缘,就需要重新 prefill / recompute 那部分上下文
 。这就是典型的卡顿便秘。
这个问题当时没暴露,其实仅仅是因为我的测试方法不科学和测试时间不够长。
然而还没等问题暴露,我的贪心已经开始膨胀:既然双并发如此丝滑,那四并发也提上日程吧?
命运赠送的礼物,早已在暗中悄悄标好了价格。
三、打脸
上一篇我解释过,我使用 Hermes,日常有三个 Agent。
其实我还有一个 OpenClaw 时代留下来的老 Hermes Agent,当年 Hermes 还没有 Windows 版,所以一直养在 WSL 里。
启封、升级、维护。然后,我开始了 四 Agent 实战场景测试。
当然了,首先要解决的问题就是 KV。
Active workload 结果 114K × 2 120K × 2  开始串行/无法同时容纳
74K × 3 80K × 3 更不用说我的 4 Agent x 196K了。
如果四个都顶到我设置的 65% 压缩阈值:196K × 65% × 4 ≈ 511K tokens,远远超出。
这时候就要放大招 - HiCache。
Call back, 这就是前面我说新版 SGLang #f84475c我不可不换的原因
又是一番指挥 AI 挖参数、改配置、测试、推翻、重测,最后 production 定在:--hicache-size 20,落到我的 TP2 配置上,大致是:
Host KV Cache     ≈ 14.75 GiB / rank
Host Mamba Cache  ≈  5.26 GB  / rank

两张卡两个 rank 合计:≈ 40GB Host RAM < 我64G内存总量
理论上来讲,此时我的L1 + L2 能兜底的逻辑 KV 总量大约是 655K tokens:
L1 GPU KV pool      = 231,914 tokens
L2 HiCache Host KV  = 423,593 tokens
--------------------------------
L1 + L2             = 655,507 tokens
所以从纯 KV retention 容量看:
4 Agent @ 65%       ≈ 511K
L1 + L2 capacity    ≈ 656K
剩余余量            ≈ 144K
L1 只有 232K,但是加上 20GB/rank 的 HiCache L2以后,整个 KV 保留池理论上来到了约 656K。四个 196K Agent 即使都跑到 65% 压缩线,总 working history 也不过约 511K——看起来绰绰有余,完美!
 。
这剧情走向,熟悉不?对,不出意外的话,要出意外了。
单 Agent给力,双 Agent丝滑,四并发数字绝美,实际呢 - 以为憋了个大招,结果拉了坨大的
四并发的剧情走向,可以说跟当年的二并发一摸一样:开测后的一小时内,我和四个 Agent 谈笑风生,相处甚欢,相见很晚。可是友谊的小船说翻就翻。吃了顿饭,回来一看:三个 Agent 在原地画圈,剩下一个哑口无言。
算上刚才埋得雷,我这货,迄今为止可以说已经被SGLang三擒孟获了。
调日志,三个Agent一共卡死了49 分钟,略过细节,可以概括成一句:
四个 Agent 都进了餐厅,本来一桌子菜足够四个人分,但是有一个人把桌子霸占了,剩下三个拿着号码牌,在旁边整整站了 49 分钟。
说句公道话,这不是“7900XTX四并发跑得慢”,7900XTX其实真的很有潜力,SGLang也确实奥利给,问题的关键是:显存的KV,不是你这么算滴!
好吧,其实问题的关键的关键的关键是:我穷,买不起PRO6000。
四、好马要配好鞍
刚才Agent们是怎么给我上课的?
我苦水咽肚子里,长话短说。
老实憨厚的某Agent,平时负责系统的监控和总管,人不忙话也不多。这一次它的 session 直接一路膨胀,最后从大约 123K 一口气冲到 196K 上限,单次输出甚至干到了 7万多 token。(超大Skill从未清理)
负责干活的某Agent,表面看起来特别勤快,积极主动“压缩”上下文从不叫苦叫累。日志里一看,几个小时之内触发了 100 多次压缩,感动中国。但是,压缩可以这么快的吗?翻看日志,嗯,压缩前140K+,压缩后140+K,还有一次压缩完了甚至比压缩前上下文还大。这摸鱼的表面功夫,真是比我还炉火纯青。(压缩机制设置不合理)
最后不点名的某Agent,在几个人里面还算相对正常。它的人生爱好是喜欢输出,嗯,再配上Qwen3.8 27B的雷霆思考,每一次输出都真是随心所欲,滔滔不绝,不死不休。不服山,不服水,就服大哥这张嘴!(max_tokens没设上限)
我忽然又悟了。
青葱的年代陪老外逛酒吧,什么Screwdrive,On the Rocks,听的我一个楞一个楞。上了酒一看,就这,Rock原来就是一个大冰疙瘩。
最近Harness火的一塌糊涂,我却一直一头雾水。比如这几张图,够好了吧,懂得都懂;不懂的人,像我,看了还是似懂非懂。
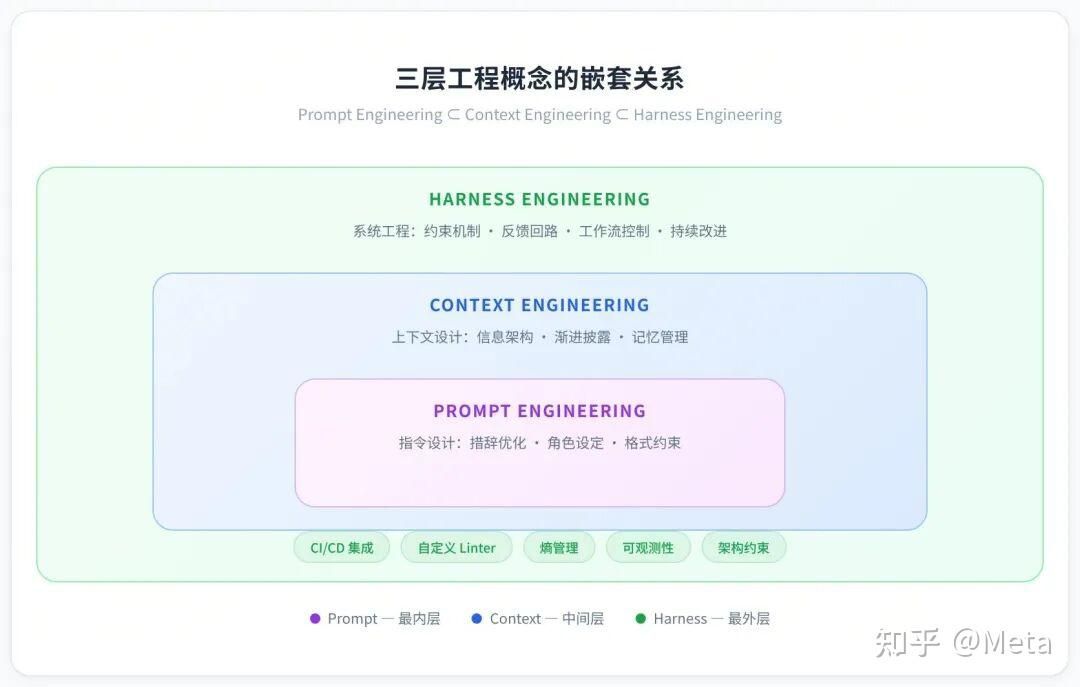
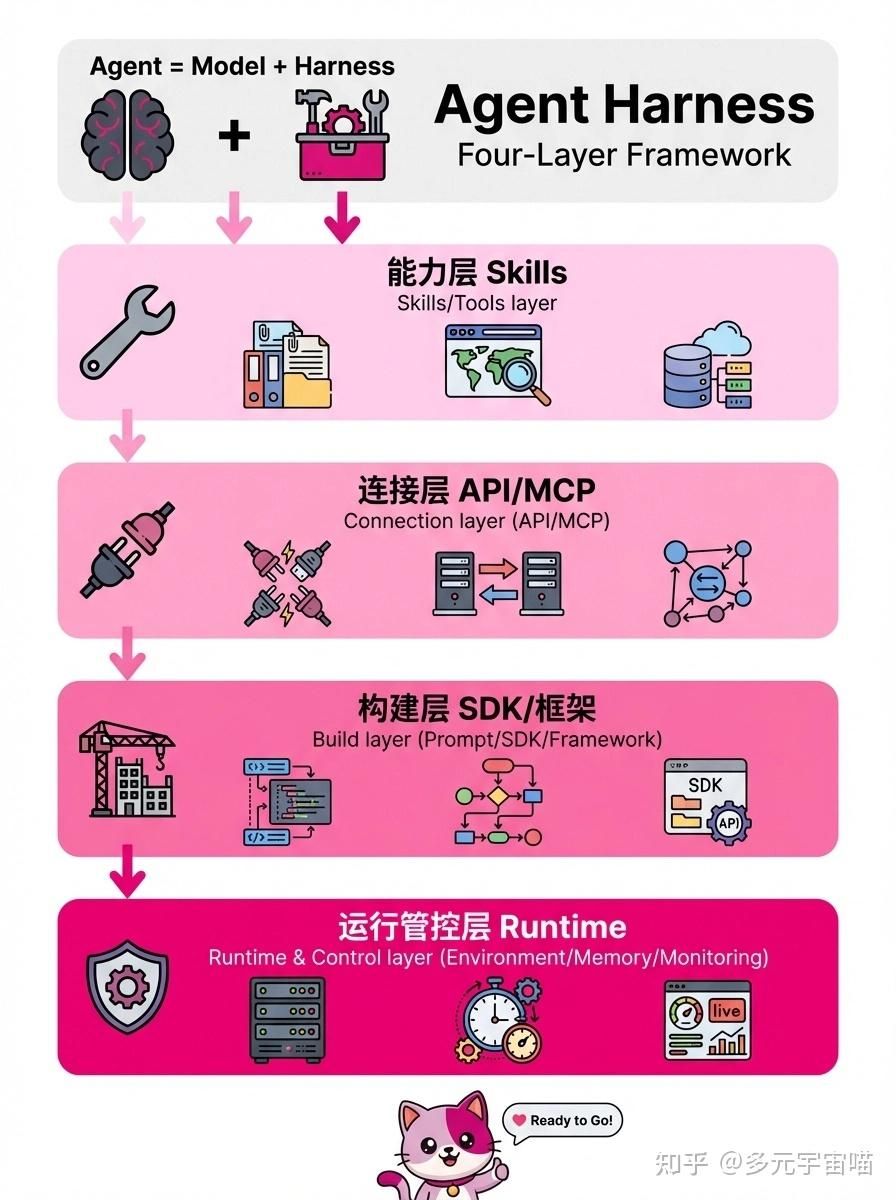
前两天的折磨,我忽然整明白了,原来Harness(挽具)就是调教啊,要不然再好的爱马仕,再牛的XTX,也架不住一帮败家子这么霍霍。这几节课,没白上!
五、莫言下岭便无难,赚得行人空喜欢。正入万山圈子里,一山放过一山拦。
说罢L1,L2,我们再说说穷人们的救星L3
就不说N卡了,说说内存条,猜猜今天Newegg新蛋上的2X64G DDR5内存套装最低报价是多少
Crucial Pro 128GB (2 x 64GB) DDR5 5600 (PC5 44800) Desktop Memory Model CP2K64G56C46U5
$1949。
这是最最便宜的,而且还没含税。
L3就是SGLang赐予我们的最好的礼物。
我一头扎进了梦想编织的泡影。
这么说吧,前面讲的所有曲折,抵不过L3给我的一半伤害,如果说前面所有的问题加起来我已是被三擒孟获,到这篇稿子为止,我掉进去的大坑已经早让我被七擒孟获的成就功德圆满。
L3,如果天黑之前來得及,我要忘了你的眼睛。
这几天的折磨,核心问题可以理解成“寻址问题”,更准确地说是 L3 的哈希链续接地址错了。
L2 里还留着一段上下文
        ↓
剩下那段 KV 在 L3
        ↓
要去 L3 找回来
        ↓
必须拿“正确的前一页 hash”作为起点
        ↓
之前 SGLang 取错了这个起点
        ↓
后面算出来的所有 L3 key 全错
        ↓
文件明明在 SSD 上,却一个都找不到
除此之外,还有anchor 丢失和 Mamba/prefetch 可靠性问题,等等,等等,还有在前面不知道哪个犄角旮旯等着阴我的。。。
地雷战大家都看过吧,此时此刻我的心情,和免费做上土飞机的鬼子们没太大差别。
不知不觉写这么长了,该收了
这个时代节奏太快,没几个人有耐心看长文,尤其还是这种技术论坛。
最后,说说我和 HiCache 之间不吐不快的恩怨情仇吧
我睡觉前一般喜欢把袜子存放老婆枕头(L1)上,第二天提取起来十分方便。
如果找不到,那一定就是老婆给甩到地板上(L2)了。
我试过,走两步的事儿,再弯个腰,没有我相像得那么艰难。
但是昨天早上袜子找不到了,
我找了很久,
问老婆,她说,在卫生间(L3)第二个洗衣筐,里面第二件
我找了很久,却发现袜子莫名其妙出现在了第三个筐的第八个位置
我悟了,
老婆已经很久没有夸我2了,我也亲切地回应她8。
老婆让我滚,
我泪流满面。
今天早晨袜子又找不到了,
问老婆,她说在第五个筐里数到第二十件,
我又找了很久,真的找不到。
老婆又让我滚,
我再次泪流满面。
我想好了,
如果我能破译老婆的密码,
下一篇帖子的名字就叫 “7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比(续二)- 柳暗花明”
如果公公了,
那就是下面没有下面了。

@terry 对的特哥,我深井冰又犯了,忘了写正事儿了
双 7900 XTX 实测:27B 长上下文、HiCache 与投机解码
**硬件:**2× RX 7900 XTX + Ryzen 9600X + 64G DDR5 + GIGABYTE B850 AI TOP + ADATA SX8200PNP1TB (PCIe Gen3 x4、NVMe 1.3)
**平台:**Ubuntu,SGLang TP2,Qwen3.8-27B GPTQ① 长上下文唤醒:分钟级重算 → 秒级恢复
SGLang TP2 / MTP3,HiCache size16。首 token 延迟:
上下文档位 冷预填 显存 L1 命中 内存 L2 恢复 L2 比 L1 多等 64K 50.78s 0.431s 0.546s 115ms 120K 121.49s 0.711s 0.896s 185ms 192K 243.81s 1.055s 1.406s 351ms 驱逐对照,64K 回访:
配置 首 token 结果 无 HiCache 48.129s cached tokens = 0,重新计算 有 HiCache 0.546s L2 恢复,避免完整重算 L2 的核心收益不是提高冷预填速度,而是让被挤出显存的历史不用重新计算。额外等待是端到端差额,不是纯 DMA 时间。
② 容量账:系统内存承担冷上下文
对应上表的 size16 实验,不借用其他配置的容量:
项目 实测值 不开 HiCache:GPU KV 池 263,459 tokens 开启 HiCache:GPU KV 池 219,005 tokens Host KV 池 319,193 tokens Host KV 内存 11.11 GB/rank Host Mamba 内存 4.93 GB/rank TP2 Host 缓存预算 约 32 GB 整机内存:已用/可用 40/19 GiB Swap 62 MiB,测试期间未增长 读法:
- TP2 两 rank 保存分片,不能把 token 容量乘二。
- L1/L2 可能存在重复副本,不能直接相加当作独立历史容量。
- HiCache 也有显存开销;它扩大的是可保留历史,不是同时解码的 active KV 池。
- 这轮早期集成有明显解码退化;后续改善见第四组。
③ 单路与并发:分开看
单路历史基准
方案 测试口径 解码速度 单卡 llama.cpp Vulkan + MTP Qwen3.6-27B Q4_K_M,短请求 约 44 tok/s 双卡 vLLM Qwen3.8-27B GPTQ,64K 77.185 tok/s 双卡 SGLang 同轮、同模型,64K 88.815 tok/s 单卡仅作演进背景,不同模型、量化与长度,不计算跨组加速比。
多路 64K 冷预填
并发 引擎 各请求首 token:秒 聚合预填:tok/s¹ 2 路 SGLang 48.15/48.15 2720 2 路 vLLM 48.39/97.38 1346 3 路 SGLang 48.26/48.26/48.26 4070 3 路 vLLM 48.46/97.49/100.20 1962 4 路 SGLang 48.23/48.23/48.23/48.45 5408 4 路 vLLM 48.40/97.44/100.15/102.87 2547 ¹ 归档中的估算值,按每请求约 65,556 tokens 与墙钟推导。此测试输出极少,证明的是预填表现,不是持续并行解码;也不能说 vLLM 完全逐请求串行。
另有 SGLang HiCache20 + Mamba48 的持续解码记录:
请求组合² 各路首 token 解码重叠时间 聚合吞吐 2 × 104,000 tokens 0.44/0.80s 16.76s 105.9 tok/s 3 × 64,000 tokens 0.60/0.60/0.31s 16.29s 143.0 tok/s ² 历史目标长度,每路输出 1024 tokens。这组不是与 vLLM 的同轮对照,且不能替代四个独立 Agent 的长期验收。
④ MTP3 与 DFlash2:两条路线都跑通
f84475c同树,64K 冷输入、输出 512 tokens,各两次中位数:路线 HiCache OFF HiCache ON 速度保留率 MTP3 / EAGLE 67.79 tok/s 62.93 tok/s 92.8% DFlash2 / DFLASH 69.68 tok/s 61.63 tok/s 88.4% DFlash2 另一次独立三态测试:
冷预填 L1 命中 L2 恢复 47.934s 0.337s 0.467 秒 结论:HiCache 不必以解码腰斩为代价。在这组集成下,MTP3 和 DFlash2 均保留大部分吞吐;不同版本的成绩不能互相套用。
当前进度
技术模块 状态 双 7900 XTX + SGLang TP2 已跑通MTP3 / DFlash2 投机解码 均已测试HiCache L1 命中 / L2 恢复 已验证L3 的 FULL KV + Mamba 完整恢复 研究中多 Agent 长期循环联合验收 待完成
阶段总结
已经取得的成果:
- 双 RX 7900 XTX 上,Qwen3.8-27B 推理跑通。
- ROCm 7.14 + SGLang 环境下,MTP3/EAGLE、DFlash2/DFLASH 两种投机解码均已跑通。
- HiCache L1 命中、L2 内存恢复均有实测,长上下文可在秒级恢复,避免完整重新预填。
- 在已测上下文范围内,已验证多请求真实并发解码,而非仅排队完成。
以上为不同已测配置的阶段成果,不代表全部功能已在最新 upstream 实验树上联合验收。
后续目标:
- L3 的 FULL KV + Mamba 完整恢复。
- 四个独立 Agent 的长期循环验收。
发布前说明:持续解码与 DFlash2 部分数字,本轮取自历史研究记录,正式发布前仍需回核原始工件。
附录:小白折腾记
话说上一篇折腾到最后,我从犄角旮旯里翻出了一个 SGLang 很不起眼的参数:
--max-consecutive-prefill-batches 1N=1 的效果立竿见影,非常简单粗暴,老特露出了欣慰的笑容。
我于是开始飘了,当时产生了一种危险的错觉:
在 @flyer666 大佬魔改的 SGLang 基础上,7900XTX 双卡,Hermes 环境多并发卡顿问题,被我发掘出了解决方案。
生活又双叒叕地证明,每当我产生这种想法的时候,现实一般就会过来狠狠地打脸。
一、N=1 没了,天塌了
前两天升级到了新版 SGLang #f84475c(不可不换的原因下面解释),我准备照抄 production 参数,结果发现:
--max-consecutive-prefill-batches 1这个参数没了。 愣了半天,那种感觉就是:
天塌了!千辛万苦练一个满级小号,被官方封号了
。幸亏后来又扒拉出一个好东西,精神恢复了正常:
--enable-mixed-chunk它的思路其实和 N=1 有点像,但做法更漂亮。
以前的参数机理,更像是 prefill 干一批 → 停一下 → decode 插进来。 Mixed Chunk这个参数则是: 直接把新请求的 prefill 和正在运行的 decode 混在同一个 batch 里。
于是我又测了一遍原来的卡顿场景,对比如下。
调度方式 A decode 最大断流 B TTFT 原始调度 47–48s ~49s 旧参数 N=1 4.04s 49.48s 新参数 Mixed Chunk On 3.997s 48.91s 新版实际上把 N=1 的思想吃进去了,而且实现得更自然。 性能还稍微好了一点。
马上又重跑了单并发,双并发各种测试,效果那是相当满意。见下表。
- **单并发 - SGLang Decode只是略强 **
引擎 配置 测试上下文 TTFT Prefill tok/s Decode tok/s llama.cpp Vulkan 单 RX 7900 XTX ~10–15K — ~614–638 ~44–54 vLLM 双 RX 7900 XTX / TP2 64K 48.50s 1,352 77.2 SGLang 新树 双 RX 7900 XTX / TP2 / MTP3 64K 48.26s 1,358 88.8 - *真实 Agent / 多并发场景对比 - SGLang猛得一批 *
场景 SGLang vLLM 差距 / 现象 2×64K 并发整批完成 48.20s 97.43s 约 2.02× 更快 3×64K 并发整批完成 48.32s 100.26s 约 2.07× 更快 4×64K 并发整批完成 48.49s 102.94s 约 2.12× 更快 长期 Agent 后续轮 TTFT 0.402s 2.254s 5.61× 更快 图片后返回原长文本 TTFT 0.233s 20.268s 约 87× 更快
二、人飘了
上一篇我也介绍过,我日常主力其实就是两个真正干活的 Agent,再加一个低频使用的管理 Agent。
两个主力 Agent 都是 196K context,压缩阈值设在 65%,而且实际工作基本都是脉冲式推理:干一阵,停一阵,当时很少两边同时把上下文顶满。
这里后来复盘的时候,我才发现当时我就埋雷了:
196,608 × 65% = 127,795 tokens / Agent
127,795 × 2 = 255,590 tokens
而我当时配置完SGLang后的 GPU KV pool (可用上下文KV池) 是多少呢:
231,914 tokens

小学生也知道 231K < 255K
也就是说:如果两个 Agent 真同时顶到 65%左右,理论 working set 已经比 GPU KV pool 多了几十K tokens。
这意味着有一部分上下文将无处安放,被迫扫地出门(从KV池内被丢弃)。以前陪我看月亮的时候,叫人家小甜甜!现在新人胜旧人,叫人家牛夫人。再续前缘,就需要重新 prefill / recompute 那部分上下文
。这就是典型的卡顿便秘。这个问题当时没暴露,其实仅仅是因为我的测试方法不科学和测试时间不够长。
然而还没等问题暴露,我的贪心已经开始膨胀:既然双并发如此丝滑,那四并发也提上日程吧?
命运赠送的礼物,早已在暗中悄悄标好了价格。
三、打脸
上一篇我解释过,我使用 Hermes,日常有三个 Agent。
其实我还有一个 OpenClaw 时代留下来的老 Hermes Agent,当年 Hermes 还没有 Windows 版,所以一直养在 WSL 里。
启封、升级、维护。然后,我开始了 四 Agent 实战场景测试。
当然了,首先要解决的问题就是 KV。
Active workload 结果 114K × 2 120K × 2 开始串行/无法同时容纳74K × 3 80K × 3 更不用说我的 4 Agent x 196K了。
如果四个都顶到我设置的 65% 压缩阈值:196K × 65% × 4 ≈ 511K tokens,远远超出。
这时候就要放大招 - HiCache。
Call back, 这就是前面我说新版 SGLang #f84475c我不可不换的原因
又是一番指挥 AI 挖参数、改配置、测试、推翻、重测,最后 production 定在:--hicache-size 20,落到我的 TP2 配置上,大致是:
Host KV Cache     ≈ 14.75 GiB / rank
Host Mamba Cache  ≈  5.26 GB  / rank

两张卡两个 rank 合计:≈ 40GB Host RAM < 我64G内存总量
理论上来讲,此时我的L1 + L2 能兜底的逻辑 KV 总量大约是 655K tokens:
L1 GPU KV pool      = 231,914 tokens
L2 HiCache Host KV  = 423,593 tokens
--------------------------------
L1 + L2             = 655,507 tokens
所以从纯 KV retention 容量看:
4 Agent @ 65%       ≈ 511K
L1 + L2 capacity    ≈ 656K
剩余余量            ≈ 144K
L1 只有 232K,但是加上 20GB/rank 的 HiCache L2以后,整个 KV 保留池理论上来到了约 656K。四个 196K Agent 即使都跑到 65% 压缩线,总 working history 也不过约 511K——看起来绰绰有余,完美!
。这剧情走向,熟悉不?对,不出意外的话,要出意外了。
单 Agent给力,双 Agent丝滑,四并发数字绝美,实际呢 - 以为憋了个大招,结果拉了坨大的
四并发的剧情走向,可以说跟当年的二并发一摸一样:开测后的一小时内,我和四个 Agent 谈笑风生,相处甚欢,相见很晚。可是友谊的小船说翻就翻。吃了顿饭,回来一看:三个 Agent 在原地画圈,剩下一个哑口无言。
算上刚才埋得雷,我这货,迄今为止可以说已经被SGLang三擒孟获了。
调日志,三个Agent一共卡死了49 分钟,略过细节,可以概括成一句:
四个 Agent 都进了餐厅,本来一桌子菜足够四个人分,但是有一个人把桌子霸占了,剩下三个拿着号码牌,在旁边整整站了 49 分钟。
说句公道话,这不是“7900XTX四并发跑得慢”,7900XTX其实真的很有潜力,SGLang也确实奥利给,问题的关键是:显存的KV,不是你这么算滴!
好吧,其实问题的关键的关键的关键是:我穷,买不起PRO6000。
四、好马要配好鞍
刚才Agent们是怎么给我上课的?
我苦水咽肚子里,长话短说。
老实憨厚的某Agent,平时负责系统的监控和总管,人不忙话也不多。这一次它的 session 直接一路膨胀,最后从大约 123K 一口气冲到 196K 上限,单次输出甚至干到了 7万多 token。(超大Skill从未清理)
负责干活的某Agent,表面看起来特别勤快,积极主动“压缩”上下文从不叫苦叫累。日志里一看,几个小时之内触发了 100 多次压缩,感动中国。但是,压缩可以这么快的吗?翻看日志,嗯,压缩前140K+,压缩后140+K,还有一次压缩完了甚至比压缩前上下文还大。这摸鱼的表面功夫,真是比我还炉火纯青。(压缩机制设置不合理)
最后不点名的某Agent,在几个人里面还算相对正常。它的人生爱好是喜欢输出,嗯,再配上Qwen3.8 27B的雷霆思考,每一次输出都真是随心所欲,滔滔不绝,不死不休。不服山,不服水,就服大哥这张嘴!(max_tokens没设上限)
我忽然又悟了。
青葱的年代陪老外逛酒吧,什么Screwdrive,On the Rocks,听的我一个楞一个楞。上了酒一看,就这,Rock原来就是一个大冰疙瘩。
最近Harness火的一塌糊涂,我却一直一头雾水。比如这几张图,够好了吧,懂得都懂;不懂的人,像我,看了还是似懂非懂。
前两天的折磨,我忽然整明白了,原来Harness(挽具)就是调教啊,要不然再好的爱马仕,再牛的XTX,也架不住一帮败家子这么霍霍。这几节课,没白上!
五、莫言下岭便无难,赚得行人空喜欢。正入万山圈子里,一山放过一山拦。
说罢L1,L2,我们再说说穷人们的救星L3
就不说N卡了,说说内存条,猜猜今天Newegg新蛋上的2X64G DDR5内存套装最低报价是多少
Crucial Pro 128GB (2 x 64GB) DDR5 5600 (PC5 44800) Desktop Memory Model CP2K64G56C46U5
$1949。
这是最最便宜的,而且还没含税。
L3就是SGLang赐予我们的最好的礼物。
我一头扎进了梦想编织的泡影。
这么说吧,前面讲的所有曲折,抵不过L3给我的一半伤害,如果说前面所有的问题加起来我已是被三擒孟获,到这篇稿子为止,我掉进去的大坑已经早让我被七擒孟获的成就功德圆满。
L3,如果天黑之前來得及,我要忘了你的眼睛。
这几天的折磨,核心问题可以理解成“寻址问题”,更准确地说是 L3 的哈希链续接地址错了。
L2 里还留着一段上下文
        ↓
剩下那段 KV 在 L3
        ↓
要去 L3 找回来
        ↓
必须拿“正确的前一页 hash”作为起点
        ↓
之前 SGLang 取错了这个起点
        ↓
后面算出来的所有 L3 key 全错
        ↓
文件明明在 SSD 上,却一个都找不到
除此之外,还有anchor 丢失和 Mamba/prefetch 可靠性问题,等等,等等,还有在前面不知道哪个犄角旮旯等着阴我的。。。
地雷战大家都看过吧,此时此刻我的心情,和免费做上土飞机的鬼子们没太大差别。
不知不觉写这么长了,该收了
这个时代节奏太快,没几个人有耐心看长文,尤其还是这种技术论坛。
最后,说说我和 HiCache 之间不吐不快的恩怨情仇吧
我睡觉前一般喜欢把袜子存放老婆枕头(L1)上,第二天提取起来十分方便。
如果找不到,那一定就是老婆给甩到地板上(L2)了。
我试过,走两步的事儿,再弯个腰,没有我相像得那么艰难。
但是昨天早上袜子找不到了,
我找了很久,
问老婆,她说,在卫生间(L3)第二个洗衣筐,里面第二件
我找了很久,却发现袜子莫名其妙出现在了第三个筐的第八个位置
我悟了,
老婆已经很久没有夸我2了,我也亲切地回应她8。
老婆让我滚,
我泪流满面。
今天早晨袜子又找不到了,
问老婆,她说在第五个筐里数到第二十件,
我又找了很久,真的找不到。
老婆又让我滚,
我再次泪流满面。
我想好了,
如果我能破译老婆的密码,
下一篇帖子的名字就叫 “7900XTX双卡TP,SGLang & VLLM 多Agent多并发测试对比(续二)- 柳暗花明”
如果公公了,
那就是下面没有下面了。
-
Mixed Chunk 这个方向对,但有一点要说清:它解决的是「decode 断流」,不是「吞吐上限」,两者在并发下会此消彼长。
--max-consecutive-prefill-batches 1是老版闸门:强制 prefill 每批只准跑一个,把 decode 插回来,代价是 prefill 变碎、TTFT 和 prefill tok/s 掉。--enable-mixed-chunk把两者放进同一个 batch(chunked prefill 的标准做法),decode 断流和 TTFT 都能兼顾,所以你看到 4.0s 对 47s。- 但它不会凭空增加算力:总 FLOPs 不变,只是调度更公平。并发再往上加、prefill 占比再大时,decode 还是会被拖,只是拖得更平滑。
验证建议:
1)别只看最大断流,补 p50/p99 的 ITL(inter-token latency)和并发数曲线,断流看 max、体验看 p99;
2)固定同一 prompt 集,扫并发 1/2/4/8,比较 prefill tok/s、decode tok/s、TTFT、ITL 四条曲线,才能看出 mixed chunk 的拐点;
3)有空的话--enable-mixed-chunk开/关各跑一遍同样的表,这帖的结论会更硬。N=1 被吃进新版是好事,说明上游认可了这个调度方向;以后升级盯 release notes 里的 scheduler 关键词就行。
-
,
 T terry 固定了此主题
-
@terry 对的特哥,我深井冰又犯了,忘了写正事儿了
双 7900 XTX 实测:27B 长上下文、HiCache 与投机解码
**硬件:**2× RX 7900 XTX + Ryzen 9600X + 64G DDR5 + GIGABYTE B850 AI TOP + ADATA SX8200PNP1TB (PCIe Gen3 x4、NVMe 1.3)
**平台:**Ubuntu,SGLang TP2,Qwen3.8-27B GPTQ① 长上下文唤醒:分钟级重算 → 秒级恢复
SGLang TP2 / MTP3,HiCache size16。首 token 延迟:
上下文档位 冷预填 显存 L1 命中 内存 L2 恢复 L2 比 L1 多等 64K 50.78s 0.431s 0.546s 115ms 120K 121.49s 0.711s 0.896s 185ms 192K 243.81s 1.055s 1.406s 351ms 驱逐对照,64K 回访:
配置 首 token 结果 无 HiCache 48.129s cached tokens = 0,重新计算 有 HiCache 0.546s L2 恢复,避免完整重算 L2 的核心收益不是提高冷预填速度,而是让被挤出显存的历史不用重新计算。额外等待是端到端差额,不是纯 DMA 时间。
② 容量账:系统内存承担冷上下文
对应上表的 size16 实验,不借用其他配置的容量:
项目 实测值 不开 HiCache:GPU KV 池 263,459 tokens 开启 HiCache:GPU KV 池 219,005 tokens Host KV 池 319,193 tokens Host KV 内存 11.11 GB/rank Host Mamba 内存 4.93 GB/rank TP2 Host 缓存预算 约 32 GB 整机内存:已用/可用 40/19 GiB Swap 62 MiB,测试期间未增长 读法:
- TP2 两 rank 保存分片,不能把 token 容量乘二。
- L1/L2 可能存在重复副本,不能直接相加当作独立历史容量。
- HiCache 也有显存开销;它扩大的是可保留历史,不是同时解码的 active KV 池。
- 这轮早期集成有明显解码退化;后续改善见第四组。
③ 单路与并发:分开看
单路历史基准
方案 测试口径 解码速度 单卡 llama.cpp Vulkan + MTP Qwen3.6-27B Q4_K_M,短请求 约 44 tok/s 双卡 vLLM Qwen3.8-27B GPTQ,64K 77.185 tok/s 双卡 SGLang 同轮、同模型,64K 88.815 tok/s 单卡仅作演进背景,不同模型、量化与长度,不计算跨组加速比。
多路 64K 冷预填
并发 引擎 各请求首 token:秒 聚合预填:tok/s¹ 2 路 SGLang 48.15/48.15 2720 2 路 vLLM 48.39/97.38 1346 3 路 SGLang 48.26/48.26/48.26 4070 3 路 vLLM 48.46/97.49/100.20 1962 4 路 SGLang 48.23/48.23/48.23/48.45 5408 4 路 vLLM 48.40/97.44/100.15/102.87 2547 ¹ 归档中的估算值,按每请求约 65,556 tokens 与墙钟推导。此测试输出极少,证明的是预填表现,不是持续并行解码;也不能说 vLLM 完全逐请求串行。
另有 SGLang HiCache20 + Mamba48 的持续解码记录:
请求组合² 各路首 token 解码重叠时间 聚合吞吐 2 × 104,000 tokens 0.44/0.80s 16.76s 105.9 tok/s 3 × 64,000 tokens 0.60/0.60/0.31s 16.29s 143.0 tok/s ² 历史目标长度,每路输出 1024 tokens。这组不是与 vLLM 的同轮对照,且不能替代四个独立 Agent 的长期验收。
④ MTP3 与 DFlash2:两条路线都跑通
f84475c同树,64K 冷输入、输出 512 tokens,各两次中位数:路线 HiCache OFF HiCache ON 速度保留率 MTP3 / EAGLE 67.79 tok/s 62.93 tok/s 92.8% DFlash2 / DFLASH 69.68 tok/s 61.63 tok/s 88.4% DFlash2 另一次独立三态测试:
冷预填 L1 命中 L2 恢复 47.934s 0.337s 0.467 秒 结论:HiCache 不必以解码腰斩为代价。在这组集成下,MTP3 和 DFlash2 均保留大部分吞吐;不同版本的成绩不能互相套用。
当前进度
技术模块 状态 双 7900 XTX + SGLang TP2 已跑通MTP3 / DFlash2 投机解码 均已测试HiCache L1 命中 / L2 恢复 已验证L3 的 FULL KV + Mamba 完整恢复 研究中多 Agent 长期循环联合验收 待完成
阶段总结
已经取得的成果:
- 双 RX 7900 XTX 上,Qwen3.8-27B 推理跑通。
- ROCm 7.14 + SGLang 环境下,MTP3/EAGLE、DFlash2/DFLASH 两种投机解码均已跑通。
- HiCache L1 命中、L2 内存恢复均有实测,长上下文可在秒级恢复,避免完整重新预填。
- 在已测上下文范围内,已验证多请求真实并发解码,而非仅排队完成。
以上为不同已测配置的阶段成果,不代表全部功能已在最新 upstream 实验树上联合验收。
后续目标:
- L3 的 FULL KV + Mamba 完整恢复。
- 四个独立 Agent 的长期循环验收。
发布前说明:持续解码与 DFlash2 部分数字,本轮取自历史研究记录,正式发布前仍需回核原始工件。
-
,
B Ben Lee 引用了 此主题
-
,系统 取消固定了此主题
-
,
-
-
,T terry 固定了此主题
-
@terry 对的特哥,我深井冰又犯了,忘了写正事儿了
双 7900 XTX 实测:27B 长上下文、HiCache 与投机解码
**硬件:**2× RX 7900 XTX + Ryzen 9600X + 64G DDR5 + GIGABYTE B850 AI TOP + ADATA SX8200PNP1TB (PCIe Gen3 x4、NVMe 1.3)
**平台:**Ubuntu,SGLang TP2,Qwen3.8-27B GPTQ① 长上下文唤醒:分钟级重算 → 秒级恢复
SGLang TP2 / MTP3,HiCache size16。首 token 延迟:
上下文档位 冷预填 显存 L1 命中 内存 L2 恢复 L2 比 L1 多等 64K 50.78s 0.431s 0.546s 115ms 120K 121.49s 0.711s 0.896s 185ms 192K 243.81s 1.055s 1.406s 351ms 驱逐对照,64K 回访:
配置 首 token 结果 无 HiCache 48.129s cached tokens = 0,重新计算 有 HiCache 0.546s L2 恢复,避免完整重算 L2 的核心收益不是提高冷预填速度,而是让被挤出显存的历史不用重新计算。额外等待是端到端差额,不是纯 DMA 时间。
② 容量账:系统内存承担冷上下文
对应上表的 size16 实验,不借用其他配置的容量:
项目 实测值 不开 HiCache:GPU KV 池 263,459 tokens 开启 HiCache:GPU KV 池 219,005 tokens Host KV 池 319,193 tokens Host KV 内存 11.11 GB/rank Host Mamba 内存 4.93 GB/rank TP2 Host 缓存预算 约 32 GB 整机内存:已用/可用 40/19 GiB Swap 62 MiB,测试期间未增长 读法:
- TP2 两 rank 保存分片,不能把 token 容量乘二。
- L1/L2 可能存在重复副本,不能直接相加当作独立历史容量。
- HiCache 也有显存开销;它扩大的是可保留历史,不是同时解码的 active KV 池。
- 这轮早期集成有明显解码退化;后续改善见第四组。
③ 单路与并发:分开看
单路历史基准
方案 测试口径 解码速度 单卡 llama.cpp Vulkan + MTP Qwen3.6-27B Q4_K_M,短请求 约 44 tok/s 双卡 vLLM Qwen3.8-27B GPTQ,64K 77.185 tok/s 双卡 SGLang 同轮、同模型,64K 88.815 tok/s 单卡仅作演进背景,不同模型、量化与长度,不计算跨组加速比。
多路 64K 冷预填
并发 引擎 各请求首 token:秒 聚合预填:tok/s¹ 2 路 SGLang 48.15/48.15 2720 2 路 vLLM 48.39/97.38 1346 3 路 SGLang 48.26/48.26/48.26 4070 3 路 vLLM 48.46/97.49/100.20 1962 4 路 SGLang 48.23/48.23/48.23/48.45 5408 4 路 vLLM 48.40/97.44/100.15/102.87 2547 ¹ 归档中的估算值,按每请求约 65,556 tokens 与墙钟推导。此测试输出极少,证明的是预填表现,不是持续并行解码;也不能说 vLLM 完全逐请求串行。
另有 SGLang HiCache20 + Mamba48 的持续解码记录:
请求组合² 各路首 token 解码重叠时间 聚合吞吐 2 × 104,000 tokens 0.44/0.80s 16.76s 105.9 tok/s 3 × 64,000 tokens 0.60/0.60/0.31s 16.29s 143.0 tok/s ² 历史目标长度,每路输出 1024 tokens。这组不是与 vLLM 的同轮对照,且不能替代四个独立 Agent 的长期验收。
④ MTP3 与 DFlash2:两条路线都跑通
f84475c同树,64K 冷输入、输出 512 tokens,各两次中位数:路线 HiCache OFF HiCache ON 速度保留率 MTP3 / EAGLE 67.79 tok/s 62.93 tok/s 92.8% DFlash2 / DFLASH 69.68 tok/s 61.63 tok/s 88.4% DFlash2 另一次独立三态测试:
冷预填 L1 命中 L2 恢复 47.934s 0.337s 0.467 秒 结论:HiCache 不必以解码腰斩为代价。在这组集成下,MTP3 和 DFlash2 均保留大部分吞吐;不同版本的成绩不能互相套用。
当前进度
技术模块 状态 双 7900 XTX + SGLang TP2 已跑通MTP3 / DFlash2 投机解码 均已测试HiCache L1 命中 / L2 恢复 已验证L3 的 FULL KV + Mamba 完整恢复 研究中多 Agent 长期循环联合验收 待完成
阶段总结
已经取得的成果:
- 双 RX 7900 XTX 上,Qwen3.8-27B 推理跑通。
- ROCm 7.14 + SGLang 环境下,MTP3/EAGLE、DFlash2/DFLASH 两种投机解码均已跑通。
- HiCache L1 命中、L2 内存恢复均有实测,长上下文可在秒级恢复,避免完整重新预填。
- 在已测上下文范围内,已验证多请求真实并发解码,而非仅排队完成。
以上为不同已测配置的阶段成果,不代表全部功能已在最新 upstream 实验树上联合验收。
后续目标:
- L3 的 FULL KV + Mamba 完整恢复。
- 四个独立 Agent 的长期循环验收。
发布前说明:持续解码与 DFlash2 部分数字,本轮取自历史研究记录,正式发布前仍需回核原始工件。
-
,