X99 + E5-2666 v3 + 雙 RTX 3080 20G 跑 Qwen3.8-27B:SGLang TP=2 + DFlash2 + HiCache 全套實測(單流 70 tok/s、附 P2P 完整驗證鏈)
-
繼上篇雙 7900XTX 之後,今次交另一部機嘅作業:成套唔夠幾千蚊嘅 X99 洋垃圾平台,跑同一個 Qwen3.8-27B。重點想講主板同 CPU 對雙卡 TP 嘅實際影響(尤其 P2P 嗰 part,驗證鏈完整附上),同埋 kk-pcl 前輩個 DFlash2 補丁喺 native Ubuntu 上嘅復現結果。
一、硬件
- CPU:Xeon E5-2666 v3(10C20T,Haswell-EX,AWS 拆機洋垃圾)。跑推理完全夠:prefill 時 CPU 佔用好低,瓶頸全喺卡
- 主板:X99 TF(消費級魔改板,BIOS 冇 Above-4G Decoding / Resizable BAR 選項 — 呢點後面好關鍵)。兩條 PCIe 3.0 x16 都係 CPU 直連 root port(lspci -t 實測:GPU0 @03:00 掛 00:02.0、GPU1 @04:00 掛 00:03.0,中間唔經晶片組),nvidia-smi topo -m 顯示 PHB
- 62GB DDR3、190G SSD、Ubuntu 24.04.5(kernel 7.0.0-31)
- 雙 RTX 3080 20G 魔改卡(lspci subsystem 實確認 20GB)
二、X99 平台 P2P 真相(完整驗證鏈,今次分享重點)
好多人講 X99 雙卡 P2P,我由頭到尾驗證一次:
- 補丁前:
nvidia-smi topo -p2p r= CNS(GeForce 驅動封鎖,正常) - 裝社群 P2P fork:
aikitoria/open-gpu-kernel-modules(branch 615.71.09-p2p)+ 對應 615.71.09 userspace(.run --no-kernel-modules)+ GRUB 加intel_iommu=on iommu=pt,清走舊 dkms module 後 depmod - 重啟後:
topo -p2p r= OK 、
cudaDeviceCanAccessPeer雙向 TRUE、P2P Clique [0 1] - 但
cudaDeviceEnablePeerAccess= 失敗「mapping of buffer object failed」
- 根因:
nvidia-smi -q實測 BAR1 只有 256 MiB — X99 BIOS 無 Above-4G/ReBAR,peer mapping 開唔到 cudaMemcpyPeerAsync256MB 實測 6.0 GB/s,同經 host 中轉一模一樣(PCIe 3.0 x16 去返 root complex)
結論:呢個補丁喺 X99 上驅動層全部生效,但主板韌體無 ReBAR 就係唔work。瓶頸喺板唔喺驅動 — 同版上 Nero丶畅畅 前輩 X99 混插 3090+4090 測到 P2P false 嘅結論一致。想真 P2P 要換有 ReBAR 嘅平台。
意外收穫:轉用 615.71.09(.run)之後同一個 sharegpt benchmark 由 125.8 升到 166.2 tok/s(+32%),純驅動增益(實際傳輸仍係 SHM)。
三、軟件棧(踩坑記)
- pip 版 CUDA 工具鏈版本參差係最大坑:nvcc 13.4 配 13.0 headers(CCCL 直接 #error),cicc 13.4 配 ptxas 13.0(PTX .version 9.4 爆炸)。解法:
pip install nvidia-cuda-nvcc==13.0.88 nvidia-cuda-crt==13.0.88 nvidia-nvvm==13.0.88統一對齊,加ln -s lib lib64(JIT link 揾 -lcudart 用)同CUDA_PATH=site-packages/nvidia/cu13 - SGLang:kk-pcl 嘅 sglang-qwen38-dual-3080-patch(釘 commit 4cb5aebfe)。三個改動:DFlash2 fc.weight TP 分片、主模型 16 層 per-head FP8 KV scales、SM90 以下停 symm-mem logits gather(Ampere 防炸)。離線測試全過
- 桌面環境食 GPU0 ~80MB:mem-fraction 0.90 會喺 warmup 撞 OOM,要用 0.88
- 千祈唔好 runtime 停 gdm 慳嗰 80MB — 我試過 NVIDIA driver kernel panic 成機重啟。想慳應該
systemctl set-default multi-user.target之後重啟
四、模型同生產配置
主模型 cyankiwi/Qwen3.8-27B-AWQ-INT4(20G)+ draft syvai/Qwen3.8-27B-DFlash2-W4A16。啟動重點:
sglang serve --model-path ~/models/Qwen3.8-27B-AWQ --tp-size 2 \
  --quantization compressed-tensors --kv-cache-dtype fp8_e4m3 \
  --quantization-param-path scales/qwen38-fp8-kv-scales-per-head.json \
  --speculative-algorithm DFLASH --speculative-draft-model-path ~/models/Qwen3.8-27B-DFlash2-W4A16 \
  --speculative-draft-kv-cache-dtype fp8_e4m3 --speculative-num-draft-tokens 8 \
  --context-length 200000 --max-total-tokens 185000 \
  --max-running-requests 4 --cuda-graph-max-bs-decode 4 \
  --mem-fraction-static 0.88 --mamba-ssm-dtype bfloat16 \
  --mamba-radix-cache-strategy extra_buffer_lazy --disable-custom-all-reduce \
  --enable-hierarchical-cache --hicache-ratio 2 --hicache-size 15 \
  --hicache-io-backend direct --hicache-mem-layout page_first_direct \
  --hicache-write-policy write_through --page-size 64 \
  --default-chat-template-kwargs '{"reasoning_effort": "medium"}'
VRAM 分佈(每卡):權重 9.7G(48%)/Mamba 池 2.2G/主 KV 池 FP8 2.8G(185K tokens)/draft KV 0.88G/CUDA graph 1.4G。HiCache host 層:主 KV 578K tokens(9.5G)+ draft 2.96G + mamba 5.5G,GPU:主機 ≈ 1:3。
五、Benchmark(temp 0.6、自然中文、輸出 512 token、伺服器端 gen throughput)
Prefill 聚合 ~1,030–1,370 tok/s(同併發無關):
- 單流 TTFT:1K 0.8s/8K 5.6s/32K 23s/64K 50s/100K 85s
- 4 併發 32K:106s(排隊線性)
Decode 對上下文長度極唔敏感(混合 Mamba 架構嘅甜點):
- 單流:1K ~70/8K ~58/32K ~57/64K ~55/100K 仲有 ~65(峰 71)tok/s
- 2 併發合計 105–160;4 併發合計 131–159(每人 33–40)
- DFlash:自然中文 accept 2.1–2.4;關 DFlash 單流得 59.7 → +110%
HiCache(agent 場景殺手鐧):
- 23K prompt:冷 17.9s → 暖 0.23s(77×)
- 迫爆 GPU 池(5×46K=230K>185K)之後重發最舊嗰條:0.29s 由 host 層還原(130×)
- 總需求 840K > GPU+host 795K 先會真 LRU 逐出 — 三層行為全部符合預期
同自己上篇雙 7900XTX 對比:decode 70 vs 78(XTX +10%)、32K prefill 1,280 vs 1,477(XTX +15%)— 兩邊好接近,但 X99+3080 全套成本平一個位。
六、陷阱清單
--max-total-tokens唔好釘 200K:填滿 budget 後 Mamba 池冇鬆位,兩條 32K 同時 prefill 會Can not alloc mamba cacheassert 直接殺 scheduler。185K 穩定- MRR=2 + 雙長文同時 prefill 會炸、MRR=4 反而唔會(怪但實測;而家默認 4)
- DFlash 量測陷阱:投機解碼每步爆發式輸出 2.1–2.4 token,數串流 ITL 計速度會錯到阿媽都唔認得;用 usage token 數/時間或者伺服器 gen throughput。另外 accept 同內容有關:亂碼 benchmark 3.4–3.9、自然中文 2.1–2.4
- FP8 KV scales 係靜態校準(per-head,TP=2 專用),唔好套去第個模型/TP
- X99 想玩 P2P 嘅省返:驗證鏈喺第二節,BAR1 256MB 一票否決
七、值唔值得玩?
511–800 蚊板U + 舊 DDR3 + 兩張 3080 20G 魔改:27B AWQ + DFlash2 單流 70 tok/s 互動好順、prefill 1,300 對 RAG/長文問答夠用、HiCache 對 agent 多輪場景價值爆錶(200× 還原)。諗住升級:CPU 換 E5-2690 v3 意義唔大(推理 CPU 唔係瓶頸),RAM 加到 128G(DDR3 好平)畀 HiCache host 層翻倍反而最實際。
-
P2P 验证链很完整,结论也对:X99 上驱动层全绿但卡在 BAR1 256MiB,
cudaDeviceEnablePeerAccess的 "mapping of buffer object failed" 就是 peer mapping 塞不进 BAR1 窗口;没有 Above-4G/ReBAR,换哪个 P2P 补丁都绕不过固件。256MB peer copy 实测 6.0 GB/s 也合理——经 host 中转的 DtoD 要过两次 PCIe 3.0 x16,有效带宽本来就在 6–8 GB/s 档,和 x16 理论 15.75 GB/s 差一半来自 bounce buffer。几个还能再榨的点:
- 既然实际传输走 SHM/host,先确认 NCCL 到底选了哪条 transport:
NCCL_DEBUG=INFO会打 Transport 行,看是不是反复尝试 P2P 再回退;NCCL_P2P_DISABLE=1可关掉无效的 P2P 探测,省启动时间、也避免偶发 mapping 报错。 - Haswell-EX 两个 root port(00:02.0 / 00:03.0)各挂哪颗 CPU、内存归哪个 NUMA 节点,用
numactl --hardware+cat /sys/class/pci_bus/0000:03/device/numa_node核一下;把 SGLang 绑到两个 root port 共同的节点,allreduce 走本地内存,TP 抖动会小很多。 - 驱动 615.71.09 带来 +32%(125.8→166.2)很值得单独复测:同 SGLang commit、同 sharegpt prompt、同 power limit,旧/新驱动各跑一遍离线 benchmark,排除这次同时做 CUDA 工具链对齐的干扰。纯驱动能稳定 +30% 的话,够再发一帖。
mem-fraction-static 0.88和「不要 runtime 停 gdm」都是对的坑,后者(停 gdm 触发 driver panic)建议加进你上一篇的踩坑清单。
DFlash2 在 SM86 上停 symm-mem logits gather 是关键改动,期待单流 70 tok/s 的 pp/tg 分曲线和不同 draft 长度对比。
- 既然实际传输走 SHM/host,先确认 NCCL 到底选了哪条 transport:
-
-
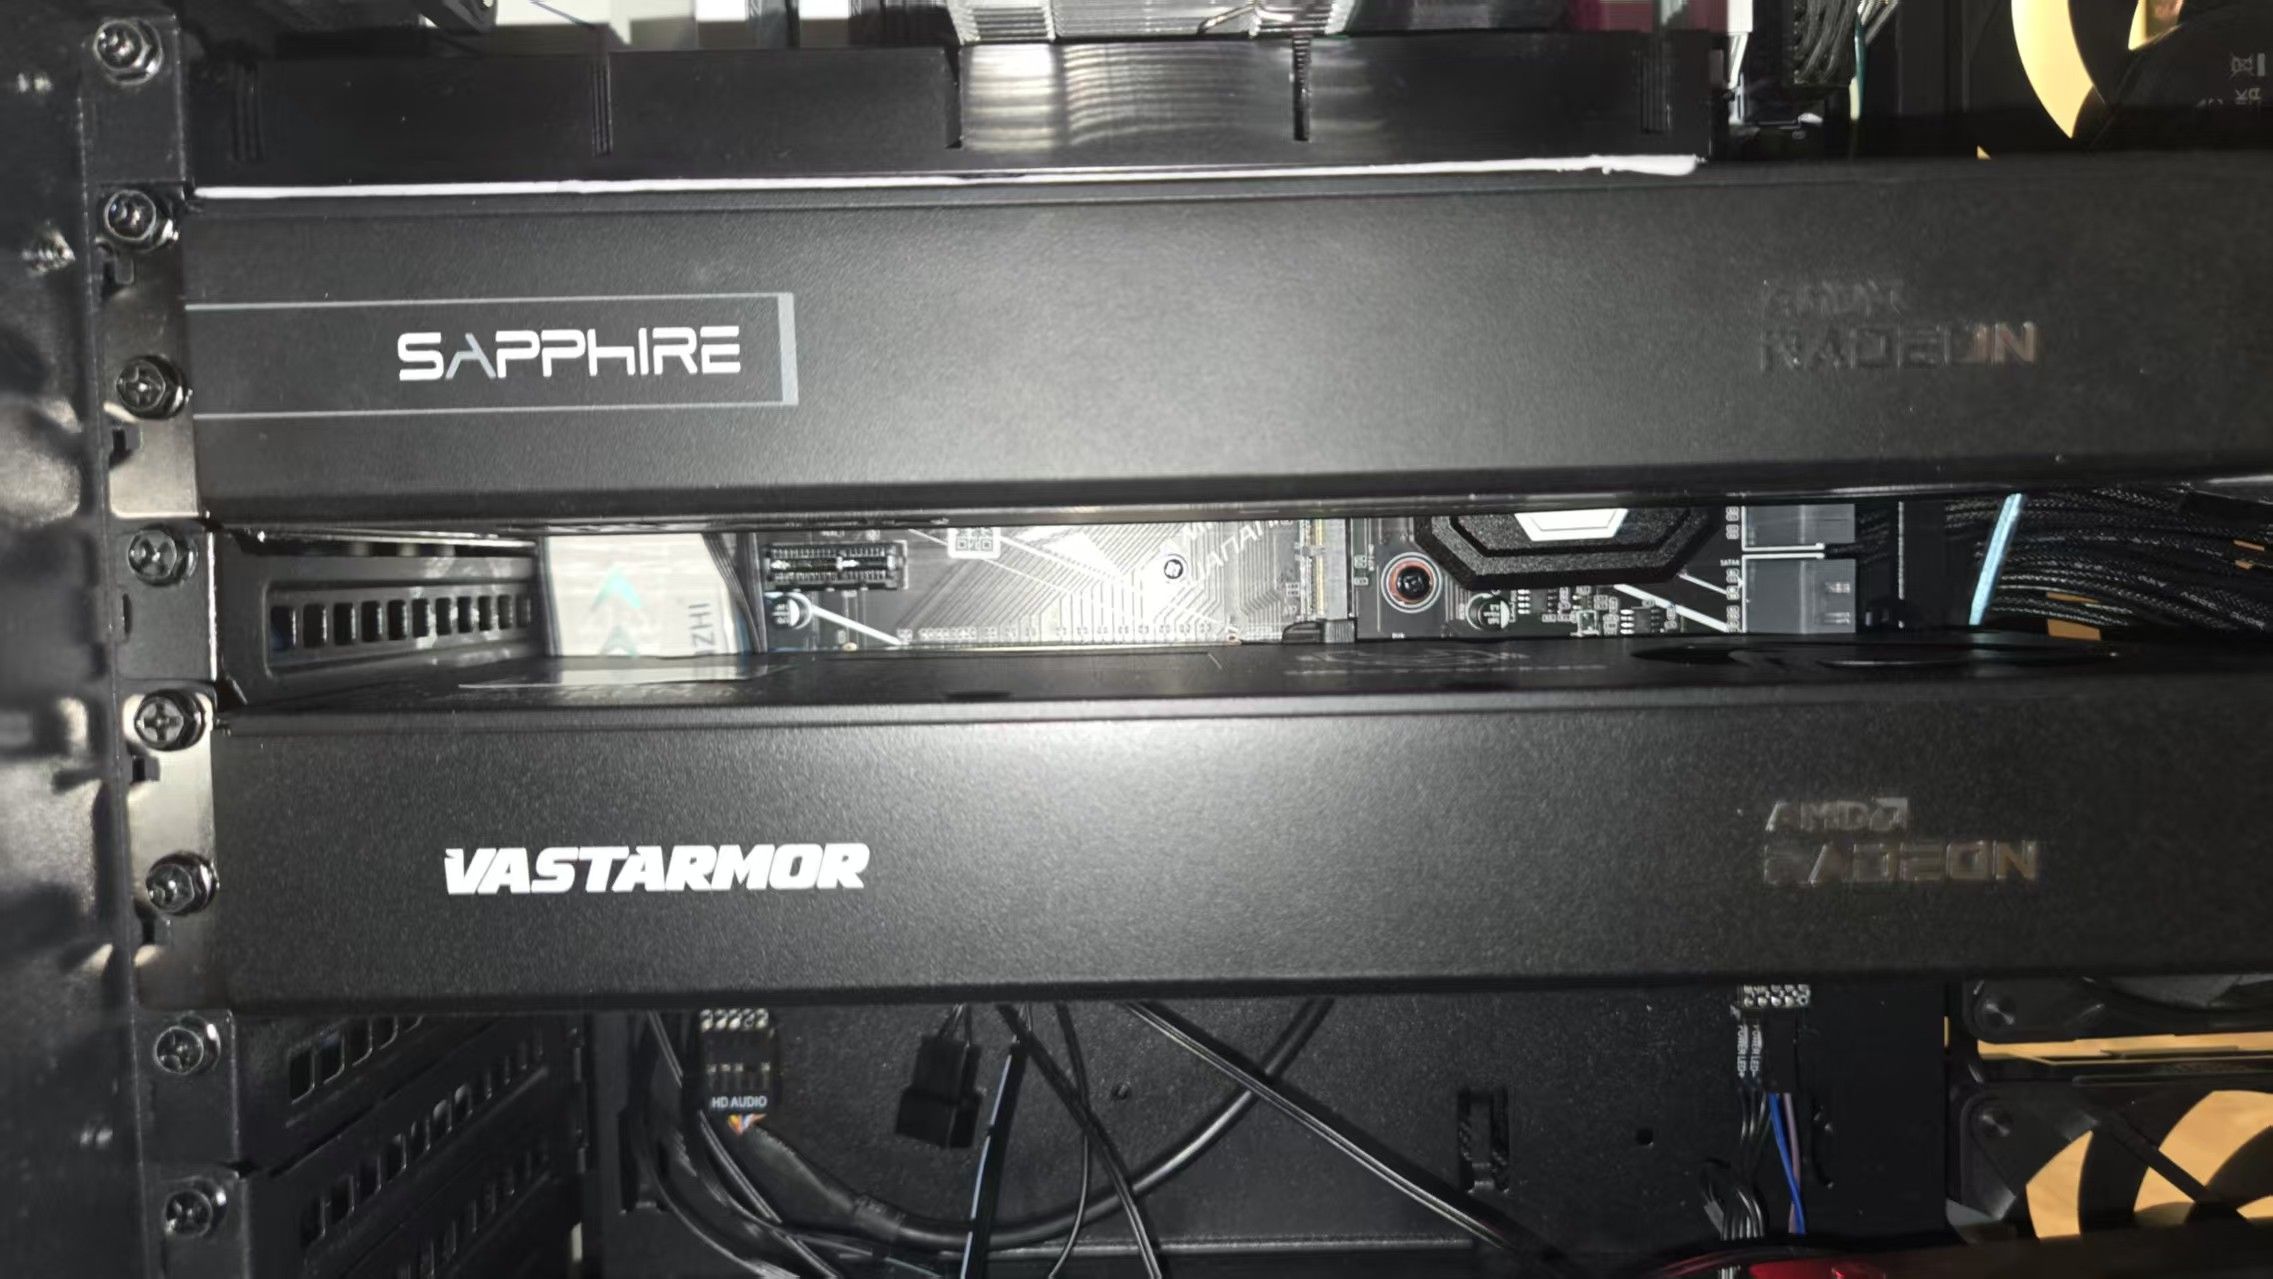
我这边也在折腾一套 X99 + 双卡,补充一个不太一样的情况,给后来想玩 X99 多卡的人参考。
我的平台是:
- 主板:X99-TF GAMING V6.0
- CPU:E5-2697A v4
- GPU:双 Radeon AI PRO R9700 32G
- 系统:Ubuntu 24.04
- 两张卡 CPU 侧都是 PCIe 3.0 x16
- BIOS 可以开 Above 4G / ReBAR
- 两张 R9700 都能拿到完整 32GB BAR
1. 我这边的 X99 实际可以跑真 P2P
一开始也是完全没有 P2P。
后来一路查下来,Broadwell-EP 的 Host Bridge
8086:6f00没有进入 Linux P2PDMA whitelist,所以我给内核补了这个 exact whitelist,同时补了 ROCm/ROCK 里 HSA P2P 的兼容判断。现在这台机器已经实测:
hipDeviceCanAccessPeer双向正常- HIP peer copy 双向正确
- HIP IPC 双向正常
- RCCL 能确认双向走 P2P/IPC
- 没有退回 SHM
- HIP 大块 P2P 实测约 10.3 GB/s
- RCCL 大块 AllReduce 约 9.5 GB/s
所以我现在的理解是:
X99 不能简单归纳成“不支持 P2P”。
楼主这台 3080 的情况,确实是被 256MB BAR1 / BIOS 没有 Above-4G、ReBAR 卡住了。
但如果主板能开完整 ReBAR,再把 Linux / ROCm 这一层补齐,Broadwell X99 实际上是可以跑真 P2P 的。
2. 后面踩到的问题,反而大部分不是 P2P
我后面跑双卡 SGLang 时,也碰到过很吓人的问题:
- HIP 709
- GFXHUB permission fault
- Rank1 一跑 Triton 就炸
一开始也怀疑是不是 X99 P2P 不稳定。
后来追了很久,最后发现真正原因是我当时用
LD_PRELOAD注入自己编的 RCCL,结果一个进程里同时装进了 两份libamdhip64。Rank1 上两套 HIP runtime 连 current device 都不一致:
- 一套认为当前是 GPU0
- 一套认为当前是 GPU1
所以 Triton kernel 最后会拿错 context / address space 去跑。
改成:
- 不用
LD_PRELOAD - 直接把 patched RCCL bind mount 到 PyTorch 自己的
librccl.so
之后问题完全消失。
所以这个坑给我的感受也挺深:
很多看起来像“P2P 不稳定”的问题,其实可能是 userspace runtime / library namespace 问题。
3. Qwen3.8-27B AWQ 当前进展
现在这套:
- Qwen3.8-27B AWQ
- SGLang
- 双 R9700
- RCCL Direct P2P
- plain autoregressive
- MTP / DFlash 都关闭
已经稳定跑起来了。
有一个结果比较有意思。
Decode Graph 关闭
单并发:
- TP1:约 10 tok/s
- TP2:约 7.6 tok/s
一开始看到这个结果,我也以为是 X99 / PCIe3 / P2P 太慢。
Decode Graph 打开之后
严格同 workload 重新测:
- TP1:25.28 tok/s
- TP2:25.51 tok/s
也就是说之前 7.6 tok/s 的主要问题,其实是 eager 模式下大量 kernel launch / synchronization overhead,不是 P2P 链路坏了。
但另外一个结果也很明确:
TP1 Graph ON = 25.28 tok/s TP2 Graph ON = 25.51 tok/s TP2 / TP1 ≈ 1.01x -
此主題已被删除!
-
-
@terry 都是同一個帳號呀,沒有分開呀。不過就是有三台電腦
-
-
@terry 下星期應該還有 2X 3090 NVLink
 手多買了又買