Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G
-
-
-
-
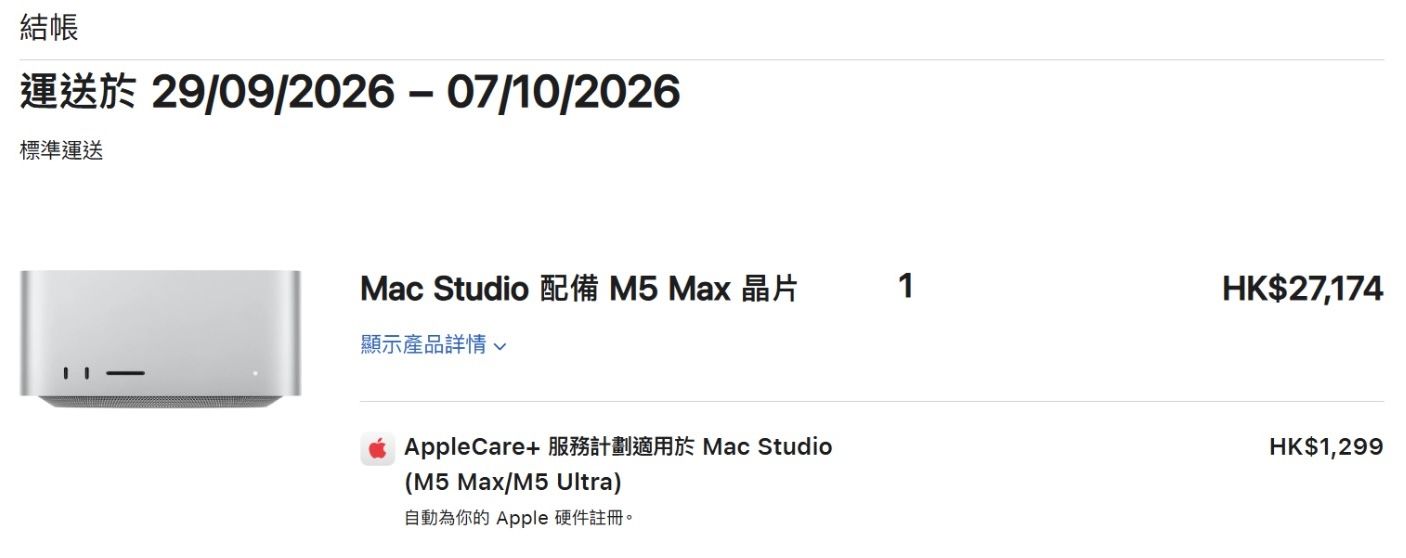
我选Mac Studio M5 Max的理由:
等M5 Max Studio的原因:
- MacBook 14 散热太差其实跑不动M5 Max
- MacBook 16 依然很难发挥Max全部能力,同时便携性很差;除非贪他的优秀大屏。
- 个人没有很大的移动办公需求;现在出门可以用Telegram远程下指令调配任务,固定的工作站式24*7的服务器模式更合适。已经在用M4的Mac Mini作为小型家庭服务器,体验极佳。
- 相比MacBook,相同配置Studio价格更实惠
-MacBook 16 Max-40GPU,64G,2T-最低标配 - $5,399; 直逼低配Ultra了 ($5,499) - 为什么选这个配置 (40GPU, 64G内存)?
- 32GPU只有400多G内存带宽;40GPU才有614G (Ultra 统一都是1.2T)
- 128G内存价格也直逼Ultra低配版了(1T硬盘,$5,399),(96G内存 $5,499; 有这个预算的话,个人建议直接上最低配的Ultra
- 个人暂时没有音视频工作流的打算,如果有大多也不会选Mac吧;多开还是Ultra高带宽高内存更好;当然有钱啥都不是事儿;综合考量着现在这个价位能跑本地Qwen3.8-27B游刃有余,可坚固日常办公Agent任务需求;是很好的中间位
- 缺货问题。现在我这边Max 128G是期货,待机1个月+

; Ultra 低配待机已经超过2个月

;
-
第一手测试资料:
先说基准测试 - MLX:
Qwen3.8-27B-MLX-6bit (模型 22.8G)
目前四档实测
Context Prefill Decode Peak Memory 512 tokens总时间
8K 921.3 tok/s 23.17 tok/s 25.26 GB 30.9 s
32K 845.4 tok/s 21.62 tok/s 26.87 GB 62.5 s
128K 596.8 tok/s 16.69 tok/s 33.69 GB 248.8 s
256K 436.7 tok/s 13.05 tok/s 42.74 GB 643.7 sQwen3.8-27B-MLX-4bit (模型 16.1G)
Context Prefill Decode Peak Memory 512 tokens总时间
8K 985.1 tok/s 31.92 tok/s 18.53 GB 24.3 s
128K 626.1 tok/s 21.10 tok/s 26.96 GB 231.6 s
256K 447.2 tok/s 15.49 tok/s 36.01 GB 613.8 s基准和网上MacBook M5 Max的测试数据差不多;长上下文内存占用不多,256K 6Bit差不多42G,4Bit36G,还是跑的动,且有冗余20来G分配给系统和Agent等。长上下文是主要耗时还是在Prefill,将近10分钟。
-
-
-
用oMLX加载MTPLX优化的模型,关闭思考,启用Lightning MTP
Model用的是Qwen3.8-27B-MTPLX-Optimized-Speed (19.5G)
执行简单回话,任务,写个贪吃蛇小游戏
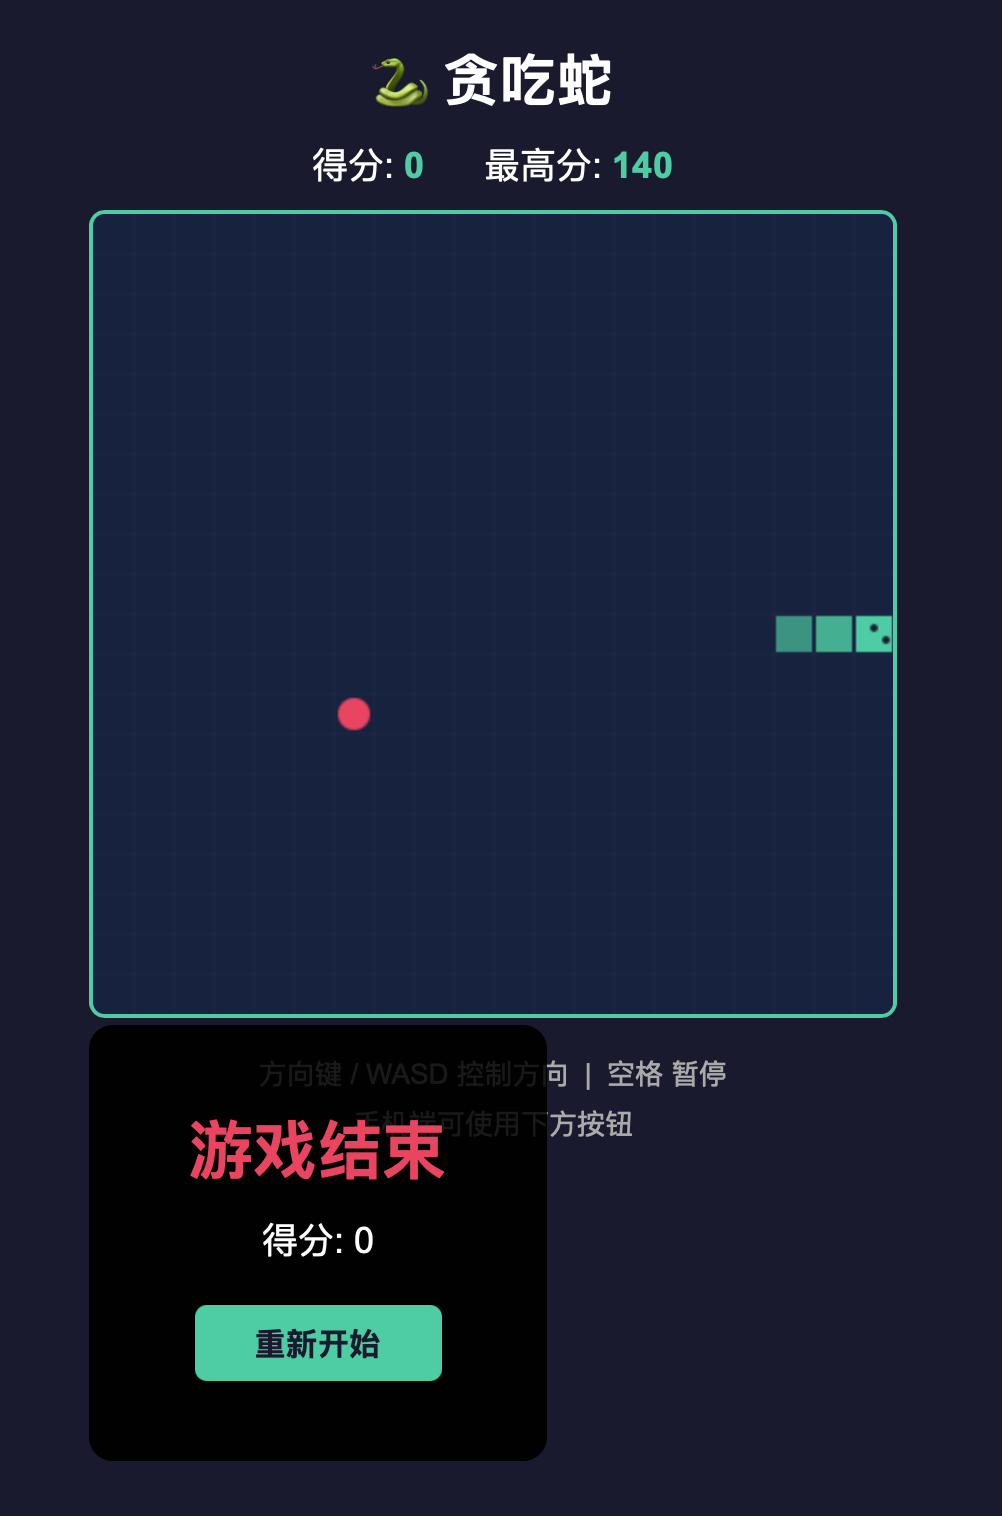
一次成功,图形画面也不错
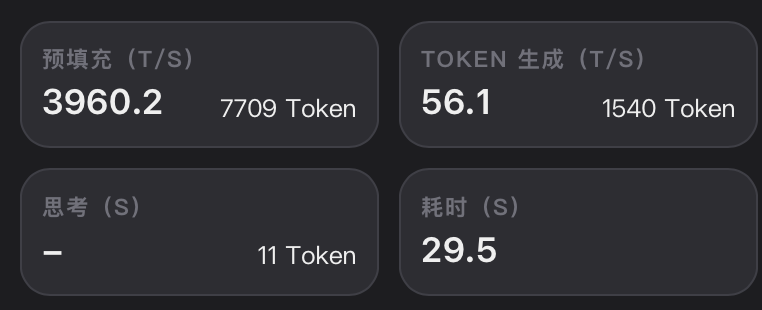
数据还挺漂亮。
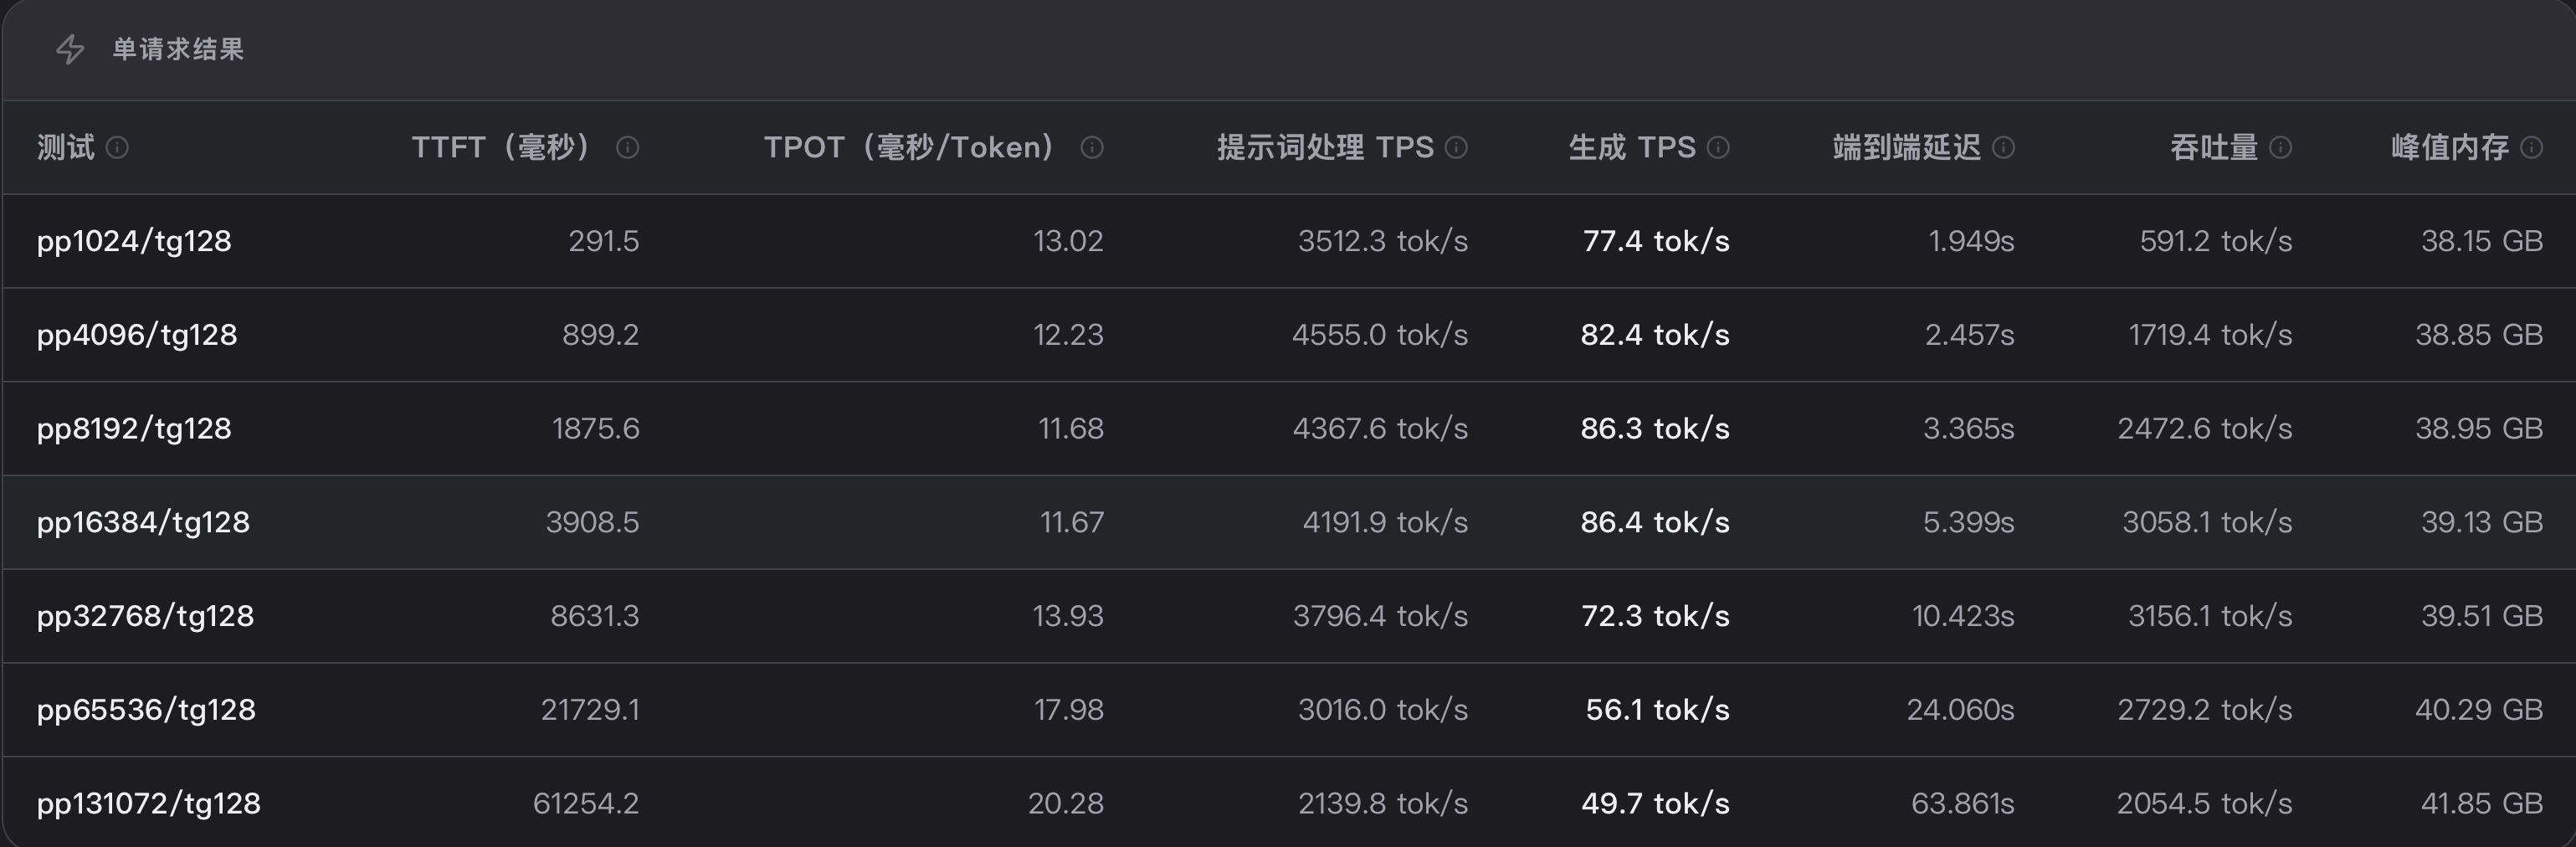
性能测试结果: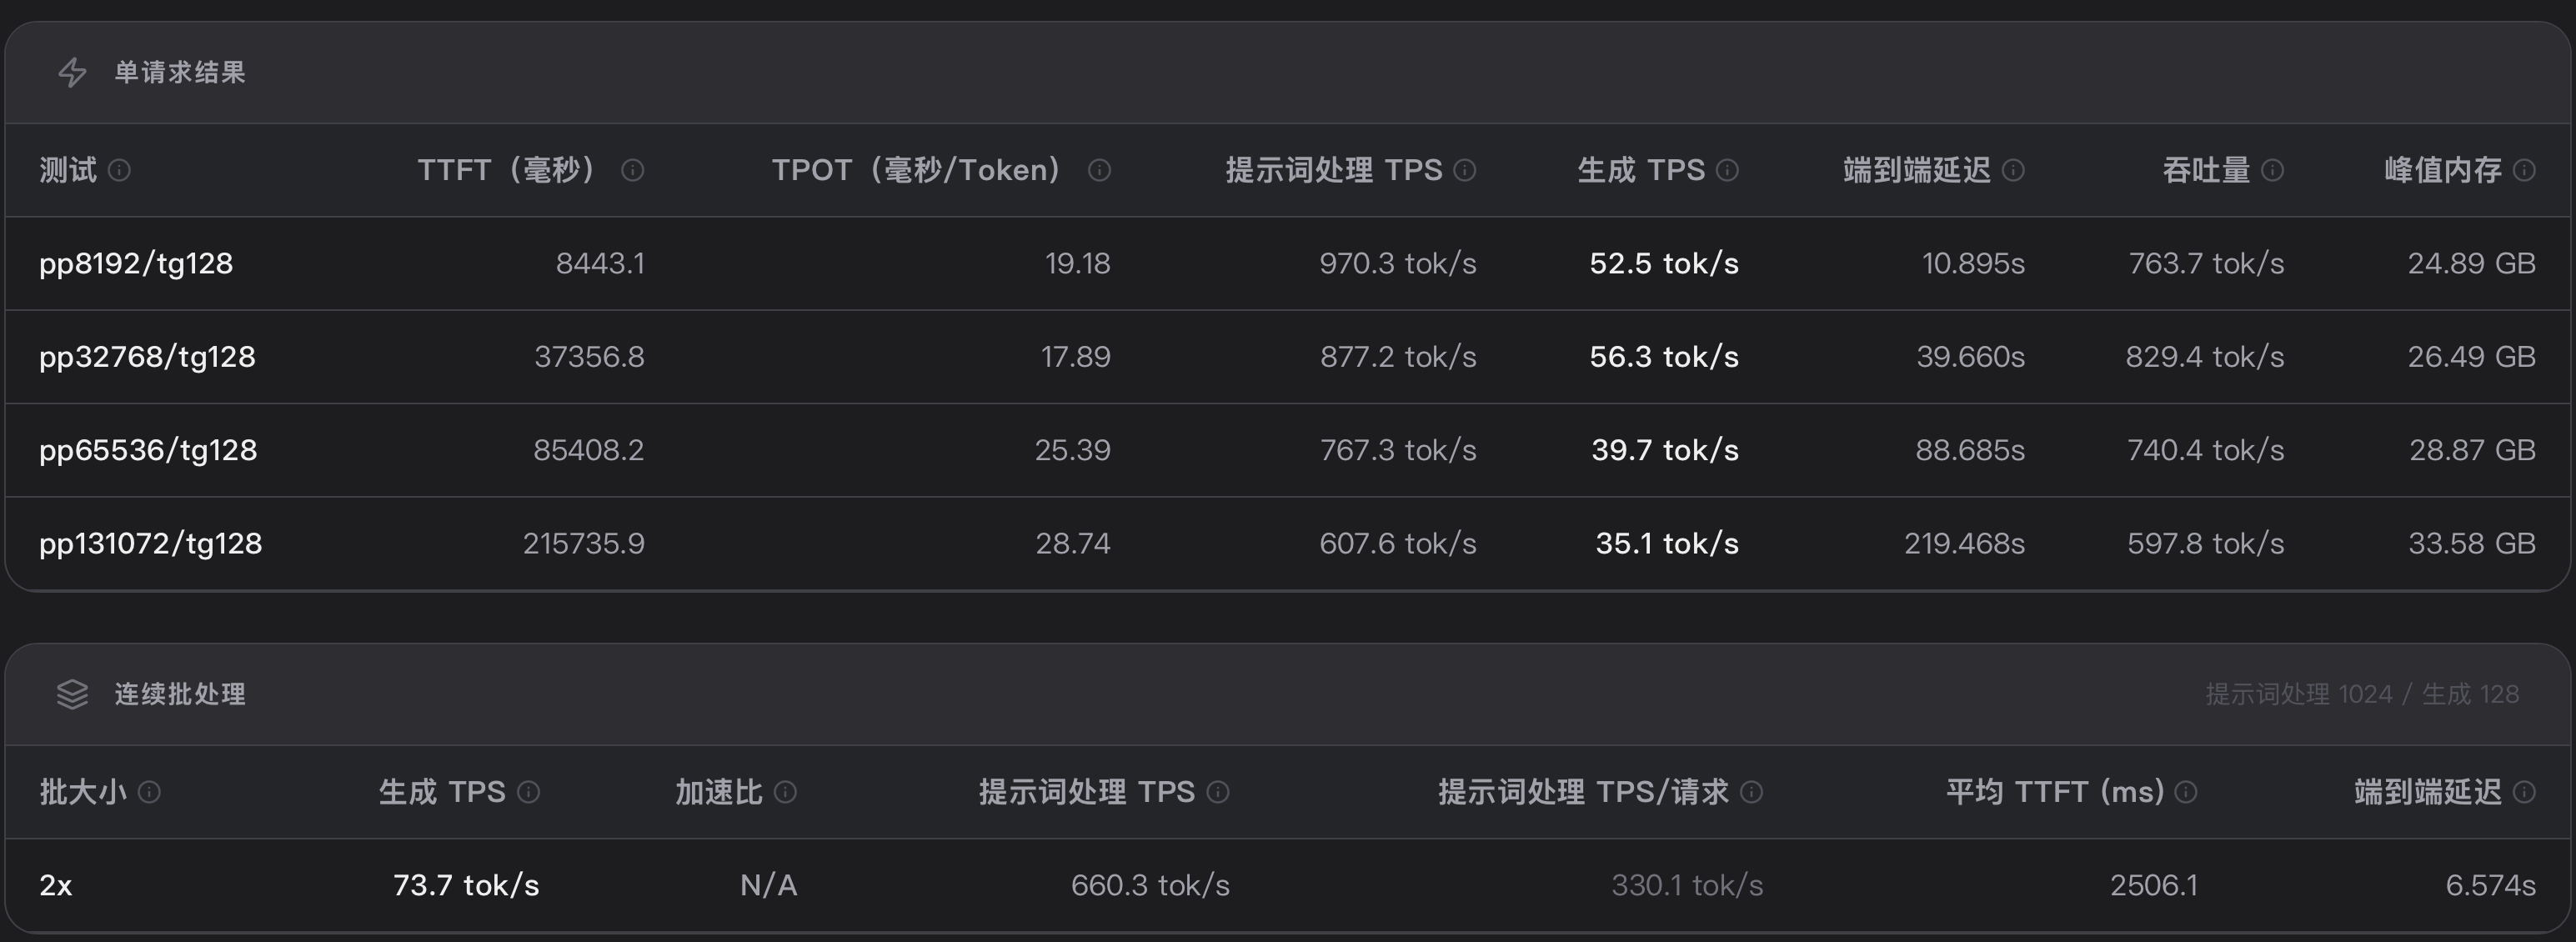
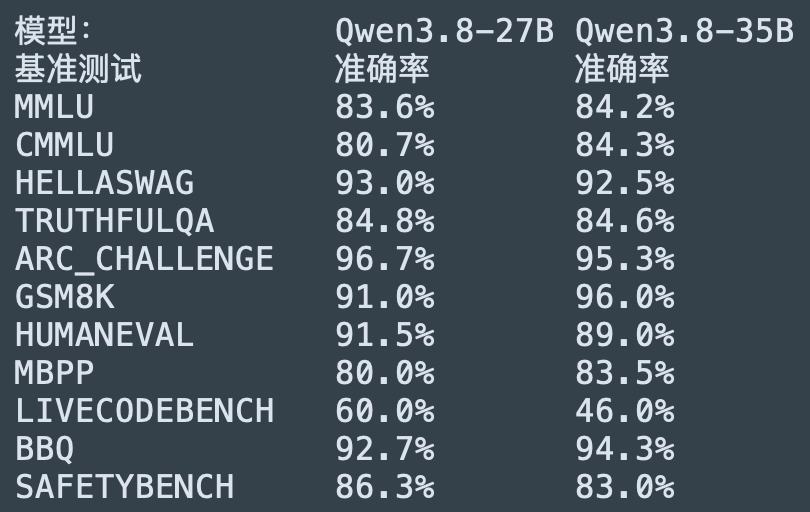
智力测试结果:
智能基准对比模式 抽样 Qwen3.8-27B-MTPLX-Optimized-Speed
MMLU 抽样 1000/14042 83.6%
CMMLU 抽样 300/11582 80.7%
HELLASWAG 抽样 200/10042 93.0%
TRUTHFULQA 全量 817 84.8%
ARC_CHALLENGE 抽样 300/1172 96.7%
WINOGRANDE 抽样 300/1267 79.0%
GSM8K 抽样 100/1319 91.0%
HUMANEVAL 全量 164 91.5%
MBPP 抽样 200/500 80.0%
LIVECODEBENCH 抽样 100/1055 60.0%
BBQ 抽样 300/10864 92.7%
SAFETYBENCH 抽样 300/11435 86.3%--- 详情 ---
模型:Qwen3.8-27B-MTPLX-Optimized-Speed
基准测试 准确率 正确 总数 Time(s) 思考MMLU 83.6% 836 1000 856 否
CMMLU 80.7% 242 300 93.5 否
HELLASWAG 93.0% 186 200 82.9 否
TRUTHFULQA 84.8% 693 817 245.3 否
ARC_CHALLENGE 96.7% 290 300 106.8 否
WINOGRANDE 79.0% 237 300 79.7 否
GSM8K 91.0% 91 100 515 否
HUMANEVAL 91.5% 150 164 375.9 否
MBPP 80.0% 160 200 535.2 否
LIVECODEBENCH 60.0% 60 100 2561 否
BBQ 92.7% 278 300 86.2 否
SAFETYBENCH 86.3% 259 300 91 否可能是关闭思考的关系,LiveCodeBench测试只拿到了60%
别的基本都还挺高 -
-
-
-
-
-
-
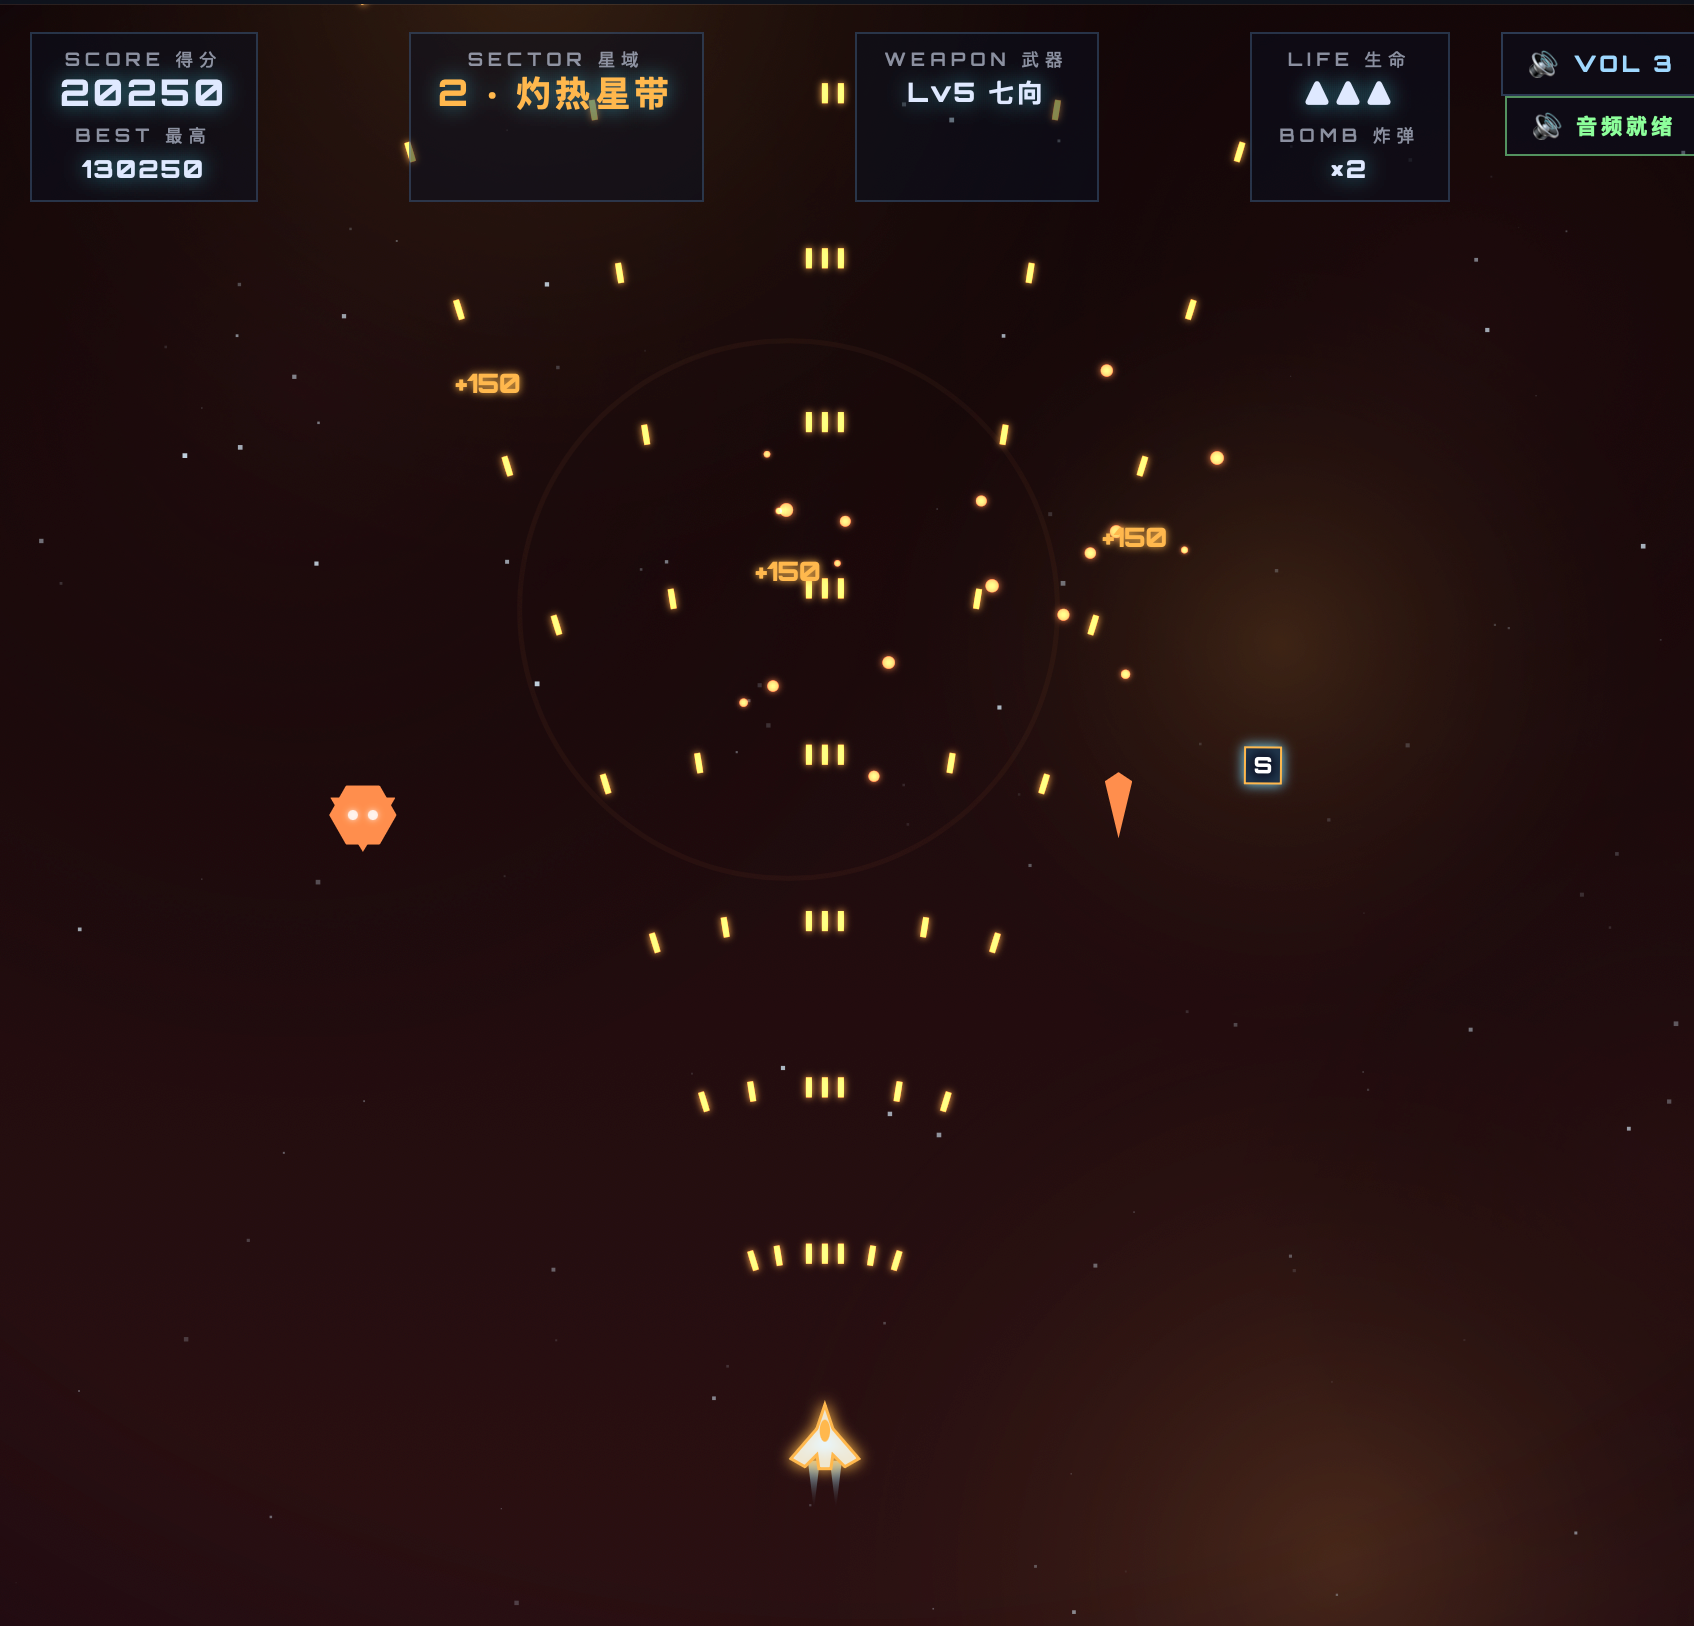
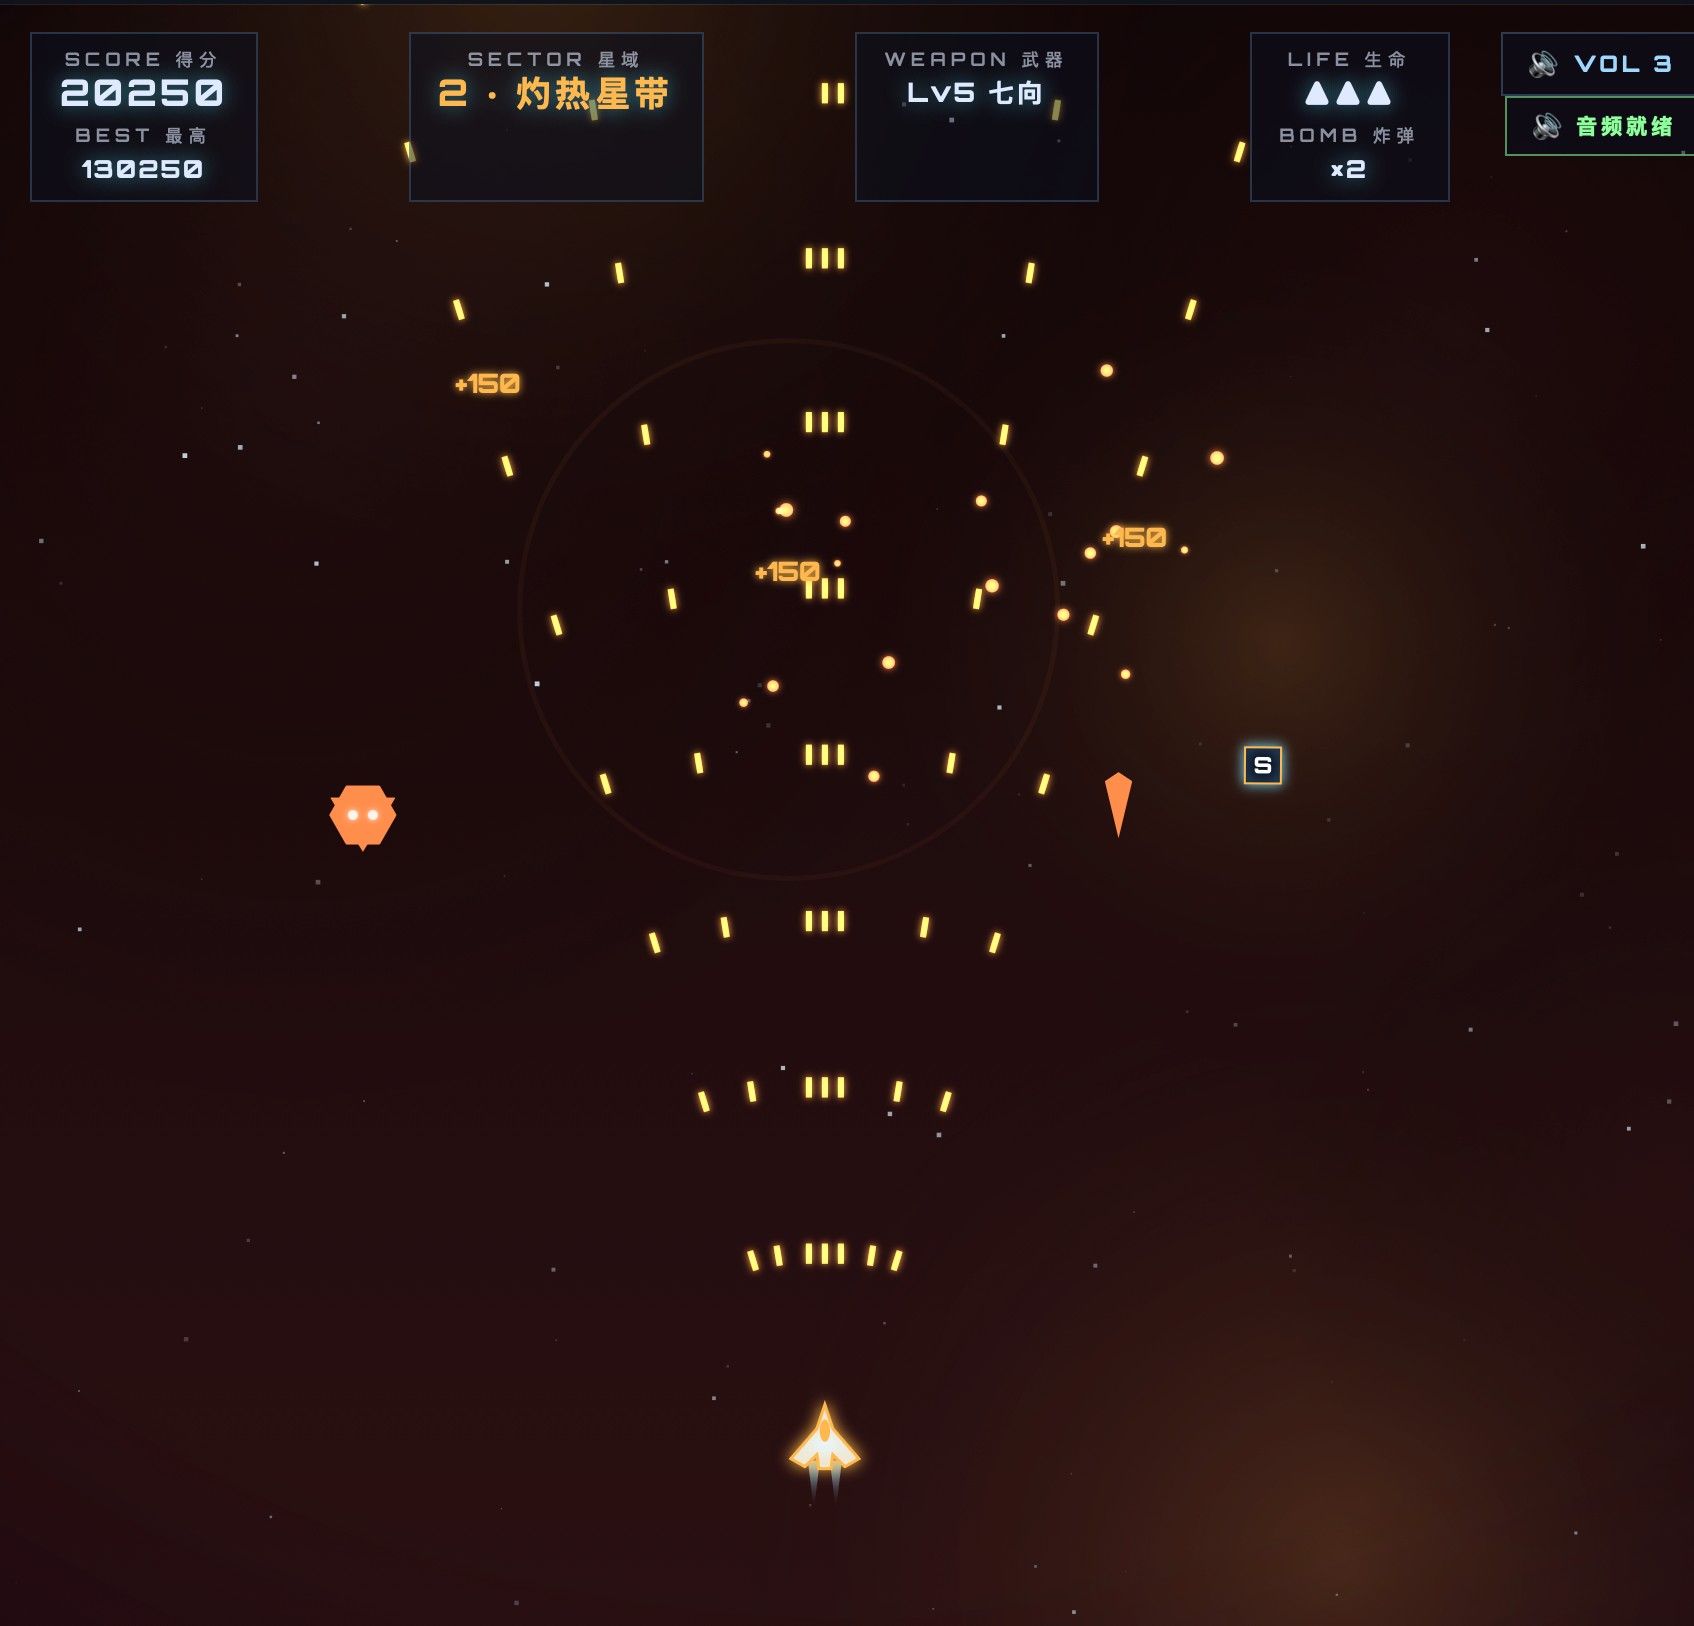
半实战测试,让Qwen3.8-27B 写了个射击小游戏;反复修一些小bug;调整关卡难度,物品掉落折腾了半天。期间大部分由hermes调配完成。不知道是不是DSH对非自家模型适配的调配机制问题。给了他几个请求发一起,他一通思考然后就爆上下文罢工了。期间还报错在自己workspace内的文件他自己无法修改,最后爆掉了。
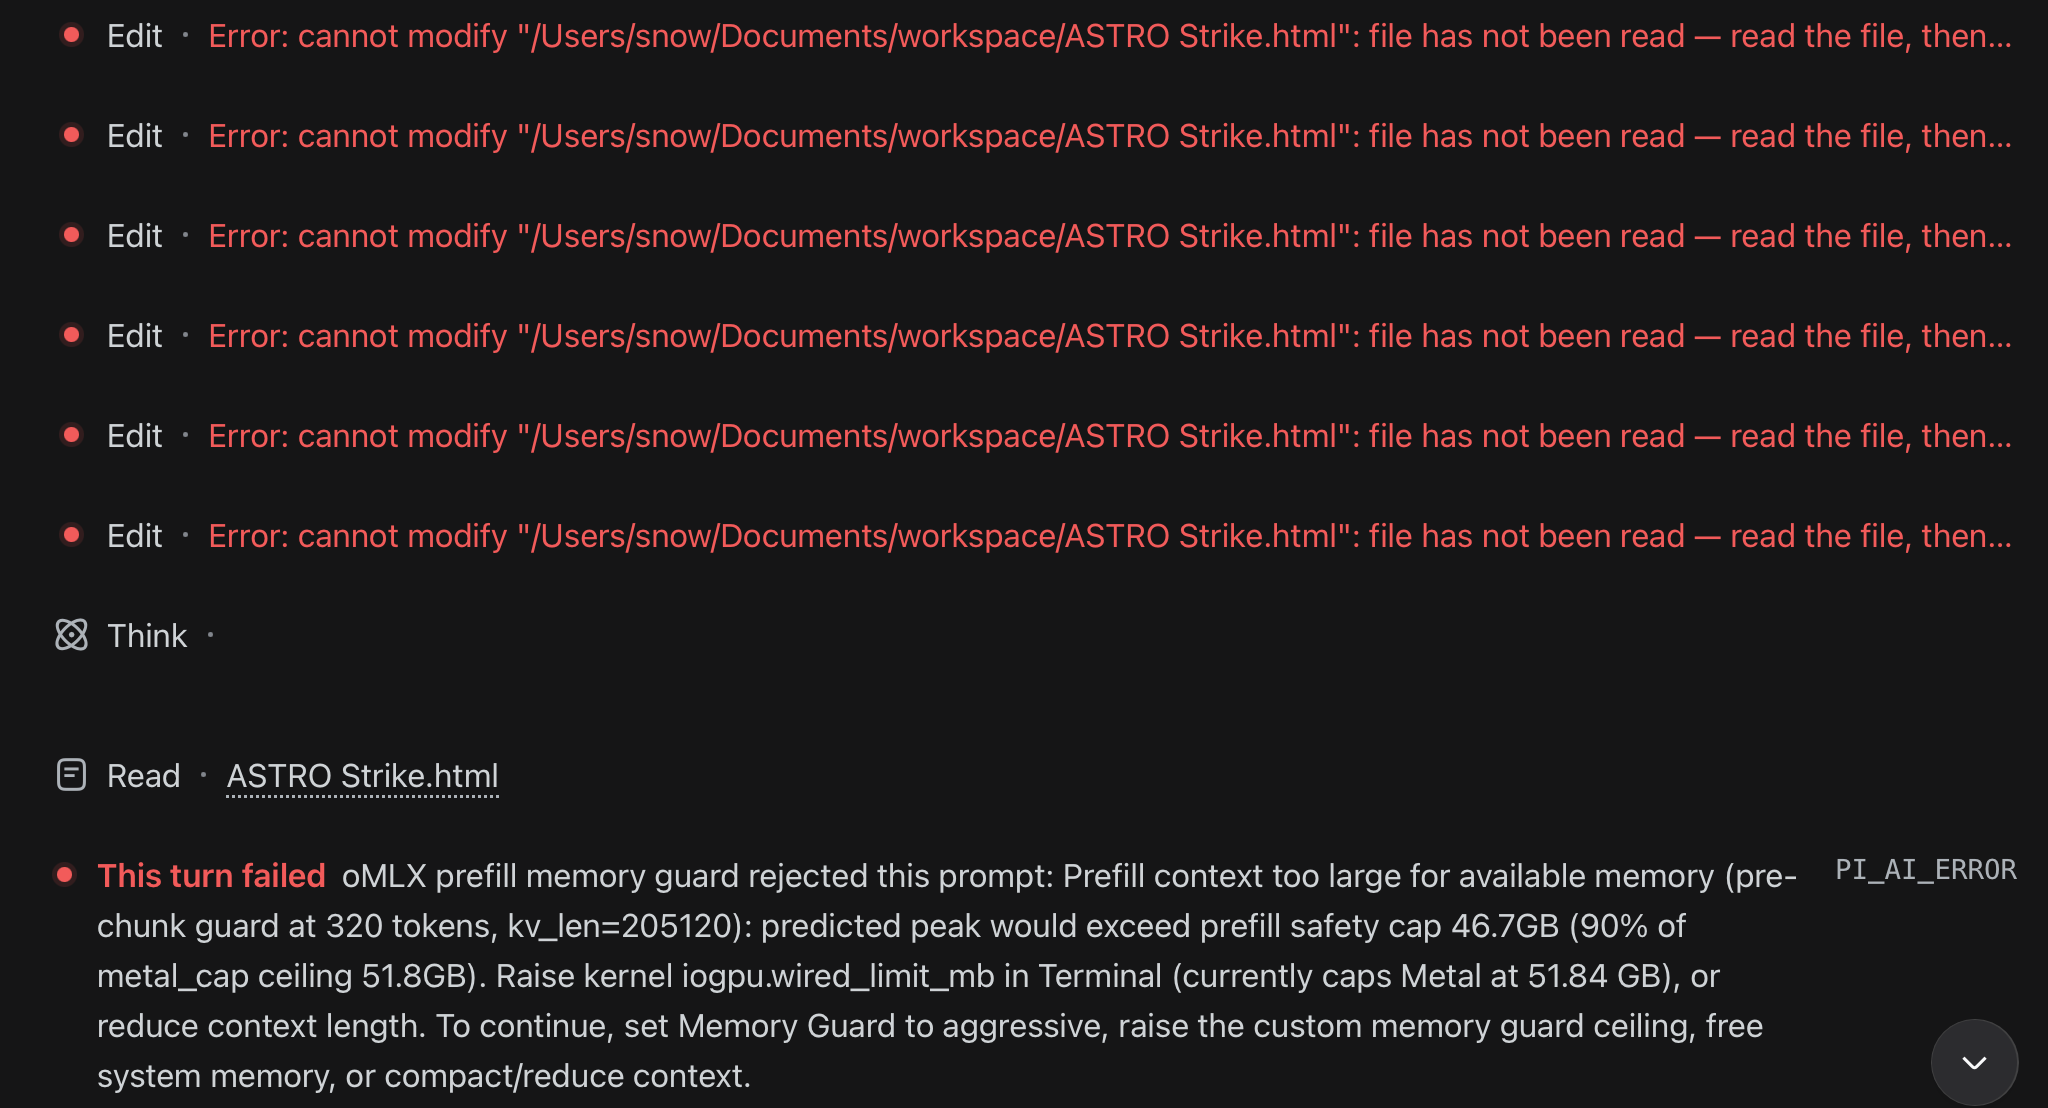
还请DSH大神指导。
然后我让Hermes去查,就是可以修改的,没问题。是DSH打开文件,又开了个复件自己修改自己被拒。。。我也是没想明白DSH怎么把自己绕进去的。
然后就让Hermes持续开发完善了小半天。长上下文持续工作下,输出就降到了33 Tok/s。
今天让35B-A3B开发了第四关,很顺利的一把完成。没遇上什么问题。因为上下文压力也比较小,输出在62 Tok/s
也算模拟小规模实际开发时,2个模型大概的能力展示。27B稠密模型这个速度也还算是可以接受,就是心理预期知道,实际能力很难维持50 Tok/s左右的。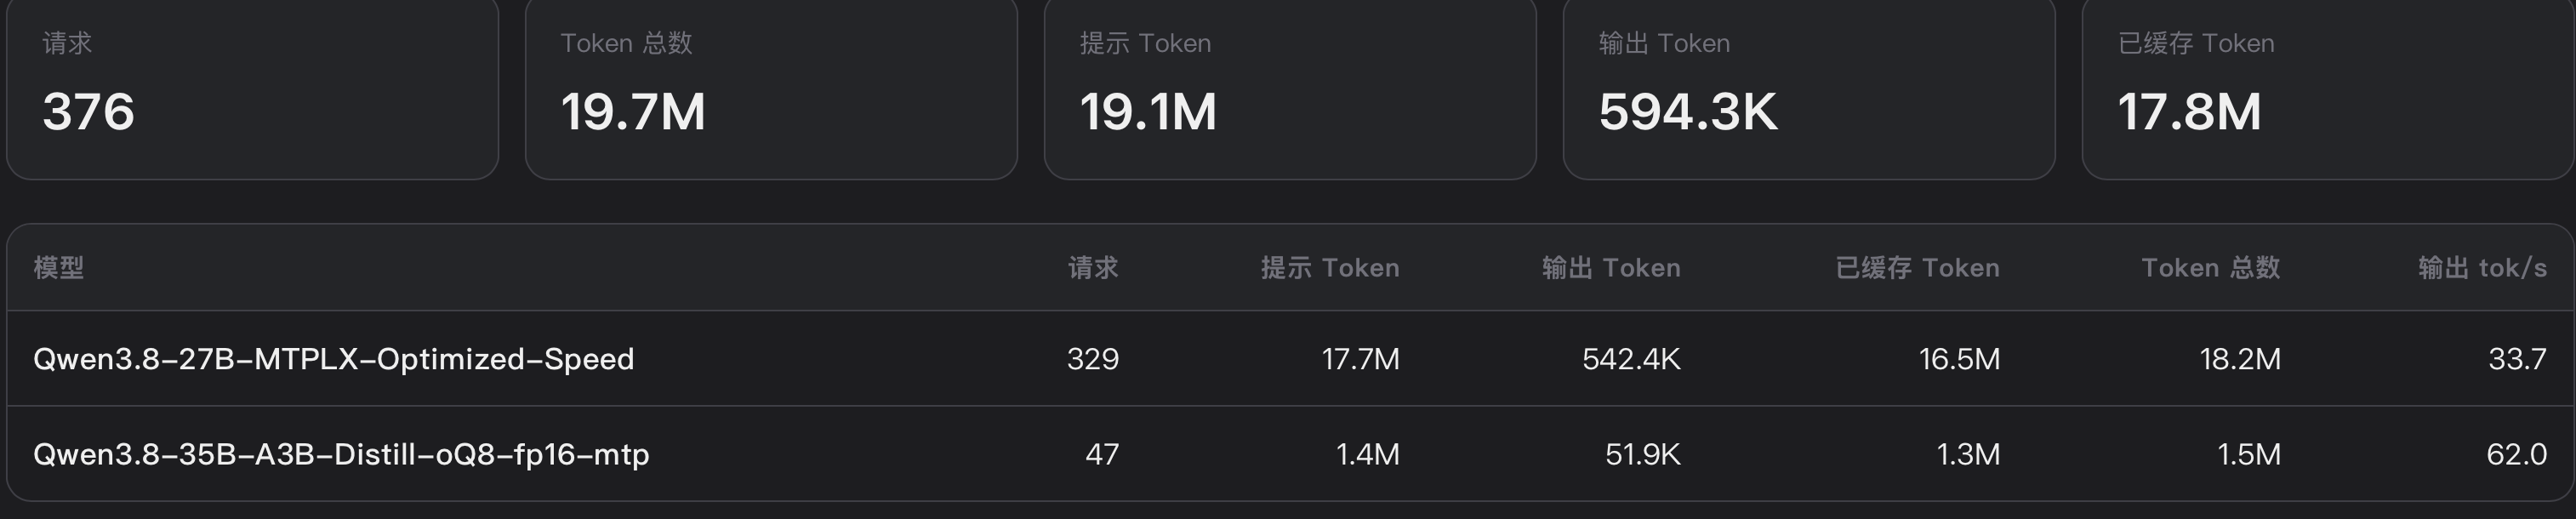
-
-
Mac M2 Max测试本地模型Qwen3.8-27B-4bit、Qwen3.8-27B-Uncensored-oQ4e-mtp模型在 oMLX(Mac M2 Max 环境) 下的横向深度对比:oMLX - LLM inference, optimized for your Mac
https://github.com/jundot/omlx
Benchmark Model: Qwen3.8-27B-4bit
Engine: Auto
Context: 代码(Python)
================================================================================
Single Request Results
Test TTFT(ms) TPOT(ms) pp TPS tg TPS E2E(s) Throughput Peak Mem
pp1024/tg128 9048.7 50.86 113.2 tok/s 19.8 tok/s 15.531 74.2 tok/s 15.85 GB
pp4096/tg128 34039.8 52.03 120.3 tok/s 19.4 tok/s 40.670 103.9 tok/s 17.10 GB
Continuous Batching
预处理1024 / 生成128
Batch tg TPS Speedup pp TPS pp TPS/req TTFT(ms) E2E(s)
1x 19.8 tok/s 1.00x 113.2 tok/s 113.2 tok/s 9048.7 15.531
2x 33.6 tok/s 1.70x 90.6 tok/s 45.3 tok/s 17273.3 30.233
4x 62.8 tok/s 3.17x 78.3 tok/s 19.6 tok/s 31000.7 60.467
oMLX - LLM inference, optimized for your Mac
https://github.com/jundot/omlx
Benchmark Model: Qwen3.8-27B-Uncensored-oQ4e-mtp
Engine: Auto
Context: 代码(Python)Single Request Results
Test TTFT(ms) TPOT(ms) pp TPS tg TPS E2E(s) Throughput Peak Mem
pp1024/tg128 8955.1 50.04 114.3 tok/s 20.1 tok/s 15.330 75.1 tok/s 22.34 GB
pp4096/tg128 33851.1 57.56 121.0 tok/s 17.5 tok/s 41.180 102.6 tok/s 23.70 GBContinuous Batching
预处理1024 / 生成128Batch tg TPS Speedup pp TPS pp TPS/req TTFT(ms) E2E(s)
1x 20.1 tok/s 1.00x 114.3 tok/s 114.3 tok/s 8955.1 15.330
2x 28.8 tok/s 1.43x 91.5 tok/s 45.8 tok/s 16951.1 31.272
4x 47.3 tok/s 2.35x 81.3 tok/s 20.3 tok/s 30249.7 61.207
数据深度分析如下:一、 关键指标对比(oQ4e-mtp vs. 常规 4bit)指标常规 4bit 模型oQ4e-mtp 模型变化分析内存峰值 (Peak Mem)15.85 - 17.10 GB22.34 - 23.70 GB大增约 6.5 GB (+38%),接近纯 6-bit 的开销单生成速度 (tg TPS)19.8 tok/s20.1 tok/s (pp1024)17.5 tok/s (pp4096)基础生成速度相当,但在长上下文下略有所衰减Prefill 吞吐量 (pp TPS)113.2 ~ 120.3 tok/s114.3 ~ 121.0 tok/s首字响应(TTFT)性能几乎完全一致Continuous Batching (4x)62.8 tok/s (3.17x)47.3 tok/s (2.35x)并发性能明显下降 (-25%)二、 性能与技术细节拆解为什么内存增加到了 22.34 - 23.70 GB?oQ4e 混合精度量化:它不是普通的均匀 4-bit 量化,而是通过 importance-matrix(重要性矩阵 calibration)对关键层/注意力层提高了精度(提升至 5-bit 或 fp16),因此实际权重体积接近 6-bit 量化。 MTP (Multi-Token Prediction / 投机/多Token预测模块):附加了 MTP 预测头,这需要额外的显存空间用于加载加速权重和维持额外的 KV Cache。 为什么单生成速度没有大幅提升?MTP 本质是通过 Speculative Decoding(投机采样)以计算换速度。但在 M2 Max(显存带宽约 300-400 GB/s) 这种带宽受限设备上,当权重增长到 22GB+ 时,内存带宽瓶颈冲淡了 MTP 带来的并行收益。长上下文(pp4096)下生成速度降至 17.5 tok/s,也是因为更高的显存占用导致 Cache 访问开销变大。为什么多并发 (Continuous Batching) 性能下降严重?从 4x 批处理来看,常规 4bit 可以达到 62.8 tok/s,而本模型降到了 47.3 tok/s。这是由于 MTP 模块和更高权重的模型在多 Request 并发时抢占显存带宽与 GPU 计算单元更剧烈,造成 Batching 的并行加速效率下降。 -
-
-